
Webbdata är det nya guldet för företag, men att få upp det ur marken är en helt annan historia. Jag har själv sett hur säljteam, e-handelsansvariga och marknadsanalytiker pressas att leverera insikter snabbare än någonsin — och den gamla kopiera-klistra-rutinen räcker helt enkelt inte längre. Enligt Gartner har 61 % av organisationerna tvingats lägga om sin data- och analysverksamhet på grund av AI:s påverkan, medan 80 % av företagsledarna säger att data nu är avgörande för beslutsfattande. Haken? De flesta team kämpar fortfarande med att få tag på de externa marknadssignaler de behöver, och det är där web scraping kommer in i bilden.
Extrahera data från vilken webbplats som helst med AI Get Started Free
Men låt oss vara ärliga: alla webbskrapare är inte skapade lika. Framväxten av verktyg som ClawdBot förändrar spelplanen för företagsanvändare som vill automatisera datainsamling, strukturera rörig webbinfo och faktiskt använda den för att driva resultat. Snabb namnhantering: ClawdBot bytte namn till Moltbot i slutet av januari 2026 efter ett varumärkesproblem med Anthropic, och döptes sedan om igen till OpenClaw ungefär tre dagar senare (2026-01-30) när projektet lutade åt öppen källkod. Installationskommandona och CLI:n i den här guiden använder det aktuella namnet openclaw; jag säger fortfarande "ClawdBot" i löptexten eftersom det är så de flesta läsare sökte efter det, och det underliggande verktyget är samma. Och när du kombinerar ClawdBot med AI-drivna hjälpredor som Thunderbit, öppnar du upp en helt ny nivå av effektivitet och precision.
Låt oss dyka in i vad som gör ClawdBot Web Scraping så kraftfullt, hur du kommer igång och hur du kombinerar det med Thunderbit för affärsframgång.
Vad är ClawdBot Web Scraping? Din väg till smartare företagsdata
ClawdBot är i grunden en plattform för personliga AI-agenter som kan automatisera webbaserade uppgifter, hämta information och strukturera data — utan att du behöver vara utvecklare. Tänk på det som din digitala forskningsassistent, som kan köras i webbläsaren, styra Chrome-flikar och schemalägga scrapingjobb så att de rullar på automatiskt.
Kärnfunktioner:
- Automatisk dataextraktion: ClawdBots verktyg “web_fetch” kan hämta innehåll från statiska webbsidor och göra om det till läsbar, strukturerad text eller markdown. För mer interaktiva eller dynamiska sajter kan verktyget “browser” faktiskt styra en Chrome-flik, klicka på knappar, fylla i formulär och till och med ta skärmbilder.
- Hanterar strukturerad och ostrukturerad data: Oavsett om du skrapar en prydlig produktrad eller ett rörigt blogginlägg kan ClawdBot extrahera, rensa och formatera datan åt dig.
- Användarvänligt gränssnitt: Med dashboard och Chrome-tillägg kan du sätta upp scrapingprojekt, schemalägga dem för valfritt intervall och skicka resultaten direkt till Slack, Telegram eller e-post.
Det som gör ClawdBot unikt:
- Till skillnad från traditionella skrapare som kräver kod eller stela mallar är ClawdBot konversationsdrivet och agentbaserat. Du kan säga vad du vill ha på vanlig svenska, så räknar det ut stegen.
- Chrome-tillägget låter dig styra dina faktiska webbläsarflikar, vilket gör det enkelt att skrapa sajter som kräver inloggning eller manuell navigering.
- Inbyggd schemaläggning (cron-jobb) gör att du kan automatisera återkommande scraping — perfekt för prisbevakning, leaduppdateringar eller dagliga rapporter.
Användarfeedback:
- MacStories och Tom’s Hardware lyfter båda fram ClawdBots förmåga att “göra saker som en riktig assistent”, inte bara hämta data utan automatisera hela arbetsflöden.
- Användare i communityn berömmer dess flexibilitet och att det “känns som att ha en junioranalytiker i beredskap”.
Varför ClawdBot Web Scraping är ett måste för företagsteam
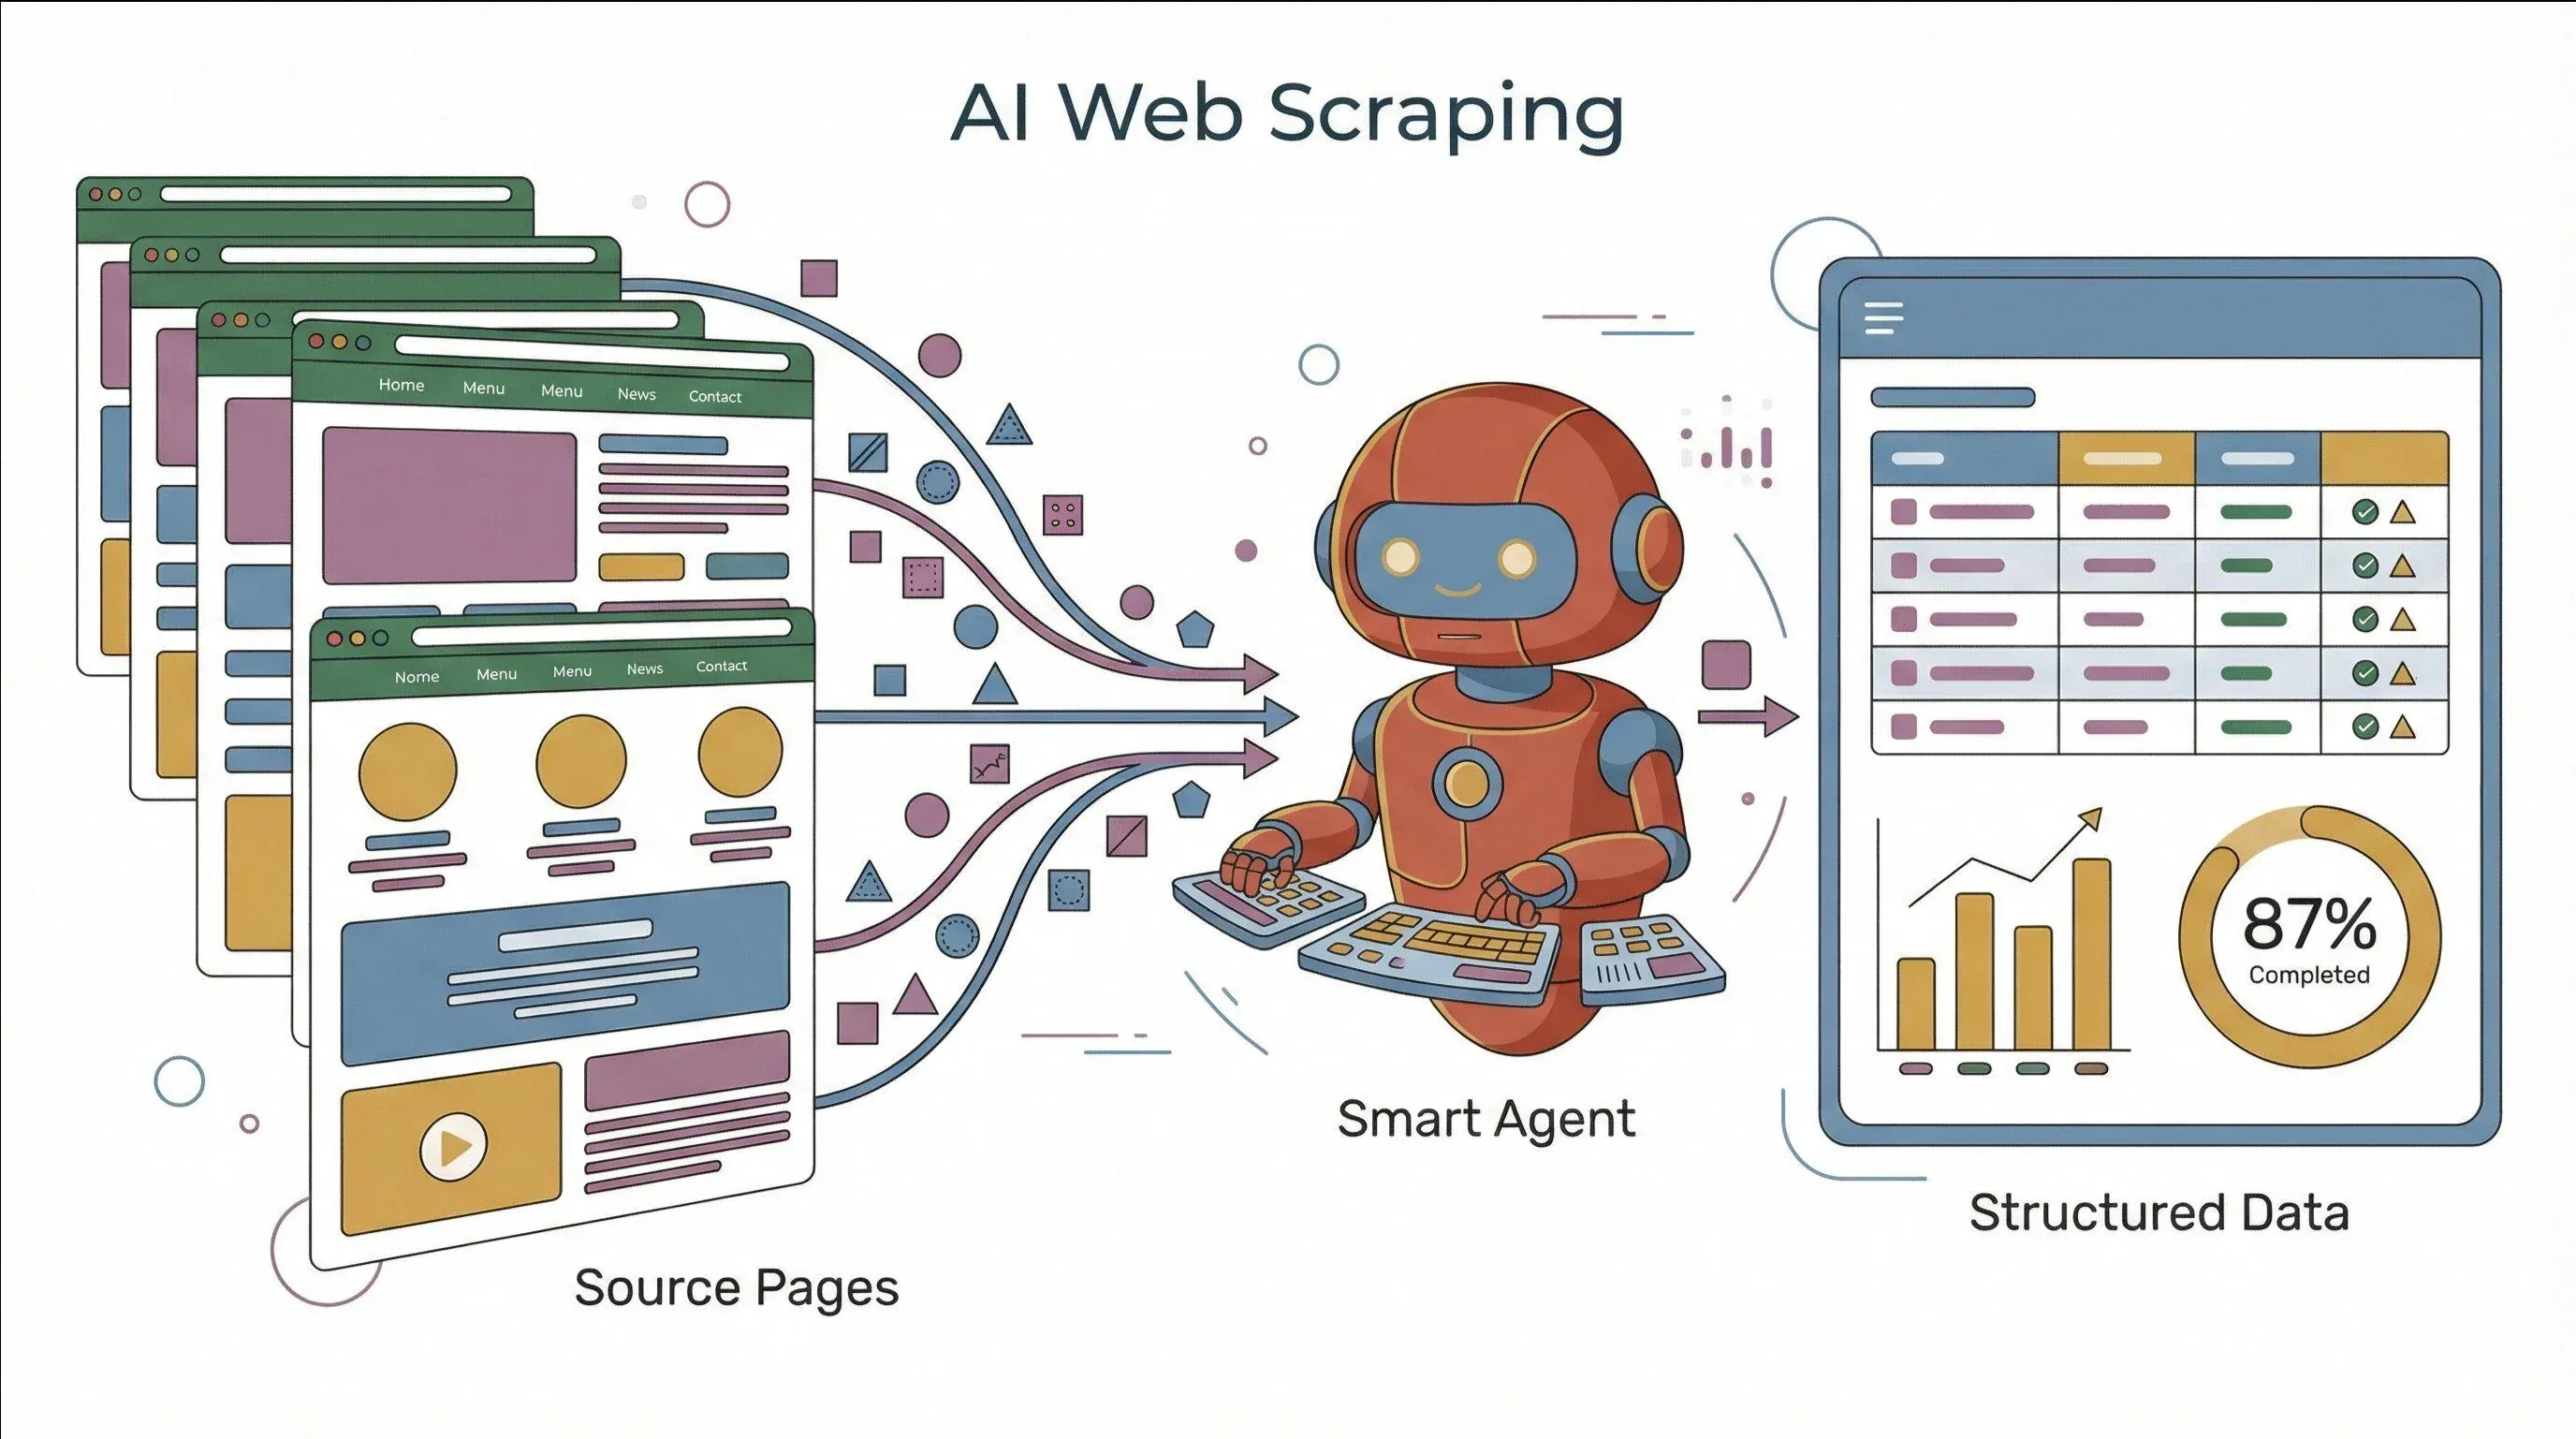 Låt oss gå rakt på sak: web scraping är inte längre bara för datanördar. Det är ett måste för alla företag som vill ligga steget före. Här är varför ClawdBot är värt att bemästra:
Viktiga funktioner för företagsanvändare
- Automatisering: Ställ in det och glöm det — ClawdBot kan köra scrapingjobb enligt schema, så att din data alltid är färsk.
- Datastrukturering: Använd fältscheman (som du kan definiera eller generera med Thunderbit) för att säkerställa att din skrapade data är ren och redo för analys.
- Felhantering: ClawdBots isolerade sessioner och webbläsarkontroller hjälper till att undvika vanliga fallgropar som trasiga skript eller sessionskonflikter.
- Integration: Resultaten kan skickas direkt till Google Sheets, CSV eller till och med teamets chattkanaler.
Verkliga affärsscenarier
| Användningsfall | Typiska datafält | Uppdateringsfrekvens | Affärsvärde | ClawdBot-verktyg |
|---|---|---|---|---|
| Säljleads | Företag, namn, e-post, LinkedIn, jobb | Veckovis/dagligen | Hitta nya prospekt, trigga uppföljning | web_fetch/browser |
| Konkurrentbevakning | SKU, pris, lager, kampanj, betyg | Dagligen/timvis | Dynamisk prissättning, kampanjsvar | browser/cron |
| Fastigheter | Adress, pris, status, mäklare, visning | Dagligen | Tidig kontakt, värdering | web_fetch/browser |
| Marknadsundersökning | Titel, datum, nyckelord, sentiment | Dagligen | Trendspaning, risklarm | web_fetch/cron |
ROI-bevis:
- Enligt Mordor Intelligence förväntas marknaden för web scraping-programvara nå 2 miljarder dollar år 2030, med en CAGR på 14,2 %.
- Dataforest (2025) lyfter web scraping som en drivkraft för dynamisk prissättning, automatiserad leadgenerering och riskövervakning.
Användaromdöme:
- “ClawdBot hjälpte oss att automatisera veckovisa prischeckar hos konkurrenter — det som tidigare tog timmar kör nu i bakgrunden och dyker upp i vår Slack varje morgon.” (E-handelschef, via MacStories)
Kom igång: Så sätter du upp ClawdBot Web Scraping på några minuter
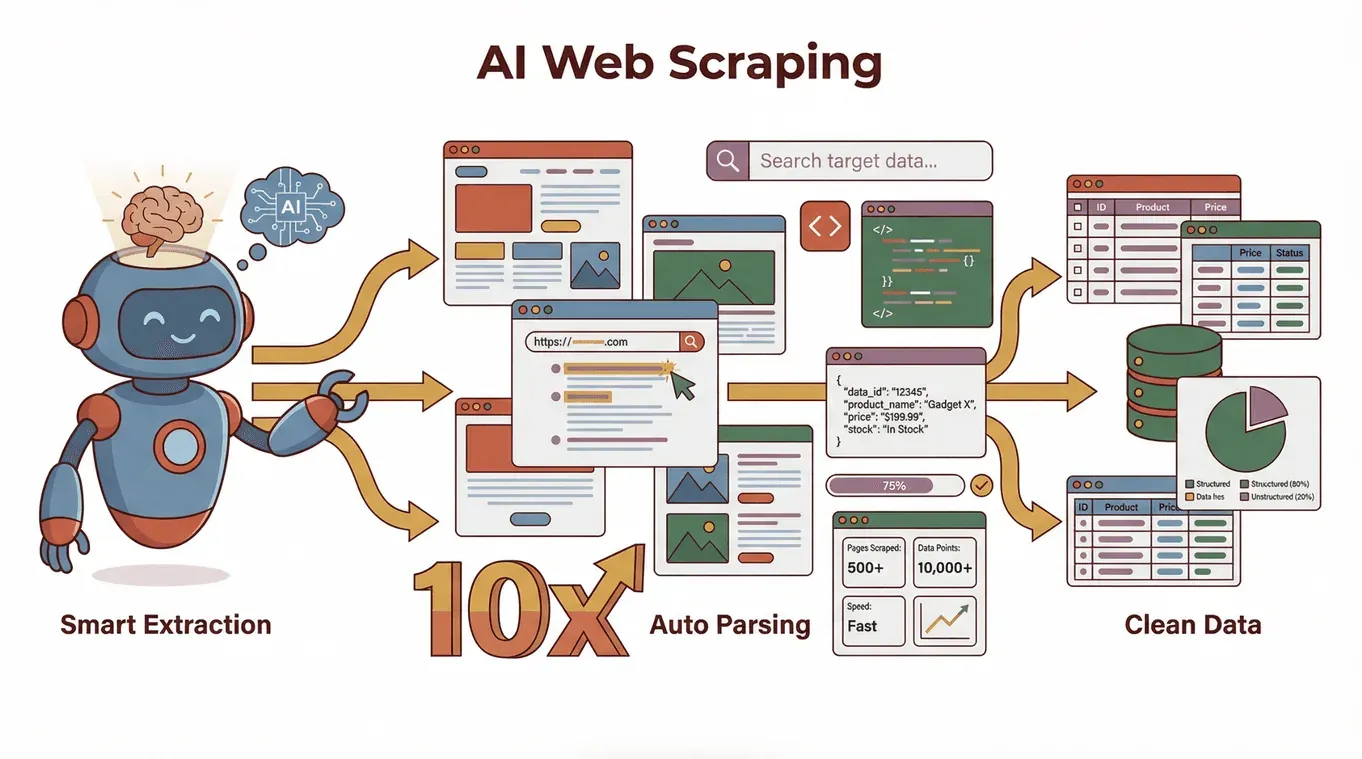 Du behöver inte vara kodare för att få igång ClawdBot. Så här kommer du i gång:
Steg 1: Installera ClawdBot (Moltbot)
-
Mac/Linux:
curl -fsSL https://molt.bot/install.sh | bash -
Windows:
iwr -useb https://molt.bot/install.ps1 | iex
(För Windows-användare rekommenderas WSL2.) -
Se till att du har Node.js v22 eller senare.
Steg 2: Starta dashboarden
- Kör
moltbot dashboardeller besökhttp://127.0.0.1:18789/i webbläsaren. - Introduktionsflödet guidar dig genom den första uppsättningen.
Steg 3: Anslut Chrome-tillägget
- Installera ClawdBot- (Moltbot-) tillägget för Chrome i utvecklarläge.
- Koppla det till din aktiva Chrome-flik så att agenten kan styra din webbläsarsession — perfekt för att skrapa sidor som kräver inloggning eller interaktion.
Steg 4: Konfigurera webbverktyg
- För enkel scraping, använd verktyget “web_fetch” (utmärkt för statiska sidor).
- För interaktiv scraping, använd verktyget “browser” (kan klicka, scrolla, fylla i formulär osv.).
- För schemalagda jobb, sätt upp en cron-uppgift i dashboarden eller via CLI.
Steg 5: Ställ in scrape-frekvens och filter
- Ange hur ofta du vill att jobbet ska köras (t.ex. varje timme, dagligen kl. 8).
- Lägg till innehållsfilter eller fältscheman för att extrahera bara den data du behöver.
Steg 6: Välj utdataformat
- Exportera till CSV, Excel eller Google Sheets.
- Ställ in leverans till Slack, Telegram eller e-post för automatiserad rapportering.
Felsökningstips:
- Om scraping misslyckas, kontrollera din Node-version och API-nycklar (Brave, Perplexity osv.).
- För webbläsarautomatisering, se till att tillägget är anslutet och att behörigheter har beviljats.
- Använd isolerade sessioner för känsliga eller högriskuppgifter.
Så sätter du upp ditt första ClawdBot-projekt
- Öppna dashboarden och skapa ett nytt projekt.
- Ange dina mål-URL:er eller sökord.
- Välj rätt verktyg (web_fetch för statiskt, browser för interaktivt).
- Definiera ditt fältschema (kolumnerna du vill extrahera).
- Förhandsgranska scrape:en för att säkerställa att datan kommer in som förväntat.
- Spara och schemalägg jobbet.
Anpassa datautmatningen efter affärsbehov
- Välj exportformat: CSV, Excel, Google Sheets eller direkt till BI-verktyg.
- Anpassa utdata efter rapporteringsbehov i verksamheten — använd tydliga kolumnnamn och datatyper.
- För återkommande rapporter, ställ in schemalagda exporter och automatiserad leverans.
Öka effektiviteten: Kombinera Thunderbit med ClawdBot Web Scraping
Här blir det riktigt intressant. Thunderbit är ett AI-drivet Chrome-tillägg för web scraping som gör det busenkelt att definiera datafält och strukturera skrapad data.
Testa Thunderbit AI Web Scraper gratis
Så kombinerar du Thunderbit och ClawdBot:
- Steg 1: Använd Thunderbits “AI Suggest Fields” på din målwebbplats för att generera en lista med rekommenderade kolumner och datatyper.
- Steg 2: Exportera detta schema som en CSV eller Google Sheet.
- Steg 3: Importera schemat till ClawdBot så att dina scrapingjobb blir strukturerade och redo för affärsanalys.
- Steg 4: Använd ClawdBots cron-jobb för att automatisera återkommande scraping och leverera resultaten till teamet.
Exempel på arbetsflöde:
- Thunderbit definierar strukturen (fältnamn, typer, extraktionslogik).
- ClawdBot kör automatiseringen (hämtar data, schemalägger jobb, levererar rapporter).
Proffstips:
Du kan till och med använda ClawdBots Chrome-tillägg för att styra webbläsaren, öppna en sida och trigga Thunderbit att skrapa och exportera data — ett sömlöst, kodfritt arbetsflöde.
Utnyttja AI för smartare datastrukturering
Thunderbits AI föreslår inte bara kolumner — den kan också:
- Märka upp, kategorisera och översätta data medan den skrapas.
- Hantera scraping av undersidor (t.ex. besöka varje produktsida för mer detaljer).
- Rensa och avduplicera data före export.
Praktiska tips:
- Förhandsgranska alltid ditt fältschema innan du kör stora jobb.
- Använd Thunderbits AI-prompter för att lägga till egna instruktioner (t.ex. “kategorisera SKU:er efter varumärke”).
- Schemalägg regelbunden scraping för att hålla dina dataset färska och användbara.
Verkliga tillämpningar: ClawdBot Web Scraping för affärsbeslut
Låt oss titta på hur ClawdBot används i olika branscher:
Sälj och leadgenerering
- Skrapa kataloger, LinkedIn eller deltagarlistor från event för nya leads.
- Bevaka företags jobbannonser för köpsignaler.
- Automatisera veckovisa uppdateringar av leadlistor som levereras till ditt CRM eller Slack.
E-handel och prisövervakning
- Följ konkurrentpriser, lagernivåer och kampanjer över hundratals SKU:er.
- Sätt upp scraping varje timme eller varje dag för att fånga förändringar i realtid.
- Använd strukturerad data för dynamisk prissättning eller lagerlarm.
Fastigheter
- Samla in objektsannonser, priser och mäklarinformation från flera sajter.
- Bevaka statusförändringar (nya objekt, prissänkningar) och skicka larm till teamet.
- Berika annonser med grannskapsdata eller nyligen genomförda försäljningar.
Marknadsundersökning och sentimentanalys
- Skrapa recensioner, nyhetsartiklar eller foruminlägg för att förstå kundernas sentiment.
- Använd AI för att tagga, kategorisera och sammanfatta stora mängder ostrukturerad text.
- Mata in data i BI-verktyg för trendanalys och rapportering.
Mini-case:
En fastighetsbyrå använde ClawdBot + Thunderbit för att dagligen skrapa nya objekt, berika dem med kontaktuppgifter till mäklare och leverera en morgonrapport till säljteamet — vilket minskade den manuella researchtiden med 80 %.
Från data till insikter: Gör skrapad data handlingsbar
När du väl har skrapat din data är det dags att göra den användbar:
- Excel/Google Sheets: Använd pivottabeller, diagram och villkorsstyrd formatering för snabb analys.
- Power BI/Tableau/Looker Studio: Bygg dashboards som uppdateras automatiskt med ny data.
- Textanalys: Använd AI-prompter för att sammanfatta recensioner, klustra ämnen eller sätta poäng på sentiment.
Tips:
Thunderbits strukturerade exporter gör det enkelt att koppla in data i vilket analysverktyg som helst — ingen rörig städning krävs.
Övervinna utmaningar: Trender inom web scraping och ClawdBots framtid
Nuvarande utmaningar
- Webbplatsstrukturer som förändras: Sajter ändrar layout, lägger till JavaScript eller blockerar bottar — vilket slår ut traditionella skrapare.
- Motåtgärder mot bottar: Fler sajter använder CAPTCHA, inloggningsmurar och botdetektering.
- Dataintegritet och efterlevnad: Strängare regler (GDPR, CCPA) betyder att du behöver skrapa ansvarsfullt.
ClawdBots angreppssätt
- Webbläsarautomatisering: Genom att styra riktiga webbläsarflikar kan ClawdBot hantera interaktiva sajter och sajter bakom inloggning.
- Isolerade sessioner: Minska risken genom att köra scrapingjobb i sandlådemiljöer.
- Säkerhetsgranskningar: Inbyggda verktyg varnar för riskabla konfigurationer eller exponerade inloggningsuppgifter.
- Flexibel schemaläggning: Cron-jobb låter dig automatisera och sprida ut scraping för att undvika upptäckt.
Framtiden
- AI-driven extraktion: Räkna med smartare fältdetektering, bättre hantering av ostrukturerad data och mer naturliga språkstyrningar.
- Integration med smarta verktyg: Att kombinera ClawdBot med Thunderbit och BI-plattformar gör datapipelines ännu smidigare.
- Efterlevnad inbyggd från början: Mer detaljerade kontroller, granskningsloggar och integritetsfunktioner finns på vägen.
Branschtrend:
TollBit rapporterar att trafiken från AI-bottar för scraping växte med 117 % under fjärde kvartalet 2024, samtidigt som antalet bottar som kringgår robots.txt ökade med 40 %. Behovet av ansvarsfulla och anpassningsbara scrapingverktyg har aldrig varit större.
Slutsats och viktiga lärdomar: Bemästra ClawdBot Web Scraping för tillväxt
Det här har jag lärt mig: att bemästra ClawdBot Web Scraping handlar inte bara om att dra ut data — det handlar om att bygga smartare, mer automatiserade arbetsflöden som ger ditt företag ett försprång. När du kombinerar ClawdBots automatisering med Thunderbits AI-drivna strukturering får du data som inte bara är snabb, utan faktiskt användbar.
Viktiga lärdomar:
- Web scraping är nu affärskritiskt för sälj-, e-handels-, fastighets- och researchteam.
- ClawdBot gör scraping tillgängligt, automatiserbart och säkert — även för den som inte kodar.
- Thunderbit förstärker ditt arbetsflöde med AI-driven fältdetektering och datarensning.
- Genom att kombinera båda verktygen kan du gå från rå webbdata till handlingsbara affärsinsikter på rekordtid.
Redo att ta din datahantering till nästa nivå? Börja med att testa ett mindre projekt — definiera dina fält i Thunderbit, automatisera din scraping i ClawdBot och se hur mycket tid du sparar. Framtiden för affärsbeslut är datadriven, och med rätt verktyg kommer du att ligga i täten.
Kom igång med AI-driven web scraping med Thunderbit
Vanliga frågor
1. Vad är ClawdBot Web Scraping och hur skiljer det sig från traditionella skrapare?
ClawdBot (nu Moltbot) är en AI-agentplattform som automatiserar extraktion av webbdata med webbläsarkontroll, schemalagda jobb och konversationsstyrda kommandon — ingen kod krävs. Till skillnad från traditionella skrapare kan den hantera interaktiva sajter, automatisera arbetsflöden och leverera resultat till teamets favoritkanaler.
2. Kan jag använda ClawdBot för affärsuppgifter som leadgenerering och prisövervakning?
Absolut. ClawdBot är byggt för affärsanvändning som leadskrapning, bevakning av konkurrentpriser, insamling av fastighetsannonser och marknadsundersökningar. Dess automatiserings- och schemaläggningsfunktioner gör det idealiskt för återkommande affärsuppgifter.
3. Hur förbättrar Thunderbit ClawdBots möjligheter?
Thunderbit använder AI för att föreslå fältnamn, datatyper och extraktionslogik, vilket gör din skrapade data renare och mer strukturerad. Du kan definiera ditt schema i Thunderbit och sedan använda ClawdBot för att automatisera scraping och rapportering.
4. Vilka är de största utmaningarna inom web scraping idag, och hur hanterar ClawdBot dem?
De största utmaningarna är föränderliga webbplatsstrukturer, botförsvar och efterlevnadskrav. ClawdBots webbläsarautomatisering, isolerade sessioner och inbyggda säkerhetsgranskningar hjälper till att övervinna dessa hinder.
5. Hur kommer jag igång med ClawdBot och Thunderbit?
Installera ClawdBot (Moltbot) med det officiella skriptet, ställ in dashboarden och anslut Chrome-tillägget. Använd Thunderbit för att definiera ditt dataschema och automatisera sedan dina scrapingjobb i ClawdBot. Börja med ett litet projekt och skala upp när du blir mer bekväm.
Nyfiken på att lära dig mer om AI-driven web scraping? Kolla in Thunderbit Blog för fler guider, tips och verkliga framgångshistorier.
Testa AI Web Scraper Get Started Free
Läs mer




