記事スクレイパー:本文・著者・日付を抽出








変化するページレイアウトでも記事データを収集
意味ベースで項目を読み取り、定期実行も可能。公開サイトなら同じワークフローを使えます。
記事レイアウトの変更にも柔軟に対応
Thunderbit は、表示されている見出し、署名、日付、要約、記事本文を意味ベースで読み取ります。ニュースサイトがレイアウトを変更しても、固定のページ位置に依存しにくいワークフローです。
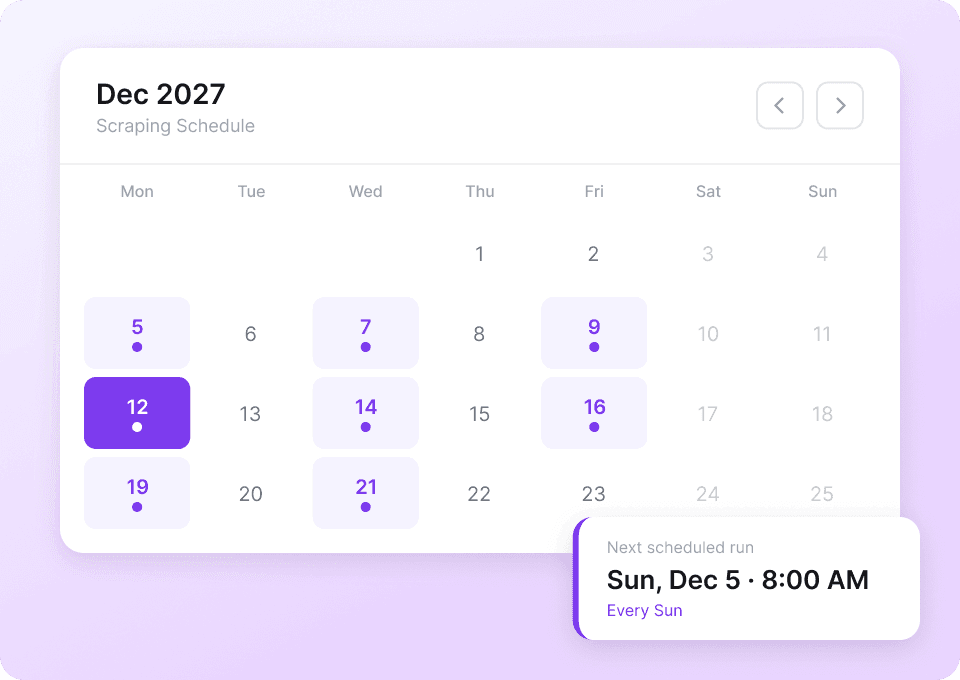
記事スクレイピングをスケジュール実行
何度も見に行く公開ニュースページ、ブログ、カテゴリページには、繰り返し実行を設定できます。Thunderbit が最新の表示記事を収集し、新しい行を指定したファイルやアプリに送ります。
どの公開サイトでも1つのワークフローで対応
記事が掲載されている公開サイトなら、同じワークフローをそのまま使えます。必要な項目名を指定するだけで、Thunderbit が各ページの内容を同じ列に整理します。
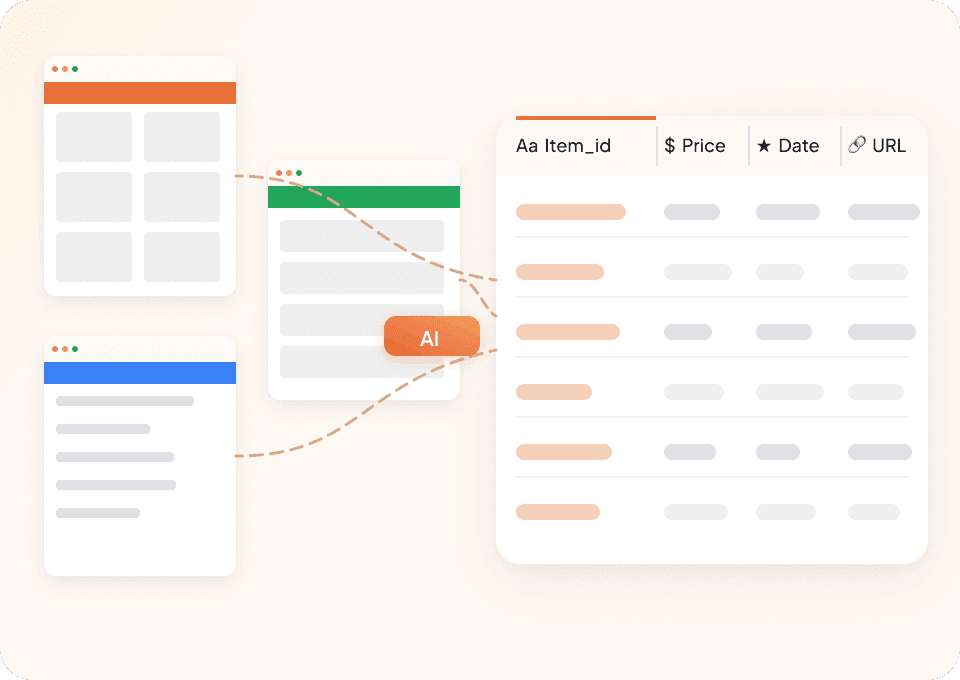
異なるページレイアウトでも共通で使える記事ワークフロー
固定セレクタは位置に依存します。Thunderbit AI は、指定された記事項目を探し出します。
出版社ごとにセレクタを個別管理
ページ設計が違うたびに保守が必要Thunderbit が記事項目を整理
必要なレコードを一貫した形で取得記事からどのようなデータを抽出できますか?
表示されているコンテンツ、著者、出版社、日付、リンク、トピック、メディア、ページメタデータの30項目から選べます。
- 見出し
- 別見出し
- 記事本文
- 記事要約
- 著者名
- 著者 URL
- 著者所属
- 出版社名
- 出版社 URL
- 公開日
- 更新日
- 記事セクション
- キーワード
- 文字数
- 言語
- 正規 URL
- 主要エンティティ URL
- 画像 URL
- 画像キャプション
- 画像クレジット
- 動画 URL
- 音声 URL
- データライン
- 関連トピック
- 言及
- 引用リンク
- ライセンス URL
- 関連記事リンク
- ページタイトル
- メタディスクリプション
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.



公開記事のスクレイピングに関する質問
ニュースサイトごとにレイアウトやページ詳細が異なるため、取得できる項目は対象の記事ページによって変わります。
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

4PDAスクレイパー
Thunderbitの4PDAスクレイパーは、AIを活用して4PDAのニュース記事やフォーラム投稿からデータを抽出できます。記事タイトル、公開日、著者、投稿内容を素早く収集できるため、リサーチや分析、テック系ディスカッションのモニタリングに最適です。テクノロジー愛好家、研究者、マーケターなど、4PDAの構造化データを求める方におすすめです。
詳しく見る ->
Ptt スクレイパー
ThunderbitのPttスクレイパーは、AIによるフィールド提案機能でPttの掲示板や投稿データを効率的に抽出できます。掲示板名、URL、人気度、投稿タイトル、投稿者、コメントなどを収集でき、リサーチやマーケティング、コンテンツ分析に最適です。マーケター、研究者、コンテンツ制作者がPttの構造化データを手軽に取得したいときにおすすめのツールです。
詳しく見る ->
ピザマーケットプレイススクレイパー
Thunderbit の Pizza Marketplace スクレイパーを使えば、Pizza Marketplace のニュース一覧やベンダーディレクトリからデータを抽出できます。AIによるフィールド提案機能で、ニュースタイトル、公開日、著者、ベンダー名、所在地、連絡先などを素早く収集でき、リサーチやマーケティング、分析に活用可能です。
詳しく見る ->
Failory スクレイパー
Thunderbit の Failory スクレイパーは、Failory のスタートアップ墓場やニュース記事から構造化データを抽出できるツールです。AIによるフィールド提案機能で、スタートアップ名、設立年、失敗理由、記事タイトル、著者などを効率的に収集可能。Failory からのインサイトを求める起業家、投資家、研究者に最適です。
詳しく見る ->
Investing.comスクレイパー
Investing.comから、株価データ(銘柄コード、価格、出来高、時価総額など)をわずか2クリックで抽出し、そのままGoogle Sheets、Notion、Excelにエクスポートできます。Investing.comの任意のページを開くだけで、AIが取得項目を自動で見つけます。
詳しく見る ->
Substackスクレイパー
Substackの購読者数、記事タイトル、配信説明文を2クリックで抽出。Excel、Google Sheets、Notionへそのまま出力できます。コードは不要で、ThunderbitのAIがデータの整理まで自動で行います。
詳しく見る ->データ抽出を一気に加速する準備はできた?
すでに20万人以上のプロがThunderbitでWebスクレイピング業務を自動化しています。
無料トライアルでは8ページ分の無制限クレジットを利用できます。



