

Reddit מדווחת כעת על 471.6 מיליון משתמשים ייחודיים פעילים שבועית ביותר מ־100,000 קהילות פעילות — ובכל זאת, להוציא את המידע הזה מ־Reddit בפורמט מובנה ושימושי מעולם לא היה קשה יותר. בין שינוי תמחור ה־API ב־2023, הסוף של Pushshift כארכיון ציבורי, והתביעות האחרונות של Reddit נגד חברות AI, עולם ה-scraping נראה לגמרי שונה ממה שהיה אפילו לפני שנתיים.
במשך שנים בניתי ובדקתי כלי חילוץ נתונים ב-Thunderbit, וראיתי איך השיחה על גריפת Reddit משתנה מ״פשוט תשתמשו ב־PRAW״ ל״רגע, מה באמת עדיין עובד?״ אז לקחתי 12 סקרייפרי Reddit — ללא קוד, עם מעט קוד, ועם קוד מלא — כדי להבין אילו מהם באמת מספקים תוצאות ב־2026 עבור צוותי מכירות, שיווק, מחקר ותפעול שצריכים נתוני Reddit בלי כאב ראש. הנה מה שמצאתי.
נסו את Thunderbit לגריפת Reddit
למה נתוני Reddit חשובים לצוותי מכירות, שיווק ומחקר
Reddit היא לא עוד פלטפורמה חברתית. זה המקום שבו אנשים אומרים מה הם באמת חושבים — באופן אנונימי, בלי פילטרים, ועם מערכת הצבעות שמקדמת את התשובות השימושיות ביותר. זה הופך אותה לאוצר עבור צוותים עסקיים, אבל גם לכזו שכמעט בלתי אפשרי לנטר ידנית בקנה מידה גדול. רק במחצית השנייה של 2024, משתמשי Reddit יצרו 237 מיליון פוסטים ו-1.79 מיליארד תגובות. זה בערך 1.3 מיליון פוסטים ו־9.7 מיליון תגובות ביום.
גם חומרי החברה של Reddit מאשרים זאת: 74% מה־redditors אומרים שהם היו מתחילים מחקר מעמיק על מוצר ב־Reddit, ובממוצע כל שנייה 2 אנשים מבקשים מקהילות Reddit המלצות, ומקבלים בממוצע 14 תגובות אישיות. מותגים כמו Škoda Auto השתמשו במשוב מ־Reddit כדי לעצב מוצרים במשותף, מה שהוביל ל-255% יותר הזמנות ול־84% סנטימנט חיובי. Nespresso ראתה עלייה של +30% במודעות לפרסום מקמפיינים מבוססי Reddit.
כך צוותים עסקיים באמת משתמשים בנתוני Reddit:
| מקרה שימוש | למה Reddit חזקה | מה צוותים גורפים |
|---|---|---|
| יצירת לידים | דיונים עם כוונת רכישה גבוהה כמו "איזה כלי כדאי לי לקנות?" | פוסטים, שרשורי תגובות, שמות משתמש של כותבים |
| ניטור מותג | תלונות ושבחים לא מסוננים צפים מוקדם | אזכורי מותג, סנטימנט, אשכולות תלונות |
| מודיעין תחרותי | קונים דנים במתחרים בשפה טבעית | השוואות מוצרים, סיבות למעבר, פערי תכונות |
| אימות מוצר | משוב ב־subreddit חושף נקודות כאב לפני סקרים | בקשות לתכונות, התנגדויות, שפת ביקוש |
| ניתוח סנטימנט | תגובות נושאות יותר ניואנסים מדירוגי כוכבים | עצי תגובות, מבנה הורה-ילד, הצבעות |
| רעיונות לתוכן | שאלות חושפות ישירות ביקוש לעריכה | כותרות פוסטים, בקשות חוזרות, מסגור של subreddit |
האתגר ברור: אי אפשר לעקוב ידנית אחרי אלפי שרשורים ביום. כאן נכנסים הסקרייפרים — אבל החוקים השתנו.
המתקפה של Reddit על ה־API (2023–2026): מה עדיין עובד ומה התקלקל
אם לא עקבתם אחרי מדיניות הגישה של Reddit, הנה הגרסה הקצרה: העולם הישן של גישה חופשית ובלתי מוגבלת ל־API ו־Pushshift כארכיון נתונים ציבורי כבר איננו. להבין מה השתנה חיוני לפני שבוחרים סקרייפר, כי זה קובע ישירות אילו כלים עדיין יכולים לספק תוצאות.
ציר הזמן של השינוי
| תאריך | שינוי | למה זה חשוב |
|---|---|---|
| אפריל 2023 | Reddit הכריזה על שינויים גדולים ב־API | סוף עידן ה־free-for-all |
| מאי 2023 | הגישה ל־Pushshift הוגבלה | הארכיון ההיסטורי התחיל להיסגר |
| יולי 2023 | נכנסו לתוקף שכבת חינם וכללי תשלום לשימוש מסחרי | ה־API החינמי הוגבל; גישה מסחרית הפכה לממומנת |
| אמצע 2024 | Reddit for Researchers הושק (בטא מוגבלת) | הגישה האקדמית עברה למסלול מבוקר |
| ינואר 2025 | Pushshift אושר כזמין רק למנהלים מאומתים ולשימוש במודרציה בלבד | כבר לא דלת אחורית למחקר |
| יוני 2025 | Reddit תבעה את Anthropic | הסלמה משפטית נגד שימוש לא מורשה בנתוני AI |
| אוקטובר 2025 | Reddit תבעה את Perplexity | גישת האכיפה הורחבה עוד יותר |
| מרץ 2026 | Reddit עדכנה את Data API Wiki, Responsible Builder Policy ו-Developer Terms | שכבת החינם, כללי האישור והעמדה נגד מסחור נשארים מחמירים |
מה עדיין עובד
- שכבת החינם של ה־Official Data API: עדיין זמינה בקצב של 100 שאילתות בדקה לכל OAuth client ID, בממוצע על פני חלון של 10 דקות.
- נקודות קצה מסוג ".json": הוספת ".json" לכל URL של Reddit עדיין מחזירה נתונים, אבל יש הגבלת קצב והיא לא מיועדת לעבודה בקנה מידה גדול.
- גריפה מבוססת דפדפן: כלים שקוראים את הדף המעובד (כמו Thunderbit או Octoparse) אינם כפופים למכסות API באותו אופן.
- שירותי scraping בענן: פלטפורמות כמו Apify ו־Oxylabs מטפלות ברינדור, בפרוקסים ובניסיונות חוזרים מצדן.
מה נשבר
- Pushshift כמקור היסטורי ציבורי: למעשה נעלם. ב־2026 הוא מוגבל ל-מנהלים מאומתים לשימוש במודרציה בלבד.
- PRAW לאיסוף מסחרי בקנה מידה גדול: מוגבל גם על ידי מגבלות השכבה החינמית וגם על ידי התנאים הרחבים יותר של Reddit.
- כל תהליך עבודה שמניח שגישה ל־API היא ברירת מחדל וששימוש מסחרי בסדר: מיושן.
איך זה מעצב את בחירת הכלי
| גישה | מושפעת ממגבלות API? | גישה לנתונים היסטוריים | מורכבות ההתקנה |
|---|---|---|---|
| Reddit API (PRAW) | כן — מגבלת 1K פוסטים, והגבלת קצב | מוגבלת לאחרונים | בינונית |
| נקודת קצה ".json" | כן — מוגבל בקצב | מוגבל מאוד | נמוכה |
| גריפה בדפדפן (Thunderbit, Octoparse) | לא — קוראת את הדף המעובד | רק מה שנראה/נטען | נמוכה מאוד |
| שירותי scraping בענן (Apify, Oxylabs) | לא (הם מטפלים בפרוקסים) | משתנה לפי הספק | נמוכה–בינונית |
השורה התחתונה: כלים שמבוססים קודם כול על API מתאימים עכשיו בעיקר למפתחים ולעומסי עבודה מוגבלים. כלים שמבוססים על דפדפן ועל ענן הם ההימור הבטוח יותר למקרי שימוש לא טכניים או בעלי נפח גבוה.
ללא קוד מול עם מעט קוד מול קוד מלא: איך בוחרים את גישת הגריפה הנכונה ל־Reddit
הקהל של סקרייפרי Reddit באמת מפוצל. חלק מהקוראים צריכים נתוני Reddit ואין להם תמיכה הנדסית בכלל. אחרים עובדים עם מפעיל טכני אבל בלי צוות crawler ייעודי. ויש כאלה שרוצים שליטה מלאה ברמת הקוד. הגישה הנכונה תלויה איפה אתם נמצאים.
משתמש ב-r/nocode פרסם לאחרונה: "I am working on a reddit scrapper but I can't get reddit api keys." אחר ב-r/NoCodeSaaS תיאר בניית לוח מחוונים חי של Reddit עם Zapier + Airtable + Softr — בלי שום קוד backend. אלה לא מקרי קצה. לפי סקר של Smarty Marketing בקרב 150 צוותי שיווק פנימיים, 47.8% אמרו שהחסם העיקרי שלהם עם Reddit הוא חוסר הבנה מספיק של הפלטפורמה, בעוד 39% חששו שייחסמו.
הנה טבלת הפשרות:
| גורם | ללא קוד | עם מעט קוד / API | קוד מלא |
|---|---|---|---|
| זמן התקנה | דקות | שעות | שעות–ימים |
| תחזוקה | אין (AI מסתגל) | נמוכה (עדכוני API) | גבוהה (שינויים בפריסה/ב־API) |
| תקרת סקייל | בינונית | גבוהה | בינונית (מגבלות קצב) |
| התאמה אישית | מוגבלת | בינונית | בלתי מוגבלת |
| עלות | שכבת חינם → בתשלום | תשלום לפי שימוש | חינם (אבל זמן פיתוח) |
ללא קוד (Thunderbit, Browse AI, Octoparse, ScrapeStorm, ParseHub): הטוב ביותר לצוותי שיווק, מכירות ומחקר. תהליך ה־2 קליקים של Thunderbit הוא המסלול המהיר ביותר כאן.
עם מעט קוד / שירותי API (Apify, ScrapingBee, Oxylabs, Firecrawl, ScrapeGraphAI): הטוב ביותר לצוותים עם מעט משאבים טכניים שצריכים סקייל וניהול פרוקסים.
קוד מלא (PRAW, Scrapy): הטוב ביותר למפתחים שרוצים שליטה מקסימלית — אבל חייבים לספוג מגבלות API ותחזוקה שוטפת.
איך בדקנו ודירגנו את 12 סקרייפרי Reddit האלה
הערכתי כל כלי לפי הקריטריונים הבאים:
- קלות שימוש: ללא קוד, עם מעט קוד, או קוד מלא?
- תכונות ספציפיות ל־Reddit: שרשור תגובות, מיקוד ב־subreddit, נתונים היסטוריים
- התמודדות עם מגבלות ה־API הנוכחיות של Reddit ועם זיהוי אנטי־בוט
- מודל תמחור ומגבלות שכבת חינם
- אפשרויות ייצוא נתונים: CSV, JSON, Sheets וכו׳
- תמיכה בגריפה מתוזמנת/חוזרת
- מקרי שימוש מיטביים
הנה טבלת ההשוואה המרכזית כדי שתוכלו לסרוק לפני קריאת הסקירות הבודדות:
| כלי | גישה | נדרש קוד? | מתמודד עם מגבלות API? | תגובות מקוננות | שכבת חינם | הטוב ביותר עבור |
|---|---|---|---|---|---|---|
| Thunderbit | סקרייפר AI לדפדפן/ענן | לא | כן (מבוסס דפדפן) | כן (תבנית subpage + תגובות) | כן — 6 דפים חינם | משתמשים לא טכניים, יצירת לידים |
| Apify | פלטפורמת Actors בענן | מעט | כן | חלקית עד חזקה (תלוי actor) | כן — קרדיטים מוגבלים | גריפת subreddits בכמות גדולה |
| PRAW | עטיפת API ב־Python | מלא | חלקית (מגבלות קצב API) | כן (עם קוד) | כן (שכבת API חינם) | מפתחים, פרויקטים קטנים |
| Octoparse | סקרייפר חזותי | לא | כן (מבוסס דפדפן) | טוב מהרגיל, אבל לא מושלם | כן | צוותי גריפה מרובי אתרים |
| Browse AI | רובוטים מוכנים מראש | לא | כן | חלקית | כן | ניטור ומעקב שינויים |
| ScrapingBee | שירות API | מעט | כן (סיבוב פרוקסים) | אין שרשור מובנה | כן — 1K קרדיטים | מפתחים שרוצים להימנע מחסימות |
| Scrapy | מסגרת Python | מלא | לא (DIY) | כן (אם בונים זאת) | כן (קוד פתוח) | צינורות מותאמים אישית בקנה מידה גדול |
| ScrapeStorm | אפליקציית AI למחשב | לא | כן (מבוסס דפדפן) | חלקית | כן | מתחילים, זיהוי אוטומטי |
| ParseHub | סקרייפר חזותי לדסקטופ | לא | כן (מבוסס דפדפן) | פוטנציאל רקורסיבי חזק | כן — 5 פרויקטים | מבני דפים מורכבים |
| Firecrawl | API לנתוני web | מעט | כן | חלקית | כן — 500 קרדיטים | צינורות נתונים ל־AI/LLM |
| Oxylabs | פרוקסים + API לגריפה | מעט | כן (פרוקסי ארגוני) | חלקית | ניסיון — 2K תוצאות | חילוץ בקנה מידה ארגוני |
| ScrapeGraphAI | מבוסס פרומפט AI | מעט | כן | חלקית | כן — 50 קרדיטים | גריפה מבוססת פרומפטים עם AI |
עכשיו, הסקירות הבודדות.
1. Thunderbit: סקרייפר Reddit ללא קוד המהיר ביותר לצוותים עסקיים
 Thunderbit הוא סקרייפר ה־AI שבנינו בחברה שלנו, אז אני מכיר את יכולות ה־Reddit שלו מכל הכיוונים. זהו תוסף Chrome שגורף את Reddit (וכל אתר) ב־2 קליקים — בלי קוד, בלי מפתחות API, בלי התקנה. הרעיון המרכזי הוא שה־AI צריך להבין איזה נתונים יש בדף, לא אתם.
עבור Reddit במיוחד, Thunderbit מציע:
- AI Suggest Fields: לחצו על הכפתור בכל עמוד subreddit ו־Thunderbit מזהה אוטומטית עמודות כמו כותרת הפוסט, מחבר, הצבעות בעד, מספר תגובות, URL ותאריך.
- גריפת תתי־עמודים: נכנסים לכל URL של פוסט כדי לשלוף טקסט מלא, תגובות מובילות, flair ותגובות מקוננות. כך מקבלים נתוני תגובות עמוקים בלי לגעת ב־API.
- סקרייפר ייעודי ל־Reddit Post Comments: ל־Thunderbit יש תבנית תגובות ל־Reddit שמחלצת את כל התגובות, קישורי השרשור, ספירת תשובות ותגובות מקוננות מתוך URL של פוסט.
- Pagination ו־infinite scroll: מטפל אוטומטית בהתנהגות ה־"load more" של Reddit באמצעות מסמכי pagination.
- Cloud Scraping: עבור דפי Reddit ציבוריים, Cloud Scraping מעבד עד 50 דפים בכל פעם לצורך מהירות.
- ייצוא חינם: שלחו נתונים ל־Excel, Google Sheets, Airtable, Notion, CSV או JSON — בלי חומת תשלום על הייצוא.
- גריפה מתוזמנת: כתבו תזמון בשפה טבעית (למשל, "כל יום שני ב־9:00"), הזינו URLs של subreddits, והנתונים יישלחו אוטומטית ליעד שלכם.
תמחור: שכבת חינם (6 דפים), ואז מסלולים בתשלום מבוססי קרדיטים החל מכ־$9 לחודש. ראו תמחור Thunderbit.
הטוב ביותר עבור: צוותי מכירות, שיווק ותפעול לא טכניים שצריכים נתוני Reddit מהר. חזק גם לניתוח שרשורים בעלי ערך גבוה, כשאתם רוצים נתוני תגובות מלאים ומעובדים מדפי פוסט בודדים.
איך לגרוף subreddit עם Thunderbit ב־5 שלבים
- התקינו את תוסף Chrome של Thunderbit ונווטו ל־subreddit (למשל, r/SaaS).
- לחצו על "AI Suggest Fields" — Thunderbit יזהה אוטומטית עמודות: כותרת הפוסט, מחבר, הצבעות בעד, מספר תגובות, URL, תאריך.
- לחצו על "Scrape" — הנתונים יופיעו תוך שניות. השתמשו ב־Cloud Scraping למהירות בדפים ציבוריים.
- לחצו על "Scrape Subpages" כדי להעשיר — ה־AI מבקר בכל URL של פוסט ושולף טקסט מלא, תגובות מובילות, flair ותגובות מקוננות.
- Export ל־Google Sheets, Excel, Airtable או Notion — בחינם לגמרי.
להדגמה של איך זה נראה בפועל, בקרו בערוץ ה-Thunderbit YouTube.
מעדיפים קוד? הנה המקביל ב־PRAW בכ־15 שורות Python:
import praw

reddit = praw.Reddit(
    client_id="YOUR_ID",
    client_secret="YOUR_SECRET",
    user_agent="reddit-scraper-demo/0.1"
)

subreddit = reddit.subreddit("SaaS")
for post in subreddit.hot(limit=10):
    print(post.title, post.score, post.num_comments, post.permalink)
Thunderbit לוקח בערך 30 שניות ואפס שורות קוד. PRAW אומר להגדיר אישורי API, לכתוב סקריפט ולהתמודד עם מגבלות קצב. לשניהם יש מקום — אבל עבור רוב המשתמשים העסקיים, מסלול 2 הקליקים מנצח.
2. Apify Reddit Scraper: חילוץ המוני של subreddits בענן
 Apify היא פלטפורמת scraping בענן, לא כלי Reddit בודד. היא מארחת "Actors" שנבנו על ידי הקהילה — סקרייפרים מוכנים מראש שאפשר להריץ על התשתית של Apify עם סיבוב פרוקסים ומנגנוני anti-blocking מובנים.
- Actors ייעודיים ל־Reddit: כמה אפשרויות, כולל Reddit Scraper של prodiger (החל מכ־$0.60 ל־1K פוסטים) ו-Reddit Scraper של trudax. כל אחד מהם תומך ברשימות subreddit (hot, new, top, rising), חיפוש לפי מילות מפתח, פרופילי משתמשים ומסנני זמן.
- תגובות מקוננות: ל־Apify יש Actor ייעודי Reddit Comments Deep Scraper עם עומק ניתן להגדרה ושדות הורה-ילד — אחת האפשרויות החזקות ביותר לחילוץ שרשורים עמוקים.
- תזמון: מתזמן בסגנון cron מובנה במסלולים בתשלום.
- ייצוא: JSON, CSV, XML, Excel, HTML Table, RSS, JSONL וגם אינטגרציה ל־API ו־webhooks.
- תמחור: שכבת חינם (~$5 לחודש בקרדיטים, ~1K תוצאות); מסלולים בתשלום החל מ־$49 לחודש.
הטוב ביותר עבור: צוותים שצריכים איסוף נתוני Reddit בקנה מידה, על בסיס חוזר, עם קצת משאבים טכניים. אם אתם צריכים עצי תגובות עמוקים בקנה מידה גדול, ה־deep scraper הייעודי הוא יתרון אמיתי.
הסתייגות: האיכות והתמחור משתנים לפי ה־actor, לכן כדאי לבדוק לפני שמתחייבים לזרימת עבודה.
3. PRAW (Python Reddit API Wrapper): הכלי המועדף למפתחים, עם מגבלות
 PRAW הוא עדיין הסטנדרט לעבודה עם Reddit דרך API בקוד תחילה. אם אתם מפתחי Python, כנראה שזה יהיה הכלי הראשון שתפנו אליו — ולפרויקטים קטנים ומוגבלים, הוא עדיין עובד מצוין. אבל ב־2026 הוא שייך לקטגוריית "כלי למפתחים לעומסי עבודה מוגבלים", לא כפתרון אוניברסלי.
- גרסה אחרונה: v7.8.1 (אוקטובר 2024)
- תכונות מרכזיות: גישה לכל נקודות הקצה של ה־API (פוסטים, תגובות, מידע על משתמשים); הזרמת פוסטים בזמן אמת; מעבר על עצי תגובות מלאים עם
replace_more() - מגבלה קריטית: כפוף למגבלות הקצב של Reddit (100 שאילתות/דקה בשכבת החינם), מגבלת 1K פוסטים לכל listing, ואכיפה מחמירה יותר של תנאי השימוש מאז 2023. PRAW עצמו מזהיר שמעל "תריסר בערך" מופעים מקבילים אפשר להיתקל במגבלות קצב.
- ייצוא: כל מה שתכתבו בקוד (CSV, JSON, מסד נתונים וכו׳)
- תזמון: DIY דרך משימות cron (דורש שרת ותחזוקה)
- תמחור: חינם וקוד פתוח, אבל שימוש מסחרי עשוי לדרוש את שכבת ה־API בתשלום של Reddit.
הטוב ביותר עבור: מפתחי Python ומדעני נתונים שצריכים אינטגרציות מותאמות אישית ל־Reddit עבור פרויקטים קטנים עד בינוניים ויכולים לחיות עם תקרת ה־API.
4. Octoparse: גריפת Reddit ויזואלית בלחיצה-בחירה
 Octoparse הוא סקרייפר web חזותי ללא קוד עם ממשק point-and-click. בניגוד להרבה סקרייפרים חזותיים כלליים, יש לו ממש תבנית ציבורית ל־Reddit Scraper — וזה חשוב, כי מבנה הדפים של Reddit מפיל הרבה כלים.
- תבנית Reddit: דורשת את
old.reddit.com, תומכת בעד 1,000 URLs של פוסטים ב־run אחד, ויכולה לחלץ שרשורי תגובות/תשובות. התבנית מזהירה מפני תגובות מכווצות או תגובות של "load more" שאינן נלכדות. להשוואה עמוקה יותר, ראו את הסקירה והחלופה שלנו ל־Octoparse. - Pagination ו־infinite scroll: נתמכים, אם כי טעינה דינמית של Reddit עדיין יכולה להיות מאתגרת.
- ייצוא: CSV, Excel, JSON, HTML, XML, מסדי נתונים, Google Sheets.
- תזמון: זמין במסלולים בתשלום, עם ניטור ומשימות parent-child.
- תמחור: התוכנית החינמית כוללת 10 משימות, 2 הרצות מקבילות, ועד 10,000 שורות לייצוא. מסלולים בתשלום מתחילים בערך מ־$69–$75 לחודש.
הטוב ביותר עבור: צוותים שצריכים כלי גריפה רב־תכליתי ל־Reddit ולאתרים אחרים בלי קוד. תבנית Reddit היא יתרון אמיתי על פני סקרייפרים חזותיים כלליים.
5. Browse AI: רובוטי Reddit מוכנים מראש עם ניטור שינויים
 Browse AI נוקט גישה אחרת: במקום לבנות סקרייפרים מאפס, משתמשים ברובוטים מוכנים מראש שתוכננו לאתרים מסוימים. עבור Reddit, Browse AI מפרטת במפורש סקרייפר לדף הבית ולפוסטים ב־subreddit, סקרייפר לתוצאות חיפוש ב־Reddit, ואוטומציות לניטור Reddit.
- ניטור: אפשר להגדיר התראות על פוסטים חדשים, אזכורי מילות מפתח או שינויים ב־subreddits מסוימים. התזמון תומך בתבניות לפי שעה, יום, שבוע, חודש או תבנית מותאמת אישית.
- אינטגרציות: CSV, JSON, Google Sheets, Airtable, Zapier, Make, API ו־webhooks.
- תמחור: שכבת החינם כוללת 50 קרדיטים בחודש, 2 אתרים ו־3 משתמשים. מסלולים בתשלום החל מכ־$49 לחודש.
הטוב ביותר עבור: משתמשים לא טכניים שרוצים ניטור אוטומטי של Reddit בלי עבודה ידנית. חזק למעקב מותג ולהתראות תחרותיות. למידע נוסף על הכלי, ראו את הסקירה והחלופה שלנו ל־Browse AI.
הסתייגות: לא מצאתי הוכחה ציבורית עדכנית לבנייה עמוקה של עצי תשובות מקוננים, ולכן עדיף לתאר אותו כחזק לניטור ולחילוץ ברמת פוסט, אבל רק חלקי עבור תגובות עמוקות.
6. ScrapingBee: גריפת Reddit מבוססת API עם ניהול פרוקסים
 ScrapingBee אינו מוצר ייעודי ל־Reddit. זהו API גריפה כללי שמטפל בדפדפנים headless, בסיבוב פרוקסים ובפתרון CAPTCHA. שולחים URL, ומקבלים HTML נקי, Markdown, או JSON מחולץ.
- רינדור JavaScript: מטפל בדפים הדינמיים של Reddit.
- סיבוב פרוקסים: אוטומטי, כדי להימנע מחסימות.
- פורמטי פלט: HTML, Markdown, טקסט רגיל, JSON מחולץ.
- אין מתזמן מובנה: יש לשלב עם cron או כלי אוטומציה.
- תמחור: ניסיון חינם עם 1,000 קרדיטים ל־API, בלי צורך בכרטיס. מסלולים מ־$49 לחודש.
הטוב ביותר עבור: מפתחים שרוצים גישה אמינה לדפי Reddit בלי לנהל פרוקסים בעצמם. לא כלי מתמחה ל־Reddit — אין בו parser מובנה ל־Reddit או שרשור תגובות. לפירוט מלא, ראו את הסקירה והחלופה שלנו ל־ScrapingBee.
7. Scrapy: מסגרת Python בקוד פתוח לצינורות Reddit מותאמים אישית
 Scrapy היא האפשרות הגמישה ביותר אם הצוות שלכם רוצה להחזיק את כל ה־crawling stack. זו מסגרת Python רבת עוצמה בקוד פתוח עם 61.4K כוכבים ב־GitHub, והגרסה האחרונה שלה היא v2.15.0 (אפריל 2026).
- עיבוד אסינכרוני: crawling מהיר עם סלקטורים של XPath/CSS למיקוד מדויק.
- ניתנת להרחבה: middlewares ו־pipelines לעימוד, מעבר על תגובות, ניקוי נתונים, סיבוב פרוקסים, ניהול user-agent ו-AutoThrottle.
- ייצוא: JSON, JSON Lines, CSV, XML, Pickle ו־Marshal.
- שיקול קריטי: Scrapy לא מטפלת במנגנוני האנטי־בוט של Reddit out of the box. צריך להוסיף לבד סיבוב פרוקסים, ניהול user-agent והגבלת קצב.
- תמחור: חינם וקוד פתוח.
הטוב ביותר עבור: מפתחי Python מנוסים שבונים מערכות גריפת Reddit מותאמות אישית בקנה מידה גדול. אם אתם רוצים שליטה מקסימלית ויכולים לספוג את התחזוקה, קשה להתחרות ב־Scrapy. להשוואה של כלי גריפת Python, ראו את המדריך שלנו ל-כלי ה־web scraping הטובים ביותר ב־Python.
8. ScrapeStorm: סקרייפר Reddit למחשב עם AI למתחילים
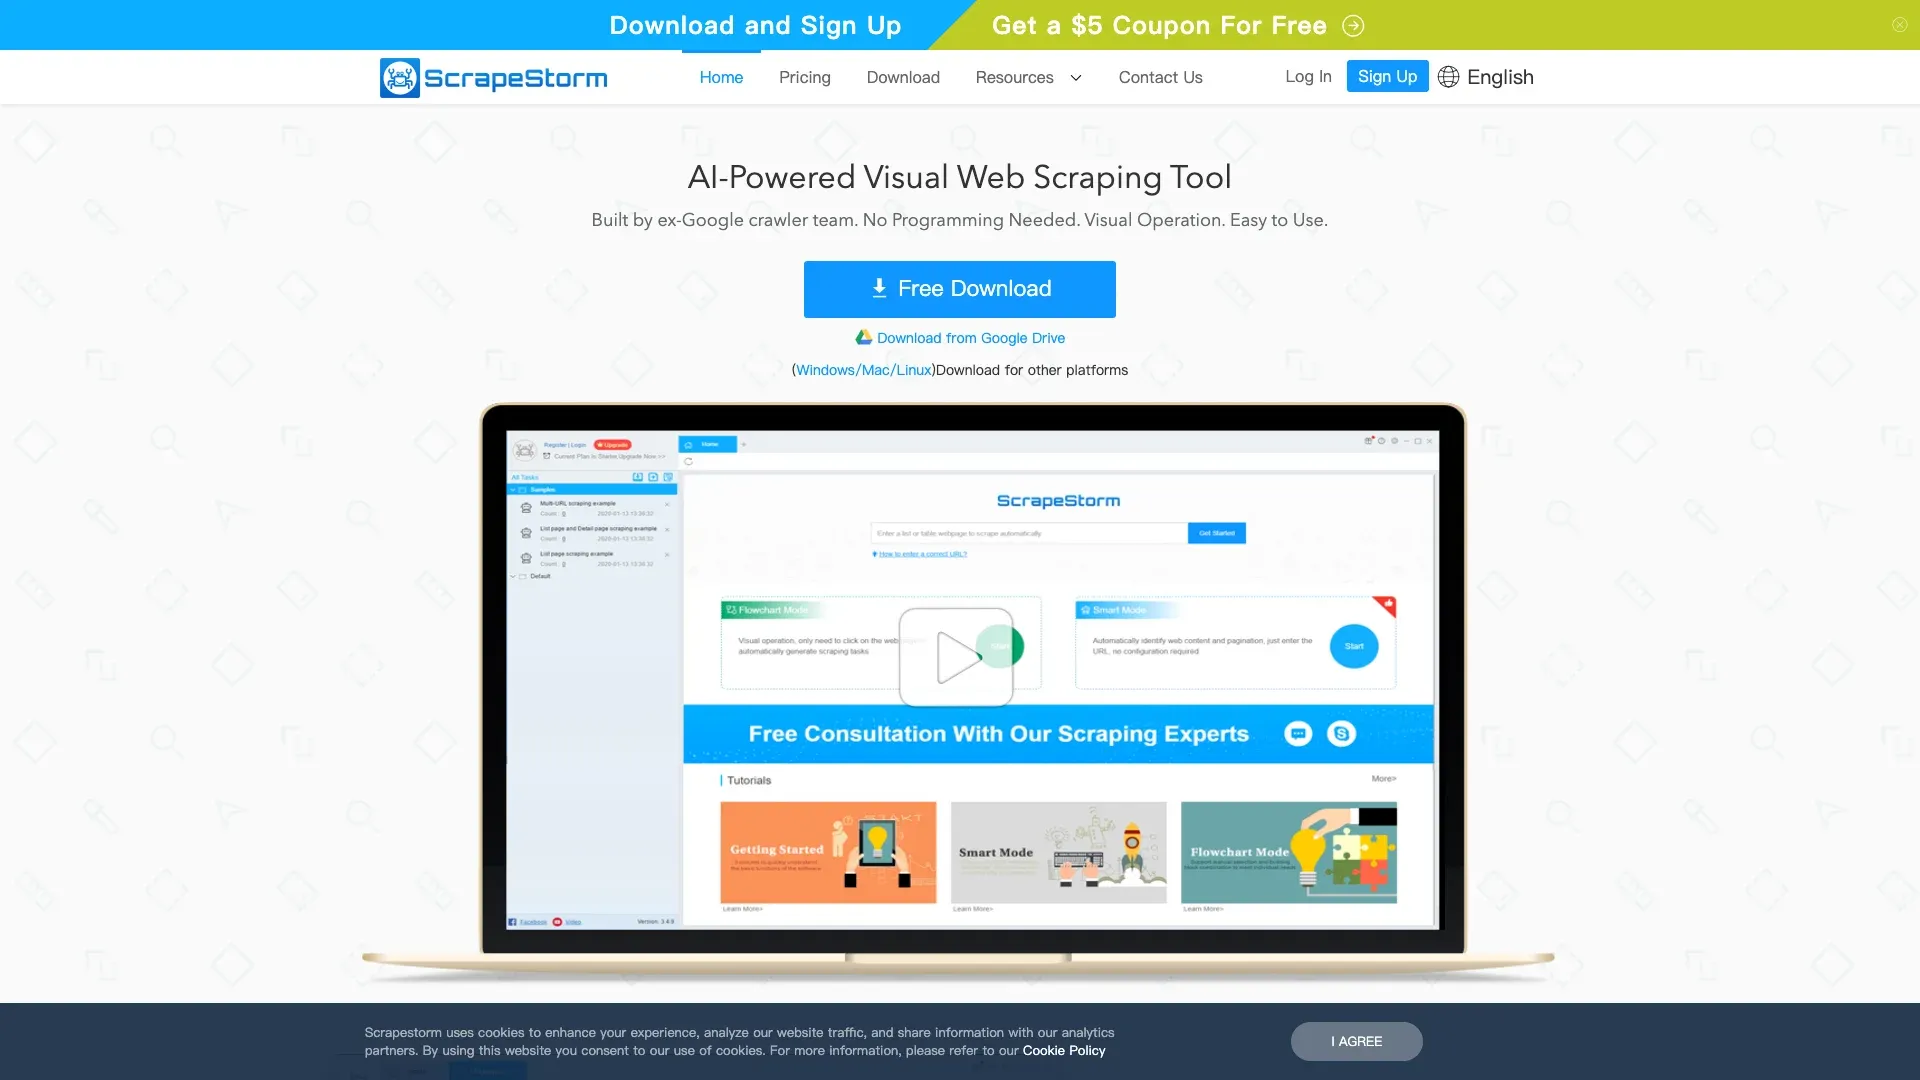 ScrapeStorm הוא יישום דסקטופ מבוסס AI שמזהה אוטומטית דפוסי נתונים בכל דף web. הגרסה הנוכחית היא v4.0.6 (דצמבר 2025).
- זיהוי אוטומטי: ה־AI מזהה נתוני פוסטים (כותרות, ציון, מחברים) בלי תצורה ידנית.
- ממשק חזותי: אפשר לחדד בחירות, להגדיר גריפה מתוזמנת (שעה/יום/שבוע), ולייצא ל־Excel, TXT, CSV, HTML, מסדי נתונים ו־Google Sheets.
- תמחור: שכבת חינם קבועה; מסלולים בתשלום החל מ־$49.99 לחודש.
הטוב ביותר עבור: מתחילים שרוצים גריפת Reddit בסיוע AI בלי קוד או התקנה מורכבת. למבט עמוק יותר, ראו את הסקירה והחלופה שלנו ל־ScrapeStorm.
הסתייגות: לא מצאתי תיעוד ייעודי ל־Reddit שמוכיח חילוץ עמוק של תגובות מקוננות. טוב לגריפה ברמת פני השטח, אבל עומק השרשור כנראה מוגבל אלא אם בונים תהליך עבודה זהיר במיוחד.
9. ParseHub: סקרייפר דסקטופ חזותי לדפי Reddit מורכבים
 ParseHub היא אפליקציית דסקטופ עם ממשק point-and-click חזותי שמטפלת בדפים עתירי JavaScript וטעינה דינמית. היא בולטת מעל הרבה כלים ללא קוד בזכות התמיכה המפורשת שלה בדפוסי חילוץ רקורסיביים/מקוננים.
- נתונים מקוננים: ParseHub מתעדת תכונות Jump, Relative Select ו־CSV Wide לטיפול בחילוץ של שרשורי תגובות — חזק יותר מרוב כלי ה־DOM ללא קוד אם משקיעים זמן בבנאי.
- תזמון: יכול לרוץ בתדירות של פעם בדקה במסלולים בתשלום.
- ייצוא: CSV, JSON, Excel, גישה ל־API.
- תמחור: חינם לעד 5 פרויקטים; בתשלום החל מכ־$89 לחודש.
הטוב ביותר עבור: משתמשים שצריכים לגרוף מבני דפי Reddit מורכבים ועתירי JavaScript בלי קוד — במיוחד אם אתם מוכנים ללמוד את התכונות המתקדמות יותר של הבנאי החזותי. ראו עוד ב-סקירה והחלופה שלנו ל־ParseHub.
10. Firecrawl: API לנתוני web שנבנה עבור צינורות AI ו־LLM
 Firecrawl הוא API שנועד לזחול ולהמיר כל דף web ל־Markdown נקי או לנתונים מובנים, מותאם להזנת נתונים ליישומי AI/LLM. הוא לא סקרייפר ילידי ל־Reddit, אבל אם המטרה שלכם היא להכניס תוכן מ־Reddit לצינור RAG או לבסיס ידע, הוא מתאים מאוד.
- פורמטי פלט: Markdown, HTML, צילום מסך, קישורים, JSON, תמונות, branding, אודיו. חילוץ JSON עולה יותר קרדיטים.
- ניתוב פרוקסים ורינדור JS: מתועדים ומטופלים.
- אין מתזמן מובנה: צריך לשלב עם כלי אוטומציה.
- תמחור: שכבת חינם עם 500 קרדיטים חד־פעמיים; בתשלום החל מכ־$16 לחודש.
הטוב ביותר עבור: צוותים טכניים שמזינים נתוני Reddit למודלים של AI, לצינורות RAG או לבסיסי ידע. להשוואה עמוקה יותר, ראו את הסקירה והחלופות שלנו ל־Firecrawl.
הסתייגות: אין שרשור תגובות ילידי ל־Reddit — הכלי מספק את תוכן הדף כ־Markdown או JSON מובנה. חזק ללכידת תוכן, לא לניתוח עצי שרשור.
11. Oxylabs: גריפת Reddit ברמת ארגון עם תשתית פרוקסים
 Oxylabs היא שירות גריפת web ופרוקסים שמיועד לארגונים. היא מספקת גם פרוקסים גולמיים וגם Web Scraper API מובנה עם תזמון, מסירה לענן ובריכות פרוקסים ענקיות.
- סקייל: משווקת 177M+ כתובות IP ב־195 מדינות ויותר מ־15,000 שותפים.
- מתזמן: מתועד; משימות חוזרות יכולות להישלח ל־AWS S3 או GCS.
- דירוג G2: 4.5/5 מתוך 425 ביקורות.
- תמחור: ניסיון חינם עד 2,000 תוצאות; Web Scraper API החל מ־$49 לחודש. התמחור הארגוני עולה משם.
הטוב ביותר עבור: ארגונים גדולים או סוכנויות שצריכים חילוץ אמין ובכמות גבוהה של נתוני Reddit בקנה מידה גדול. לסקירה מלאה, ראו את הסקירה והחלופה שלנו ל־Oxylabs.
הסתייגות: לא מצאתי תבנית או parser ייעודיים ל־Reddit ב־Oxylabs. זו תשתית עוצמתית — אבל אתם בונים את הלוגיקה הספציפית ל־Reddit בעצמכם.
12. ScrapeGraphAI: חילוץ Reddit מבוסס פרומפטים עם AI
 ScrapeGraphAI היא אחת הכניסות החדשות יותר שמבוססות AI תחילה. אתם מתארים מה אתם רוצים לחלץ באנגלית פשוטה, וה־AI מטפל בשאר — בלי סלקטורים, בלי סכמות.
- GitHub: 21.9K כוכבים.
- פלט: JSON, CSV, Markdown.
- תמחור: שכבת חינם עם 50 קרדיטים ל־API ו־10 בקשות לדקה; בתשלום החל מכ־$17 לחודש.
הטוב ביותר עבור: משתמשים שרוצים גריפת Reddit שמבוססת AI ופרומפטים, בלי להגדיר סלקטורים או סכמות ידנית. לעוד מידע, ראו את הסקירה והחלופה שלנו ל־ScrapeGraphAI.
הסתייגות: לא מצאתי מסמכים ציבוריים ייעודיים ל־Reddit שמבצעים benchmark לאמינות של שרשור התגובות שלו. זהו מחלץ גנרי חזק מבוסס פרומפטים, לא מומחה מותאם ל־Reddit.
בעיית התגובות המקוננות: אילו סקרייפרי Reddit מטפלים בשרשורים עמוקים
זהו החלק שרוב רשימות ה־"best Reddit scraper" מדלגות עליו, והוא גם החשוב ביותר למחקר רציני. שיחות ב־Reddit הן בעלות מבנה עץ, והמבנה הזה משמעותי מבחינה אנליטית. מאמר משנת 2024 ב־Applied Network Science מצא שמידול המבנה ההיררכי של שרשורי Reddit חשוב להבנת תופעות חברתיות. פרה־פרינט משנת 2022 דיווח על עומק תגובה חציוני של 3 ועל מקסימום של 828.
אם אתם עושים ניתוח סנטימנט, איסוף נתוני אימון ל־AI או מחקר איכותני, אתם צריכים את עץ התגובות המלא — לא רק תשובות ברמה העליונה. רוב הסקרייפרים משטיחים תגובות כי הם קוראים רק את ה־DOM הנראה או את פרמטר ברירת המחדל של ה־API.
כך הם עומדים בהשוואה:
| כלי | עומק תגובות | שיטה |
|---|---|---|
| PRAW | עץ מלא (עם קוד) | קריאות API עם replace_more() — שורף מגבלת קצב |
| Apify Deep Scraper | עץ מלא | Actor ייעודי |
| Thunderbit | כל השרשור הגלוי | תבנית תגובות ל־Reddit + גריפת subpages על URLs של פוסטים בודדים |
| ParseHub | פוטנציאל רקורסיבי חזק | Relative Select + Jump + CSV Wide |
| Octoparse | טוב מהרגיל, אבל לא מושלם | תבנית Reddit עם חילוץ תגובות/תשובות; מפספס מקרים של collapsed/load-more |
| Browse AI | חלקי | טוב לניטור, הוכחה חלשה יותר לעומק רקורסיבי |
| ScrapeStorm | חלקי | חילוץ DOM/דפדפן גנרי |
| Firecrawl | חלקי | טוב ללכידת תוכן, לא מומחה לעצי שרשור |
| Oxylabs | חלקי | אפשר לבנות דרך הוראות דפדפן, בלי מסמכי Reddit ייעודיים |
| ScrapeGraphAI | חלקי | חילוץ מבוסס פרומפט/סכמה על תוכן מעובד |
עצה מעשית: עבור גריפת כמות גדולה ברמת subreddit, נתונים שטוחים מספיקים לעיתים קרובות. עבור שרשורים ספציפיים בעלי ערך גבוה (משוב על מוצר, מחקר שוק, מודיעין תחרותי), השתמשו בכלי שנכנס לכל דף פוסט ומחלץ את שרשור התגובות המעובד במלואו.
ניטור Reddit קבוע ואוטומטי: גריפה מתוזמנת למודיעין מותג ושוק
עבור הרבה צוותים עסקיים, השאלה האמיתית היא לא "האם אני יכול לגרוף את Reddit פעם אחת?" — אלא "האם אני יכול להמשיך לשלוף אזכורים של מותג ומתחרים כל יום בלי להשגיח על זה?" משתמש ב-r/NoCodeSaaS תיאר בניית לוח מחוונים חי של נתוני Reddit עם Zapier + Airtable + Softr עבור סטטיסטיקות של subreddit ומגמות צמיחה, וכל זה בלי לכתוב קוד backend. זה בדיוק סוג התהליך שהגריפה המתוזמנת מאפשרת.
מקרי שימוש
- מעקב אחרי אזכורים של המותג שלכם או של מתחרים ב־r/SaaS, r/ecommerce, r/startups
- ניטור דיונים על תמחור והשוואות מוצרים
- איתור לידים חדשים שמבקשים המלצות ב־subreddits נישתיים
- הזנת תקצירי Reddit שבועיים ל־Slack או למייל של הצוות
איך הכלים משתווים
| כלי | תזמון מובנה | קושי התקנה | ייצוא אוטומטי |
|---|---|---|---|
| Thunderbit | כן — תזמון בשפה טבעית | קל מאוד | Sheets, Airtable, Notion, CSV, JSON |
| Apify | כן — מתזמן בסגנון cron | בינוני | Datasets, API, webhooks |
| Browse AI | כן — רובוטי ניטור | קל | CSV, JSON, Sheets, Airtable, אינטגרציות |
| PRAW + cron | DIY בלבד | קשה (שרת, תחזוקה) | כל מה שתכתבו |
| Octoparse | כן (מסלולים בתשלום) | בינוני | CSV, Excel, JSON, מסדי נתונים, Sheets |
| ParseHub | כן (מסלולים בתשלום) | בינוני | CSV, JSON, API |
ה־Scheduled Scraper של Thunderbit מאפשר לכם לכתוב משהו כמו "כל יום שני ב־9 בבוקר", להזין את URLs של ה־subreddit שלכם, וללחוץ Schedule. הנתונים יוצאים אוטומטית ל־Sheets, Airtable או Notion, כך שהצוות יכול להגדיר התראות או לוחות מחוונים בלי לחזור לגעת בסקרייפר. למידע נוסף על אוטומציה של איסוף נתוני web, כתבנו מדריך נפרד.
השוואה זה לצד זה: כל 12 סקרייפרי Reddit במבט אחד
| כלי | גישה | נדרש קוד | מתמודד עם מגבלות API? | תגובות מקוננות | שכבת חינם | תמחור מתחיל | הטוב ביותר עבור |
|---|---|---|---|---|---|---|---|
| Thunderbit | סקרייפר AI לדפדפן/ענן | לא | כן | חזק (תבנית תגובות + subpages) | כן | חינם / ~$9 לחודש | צוותים עסקיים לא טכניים |
| Apify | פלטפורמת Actors | מעט | כן | חלקית עד חזקה | כן (קרדיטים מוגבלים) | לפי actor / $49 לחודש | גריפת subreddits בכמות גדולה |
| PRAW | עטיפת API | כן | חלקית | כן | כן | חינם | מפתחים, מדעני נתונים |
| Octoparse | סקרייפר חזותי | לא | כן | טוב מהרגיל, לא מושלם | כן | ~$69–$75 לחודש | גריפה ללא קוד מרובת אתרים |
| Browse AI | רובוטי ניטור | לא | כן | חלקית | כן | ~$49 לחודש | ניטור והתראות |
| ScrapingBee | שירות API | מעט | כן | אין שרשור מובנה | כן (1K קרדיטים) | $49 לחודש | מפתחים שרוצים להימנע מניהול פרוקסים |
| Scrapy | מסגרת Python | כן | לא (DIY) | כן (אם בונים זאת) | כן | חינם | צינורות מותאמים אישית עם שליטה מלאה |
| ScrapeStorm | אפליקציית AI לדסקטופ | לא | כן | חלקית | כן | $49.99 לחודש | מתחילים |
| ParseHub | סקרייפר חזותי לדסקטופ | לא | כן | פוטנציאל רקורסיבי חזק | כן (5 פרויקטים) | ~$89 לחודש | דפים דינמיים מורכבים |
| Firecrawl | API לנתוני web | מעט | כן | חלקית | כן (500 קרדיטים) | ~$16 לחודש | צינורות AI/LLM |
| Oxylabs | API לגריפת web + פרוקסים | מעט–בינוני | כן | חלקית | ניסיון (2K תוצאות) | $49 לחודש | סקייל ארגוני |
| ScrapeGraphAI | מבוסס פרומפט AI | מעט–בינוני | כן | חלקית | כן (50 קרדיטים) | ~$17 לחודש | תהליכי עבודה AI תחילה מבוססי פרומפט |
כמה דפוסים בולטים מיד. כלים ללא קוד מנצחים במהירות ובנגישות. כלים מבוססי קוד מנצחים בהתאמה אישית. כלים מבוססי API בענן מנצחים בסקייל.
לגבי עומק ספציפי ל־Reddit — במיוחד תגובות מקוננות — רק קומץ כלים באמת מספקים: PRAW, ה־deep scraper של Apify, תבנית התגובות של Thunderbit, ו־ParseHub עם חילוץ רקורסיבי.
איך לבחור את סקרייפר Reddit הטוב ביותר עבור הצוות שלכם
אחרי שבדקתי את כל 12, כך הייתי מחלק אותם:
- צוות מכירות או שיווק בלי מפתחים? התחילו עם Thunderbit או Browse AI. Thunderbit הוא המהיר ביותר לגריפה חד־פעמית ומתוזמנת; Browse AI חזק יותר להתראות ניטור.
- צריכים נתוני subreddit בכמות גדולה עם מעט משאבים טכניים? Apify או Oxylabs. אקוסיסטם ה־actor של Apify נותן אפשרויות ייעודיות ל־Reddit; Oxylabs מספקת תשתית ברמת ארגון.
- מפתח שבונה צינורות מותאמים אישית? PRAW או Scrapy. PRAW לתהליכי עבודה שמתחילים ב־API; Scrapy לזחילה עם שליטה מלאה. רק תקצו תקציב לתחזוקה ולניהול מגבלות קצב.
- נתוני Reddit ליישומי AI/LLM? Firecrawl, ScrapeGraphAI, או ה־API של Thunderbit. Firecrawl מצטיינת בפלט Markdown עבור RAG; ScrapeGraphAI מעולה לחילוץ מבוסס פרומפטים.
- ניטור והתראות מתמשכים? Thunderbit Scheduled Scraper, Browse AI, או Apify schedules.
הערה קצרה על שיקולים משפטיים ואתיים
התנאים של Reddit מחמירים יותר עכשיו. שימוש מסחרי ב־API דורש אישור, Pushshift כבר לא ארכיון ציבורי, ו־Reddit תבעה בפועל חברות על גריפה לא מורשית. גריפת דפים ציבוריים אפשרית מבחינה טכנית, אבל הסיכון המדיניותי אמיתי. אם הצוות שלכם אוסף מידע אישי, שומר תוכן שנמחק, או בונה ניטור מסחרי בקנה מידה גדול, כדאי לקבל בדיקה משפטית. תמיד כבדו את User Agreement של Reddit ואת Developer Terms.
לסיום
נתוני Reddit יקרי ערך יותר מאי פעם — וקשים יותר לגישה מאי פעם. הכלים שעבדו ב־2022 לא כולם עובדים ב־2026.
גישות שמבוססות קודם כול על API מוגבלות כעת על ידי מגבלות קצב והגבלות מסחריות. כלי גריפה מבוססי דפדפן וענן הפכו לברירת המחדל המעשית עבור רוב הצוותים העסקיים.
אם אתם רוצים לראות איך נראה גריפת Reddit מודרנית בלי לכתוב שורת קוד, נסו את הניסיון החינמי של Thunderbit. ואם Thunderbit לא מושלם עבורכם, נסו כמה אחרים מהרשימה הזו. הסקרייפר הטוב ביותר הוא זה שבאמת מביא לכם את הנתונים שאתם צריכים, בזמן, בלי לאכול לכם את סוף השבוע.
גריפה נעימה — ושעצי התגובות שלכם תמיד יהיו פתוחים עד הסוף.
נסו את Thunderbit לגריפת Reddit Get Started Free
שאלות נפוצות
1. האם חוקי לגרוף את Reddit ב־2026?
User Agreement של Reddit ו-Developer Terms מגבילים בבירור גריפה ללא הסכמה בכתב, ושימוש מסחרי ב־API דורש אישור. Reddit תבעה חברות כמו Anthropic ו־Perplexity על שימוש לא מורשה בנתונים. גישה לדפים ציבוריים אפשרית מבחינה טכנית, אבל הסיכון הרגולטורי והמשפטי אמיתי. אם אתם גורפים בקנה מידה גדול או למטרות מסחריות, כדאי לבצע בדיקה משפטית.
2. אפשר לגרוף את Reddit בלי קוד?
כן. אפשרויות ה־no-code החזקות ביותר ב־2026 הן Thunderbit, Browse AI, Octoparse, ScrapeStorm ו־ParseHub. תהליך ה־2 קליקים של Thunderbit הוא המסלול המהיר ביותר למשתמשים לא טכניים — בלי מפתחות API, בלי התקנה, בלי סקריפטים.
3. מהו סקרייפר Reddit החינמי הטוב ביותר?
עבור מפתחים, PRAW עדיין האפשרות הטובה ביותר בחינם שמבוססת קוד (בכפוף למגבלות API). עבור משתמשים לא טכניים, Thunderbit, Browse AI ו־Octoparse כוללים כולם שכבות חינם משמעותיות. Thunderbit נותן 6 דפים בחינם עם ייצוא מלא ל־Sheets, Excel, Airtable ו־Notion.
4. איך עוקפים את מגבלת 1,000 הפוסטים של Reddit?
בדרך כלל אי אפשר לעקוף אותה בצורה נקייה דרך ה־API הרשמי — התקרה הזו עדיין מגבלה מעשית בתהליכי עבודה מסוג listing API. גריפה מבוססת דפדפן (Thunderbit, Octoparse), גישות actor בענן (Apify), או שאילתות ממוקדות וצרות יותר הן חלופות מציאותיות יותר. עבור נתונים היסטוריים עמוקים, הטריק הישן של Pushshift כבר לא זמין.
5. אפשר לגרוף תגובות של Reddit יחד עם פוסטים?
כן, אבל איכות הכלים משתנה מאוד. PRAW יכול לעבור על עצי תגובות מלאים (במחיר של מגבלת הקצב של ה־API). ה-Reddit Comments Deep Scraper של Apify נבנה בדיוק לזה. תבנית התגובות של Thunderbit ל־Reddit וגריפת subpages מחלצות את שרשור התגובות המעובד במלואו מדפי פוסט בודדים. גם החילוץ הרקורסיבי של ParseHub יכול לטפל בתגובות מקוננות אם מגדירים אותו בזהירות.
לקריאה נוספת



