

Thunderbit 的 PubMed 爬蟲 能運用 AI,將 PubMed 頁面轉換成乾淨、結構化的資料集。你可以擷取熱門醫學研究、臨床試驗證據、摘要、作者、機構、發表日期、PMID 與文章連結,然後匯出到 Excel、Google Sheets、Airtable 或 Notion。你只要在 Chrome 中打開 PubMed,讓 AI 建議最佳欄位,再開始爬取即可。
🧬 什麼是 PubMed 爬蟲
PubMed 爬蟲 是專為 PubMed | US National Library of Medicine 打造的 AI Web Scraper。透過 Thunderbit(一款 AI 網頁爬蟲 Chrome 擴充功能),你可以進入任何 PubMed 結果頁,點擊 AI Suggest Columns,接著按下 Scrape,無需寫程式即可擷取結構化資料。
🔎 你可以用 PubMed 抓取什麼
PubMed 裡有大量高價值的生醫中繼資料,但它們不一定適合直接分析。Thunderbit 的 AI Web Scraper(https://thunderbit.com/)可以幫你收集與整理 PubMed 列表,並透過 Subpage Scraping(開啟每篇文章頁面,補抓摘要、機構、DOI 等欄位)進一步豐富資料。
以下是兩個你可以在幾分鐘內完成的常見流程。
📈 抓取 PubMed 熱門醫學研究監測資料
這個流程適合用來監控 PubMed 熱門頁面上的醫學研究趨勢。你可以用它來掌握最新動態、建立內部摘要、追蹤競品發表,或作為文獻監測流程的一部分。
目的地頁面範例:PubMed Trending
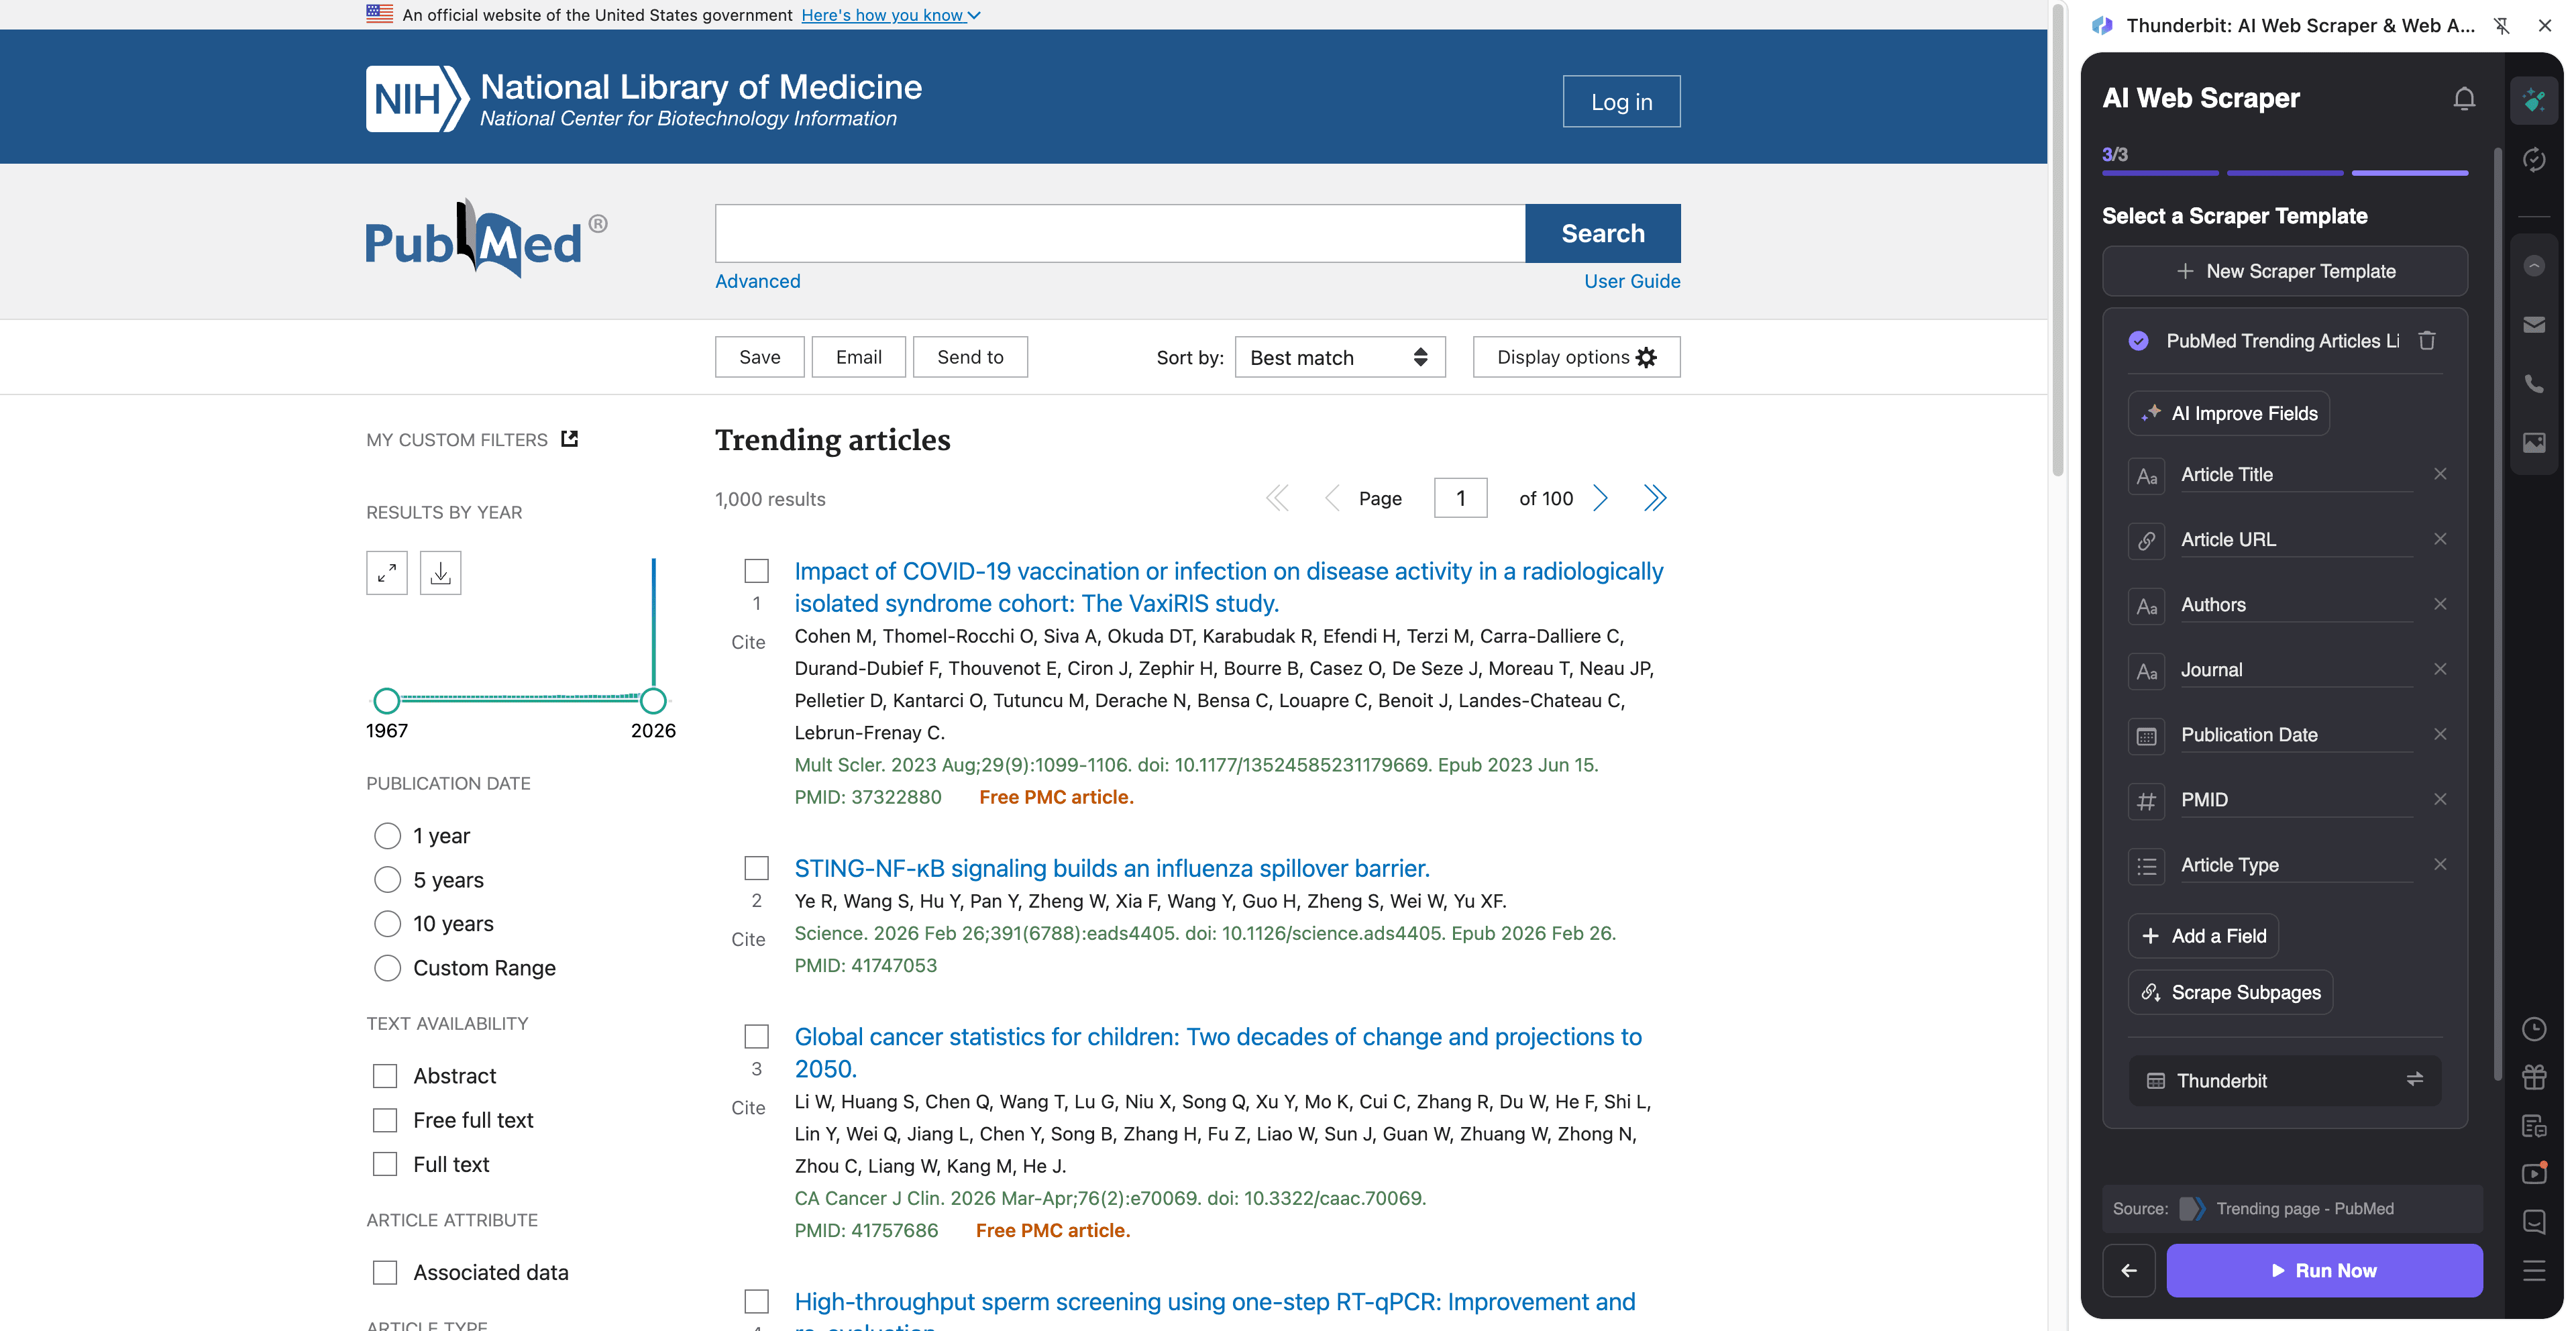
步驟:
- 下載 Thunderbit Chrome Extension 並註冊帳號。
- 前往目的地頁面,例如:PubMed Trending。
- 點擊 AI Suggest Columns,讓 AI 推薦最適合的欄位名稱與資料類型。
- 點擊 Scrape 擷取資料,然後匯出到 Excel、Google Sheets、Airtable 或 Notion。
欄位名稱
| 欄位 | 說明 |
|---|---|
| 🧾 文章標題 | 熱門 PubMed 文章的標題。 |
| 🔗 文章 URL | 直接連到該 PubMed 紀錄頁的網址。 |
| 🆔 PMID | 這筆紀錄的 PubMed 識別碼(適合作為穩定鍵值)。 |
| 🏛️ 期刊 | 文章發表的期刊名稱。 |
| 📅 發表日期 | 列表中顯示的發表日期。 |
| ✍️ 作者 | 結果卡片上顯示的作者資訊。 |
| 🧪 文章類型 | 若有顯示,則為發表類型(例如 Review、Clinical Trial)。 |
| 🏷️ 關鍵字 / 主題 | 列表中可見的主題標籤或關鍵字(若有)。 |
| 📝 摘要片段 / 概要 | 列表中顯示的簡短摘要文字(若有)。 |
| 🧷 DOI | DOI(通常透過子頁面爬取可取得更完整結果)。 |
| 🧑🔬 機構 | 作者所屬機構(通常透過子頁面爬取擷取)。 |
| 📄 摘要 | 文章摘要文字(通常透過子頁面爬取擷取)。 |
🧫 抓取 PubMed 臨床試驗證據
這個流程可用來從 PubMed 搜尋結果中擷取與臨床試驗相關的證據,接著再逐筆打開文章頁面,補抓摘要、試驗訊號與審查所需的中繼資料。
目的地頁面範例:Clinical trial search results
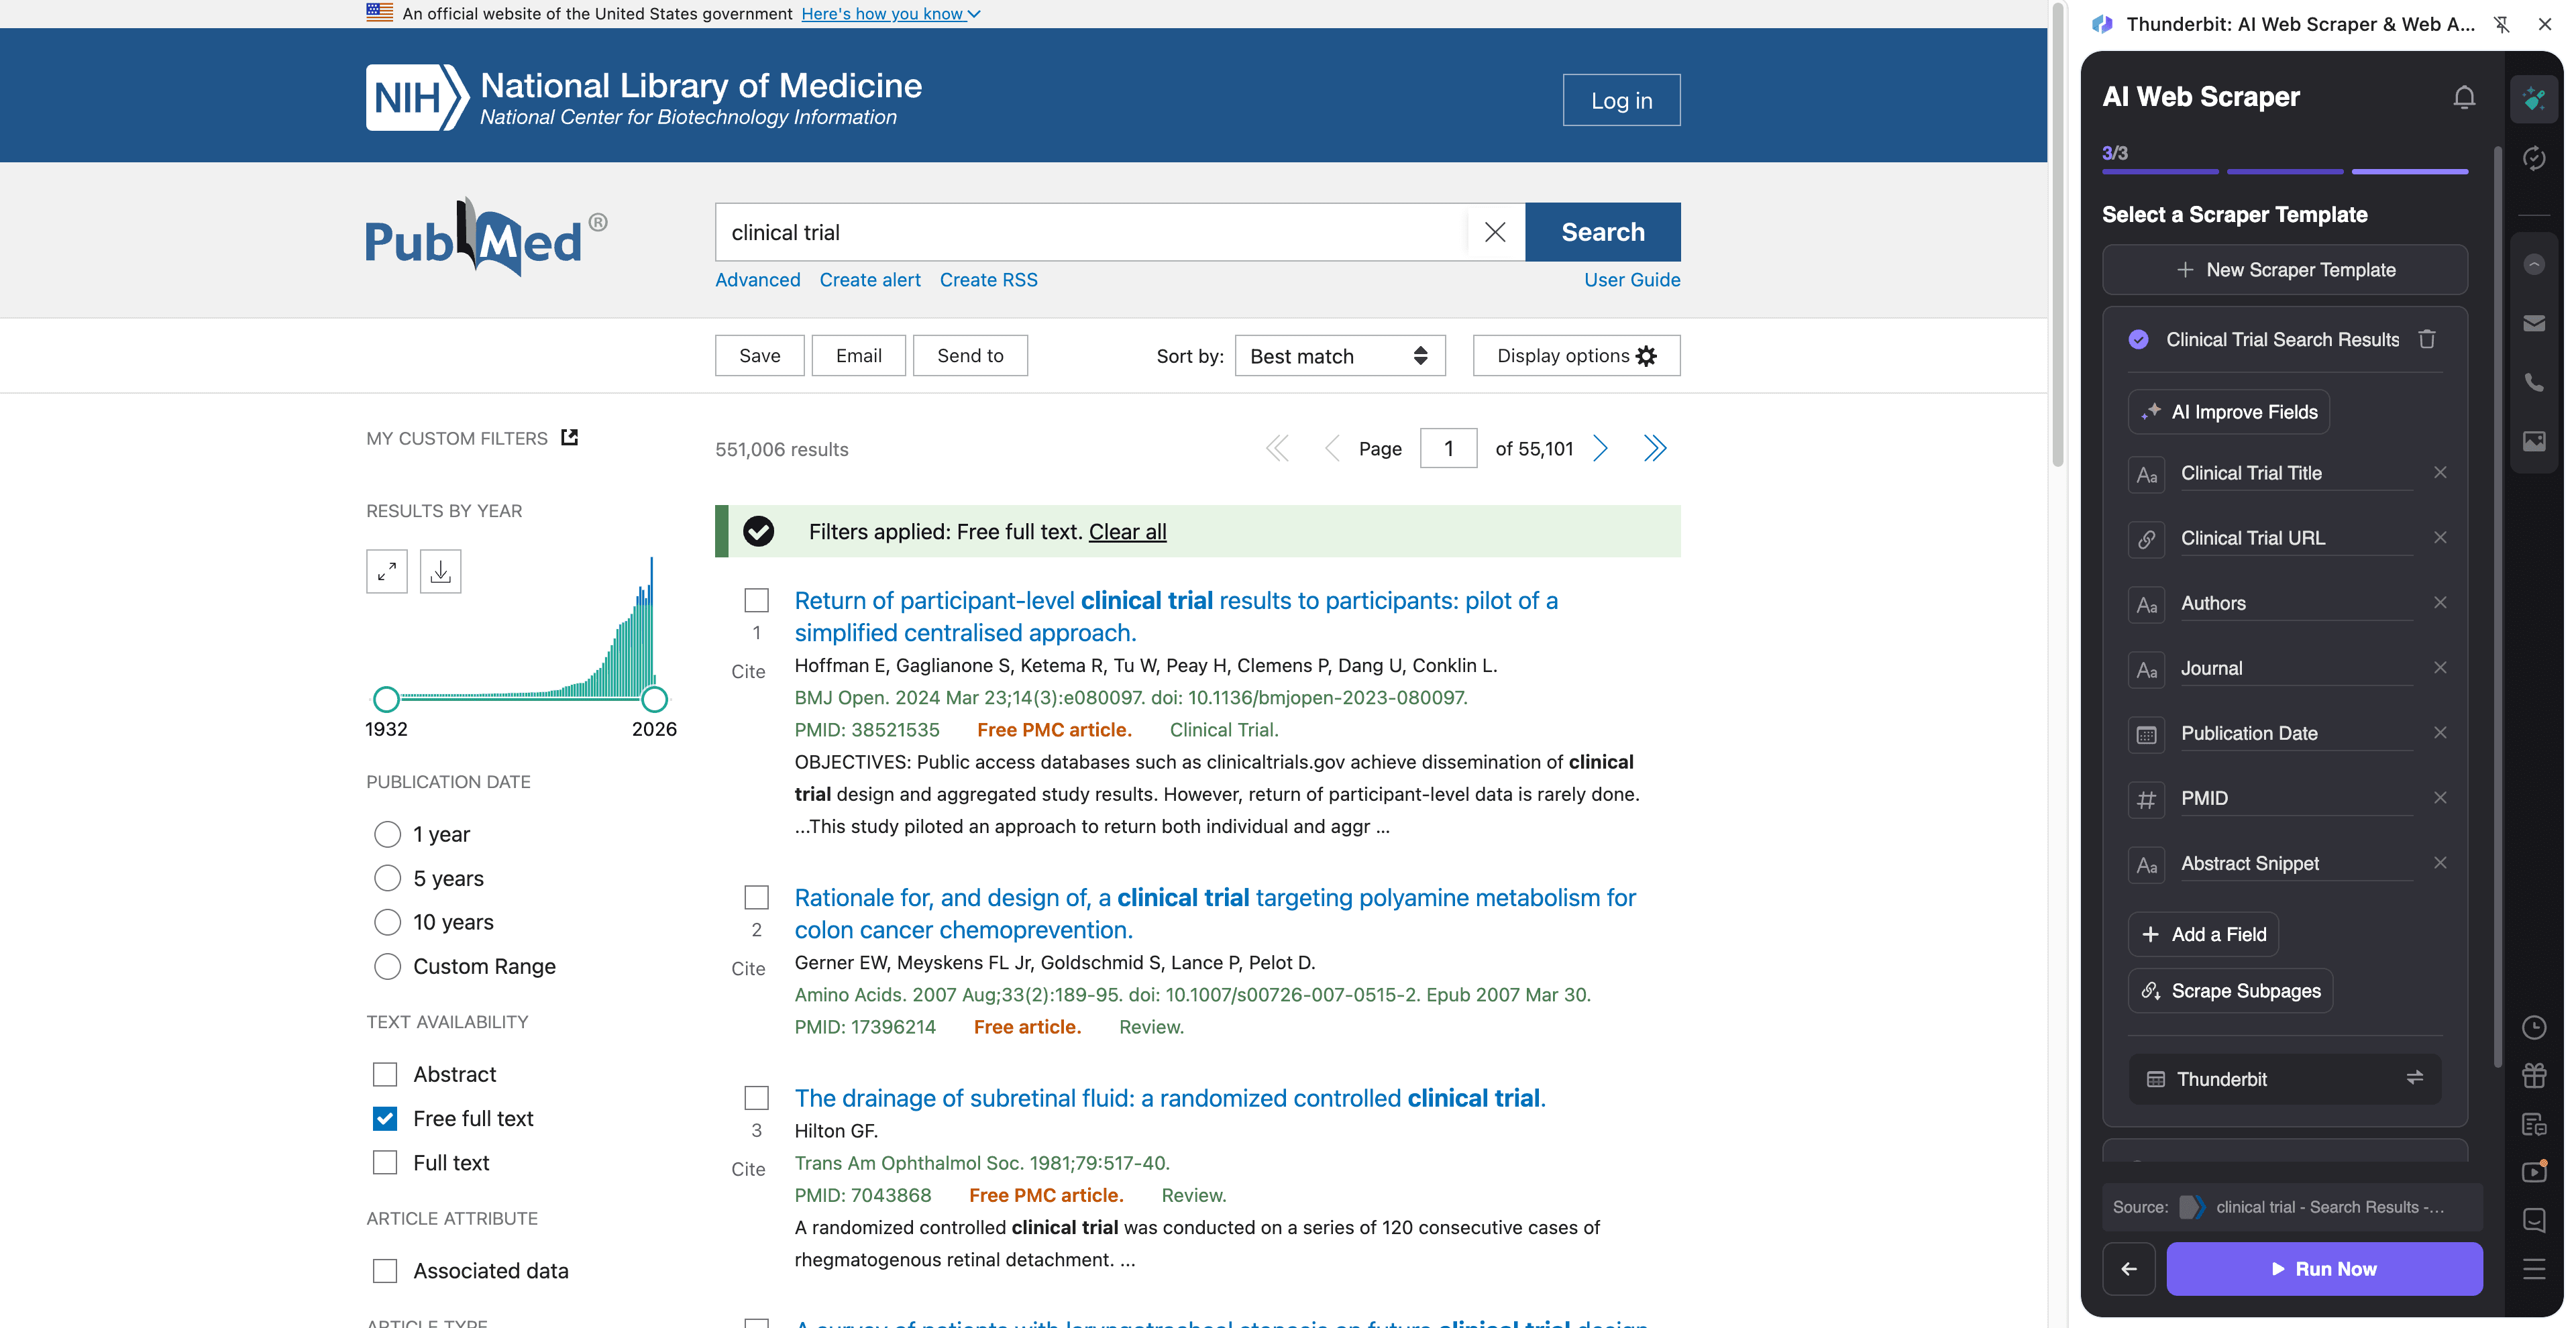
步驟:
- 下載 Thunderbit Chrome Extension 並註冊帳號。
- 前往目的地頁面,例如:Clinical trial search results。
- 點擊 AI Suggest Columns 產生建議欄位(你也可以重新命名或自行新增欄位)。
- 點擊 Scrape 收集結果,接著使用 Scrape Subpages 補抓每筆資料的摘要、機構、DOI 等資訊。
欄位名稱
| 欄位 | 說明 |
|---|---|
| 🧾 標題 | 搜尋結果中的文章標題。 |
| 🔗 PubMed URL | 連到 PubMed 文章頁的連結,方便做子頁面補抓。 |
| 🆔 PMID | 用於去重與引用的 PubMed 識別碼。 |
| 🧑⚕️ 作者 | 結果摘要中列出的作者。 |
| 🏛️ 期刊 | 結果中顯示的期刊名稱與引用資訊。 |
| 📅 日期 | 列表中顯示的發表日期(或 ePub 日期)。 |
| 🧪 發表類型 | 如 Clinical Trial、Randomized Controlled Trial、Meta-Analysis 等標記(通常在文章頁更清楚)。 |
| 🧾 摘要 | 完整摘要文字(建議透過子頁面爬取取得)。 |
| 🧬 MeSH 詞彙 | 若有提供,則為醫學主題詞(通常在文章頁)。 |
| 🧷 DOI | 用於連結出版社頁面與文獻管理工具的 DOI。 |
| 🏥 機構 | 作者機構資訊,便於做機構分析(子頁面爬取)。 |
| 🌍 國家 / 機構 | 可透過 Field AI Prompts 從機構資訊中解析(選用)。 |
| 🔍 臨床試驗關鍵字 | 例如 “randomized”、“double-blind”、“placebo” 等 AI 標註訊號(可透過 Field AI Prompt 選用)。 |
| 📎 全文連結 | 若有,可抓取導向出版社或免費全文的外部連結。 |
🎯 為什麼要使用 PubMed 工具
抓取 PubMed 的重點在於速度、一致性,以及讓研究資料能在你的工作流程中真正可用。與其一筆一筆手動複製引用,不如建立可篩選、可標記、可分享的結構化資料集。
團隊常用 PubMed 爬蟲的原因包括:
- 醫藥事務與製藥團隊:追蹤某治療領域的新發表、監控競品試驗,並建立內部審查用的證據表。
- 生技與臨床營運:收集與試驗相關的論文,整理機構與研究者資訊,並維護持續更新的文獻清單。
- 醫療行銷與內容團隊:找出熱門主題、高影響力期刊與新興關鍵字,作為內容規劃依據。
- 學術研究者與圖書館員:建立文獻回顧資料集,依 PMID 去重,並匯出到試算表進行初步篩選。
- 資料團隊:將資料整理成後續分析、儀表板或內部知識庫所需的結構化輸入。
當你需要的不只是列表頁資料時,Thunderbit 特別有幫助。透過 Subpage Scraping,你可以大規模擷取摘要、機構、DOI、MeSH 詞彙與全文連結。
🧩 如何使用 PubMed Chrome 擴充功能
- 安裝 Thunderbit Chrome Extension:從 Chrome Web Store 下載並建立帳號。
- 前往 PubMed 頁面:打開 PubMed、像 Trending 這樣的熱門頁面,或像 clinical trial results 這類查詢結果頁。
- 啟用 AI 驅動的爬蟲:點擊 AI Suggest Columns 生成欄位,調整資料類型(文字/日期/網址),並新增可選的 Field AI Prompts(用於標註、格式化或擷取試驗訊號)。
- 爬取並匯出:點擊 Scrape。如果你需要摘要/機構/MeSH 等資料,再執行 Scrape Subpages 擴充每筆資料,然後匯出到 Excel、Google Sheets、Airtable 或 Notion。
如果你正在建立可重複使用的流程,以下內容值得一讀:
- How to Scrape Any Website Using AI
- What Is Data Scraping and How to Do It in 2025
- How to Scrape Website Data into Excel using AI
- What Is List Crawling and How to Do It Using AI
💳 PubMed 價格方案
Thunderbit 採用簡單的點數制度:
- 1 點數 = 1 筆輸出資料列,也就是結果表中的一筆紀錄(例如一筆 PubMed 記錄)。
- 資料匯出免費:可下載 CSV/JSON,或直接傳送到 Excel、Google Sheets、Airtable 或 Notion。
你可以從以下方案開始:
- 免費方案:每月可爬取 6 頁(Free 方案以頁數計算)。
- 免費試用:可免費爬取 10 頁,非常適合測試 PubMed 熱門頁與幾個臨床試驗結果頁。
如果你會定期爬取(每週監控、證據更新或大量查詢),付費方案會提供更多點數。年繳方案通常更划算,因為相較於月繳可享有折扣。
你可以到 Thunderbit Pricing 查看方案內容。
❓ 常見問題
-
什麼是 AI 驅動的 PubMed 爬蟲?
AI 驅動的 PubMed 爬蟲是 Thunderbit 中的一個工作流程,可從 PubMed 搜尋結果與文章頁擷取結構化資料。你可以用 AI 建議欄位、爬取列表,並透過開啟文章子頁面補抓摘要、機構、DOI 等資訊,豐富每一筆資料。 -
什麼是 Thunderbit?
Thunderbit 是一款 AI 網頁爬蟲 Chrome 擴充功能,專為需要從網站取得結構化資料的商務與研究工作流程而設計。它能幫助你快速擷取、標註並匯出資料,無需建立或維護爬蟲腳本。 -
可以抓取 PubMed 熱門頁和一般搜尋結果嗎?
可以。你可以抓取 PubMed Trending 頁面、一般關鍵字搜尋,以及有篩選條件的結果頁(例如聚焦臨床試驗的查詢)。Thunderbit 的 AI 會先讀取頁面,再根據不同版型自動提出欄位建議。 -
Thunderbit 可以擷取摘要、機構與 MeSH 詞彙嗎?
可以,而且這正是 Subpage Scraping 最有幫助的地方。你可以先抓取搜尋結果列表,再讓 Thunderbit 開啟每個 PubMed 紀錄頁,將摘要、機構、MeSH 詞彙、DOI 與其他中繼資料整理到同一張表中。 -
PubMed 的分頁與無限捲動要怎麼處理?
Thunderbit 支援分頁爬取,包括「下一頁」式的導覽。如果 PubMed 改變結果載入方式,AI 擷取通常比固定選擇器更有韌性,因為它會在每次執行時重新讀取頁面結構。 -
PubMed 資料可以匯出成哪些格式?
你可以匯出成 CSV 或 JSON,也可以直接把資料集送到 Excel、Google Sheets、Airtable 或 Notion。這對篩選流程、證據表、儀表板,以及與協作者共享都很有幫助。 -
我可以免費抓取多少筆 PubMed 紀錄?
在免費方案下,你每月可爬取 6 頁,通常足夠小型監測任務使用。若使用免費試用,你可以免費爬取 10 頁,方便驗證欄位設定與子頁面補抓策略。 -
我可以針對特定證據擷取需求自訂欄位嗎?
可以。你可以重新命名欄位、設定資料類型(文字/日期/網址),並新增 Field AI Prompts 來擷取或標註資訊,例如試驗設計關鍵字、族群、介入、對照、結果,或從機構欄位解析國家資訊。這能幫助你從單純抓取資料,進一步變成結構化的證據整理。 -
抓取 PubMed 合法嗎?
PubMed 是公開資源,許多團隊會收集其書目中繼資料用於研究與分析。不過你仍應遵守適用法律、尊重網站條款,並採取負責任的爬取方式,尤其是在執行大量且頻繁的任務時。
📚 了解更多
- 取得擴充功能:Thunderbit Chrome Extension 下載頁
- 瀏覽 Thunderbit Blog 的教學文章
- 學習基礎知識:What Is Data Scraping and How to Do It in 2025
- 建立列表工作流程:What Is List Crawling and How to Do It Using AI
- 匯出到試算表:How to Scrape Website Data into Excel using AI
- 如果你也在研究流程中抓取 PDF:How to Scrape Data from PDF using AI










