
網頁爬蟲曾經被貼上「工程師專屬」的標籤,好像非得看得懂程式碼、熬得住除錯,才配碰這門技術。但走到 2026 年,情況早就變了。只要你想做出更精準的商業判斷、把重複的複製貼上工作交出去,或是單純想省下每天整理資料的時間,網頁爬蟲就是一項值得學的基本功。這幾年,從業務、電商經理到房仲,愈來愈多完全不寫程式的人開始用它來建立潛在客戶名單、盯著對手的動態、蒐集市場情報。
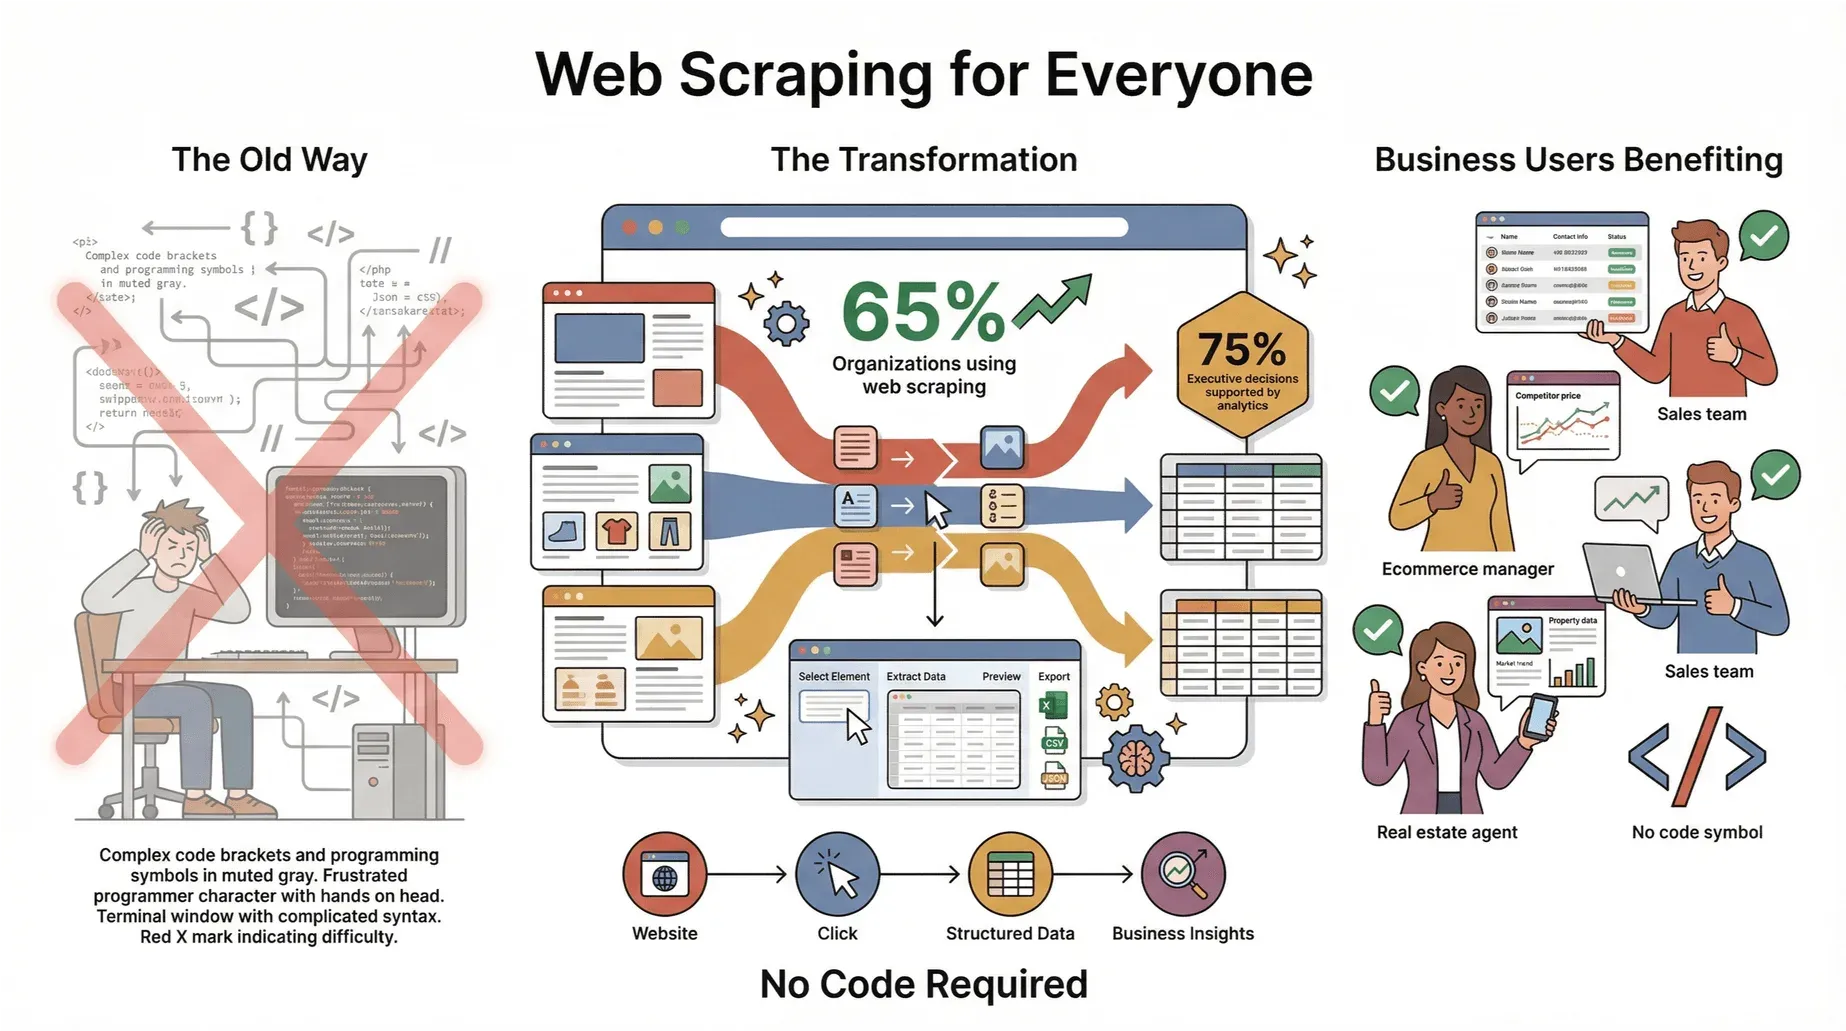
趨勢也反映在數字上。65% 的組織 已經把網頁爬蟲用在 AI 專案與日常營運上,而 LinkedIn 2024 年對領導力的分析 則預估,約有 75% 的高層決策未來會靠分析與自動化來支撐。門檻這一關,現在也有 Thunderbit 這類工具幫忙跨過,完全沒經驗的人也能上手。如果你想把網路上的公開資料變成自己的資產,又不想被技術卡住,這篇指南就是寫給你的。
網頁爬蟲入門:先搞懂幾個關鍵名詞
剛接觸時,你會看到一堆看起來很硬的專有名詞。別緊張,拆開來其實都不難理解。

-
網頁爬蟲(Web Scraping): 用軟體自動把網站上的資訊抓下來,整理成試算表或資料庫。原本要花好幾小時手動複製貼上的活,爬蟲幾分鐘就搞定 (Wikipedia)。
-
HTML 解析(HTML Parsing): 每個網頁背後都是一段 HTML,負責告訴瀏覽器要顯示什麼。解析就是把這段程式碼讀懂,轉成一張結構圖(也就是 DOM),讓爬蟲知道你要的資料放在哪 (Firecrawl)。
-
CSS 選擇器(CSS Selectors): 可以把它想成網頁上的門牌號碼。假設你要抓產品頁上的所有價格,CSS 選擇器就負責指路,例如「找出 class 是 price 的元素裡的所有文字」。
-
資料擷取(Data Extraction): 這是整件事的終點——把你在意的資訊(姓名、價格、信箱等)抓出來,放進可以直接使用的結構化格式。
-
API(應用程式介面,Application Programming Interface): 有些網站會開放官方的資料存取管道,也就是 API。網站有 API 的話,通常比直接爬 HTML 更省事、更穩定。只是不是每個網站都提供,這也正是網頁爬蟲會這麼受歡迎的原因 (Initial Data Offering)。
說白了,網頁爬蟲就像派一位手腳飛快的助理去網站幫你找資料,找完還幫你排得整整齊齊搬進表格,全程不用你動手。
不會寫程式,為什麼也該學網頁爬蟲
什麼是資料抓取?2025 年完整做法指南 Get Started Free
如果你不是開發者,學這個到底有什麼用?答案很直接:它幫你省下大量時間,也讓商務工作者在競爭裡多一分優勢。以下幾個都是實際會用到的情境:
| 應用情境 | 商業價值 |
|---|---|
| 開發潛在客戶(銷售) | 幾分鐘內就能從名錄或 LinkedIn 建立潛在客戶清單,不必再花幾小時整理。 |
| 價格監控(電商) | 自動追蹤競品價格與庫存,隨時調整自己的定價保持競爭力。 |
| 顧客評論蒐集(行銷) | 彙整多個網站上的評論,了解消費者情緒並優化產品。 |
| 市場研究 | 追蹤產業新聞、職缺資訊或競品動態,取得策略洞察。 |
舉個實例,BrowserCat 的網頁爬蟲效益整理 提到,一家英國零售商靠爬取競品價格加快定價反應後,銷售額大約成長了 4%。另外,一份被廣泛引用的彙編 指出,以資料為本的公司獲利能力可達 19 倍,對客戶的理解度也高出 52%(這些數字最早出自較早期的產業調查)。
換句話說,網頁爬蟲替你把瑣碎工作自動化,讓判斷更有依據,也把時間留給真正能帶動業績的事。
少踩坑的第一步:把事情做簡單
跟新手聊多了就會發現,大家反覆卡在同幾個地方。這裡整理最常見的失誤,以及對應的解法:
-
沒有先定目標: 沒規劃就直接開抓,多半只會拿到一堆亂資料,還白白浪費時間。動手前先想清楚:你要哪些資料、為什麼要 (Infatica)。
-
一開始就想抓太多: 很多人想一步到位,第一次就衝著幾千頁去抓,結果通常是滿滿的挫折。建議先小規模試水——先抓一頁,確認沒問題再慢慢放大。
-
資料重複又雜亂: 新手常抓到重複項目,或格式不一致的資料(同樣是價格,有的寫「$1,299」、有的寫「1299 USD」)。抓的過程中就要邊查重複、邊統一格式 (Medium)。
-
漏掉分頁或子頁面: 只抓列表第一頁、後面全漏掉,是很典型的新手狀況。確認你的工具能處理「下一頁」按鈕,也能跟著連結進到詳細頁。
-
無視網站規則: 沒看 robots.txt 或服務條款就下手,輕則被封鎖,重則惹上更麻煩的糾紛。尊重網站規範這件事,省不得。 (Dev.to)。
一個實用做法:先挑像 Thunderbit 這種對新手友善的工具,很多麻煩它已經替你處理好了。工具選對,省下的往往是好幾個鐘頭,也能少踩最常見的那幾個坑。
零程式碼上手:Thunderbit 怎麼把難的變簡單
使用 AI 從任何網站抓取資料 Get Started Free
這幾年市面上的爬蟲工具看過不少,Thunderbit 是我第一個願意推薦給非技術朋友和商務用戶的。原因很單純:它就是為「只想要結果、不想背術語」的人設計的。
Thunderbit 的重點功能包括:
-
兩步驟 AI 抓取: 打開 Thunderbit Chrome 擴充功能,按下「AI 建議欄位」,它的 AI 就會掃過整頁、幫你挑出最適合擷取的欄位(例如「產品名稱」「價格」「評分」)。接著點一下「Scrape」就完成,不用寫程式、不用管選擇器,也不必傷腦筋 (Thunderbit Blog)。
-
子頁面抓取: 想要更細的資料?Thunderbit 能自動點進每個連結的子頁面(像產品詳情頁),把額外資訊抓回來,再一鍵補進你的表格 (Thunderbit Blog)。
-
自動分頁: 「下一頁」按鈕和無限捲動,Thunderbit 都會幫你處理,不會讓你漏掉後面的結果 (Thunderbit Blog)。
-
即用模板: 碰到 Amazon、Zillow、LinkedIn 這類熱門網站,Thunderbit 備有現成模板,挑一個就能一鍵匯出資料 (Thunderbit)。
-
免費匯出: 結果可以直接送到 Excel、Google Sheets、Airtable 或 Notion,不加價、也不設限 (Thunderbit)。
-
AI 資料清理: 抓取的當下,Thunderbit 就能替你標記、格式化、翻譯,甚至摘要資料,讓試算表一拿到就是可用狀態 (Thunderbit)。
-
雲端或瀏覽器抓取: 想快,就用雲端模式(一次最多 50 頁);碰到需要登入的網站,就切成瀏覽器模式。
用起來,它比較像一位不會累、不抱怨的 AI 實習生,資料永遠幫你收得妥妥當當。
實作演練:用 Thunderbit 完成第一次抓取
想動手了嗎?下面就照著走一遍,第一次抓取也能全程不寫程式。
-
安裝 Thunderbit: 把 Thunderbit Chrome 擴充功能 加進瀏覽器,註冊免費帳號(每月 6 個免費頁面,試用加成下可到 10 個)。
-
打開目標網站: 進到你想抓的頁面,例如房地產列表、產品頁或目錄頁。
-
叫出 Thunderbit: 點工具列上的 Thunderbit 圖示,面板就會跳出來。
-
按「AI 建議欄位」: Thunderbit 的 AI 會掃過整頁、建議最合適的擷取欄位;你也可以自己編修或加欄位。
-
按「Scrape」: Thunderbit 開始把頁面資料抓下來,多頁的話也會自動處理分頁。
-
(選用)抓子頁面: 想要每個項目更多細節,就按「Scrape Subpages」,Thunderbit 會逐一點進連結頁擷取額外資訊。
-
匯出資料: 按「Export」,選 Excel、Google Sheets、Airtable 或 Notion,資料馬上能用。
-
核對結果: 快速掃一遍試算表,確認內容對不對。發現缺漏或雜亂,調整欄位後再抓一次即可。
就這樣,你已經完成了一次網站抓取,而且沒寫過任何一行程式碼。
至於疑難排解:如果卡住(資料抓不全、或碰到要登入的頁面),可以試著在雲端模式和瀏覽器模式之間切換,或確認一下網站版型是不是改過。真的動不了,Thunderbit 的 文件 和支援團隊都幫得上忙。
新手該懂的倫理與法律界線
在你開始到處抓網站之前,先把規矩講清楚。針對公開資料做網頁爬蟲,多數情況下是合法的,但有幾條線一定要守:
-
先看 robots.txt 與服務條款: 大約 60% 的網站 明文禁止未經授權的抓取。務必檢查網站的 robots.txt 檔案(在網址後加上
/robots.txt就能看到),並讀一遍服務條款。若禁止抓取,就改找官方 API,或事先徵得同意。 -
不碰個資與敏感資料: 除非資訊本身明確公開、你也有正當用途,否則別去蒐集個人資料(信箱、電話等)。GDPR、CCPA 這些隱私法規,可不是拿來嚇人的。
-
不轉載受版權保護的內容: 用爬蟲做分析或內部參考沒問題,但別未經許可就把別人的文章、圖片原封搬走。
-
抓得客氣一點: 別用海量請求把網站打垮。可行的話,加點延遲,挑流量較低的時段抓。
-
好好保管資料: 蒐集到的若是敏感的商業資訊,就要安全存放,別隨手公開。
倫理爬蟲檢查清單:
- 檢查 robots.txt 與 ToS
- 避免個人/私人資料
- 不重新發布受版權保護的內容
- 控制請求頻率
- 需要時使用 API
- 保護資料安全
守住這幾條,你就站在合法範圍內,也讓整個網路環境對大家都友善一些 (Initial Data Offering)。
適合新手的節奏:先小後大,一步步長起來
給新手最要緊的一句話:從小而能完成的專案起步,再往上加難度。順序可以這樣安排:
-
先抓單一頁面: 拿一個產品列表或聯絡人清單練手,先摸熟工具和資料長什麼樣。
-
處理分頁: 有把握之後,再把整份清單的所有頁面都抓下來(「下一頁」按鈕交給 Thunderbit)。
-
抓取子頁面: 進一步擷取連結頁的細節,例如產品詳情或業務、房仲的介紹。
-
換不同資料類型試試: 文字、圖片,甚至 PDF 都可以試,Thunderbit 都吃得下 (Thunderbit Docs)。
-
用排程自動化: 準備好了,就設定定時抓取,讓資料自己保持更新。
每一次小小的成功,都在替你累積實力和信心。抓下第一份 100 列的資料,就值得停下來記一筆——這是很不錯的里程碑。
把抓下來的資料整理乾淨
乾淨的資料,才是真正拿得動的資料。幾個做法能讓你的結果更整齊、更好直接使用:
-
欄位名稱統一: 盡量用清楚一致的欄位名稱,例如「價格」或「電子郵件」。Thunderbit 的 AI 建議功能能幫你更省力做到這件事。
-
格式一致: 讓數字、日期、文字在整份資料裡維持同一種格式。Thunderbit 在抓的當下就能協助格式化,甚至順手翻譯 (Thunderbit)。
-
檢查重複: 用 Excel 或 Google Sheets 把重複的列移掉。
-
邊抓邊驗: 抓取過程中和結束後都抽查一下,錯誤才能及早抓出來。
-
替資料留紀錄: 記下來源、日期,以及你做過哪些轉換。日後你和團隊都能很快搞清楚這份資料的來龍去脈。
一份整理妥當的試算表,代表你可以直接進到分析或分享的階段,不必再耗一大段時間去清理。
進階規模:什麼時候、怎麼接更複雜的任務
基礎踩穩之後,你大概會想挑戰更大型的專案。以下幫你判斷是不是時候到了,以及怎麼放大規模又不會手忙腳亂:
準備好的訊號:
- 你已經順利完成幾次抓取,想再做更多。
- 你需要定期監控資料,例如每天盯一次價格。
- 你要抓的網站頁數很多、或版面很複雜。
放大規模的做法:
- 改用雲端抓取: Thunderbit 的雲端模式一次可抓最多 50 頁,很適合大型任務 (Thunderbit Blog)。
- 設定定期抓取: 把重複的任務自動化,讓資料主動送上門。
- 應付登入與動態內容: 遇到要驗證或版面較複雜的網站,就切成瀏覽器模式。
- 持續監控、隨時微調: 定期檢查結果,網站一有變動就趕快修設定。
放大規模的訣竅,就是在穩固的基礎上,一步一步往前推。
重點回顧:新手網頁爬蟲最佳實踐
把幾個要點收攏一下:
- 從簡單開始: 先定目標,從單一頁面下手,確認方法對了再往下做。
- 善用新手友善的工具: Thunderbit 讓抓取又快又準又好上手,全程不用寫程式。
- 避開常見錯誤: 事先規劃、保持資料乾淨、尊重網站規則。
- 把資料整理好: 欄位名稱清楚、格式統一,處理流程也記下來。
- 聰明放大規模: 隨著愈來愈熟練,再逐步加上自動化、排程與監控。
網頁爬蟲早就不是技術人員的專利。方法對、工具選得好,任誰都能運用網路上的公開資料,替自己的事業做出更快、更好的決策。
想試試看嗎?下載 Thunderbit,今天就開始你的第一個專案。想看更多技巧、教學或靈感,也歡迎逛逛 Thunderbit 部落格。
免費試用 AI 網頁爬蟲 Get Started Free
常見問題
1. 新手做網頁爬蟲合法嗎?
一般來說,抓取公開資料是合法的,前提是你遵守各網站的 robots.txt、服務條款與隱私法規。避開個人資料和受版權保護的內容,只要有官方 API 就優先用 API (Initial Data Offering)。
2. 開始網頁爬蟲需要會寫程式嗎?
不用。像 Thunderbit 這類工具本來就是為非技術使用者設計的,點幾下就能完成抓取,不需要任何程式基礎。
3. 新手最常犯哪些錯?
最常見的是沒定目標、一次抓太多、漏掉分頁或子頁面、資料雜亂,還有無視網站規則。從小專案起步、搭配新手友善的工具,就能避開這些坑。
4. 怎麼讓抓下來的資料保持整齊乾淨?
用一致的欄位名稱、統一格式、檢查重複,並在抓取過程中持續驗證。Thunderbit 的 AI 能協助標記、格式化,還能把資料匯出到 Excel 或 Google Sheets。
5. 愈來愈熟練後,該怎麼擴大專案規模?
上手之後,可以善用 Thunderbit 的雲端抓取、子頁面擷取與排程功能,接更大、更複雜的任務。同時也別忘了持續監控結果、視需要調整。
延伸閱讀



