
網路早就不只是拿來看貓咪影片和迷因的地方了——它是全球最大、最雜亂、也最有價值的資料來源。現在,企業正陷在一場資料競賽裡:零售商每天追蹤競爭對手的價格,而越來越多數據驅動團隊,會直接用瀏覽器擴充功能,不再把工單丟給工程團隊。無論你是在業務、行銷、電商還是營運領域,能不能又快又準地拿到正確格式的資料,往往就是拉開差距的關鍵。
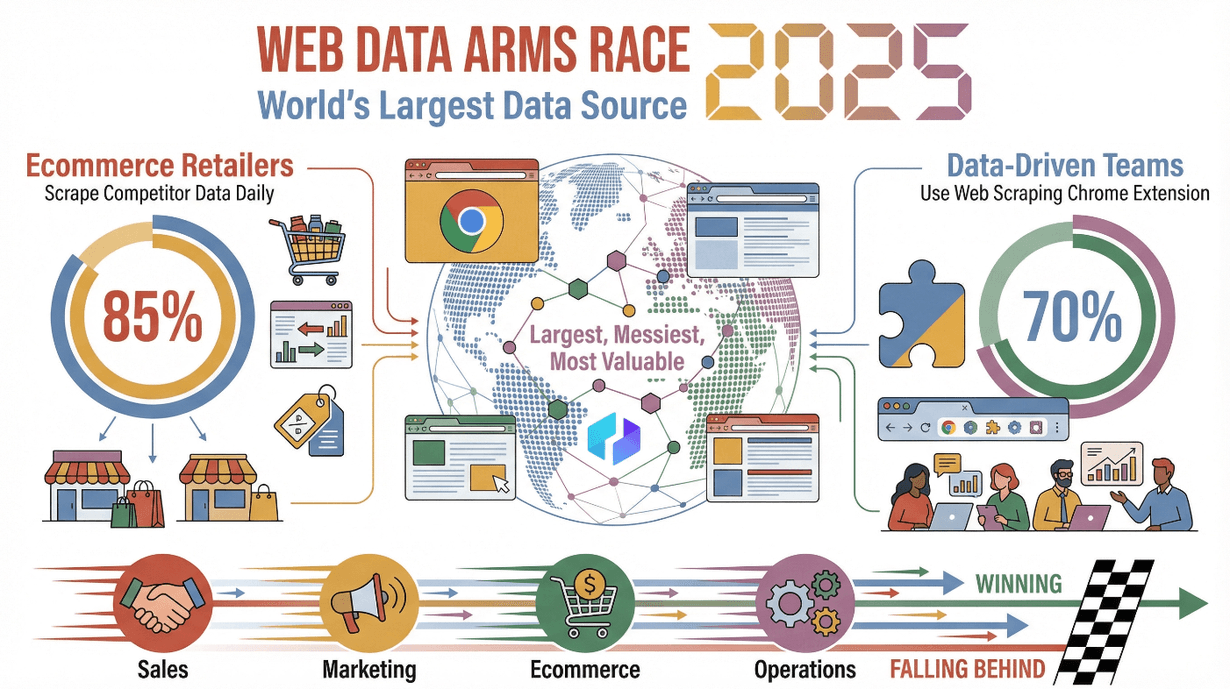
但問題是:網站可不會乖乖鋪紅毯,讓你輕鬆抓資料。它們通常又亂又動態,設計是給人看的,不是給試算表用的。這時候,網頁爬蟲工具就很有用,能把雜亂資訊整理成乾淨、結構化的表格,讓你真的能拿來分析和運用。我在 SaaS 和自動化領域待了很多年,親眼看過選對工具如何省下大量時間、提升準確度,甚至挖出那些原本就在眼前、卻沒人注意到的洞察。
那麼,2025 年到底哪些網頁爬蟲工具真的值得你花時間?我整理了 9 款最值得關注的工具——從給商務使用者的 AI Chrome 擴充功能,到給開發者的開源框架,帶你一次看懂。
為什麼網頁爬蟲工具對現代企業這麼重要
使用 AI 從任何網站抓取資料 Get Started Free
網頁爬蟲工具是更聰明的銷售、更精準的行銷,以及更靈活營運背後的重要武器。它們之所以重要,原因如下:
- 開發潛在客戶: 銷售團隊會抓取名錄、LinkedIn 和評論網站,建立精準的潛在客戶名單。
- 競品分析: 行銷與電商團隊會即時或近即時監控競爭對手的價格、產品上新與廣告投放。
- 市場研究: 研究人員與分析師會彙整評論、新聞與使用者情緒,搶先看出市場趨勢。
- 價格監控: 零售商與品牌會追蹤數百個網站上的價格與庫存,保持競爭力(Kanhasoft)。
- 內容彙整: 營運團隊會從求職網站、房地產列表或供應商型錄抓取資料,簡化工作流程。
以下快速看看網頁爬蟲工具如何推動商業成果:
| 商業應用場景 | 人工處理痛點 | 網頁爬蟲解決方案 |
|---|---|---|
| 開發潛在客戶 | 從數十個網站複製貼上 | 自動擷取、大量匯出 |
| 價格監控 | 每天手動檢查 | 排程爬取、即時提醒 |
| 市場研究 | 閱讀數百則評論 | 彙整後的結構化資料集 |
| 內容彙整 | 整合多個網站的資料 | 一鍵匯出至 Excel/Sheets |
| 競品分析 | 資料慢、不完整 | 即時且全面的洞察 |
投資報酬率非常真實:採用現代爬蟲工具的團隊,往往能把研究與資料蒐集從幾天壓縮到幾小時,而銷售團隊也常常會運用爬下來的資料,讓提案更貼近客戶需求。
我們如何挑選最佳網頁爬蟲工具
不是每一款網頁爬蟲工具都一樣。有些是為想零程式碼就拿到結果的商務使用者設計,有些則是給開發者用來打造客製化、大規模專案的工具。以下是我在挑選最佳工具時特別重視的條件:
- 易用性: 非工程背景的人能不能很快上手?介面是否直覺?
- 擴充性: 能不能處理數百頁,甚至數百萬頁?能不能自動化與排程?
- 資料匯出選項: 能不能匯出到 Excel、Google Sheets、Airtable、Notion,或透過 API?
- 支援與社群: 文件、教學和客服回應是否完善?
- 價格與價值: 是否有免費方案?付費方案是否透明又合理?
- 獨特功能: 是否支援 AI 擷取、子頁面爬取、API 整合或視覺化流程?
我也把每款工具對應到最適合的商業情境,讓你能依照需求與技術程度快速找到合適選擇。
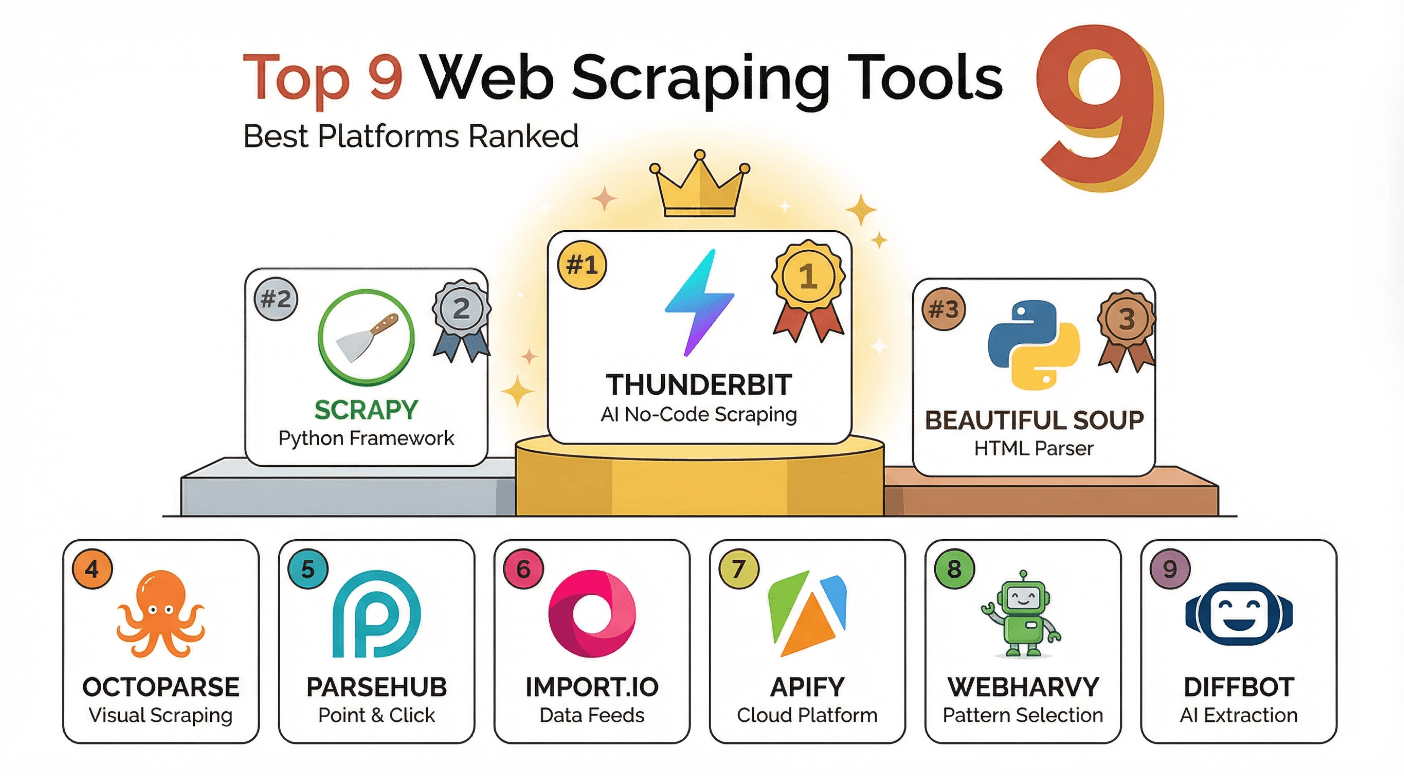
1. Thunderbit
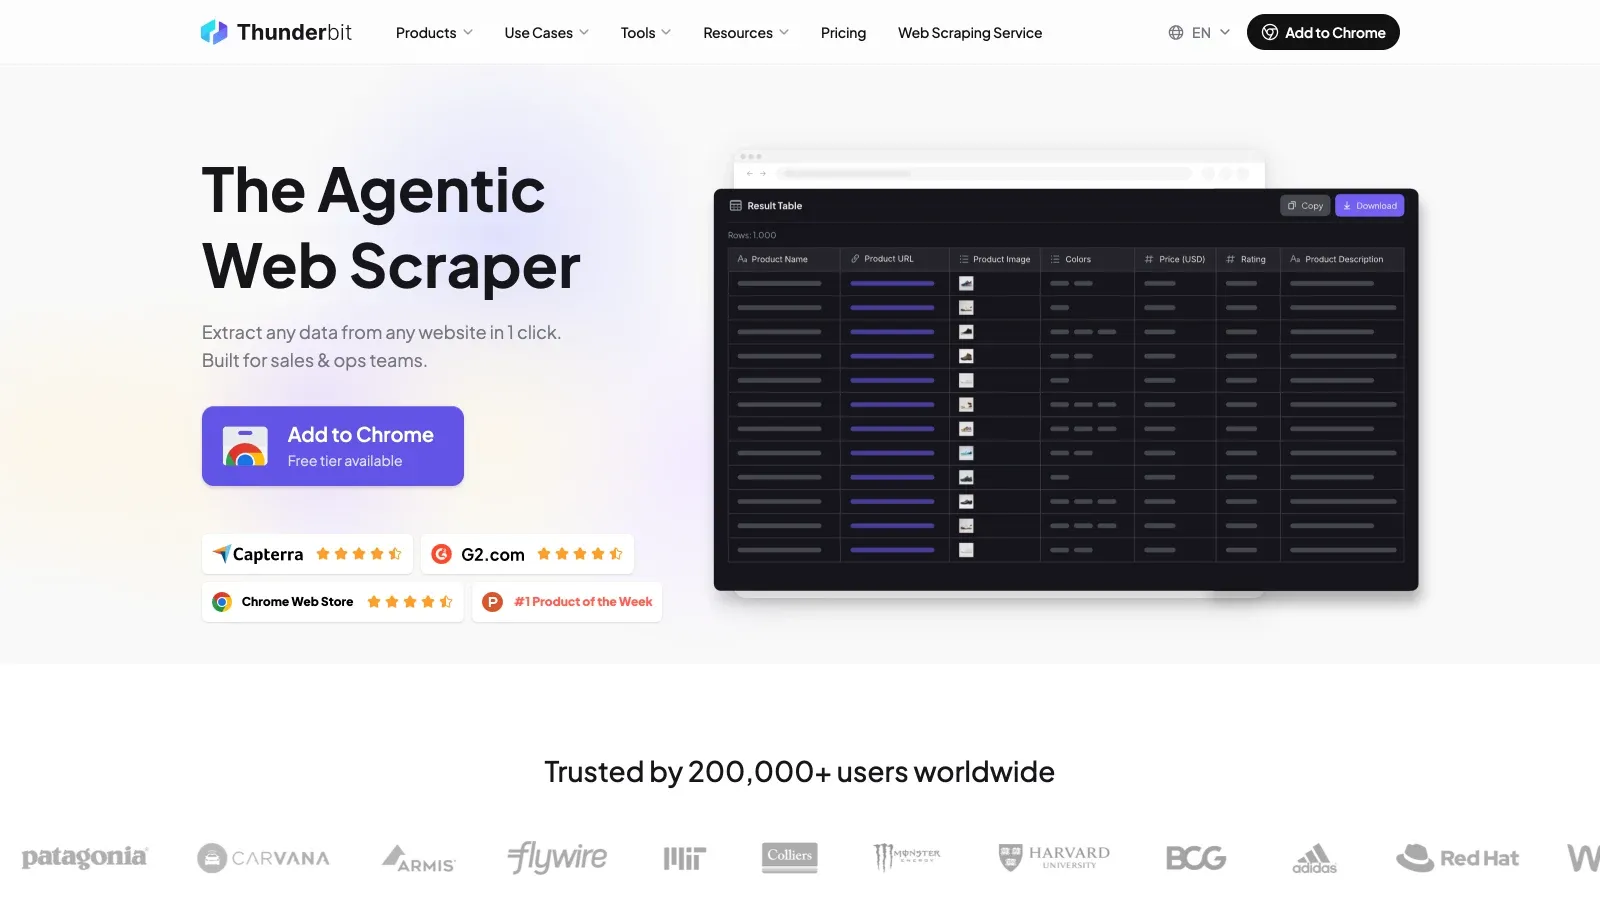
Thunderbit 是我最推薦給商務使用者的工具,因為它能在沒有技術負擔的情況下,提供 AI 驅動的網頁爬取體驗。作為一款 Chrome 擴充功能,Thunderbit 專為銷售、行銷、電商與營運團隊打造,幫助你快速取得準確、結構化的資料。
Thunderbit 的亮點在哪?關鍵就是簡單又強大:
- AI 智能欄位建議: 點一下「AI Suggest Fields」,Thunderbit 會讀取頁面、推薦欄位(例如姓名、價格、Email),甚至自動為每個欄位生成擷取提示詞。
- 子頁面爬取: 需要更完整的資訊嗎?Thunderbit 的 AI 可以逐一造訪每個子頁面(例如產品頁或個人資料頁),自動補充表格內容,完全不用額外設定。
- 即時匯出: 可直接將資料傳送到 Excel、Google Sheets、Airtable 或 Notion,匯出功能永久免費。
- 排程爬取: 透過自然語言設定排程,自動執行重複任務,例如每日價格檢查。
- 免費 Email、電話與圖片提取器: 一鍵從任何網站擷取聯絡資訊或圖片。
- AI 自動填表: 讓 AI 幫你填寫線上表單,非常適合工作流程與重複性任務。
Thunderbit 受到全球超過 200,000 位使用者 信賴,且 免費方案 每月可抓取最多 6 頁。付費方案則從每月 15 美元、500 點數起跳,非常適合各種規模的團隊。
如果你想實際看看 Thunderbit 怎麼運作,可以前往我們的 YouTube 頻道,或直接閱讀我們的 部落格,裡面有許多教學與實用技巧。
2. Scrapy
Scrapy 是開發者最常選用的開源框架,適合想完全掌控網頁爬取專案的人。它以 Python 撰寫,讓你能打造客製化 spider,大規模地抓取、擷取並處理資料。
開發者為什麼喜歡 Scrapy?
- 功能強大的框架: 支援複雜的多層爬取、自訂資料處理流程,以及 API 整合。
- 高擴充性: 可處理大型專案、並行請求,還能同時抓取大量頁面(ZenRows)。
- 延展性高: 可加入代理伺服器、User Agent 或 JavaScript 渲染等 middleware(搭配 Splash)。
- 活躍社群: 擁有大量教學、外掛與進階應用支援。
Scrapy 最適合具備 Python 技能、需要大規模抓取、串接資料流程或打造穩定可重複工作流程的團隊。它是免費開源工具,但你需要自行建置環境並維護程式碼。
3. Beautiful Soup
Beautiful Soup 是許多初學者喜愛的 Python 函式庫,因為它在解析 HTML 與 XML 時,兼具簡單與強大。如果你需要快速從靜態網頁中擷取資料,Beautiful Soup 會是很好的選擇。
為什麼選 Beautiful Soup?
- 對新手友善: 容易學習,上手門檻低,而且有很多教學資源(ScraperAPI)。
- 解析彈性高: 對雜亂或破損的 HTML 也能處理得很好。
- 適合小型專案: 很適合一次性腳本、快速抓資料,或作為學習網頁爬取基礎的起點。
限制呢?Beautiful Soup 並不是為大規模或動態網站設計的,也不支援 JavaScript。若有這類需求,通常會搭配 requests 或 Selenium 使用,或直接升級到 Scrapy。
4. Octoparse
Octoparse 是一款無程式碼網頁爬蟲工具,適合從獨立創業者到企業團隊等各類使用者。它的點選式介面,即使面對複雜或動態網站,也能輕鬆擷取資料。
Octoparse 受歡迎的原因:
- 不需要寫程式: 視覺化流程建立器、拖放式選取器,以及預建範本。
- 雲端與本機模式: 可在桌面執行,也能在雲端跑爬蟲,速度更快、規模更大。
- 支援分頁與動態內容: 可抓取「載入更多」頁面、無限捲動與 AJAX 網站。
- 匯出選項豐富: 可下載為 CSV、Excel、JSON、HTML,或匯出到資料庫(Octoparse Pricing)。
Octoparse 的免費方案適合小型任務,付費方案則約從每月 69 美元起,能支援更重度的使用需求。它深受市場研究、競品分析,以及想要不用寫程式就拿到結果的人歡迎。
5. ParseHub
ParseHub 是一款視覺化爬取工具,特別擅長處理大量 JavaScript 與動態內容的網站。它的流程建立器讓你可以透過點選、迴圈與條件式擷取,即使是棘手網站也能搞定。
ParseHub 的亮點包括:
- 視覺化資料選取: 透過點選元素來選取資料、遍歷清單,並處理巢狀頁面。
- 支援動態內容: 可抓取由 JavaScript 載入的資料、處理下拉選單,並自動執行點擊操作。
- 匯出彈性高: 可下載為 CSV、Excel、JSON,或整合 Dropbox/Amazon S3(Salesforge)。
- 免費方案: 每個專案最多 5 個、每次執行最多 200 頁;付費方案則提供更高能力。
ParseHub 很適合想要高度彈性、又不想深入寫程式的中階使用者,尤其常見於電商、求職網站與房地產資料抓取。
6. Import.io
Import.io 是為企業級資料擷取與視覺化打造的平台。它著重在大型專案,提供直覺式介面、穩定的支援與進階分析能力。
Import.io 的特色在哪?
- 點選式擷取: 不需要寫程式,只要選取你要的資料即可。
- 資料視覺化: 內建工具可分析、繪圖並分享結果。
- 企業功能: 包含合規支援、代管服務與高流量處理能力。
- 匯出與整合: 可下載為 CSV、Excel,或與 Google Sheets 及 BI 工具串接(Salesforge)。
它的價格採企業客製方案,適合資料需求龐大且預算充足的組織。
7. Apify

Apify 是一個可擴充的網頁自動化與客製化資料擷取平台。對開發者來說,它非常適合建立、執行與分享爬取用的「actors」(預建或自訂腳本)。
Apify 為何名列前茅:
- Actors 市集: 可直接使用 200+ 個常見網站的預建爬蟲,或用 JavaScript/Python 自行打造。
- API 優先: 可將爬取資料直接整合進工作流程或應用程式。
- 雲端部署: 支援大規模執行、排程重複任務,並可在儀表板集中管理(Apify Pricing)。
- 彈性計價: 小型任務有免費方案,大型專案則可依使用量付費。
Apify 非常適合具備技術能力、想把網頁資料自動化、規模化並整合進商業流程的團隊。
8. WebHarvy
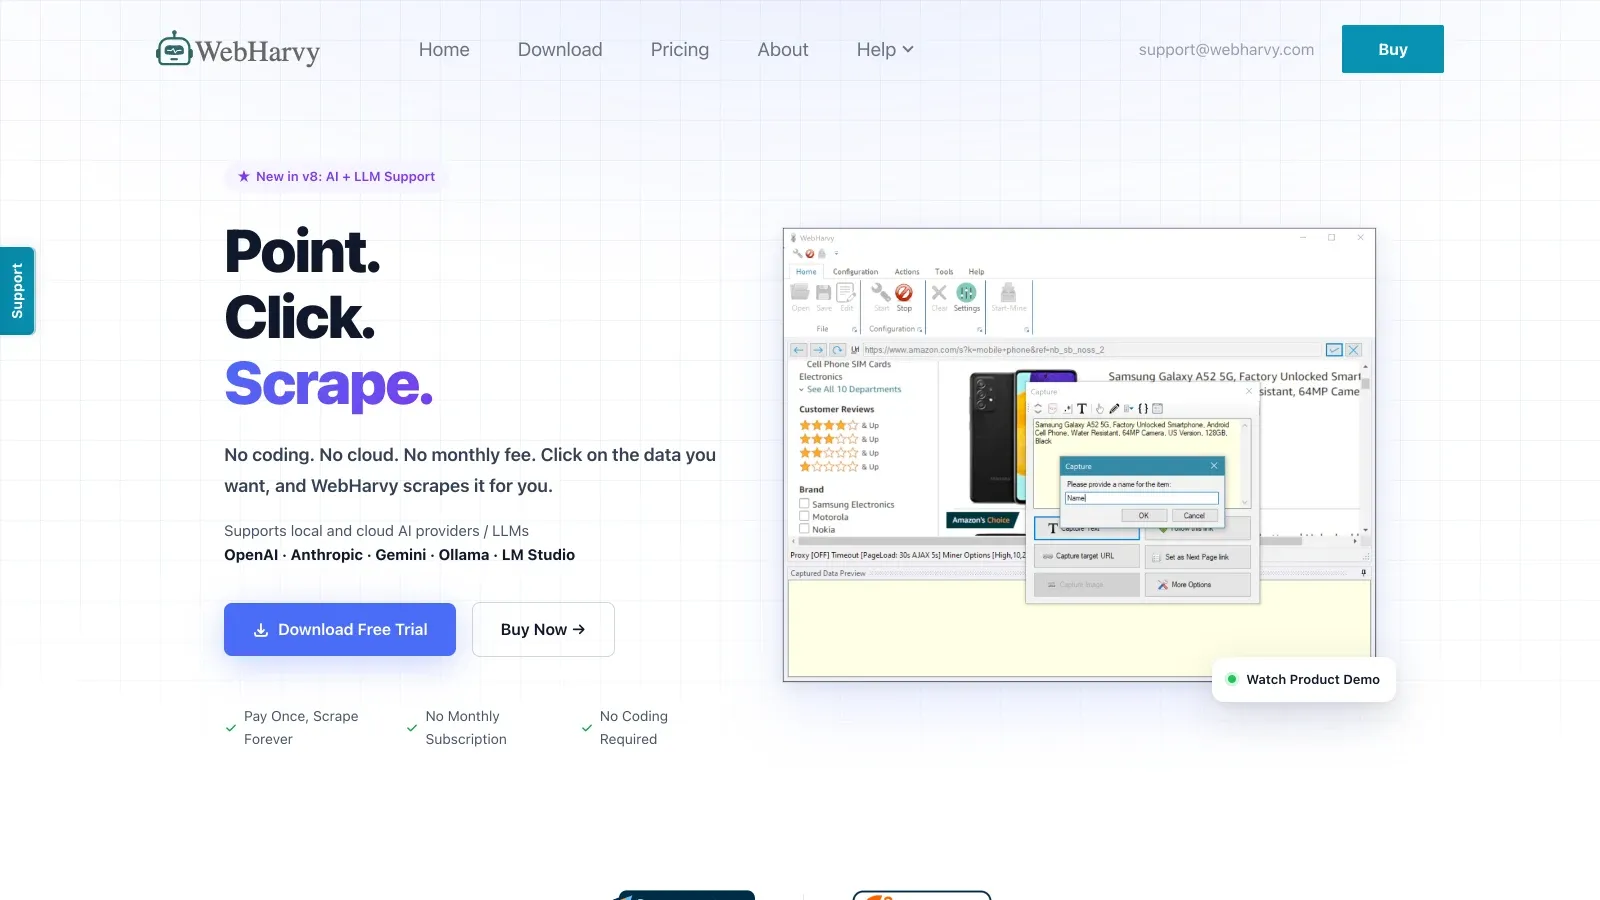
WebHarvy 是一款點選式網頁爬蟲工具,能自動辨識網頁上的資料模式。它特別適合不想學 XPath 或 CSS selector、但又想拿到結果的非工程使用者。
WebHarvy 的關鍵功能:
- 自動模式辨識: 點選某個資料欄位後,WebHarvy 會自動找出相似元素供你擷取(Thunderbit Blog)。
- 支援 AJAX/JavaScript: 可處理動態內容、圖片抓取與關鍵字式擷取。
- 匯出選項: 可下載為 Excel、CSV、XML、JSON 或 SQL。
- 一次性授權: 付一次費用即可永久使用(含一年更新與支援)。
WebHarvy 很受中小企業、研究人員與個人創業者歡迎,尤其適合偏好視覺化操作、又不需要進階自動化的人。
9. Diffbot
Diffbot 是網頁資料擷取領域的 AI 強者。它運用機器學習與電腦視覺,能把任何公開網頁轉換成結構化資料,幾乎不需要手動設定。
Diffbot 的獨特之處:
- AI 驅動擷取: 能自動辨識並擷取網頁中的實體、關係與事實(VentureBeat)。
- 知識圖譜: 可存取一個龐大且持續更新的人物、公司、產品等資料庫。
- API 存取: 能將結構化資料整合到你的應用、研究或分析流程中(Diffbot Docs)。
- 企業就緒: 微軟、Adobe、Hubspot 等大型企業都在使用。
其價格從每月 299 美元的 Startup 方案起跳,API 另有按次計費選項(Diffbot Pricing)。它最適合研究、企業資料科學,以及任何需要大規模 AI 級準確度的人。
網頁爬蟲工具比較表
以下是這 9 款工具的並列比較:
| 工具 | 最適合 | 無程式碼 | AI 驅動 | API/開發者友善 | 支援子頁面爬取 | 匯出選項 | 起始價格 |
|---|---|---|---|---|---|---|---|
| Thunderbit | 商務使用者 | 是 | 是 | 否 | 是 | Excel、CSV、Sheets、Notion、Airtable | 免費(6 頁),$15/月 |
| Scrapy | 開發者 | 否 | 否 | 是 | 是(自訂) | CSV、JSON、XML、資料庫 | 免費,開源 |
| Beautiful Soup | 初學者、開發者 | 否 | 否 | 是 | 否 | 自訂(透過 Python) | 免費,開源 |
| Octoparse | 非工程使用者、團隊 | 是 | 否 | 部分支援 | 是 | CSV、Excel、JSON、資料庫 | 免費,$69/月 |
| ParseHub | 視覺化、動態網站使用者 | 是 | 否 | 部分支援 | 是 | CSV、Excel、JSON、S3、Dropbox | 免費,$189/月 |
| Import.io | 企業、分析團隊 | 是 | 否 | 是 | 是 | CSV、Excel、Sheets、BI 工具 | 客製,企業方案 |
| Apify | 開發者、自動化 | 否 | 否 | 是 | 是 | CSV、JSON、Sheets、API | 免費,按使用量付費 |
| WebHarvy | 非工程使用者、中小企業 | 是 | 否 | 否 | 是 | Excel、CSV、XML、JSON、SQL | $129(一次性) |
| Diffbot | AI、研究、企業 | 否 | 是 | 是 | 是(AI 爬取) | JSON、Knowledge Graph API | $299/月 |
如何根據需求選擇合適的網頁爬蟲工具
2025 年最佳網頁爬蟲工具與軟體 Get Started Free
那麼,你到底該選哪一款?這裡是我的快速建議:
- 給非工程/商務使用者: Thunderbit、Octoparse、ParseHub、WebHarvy
- 給開發者/自動化需求: Scrapy、Beautiful Soup、Apify
- 給企業級/AI 需求: Import.io、Diffbot
- 給動態或 JavaScript 較重的網站: ParseHub、Octoparse、Apify
- 需要即時、結構化匯出: Thunderbit、Import.io
我的建議是:先從你的商業目標與技術熟悉度出發。如果你想要 AI 驅動、操作省事、又能即時匯出, Thunderbit 幾乎很難被超越。如果你需要完全控制,或想打造自訂爬蟲,Scrapy 或 Apify 都非常出色。若是企業級規模或 AI 驅動的資料需求,Import.io 和 Diffbot 則是重量級選手。
多數工具都提供免費試用或免費方案,所以不妨多試幾款,看看哪個最符合你的工作流程。
常見問題
1. 什麼是網頁爬蟲工具?為什麼我需要它?
網頁爬蟲工具是一種能從網站擷取資料,並將其轉換成試算表或資料庫等結構化格式的軟體。企業會用它來開發潛在客戶、監控價格、市場研究等;相較於手動複製貼上,它能大幅節省時間並提升準確度。
2. 網頁爬取是否合法?
只要你擷取的是公開可取得的資料,並遵守網站服務條款,網頁爬取通常是合法的。務必避免在未經同意下抓取個資或敏感資訊,也要確認當地法規。
3. 哪一款網頁爬蟲工具最適合非工程背景的人?
Thunderbit、Octoparse、ParseHub 和 WebHarvy 都很適合非技術使用者。Thunderbit 的 AI 智能欄位建議,以及可直接匯出到 Excel、Google Sheets、Notion 或 Airtable 的功能,特別突出。
4. 我可以抓取動態或 JavaScript 很重的網站嗎?
可以!像 ParseHub、Octoparse 和 Apify 這類工具,就是為了處理動態內容、AJAX 和「載入更多」頁面而設計。Thunderbit 的 AI 也能適應許多現代網站版型。
5. 我該如何為我的業務選擇合適的網頁爬蟲工具?
請考量你的技術能力、資料量、匯出需求與預算。非工程使用者可先從 Thunderbit 或 Octoparse 入手;開發者可能會偏好 Scrapy 或 Apify;而有大量資料需求的企業,則可考慮 Import.io 或 Diffbot。多數工具都提供免費試用——建議你實際試幾款,看看哪個最適合。
準備好把網路變成你的下一個商業優勢了嗎?下載 Thunderbit 或前往我們的 Thunderbit 部落格 了解更多指南與技巧。祝你抓取順利!
試用 AI 網頁爬蟲 Get Started Free
延伸閱讀



