
Web verileri, işletmeler için yeni petrol gibidir; ama onu yerin altından çıkarmak bambaşka bir iştir. Satış ekiplerinin, e-ticaret operasyonlarının ve pazar araştırmacılarının, her zamankinden daha hızlı içgörü üretme baskısı altında olduğunu yakından görüyorum — eski kopyala-yapıştır yöntemi artık yetmiyor. Gartner’a göre kuruluşların %61’i, yapay zekânın etkisiyle veri ve analitik operasyonlarını baştan düzenlemek zorunda kaldı; iş liderlerinin %80’i ise artık verinin karar alma sürecinde kritik olduğunu söylüyor. Ama işin zor tarafı şu: Çoğu ekip, ihtiyaç duyduğu dış pazar sinyallerini hâlâ toplayamıyor; işte tam bu noktada web scraping devreye giriyor.
Yapay zekâ kullanarak herhangi bir web sitesinden veri çıkarın Get Started Free
Ama dürüst olalım: Her web kazıyıcı aynı değil. ClawdBot gibi araçların yükselişi, veri toplamayı otomatikleştirmek, dağınık web bilgilerini yapılandırmak ve bunları gerçekten sonuç üretmek için kullanmak isteyen iş kullanıcıları için oyunu değiştiriyor. Küçük bir isim notu: ClawdBot, Anthropic ile yaşanan bir marka sorunu nedeniyle 2026 Ocak ayının sonlarında Moltbot olarak yeniden adlandırıldı; açık kaynak yönüne kaymasıyla yaklaşık üç gün sonra, 2026-01-30 tarihinde bir kez daha OpenClaw adını aldı. Bu rehberdeki kurulum komutları ve CLI, mevcut openclaw adını kullanıyor; ancak okuyucuların çoğu onu bu isimle aradığı için metin içinde hâlâ "ClawdBot" diyorum ve alttaki araç aslında aynı araç. ClawdBot’u Thunderbit gibi yapay zekâ destekli yardımcılarla birlikte kullandığınızda, verimlilik ve doğrulukta bambaşka bir seviyeye çıkarsınız.
Gelin, ClawdBot Web Scraping’i bu kadar güçlü yapan şeyin ne olduğuna, nasıl başlayacağınıza ve bunu iş başarısı için Thunderbit ile nasıl birleştirebileceğinize bakalım.
ClawdBot Web Scraping nedir? Daha akıllı iş verilerine açılan kapınız
ClawdBot, özünde geliştirici olmanızı gerektirmeden web görevlerini otomatikleştirebilen, bilgi çekebilen ve veriyi yapılandırabilen kişisel bir yapay zekâ ajanı platformudur. Bunu, tarayıcınızda çalışabilen, Chrome sekmelerini kontrol edebilen ve scraping görevlerini kendi kendine çalışacak şekilde planlayabilen dijital bir araştırma asistanı gibi düşünebilirsiniz.
Temel Yetenekler:
- Otomatik Veri Çıkarma: ClawdBot’un “web_fetch” aracı, statik web sayfalarındaki içerikleri çekip okunabilir, yapılandırılmış metne veya markdown’a dönüştürebilir. Daha etkileşimli veya dinamik sitelerde ise “browser” aracı gerçekten bir Chrome sekmesini kontrol edebilir, düğmelere tıklayabilir, formları doldurabilir ve hatta ekran görüntüsü alabilir.
- Yapılandırılmış ve Yapılandırılmamış Verileri İşler: İster düzenli bir ürün tablosu ister karmaşık bir blog yazısı olsun, ClawdBot veriyi sizin için çıkarabilir, temizleyebilir ve biçimlendirebilir.
- Kullanıcı Dostu Arayüz: Paneli ve Chrome uzantısı sayesinde scraping projeleri kurabilir, bunları istediğiniz aralıkta çalışacak şekilde planlayabilir ve sonuçları doğrudan Slack, Telegram veya e-postaya iletebilirsiniz.
ClawdBot’u Öne Çıkaran Şeyler:
- Kodlama veya katı şablonlar gerektiren geleneksel kazıyıcıların aksine, ClawdBot sohbet tabanlı ve ajan odaklıdır. Ne istediğinizi sade İngilizceyle söylersiniz; adımları o çözer.
- Chrome uzantısı, gerçek tarayıcı sekmelerinizi kontrol etmenizi sağlar; bu da oturum açma gerektiren veya manuel gezinme isteyen siteleri kazımayı kolaylaştırır.
- Yerleşik zamanlama (cron jobs), tekrar eden kazımaları otomatikleştirmenize olanak verir — fiyat takibi, potansiyel müşteri güncellemeleri veya günlük raporlar için idealdir.
Kullanıcı Geri Bildirimi:
- MacStories ve Tom’s Hardware, ClawdBot’un yalnızca veri çekmekle kalmayıp “gerçek bir asistan gibi iş yapabilme” yeteneğini özellikle vurguluyor.
- Topluluk kullanıcıları, esnekliğini ve “çağırdığınızda yanınızda bir junior analist varmış gibi hissettirmesini” övüyor.
ClawdBot Web Scraping neden iş ekipleri için olmazsa olmaz?
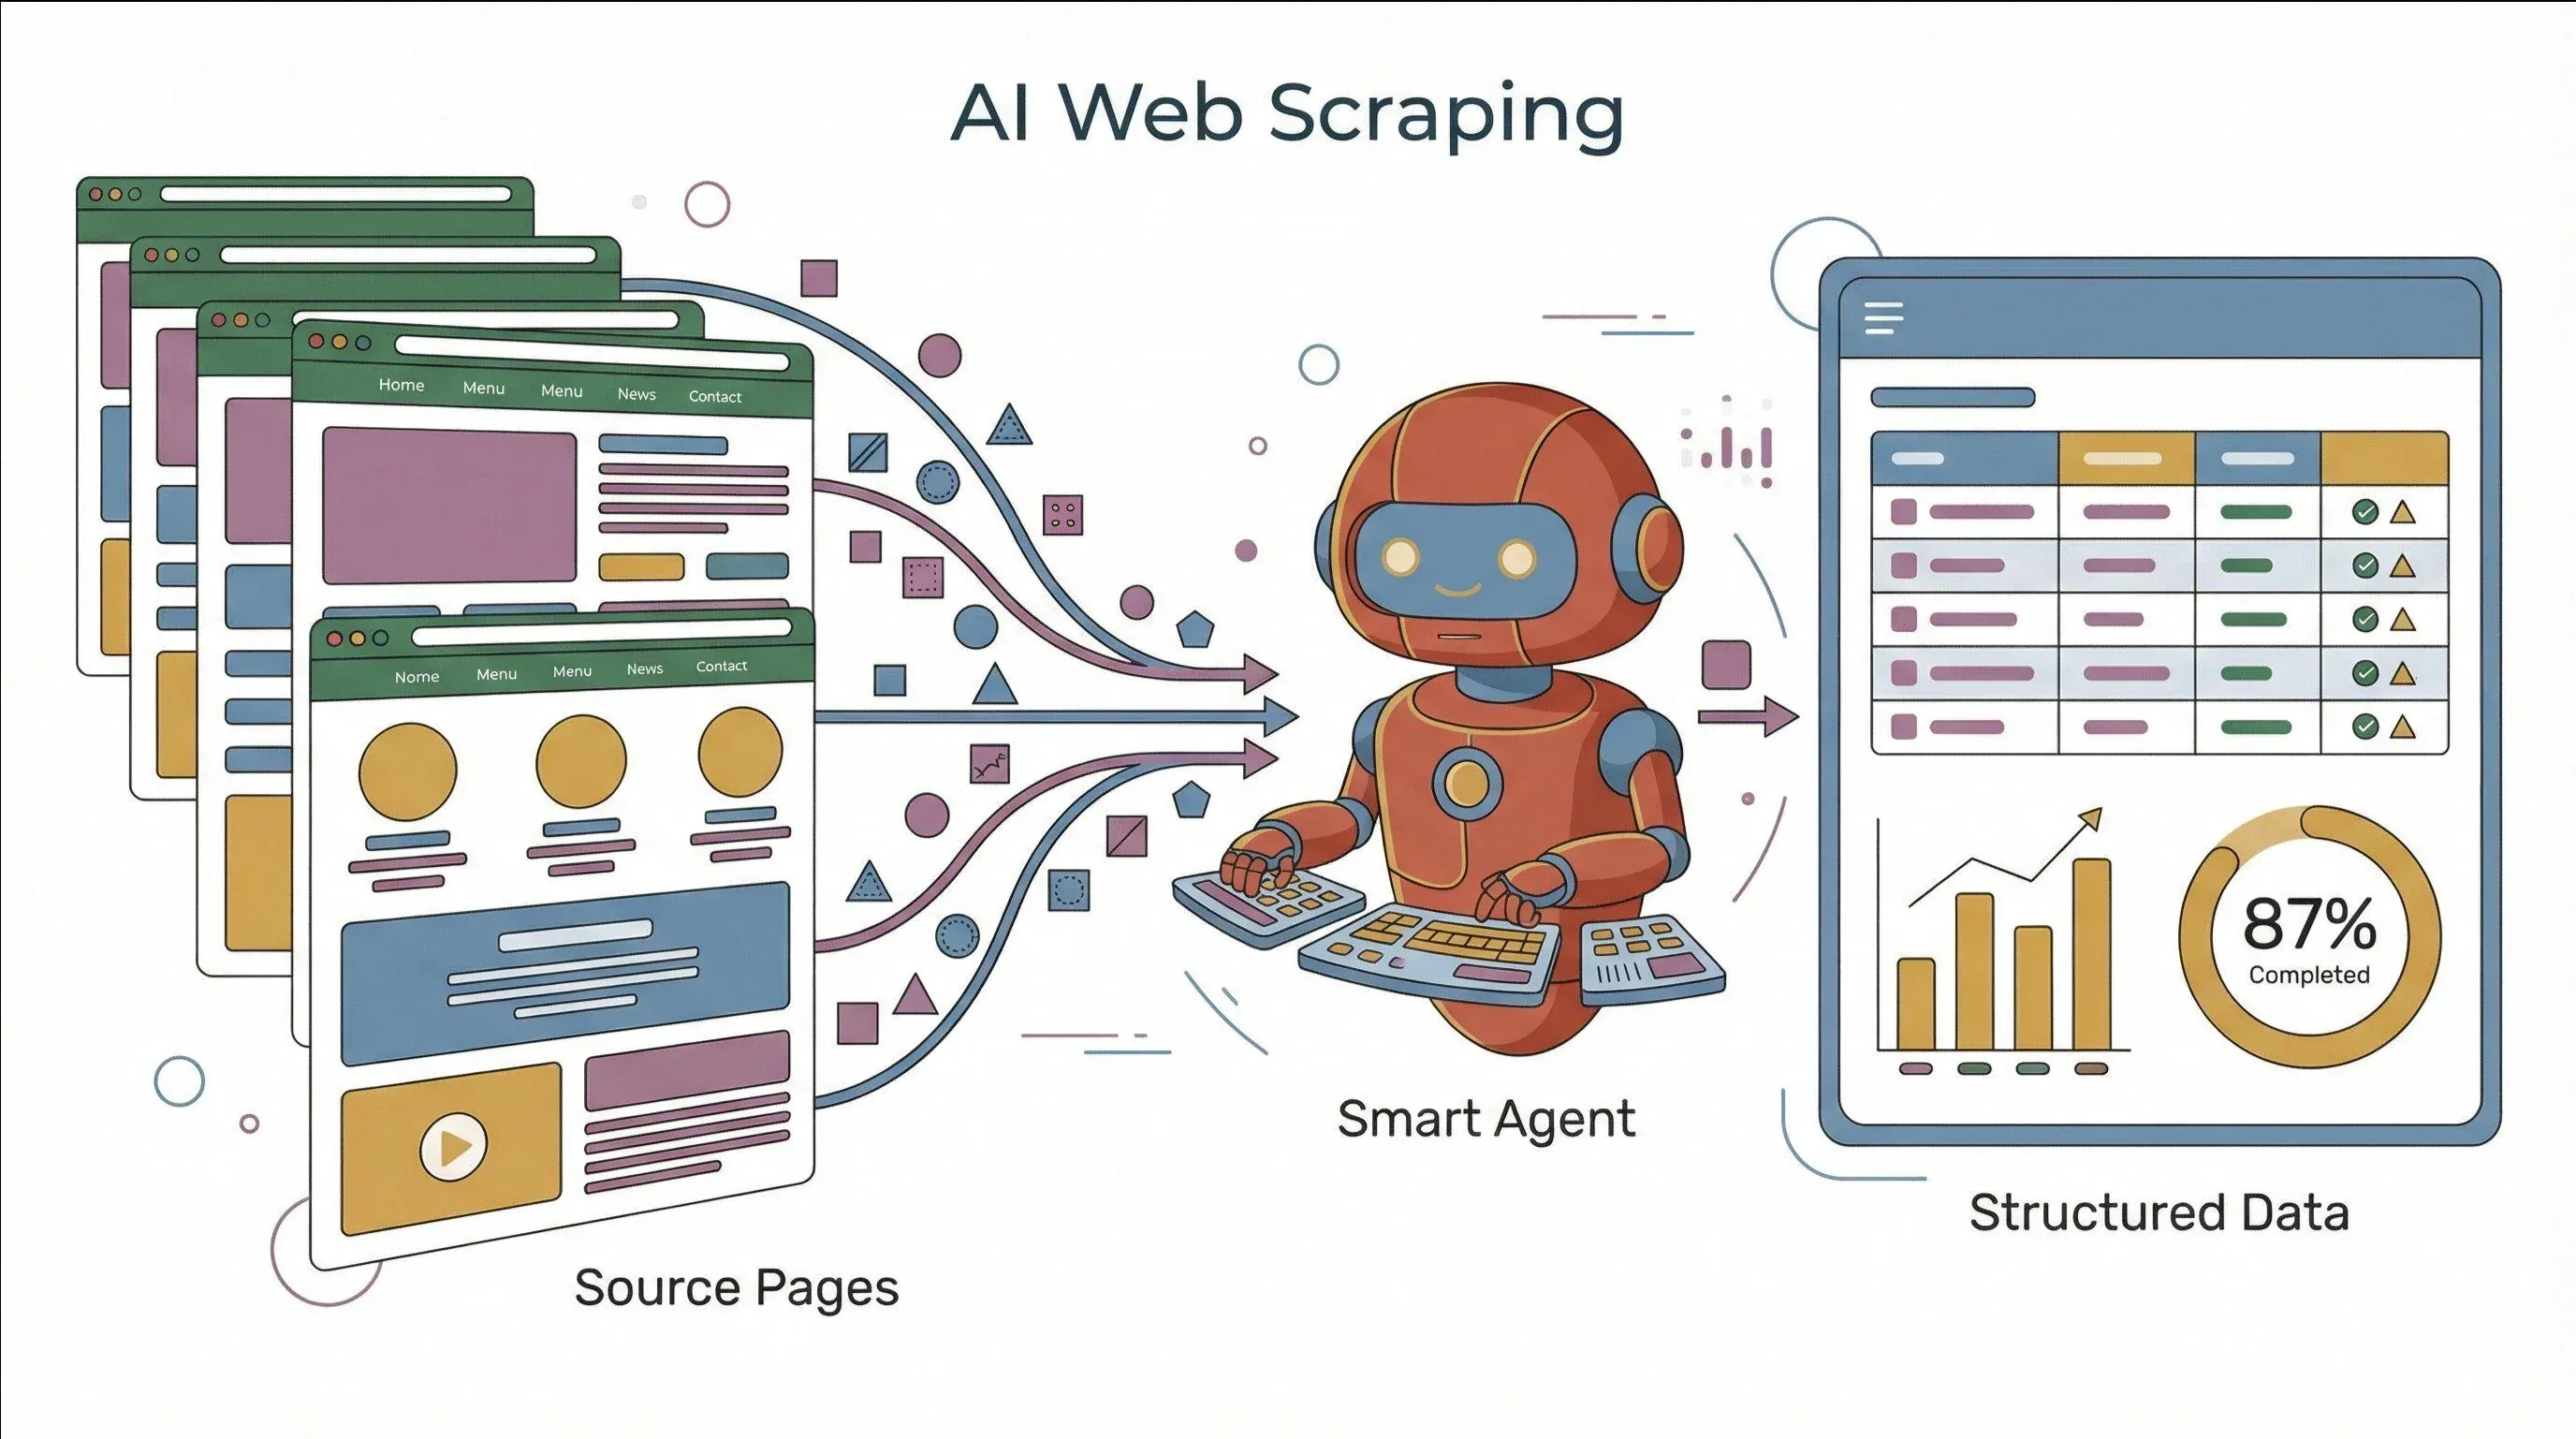 Konuyu netleştirelim: web scraping artık sadece veri meraklılarına özel değil. İleride kalmak isteyen her işletme için olmazsa olmaz. ClawdBot’u ustalaşmaya değer kılan nedenler şunlar:
İş Kullanıcıları için Temel Özellikler
- Otomasyon: Ayarlayın ve unutun — ClawdBot scraping görevlerini planlı şekilde çalıştırabilir, böylece veriniz her zaman güncel kalır.
- Veri Yapılandırma: Thunderbit ile tanımlayabileceğiniz veya oluşturabileceğiniz alan şemalarını kullanarak, kazıdığınız verinin temiz ve analize hazır olmasını sağlayın.
- Hata Yönetimi: ClawdBot’un izole oturumları ve tarayıcı kontrolleri, bozuk betikler veya oturum çakışmaları gibi yaygın scraping sorunlarını azaltmaya yardımcı olur.
- Entegrasyon: Sonuçlar doğrudan Google Sheets’e, CSV’ye veya ekip sohbet kanallarınıza gönderilebilir.
Gerçek Dünyadan İş Senaryoları
| Kullanım Senaryosu | Tipik Veri Alanları | Güncelleme Sıklığı | İş Değeri | ClawdBot Aracı |
|---|---|---|---|---|
| Satış Potansiyel Müşteri Oluşturma | Şirket, Ad, E-posta, LinkedIn, İş İlanları | Haftalık/Günlük | Yeni potansiyel müşteriler bulun, iletişimi başlatın | web_fetch/browser |
| Rakip Takibi | SKU, Fiyat, Stok, Kampanya, Puanlar | Günlük/Saatlik | Dinamik fiyatlandırma, kampanyaya hızlı tepki | browser/cron |
| Emlak | Adres, Fiyat, Durum, Emlak Danışmanı, Açık Ev | Günlük | Erken temas, değerleme | web_fetch/browser |
| Pazar Araştırması | Başlık, Tarih, Anahtar Kelimeler, Duygu | Günlük | Trendleri yakalayın, risk uyarıları alın | web_fetch/cron |
ROI Kanıtı:
- Mordor Intelligence verilerine göre, web scraping yazılım pazarının %14,2 YBBO ile 2030’a kadar 2 milyar dolara ulaşması bekleniyor.
- Dataforest (2025), web scraping’i dinamik fiyatlandırma, otomatik potansiyel müşteri oluşturma ve risk izleme için bir itici güç olarak öne çıkarıyor.
Kullanıcı Yorumu:
- “ClawdBot, haftalık rakip fiyat kontrollerini otomatikleştirmemize yardımcı oldu — eskiden saatler süren iş artık arka planda çalışıyor ve her sabah Slack’e düşüyor.” (E-ticaret Operasyon Yöneticisi, MacStories aracılığıyla)
Başlarken: ClawdBot Web Scraping’i dakikalar içinde nasıl kurarsınız?
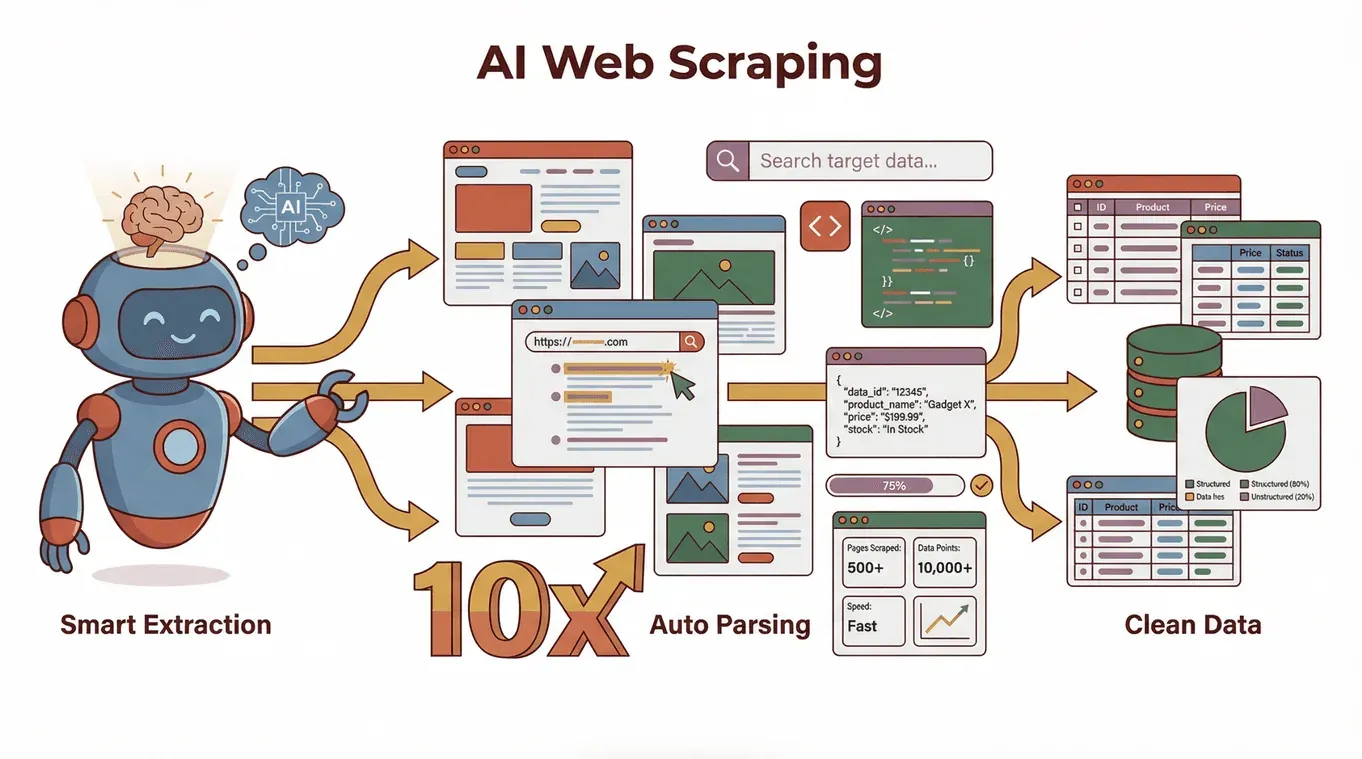 ClawdBot’u çalışır hâle getirmek için kod yazmayı bilmeniz gerekmez. Başlamak için şunları yapın:
Adım 1: ClawdBot’u (Moltbot) yükleyin
-
Mac/Linux:
curl -fsSL https://molt.bot/install.sh | bash -
Windows:
iwr -useb https://molt.bot/install.ps1 | iex
(Windows kullanıcıları için WSL2 önerilir.) -
Node.js v22 veya üzerinin kurulu olduğundan emin olun.
Adım 2: Paneli açın
moltbot dashboardkomutunu çalıştırın veya tarayıcınızdahttp://127.0.0.1:18789/adresini açın.- Başlangıç akışı ilk kurulumu adım adım yönlendirecektir.
Adım 3: Chrome uzantısını bağlayın
- ClawdBot (Moltbot) Chrome uzantısını geliştirici modunda yükleyin.
- Ajanın gezinme oturumunuzu kontrol edebilmesi için uzantıyı aktif Chrome sekmenize bağlayın — oturum açılmış veya etkileşimli siteleri kazımak için mükemmeldir.
Adım 4: Web araçlarını yapılandırın
- Temel scraping için “web_fetch” aracını kullanın (statik sayfalar için idealdir).
- Etkileşimli scraping için “browser” aracını kullanın (tıklama, kaydırma, form doldurma vb. yapabilir).
- Planlı işler için panelde veya CLI üzerinden bir cron görevi oluşturun.
Adım 5: Kazıma sıklığını ve filtreleri ayarlayın
- Görevin ne sıklıkla çalışacağını tanımlayın (ör. her saat, her gün saat 08.00’de).
- Yalnızca ihtiyacınız olan veriyi çıkarmak için içerik filtreleri veya alan şemaları ekleyin.
Adım 6: Çıktı biçimini seçin
- Çıktıyı CSV, Excel veya Google Sheets’e alın.
- Otomatik raporlama için Slack, Telegram veya e-postaya teslimatı ayarlayın.
Sorun Giderme İpuçları:
- Scraping başarısız olursa Node sürümünüzü ve API anahtarlarınızı (Brave, Perplexity vb.) kontrol edin.
- Tarayıcı otomasyonu için uzantının bağlı olduğundan ve izinlerin verildiğinden emin olun.
- Hassas veya yüksek riskli görevlerde izole oturumlar kullanın.
İlk ClawdBot Projenizi Kurma
- Paneli açın ve yeni bir proje oluşturun.
- Hedef URL’lerinizi veya arama anahtar kelimelerinizi girin.
- Uygun aracı seçin (statik için web_fetch, etkileşimli için browser).
- Alan şemanızı tanımlayın (çıkarmak istediğiniz sütunlar).
- Verinin beklendiği gibi gelip gelmediğini görmek için kazımayı önizleyin.
- Kaydedin ve görevi zamanlayın.
Veri Çıktısını İş İhtiyaçlarına Göre Özelleştirme
- Dışa aktarma biçimini seçin: CSV, Excel, Google Sheets veya doğrudan BI araçları.
- Çıktınızı iş raporlama ihtiyaçlarıyla uyumlu hâle getirin — net sütun adları ve veri türleri kullanın.
- Tekrarlayan raporlar için planlı dışa aktarmalar ve otomatik teslimat kurun.
Verimliliği artırın: Thunderbit ile ClawdBot Web Scraping’i birleştirmek
İşin gerçekten ilginçleştiği yer burası. Thunderbit, veri alanlarını tanımlamayı ve kazınan veriyi yapılandırmayı çocuk oyuncağı hâline getiren yapay zekâ destekli bir web kazıyıcı Chrome uzantısıdır.
Thunderbit AI Web Scraper’ı ücretsiz deneyin
Thunderbit ve ClawdBot nasıl birlikte kullanılır:
- Adım 1: Hedef web sitenizde Thunderbit’in “AI Suggest Fields” özelliğini kullanarak önerilen sütunlar ve veri türleri listesini oluşturun.
- Adım 2: Bu şemayı CSV veya Google Sheet olarak dışa aktarın.
- Adım 3: Şemayı ClawdBot’a aktarın; böylece scraping görevleriniz yapılandırılmış ve iş analizi için hazır olur.
- Adım 4: Tekrarlayan kazımaları otomatikleştirmek ve sonuçları ekibinize ulaştırmak için ClawdBot’un cron görevlerini kullanın.
İş Akışı Örneği:
- Thunderbit yapıyı tanımlar (alan adları, türler, çıkarım mantığı).
- ClawdBot otomasyonu çalıştırır (veriyi çeker, görevleri planlar, raporları teslim eder).
İpucu:
ClawdBot’un Chrome uzantısını kullanarak tarayıcınızı kontrol edebilir, bir sayfa açabilir ve Thunderbit’i veriyi kazıma ve dışa aktarma için tetikleyebilirsiniz — böylece kusursuz, kodsuz bir iş akışı oluşturursunuz.
Daha akıllı veri yapılandırması için yapay zekâdan yararlanmak
Thunderbit’in yapay zekâsı yalnızca sütun önermekle kalmaz, ayrıca şunları da yapabilir:
- Veriyi kazırken etiketleme, kategorize etme ve çevirme.
- Alt sayfa kazımayı yönetme (örneğin, daha fazla ayrıntı için her ürün sayfasını ziyaret etme).
- Dışa aktarmadan önce veriyi temizleme ve yinelenenleri silme.
Pratik İpuçları:
- Büyük işleri çalıştırmadan önce alan şemanızı mutlaka önizleyin.
- Özel talimatlar eklemek için Thunderbit’in yapay zekâ istemlerini kullanın (ör. “SKU’ları markaya göre kategorize et”).
- Verisetlerinizi güncel ve aksiyona uygun tutmak için düzenli kazımalar planlayın.
Gerçek dünyadaki uygulamalar: İş kararları için ClawdBot Web Scraping
ClawdBot’un sektörler genelinde nasıl kullanıldığına bakalım:
Satış ve Potansiyel Müşteri Oluşturma
- Yeni potansiyel müşteriler için dizinleri, LinkedIn’i veya etkinlik katılımcı listelerini kazıyın.
- Şirket iş ilanlarını satın alma sinyalleri için izleyin.
- Haftalık potansiyel müşteri listesi güncellemelerini CRM’inize veya Slack’e otomatik olarak gönderin.
E-ticaret ve Fiyat Takibi
- Yüzlerce SKU boyunca rakip fiyatlarını, stok seviyelerini ve kampanyaları izleyin.
- Değişiklikleri gerçek zamanlı yakalamak için saatlik veya günlük kazımalar kurun.
- Dinamik fiyatlandırma veya stok uyarıları için yapılandırılmış veri kullanın.
Emlak
- Birden fazla siteden mülk ilanlarını, fiyatları ve emlak danışmanı bilgilerini toplayın.
- Durum değişikliklerini (yeni ilanlar, fiyat düşüşleri) izleyin ve ekibinize uyarılar gönderin.
- İlanları mahalle verileri veya son satışlarla zenginleştirin.
Pazar Araştırması ve Duygu Analizi
- Müşteri duygusunu anlamak için yorumları, haber makalelerini veya forum gönderilerini kazıyın.
- Büyük miktarda yapılandırılmamış metni etiketlemek, kategorize etmek ve özetlemek için yapay zekâ kullanın.
- Veriyi trend analizi ve raporlama için BI araçlarına aktarın.
Mini Vaka Çalışması:
Bir emlak ajansı, yeni ilanları günlük olarak kazımak, bunları emlak danışmanı iletişim bilgileriyle zenginleştirmek ve sabah raporunu satış ekibine ulaştırmak için ClawdBot + Thunderbit kullandı — manuel araştırma süresini %80 azalttı.
Veriden içgörüye: Kazınan veriyi aksiyona dönüştürmek
Verinizi kazıdıktan sonra sıra onu kullanılabilir hâle getirmeye gelir:
- Excel/Google Sheets: Hızlı analiz için pivot tablolar, grafikler ve koşullu biçimlendirme kullanın.
- Power BI/Tableau/Looker Studio: Yeni verilerle otomatik yenilenen panolar oluşturun.
- Metin Analizi: Yorumları özetlemek, konuları kümelendirmek veya duygu puanı vermek için yapay zekâ istemlerinden yararlanın.
İpucu:
Thunderbit’in yapılandırılmış dışa aktarımları, veriyi herhangi bir analitik araca kolayca bağlamanızı sağlar — dağınık temizlik işlerine gerek kalmaz.
Zorlukların üstesinden gelmek: Web scraping trendleri ve ClawdBot’un geleceği
Güncel Zorluklar
- Değişen Web Sitesi Yapıları: Siteler düzenlerini değiştiriyor, JavaScript ekliyor veya botları engelliyor — bu da geleneksel kazıyıcıları bozuyor.
- Bot Karşıtı Önlemler: Daha fazla site CAPTCHA, giriş duvarları ve bot tespiti kullanıyor.
- Veri Gizliliği ve Uyumluluk: Artan düzenlemeler (GDPR, CCPA) sorumlu şekilde kazıma yapmanızı gerektiriyor.
ClawdBot’un Yaklaşımı
- Tarayıcı Otomasyonu: Gerçek tarayıcı sekmelerini kontrol ederek etkileşimli ve giriş korumalı siteleri yönetebilir.
- İzole Oturumlar: Sandboxed ortamlarda scraping görevleri çalıştırarak riski azaltır.
- Güvenlik Denetimleri: Yerleşik araçlar, riskli yapılandırmalar veya açıkta kalan kimlik bilgileri konusunda sizi uyarır.
- Esnek Zamanlama: Cron görevleri, tespitten kaçınmak için kazımaları otomatikleştirip zamana yaymanıza olanak verir.
Gelecek
- Yapay Zekâ Destekli Çıkarma: Daha akıllı alan tespiti, yapılandırılmamış veriyi daha iyi işleme ve daha doğal dil kontrolleri bekleyin.
- Akıllı Araçlarla Entegrasyon: ClawdBot’u Thunderbit ve BI platformlarıyla birleştirmek veri akışlarını daha da sorunsuz hâle getirecek.
- Tasarımdan İtibaren Uyumluluk: Daha ayrıntılı kontroller, denetim kayıtları ve gizlilik özellikleri yol haritasında yer alıyor.
Sektör Trendi:
TollBit’e göre AI bot scraping trafiği 2024’ün 4. çeyreğinde 117% arttı; robots.txt’yi aşan botlarda ise %40 artış görüldü. Sorumlu ve uyarlanabilir scraping araçlarına duyulan ihtiyaç hiç bu kadar büyük olmamıştı.
Sonuç ve temel çıkarımlar: İş büyümesi için ClawdBot Web Scraping’de ustalaşmak
Şunu öğrendim: ClawdBot Web Scraping’de ustalaşmak sadece veri çekmekle ilgili değil; işletmenize avantaj sağlayan daha akıllı, daha otomatik iş akışları kurmakla ilgili. ClawdBot’un otomasyonunu Thunderbit’in yapay zekâ destekli yapılandırmasıyla birleştirdiğinizde, sadece hızlı değil gerçekten faydalı veri elde edersiniz.
Temel Çıkarımlar:
- Web scraping artık satış, e-ticaret, emlak ve araştırma ekipleri için kritik öneme sahip.
- ClawdBot, kod bilmeyenler için bile scraping’i erişilebilir, otomatikleştirilebilir ve güvenli hâle getirir.
- Thunderbit, yapay zekâ destekli alan tespiti ve veri temizleme ile iş akışınızı güçlendirir.
- Her iki aracı birlikte kullanmak, ham web verisinden uygulanabilir iş içgörülerine rekor sürede ulaşmanızı sağlar.
Veri oyununuzu bir üst seviyeye taşımaya hazır mısınız? Küçük bir projeyle başlayın — alanlarınızı Thunderbit’te tanımlayın, scraping işinizi ClawdBot’ta otomatikleştirin ve ne kadar zaman kazandığınızı görün. İş kararlarının geleceği veriye dayanıyor; doğru araçlarla siz de önde koşanlar arasında olacaksınız.
Thunderbit ile yapay zekâ destekli web scraping’e başlayın
SSS
1. ClawdBot Web Scraping nedir ve geleneksel kazıyıcılardan farkı nedir?
ClawdBot (şimdiki adıyla Moltbot), tarayıcı kontrolü, planlı görevler ve sohbet tabanlı komutlar kullanarak web verisi çıkarmayı otomatikleştiren bir yapay zekâ ajanı platformudur — kod gerekmez. Geleneksel kazıyıcılardan farklı olarak etkileşimli siteleri işleyebilir, iş akışlarını otomatikleştirebilir ve sonuçları ekibinizin tercih ettiği kanallara iletebilir.
2. ClawdBot’u potansiyel müşteri oluşturma ve fiyat takibi gibi iş görevlerinde kullanabilir miyim?
Kesinlikle. ClawdBot, satış potansiyel müşterisi kazıma, rakip fiyat takibi, emlak ilanlarını toplama ve pazar araştırması gibi iş kullanım senaryoları için tasarlanmıştır. Otomasyon ve zamanlama özellikleri, tekrar eden iş görevleri için onu ideal kılar.
3. Thunderbit, ClawdBot’un yeteneklerini nasıl geliştirir?
Thunderbit, alan adlarını, veri türlerini ve çıkarım mantığını önermek için yapay zekâ kullanır; böylece kazınan veriniz daha temiz ve daha yapılandırılmış olur. Şemanızı Thunderbit’te tanımlayıp ardından ClawdBot ile scraping ve raporlamayı otomatikleştirebilirsiniz.
4. Bugün web scraping’deki başlıca zorluklar nelerdir ve ClawdBot bunları nasıl çözer?
En büyük zorluklar değişen web sitesi yapıları, bot savunmaları ve uyumluluk gereksinimleridir. ClawdBot’un tarayıcı otomasyonu, izole oturumları ve yerleşik güvenlik denetimleri bu engelleri aşmanıza yardımcı olur.
5. ClawdBot ve Thunderbit’e nasıl başlarım?
Resmî betiği kullanarak ClawdBot’u (Moltbot) kurun, paneli ayarlayın ve Chrome uzantısını bağlayın. Veri şemanızı tanımlamak için Thunderbit’i kullanın, ardından scraping görevlerinizi ClawdBot’ta otomatikleştirin. Küçük bir projeyle başlayın ve alıştıkça ölçeği büyütün.
Yapay zekâ destekli web scraping hakkında daha fazla bilgi edinmek ister misiniz? Daha fazla rehber, ipucu ve gerçek başarı hikâyesi için Thunderbit Blog sayfasına göz atın.
Yapay zekâ web kazıyıcısını deneyin Get Started Free
Daha Fazla Bilgi Edinin




