

Reddit artık 100.000’den fazla aktif toplulukta haftalık 471,6 milyon benzersiz kullanıcı bildirdiğini söylüyor — buna rağmen, bu verileri Reddit’ten yapılandırılmış ve kullanılabilir bir formatta çekmek hiç bu kadar zor olmamıştı. 2023 API fiyatlandırma değişikliği, Pushshift’in kamuya açık bir arşiv olarak fiilen sona ermesi ve Reddit’in son dönemde yapay zekâ şirketlerine açtığı davalar arasında, scraping ortamı iki yıl öncesine göre bambaşka görünüyor.
Yıllardır Thunderbit bünyesinde veri çıkarma araçları geliştirip test ediyorum ve Reddit scraping tartışmasının “PRAW kullan gitsin” seviyesinden “bekle, aslında ne hâlâ çalışıyor?” noktasına evrildiğini gördüm. Bu yüzden satış ekipleri, pazarlamacılar, araştırmacılar ve operasyon profesyonelleri için 2026’da hangilerinin gerçekten iş gördüğünü anlamak adına 12 Reddit scraper’ı — no-code, low-code ve full-code — bizzat denedim. İşte bulduklarım.
Reddit Scraping İçin Thunderbit’i Deneyin
Reddit Verisi Neden Satış, Pazarlama ve Araştırma Ekipleri İçin Önemli?
Reddit sıradan bir sosyal platform değil. İnsanların gerçekten ne düşündüğünü — takma adlarla, filtresiz ve en faydalı yanıtları öne çıkaran bir upvote sistemiyle — paylaştığı yer. Bu da onu iş ekipleri için bir altın madene dönüştürüyor; ancak ölçekli şekilde manuel olarak izlemek neredeyse imkânsız. Sadece 2024’ün ikinci yarısında Reddit kullanıcıları 237 milyon gönderi ve 1,79 milyar yorum oluşturdu. Bu da günde yaklaşık 1,3 milyon gönderi ve 9,7 milyon yorum demek.
Reddit’in kendi iş materyalleri de bunu doğruluyor: redditor’ların yüzde 74’ü ürün araştırmasına Reddit’te başlayacağını söylüyor ve her saniye ortalama 2 kişi Reddit topluluklarından öneri istiyor; ortalama 14 kişisel yanıt alıyor. Škoda Auto gibi markalar, ürünleri birlikte tasarlamak için Reddit geri bildirimlerini kullanarak yüzde 255 daha fazla sipariş ve yüzde 84 olumlu duygu elde etti. Nespresso ise Reddit destekli kampanyalarla +%30 reklam bilinirliği artışı gördü.
İş ekipleri Reddit verisini aslında şöyle kullanıyor:
| Kullanım Senaryosu | Reddit Neden Güçlü? | Ekipler Neyi Çeker? |
|---|---|---|
| Lead generation | “Hangi aracı almalıyım?” gibi yüksek niyetli başlıklar | Gönderiler, yorum dizileri, yazar kullanıcı adları |
| Marka takibi | Filtresiz şikâyetler ve övgüler erken ortaya çıkar | Marka mentions, duygu analizi, şikâyet kümeleri |
| Rekabet istihbaratı | Alıcılar rakipleri doğal dille tartışır | Ürün karşılaştırmaları, geçiş nedenleri, özellik eksikleri |
| Ürün doğrulama | Alt topluluk geri bildirimi anketlerden önce acı noktalarını gösterir | Özellik talepleri, itirazlar, talep dili |
| Duygu analizi | Yorumlar yıldız puanlarından daha fazla nüans taşır | Yorum ağaçları, ebeveyn-çocuk yapısı, oylar |
| İçerik fikirleri | Sorular editoryal talebi doğrudan ortaya çıkarır | Gönderi başlıkları, tekrarlanan sorular, alt topluluk çerçeveleri |
Zorluk açık: günde binlerce diziyi elle takip edemezsiniz. İşte scraper’lar burada devreye giriyor — ama kurallar değişti.
Reddit’in API Baskısı (2023–2026): Hâlâ Ne Çalışıyor, Ne Bozuldu?
Reddit’in erişim politikalarını yakından takip etmediyseniz, kısa versiyon şu: ücretsiz ve sınırsız API erişimi ile Pushshift’in kamuya açık veri arşivi dönemi bitti. Bir scraper seçmeden önce nelerin değiştiğini anlamak kritik; çünkü hangi araçların hâlâ iş görebileceğini doğrudan bu belirliyor.
Yeniden Başlangıcın Zaman Çizelgesi
| Tarih | Değişiklik | Neden Önemli? |
|---|---|---|
| Nisan 2023 | Reddit büyük API değişikliklerini duyurdu | Ücretsiz ve sınırsız dönemin sonu |
| Mayıs 2023 | Pushshift erişimi kısıtlandı | Tarihsel arşiv kapanmaya başladı |
| Temmuz 2023 | Ücretsiz katman ve ücretli ticari kurallar yürürlüğe girdi | Ücretsiz API sınırlandı; ticari erişim ücretli oldu |
| 2024 ortası | Reddit for Researchers başlatıldı (sınırlı beta) | Akademik erişim kontrollü bir kanala taşındı |
| Ocak 2025 | Pushshift’in yalnızca doğrulanmış moderatörler için, sadece moderasyon amaçlı olduğu doğrulandı | Artık araştırma için bir arka kapı değil |
| Haziran 2025 | Reddit, Anthropic’e dava açtı | İzin alınmadan kullanılan yapay zekâ verisine karşı yasal baskı arttı |
| Ekim 2025 | Reddit, Perplexity’ye dava açtı | Uygulama baskısı daha da genişledi |
| Mart 2026 | Reddit, Data API Wiki, Responsible Builder Policy ve Developer Terms bölümlerini güncelledi | Ücretsiz katman, onay kuralları ve ticarileştirmeye karşı duruş sıkı kalmaya devam ediyor |
Hâlâ Ne Çalışıyor?
- Resmî Data API ücretsiz katmanı: OAuth istemci kimliği başına dakikada 100 sorgu ile, 10 dakikalık pencere ortalaması üzerinden hâlâ kullanılabiliyor.
.jsonuç noktaları: Herhangi bir Reddit URL’sinin sonuna.jsoneklemek hâlâ veri döndürüyor, ancak hız sınırı var ve ölçek için tasarlanmadı.- Tarayıcı tabanlı scraping: İşlenmiş sayfayı okuyan araçlar (Thunderbit veya Octoparse gibi) API kotalarına aynı şekilde tabi değil.
- Bulut scraping servisleri: Apify ve Oxylabs gibi platformlar render, proxy ve yeniden denemeleri kendi taraflarında yönetiyor.
Ne Bozuldu?
- Kamuya açık tarih kaynağı olarak Pushshift: Fiilen bitti. 2026 itibarıyla yalnızca doğrulanmış moderatörler için, moderasyon amaçlı kullanım ile sınırlı.
- Ticari ölçekte veri toplama için PRAW: Hem ücretsiz katman limitleri hem de Reddit’in daha geniş şartları nedeniyle kısıtlı.
- API erişiminin varsayılan ve ticari kullanımın sorun olmadığına dayanan her iş akışı: Eskidi.
Bu, Araç Seçimini Nasıl Şekillendiriyor?
| Yaklaşım | API Sınırlarından Etkilenir mi? | Tarihsel Veriye Erişim | Kurulum Karmaşıklığı |
|---|---|---|---|
| Reddit API (PRAW) | Evet — 1K gönderi limiti, hız sınırları | Yalnızca yakın dönemle sınırlı | Orta |
.json uç noktası | Evet — hız sınırı var | Çok sınırlı | Düşük |
| Tarayıcı scraping (Thunderbit, Octoparse) | Hayır — işlenmiş sayfayı okur | Yalnızca görünen/yüklenebilir olan | Çok düşük |
| Bulut scraping servisleri (Apify, Oxylabs) | Hayır (proxy’leri onlar yönetir) | Sağlayıcıya göre değişir | Düşük-Orta |
Özet: API odaklı araçlar artık geliştiriciler ve sınırları net iş yükleri için en iyisi. Tarayıcı odaklı ve bulut scraper araçları ise teknik olmayan veya daha yüksek hacimli kullanım senaryoları için daha güvenli tercih.
No-Code vs. Low-Code vs. Full-Code: Doğru Reddit Scraping Yaklaşımını Seçmek
Reddit scraper kitlesi gerçekten ikiye bölünmüş durumda. Bazı kullanıcıların Reddit verisine ihtiyacı var ama hiç mühendislik desteği yok. Bazılarının teknik bir operatörü var ama özel bir crawler ekibi yok. Bazılarıysa tam kod kontrolü istiyor. Doğru yaklaşım, sizin hangi gruba girdiğinize bağlı.
r/nocode içindeki bir kullanıcı yakın zamanda şöyle yazdı: “Bir reddit scrapper üzerinde çalışıyorum ama reddit API anahtarlarını alamıyorum.” r/NoCodeSaaS içindeki başka biri ise Zapier + Airtable + Softr ile, hiç backend kodu yazmadan canlı bir Reddit panosu kurduğunu anlattı. Bunlar istisna değil. Smarty Marketing anketine göre, kurum içi 150 pazarlama ekibinin yüzde 47,8’i Reddit ile ilgili ana engellerinin platformu yeterince iyi anlamamak olduğunu söylerken, yüzde 39’u banlanmaktan endişe ediyor.
İşte karar matrisi:
| Faktör | No-Code | Low-Code / API | Full-Code |
|---|---|---|---|
| Kurulum süresi | Dakikalar | Saatler | Saatler-Günler |
| Bakım | Yok (AI uyum sağlar) | Düşük (API güncellemeleri) | Yüksek (yerleşim/API değişiklikleri) |
| Ölçek tavanı | Orta | Yüksek | Orta (hız sınırları) |
| Özelleştirme | Sınırlı | Orta | Sınırsız |
| Maliyet | Ücretsiz katman → ücretli | Kullanım başına ödeme | Ücretsiz (ama geliştirici zamanı) |
No-code (Thunderbit, Browse AI, Octoparse, ScrapeStorm, ParseHub): Pazarlama, satış ve araştırma ekipleri için en iyisi. Thunderbit’in 2 tıklamalı AI akışı burada en hızlı yol.
Low-code / API servisleri (Apify, ScrapingBee, Oxylabs, Firecrawl, ScrapeGraphAI): Ölçek ve proxy yönetimi isteyen, bir miktar teknik kaynağı olan ekipler için en iyisi.
Full-code (PRAW, Scrapy): Maksimum kontrol isteyen geliştiriciler için en iyisi — ama API kısıtları ve devam eden bakım yükü kabul edilmeli.
Bu 12 Reddit Scraper’ı Nasıl Test Edip Sıraladık?
Her aracı şu kriterlere göre değerlendirdim:
- Kullanım kolaylığı: No-code, low-code veya full-code mu?
- Reddit’e özgü özellikler: Yorum dizilimi, alt topluluk hedefleme, tarihsel veri
- Reddit’in güncel API kısıtları ve bot karşıtı tespitiyle başa çıkma
- Fiyatlandırma modeli ve ücretsiz katman limitleri
- Veri dışa aktarma seçenekleri: CSV, JSON, Sheets vb.
- Zamanlanmış / tekrarlayan scraping desteği
- En uygun kullanım senaryosu
Tek tek incelemelere geçmeden önce ana karşılaştırma tablosu burada:
| Araç | Yaklaşım | Kod Gerekli mi? | API Sınırlarını Aşar mı? | İç içe yorumlar | Ücretsiz Katman | En Uygun Olduğu Alan |
|---|---|---|---|---|---|---|
| Thunderbit | AI tarayıcı/bulut scraper | Hayır | Evet (tarayıcı tabanlı) | Evet (alt sayfa + yorum şablonu) | Evet — 6 sayfa ücretsiz | Teknik olmayan kullanıcılar, lead generation |
| Apify | Bulut actor platformu | Low-code | Evet | Kısmi ile güçlü arası (actor’a bağlı) | Evet — sınırlı kredi | Toplu alt topluluk scraping |
| PRAW | Python API sarıcı | Full code | Kısmi (API hız sınırları) | Evet (kodla) | Evet (API ücretsiz katman) | Geliştiriciler, küçük projeler |
| Octoparse | Görsel scraper | No code | Evet (tarayıcı tabanlı) | Tipik araçlardan daha iyi, ama kusursuz değil | Evet | Çoklu site scraping ekipleri |
| Browse AI | Hazır robotlar | No code | Evet | Kısmi | Evet | İzleme ve değişim takibi |
| ScrapingBee | API servisi | Low-code | Evet (proxy rotasyonu) | Yerleşik thread desteği yok | Evet — 1K kredi | Engellemelerden kaçınan geliştiriciler |
| Scrapy | Python çerçevesi | Full code | Hayır (kendin yaparsın) | Evet (kurarsan) | Evet (açık kaynak) | Büyük ölçekli özel iş akışları |
| ScrapeStorm | AI masaüstü uygulaması | No code | Evet (tarayıcı tabanlı) | Kısmi | Evet | Başlangıç seviyesi kullanıcılar, otomatik algılama |
| ParseHub | Görsel masaüstü scraper | No code | Evet (tarayıcı tabanlı) | Güçlü yinelemeli potansiyel | Evet — 5 proje | Karmaşık sayfa yapıları |
| Firecrawl | Web verisi API’si | Low-code | Evet | Kısmi | Evet — 500 kredi | AI/LLM veri iş akışları |
| Oxylabs | Proxy + scraping API | Low-code | Evet (kurumsal proxy’ler) | Kısmi | Deneme — 2K sonuç | Kurumsal ölçekli çıkarım |
| ScrapeGraphAI | AI prompt tabanlı | Low-code | Evet | Kısmi | Evet — 50 kredi | AI öncelikli prompt tabanlı scraping |
Şimdi tek tek inceleyelim.
1. Thunderbit: İş Ekipleri İçin En Hızlı No-Code Reddit Scraper
 Thunderbit şirketimizde geliştirdiğimiz AI web scraper olduğu için Reddit yeteneklerini içten dışa biliyorum. Bu bir Chrome uzantısı; Reddit’i (ve herhangi bir siteyi) 2 tıklamada scrape eder — kod yok, API anahtarı yok, kurulum yok. Temel fikir şu: Sayfadaki verinin ne olduğunu AI çözsün, siz değil.
Reddit özelinde Thunderbit şunları sunar:
- AI ile Alan Öner: Herhangi bir alt topluluk sayfasında butona tıklayın; Thunderbit Post Başlığı, Yazar, Upvote sayısı, Yorum Sayısı, URL ve Tarih gibi sütunları otomatik algılar.
- Alt sayfa scraping: Her gönderi URL’sini ziyaret ederek tam metni, en iyi yorumları, flair’ı ve iç içe yanıtları çeker. API’ye dokunmadan derin yorum verisine böyle ulaşırsınız.
- Özel Reddit Post Comments Scraper: Thunderbit’in bir Reddit yorum şablonu vardır; bu şablon bir gönderi URL’sinden tüm yorumları, thread bağlantılarını, yanıt sayılarını ve iç içe yorumları çıkarır.
- Sayfalama ve sonsuz kaydırma: Reddit’in “daha fazlasını yükle” davranışını sayfalama dokümanları üzerinden otomatik yönetir.
- Bulut Scraping: Kamuya açık Reddit sayfaları için Cloud Scraping, hız için aynı anda 50 sayfaya kadar işler.
- Ücretsiz dışa aktarma: Veriyi Excel, Google Sheets, Airtable, Notion, CSV veya JSON’a gönderin — dışa aktarmada ücret duvarı yok.
- Zamanlanmış scraping: Doğal dilde bir takvim girin (örneğin “her Pazartesi saat 9’da”), alt topluluk URL’lerini ekleyin ve veri otomatik olarak hedefinize dışa aktarılsın.
Fiyatlandırma: Ücretsiz katman (6 sayfa), ardından yaklaşık 9 $/ay’dan başlayan kredi bazlı ücretli planlar. Thunderbit fiyatlandırmasına bakın.
En uygun olduğu alan: Reddit verisini hızlıca isteyen teknik olmayan satış, pazarlama ve operasyon ekipleri. Ayrıca tekil gönderi sayfalarından tam işlenmiş yorum verisi istediğiniz yüksek değerli thread analizleri için de güçlü.
Thunderbit ile 5 Adımda Bir Alt Topluluk Nasıl Scrape Edilir?
- Thunderbit Chrome uzantısını kurun ve bir alt topluluğa gidin (ör. r/SaaS).
- “AI ile Alan Öner” seçeneğine tıklayın — Thunderbit otomatik olarak şu sütunları algılar: Post Başlığı, Yazar, Upvote sayısı, Yorum Sayısı, URL, Tarih.
- “Scrape”’e tıklayın — veri saniyeler içinde oluşur. Kamuya açık sayfalarda hız için Cloud Scraping kullanın.
- Zenginleştirmek için “Alt Sayfaları Scrape Et”’e tıklayın — AI her gönderi URL’sini ziyaret eder ve tam metni, en iyi yorumları, flair’ı ve iç içe yanıtları çeker.
- Google Sheets, Excel, Airtable veya Notion’a dışa aktarın — tamamen ücretsiz.
Bunun pratikte nasıl göründüğünü görmek için Thunderbit YouTube kanalına göz atın.
Kod tercih ediyor musunuz? İşte PRAW eşdeğeri, yaklaşık 15 satır Python ile:
import praw

reddit = praw.Reddit(
    client_id="YOUR_ID",
    client_secret="YOUR_SECRET",
    user_agent="reddit-scraper-demo/0.1"
)

subreddit = reddit.subreddit("SaaS")
for post in subreddit.hot(limit=10):
    print(post.title, post.score, post.num_comments, post.permalink)
Thunderbit yaklaşık 30 saniye ve sıfır satır kod ister. PRAW ise API kimlik bilgilerini kurmayı, bir script yazmayı ve hız sınırlarıyla uğraşmayı gerektirir. İkisinin de yeri var — ama çoğu iş kullanıcısı için 2 tıklamalı yol kazanır.
2. Apify Reddit Scraper: Toplu Alt Topluluk Çıkarmada Bulut Gücü
 Apify tek bir Reddit aracı değil, bir bulut scraping platformudur. Topluluk tarafından oluşturulmuş “Actors” barındırır — proxy rotasyonu ve engelleme karşıtı önlemler hazır halde gelen, Apify altyapısında çalıştırabileceğiniz önceden hazırlanmış scraper’lar.
- Reddit’e özel actor’lar: prodiger’in Reddit Scraper’ı (yaklaşık 0,60 $ / 1K gönderi) ve trudax’ın Reddit Scraper’ı gibi birden fazla seçenek. Her biri alt topluluk listelerini (hot, new, top, rising), anahtar kelime aramasını, kullanıcı profillerini ve zaman filtrelerini destekler.
- İç içe yorumlar: Apify’nin, yapılandırılabilir derinlik ve ebeveyn-çocuk alanlarına sahip özel bir Reddit Comments Deep Scraper actor’ı var — derin thread çıkarımı için en güçlü seçeneklerden biri.
- Zamanlama: Ücretli planlarda yerleşik cron tarzı zamanlayıcı.
- Dışa aktarma: JSON, CSV, XML, Excel, HTML Table, RSS, JSONL artı API entegrasyonu ve webhooks.
- Fiyatlandırma: Ücretsiz katman (yaklaşık 5 $/ay kredi, yaklaşık 1K sonuç); ücretli planlar 49 $/ay’dan başlıyor.
En uygun olduğu alan: Bir miktar teknik kaynağı olan ve ölçeklenebilir, tekrarlayan Reddit veri toplama ihtiyacı bulunan ekipler. Ölçekte derin yorum ağaçlarına ihtiyacınız varsa, özel deep scraper actor gerçekten fark yaratır.
Uyarı: Kalite ve fiyatlandırma actor’a göre değişebilir; bu yüzden iş akışına bağlamadan önce test edin.
3. PRAW (Python Reddit API Wrapper): Geliştiricilerin İlk Tercihi (Ama Sınırları Var)
 PRAW hâlâ kod öncelikli Reddit API sarıcısının standardı. Python geliştiricisiyseniz muhtemelen ilk başvuracağınız araçtır — ve küçük, sınırları belli projelerde hâlâ gayet iyi çalışır. Ama 2026’da evrensel çözüm değil, “sınırları olan iş yükleri için geliştirici aracı” kategorisinde yer alıyor.
- En son sürüm: v7.8.1 (Ekim 2024)
- Temel özellikler: Tüm API uç noktalarına erişim (submissions, comments, user info); gerçek zamanlı gönderi akışı;
replace_more()ile tam yorum ağaçlarını dolaşma - Kritik sınırlama: Reddit’in API hız sınırlarına tabi (ücretsiz katmanda dakikada 100 sorgu), liste başına 1K gönderi tavanı ve 2023’ten beri daha sıkı ToS uygulaması. PRAW’in kendisi, “bir düzine kadar” eşzamanlı örneğin hız sınırlarını tetikleyebileceği uyarısını veriyor.
- Dışa aktarma: Kodla ne yaparsanız (CSV, JSON, veritabanı vb.)
- Zamanlama: cron işleriyle kendin yap (sunucu ve bakım gerekir)
- Fiyatlandırma: Ücretsiz ve açık kaynak, ancak ticari kullanım Reddit’in ücretli API katmanını gerektirebilir.
En uygun olduğu alan: Küçük-orta ölçekli projelerde özel Reddit entegrasyonlarına ihtiyaç duyan ve API tavanı ile yaşayabilen Python geliştiricileri ve veri bilimcileri.
4. Octoparse: Görsel, Tıkla-Seç Reddit Scraping
 Octoparse, tıkla-seç arayüzüne sahip no-code görsel bir web scraper’dır. Pek çok genel amaçlı görsel scraper’dan farklı olarak, herkese açık bir Reddit Scraper şablonu vardır — bu önemli, çünkü Reddit’in sayfa yapısı birçok aracı zorlar.
- Reddit şablonu:
old.reddit.comgerektirir, çalıştırma başına 1.000 Reddit gönderi URL’sine kadar destekler ve yorum/yanıt dizilerini çıkarabilir. Şablon, kapatılmış veya “daha fazlasını yükle” yorumların eksik kalabileceği konusunda uyarır. Daha derin bir karşılaştırma için Octoparse incelememize ve alternatifimize bakın. - Sayfalama ve sonsuz kaydırma: Desteklenir, ancak Reddit’in dinamik yüklemesi yine de zorlayıcı olabilir.
- Dışa aktarma: CSV, Excel, JSON, HTML, XML, veritabanları, Google Sheets.
- Zamanlama: Ücretli planlarda mevcut; izleme ve ebeveyn-çocuk görevleriyle birlikte.
- Fiyatlandırma: Ücretsiz plan 10 görev, 2 eşzamanlı çalışma ve dışa aktarmada 10.000 satıra kadar içerir. Ücretli planlar yaklaşık 69–75 $/ay’dan başlar.
En uygun olduğu alan: Kod yazmadan Reddit ve diğer web siteleri için çok yönlü bir scraping aracı isteyen ekipler. Reddit şablonu, genel görsel scraper’lara göre gerçek bir avantaj.
5. Browse AI: Değişim İzlemeli Hazır Reddit Robotları
 Browse AI farklı bir açıdan yaklaşır: scraper’ları sıfırdan kurmak yerine, belirli web siteleri için tasarlanmış hazır “robotlar” kullanırsınız. Reddit için Browse AI; bir Reddit ana sayfası ve alt topluluk gönderi scraper’ı, bir Reddit arama sonuçları scraper’ı ve Reddit izleme otomasyonlarını açıkça listeliyor.
- İzleme: Yeni gönderiler, anahtar kelime mention’ları veya belirli alt topluluklardaki değişiklikler için uyarılar kurun. Zamanlama; saatlik, günlük, haftalık, aylık veya özel desenleri destekler.
- Entegrasyonlar: CSV, JSON, Google Sheets, Airtable, Zapier, Make, API ve webhooks.
- Fiyatlandırma: Ücretsiz katman ayda 50 kredi, 2 web sitesi ve 3 kullanıcı içerir. Ücretli planlar yaklaşık 49 $/ay’dan başlar.
En uygun olduğu alan: Hiç manuel iş yapmadan otomatik Reddit izleme isteyen teknik olmayan kullanıcılar. Marka takibi ve rekabet uyarıları için güçlü. Bu araçla ilgili daha fazla bilgi için Browse AI incelememize ve alternatifimize bakın.
Uyarı: Derin iç içe yanıt ağacını yeniden oluşturduğuna dair güncel kamu kanıtı bulamadım; bu yüzden izleme ve gönderi düzeyi çıkarımda güçlü, ancak derin yorumlarda yalnızca kısmi olarak değerlendirmek daha doğru.
6. ScrapingBee: Proxy Yönetimli API Tabanlı Reddit Scraping
 ScrapingBee, Reddit’e özel bir ürün değildir. Headless browser’ları, proxy rotasyonunu ve CAPTCHA çözmeyi yöneten genel amaçlı bir scraping API’sidir. Siz bir URL gönderirsiniz, temiz HTML, Markdown veya çıkarılmış JSON geri alırsınız.
- JavaScript render etme: Reddit’in dinamik sayfalarını işler.
- Proxy rotasyonu: Engellenmemek için otomatik.
- Çıktı formatları: HTML, Markdown, düz metin, çıkarılmış JSON.
- Yerleşik zamanlayıcı yok: cron veya otomasyon araçlarıyla entegre edin.
- Fiyatlandırma: Kredi kartı gerektirmeyen 1.000 API kredilik ücretsiz deneme. Planlar 49 $/ay’dan başlıyor.
En uygun olduğu alan: Proxy yönetimiyle tek tek uğraşmadan güvenilir Reddit sayfası erişimi isteyen geliştiriciler. Reddit’e özel bir araç değil — yerleşik Reddit ayrıştırıcısı veya yorum thread desteği yok. Daha ayrıntılı inceleme için ScrapingBee incelememize ve alternatifimize bakın.
7. Scrapy: Özel Reddit İş Akışları İçin Açık Kaynak Python Çerçevesi
 Scrapy tüm tarama yığınını kendi elinde tutmak isteyen ekipler için en esnek seçenektir. 61,4K GitHub yıldızına sahip güçlü bir açık kaynak Python çerçevesidir ve en son sürümü v2.15.0 (Nisan 2026).
- Asenkron işleme: Hassas hedefleme için XPath/CSS seçicilerle hızlı tarama.
- Genişletilebilir: Sayfalama, yorum dolaşımı, veri temizleme, proxy rotasyonu, user-agent yönetimi ve AutoThrottle için middleware ve pipeline’lar.
- Dışa aktarma: JSON, JSON Lines, CSV, XML, Pickle ve Marshal.
- Kritik nokta: Scrapy, Reddit’in bot karşıtı önlemlerini kutudan çıktığı hâliyle yönetmez. Proxy rotasyonu, user-agent yönetimi ve hız sınırlamayı kendiniz eklemelisiniz.
- Fiyatlandırma: Ücretsiz ve açık kaynak.
En uygun olduğu alan: Büyük ölçekli, özel Reddit scraping sistemleri kuran deneyimli Python geliştiricileri. Maksimum kontrol istiyor ve bakım yükünü üstlenebiliyorsanız Scrapy’yi geçmek zor. Python scraping araçlarını karşılaştırmak için en iyi Python web scraping araçları rehberimize bakın.
8. ScrapeStorm: Başlangıç Seviyesi İçin AI Destekli Masaüstü Reddit Scraper’ı
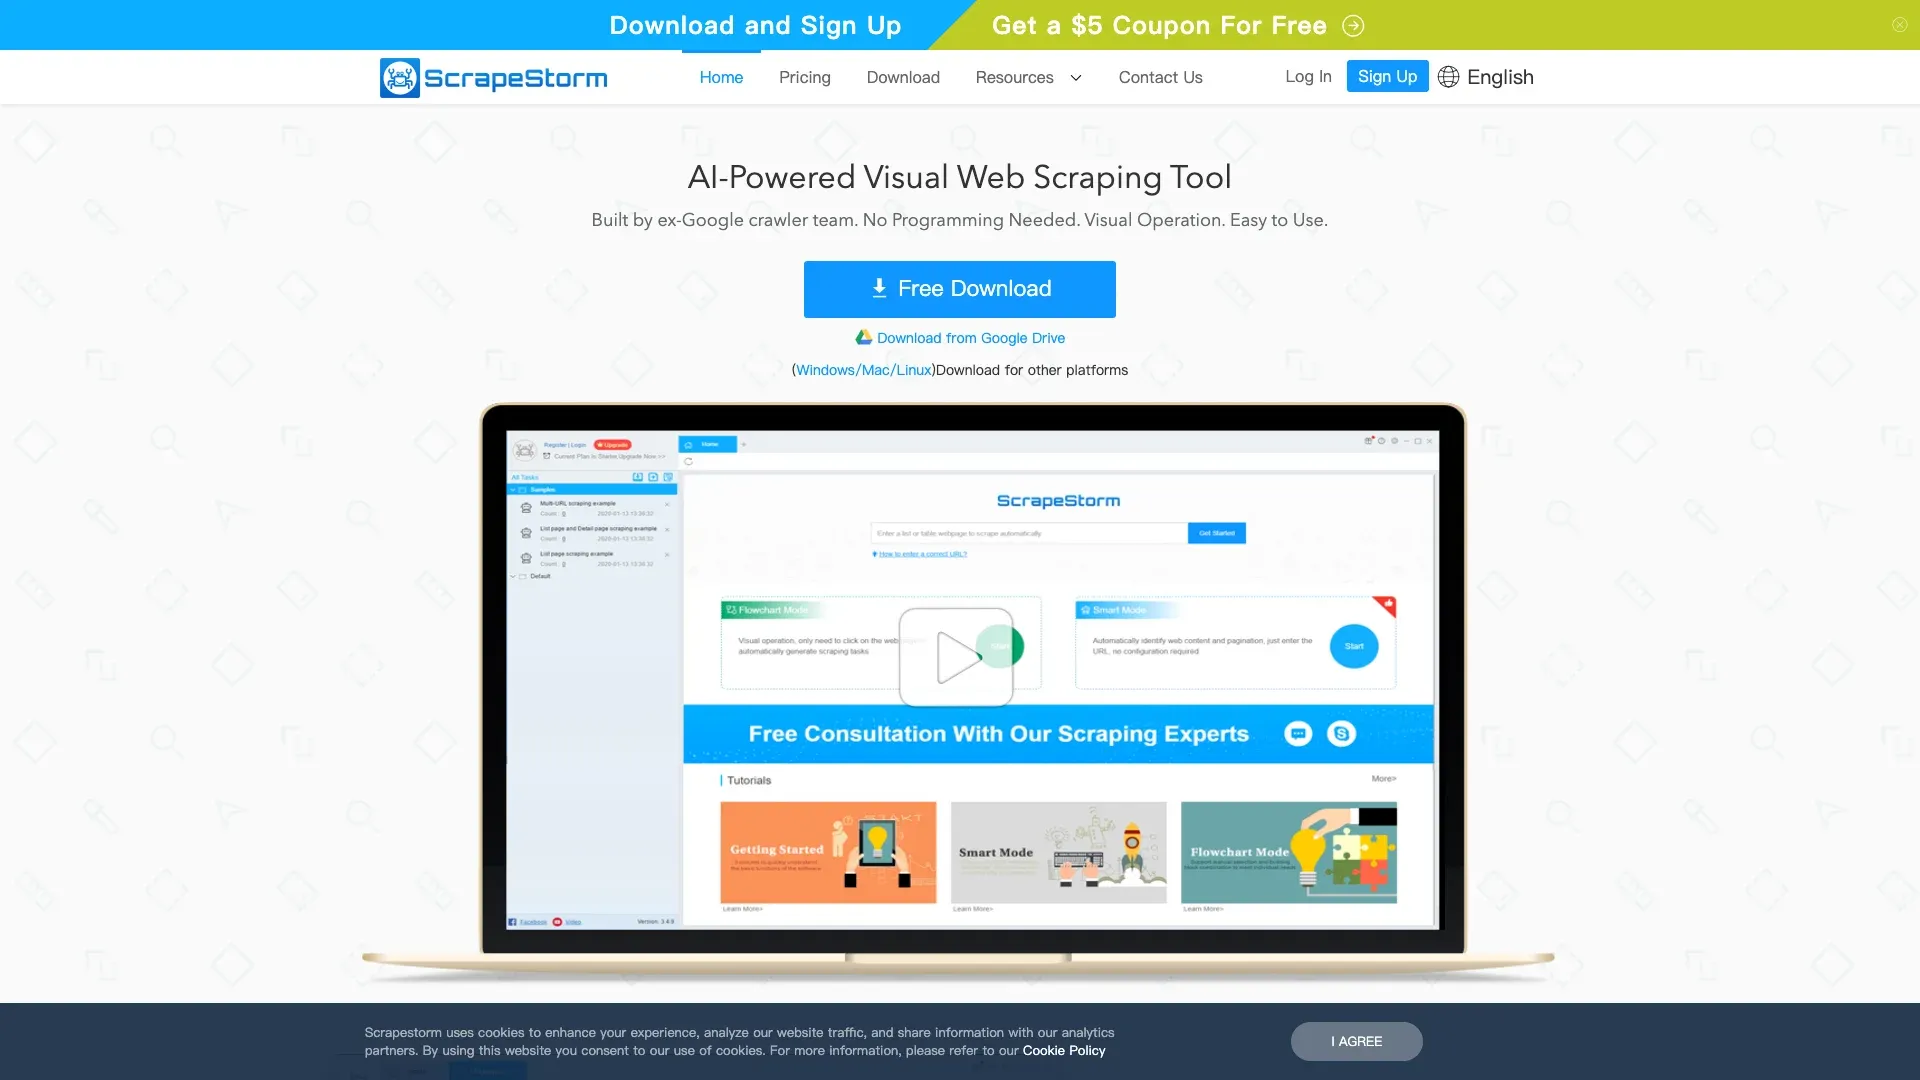 ScrapeStorm, herhangi bir web sayfasındaki veri kalıplarını otomatik algılayan AI destekli bir masaüstü uygulamasıdır. Mevcut sürüm v4.0.6’dır (Aralık 2025).
- Otomatik algılama: AI, manuel yapılandırma olmadan gönderi verisini (başlıklar, puanlar, yazarlar) tanır.
- Görsel arayüz: Seçimleri ince ayarlayın, zamanlanmış scraping kurun (saatlik/günlük/haftalık) ve Excel, TXT, CSV, HTML, veritabanları ile Google Sheets’e aktarın.
- Fiyatlandırma: Süresiz ücretsiz katman; ücretli planlar 49,99 $/ay’dan başlar.
En uygun olduğu alan: Kod veya karmaşık kurulum olmadan AI destekli Reddit scraping isteyen başlangıç seviyesindeki kullanıcılar. Daha detaylı bakış için ScrapeStorm incelememize ve alternatifimize göz atın.
Uyarı: Derin iç içe yorum çıkarımını kanıtlayan Reddit’e özel dokümantasyon bulamadım. Yüzeysel scraping için iyi; ancak dikkatli oluşturulmuş bir akış şeması iş akışı kurmadığınız sürece thread derinliği muhtemelen sınırlı.
9. ParseHub: Karmaşık Reddit Sayfaları İçin Görsel Masaüstü Scraper
 ParseHub, JavaScript ağırlıklı ve dinamik yüklenen sayfaları işleyen görsel tıkla-seç arayüzüne sahip bir masaüstü uygulamasıdır. Yinelemeli/iç içe çıkarım desenlerine açık desteği sayesinde birçok no-code araçtan ayrılır.
- İç içe veri: ParseHub, yorum dizisi çıkarımını yönetmek için Jump, Relative Select ve CSV Wide özelliklerini belgeliyor — oluşturucusuna zaman ayırırsanız çoğu no-code DOM aracından daha güçlü.
- Zamanlama: Ücretli planlarda dakikada bir çalışabilir.
- Dışa aktarma: CSV, JSON, Excel, API erişimi.
- Fiyatlandırma: En fazla 5 proje için ücretsiz; ücretli planlar yaklaşık 89 $/ay’dan başlıyor.
En uygun olduğu alan: Kod yazmadan karmaşık, JavaScript ağırlıklı Reddit sayfa yapılarını scrape etmek isteyen kullanıcılar — özellikle de görsel oluşturucunun daha gelişmiş özelliklerini öğrenmeye hazırsanız. Daha fazlası için ParseHub incelememize ve alternatifimize bakın.
10. Firecrawl: AI ve LLM İş Akışları İçin Tasarlanmış Web Verisi API’si
 Firecrawl herhangi bir web sayfasını temiz Markdown’a veya yapılandırılmış veriye dönüştürmek için tasarlanmış, AI/LLM uygulamalarına veri beslemek üzere optimize edilmiş bir API’dir. Yerel bir Reddit scraper’ı değildir; ancak hedefiniz Reddit içeriğini bir RAG pipeline’ına veya bilgi tabanına taşımaksa güçlü bir uyum sağlar.
- Çıktı formatları: Markdown, HTML, ekran görüntüsü, bağlantılar, JSON, görseller, branding, ses. JSON çıkarımı daha fazla kredi tüketir.
- Proxy yönlendirme ve JS render etme: Dokümante edilmiş ve yönetilen.
- Yerleşik zamanlayıcı yok: Otomasyon araçlarıyla entegre edin.
- Fiyatlandırma: 500 tek seferlik kredili ücretsiz katman; ücretli planlar yaklaşık 16 $/ay’dan başlıyor.
En uygun olduğu alan: Reddit verisini AI modellerine, RAG pipeline’larına veya bilgi tabanlarına aktaran teknik ekipler. Daha derin karşılaştırma için Firecrawl incelememize ve alternatiflerimize bakın.
Uyarı: Yerel Reddit yorum thread desteği yok — sayfa içeriğini Markdown veya yapılandırılmış JSON olarak verir. İçerik yakalama için güçlü, ağaç yapılı thread analizi için değil.
11. Oxylabs: Proxy Altyapılı Kurumsal Düzey Reddit Scraping
 Oxylabs kurumsal odaklı bir web scraping ve proxy servisidir. Hem ham proxy’ler hem de zamanlama, bulut teslimi ve büyük proxy havuzları içeren yapılandırılmış bir Web Scraper API sunar.
- Ölçek: 195 ülkede 177M+ IP ve 15.000+ iş ortağı sunar.
- Zamanlayıcı: Dokümante edilmiştir; tekrarlayan işler AWS S3 veya GCS’ye teslim edilebilir.
- G2 puanı: 425 değerlendirmeden 4,5/5.
- Fiyatlandırma: 2.000 sonuca kadar ücretsiz deneme; Web Scraper API 49 $/ay’dan başlıyor. Kurumsal fiyatlama buradan yukarı ölçekleniyor.
En uygun olduğu alan: Ölçekte yüksek hacimli ve güvenilir Reddit veri çıkarımı isteyen büyük işletmeler veya ajanslar. Tam inceleme için Oxylabs incelememize ve alternatifimize bakın.
Uyarı: Reddit’e özel bir Oxylabs şablonu veya ayrıştırıcı bulamadım. Bu bir altyapı yatırımı — güçlü, ama Reddit’e özel mantığı kendiniz kuruyorsunuz.
12. ScrapeGraphAI: Prompt Tabanlı AI Destekli Reddit Çıkarımı
 ScrapeGraphAI daha yeni AI-öncelikli ürünlerden biri. Ne çıkarmak istediğinizi sade İngilizce ile tarif ediyorsunuz; geri kalanını AI hallediyor — seçici yok, şema yok.
- GitHub: 21,9K yıldız.
- Çıktı: JSON, CSV, Markdown.
- Fiyatlandırma: 50 API kredili ücretsiz katman ve dakikada 10 istek; ücretli planlar yaklaşık 17 $/ay’dan başlıyor.
En uygun olduğu alan: Seçici veya şemaları elle tanımlamadan AI öncelikli, prompt tabanlı Reddit scraping isteyen kullanıcılar. Daha fazlası için ScrapeGraphAI incelememize ve alternatifimize bakın.
Uyarı: Yorum thread doğruluğunu karşılaştıran Reddit’e özel kamu dokümantasyonu bulamadım. Güçlü bir genel amaçlı prompt tabanlı çıkarıcı, ama Reddit’e optimize edilmiş uzman bir araç değil.
İç İçe Yorum Sorunu: Hangi Reddit Scraper’lar Derin Thread’leri Destekliyor?
Bu bölüm, çoğu “en iyi Reddit scraper” listesinin atladığı ve ciddi araştırma için en önemli kısım. Reddit konuşmaları ağaç yapılıdır ve bu yapı analitik olarak anlamlıdır. Applied Network Science’teki 2024 tarihli bir çalışma, Reddit’in hiyerarşik thread yapısını modellemenin sosyal olguları anlamada önemli olduğunu buldu. 2022 tarihli bir ön baskı, medyan yorum derinliğinin 3, maksimumun ise 828 olduğunu bildirdi.
Duygu analizi, yapay zekâ eğitim verisi toplama veya nitel araştırma yapıyorsanız, yalnızca üst seviye yanıtlar değil, tam yorum ağacı gerekir. Çoğu scraper yorumları düzleştirir; çünkü yalnızca görünen DOM’u ya da API’nin varsayılan limit parametresini okur.
İşte karşılaştırma:
| Araç | Yorum Derinliği | Yöntem |
|---|---|---|
| PRAW | Tam ağaç (kodla) | API replace_more() çağrıları — hız sınırını tüketir |
| Apify Deep Scraper | Tam ağaç | Özel actor |
| Thunderbit | Görünen tam thread | Reddit yorum şablonu + tekil gönderi URL’lerinde alt sayfa scraping |
| ParseHub | Güçlü yinelemeli potansiyel | Relative Select + Jump + CSV Wide |
| Octoparse | Tipik araçlardan daha iyi, ama kusursuz değil | Yorum/yanıt çıkarımlı Reddit şablonu; collapsed/load-more durumlarını kaçırabilir |
| Browse AI | Kısmi | İzleme için iyi, yinelemeli derinlikte kanıt daha zayıf |
| ScrapeStorm | Kısmi | Genel DOM/tarayıcı çıkarımı |
| Firecrawl | Kısmi | İçerik yakalamada iyi, thread-ağacı uzmanı değil |
| Oxylabs | Kısmi | Tarayıcı talimatlarıyla kurulabilir, Reddit’e özel doküman yok |
| ScrapeGraphAI | Kısmi | İşlenmiş içerik üzerinde prompt/şema çıkarımı |
Pratik tavsiye: Alt topluluk düzeyinde toplu scraping için düzleştirilmiş veri çoğu zaman yeterlidir. Belirli ve yüksek değerli thread’ler içinse (ürün geri bildirimi, pazar araştırması, rekabet istihbaratı) tekil gönderi sayfalarına gidip tam işlenmiş yorum thread’ini çıkaran bir araç kullanın.
Kur ve Unut Reddit İzleme: Marka ve Pazar İstihbaratı İçin Zamanlanmış Scraping
Birçok iş ekibi için asıl soru “Reddit’i bir kez scrape edebilir miyim?” değil — “Marka ve rakip mention’larını her gün, başında beklemeden çekmeye devam edebilir miyim?” oluyor. r/NoCodeSaaS içindeki bir kullanıcı, alt topluluk istatistikleri ve büyüme trendleri için backend kod yazmadan Zapier + Airtable + Softr ile canlı bir Reddit veri panosu kurduğunu anlattı. Zamanlanmış scraping işte böyle akışları mümkün kılar.
Kullanım Senaryoları
- r/SaaS, r/ecommerce, r/startups içinde marka veya rakip mention’larını takip etme
- Fiyatlandırma tartışmalarını ve ürün karşılaştırmalarını izleme
- Belirli niş alt topluluklarda öneri isteyen yeni lead’leri ortaya çıkarma
- Haftalık Reddit özetlerini ekip için Slack’e veya e-postaya aktarma
Araçlar Nasıl Karşılaştırılıyor?
| Araç | Yerleşik Zamanlama | Kurulum Zorluğu | Otomatik Dışa Aktarma |
|---|---|---|---|
| Thunderbit | Evet — doğal dilde zamanlama | Çok kolay | Sheets, Airtable, Notion, CSV, JSON |
| Apify | Evet — cron tarzı zamanlayıcı | Orta | Dataset’ler, API, webhooks |
| Browse AI | Evet — izleme robotları | Kolay | CSV, JSON, Sheets, Airtable, entegrasyonlar |
| PRAW + cron | Sadece kendin yap | Zor (sunucu, bakım) | Kodladığınız her şey |
| Octoparse | Evet (ücretli planlar) | Orta | CSV, Excel, JSON, veritabanları, Sheets |
| ParseHub | Evet (ücretli planlar) | Orta | CSV, JSON, API |
Thunderbit’in Scheduled Scraper özelliği, “her Pazartesi saat 9’da” gibi bir ifade girip alt topluluk URL’lerini eklemenize ve Schedule’a tıklamanıza izin verir. Veri otomatik olarak Sheets, Airtable veya Notion’a aktarılır; böylece ekibiniz scraper’a bir daha dokunmadan uyarılar veya panolar kurabilir. Web veri toplamayı otomatikleştirme konusunda ayrıca bir rehber de yazdık.
Yan Yana Karşılaştırma: 12 Reddit Scraper’ın Hızlı Görünümü
| Araç | Yaklaşım | Kod Gerekli | API Sınırlarını Aşar mı? | İç İçe Yorumlar | Ücretsiz Katman | Başlangıç Fiyatı | En Uygun Olduğu Alan |
|---|---|---|---|---|---|---|---|
| Thunderbit | Tarayıcı/bulut AI scraper | Hayır | Evet | Güçlü (yorum şablonu + alt sayfalar) | Evet | Ücretsiz / yaklaşık 9 $/ay | Teknik olmayan iş ekipleri |
| Apify | Actor platformu | Low | Evet | Kısmi ile güçlü arası | Evet (sınırlı kredi) | Actor’a özel / 49 $/ay | Toplu alt topluluk scraping |
| PRAW | API sarıcı | Evet | Kısmi | Evet | Evet | Ücretsiz | Geliştiriciler, veri bilimciler |
| Octoparse | Görsel scraper | Hayır | Evet | Tipik araçlardan daha iyi, kusursuz değil | Evet | yaklaşık 69–75 $/ay | Çoklu site no-code scraping |
| Browse AI | İzleme robotları | Hayır | Evet | Kısmi | Evet | yaklaşık 49 $/ay | İzleme ve uyarılar |
| ScrapingBee | API servisi | Low | Evet | Yerleşik thread yok | Evet (1K kredi) | 49 $/ay | Proxy yönetiminden kaçınan geliştiriciler |
| Scrapy | Python çerçevesi | Evet | Hayır (kendin yaparsın) | Evet (kurarsan) | Evet | Ücretsiz | Tam kontrol isteyen özel iş akışları |
| ScrapeStorm | AI masaüstü uygulaması | Hayır | Evet | Kısmi | Evet | 49,99 $/ay | Başlangıç seviyesi kullanıcılar |
| ParseHub | Görsel masaüstü scraper | Hayır | Evet | Güçlü yinelemeli potansiyel | Evet (5 proje) | yaklaşık 89 $/ay | Karmaşık dinamik sayfalar |
| Firecrawl | Web verisi API’si | Low | Evet | Kısmi | Evet (500 kredi) | yaklaşık 16 $/ay | AI/LLM iş akışları |
| Oxylabs | Web scraping API + proxy’ler | Low-Orta | Evet | Kısmi | Deneme (2K sonuç) | 49 $/ay | Kurumsal ölçek |
| ScrapeGraphAI | AI prompt tabanlı | Low-Orta | Evet | Kısmi | Evet (50 kredi) | yaklaşık 17 $/ay | Prompt öncelikli AI iş akışları |
Birkaç desen hemen göze çarpıyor. No-code araçlar hız ve erişilebilirlikte kazanır. Kod tabanlı araçlar özelleştirmede kazanır. Bulut API araçları ölçekte kazanır.
Reddit’e özgü derinlikte — özellikle iç içe yorumlarda — gerçekten iş gören araç sayısı az: PRAW, Apify’nin deep scraper’ı, Thunderbit’in yorum şablonu ve ParseHub’ın yinelemeli çıkarımı.
Ekibiniz İçin En İyi Reddit Scraper’ı Nasıl Seçersiniz?
12 aracın hepsini test ettikten sonra sıralamam şöyle olurdu:
- Geliştiricisi olmayan satış veya pazarlama ekibi mi? Thunderbit veya Browse AI ile başlayın. Thunderbit tek seferlik ve zamanlanmış scraping için en hızlısı; Browse AI ise izleme uyarılarında güçlü.
- Bir miktar teknik kaynakla toplu alt topluluk verisine mi ihtiyacınız var? Apify veya Oxylabs. Apify’nin actor ekosistemi Reddit’e özel seçenekler sunar; Oxylabs kurumsal düzey altyapı sağlar.
- Özel pipeline kuran geliştirici misiniz? PRAW veya Scrapy. API öncelikli iş akışları için PRAW; tam kontrol isteyen crawling için Scrapy. Sadece bakım ve hız sınırı yönetimi için bütçe ayırın.
- AI/LLM uygulamaları için Reddit verisi mi gerekiyor? Firecrawl, ScrapeGraphAI veya Thunderbit’in API’si. Firecrawl, RAG için Markdown çıktısında öne çıkar; ScrapeGraphAI prompt tabanlı çıkarım için harika.
- Sürekli izleme ve uyarılar mı? Thunderbit Scheduled Scraper, Browse AI veya Apify schedules.
Hukuki ve Etik Konular Üzerine Kısa Bir Not
Reddit’in şartları artık daha sıkı. Ticari API kullanımı onay gerektiriyor, Pushshift artık kamuya açık bir arşiv değil ve Reddit yetkisiz scraping yapan şirketlere aktif olarak dava açtı. Kamuya açık sayfaları scrape etmek teknik olarak mümkün olsa da politika riski gerçek. Ekibiniz kişisel veri topluyor, silinmiş içerikleri saklıyor veya ölçekli ticari izleme yapıyorsa hukuki inceleme gerekir. Her zaman Reddit Kullanıcı Sözleşmesine ve Developer Terms kurallarına uyun.
Kapanış
Reddit verisi her zamankinden daha değerli — ve erişmesi de her zamankinden daha zor. 2022’de işe yarayan araçların hepsi 2026’da çalışmıyor.
API öncelikli yaklaşımlar artık hız sınırları ve ticari kısıtlarla sınırlı. Tarayıcı tabanlı ve bulut scraping araçları çoğu iş ekibi için pratik varsayılan hâline geldi.
Kod yazmadan modern Reddit scraping’in nasıl göründüğünü görmek istiyorsanız Thunderbit’in ücretsiz denemesini deneyin. Thunderbit tam size göre değilse, bu listedeki birkaç alternatifi de test edin. En iyi scraper, gerçekten ihtiyacınız olan veriyi, zamanında, hafta sonunuzu yemeden getiren scraper’dır.
İyi scraping’ler — ve yorum ağaçlarınız hep tamamen genişlemiş olsun.
Reddit Scraping İçin Thunderbit’i Deneyin Get Started Free
SSS
1. 2026’da Reddit scrape etmek yasal mı?
Reddit’in User Agreement ve Developer Terms belgeleri, yazılı onay olmadan scraping’i açıkça sınırlandırır ve ticari API kullanımı onay gerektirir. Reddit, yetkisiz veri kullanımı nedeniyle Anthropic ve Perplexity gibi şirketlere dava açtı. Kamuya açık sayfalara teknik olarak erişilebilir, ancak politika ve dava riski gerçektir. Ölçekli veya ticari amaçlarla scraping yapıyorsanız hukuki inceleme iyi bir fikirdir.
2. Kod yazmadan Reddit scrape edebilir miyim?
Evet. 2026’da en güçlü no-code seçenekler Thunderbit, Browse AI, Octoparse, ScrapeStorm ve ParseHub’dır. Thunderbit’in 2 tıklamalı AI akışı, teknik olmayan kullanıcılar için en hızlı yoldur — API anahtarı yok, kurulum yok, script yok.
3. En iyi ücretsiz Reddit scraper hangisi?
Geliştiriciler için PRAW hâlâ en iyi ücretsiz kod tabanlı seçenek (API limitlerine tabi). Teknik olmayan kullanıcılar için Thunderbit, Browse AI ve Octoparse anlamlı ücretsiz katmanlar sunar. Thunderbit, Sheets, Excel, Airtable ve Notion’a tam dışa aktarma ile 6 ücretsiz sayfa verir.
4. Reddit’in 1.000 gönderi sınırını nasıl aşarım?
Genellikle resmî API üzerinden bunu temiz bir şekilde aşamazsınız — bu tavan, liste tabanlı API iş akışları için hâlâ pratik bir kısıttır. Tarayıcı tabanlı scraping (Thunderbit, Octoparse), bulut actor yaklaşımları (Apify) veya daha dar hedefli sorgular daha gerçekçi alternatiflerdir. Derin tarihsel veri için eski Pushshift çözümü artık yok.
5. Gönderilerle birlikte Reddit yorumlarını da scrape edebilir miyim?
Evet, ama araç kalitesi ciddi şekilde değişir. PRAW, API hız sınırı pahasına tam yorum ağacını dolaşabilir. Apify’nin Reddit Comments Deep Scraper aracı bunun için özel olarak tasarlanmıştır. Thunderbit’in Reddit yorum şablonu ve alt sayfa scraping’i, tekil gönderi sayfalarındaki tam işlenmiş yorum thread’ini çıkarır. ParseHub’ın yinelemeli çıkarımı da dikkatli yapılandırılırsa iç içe yorumları işleyebilir.
Daha Fazlasını Öğrenin



