

Reddit kini melaporkan 471,6 juta pengguna aktif unik mingguan di lebih dari 100.000 komunitas aktif — tetapi mengambil data itu dari Reddit dalam format yang terstruktur dan mudah dipakai belum pernah sesulit ini. Antara perubahan besar harga API pada 2023, matinya Pushshift sebagai arsip publik, dan gugatan terbaru Reddit terhadap perusahaan AI, lanskap scraping sekarang terlihat jauh berbeda dibanding dua tahun lalu.
Saya sudah bertahun-tahun membangun dan menguji alat ekstraksi data di Thunderbit, dan saya melihat percakapan soal scraping Reddit bergeser dari "pakai PRAW saja" menjadi "tunggu, sebenarnya apa yang masih jalan?" Jadi saya turun langsung untuk menguji 12 Reddit scraper — no-code, low-code, dan full-code — untuk mencari tahu mana yang benar-benar berguna di 2026 bagi tim sales, marketer, peneliti, dan profesional operasional yang butuh data Reddit tanpa ribet. Ini temuan saya.
Coba Thunderbit untuk Scraping Reddit
Mengapa Data Reddit Penting untuk Tim Sales, Marketing, dan Riset
Reddit bukan sekadar platform sosial biasa. Di sanalah orang-orang bilang apa yang benar-benar mereka pikirkan — anonim, tanpa filter, dan dengan sistem upvote yang menonjolkan jawaban paling berguna. Itu membuatnya jadi tambang emas bagi tim bisnis, tetapi juga hampir mustahil dipantau manual dalam skala besar. Hanya pada H2 2024, pengguna Reddit membuat 237 juta postingan dan 1,79 miliar komentar. Itu kira-kira 1,3 juta postingan dan 9,7 juta komentar per hari.
Materi bisnis resmi Reddit sendiri mendukung hal ini: 74% redditor mengatakan mereka akan memulai riset produk mendalam di Reddit, dan setiap detik, rata-rata 2 orang meminta rekomendasi ke komunitas Reddit, lalu menerima rata-rata 14 respons personal. Merek seperti Škoda Auto menggunakan masukan Reddit untuk ikut merancang produk, menghasilkan 255% lebih banyak pesanan dan sentimen positif sebesar 84%. Nespresso melihat kenaikan +30% awareness iklan dari kampanye berbasis Reddit.
Begini cara tim bisnis benar-benar memakai data Reddit:
| Use Case | Mengapa Reddit Kuat | Apa yang Diekstrak Tim |
|---|---|---|
| Lead generation | Thread "tool apa yang sebaiknya saya beli?" punya niat beli tinggi | Postingan, thread komentar, handle penulis |
| Brand monitoring | Keluhan dan pujian tanpa filter muncul lebih awal | Penyebutan merek, sentimen, klaster keluhan |
| Competitive intelligence | Pembeli membahas kompetitor dengan bahasa sehari-hari | Perbandingan produk, alasan pindah, celah fitur |
| Product validation | Masukan subreddit menunjukkan pain point sebelum survei | Permintaan fitur, keberatan, bahasa permintaan |
| Sentiment analysis | Komentar punya nuansa lebih kaya daripada rating bintang | Pohon komentar, struktur induk-anak, suara/upvote |
| Content ideation | Pertanyaan langsung menampilkan kebutuhan editorial | Judul postingan, pertanyaan berulang, framing subreddit |
Tantangannya jelas: Anda tidak bisa memantau ribuan thread per hari secara manual. Di situlah scraper berperan — tetapi aturannya sudah berubah.
Pengetatan API Reddit (2023–2026): Apa yang Masih Jalan dan Apa yang Rusak
Kalau Anda belum mengikuti kebijakan akses Reddit, ringkasnya begini: dunia lama dengan akses API gratis tanpa batas dan Pushshift sebagai arsip data publik sudah hilang. Memahami apa yang berubah sangat penting sebelum memilih scraper, karena itu langsung menentukan alat mana yang masih bisa diandalkan.
Linimasa Perubahannya
| Tanggal | Perubahan | Mengapa Penting |
|---|---|---|
| April 2023 | Reddit mengumumkan perubahan besar API | Era akses bebas berakhir |
| Mei 2023 | Akses Pushshift dibatasi | Arsip historis mulai ditutup |
| Juli 2023 | Tier gratis dan aturan komersial berbayar mulai berlaku | API gratis menjadi terbatas; akses komersial jadi berbayar |
| Pertengahan 2024 | Reddit for Researchers diluncurkan (beta terbatas) | Akses akademik pindah ke jalur yang terkontrol |
| Januari 2025 | Pushshift dikonfirmasi hanya untuk moderator terverifikasi, dan hanya untuk moderasi | Tidak lagi jadi pintu belakang untuk riset |
| Juni 2025 | Reddit menggugat Anthropic | Eskalasi hukum terhadap penggunaan data AI tanpa izin |
| Oktober 2025 | Reddit menggugat Perplexity | Penegakan aturan semakin luas |
| Maret 2026 | Reddit memperbarui Data API Wiki, Responsible Builder Policy, dan Developer Terms | Tier gratis, aturan persetujuan, dan sikap anti-komersialisasi tetap ketat |
Apa yang Masih Jalan
- Tier gratis Official Data API: Masih tersedia dengan 100 kueri per menit per OAuth client ID, dirata-ratakan selama jendela 10 menit.
- Endpoint ".json": Menambahkan ".json" ke URL Reddit masih mengembalikan data, tetapi dibatasi laju dan memang tidak ditujukan untuk skala besar.
- Scraping berbasis browser: Alat yang membaca halaman yang sudah dirender (seperti Thunderbit atau Octoparse) tidak tunduk pada kuota API dengan cara yang sama.
- Layanan cloud scraping: Platform seperti Apify dan Oxylabs menangani rendering, proxy, dan retry di sisi mereka.
Apa yang Rusak
- Pushshift sebagai sumber histori publik: Praktis hilang. Di 2026, aksesnya terbatas untuk moderator terverifikasi dan penggunaan moderasi saja.
- PRAW untuk pengambilan data skala komersial: Terbatas oleh kuota tier gratis dan syarat Reddit yang lebih luas.
- Workflow apa pun yang mengasumsikan akses API itu default dan penggunaan komersial aman: Sudah ketinggalan zaman.
Dampaknya pada Pemilihan Alat
| Pendekatan | Terdampak Batas API? | Akses Data Historis | Kompleksitas Setup |
|---|---|---|---|
| Reddit API (PRAW) | Ya — batas 1K postingan, rate limit | Terbatas pada yang baru-baru ini | Menengah |
| Endpoint ".json" | Ya — dibatasi laju | Sangat terbatas | Rendah |
| Scraping browser (Thunderbit, Octoparse) | Tidak — membaca halaman yang dirender | Hanya yang terlihat/dapat dimuat | Sangat rendah |
| Layanan cloud scraping (Apify, Oxylabs) | Tidak (mereka menangani proxy) | Bervariasi tergantung penyedia | Rendah–Menengah |
Intinya: alat yang mengutamakan API kini paling cocok untuk developer dan workload yang terukur. Alat berbasis browser dan cloud scraper lebih aman untuk penggunaan non-teknis atau volume tinggi.
No-Code vs Low-Code vs Full-Code: Memilih Pendekatan Scraping Reddit yang Tepat
Audiens pengguna Reddit scraper memang terbagi. Ada yang butuh data Reddit tetapi sama sekali tidak punya dukungan engineering. Ada yang punya operator teknis, tapi bukan tim crawler khusus. Dan ada juga yang menginginkan kontrol penuh di level kode. Pendekatan yang tepat bergantung pada posisi Anda.
Seorang pengguna di r/nocode baru-baru ini menulis: "Saya sedang mengerjakan reddit scrapper tapi saya tidak bisa mendapatkan API key Reddit." Pengguna lain di r/NoCodeSaaS menjelaskan bagaimana mereka membangun dashboard Reddit live dengan Zapier + Airtable + Softr — tanpa kode backend sama sekali. Ini bukan kasus pinggiran. Menurut survei Smarty Marketing terhadap 150 tim marketing internal, 47,8% mengatakan hambatan utama mereka dengan Reddit adalah kurang memahami platform tersebut, sementara 39% khawatir akan diblokir.
Berikut matriks trade-off-nya:
| Faktor | No-Code | Low-Code / API | Full-Code |
|---|---|---|---|
| Waktu setup | Menit | Jam | Jam–Hari |
| Maintenance | Tidak ada (AI beradaptasi) | Rendah (update API) | Tinggi (perubahan layout/API) |
| Batas skala | Menengah | Tinggi | Menengah (rate limit) |
| Kustomisasi | Terbatas | Moderat | Tak terbatas |
| Biaya | Tier gratis → berbayar | Bayar per pemakaian | Gratis (tapi waktu dev) |
No-code (Thunderbit, Browse AI, Octoparse, ScrapeStorm, ParseHub): Paling cocok untuk tim marketing, sales, dan riset. Alur AI 2 klik Thunderbit adalah jalan tercepat di sini.
Low-code / layanan API (Apify, ScrapingBee, Oxylabs, Firecrawl, ScrapeGraphAI): Paling cocok untuk tim yang punya sumber daya teknis dan butuh skala serta manajemen proxy.
Full-code (PRAW, Scrapy): Paling cocok untuk developer yang ingin kontrol maksimal — tetapi harus siap menghadapi pembatasan API dan maintenance berkelanjutan.
Bagaimana Kami Menguji dan Merangking 12 Reddit Scraper Ini
Saya mengevaluasi tiap alat berdasarkan kriteria berikut:
- Kemudahan penggunaan: No-code, low-code, atau full-code?
- Fitur khusus Reddit: Thread komentar, target subreddit, data historis
- Kemampuan menghadapi pembatasan API Reddit saat ini dan deteksi anti-bot
- Model harga dan batas tier gratis
- Opsi ekspor data: CSV, JSON, Sheets, dll.
- Dukungan scraping terjadwal/berulang
- Use case terbaik
Berikut tabel perbandingan utama agar Anda bisa memindai dulu sebelum membaca ulasan satu per satu:
| Alat | Pendekatan | Perlu Kode? | Menangani Batas API? | Komentar Bertingkat | Tier Gratis | Terbaik Untuk |
|---|---|---|---|---|---|---|
| Thunderbit | AI scraper browser/cloud | Tidak | Ya (berbasis browser) | Ya (template subpage + komentar) | Ya — 6 halaman gratis | Pengguna non-teknis, lead gen |
| Apify | Platform actor cloud | Low-code | Ya | Parsial hingga kuat (tergantung actor) | Ya — kredit terbatas | Scraping subreddit dalam jumlah besar |
| PRAW | Wrapper API Python | Full code | Parsial (rate limit API) | Ya (dengan kode) | Ya (tier gratis API) | Developer, proyek kecil |
| Octoparse | Visual scraper | Tidak | Ya (berbasis browser) | Lebih baik dari rata-rata, tapi belum sempurna | Ya | Tim scraping multi-situs |
| Browse AI | Robot siap pakai | Tidak | Ya | Parsial | Ya | Monitoring & pelacakan perubahan |
| ScrapingBee | Layanan API | Low-code | Ya (rotasi proxy) | Tidak ada threading native | Ya — 1K kredit | Developer yang ingin menghindari blok |
| Scrapy | Framework Python | Full code | Tidak (DIY) | Ya (jika Anda membangunnya) | Ya (open-source) | Pipeline kustom skala besar |
| ScrapeStorm | Aplikasi desktop AI | Tidak | Ya (berbasis browser) | Parsial | Ya | Pemula, auto-detection |
| ParseHub | Scraper desktop visual | Tidak | Ya (berbasis browser) | Potensi rekursif yang kuat | Ya — 5 proyek | Struktur halaman yang kompleks |
| Firecrawl | API data web | Low-code | Ya | Parsial | Ya — 500 kredit | Pipeline data AI/LLM |
| Oxylabs | Proxy + API scraping | Low-code | Ya (proxy enterprise) | Parsial | Trial — 2K hasil | Ekstraksi skala enterprise |
| ScrapeGraphAI | Berbasis prompt AI | Low-code | Ya | Parsial | Ya — 50 kredit | Scraping berbasis prompt AI-first |
Sekarang, ulasan per alat.
1. Thunderbit: Reddit Scraper Tanpa Kode Tercepat untuk Tim Bisnis
 Thunderbit adalah AI web scraper yang kami bangun di perusahaan kami, jadi saya tahu kemampuan Reddit-nya luar dalam. Ini ekstensi Chrome yang melakukan scraping Reddit (dan situs apa pun) dalam 2 klik — tanpa kode, tanpa API key, tanpa setup. Ide intinya: AI yang mencari tahu data apa yang ada di halaman, bukan Anda.
Untuk Reddit, Thunderbit menawarkan:
- AI Suggest Fields: Klik tombol di halaman subreddit mana pun dan Thunderbit otomatis mendeteksi kolom seperti Judul Postingan, Penulis, Upvote, Jumlah Komentar, URL, dan Tanggal.
- Scraping subpage: Kunjungi tiap URL postingan untuk mengambil teks lengkap, komentar teratas, flair, dan balasan bertingkat. Begini cara mendapatkan data komentar mendalam tanpa menyentuh API.
- Dedicated Reddit Post Comments Scraper: Thunderbit punya template komentar Reddit yang mengekstrak semua komentar, tautan thread, jumlah balasan, dan komentar bertingkat dari URL postingan.
- Pagination dan infinite scroll: Menangani perilaku "load more" Reddit secara otomatis lewat dokumentasi pagination.
- Cloud Scraping: Untuk halaman Reddit publik, Cloud Scraping memproses hingga 50 halaman sekaligus demi kecepatan.
- Ekspor gratis: Kirim data ke Excel, Google Sheets, Airtable, Notion, CSV, atau JSON — tanpa paywall untuk ekspor.
- Scraping terjadwal: Ketik jadwal dalam bahasa natural (misalnya, "setiap Senin jam 9 pagi"), masukkan URL subreddit, dan data diekspor otomatis ke tujuan Anda.
Harga: Tier gratis (6 halaman), lalu paket berbayar berbasis kredit mulai dari sekitar ~$9/bulan. Lihat harga Thunderbit.
Terbaik untuk: Tim sales, marketing, dan operasional non-teknis yang butuh data Reddit dengan cepat. Juga kuat untuk analisis thread bernilai tinggi saat Anda ingin data komentar yang sudah dirender penuh dari halaman postingan individual.
Cara Scrape Subreddit dengan Thunderbit dalam 5 Langkah
- Instal ekstensi Chrome Thunderbit dan buka sebuah subreddit (misalnya, r/SaaS).
- Klik "AI Suggest Fields" — Thunderbit otomatis mendeteksi kolom: Judul Postingan, Penulis, Upvote, Jumlah Komentar, URL, Tanggal.
- Klik "Scrape" — data muncul dalam hitungan detik. Gunakan Cloud Scraping untuk kecepatan di halaman publik.
- Klik "Scrape Subpages" untuk memperkaya data — AI membuka tiap URL postingan dan mengambil teks lengkap, komentar teratas, flair, dan balasan bertingkat.
- Ekspor ke Google Sheets, Excel, Airtable, atau Notion — sepenuhnya gratis.
Untuk walkthrough tentang tampilannya dalam praktik, lihat kanal YouTube Thunderbit.
Lebih suka kode? Berikut padanannya dalam PRAW dalam sekitar 15 baris Python:
import praw

reddit = praw.Reddit(
    client_id="YOUR_ID",
    client_secret="YOUR_SECRET",
    user_agent="reddit-scraper-demo/0.1"
)

subreddit = reddit.subreddit("SaaS")
for post in subreddit.hot(limit=10):
    print(post.title, post.score, post.num_comments, post.permalink)
Thunderbit butuh sekitar 30 detik dan nol baris kode. PRAW berarti menyiapkan kredensial API, menulis skrip, dan menghadapi rate limit. Keduanya punya tempatnya masing-masing — tetapi untuk sebagian besar pengguna bisnis, jalur 2 klik menang.
2. Apify Reddit Scraper: Ekstraksi Subreddit Massal Bertenaga Cloud
 Apify adalah platform cloud scraping, bukan satu alat Reddit tertentu. Platform ini menampung "Actors" buatan komunitas — scraper siap pakai yang bisa dijalankan di infrastruktur Apify dengan rotasi proxy dan anti-blocking bawaan.
- Actor khusus Reddit: Ada banyak opsi, termasuk Reddit Scraper milik prodiger (mulai dari sekitar ~$0,60/1K postingan) dan Reddit Scraper milik trudax. Keduanya mendukung listing subreddit (hot, new, top, rising), pencarian kata kunci, profil pengguna, dan filter waktu.
- Komentar bertingkat: Apify punya actor Reddit Comments Deep Scraper khusus dengan kedalaman yang bisa dikonfigurasi serta field induk-anak — salah satu opsi terkuat untuk ekstraksi thread mendalam.
- Penjadwalan: Scheduler gaya cron bawaan di paket berbayar.
- Ekspor: JSON, CSV, XML, Excel, HTML Table, RSS, JSONL plus integrasi API dan webhook.
- Harga: Tier gratis (kredit sekitar ~$5/bulan, ~1K hasil); paket berbayar mulai $49/bulan.
Terbaik untuk: Tim yang membutuhkan pengumpulan data Reddit yang skalabel dan berulang dengan sumber daya teknis tertentu. Jika Anda butuh pohon komentar yang dalam dalam skala besar, actor deep scraper khusus ini benar-benar pembeda.
Catatan: Kualitas dan harga bervariasi antar actor, jadi uji dulu sebelum berkomitmen ke satu workflow.
3. PRAW (Python Reddit API Wrapper): Andalan Developer, dengan Batasan
 PRAW masih menjadi wrapper API Reddit standar yang mengutamakan kode. Kalau Anda developer Python, ini mungkin alat pertama yang akan Anda pakai — dan untuk proyek kecil yang terukur, alat ini masih berfungsi dengan baik. Tapi di 2026, posisinya ada di kategori "alat developer untuk workload terukur", bukan jawaban universal.
- Rilis terbaru: v7.8.1 (Oktober 2024)
- Fitur utama: Akses semua endpoint API (submission, komentar, info pengguna); streaming postingan real-time; menelusuri seluruh pohon komentar dengan
replace_more() - Keterbatasan kritis: Tunduk pada rate limit API Reddit (100 kueri/menit tier gratis), batas 1K postingan per listing, dan penegakan ToS yang lebih ketat sejak 2023. PRAW sendiri memperingatkan bahwa lebih dari "sekitar selusin" instance bersamaan bisa kena rate limit.
- Ekspor: Apa pun yang Anda buat sendiri (CSV, JSON, database, dll.)
- Penjadwalan: DIY lewat cron job (butuh server dan maintenance)
- Harga: Gratis dan open-source, tetapi penggunaan komersial mungkin memerlukan tier API berbayar Reddit.
Terbaik untuk: Developer Python dan data scientist yang membutuhkan integrasi Reddit kustom untuk proyek kecil hingga menengah dan bisa hidup dengan batas API.
4. Octoparse: Scraping Reddit Visual Klik-Pilih
 Octoparse adalah web scraper visual tanpa kode dengan antarmuka klik-pilih. Tidak seperti banyak scraper visual generik, Octoparse benar-benar punya template Reddit Scraper publik — yang penting, karena struktur halaman Reddit menjebak banyak alat.
- Template Reddit: Membutuhkan
old.reddit.com, mendukung hingga 1.000 URL postingan Reddit per run, dan bisa mengekstrak thread komentar/balasan. Template ini memperingatkan soal komentar yang diciutkan atau "load more" yang mungkin terlewat. Untuk perbandingan lebih dalam, lihat ulasan dan alternatif Octoparse. - Pagination dan infinite scroll: Didukung, meski loading dinamis Reddit tetap bisa tricky.
- Ekspor: CSV, Excel, JSON, HTML, XML, database, Google Sheets.
- Penjadwalan: Tersedia di paket berbayar, dengan monitoring dan task parent-child.
- Harga: Paket gratis mencakup 10 task, 2 run bersamaan, dan hingga 10.000 baris per ekspor. Paket berbayar mulai sekitar $69–$75/bulan.
Terbaik untuk: Tim yang butuh alat scraping serbaguna untuk Reddit dan situs lain tanpa coding. Template Reddit adalah keunggulan nyata dibanding visual scraper generik.
5. Browse AI: Robot Reddit Siap Pakai dengan Monitoring Perubahan
 Browse AI mengambil pendekatan berbeda: alih-alih membangun scraper dari nol, Anda menggunakan "robot" siap pakai yang dirancang untuk situs tertentu. Untuk Reddit, Browse AI secara eksplisit mencantumkan scraper homepage Reddit dan subreddit, scraper hasil pencarian Reddit, serta automasi monitoring Reddit.
- Monitoring: Buat alert untuk postingan baru, penyebutan kata kunci, atau perubahan di subreddit tertentu. Penjadwalan mendukung pola per jam, harian, mingguan, bulanan, atau kustom.
- Integrasi: CSV, JSON, Google Sheets, Airtable, Zapier, Make, API, dan webhook.
- Harga: Tier gratis mencakup 50 kredit/bulan, 2 situs web, dan 3 pengguna. Paket berbayar mulai sekitar $49/bulan.
Terbaik untuk: Pengguna non-teknis yang ingin monitoring Reddit otomatis tanpa pekerjaan manual. Kuat untuk pelacakan merek dan alert kompetitor. Untuk info lebih lanjut soal alat ini, lihat ulasan dan alternatif Browse AI.
Catatan: Saya tidak menemukan bukti publik terbaru yang menunjukkan kemampuan merekonstruksi pohon balasan bertingkat secara mendalam, jadi paling tepat disebut kuat untuk monitoring dan ekstraksi level postingan, tetapi hanya parsial untuk komentar mendalam.
6. ScrapingBee: Scraping Reddit Berbasis API dengan Manajemen Proxy
 ScrapingBee bukan produk khusus Reddit. Ini API scraping serbaguna yang menangani headless browser, rotasi proxy, dan penyelesaian CAPTCHA. Anda mengirim URL, lalu menerima HTML bersih, Markdown, atau JSON hasil ekstraksi.
- Rendering JavaScript: Menangani halaman dinamis Reddit.
- Rotasi proxy: Otomatis, untuk menghindari blok.
- Format output: HTML, Markdown, plain text, JSON ter-ekstrak.
- Tidak ada scheduler bawaan: Integrasikan dengan cron atau alat automasi.
- Harga: Trial gratis dengan 1.000 kredit API, tanpa perlu kartu. Paket mulai $49/bulan.
Terbaik untuk: Developer yang ingin akses halaman Reddit yang andal tanpa harus mengelola proxy sendiri. Bukan alat yang spesifik untuk Reddit — tidak ada parser Reddit bawaan atau threading komentar. Untuk uraian lengkap, lihat ulasan dan alternatif ScrapingBee.
7. Scrapy: Framework Python Open-Source untuk Pipeline Reddit Kustom
 Scrapy adalah opsi paling fleksibel jika tim Anda ingin menguasai seluruh stack crawling. Ini framework Python open-source yang kuat dengan 61,4K bintang GitHub, dan rilis terbarunya adalah v2.15.0 (April 2026).
- Pemrosesan asinkron: Crawling cepat dengan selector XPath/CSS untuk targeting presisi.
- Dapat diperluas: Middleware dan pipeline untuk pagination, penelusuran komentar, pembersihan data, rotasi proxy, manajemen user-agent, dan AutoThrottle.
- Ekspor: JSON, JSON Lines, CSV, XML, Pickle, dan Marshal.
- Pertimbangan kritis: Scrapy tidak menangani proteksi anti-bot Reddit secara bawaan. Anda perlu menambahkan rotasi proxy, manajemen user-agent, dan rate limiting sendiri.
- Harga: Gratis dan open-source.
Terbaik untuk: Developer Python berpengalaman yang membangun sistem scraping Reddit kustom skala besar. Jika Anda ingin kontrol maksimum dan sanggup menanggung maintenance, Scrapy sulit dikalahkan. Untuk perbandingan alat scraping Python, lihat panduan alat web scraping Python terbaik kami.
8. ScrapeStorm: Reddit Scraper Desktop Berbasis AI untuk Pemula
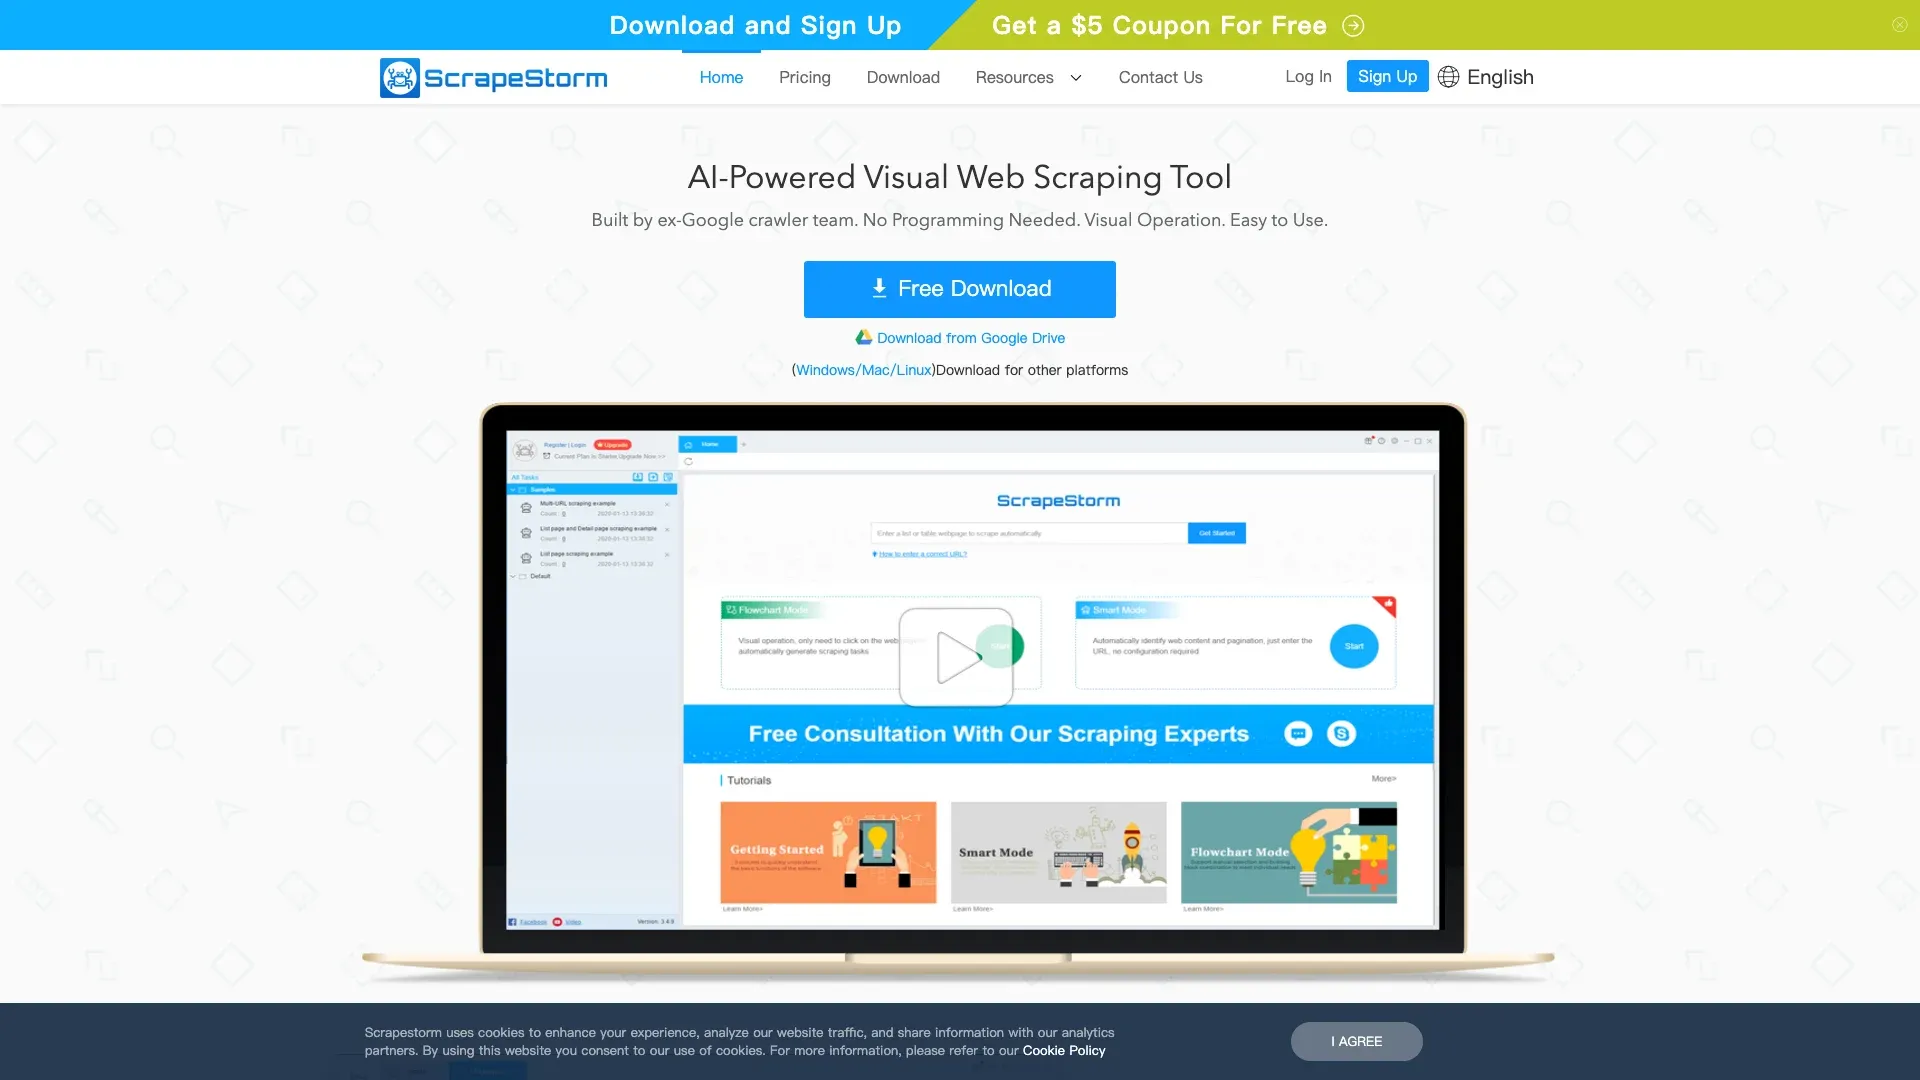 ScrapeStorm adalah aplikasi desktop berbasis AI yang otomatis mendeteksi pola data di halaman web mana pun. Versi saat ini adalah v4.0.6 (Desember 2025).
- Deteksi otomatis: AI mengenali data postingan (judul, skor, penulis) tanpa konfigurasi manual.
- Antarmuka visual: Sempurnakan pilihan, atur scraping terjadwal (per jam/harian/mingguan), dan ekspor ke Excel, TXT, CSV, HTML, database, dan Google Sheets.
- Harga: Tier gratis selamanya; paket berbayar mulai $49,99/bulan.
Terbaik untuk: Pemula yang ingin scraping Reddit dengan bantuan AI tanpa kode atau setup rumit. Untuk ulasan lebih dalam, lihat ulasan dan alternatif ScrapeStorm.
Catatan: Saya tidak menemukan dokumentasi khusus Reddit yang membuktikan ekstraksi komentar bertingkat secara mendalam. Bagus untuk scraping level permukaan, tetapi kedalaman thread kemungkinan terbatas kecuali Anda membangun workflow flowchart yang hati-hati.
9. ParseHub: Scraper Desktop Visual untuk Halaman Reddit yang Kompleks
 ParseHub adalah aplikasi desktop dengan antarmuka visual klik-pilih yang menangani halaman berat JavaScript dan halaman yang dimuat dinamis. Alat ini menonjol dibanding banyak tool no-code karena dukungan eksplisitnya untuk pola ekstraksi rekursif/bertingkat.
- Data bertingkat: ParseHub mendokumentasikan fitur Jump, Relative Select, dan CSV Wide untuk menangani ekstraksi thread komentar — lebih kuat daripada kebanyakan tool DOM no-code jika Anda mau meluangkan waktu mempelajari builder-nya.
- Penjadwalan: Bisa berjalan sesering setiap menit di paket berbayar.
- Ekspor: CSV, JSON, Excel, akses API.
- Harga: Gratis hingga 5 proyek; berbayar mulai sekitar ~$89/bulan.
Terbaik untuk: Pengguna yang perlu mengekstrak struktur halaman Reddit yang kompleks dan berat JavaScript tanpa coding — terutama jika Anda mau belajar fitur lanjutan builder visualnya. Lihat ulasan dan alternatif ParseHub kami untuk detail tambahan.
10. Firecrawl: API Data Web untuk Pipeline AI dan LLM
 Firecrawl adalah API yang dirancang untuk merayapi dan mengubah halaman web apa pun menjadi Markdown bersih atau data terstruktur, dioptimalkan untuk memasok data ke aplikasi AI/LLM. Ini bukan scraper native Reddit, tetapi jika tujuan Anda adalah memasukkan konten Reddit ke pipeline RAG atau knowledge base, ini cocok kuat.
- Format output: Markdown, HTML, screenshot, link, JSON, gambar, branding, audio. Ekstraksi JSON membutuhkan lebih banyak kredit.
- Routing proxy dan rendering JS: Didokumentasikan dan ditangani.
- Tidak ada scheduler bawaan: Integrasikan dengan alat automasi.
- Harga: Tier gratis dengan 500 kredit sekali pakai; berbayar mulai sekitar ~$16/bulan.
Terbaik untuk: Tim teknis yang memasukkan data Reddit ke model AI, pipeline RAG, atau knowledge base. Untuk perbandingan lebih dalam, lihat ulasan dan alternatif Firecrawl.
Catatan: Tidak ada threading komentar Reddit native — hasilnya berupa konten halaman sebagai Markdown atau JSON terstruktur. Kuat untuk pengambilan konten, bukan untuk analisis thread bertingkat.
11. Oxylabs: Scraping Reddit Kelas Enterprise dengan Infrastruktur Proxy
 Oxylabs adalah layanan web scraping dan proxy yang berfokus pada enterprise. Mereka menyediakan proxy mentah maupun Web Scraper API terstruktur dengan penjadwalan, pengiriman cloud, dan kumpulan proxy yang sangat besar.
- Skala: Memasarkan 177 juta+ IP di 195 negara dan 15.000+ partner.
- Scheduler: Terdokumentasi; job berulang dapat dikirim ke AWS S3 atau GCS.
- Rating G2: 4,5/5 dari 425 ulasan.
- Harga: Trial gratis hingga 2.000 hasil; Web Scraper API mulai $49/bulan. Harga enterprise meningkat dari sana.
Terbaik untuk: Perusahaan besar atau agensi yang membutuhkan ekstraksi data Reddit volume tinggi dan andal dalam skala besar. Untuk ulasan lengkap, lihat ulasan dan alternatif Oxylabs.
Catatan: Saya tidak menemukan template atau parser Oxylabs khusus Reddit. Ini pendekatan infrastruktur — sangat kuat, tetapi logika spesifik Reddit-nya Anda bangun sendiri.
12. ScrapeGraphAI: Ekstraksi Reddit Berbasis Prompt dengan AI
 ScrapeGraphAI adalah salah satu entri AI-first yang lebih baru. Anda menjelaskan apa yang ingin diekstrak dengan bahasa Inggris biasa, lalu AI mengurus sisanya — tanpa selector, tanpa schema.
- GitHub: 21,9K bintang.
- Output: JSON, CSV, Markdown.
- Harga: Tier gratis dengan 50 kredit API dan 10 req/menit; berbayar mulai sekitar ~$17/bulan.
Terbaik untuk: Pengguna yang ingin scraping Reddit berbasis prompt AI-first tanpa mendefinisikan selector atau schema secara manual. Untuk info lebih lanjut, lihat ulasan dan alternatif ScrapeGraphAI.
Catatan: Saya tidak menemukan dokumentasi publik khusus Reddit yang menguji ketepatan thread komentarnya. Ini extractor berbasis prompt generik yang kuat, bukan spesialis yang dioptimalkan untuk Reddit.
Masalah Komentar Bertingkat: Scraper Mana yang Mampu Menangani Thread Dalam
Ini bagian yang paling sering dilewati daftar "best Reddit scraper", padahal justru paling penting untuk riset serius. Percakapan di Reddit berbentuk pohon, dan struktur itu punya makna analitis. Sebuah paper 2024 di Applied Network Science menemukan bahwa pemodelan struktur thread hierarkis Reddit penting untuk memahami fenomena sosial. Sebuah preprint 2022 melaporkan kedalaman komentar median 3 dan maksimum 828.
Kalau Anda melakukan sentiment analysis, pengumpulan data pelatihan AI, atau riset kualitatif, Anda butuh seluruh pohon komentar — bukan hanya balasan level atas. Kebanyakan scraper meratakan komentar karena mereka hanya membaca DOM yang terlihat atau parameter default dari API.
Begini perbandingannya:
| Alat | Kedalaman Komentar | Metode |
|---|---|---|
| PRAW | Seluruh pohon (dengan kode) | Panggilan API replace_more() — memakan rate limit |
| Apify Deep Scraper | Seluruh pohon | Actor khusus |
| Thunderbit | Seluruh thread yang terlihat | Template komentar Reddit + scraping subpage pada URL postingan individual |
| ParseHub | Potensi rekursif yang kuat | Relative Select + Jump + CSV Wide |
| Octoparse | Lebih baik dari rata-rata, tapi belum sempurna | Template Reddit dengan ekstraksi komentar/balasan; bisa melewatkan kasus yang diciutkan/load more |
| Browse AI | Parsial | Bagus untuk monitoring, bukti kedalaman rekursif lebih lemah |
| ScrapeStorm | Parsial | Ekstraksi DOM/browser generik |
| Firecrawl | Parsial | Bagus untuk pengambilan konten, bukan spesialis pohon thread |
| Oxylabs | Parsial | Bisa dibangun lewat instruksi browser, tanpa docs spesifik Reddit |
| ScrapeGraphAI | Parsial | Ekstraksi prompt/schema pada konten yang sudah dirender |
Saran praktis: Untuk scraping massal level subreddit, data yang diratakan sering kali sudah cukup. Untuk thread bernilai tinggi tertentu (umpan balik produk, riset pasar, intel kompetitor), gunakan alat yang membuka halaman postingan individual dan mengekstrak seluruh thread komentar yang sudah dirender.
Monitoring Reddit yang Praktis dan Otomatis: Scraping Terjadwal untuk Intel Brand dan Pasar
Bagi banyak tim bisnis, pertanyaan sebenarnya bukan "Bisa scrape Reddit sekali?" — melainkan "Bisa nggak terus menarik penyebutan brand dan kompetitor setiap hari tanpa harus terus diawasi?" Seorang pengguna di r/NoCodeSaaS menjelaskan bagaimana mereka membangun dashboard data Reddit live dengan Zapier + Airtable + Softr untuk statistik subreddit dan tren pertumbuhan, semuanya tanpa menulis kode backend. Itulah jenis workflow yang dimungkinkan oleh scraping terjadwal.
Use Case
- Melacak penyebutan brand Anda atau kompetitor di r/SaaS, r/ecommerce, r/startups
- Memantau diskusi harga dan perbandingan produk
- Menemukan lead baru yang meminta rekomendasi di subreddit niche
- Mengirim ringkasan Reddit mingguan ke Slack atau email untuk tim Anda
Perbandingan Alat
| Alat | Penjadwalan Bawaan | Tingkat Kesulitan Setup | Auto-Export |
|---|---|---|---|
| Thunderbit | Ya — penjadwalan bahasa natural | Sangat mudah | Sheets, Airtable, Notion, CSV, JSON |
| Apify | Ya — scheduler gaya cron | Menengah | Dataset, API, webhook |
| Browse AI | Ya — robot monitoring | Mudah | CSV, JSON, Sheets, Airtable, integrasi |
| PRAW + cron | Hanya DIY | Sulit (server, maintenance) | Apa pun yang Anda kodekan |
| Octoparse | Ya (paket berbayar) | Menengah | CSV, Excel, JSON, database, Sheets |
| ParseHub | Ya (paket berbayar) | Menengah | CSV, JSON, API |
Scheduled scraper Thunderbit memungkinkan Anda mengetik sesuatu seperti "setiap Senin jam 9 pagi," memasukkan URL subreddit Anda, lalu mengklik Schedule. Data otomatis diekspor ke Sheets, Airtable, atau Notion sehingga tim Anda bisa menyiapkan alert atau dashboard tanpa perlu menyentuh scraper lagi. Untuk pembahasan lebih lanjut tentang mengotomatiskan pengumpulan data web, kami sudah menulis panduan terpisah.
Perbandingan Berdampingan: Semua 12 Reddit Scraper Sekilas
| Alat | Pendekatan | Perlu Kode | Menangani Batas API? | Komentar Bertingkat | Tier Gratis | Harga Awal | Terbaik Untuk |
|---|---|---|---|---|---|---|---|
| Thunderbit | AI scraper browser/cloud | Tidak | Ya | Kuat (template komentar + subpage) | Ya | Gratis / ~$9/bulan | Tim bisnis non-teknis |
| Apify | Platform actor | Low | Ya | Parsial hingga kuat | Ya (kredit terbatas) | Tergantung actor / $49/bulan | Scraping subreddit massal |
| PRAW | Wrapper API | Ya | Parsial | Ya | Ya | Gratis | Developer, data scientist |
| Octoparse | Scraper visual | Tidak | Ya | Lebih baik dari rata-rata, belum sempurna | Ya | ~$69–$75/bulan | Scraping no-code multi-situs |
| Browse AI | Robot monitoring | Tidak | Ya | Parsial | Ya | ~$49/bulan | Monitoring dan alert |
| ScrapingBee | Layanan API | Low | Ya | Tidak ada threading native | Ya (1K kredit) | $49/bulan | Dev yang ingin menghindari manajemen proxy |
| Scrapy | Framework Python | Ya | Tidak (DIY) | Ya (jika Anda membangunnya) | Ya | Gratis | Pipeline kustom penuh kontrol |
| ScrapeStorm | Aplikasi desktop AI | Tidak | Ya | Parsial | Ya | $49,99/bulan | Pemula |
| ParseHub | Scraper desktop visual | Tidak | Ya | Potensi rekursif yang kuat | Ya (5 proyek) | ~$89/bulan | Halaman dinamis yang kompleks |
| Firecrawl | API data web | Low | Ya | Parsial | Ya (500 kredit) | ~$16/bulan | Pipeline AI/LLM |
| Oxylabs | API scraping web + proxy | Low–Menengah | Ya | Parsial | Trial (2K hasil) | $49/bulan | Skala enterprise |
| ScrapeGraphAI | Berbasis prompt AI | Low–Menengah | Ya | Parsial | Ya (50 kredit) | ~$17/bulan | Workflow AI berbasis prompt |
Ada beberapa pola yang langsung terlihat. Alat no-code menang dalam kecepatan dan aksesibilitas. Alat berbasis kode menang dalam kustomisasi. Alat cloud API menang dalam skala.
Untuk kedalaman spesifik Reddit — terutama komentar bertingkat — hanya segelintir alat yang benar-benar unggul: PRAW, deep scraper milik Apify, template komentar Thunderbit, dan ekstraksi rekursif ParseHub.
Cara Memilih Reddit Scraper Terbaik untuk Tim Anda
Setelah menguji semuanya, ini urutan yang saya sarankan:
- Tim sales atau marketing tanpa developer? Mulai dengan Thunderbit atau Browse AI. Thunderbit paling cepat untuk scraping sekali pakai maupun terjadwal; Browse AI paling kuat untuk alert monitoring.
- Butuh data subreddit dalam jumlah besar dengan sumber daya teknis tertentu? Apify atau Oxylabs. Ekosistem actor Apify memberi opsi khusus Reddit; Oxylabs menyediakan infrastruktur kelas enterprise.
- Developer yang membangun pipeline kustom? PRAW atau Scrapy. PRAW untuk workflow API-first; Scrapy untuk crawling penuh kontrol. Sisihkan anggaran untuk maintenance dan manajemen rate limit.
- Data Reddit untuk aplikasi AI/LLM? Firecrawl, ScrapeGraphAI, atau API Thunderbit. Firecrawl unggul untuk output Markdown dalam RAG; ScrapeGraphAI bagus untuk ekstraksi berbasis prompt.
- Monitoring dan alert berkelanjutan? Thunderbit Scheduled Scraper, Browse AI, atau jadwal Apify.
Catatan Singkat tentang Legal dan Etika
Syarat Reddit sekarang lebih ketat. Penggunaan API komersial memerlukan persetujuan, Pushshift bukan lagi arsip publik, dan Reddit aktif menggugat perusahaan untuk scraping tanpa izin. Scraping halaman publik secara teknis memungkinkan, tetapi risikonya pada kebijakan tetap nyata. Jika tim Anda mengumpulkan data pribadi, menyimpan konten yang dihapus, atau membangun monitoring komersial dalam skala besar, tinjauan hukum sangat disarankan. Selalu patuhi User Agreement Reddit dan Developer Terms.
Penutup
Data Reddit lebih bernilai dari sebelumnya — dan lebih sulit diakses dari sebelumnya. Alat yang bekerja di 2022 tidak semuanya masih bekerja di 2026.
Pendekatan yang mengutamakan API kini dibatasi oleh rate limit dan pembatasan komersial. Alat berbasis browser dan cloud scraping telah menjadi default praktis untuk sebagian besar tim bisnis.
Kalau Anda ingin melihat seperti apa scraping Reddit modern tanpa menulis satu baris kode pun, coba trial gratis Thunderbit. Dan kalau Thunderbit bukan pilihan yang paling pas, coba beberapa alat lain dari daftar ini. Scraper terbaik adalah yang benar-benar memberi Anda data yang dibutuhkan, tepat waktu, tanpa menghabiskan akhir pekan Anda.
Selamat scraping — dan semoga pohon komentar Anda selalu terbuka sepenuhnya.
Coba Thunderbit untuk Scraping Reddit Get Started Free
FAQ
1. Apakah legal melakukan scraping Reddit di 2026?
User Agreement Reddit dan Developer Terms dengan jelas membatasi scraping tanpa persetujuan tertulis, dan penggunaan API komersial memerlukan persetujuan. Reddit telah menggugat perusahaan seperti Anthropic dan Perplexity atas penggunaan data tanpa izin. Akses halaman publik secara teknis memungkinkan, tetapi risiko kebijakan dan litigasinya nyata. Jika Anda melakukan scraping dalam skala besar atau untuk tujuan komersial, tinjauan hukum sangat disarankan.
2. Bisakah Anda scrape Reddit tanpa coding?
Ya. Opsi no-code terkuat di 2026 adalah Thunderbit, Browse AI, Octoparse, ScrapeStorm, dan ParseHub. Alur AI 2 klik Thunderbit adalah jalan tercepat untuk pengguna non-teknis — tanpa API key, tanpa setup, tanpa skrip.
3. Apa Reddit scraper gratis terbaik?
Untuk developer, PRAW masih menjadi opsi berbasis kode gratis terbaik (dengan batas API). Untuk pengguna non-teknis, Thunderbit, Browse AI, dan Octoparse semuanya menawarkan tier gratis yang cukup berguna. Thunderbit memberi Anda 6 halaman gratis dengan ekspor penuh ke Sheets, Excel, Airtable, dan Notion.
4. Bagaimana cara melewati batas 1.000 postingan Reddit?
Secara umum Anda tidak bisa melewatinya dengan rapi lewat API resmi — batas itu masih menjadi kendala praktis untuk workflow API bergaya listing. Scraping berbasis browser (Thunderbit, Octoparse), pendekatan actor cloud (Apify), atau kueri yang lebih sempit dan tertarget adalah alternatif yang lebih realistis. Untuk data historis yang dalam, workaround Pushshift lama sudah tidak tersedia lagi.
5. Bisakah saya scrape komentar Reddit bersama postingannya?
Bisa, tetapi kualitas alat sangat bervariasi. PRAW dapat menelusuri seluruh pohon komentar (dengan konsekuensi rate limit API). Reddit Comments Deep Scraper milik Apify memang dibuat khusus untuk ini. Template komentar Reddit milik Thunderbit dan scraping subpage mengekstrak seluruh thread komentar yang sudah dirender dari halaman postingan individual. Ekstraksi rekursif ParseHub juga bisa menangani komentar bertingkat jika dikonfigurasi dengan hati-hati.
Pelajari Lebih Lanjut



