
Webová data jsou pro byznys nová ropa, ale dostat je ze země je úplně jiný příběh. Na vlastní oči vidím, jak jsou obchodní týmy, provozní lidé v e-commerce i market research pod tlakem dodávat poznatky rychleji než kdy dřív — a staré kopírování a vkládání už prostě nestačí. Podle Gartneru muselo 61 % organizací kvůli dopadu AI zásadně předělat své datové a analytické procesy, zatímco 80 % byznys lídrů říká, že data jsou dnes pro rozhodování zásadní. Háček? Většina týmů se pořád potýká se získáváním externích signálů z trhu, které potřebuje — a právě tady přichází ke slovu web scraping.
Získejte data z libovolného webu pomocí AI Get Started Free
Ale pojďme na rovinu: ne každý web scraper je stejný. Nástup nástrojů jako ClawdBot mění pravidla hry pro byznys uživatele, kteří chtějí automatizovat sběr dat, strukturovat chaotické webové informace a skutečně je využít k výsledkům. Krátké upřesnění názvu: ClawdBot byl koncem ledna 2026 kvůli sporu o ochrannou známku s Anthropic přejmenován na Moltbot a pak zhruba o tři dny později znovu přejmenován na OpenClaw (2026-01-30), když se projekt posunul směrem k open source. Návod níže používá aktuální název openclaw v instalačních příkazech i v CLI; v textu ale dál říkám „ClawdBot“, protože tak ho většina čtenářů hledala, a samotný nástroj je pořád tentýž. A když ClawdBot zkombinujete s AI poháněnými pomocníky, jako je Thunderbit, otevře se vám úplně nová úroveň efektivity a přesnosti.
Pojďme se podívat, proč je ClawdBot Web Scraping tak silný, jak s ním začít a jak ho spojit s Thunderbitem pro firemní úspěch.
Co je ClawdBot Web Scraping? Vaše brána k chytřejším firemním datům
ClawdBot je v jádru platforma osobního AI agenta, která umí automatizovat webové úlohy, získávat informace a strukturovat data — bez toho, abyste museli být vývojář. Berte ho jako svého digitálního výzkumného asistenta, který dokáže běžet v prohlížeči, ovládat karty v Chrome a plánovat scrapingové úlohy tak, aby běžely samy na autopilota.
Hlavní schopnosti:
- Automatické získávání dat: Nástroj „web_fetch“ v ClawdBotu umí vytáhnout obsah ze statických webových stránek a převést ho do čitelného, strukturovaného textu nebo markdownu. U interaktivnějších či dynamičtějších webů jeho nástroj „browser“ skutečně ovládá kartu v Chrome, kliká na tlačítka, vyplňuje formuláře a dokonce pořizuje snímky obrazovky.
- Práce se strukturovanými i nestrukturovanými daty: Ať už scrapujete přehlednou tabulku produktů, nebo chaotický blogový článek, ClawdBot data umí vytáhnout, vyčistit a naformátovat za vás.
- Uživatelsky přívětivé rozhraní: Díky dashboardu a rozšíření do Chrome můžete nastavit scrapingové projekty, naplánovat jejich spuštění v libovolném intervalu a doručovat výsledky přímo do Slacku, Telegramu nebo e-mailu.
V čem ClawdBot vyniká:
- Na rozdíl od tradičních scraperů, které vyžadují kódování nebo striktní šablony, je ClawdBot konverzační a agentní. Můžete mu prostě česky nebo anglicky říct, co chcete, a on si sám najde kroky.
- Rozšíření pro Chrome vám umožní ovládat skutečné karty v prohlížeči, což usnadňuje scraping webů, které vyžadují přihlášení nebo ruční navigaci.
- Vestavěné plánování (cron úlohy) znamená, že můžete automatizovat opakované scrapingy — ideální pro hlídání cen, aktualizace leadů nebo denní reporty.
Zpětná vazba uživatelů:
- MacStories i Tom’s Hardware vyzdvihují schopnost ClawdBotu „dělat věci jako skutečný asistent“ — nejen získávat data, ale automatizovat celé workflow.
- Uživatelé z komunity oceňují jeho flexibilitu a to, že „působí jako junior analytik na telefonu“.
Proč je ClawdBot Web Scraping pro firemní týmy nepostradatelný
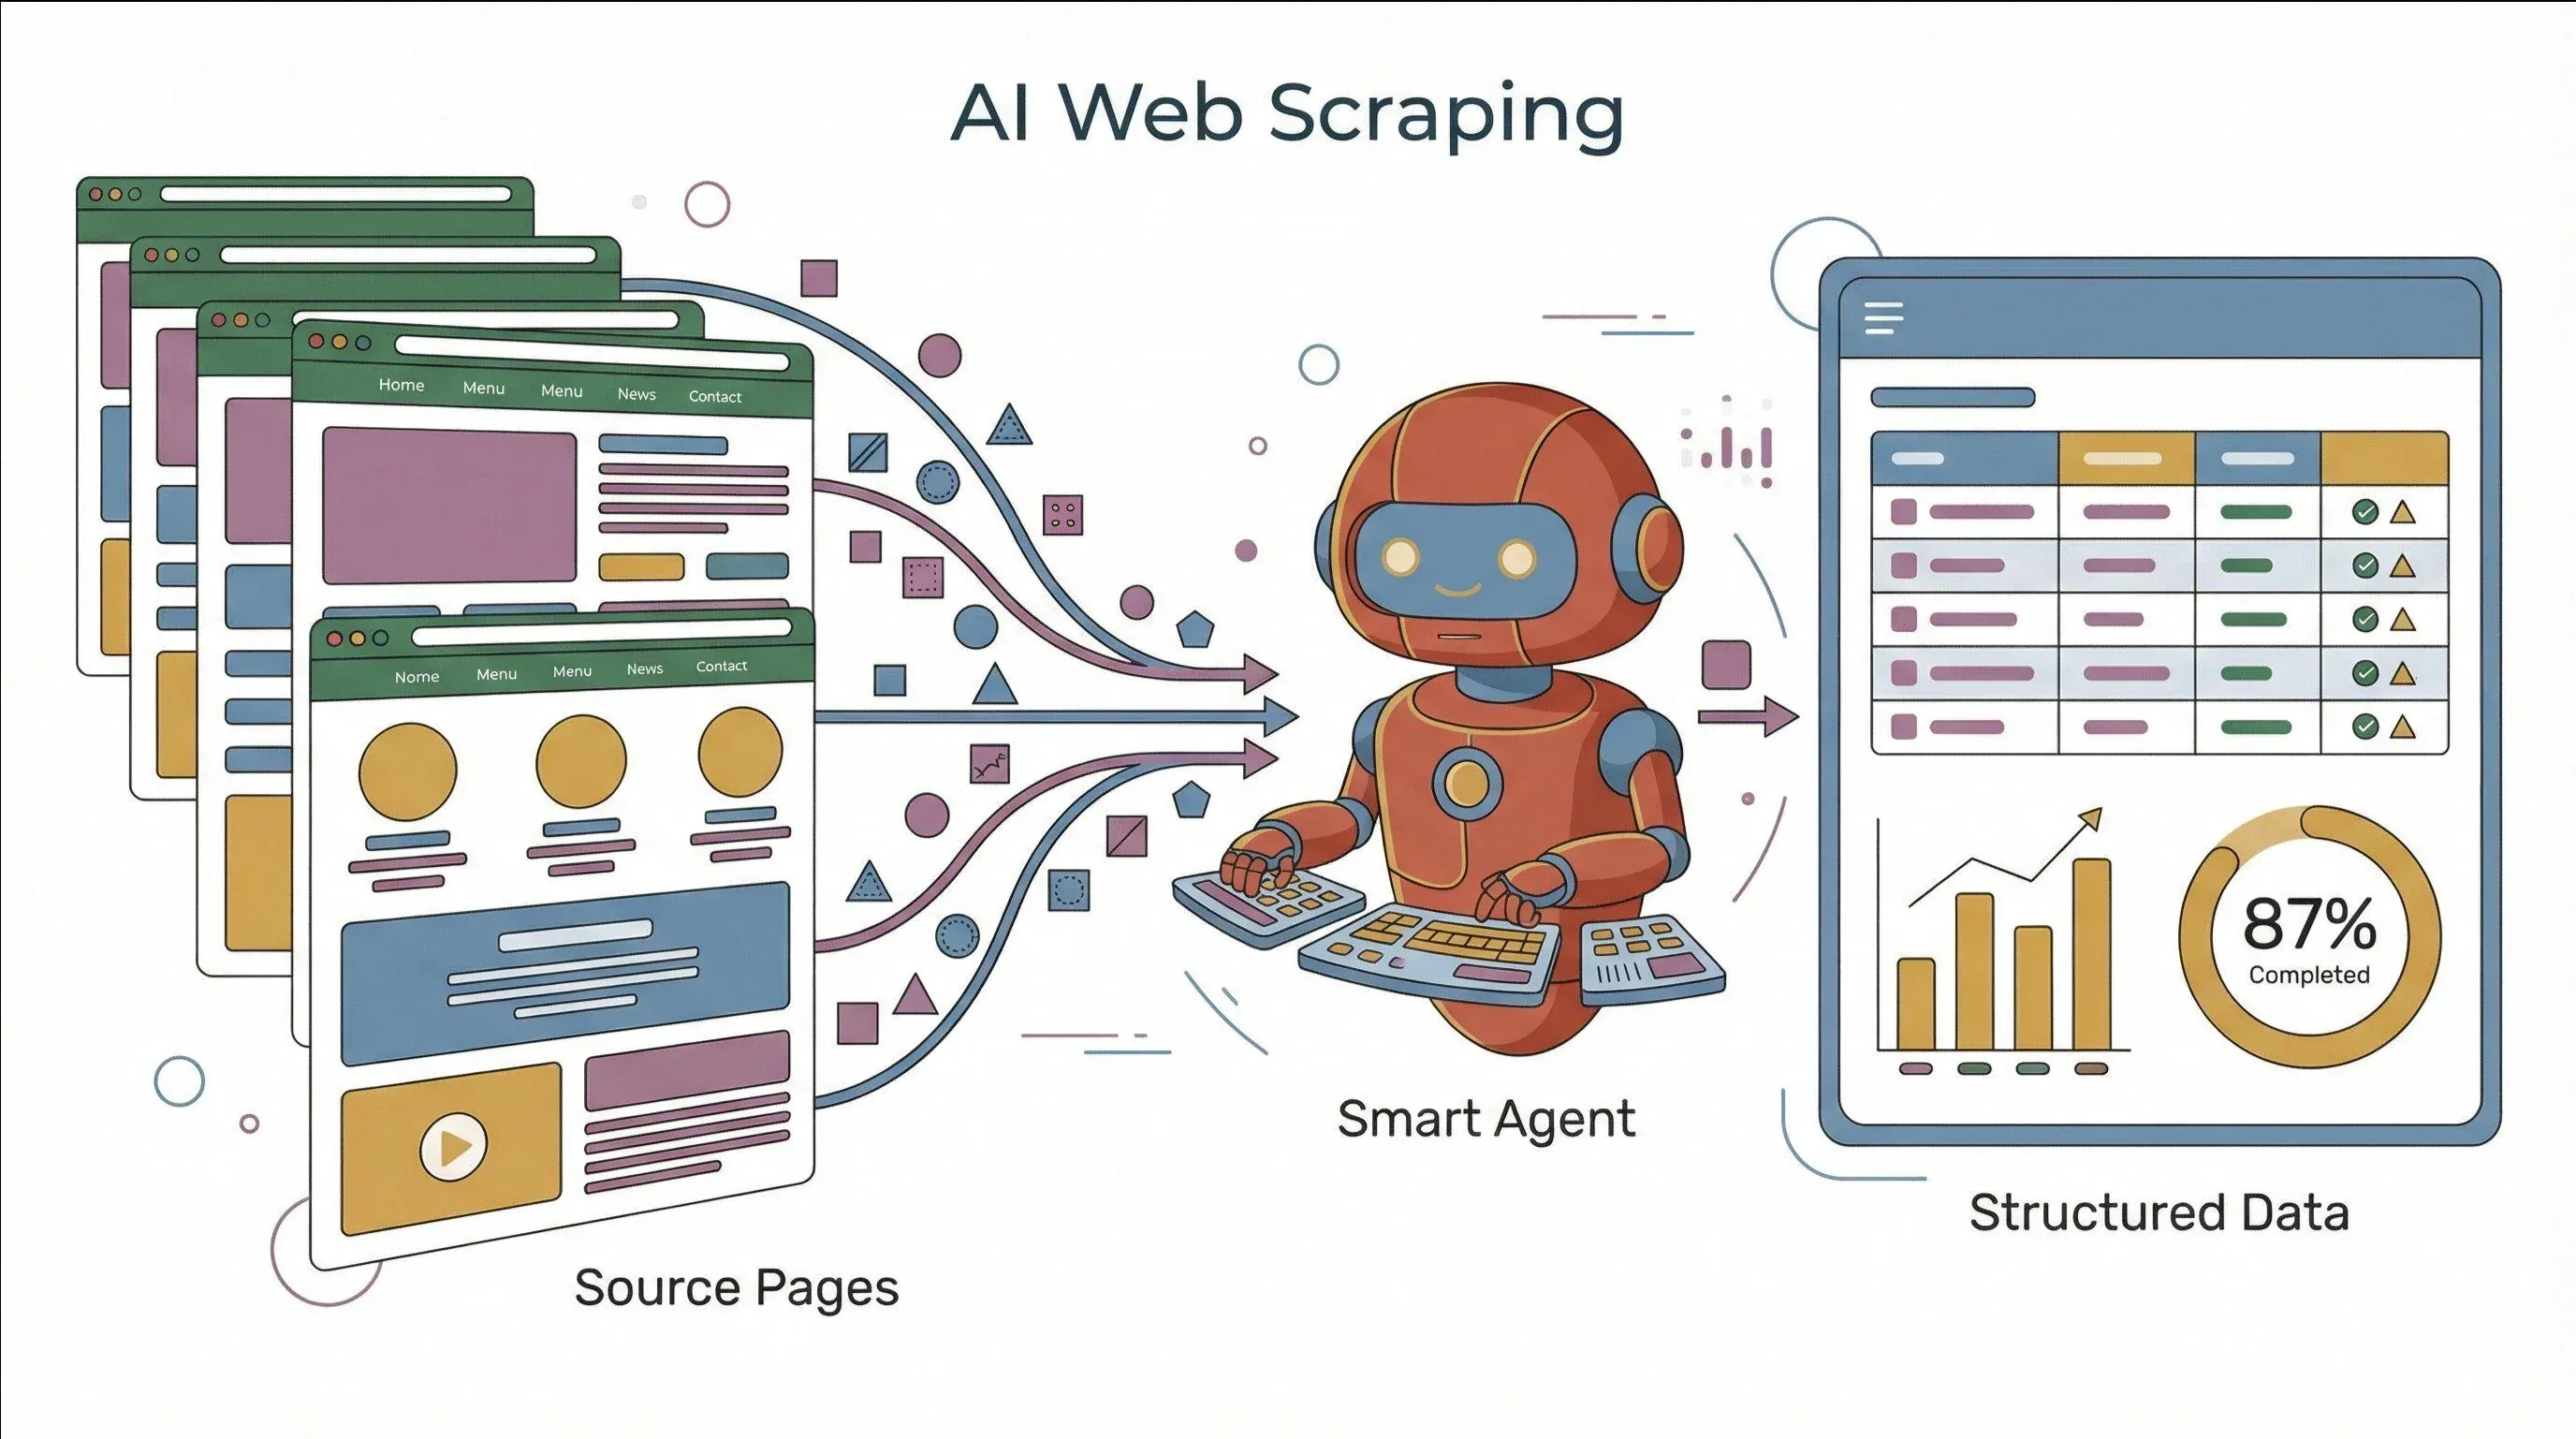 Pojďme k jádru věci: web scraping už dávno není jen pro datové nadšence. Je to must-have pro každou firmu, která chce držet náskok. Tady je důvod, proč se vyplatí ClawdBot ovládnout:
Klíčové funkce pro byznys uživatele
- Automatizace: Nastavíte jednou a necháte běžet — ClawdBot umí spouštět scrapingové úlohy podle plánu, takže data máte vždy čerstvá.
- Strukturování dat: Používejte datová schémata polí (která můžete definovat sami nebo si je nechat vygenerovat pomocí Thunderbitu), aby vaše scraped data byla čistá a připravená k analýze.
- Zpracování chyb: Izolované relace a ovládání prohlížeče v ClawdBotu pomáhají vyhnout se běžným problémům, jako jsou rozbité skripty nebo konflikty relací.
- Integrace: Výsledky můžete posílat přímo do Google Sheets, CSV nebo i do týmových chatovacích kanálů.
Reálné byznys scénáře
| Případ použití | Typická datová pole | Frekvence aktualizace | Byznys přínos | Nástroj ClawdBotu |
|---|---|---|---|---|
| Generování sales leadů | Společnost, jméno, e-mail, LinkedIn, pracovní nabídky | Týdně/denně | Najít nové příležitosti, spustit oslovení | web_fetch/browser |
| Sledování konkurence | SKU, cena, sklad, promo, hodnocení | Denně/hodinově | Dynamické ceny, reakce na promo akce | browser/cron |
| Realitní byznys | Adresa, cena, stav, makléř, den otevřených dveří | Denně | Včasný kontakt, ocenění | web_fetch/browser |
| Průzkum trhu | Název, datum, klíčová slova, sentiment | Denně | Sledování trendů, upozornění na rizika | web_fetch/cron |
Důkaz návratnosti investice:
- Podle Mordor Intelligence má trh se softwarem pro web scraping do roku 2030 dosáhnout 2 miliard dolarů, s CAGR 14,2 %.
- Dataforest (2025) označuje web scraping za motor dynamického oceňování, automatizovaného generování leadů a monitoringu rizik.
Reference uživatele:
- „ClawdBot nám pomohl automatizovat týdenní kontrolu cen konkurence — to, co dřív trvalo hodiny, teď běží na pozadí a každé ráno přistane v našem Slacku.“ (Ecommerce Ops Manager, přes MacStories)
Začínáme: Jak nastavit ClawdBot Web Scraping během několika minut
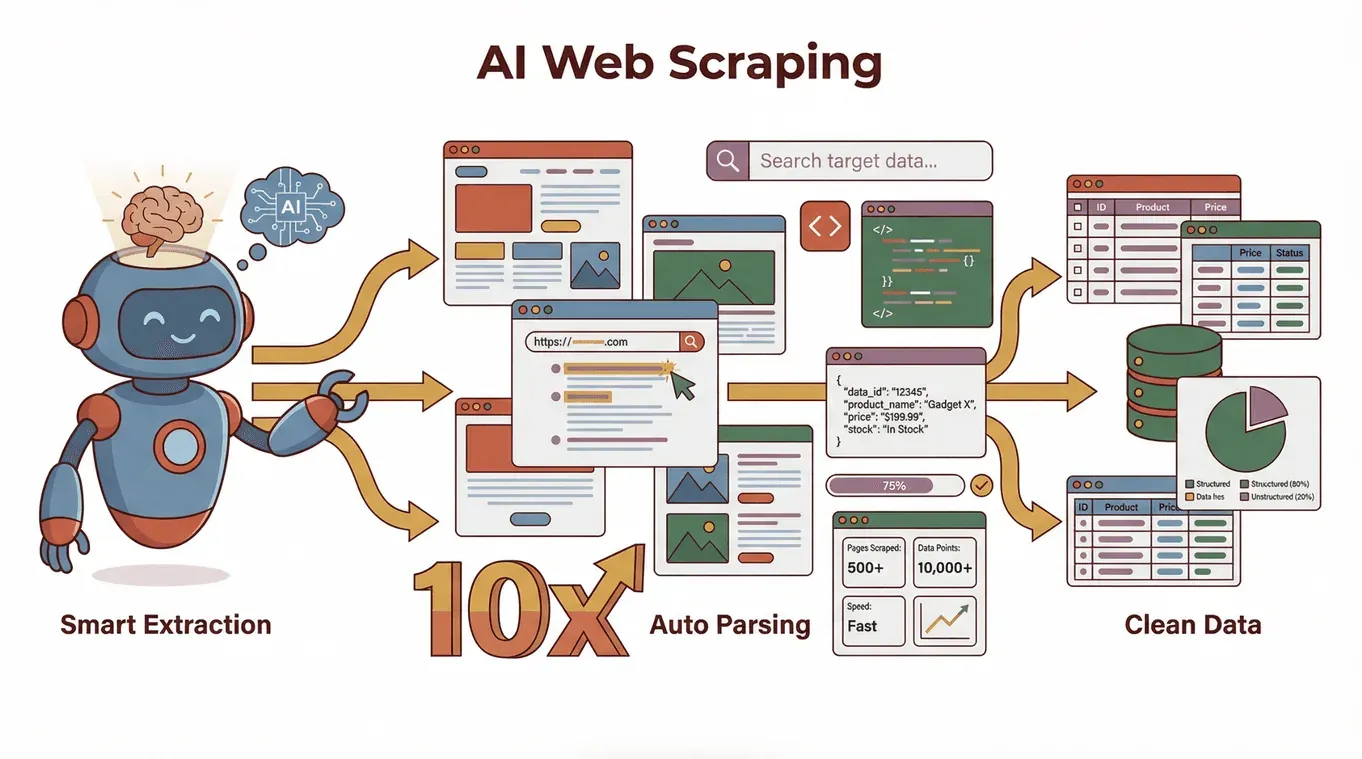 K rozjetí ClawdBotu nepotřebujete být programátor. Takhle začít:
Krok 1: Nainstalujte ClawdBot (Moltbot)
-
Mac/Linux:
curl -fsSL https://molt.bot/install.sh | bash -
Windows:
iwr -useb https://molt.bot/install.ps1 | iex
(Uživatelům Windows doporučujeme WSL2.) -
Ujistěte se, že máte Node.js v22 nebo vyšší.
Krok 2: Spusťte dashboard
- Spusťte
moltbot dashboardnebo v prohlížeči otevřetehttp://127.0.0.1:18789/. - Úvodní průvodce vás provede prvotním nastavením.
Krok 3: Propojte rozšíření do Chrome
- Nainstalujte rozšíření ClawdBot (Moltbot) pro Chrome v režimu pro vývojáře.
- Připojte ho k aktivní kartě v Chrome, aby agent mohl ovládat vaši relaci prohlížení — ideální pro scraping přihlášených nebo interaktivních webů.
Krok 4: Nastavte webové nástroje
- Pro základní scraping použijte nástroj „web_fetch“ (skvělý pro statické stránky).
- Pro interaktivní scraping použijte nástroj „browser“ (umí klikat, scrollovat, vyplňovat formuláře atd.).
- Pro plánované úlohy nastavte cron úlohu v dashboardu nebo přes CLI.
Krok 5: Nastavte frekvenci scrapingu a filtry
- Určete, jak často se má úloha spouštět (např. každou hodinu, denně v 8:00).
- Přidejte filtry obsahu nebo schémata polí, aby se vytáhla jen data, která skutečně potřebujete.
Krok 6: Zvolte formát výstupu
- Výstup do CSV, Excelu nebo Google Sheets.
- Nastavte doručování do Slacku, Telegramu nebo e-mailu pro automatické reportování.
Tipy pro řešení problémů:
- Když scraping selže, zkontrolujte verzi Node a API klíče (Brave, Perplexity atd.).
- U automatizace prohlížeče se ujistěte, že je rozšíření připojené a máte udělená oprávnění.
- Pro citlivé nebo rizikové úlohy používejte izolované relace.
Jak založit svůj první projekt v ClawdBotu
- Otevřete dashboard a vytvořte nový projekt.
- Zadejte cílové URL nebo vyhledávací klíčová slova.
- Zvolte vhodný nástroj (web_fetch pro statické stránky, browser pro interaktivní).
- Definujte schéma polí (sloupce, které chcete vytáhnout).
- Náhledně spusťte scraping a ověřte, že data přicházejí správně.
- Uložte úlohu a naplánujte její spuštění.
Přizpůsobení výstupu dat pro potřeby byznysu
- Zvolte formát exportu: CSV, Excel, Google Sheets nebo přímé napojení na BI nástroje.
- Přizpůsobte výstup firemnímu reportingu — používejte jasné názvy sloupců a datové typy.
- Pro pravidelné reporty nastavte plánované exporty a automatické doručování.
Zvyšte efektivitu: Kombinace Thunderbitu s ClawdBot Web Scrapingem
A tady začíná být opravdu zajímavé. Thunderbit je Chrome rozšíření pro AI web scraping, které výrazně usnadňuje definování datových polí i strukturování scrapovaných dat.
Vyzkoušejte Thunderbit AI Web Scraper zdarma
Jak Thunderbit a ClawdBot spojit:
- Krok 1: Použijte v Thunderbitu funkci „AI Suggest Fields“ na cílovém webu a nechte si vygenerovat seznam doporučených sloupců a datových typů.
- Krok 2: Exportujte toto schéma do CSV nebo Google Sheetu.
- Krok 3: Importujte schéma do ClawdBotu, aby byly scrapingové úlohy strukturované a připravené pro byznys analýzu.
- Krok 4: Využijte cron úlohy v ClawdBotu k automatizaci opakovaných scrapingů a doručování výsledků vašemu týmu.
Příklad workflow:
- Thunderbit definuje strukturu (názvy polí, typy, logiku extrakce).
- ClawdBot spouští automatizaci (stahuje data, plánuje úlohy, doručuje reporty).
Pro tip:
Můžete dokonce použít rozšíření ClawdBotu do Chrome k ovládání prohlížeče, otevření stránky a spuštění Thunderbitu pro scraping a export dat — vznikne tak plynulé workflow bez kódu.
Využití AI pro chytřejší strukturování dat
AI v Thunderbitu nejen navrhuje sloupce — dokáže také:
- Označovat, kategorizovat a překládat data přímo během scrapingu.
- Zvládat scraping podstránek (např. navštívit každou stránku produktu pro více detailů).
- Čistit data a odstraňovat duplicity před exportem.
Praktické tipy:
- Před spuštěním velkých úloh si vždy zobrazte náhled schématu polí.
- Používejte AI prompty v Thunderbitu pro přidání vlastních instrukcí (např. „zařaď SKU podle značky“).
- Plánujte pravidelné scrapingy, aby vaše datasety zůstaly čerstvé a použitelné.
Reálné využití: ClawdBot Web Scraping pro byznys rozhodování
Podívejme se, jak se ClawdBot používá napříč odvětvími:
Obchod a generování leadů
- Scrapujte adresáře, LinkedIn nebo seznamy účastníků akcí a získávejte nové leady.
- Sledujte pracovní nabídky firem jako signály k nákupu.
- Automatizujte týdenní aktualizace seznamů leadů a doručujte je do CRM nebo Slacku.
E-commerce a sledování cen
- Sledujte ceny konkurence, skladové zásoby a promo akce napříč stovkami SKU.
- Nastavte hodinové nebo denní scrapingy, abyste zachytili změny v reálném čase.
- Používejte strukturovaná data pro dynamické ceny nebo upozornění na zásoby.
Reality
- Seskupujte nabídky nemovitostí, ceny a informace o makléřích z více webů.
- Sledujte změny stavu (nové nabídky, snížení cen) a posílejte upozornění týmu.
- Obohacujte nabídky o údaje o lokalitě nebo nedávné prodeje.
Průzkum trhu a analýza sentimentu
- Scrapujte recenze, zpravodajské články nebo příspěvky na fórech a analyzujte zákaznický sentiment.
- Využijte AI k označování, kategorizaci a shrnutí velkého objemu nestrukturovaného textu.
- Napojte data do BI nástrojů pro analýzu trendů a reporting.
Mini případová studie:
Realitní agentura použila ClawdBot + Thunderbit ke každodennímu scrapingu nových nabídek, obohacování o kontaktní údaje makléřů a doručování ranního reportu obchodnímu týmu — čímž snížila čas strávený ručním průzkumem o 80 %.
Od dat k poznatkům: Jak ze scrapovaných dat udělat akci
Jakmile máte data sesbíraná, je čas je proměnit v něco, co se dá využít:
- Excel / Google Sheets: Používejte kontingenční tabulky, grafy a podmíněné formátování pro rychlou analýzu.
- Power BI / Tableau / Looker Studio: Vytvářejte dashboardy, které se automaticky obnovují s novými daty.
- Textová analýza: Použijte AI prompty k shrnutí recenzí, seskupení témat nebo hodnocení sentimentu.
Tip:
Strukturované exporty v Thunderbitu usnadňují napojení dat do libovolného analytického nástroje — bez chaotického čištění.
Překonávání výzev: Trendy web scrapingu a budoucnost ClawdBotu
Aktuální výzvy
- Měnící se struktura webů: Weby upravují layout, přidávají JavaScript nebo blokují boty — a tím rozbíjejí tradiční scrapery.
- Anti-bot opatření: Čím dál více webů používá CAPTCHA, přihlašovací brány a detekci botů.
- Ochrana dat a compliance: Rostoucí regulace (GDPR, CCPA) znamenají, že je třeba scrapovat zodpovědně.
Přístup ClawdBotu
- Automatizace prohlížeče: Díky ovládání skutečných karet v prohlížeči zvládne ClawdBot interaktivní weby i weby chráněné přihlášením.
- Izolované relace: Snižují riziko tím, že scraping běží v sandboxovaném prostředí.
- Bezpečnostní audity: Vestavěné nástroje vás upozorní na rizikové konfigurace nebo odhalené přihlašovací údaje.
- Flexibilní plánování: Cron úlohy umožňují automatizovat scraping a rozložit jeho běh v čase, aby se snížila detekce.
Budoucnost
- AI extrakce dat: Očekávejte chytřejší rozpoznávání polí, lepší práci s nestrukturovanými daty a přirozenější ovládání pomocí jazyka.
- Integrace s chytrými nástroji: Kombinace ClawdBotu s Thunderbitem a BI platformami udělá datové pipeline ještě plynulejší.
- Compliance už v návrhu: Na roadmapě jsou podrobnější kontroly, auditní logy a funkce ochrany soukromí.
Trend v oboru:
TollBit uvádí, že provoz AI botů pro scraping vzrostl ve 4. čtvrtletí 2024 o 117 %, přičemž o 40 % přibylo botů obcházejících robots.txt. Potřeba zodpovědných a přizpůsobivých nástrojů pro scraping nikdy nebyla větší.
Závěr a klíčové poznatky: Ovládněte ClawdBot Web Scraping pro růst byznysu
Tady je to hlavní, co jsem se naučil: ovládnout ClawdBot Web Scraping neznamená jen stahovat data — jde o budování chytřejších, více automatizovaných workflow, která vaší firmě dávají výhodu. Když spojíte automatizaci ClawdBotu s AI strukturováním v Thunderbitu, získáte data, která nejsou jen rychlá, ale opravdu užitečná.
Klíčové poznatky:
- Web scraping je dnes naprosto zásadní pro obchodní týmy, e-commerce, reality i výzkumné týmy.
- ClawdBot dělá scraping dostupný, automatizovatelný a bezpečný — i pro lidi bez programování.
- Thunderbit posouvá workflow na vyšší úroveň díky AI detekci polí a čištění dat.
- Kombinace obou nástrojů vám umožní přejít od syrových webových dat k použitelným byznys poznatkům v rekordním čase.
Jste připraveni posunout práci s daty na vyšší úroveň? Začněte malým projektem — definujte pole v Thunderbitu, automatizujte scraping v ClawdBotu a sledujte, kolik času ušetříte. Budoucnost byznysového rozhodování je datově řízená a se správnými nástroji budete patřit mezi lídry.
Začněte s AI web scrapingem pomocí Thunderbitu
Časté dotazy
1. Co je ClawdBot Web Scraping a čím se liší od tradičních scraperů?
ClawdBot (dnes Moltbot) je platforma AI agentů, která automatizuje získávání webových dat pomocí ovládání prohlížeče, plánovaných úloh a konverzačních příkazů — bez nutnosti kódování. Na rozdíl od tradičních scraperů zvládá interaktivní weby, automatizuje workflow a doručuje výsledky do oblíbených kanálů vašeho týmu.
2. Můžu ClawdBot použít na byznys úkoly jako generování leadů nebo hlídání cen?
Rozhodně. ClawdBot je navržený pro byznysové scénáře, jako je scraping obchodních leadů, sledování cen konkurence, agregace realitních nabídek nebo průzkum trhu. Díky automatizaci a plánování je ideální pro opakované firemní úlohy.
3. Jak Thunderbit rozšiřuje možnosti ClawdBotu?
Thunderbit pomocí AI navrhuje názvy polí, datové typy a logiku extrakce, takže vaše scrapovaná data jsou čistší a strukturovanější. Schéma si můžete definovat v Thunderbitu a pak použít ClawdBot k automatizaci scrapingu i reportingu.
4. Jaké jsou dnes hlavní výzvy web scrapingu a jak je ClawdBot řeší?
Největší výzvy jsou měnící se struktury webů, anti-bot obrana a požadavky na compliance. Automatizace prohlížeče, izolované relace a vestavěné bezpečnostní audity v ClawdBotu pomáhají tyto překážky překonat.
5. Jak začít s ClawdBotem a Thunderbitem?
Nainstalujte ClawdBot (Moltbot) pomocí oficiálního skriptu, nastavte dashboard a propojte rozšíření pro Chrome. V Thunderbitu si definujte datové schéma a pak v ClawdBotu automatizujte scrapingové úlohy. Začněte malým projektem a postupně škálujte, až si budete jistí.
Chcete se dozvědět víc o AI web scrapingu? Podívejte se na Thunderbit Blog pro další návody, tipy a reálné úspěšné příběhy.
Vyzkoušejte AI Web Scraper Get Started Free
Zjistěte více
- Top 10 automatizovaných nástrojů pro web scraping v roce 2025
- Top 5 nejlepších softwarů pro web scraping dat v roce 2026
- 15 nejlepších nástrojů pro extrakci dat v roce 2025
- Top 6 základních nástrojů pro web scraping pro úspěch v roce 2025
- Jak efektivně scrapovat data z webu s pomocí špičkových nástrojů




