
V roce 2015 scraping znamenal buď prosit vývojáře o Python skript, nebo strávit víkend učením XPath. V roce 2026 prostě napíšete „získej všechny názvy produktů a ceny“ a zbytek udělá AI.
Ta změna přišla nečekaně rychle. V průzkumu Censuswide mezi 506 profesionály v oblasti web scrapingu v USA a Velké Británii 74 % uvedlo, že jejich firmy během předchozích 12 měsíců zaznamenaly vyšší poptávku po webových datech.
Největším tahounem jsou? AI web crawlery. Umí se přizpůsobit změnám rozložení. Chápou obsah stránky, ne jen HTML tagy. A fungují i pro lidi, kteří nikdy nenapsali jediný řádek kódu.
Strávil jsem měsíce testováním 15 nástrojů. Tady je, co jsem zjistil — včetně toho, proč Thunderbit (ano, firma, kterou jsem spoluzaložil) skončil na prvním místě.
Proč AI mění scraping webových stránek: nová éra nástrojů pro web scraping
Získejte data z libovolného webu pomocí AI Get Started Free
Buďme upřímní: tradiční web scraping nikdy nebyl stavěný pro běžného firemního uživatele. Bylo to hlavně o kódu, selektorech a doufání, že se váš skript nerozbije při další změně rozložení webu. AI a LLM ale pravidla úplně otočily.
Jak?
- Pokyny v přirozeném jazyce: Místo zápasu s kódem prostě řeknete AI, co potřebujete. Nástroje jako Thunderbit používají AI k rozpoznání užitečných polí a automatickému nastavení extrakce.
- Adaptivní učení: AI scrapery se umí přizpůsobit změnám rozložení na webech, což výrazně snižuje nutnost údržby.
- Zvládání dynamického obsahu: Moderní weby milují JavaScript a nekonečné scrollování. Nástroje s AI si poradí i s těmito prvky a vytáhnou data, která by starší scrapery minuly.
- Strukturovaný výstup díky AI parsování: Scrapery postavené na LLM skutečně chápou obsah stránky a vracejí čistá, strukturovaná data.
- Infrastruktura pro dynamické weby: Některé platformy kombinují AI extrakci s vykreslováním v prohlížeči, proxy servery a řešením CAPTCHA. Právě tyto infrastrukturní prvky — ne samotná AI — pomáhají u náročných nebo chráněných webů.
- Integrované datové workflow: Ty nejlepší nástroje data nejen stáhnou — doručí je tam, kde je potřebujete, s přímým exportem do Google Sheets, Airtable, Notion a dalších aplikací (zdroj).
Výsledek? Web scraping je dnes záležitost typu klikni a hotovo — nebo dokonce konverzační rozhraní — a otevírá cestu nejen vývojářům, ale i týmům obchodu, marketingu a provozu, aby mohly webová data využívat napřímo.
15 AI web crawlerů, které stojí v roce 2026 za pozornost
Pojďme si rozebrat top 15 AI web crawlerů, začneme u Thunderbitu. U každého nástroje shrnu hlavní funkce, cílové uživatele, cenu a to, čím vyčnívá. A ano, budu otevřený i v tom, kde exceluje — a kde už tolik ne.
1. Thunderbit: AI web scraper pro každého
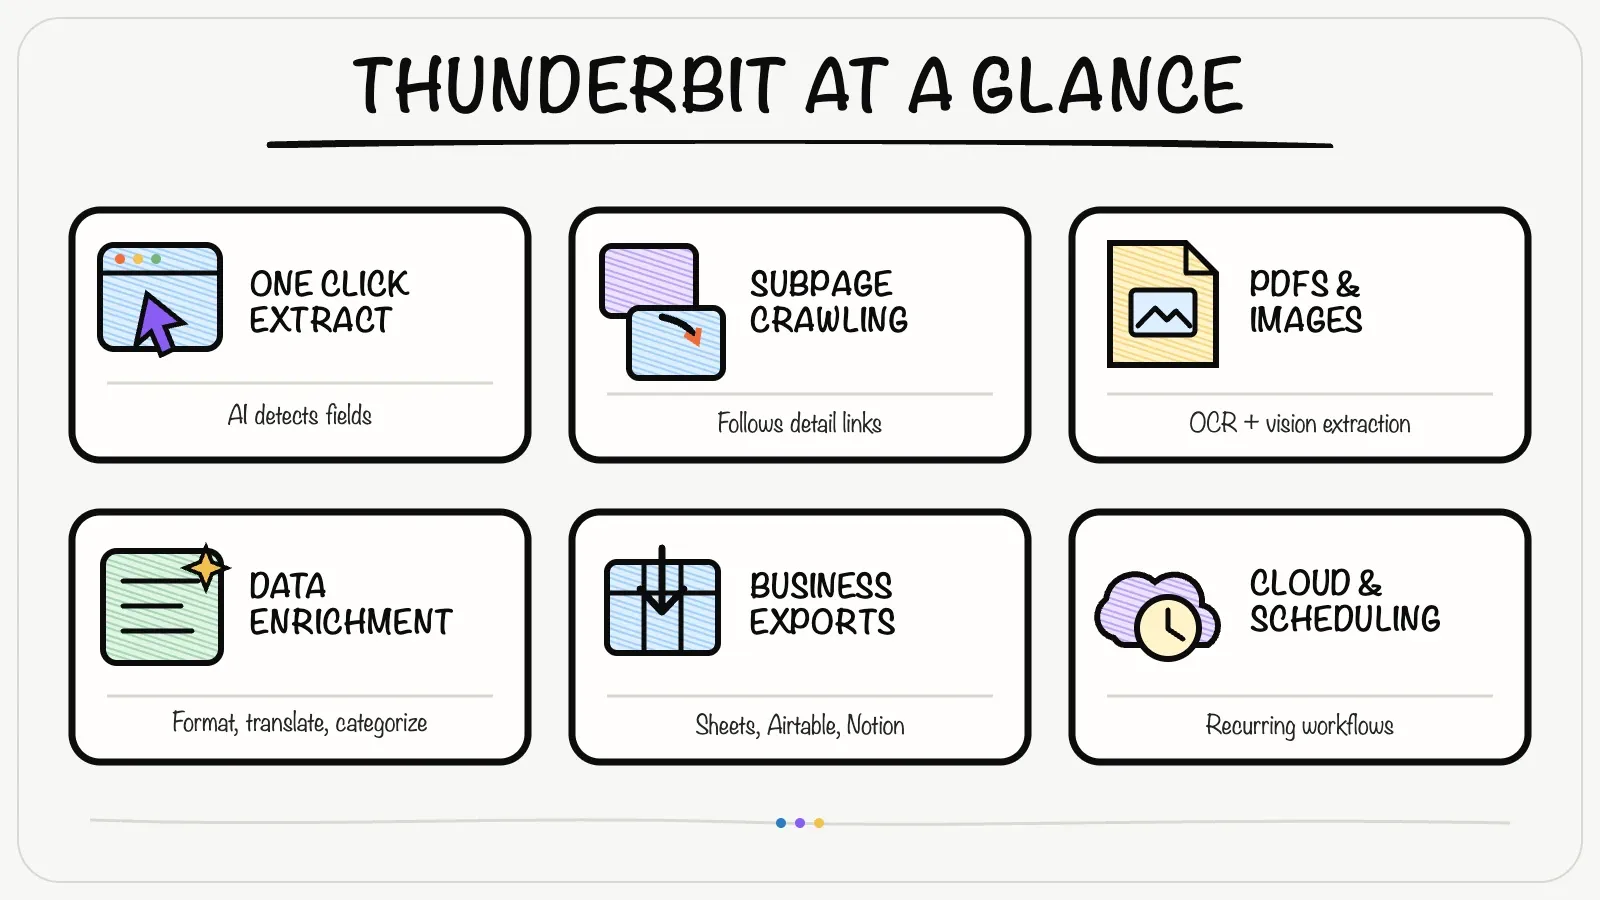
Tady jsem samozřejmě trochu zaujatý, ale Thunderbit je agentní web scraper, kterého bych si býval přál mít už před lety. Otevřete stránku a kliknete na One Click Extract: agent rozpozná strukturu stránky, identifikuje užitečná pole a připraví extrakci. Můžete hned kliknout na Run Now, nebo nechat úlohu spustit automaticky. Tady je důvod, proč je tohle jednička v seznamu:

- Extrakce v přirozeném jazyce: Thunderbit kombinuje zadání polí v běžné řeči s funkcí One Click Extract, která automaticky analyzuje stránku a najde užitečná pole — bez kódu a bez selektorů (zdroj).
- Crawling podstránek a vícestupňové procházení: Thunderbit umí následovat odkazy a scrapovat podstránky. Například vytáhnete seznam produktů a pak v rámci stejného workflow otevřete každou produktovou stránku pro detailní data (zdroj).
- Okamžitě strukturovaný výstup: AI sama navrhne pole, sjednotí formáty a dokáže data také shrnout, zařadit, přeložit nebo jinak obohatit (zdroj).
- Široká podpora zdrojů: Thunderbit umí extrahovat data z webů, PDF i obrázků pomocí OCR a vision AI (zdroj).
- Firemní integrace: Export do Google Sheets, Airtable, Notion nebo Excelu a k tomu plánované cloudové scrapování pro pravidelné workflow (zdroj).
- Předpřipravené šablony: Thunderbit nabízí hotové šablony pro populární weby, aby urychlil běžné extrakční úkoly.
- Snadné a přístupné použití: Rozhraní je klikací a má intuitivního asistenta. Uživatelé často zvládnou začít během několika minut.
Thunderbit používá více než 200 000 uživatelů po celém světě. Obchodní týmy ho využívají pro tvorbu lead listů, realitní makléři pro agregaci nabídek nemovitostí a marketéři pro sledování konkurence — bez jediného řádku kódu.
Cena: Bezplatný tarif zahrnuje 6 stránek měsíčně. Placené plány začínají na 15,99 USD/měsíc.
Thunderbit je to nejbližší, co jsem kdy viděl k „přeměně webu v databázi“ — a je určený pro každého, ne jen pro inženýry.
Vyzkoušet rozšíření Thunderbit pro Chrome
2. Crawl4AI
Pro koho je: Vývojáři a technické týmy, které staví vlastní pipeline.
Crawl4AI je open-source framework v Pythonu, optimalizovaný na rychlost a rozsáhlé crawlingy, s ohledem na integraci s LLM. Je extrémně rychlý, podporuje headless prohlížeče pro dynamický obsah a dokáže strukturovat data tak, aby se snadno napojila na AI workflow.
- Nejlepší pro: Vývojáře, kteří potřebují výkonný a přizpůsobitelný crawling engine.
- Cena: Zdarma a open source pod licencí Apache 2.0 s uvedením autora. Budete si to muset hostovat a provozovat sami.
3. ScrapeGraphAI
Pro koho je: Vývojáři a analytici, kteří staví AI agenty nebo komplexní datové pipeline.
ScrapeGraphAI je open-source Python knihovna řízená prompty, která mění weby na strukturovaná datová „grafová“ schémata pomocí LLM. Můžete psát zadání typu „Vytáhni názvy všech produktů, ceny a hodnocení z prvních 5 stránek“ a nástroj za vás sestaví scraping workflow (zdroj).
- Nejlepší pro: Technicky zdatné uživatele, kteří chtějí flexibilní scraping řízený prompty.
- Cena: Knihovna je zdarma; cloud API začíná na 20 USD/měsíc.
4. Firecrawl
Pro koho je: Vývojáři stavějící AI agenty nebo rozsáhlé datové pipeline.
Firecrawl je AI-first crawling platforma a API, která převádí celé weby do dat připravených pro LLM (zdroj). Vrací Markdown nebo JSON, zvládá dynamický obsah a integruje se s frameworky jako LangChain a LlamaIndex.
- Nejlepší pro: Vývojáře, kteří potřebují posílat živá webová data do AI modelů.
- Cena: Základní open-source verze je zdarma. Cloud tarif Hobby stojí 19 USD měsíčně při měsíční fakturaci nebo 16 USD/měsíc při roční fakturaci; k dispozici je i omezený free tier.
5. Browse AI
Pro koho je: Business uživatelé, growth hackeři a analytici.
Browse AI je no-code platforma s klikacím rozhraním. „Vytrénujete“ robota tím, že klikáte na data, která chcete získat, a AI si vzor zobecní pro další scrapování. Umí přihlašování, nekonečný scroll a dokáže hlídat změny na webech.
- Nejlepší pro: Netехничесké uživatele, kteří chtějí automatizovat sběr dat a monitoring.
- Cena: Free plán (50 kreditů měsíčně). Personal plán začíná na 19 USD/měsíc při roční fakturaci; při měsíční fakturaci stojí 48 USD/měsíc.
6. LLM Scraper
Pro koho je: Vývojáři, kteří chtějí, aby parsování dělal AI model.
LLM Scraper je open-source JavaScript/TypeScript knihovna, která vám umožní definovat datové schéma a nechat LLM tato data extrahovat z libovolné webové stránky. Je postavená na Playwrightu, podporuje více poskytovatelů LLM a umí dokonce generovat znovupoužitelný kód.
- Nejlepší pro: Vývojáře, kteří chtějí převést libovolnou stránku na strukturovaná data pomocí LLM.
- Cena: Zdarma (licence MIT).
7. Reader (Jina Reader)
Pro koho je: Vývojáři stavějící LLM aplikace, chatboty nebo sumarizátory.
Jina Reader, dnes součást Elastic, je API, které z webových stránek extrahuje čistý text a strukturovaná data (a dokonce i PDF/obrázky) a vrací Markdown nebo JSON připravený pro LLM. Umí také popisovat obrázky.
- Nejlepší pro: Získávání čistého, čitelného obsahu pro LLM nebo Q&A systémy.
- Cena: Zdarma API (pro základní použití není potřeba klíč).
8. Bright Data
Pro koho je: Firmy a profesionální uživatelé, kteří potřebují škálování, compliance a spolehlivost.
Bright Data je těžká váha ve světě webových dat, s obrovskou proxy sítí a AI řízenými scraping nástroji. Nabízí hotové scrapery, univerzální Web Scraper API a datové feedy připravené pro LLM.
- Nejlepší pro: Organizace, které potřebují spolehlivá webová data ve velkém.
- Cena: Podle využití, prémiová. K dispozici jsou trial verze zdarma.
9. Octoparse
Pro koho je: Netехническі až částečně technicky zdatní uživatelé.
Octoparse je zavedený no-code nástroj s vizuálním návrhářem workflow a AI automatickým rozpoznáváním. Zvládá přihlášení, nekonečný scroll a export do různých formátů.

- Nejlepší pro: Analytiky, majitele malých firem nebo výzkumníky.
- Cena: K dispozici free tier. Standard plán stojí 83 USD měsíčně nebo 69 USD/měsíc při roční fakturaci.
10. Apify
Pro koho je: Vývojáři a technické týmy, které potřebují vlastní scraping/automatizaci.
Apify je cloudová platforma pro spouštění scraping skriptů („actors“) a nabízí i marketplace hotových actorů. Je škálovatelná, integruje AI a podporuje správu proxy.

- Nejlepší pro: Vývojáře, kteří chtějí spouštět vlastní skripty v cloudu.
- Cena: Free plán obsahuje 5 USD měsíčního využití. Starter plán začíná na 29 USD/měsíc.
11. Zyte (Scrapy Cloud)
Pro koho je: Vývojáři a firmy, které potřebují scraping na enterprise úrovni.
Zyte je společnost stojící za Scrapy a nabízí cloudovou platformu i AI podporovanou automatickou extrakci. Umí plánování, proxy a velké projekty.
- Nejlepší pro: Dev týmy, které běží dlouhodobé scraping projekty.
- Cena: K dispozici je zkušební kredit 5 USD; Zyte API pak účtuje podle typu požadavku a úspěšnosti.
12. Webscraper.io
Pro koho je: Začátečníci, novináři a výzkumníci.
Webscraper.io je oblíbené rozšíření pro Chrome pro klikací extrakci dat. Je jednoduché, zdarma pro lokální použití a pro větší úlohy nabízí cloudovou službu.
- Nejlepší pro: Rychlé jednorázové scraping úkoly.
- Cena: Bezplatné rozšíření; cloud tarify začínají zhruba na 50 USD/měsíc.
13. ParseHub
Pro koho je: Netехничесkých uživatelé, kteří potřebují víc výkonu než základní nástroje.
ParseHub je desktopová aplikace s vizuálním workflow pro scraping dynamického obsahu, včetně map a formulářů. Umí projekty spouštět v cloudu a nabízí API.
- Nejlepší pro: Digitální marketéry, analytiky a novináře.
- Cena: Free tier (200 stránek na běh); placené plány začínají na 189 USD/měsíc.
14. Diffbot
Pro koho je: Firmy a AI společnosti, které potřebují velké objemy strukturovaných webových dat.
Diffbot využívá počítačové vidění a NLP k automatické extrakci dat z libovolné webové stránky a nabízí API pro články, produkty i rozsáhlý knowledge graph.
- Nejlepší pro: Tržní inteligenci, finance a trénovací data pro AI.
- Cena: Free plán s 10 000 kredity měsíčně; placené plány začínají na 299 USD/měsíc.
15. DataMiner
Pro koho je: Netехничесšti uživatelé, hlavně v prodeji, marketingu a žurnalistice.
DataMiner je Chrome rozšíření pro rychlou, klikací extrakci webových dat. Má knihovnu předpřipravených „receptů“ a umí exportovat přímo do Google Sheets.
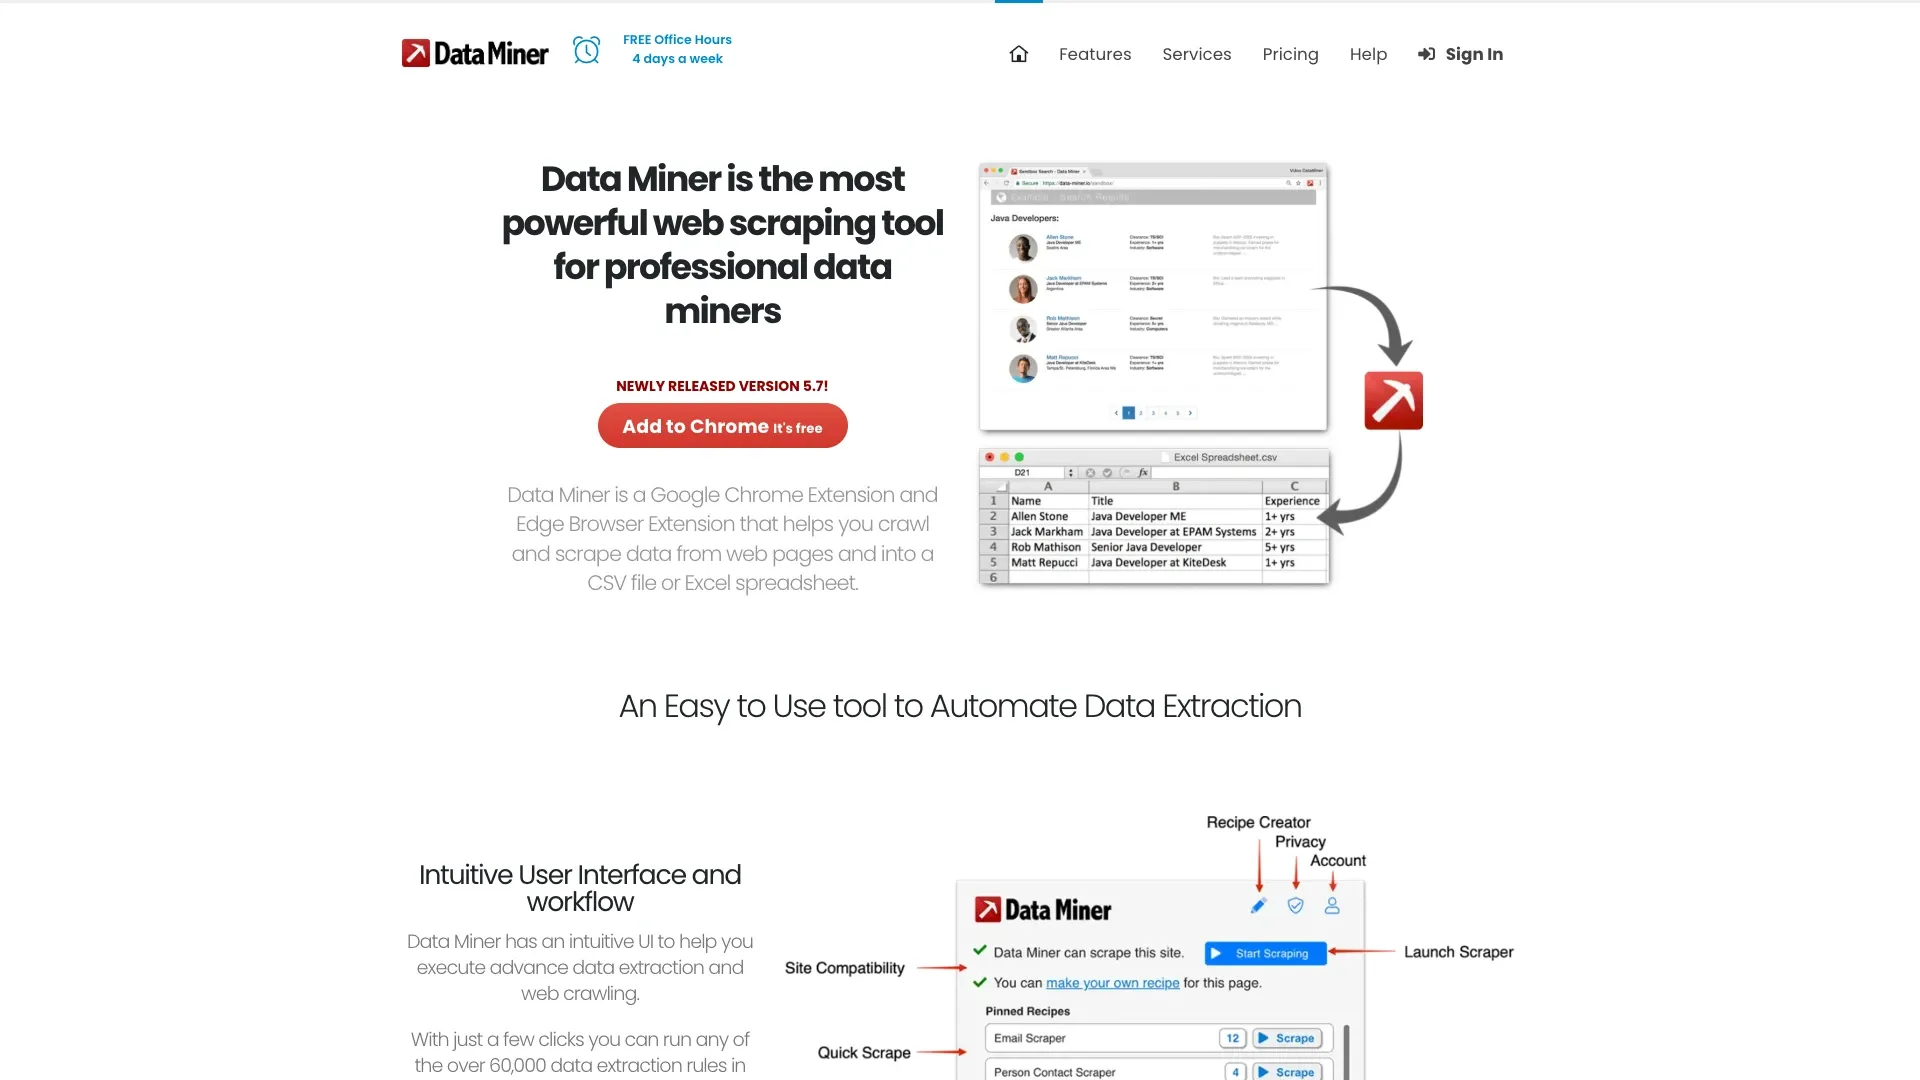
- Nejlepší pro: Rychlé úlohy, jako je export tabulek nebo seznamů do tabulek.
- Cena: Free tier (500 stránek/měsíc); Solo plán začíná na 19,99 USD/měsíc.
Srovnání top AI web scraperů: který sedí vašim potřebám?
Tady je rychlé srovnání, které vám pomůže zorientovat se:
| Nástroj | Použití AI/LLM | Snadnost použití | Výstup / integrace | Pro koho je ideální | Cena |
|---|---|---|---|---|---|
| Thunderbit | Agentní One Click Extract rozpozná pole a strukturuje data | Nejjednodušší (no-code rozšíření) | Exporty do Sheets, Airtable, Notion | Netехничесké týmy | Zdarma 6 stránek/měs.; placené od 15,99 USD/měs. |
| Crawl4AI | Crawling připravený pro AI; integrace LLM | Těžké (Python kód) | Knihovna/CLI; integrace přes kód | Vývojáři potřebující rychlé AI datové pipeline | Zdarma |
| ScrapeGraphAI | LLM prompt pipeline pro scraping | Střední (nějaký kód nebo API) | API/SDK; JSON výstup | Vývojáři/analytici stavějící AI agenty | Zdarma OSS; API od 20 USD/měs. |
| Firecrawl | Převádí crawling do Markdown/JSON připraveného pro LLM | Střední (použití API/SDK) | SDK (Py, Node atd.); integrace s LangChain | Vývojáři napojující živá webová data na AI | Zdarma; Hobby 19 USD měsíčně nebo 16 USD/měs. ročně |
| Browse AI | AI asistované klikání | Snadné (no-code) | Integrace aplikací přes Zapier | Netехничесké uživatele automatizující monitoring webů | Zdarma 50 kreditů; 19 USD/měs. ročně nebo 48 USD měsíčně |
| LLM Scraper | LLM parsuje stránku do schématu | Těžké (TS/JS kód) | Knihovna v kódu; JSON výstup | Vývojáři, kteří chtějí parsování nechat na AI | Zdarma (vlastní LLM API) |
| Reader (Jina) | AI model extrahuje text/JSON | Snadné (jednoduchý API call) | REST API vrací Markdown/JSON | Vývojáři přidávající webový obsah do LLM | Zdarma API |
| Bright Data | AI vylepšená scraping API; velká proxy síť | Těžké (API, technické) | API/SDK; datové streamy nebo datasety | Enterprise škála | Podle využití |
| Octoparse | AI automaticky rozpozná seznamy | Střední (no-code aplikace) | CSV/Excel, API pro výsledky | Částečně technicky zdatní uživatelé | Zdarma; Standard 83 USD měsíčně nebo 69 USD/měs. ročně |
| Apify | Některé AI funkce (Actors, AI návody) | Těžké (skripty v kódu) | Komplexní API; integrace s LangChain | Vývojáři potřebující vlastní scraping v cloudu | Zdarma 5 USD využití; Starter 29 USD/měs. |
| Zyte (Scrapy) | ML-based automatická extrakce; framework Scrapy | Těžké (Python kód) | API, UI Scrapy Cloud; JSON/CSV | Dev týmy, dlouhodobé projekty | 5 USD trial kredit; PAYG podle využití |
| Webscraper.io | Bez AI (ruční šablony) | Snadné (browser extension) | CSV download, Cloud API | Začátečníci, rychlé jednorázové scrapingy | Zdarma rozšíření; Cloud cca 50 USD/měs. |
| ParseHub | Bez explicitního LLM; vizuální builder | Střední (no-code aplikace) | JSON/CSV; API pro cloud běhy | Netехническі uživatelé scrapující složité weby | Zdarma 200 stránek; placené od 189 USD/měs. |
| Diffbot | AI vision/NLP pro libovolnou stránku; knowledge graph | Snadné (jen API calls) | API (Article/Prod/...) + dotazy do Knowledge Graph | Enterprise, strukturovaná webová data | Zdarma 10k kreditů; placené od 299 USD/měs. |
| DataMiner | Bez LLM; komunitní recepty | Nejjednodušší (browser UI) | Export do Excel/CSV; Google Sheets | Netехничесké uživatele scrapující do tabulek | Zdarma 500 stránek/měs.; Solo 19,99 USD/měs. |
Kategorie nástrojů: od vývojářských obrů po business-friendly scrapery
Aby ten seznam dával smysl, rozdělme si nástroje do několika kategorií:
1. Vývojářské a open-source opory
- Příklady: Crawl4AI, LLM Scraper, Apify, Zyte/Scrapy, Firecrawl
- Silné stránky: Velká flexibilita, škálování a možnost přizpůsobení. Skvělé pro tvorbu vlastních pipeline nebo integraci s AI modely.
- Nevýhody: Vyžadují programování a více konfigurace.
- Případy použití: Stavba vlastní datové pipeline, scraping složitých webů nebo napojení na interní systémy.
2. AI-integrovaní scraping agenti
- Příklady: Thunderbit, ScrapeGraphAI, Firecrawl, Reader (Jina), LLM Scraper
- Silné stránky: Zmenšují propast mezi scrapováním a porozuměním datům. Díky rozhraní v přirozeném jazyce jsou přístupnější.
- Nevýhody: Některé se stále vyvíjejí; nemusí nabídnout jemnozrnnou kontrolu.
- Případy použití: Rychlé získání odpovědí nebo datasetů, tvorba autonomních agentů nebo napájení LLM živými daty.
3. No-code/low-code scrapery přátelské byznysu
- Příklady: Thunderbit, Browse AI, Octoparse, ParseHub, Webscraper.io, DataMiner
- Silné stránky: Uživatelsky přívětivé, minimální nebo žádné programování, vhodné pro běžné firemní úkoly.
- Nevýhody: Mohou mít problémy s velmi složitými weby nebo opravdu velkým měřítkem.
- Případy použití: Generování leadů, sledování konkurence, výzkumné projekty a jednorázové stažení dat.
4. Enterprise datové platformy a služby
- Příklady: Bright Data, Diffbot, Zyte
- Silné stránky: Kompletní řešení, spravované služby, compliance a spolehlivost ve velkém.
- Nevýhody: Vyšší cena, složitější onboarding.
- Případy použití: Velké, nepřetržité datové pipeline, market intelligence a trénovací data pro AI.
Jak vybrat správný AI web crawler pro vaše potřeby web scrapingu
Co je data scraping a jak ho dělat Get Started Free
Vybrat správný nástroj může být zahlcující, takže tady je můj postup krok za krokem:
- Definujte cíle a datové požadavky: Jaké weby a data potřebujete? Jak často? Kolik? A co s nimi budete dělat?
- Zhodnoťte své technické schopnosti: Bez kódování? Zkuste Thunderbit, Browse AI nebo Octoparse. Umíte trochu skriptovat? LLM Scraper nebo DataMiner. Silní vývojáři? Crawl4AI, Apify nebo Zyte.
- Zvažte frekvenci a rozsah: Jednorázově? Použijte free nástroje. Opakovaně? Hledejte plánování. Ve velkém? Enterprise nástroje nebo open-source ve škále.
- Rozpočet a cenový model: Free plány jsou skvělé na testování. Předplatné vs. platba podle využití záleží na vašich potřebách.
- Zkušební provoz a proof of concept: Otestujte pár nástrojů na vlastních datech. Většina má free tier.
- Údržba a podpora: Kdo to opraví, když se web změní? No-code nástroje s AI umí automaticky opravit menší změny; u open-source jste závislí na sobě nebo komunitě.
- Přiřaďte nástroje ke scénářům: Obchodní tým sbírá leady? Thunderbit nebo Browse AI. Výzkumník sbírá tweety? DataMiner nebo Webscraper.io. AI model potřebuje zpravodajské články? Jina Reader nebo Zyte. Stavíte srovnávací web? Apify nebo Zyte.
- Mějte záložní plán: Někdy jeden nástroj na konkrétní web nefunguje. Mějte připravenou alternativu.
„Správný“ nástroj je ten, který vám dodá potřebná data s co nejmenším třením a ve vašem rozpočtu. Někdy je to kombinace více nástrojů.
Thunderbit vs. tradiční web scraper nástroje: čím vyčnívá?
Pojďme se podívat konkrétněji na to, proč je Thunderbit jiný:
- Agentní nastavení na jedno kliknutí: Kliknete na One Click Extract a Thunderbit rozpozná užitečné sloupce; pak zvolíte Run Now nebo necháte úlohu spustit automaticky (zdroj).
- Nízká konfigurace: Thunderbit umí rozpoznat běžné struktury stránek, stránkování i odkazy na podstránky, takže výrazně ubývá ručního nastavování (zdroj).
- AI čištění a obohacování dat: Shrňte, zařaďte, přeložte a obohaťte data už během scrapování (zdroj).
- Méně starostí s údržbou: AI v Thunderbitu je odolná vůči drobným změnám webu, takže se méně často něco rozbije.
- Integrace s firemními nástroji: Přímý export do Google Sheets, Airtable, Notion — žádné další trápení s CSV (zdroj).
- Rychlý přínos: Z nápadu na data se dostanete během minut, ne dnů.
- Nízká křivka učení: Když umíte procházet web a popsat, co potřebujete, Thunderbit zvládnete používat.
- Přizpůsobivost: Scrapujte weby, PDF, obrázky a další — vše jedním nástrojem.
Thunderbit není jen scraper — je to datový asistent, který zapadne do vašeho workflow, ať už pracujete v sales, marketingu, ecommerce nebo realitách.
Vyzkoušet Thunderbit AI Web Scraper
Best practices pro scraping webových stránek s AI web scraper nástroji
Aby z AI scraperů vytěžili maximum, tady jsou mé hlavní tipy:
- Jasně si definujte datové potřeby: Vězte, která pole chcete, kolik stránek a v jakém formátu.
- Využívejte AI doporučení: Používejte detekci polí a AI návrhy nástrojů, abyste nepropásli důležitá data (zdroj).
- Začněte v malém a ověřujte: Otestujte na malé vzorku, zkontrolujte výstup a upravte podle potřeby.
- Pracujte s dynamickým obsahem: Ujistěte se, že váš nástroj podporuje dynamický obsah a interakce (stránkování, nekonečný scroll atd.).
- Respektujte pravidla webu: Zkontrolujte robots.txt, nescrapujte citlivá data a respektujte limity rychlosti.
- Propojte to s automatizací: Používejte exporty a webhooky, aby se data dostala přímo do vašeho workflow.
- Hlídání kvality dat: Kontrolujte data, používejte post-processing a sledujte chyby.
- Buďte struční v promtech: U AI nástrojů přinášejí jasné a konkrétní instrukce lepší výsledky.
- Učte se od komunity: Připojte se k fórům a komunitám pro tipy a řešení problémů.
- Zůstávejte v obraze: AI nástroje se vyvíjejí rychle — sledujte nové funkce a vylepšení.
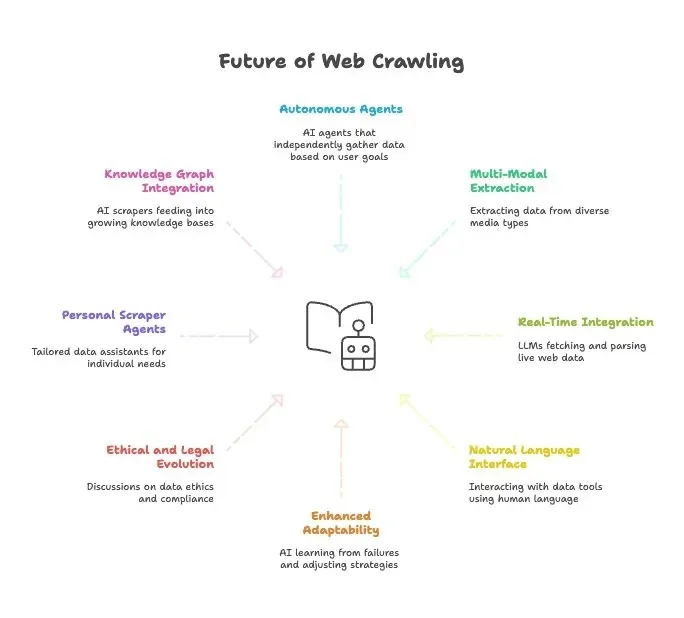
Budoucnost web scrapingu: AI, LLM a nástup agentů pro web scraping v přirozeném jazyce
Do budoucna se propojení AI a web scrapingu bude dál zrychlovat:
- Plně autonomní scraping agenti: Brzy jen zadáte AI agentovi cíl a on si sám najde cestu k datům.
- Vícemodální extrakce dat: Scrapery budou brát data z textu, obrázků, PDF a dokonce i videí.
- Napojení na AI modely v reálném čase: LLM dostanou vestavěné moduly pro načítání a parsování živých webových dat.
- Všechno v přirozeném jazyce: S datovými nástroji budeme mluvit stejně jako s lidmi, takže sběr a transformace dat budou dostupné všem.
- Vyšší adaptabilita: AI scrapery se budou učit z chyb a automaticky přizpůsobovat strategie.
- Etický a právní vývoj: Očekávejte víc diskusí o etice dat, compliance a férovém použití.
- Osobní scraping agenti: Představte si osobního datového asistenta, který vám na míru sbírá zprávy, pracovní nabídky a další obsah.
- Napojení na knowledge graphy: AI scrapery budou průběžně napájet stále rostoucí znalostní báze a tím posilovat chytřejší AI.
Shrnutí? Budoucnost web scrapingu je úzce propojená s budoucností AI. Nástroje jsou každý den chytřejší, samostatnější a dostupnější.
Závěr: Odemkněte byznysovou hodnotu se správným AI web crawlerem
Web scraping se díky AI posunul z úzké technické disciplíny na klíčovou firemní schopnost. Patnáct nástrojů, které jsem tu prošel, představuje to nejlepší, co je v roce 2026 k dispozici — od vývojářských obrů až po business-friendly asistenty.
Skutečné tajemství? Správná volba nástroje vám může dramaticky zvýšit hodnotu, kterou z webových dat získáte. Pro netechnické týmy je Thunderbit nejjednodušší cesta, jak proměnit web ve strukturovanou databázi připravenou pro analýzu — bez kódu, bez starostí, jen výsledky.
Ať už sbíráte leady, sledujete konkurenci nebo napájíte svůj next-gen AI model, věnujte čas vyhodnocení potřeb, vyzkoušejte pár nástrojů a zjistěte, co vám sedí. A pokud chcete budoucnost web scrapingu zažít už dnes, vyzkoušejte Thunderbit. Insights, které potřebujete, jsou jen jeden prompt daleko.
Chcete víc? Podívejte se na Thunderbit Blog pro hlubší rozbory, návody a nejnovější trendy v AI-driven extrakci dat.
Další čtení:
- Co je data scraping a jak ho dělat v roce 2026
- Jak pomocí AI scrapovat data z webu do Excelu
- Nejlepší nástroje a software pro web scraping v roce 2026
Vyzkoušet AI Web Scraper Get Started Free
Často kladené otázky
1. Co je AI web crawler a čím se liší od tradičních web scraperů?
AI web crawler používá zpracování přirozeného jazyka a strojové učení k porozumění webovým datům, jejich extrakci a strukturování. Na rozdíl od tradičních scraperů, které vyžadují ruční kódování a XPath selektory, si AI nástroje poradí s dynamickým obsahem, přizpůsobí se změnám rozložení a umí interpretovat zadání v běžné angličtině.
2. Kdo by měl používat AI web scraping nástroje jako Thunderbit?
Thunderbit je určený pro netechnické i technické uživatele. Hodí se pro lidi z obchodu, marketingu, provozu, výzkumu i ecommerce, kteří chtějí získávat strukturovaná data z webů, PDF nebo obrázků — bez psaní kódu.
3. Jaké funkce dělají Thunderbit výjimečným oproti jiným AI web crawlerům?
Thunderbit nabízí rozhraní v přirozeném jazyce, vícestupňové crawlingy, automatické strukturování dat, podporu OCR a bezproblémový export do nástrojů jako Google Sheets a Airtable. K tomu přidává AI návrhy polí a předpřipravené šablony pro populární weby.
4. Existují v roce 2026 bezplatné možnosti pro AI web scraping?
Ano. Thunderbit, Browse AI, DataMiner a Diffbot nabízejí free plány s omezeným využitím. Pro vývojáře poskytují open-source možnosti jako Crawl4AI a ScrapeGraphAI základní funkce bez licenčních nákladů na software, i když vyžadují technické nastavení a mohou zahrnovat náklady na hosting nebo modely.
5. Jak si vybrat správný AI web crawler pro své potřeby?
Začněte tím, že si určíte datové cíle, technické schopnosti, rozpočet a požadovaný rozsah. Pokud chcete snadné no-code řešení, Thunderbit nebo Browse AI jsou skvělé volby. Pro velké nebo specifické potřeby se lépe hodí nástroje jako Apify nebo Bright Data.




