

Reddit nyní uvádí 471,6 milionu týdenně aktivních unikátních uživatelů napříč více než 100 000 aktivními komunitami — a přesto je dnes získání těchto dat z Redditu ve strukturované a použitelné podobě těžší než kdy dřív. Po změně cen API v roce 2023, konci Pushshiftu jako veřejného archivu a nedávných žalobách Redditu proti AI firmám vypadá prostředí pro scraping úplně jinak než ještě před dvěma lety.
V Thunderbitu jsem roky budoval a testoval nástroje pro extrakci dat a sledoval jsem, jak se debata o scrapingu Redditu posunula od „prostě použij PRAW“ k „počkej, co vlastně ještě funguje?“. Tak jsem si prakticky prošel 12 Reddit scraperů — bezkódových, low-code i plně kódových — abych zjistil, které z nich v roce 2026 skutečně fungují pro obchodní týmy, marketéry, výzkumníky a ops profesionály, kteří potřebují data z Redditu bez zbytečné otravy. Tady je, k čemu jsem dospěl.
Vyzkoušej Thunderbit pro scraping Redditu
Proč jsou data z Redditu důležitá pro sales, marketing a výzkum
Reddit není jen další sociální platforma. Je to místo, kde lidé říkají, co si opravdu myslí — anonymně, bez filtru a s hlasováním nahoru, které vytahuje ty nejužitečnější odpovědi na povrch. To z něj dělá zlatý důl pro firemní týmy, ale takový, který je téměř nemožné sledovat ručně ve větším měřítku. Jen ve druhé polovině roku 2024 vytvořili uživatelé Redditu 237 milionů příspěvků a 1,79 miliardy komentářů. To je zhruba 1,3 milionu příspěvků a 9,7 milionu komentářů denně.
Potvrzují to i samotné podklady Redditu pro byznys: 74 % redditorů říká, že by na Redditu začali s hlubokým průzkumem produktu, a každou sekundu v průměru 2 lidé žádají komunity Redditu o doporučení, přičemž dostanou průměrně 14 osobních odpovědí. Značky jako Škoda Auto využily zpětnou vazbu z Redditu ke spoluvytváření produktů, což vedlo k o 255 % více objednávkám a 84% pozitivnímu sentimentu. Nespresso zaznamenalo díky kampaním poháněným Redditem o 30 % vyšší povědomí o reklamě.
Takto firmy data z Redditu skutečně využívají:
| Případ použití | Proč je Reddit silný | Co týmy scrapují |
|---|---|---|
| Generování leadů | Vlákna typu „jaký nástroj si mám koupit?“ mají vysoký záměr | Příspěvky, komentářová vlákna, autoři |
| Sledování značky | Nezastřené stížnosti i pochvaly se objevují brzy | Zmínky o značce, sentiment, shluky stížností |
| Konkurenční inteligence | Nákupčí mluví o konkurenci normálním jazykem | Srovnání produktů, důvody přechodu, chybějící funkce |
| Ověření produktu | Zpětná vazba v subredditech ukazuje bolestivá místa dřív než dotazníky | Požadavky na funkce, námitky, jazyk poptávky |
| Analýza sentimentu | Komentáře mají víc nuancí než hvězdičkové hodnocení | Komentářové stromy, vztah rodič–potomek, hlasy |
| Náměty na obsah | Otázky přímo odhalují poptávku po obsahu | Názvy příspěvků, opakující se dotazy, rámování v subredditu |
Výzva je jasná: tisíce vláken denně nelze sledovat ručně. A právě tady přicházejí na řadu scrapery — jenže pravidla se mezitím změnila.
Tvrdý zásah Redditu do API (2023–2026): co ještě funguje a co je rozbité
Pokud jste nesledovali přístupová pravidla Redditu, stručně řečeno: starý svět bezplatného, neomezeného přístupu k API a Pushshift jako veřejný datový archiv je pryč. Než si vyberete scraper, je nezbytné rozumět tomu, co se změnilo, protože to přímo určuje, které nástroje dnes ještě dokážou fungovat.
Časová osa změn
| Datum | Změna | Proč na tom záleží |
|---|---|---|
| Duben 2023 | Reddit oznámil zásadní změny API | Konec éry volného přístupu |
| Květen 2023 | Omezen přístup k Pushshiftu | Historický archiv se začal uzavírat |
| Červenec 2023 | Vešla v platnost bezplatná úroveň i placená komerční pravidla | Bezplatné API bylo omezené; komerční přístup zpoplatněn |
| Polovina roku 2024 | Spuštěn Reddit for Researchers (omezená beta) | Akademický přístup se přesunul do kontrolovaného režimu |
| Leden 2025 | Pushshift potvrzen jako dostupný jen pro ověřené moderátory a pouze pro moderaci | Už nejde o zadní vrátka pro výzkum |
| Červen 2025 | Reddit žaloval Anthropic | Eskalace právního postupu proti neoprávněnému využití dat pro AI |
| Říjen 2025 | Reddit žaloval Perplexity | Přístup k vymáhání se dále zpřísnil |
| Březen 2026 | Reddit aktualizoval Data API Wiki, Responsible Builder Policy a Developer Terms | Bezplatná úroveň, pravidla schvalování i odpor ke komercializaci zůstávají přísné |
Co stále funguje
- Bezplatná úroveň oficiálního Data API: Stále dostupná, s limitem 100 dotazů za minutu na OAuth client ID, počítaným v průměru za 10minutové okno.
- Koncovky
.json: Přidání.jsonk libovolné URL Redditu stále vrací data, ale je to rate-limited a není to určené pro škálování. - Scraping přes prohlížeč: Nástroje, které čtou vykreslenou stránku (jako Thunderbit nebo Octoparse), nepodléhají API kvótám stejným způsobem.
- Cloudové scraping služby: Platformy jako Apify a Oxylabs řeší vykreslování, proxy i opakované pokusy na své straně.
Co je rozbité
- Pushshift jako veřejný zdroj historie: Prakticky pryč. V roce 2026 je omezený na ověřené moderátory pro moderátorské použití.
- PRAW pro komerční sběr ve větším měřítku: Omezený jak limity bezplatné úrovně, tak širšími podmínkami Redditu.
- Jakýkoli workflow, který předpokládá, že přístup k API je automatický a komerční použití je v pohodě: Zastaralé.
Jak to ovlivňuje výběr nástroje
| Přístup | Dotýkají se ho limity API? | Přístup k historickým datům | Složitost nastavení |
|---|---|---|---|
| Reddit API (PRAW) | Ano — limit 1K příspěvků, rate limits | Omezeno na nedávné | Střední |
Koncovka .json | Ano — rate limited | Velmi omezený | Nízká |
| Scraping v prohlížeči (Thunderbit, Octoparse) | Ne — čte vykreslenou stránku | Jen to, co je viditelné / načitatelné | Velmi nízká |
| Cloudové scraping služby (Apify, Oxylabs) | Ne (proxy řeší samy) | Liší se podle poskytovatele | Nízká–střední |
Krátce: nástroje postavené primárně na API jsou dnes nejlepší pro vývojáře a přesně vymezené úlohy. Nástroje založené na prohlížeči a cloud scrapers jsou bezpečnější volbou pro netechnické týmy nebo vyšší objem použití.
Bez kódu vs. low-code vs. full-code: jak zvolit správný přístup ke scrapingu Redditu
Publikum pro Reddit scrapery je opravdu rozdělené. Někteří potřebují data z Redditu, ale nemají žádnou technickou podporu. Jiní mají technického operátora, ale ne dedikovaný crawler tým. A další chtějí plnou kontrolu na úrovni kódu. Správný přístup závisí na tom, do které skupiny patříte.
Uživatel v r/nocode nedávno napsal: „Pracuji na reddit scraperu, ale nemůžu získat reddit API klíče.“ Další v r/NoCodeSaaS popsal, jak si postavil živý dashboard s daty z Redditu pomocí Zapier + Airtable + Softr — bez jakéhokoli backendového kódu. To nejsou okrajové případy. Podle průzkumu Smarty Marketing mezi 150 interními marketingovými týmy 47,8 % uvedlo, že jejich hlavní bariérou u Redditu je nedostatečné pochopení platformy, zatímco 39 % se obávalo zabanování.
Tady je matice kompromisů:
| Faktor | Bez kódu | Low-code / API | Full-code |
|---|---|---|---|
| Doba nastavení | Minuty | Hodiny | Hodiny–dny |
| Údržba | Žádná (AI se přizpůsobí) | Nízká (aktualizace API) | Vysoká (změny rozložení/API) |
| Strop škálování | Střední | Vysoký | Střední (rate limity) |
| Možnosti úprav | Omezené | Střední | Neomezené |
| Cena | Bezplatná úroveň → placené | Platba za použití | Zdarma (ale čas vývojáře) |
Bez kódu (Thunderbit, Browse AI, Octoparse, ScrapeStorm, ParseHub): Nejlepší pro marketingové, obchodní a výzkumné týmy. Thunderbitův 2klikový AI postup je tady nejrychlejší cesta.
Low-code / API služby (Apify, ScrapingBee, Oxylabs, Firecrawl, ScrapeGraphAI): Nejlepší pro týmy s nějakými technickými zdroji, které potřebují škálování a správu proxy.
Full-code (PRAW, Scrapy): Nejlepší pro vývojáře, kteří chtějí maximální kontrolu — ale musejí počítat s omezeními API a průběžnou údržbou.
Jak jsme těchto 12 Reddit scraperů testovali a řadili
Každý nástroj jsem hodnotil podle těchto kritérií:
- Snadnost použití: Bez kódu, low-code, nebo full-code?
- Funkce specifické pro Reddit: Větvení komentářů, cílení na subreddit, historická data
- Zvládání současných omezení API Redditu a detekce botů
- Cenový model a limity bezplatné úrovně
- Možnosti exportu dat: CSV, JSON, Sheets atd.
- Podpora plánovaného / opakovaného scrapingu
- Nejvhodnější případ použití
Tady je hlavní srovnávací tabulka, abyste si mohli udělat přehled ještě před čtením jednotlivých recenzí:
| Nástroj | Přístup | Vyžaduje kód? | Zvládá limity API? | Vnořené komentáře | Bezplatná úroveň | Nejlepší pro |
|---|---|---|---|---|---|---|
| Thunderbit | AI scraper v prohlížeči / cloudu | Ne | Ano (v prohlížeči) | Ano (šablona pro podstránky + komentáře) | Ano — 6 stránek zdarma | Netechnické uživatele, generování leadů |
| Apify | Cloudová platforma pro aktory | Low-code | Ano | Částečně až silně (záleží na actoru) | Ano — omezené kredity | Hromadné scrapování subredditů |
| PRAW | Python API wrapper | Full code | Částečně (rate limity API) | Ano (s kódem) | Ano (bezplatná úroveň API) | Vývojáře, malé projekty |
| Octoparse | Vizuální scraper | Ne | Ano (v prohlížeči) | Lepší než běžně, ale ne dokonalý | Ano | Týmy scrapující více webů |
| Browse AI | Předpřipravení roboti | Ne | Ano | Částečně | Ano | Monitoring a sledování změn |
| ScrapingBee | API služba | Low-code | Ano (rotace proxy) | Nativní větvení ne | Ano — 1K kreditů | Vývojáře, kteří se chtějí vyhnout blokacím |
| Scrapy | Python framework | Full code | Ne (vlastní řešení) | Ano (když si to vytvoříte) | Ano (open-source) | Velké vlastní pipeline |
| ScrapeStorm | AI desktop aplikace | Ne | Ano (v prohlížeči) | Částečně | Ano | Začátečníky, automatické rozpoznávání |
| ParseHub | Vizuální desktop scraper | Ne | Ano (v prohlížeči) | Silný potenciál rekurze | Ano — 5 projektů | Složitými strukturami stránek |
| Firecrawl | API pro webová data | Low-code | Ano | Částečně | Ano — 500 kreditů | AI/LLM datové pipeline |
| Oxylabs | Proxy + scraping API | Low-code | Ano (enterprise proxy) | Částečně | Zkušební verze — 2K výsledků | Extrace ve firemním měřítku |
| ScrapeGraphAI | Postavené na AI promtu | Low-code | Ano | Částečně | Ano — 50 kreditů | AI-first scraping na základě promptů |
A teď jednotlivé recenze.
1. Thunderbit: Nejrychlejší bezkódový Reddit scraper pro obchodní týmy
 Thunderbit je AI web scraper, který jsme vytvořili u nás ve firmě, takže jeho možnosti pro Reddit znám do posledního detailu. Je to rozšíření pro Chrome, které scrapuje Reddit (a jakýkoli web) ve 2 krocích — bez kódu, bez API klíčů, bez nastavování. Hlavní myšlenka je, že má AI zjistit, jaká data jsou na stránce, ne vy.
Konkrétně pro Reddit Thunderbit nabízí:
- AI Suggest Fields: Kliknete na tlačítko na libovolné stránce subredditu a Thunderbit automaticky rozpozná sloupce jako název příspěvku, autor, upvoty, počet komentářů, URL a datum.
- Scraping podstránek: Otevřete URL každého příspěvku a získáte plný text, top komentáře, flair i vnořené odpovědi. Takhle dostanete hluboká data z komentářů bez dotyku API.
- Samostatný Reddit Post Comments Scraper: Thunderbit má šablonu pro Reddit komentáře, která z URL příspěvku vytáhne všechny komentáře, odkazy na vlákna, počty odpovědí i vnořené komentáře.
- Stránkování a nekonečné scrollování: Automaticky zvládá chování Redditu typu „načíst další“ pomocí dokumentace ke stránkování.
- Cloud Scraping: U veřejných stránek Redditu zpracuje Cloud Scraping až 50 stránek najednou pro větší rychlost.
- Bezplatný export: Posíláte data do Excelu, Google Sheets, Airtable, Notionu, CSV nebo JSON — exporty nejsou za paywallem.
- Plánovaný scraping: Napíšete rozvrh přirozeným jazykem (např. „každé pondělí v 9:00“), zadáte URL subredditů a data se automaticky exportují do cílové destinace.
Cena: Bezplatná úroveň (6 stránek), poté placené plány na kreditním principu od zhruba 9 USD/měsíc. Viz ceny Thunderbitu.
Nejlepší pro: Netechnické sales, marketingové a ops týmy, které potřebují data z Redditu rychle. Silný je také pro analýzu hodnotných vláken, kde chcete plná vykreslená data komentářů z jednotlivých stránek příspěvků.
Jak scrapovat subreddit s Thunderbitem ve 5 krocích
- Nainstalujte Thunderbit Chrome extension a přejděte na subreddit (např. r/SaaS).
- Klikněte na „AI Suggest Fields“ — Thunderbit automaticky rozpozná sloupce: název příspěvku, autor, upvoty, počet komentářů, URL, datum.
- Klikněte na „Scrape“ — data se naplní během několika vteřin. Na veřejných stránkách použijte pro rychlost Cloud Scraping.
- Klikněte na „Scrape Subpages“ pro obohacení dat — AI navštíví každou URL příspěvku a vytáhne plný text, top komentáře, flair a vnořené odpovědi.
- Exportujte do Google Sheets, Excelu, Airtable nebo Notionu — úplně zdarma.
Pro ukázku, jak to vypadá v praxi, se podívejte na Thunderbit YouTube kanál.
Preferujete kód? Tady je ekvivalent v PRAW zhruba v 15 řádcích Pythonu:
import praw

reddit = praw.Reddit(
    client_id="YOUR_ID",
    client_secret="YOUR_SECRET",
    user_agent="reddit-scraper-demo/0.1"
)

subreddit = reddit.subreddit("SaaS")
for post in subreddit.hot(limit=10):
    print(post.title, post.score, post.num_comments, post.permalink)
Thunderbit zabere asi 30 sekund a nula řádků kódu. PRAW znamená nastavit API přihlašovací údaje, napsat skript a vypořádat se s rate limity. Oba přístupy mají své místo — ale pro většinu obchodních uživatelů vyhrává 2kliková cesta.
2. Apify Reddit Scraper: Hromadná extrakce subredditů poháněná cloudem
 Apify je cloudová scraping platforma, ne jeden jediný Reddit nástroj. Hostuje komunitně vytvořené „Aktory“ — hotové scrapery, které můžete spouštět na infrastruktuře Apify s rotací proxy a anti-blockingem zabudovaným v základu.
- Aktory specifické pro Reddit: Více možností, včetně prodigerova Reddit Scraperu (od cca 0,60 USD / 1K příspěvků) a trudaxova Reddit Scraperu. Každý podporuje výpisy subredditů (hot, new, top, rising), vyhledávání podle klíčových slov, profily uživatelů a časové filtry.
- Vnořené komentáře: Apify má samostatného actoru Reddit Comments Deep Scraper s nastavitelnou hloubkou a poli rodič–potomek — jednu z nejsilnějších možností pro hlubokou extrakci vláken.
- Plánování: Vestavěný cronový plánovač na placených plánech.
- Export: JSON, CSV, XML, Excel, HTML Table, RSS, JSONL plus integrace přes API a webhooky.
- Cena: Bezplatná úroveň (cca 5 USD/měsíc v kreditech, asi 1K výsledků); placené plány od 49 USD/měsíc.
Nejlepší pro: Týmy, které potřebují škálovaný a opakovaný sběr dat z Redditu a mají k dispozici nějaké technické zdroje. Pokud potřebujete hluboké stromy komentářů ve velkém měřítku, dedikovaný deep scraper actor je skutečný rozdíl.
Poznámka: Kvalita i cena se liší podle actoru, takže před zavedením do workflow testujte.
3. PRAW (Python Reddit API Wrapper): Oblíbená volba vývojářů, ale s limity
 PRAW je stále standardní code-first wrapper pro Reddit API. Pokud jste Python vývojář, je to pravděpodobně první nástroj, po kterém sáhnete — a pro malé, přesně vymezené projekty pořád funguje dobře. Ale v roce 2026 patří do kategorie „vývojářský nástroj pro omezené workloady“, ne univerzální odpověď.
- Nejnovější verze: v7.8.1 (říjen 2024)
- Klíčové funkce: Přístup ke všem API endpointům (příspěvky, komentáře, informace o uživatelích); streamování příspěvků v reálném čase; procházení celých stromů komentářů s funkcí
replace_more() - Kritické omezení: Podléhá rate limitům Reddit API (100 dotazů/min na bezplatné úrovni), limit 1K příspěvků na jeden listing a od roku 2023 přísnějšímu vymáhání podmínek. PRAW sám upozorňuje, že víc než „zhruba tucet“ současně běžících instancí může narazit na rate limity.
- Export: Cokoliv napíšete v kódu (CSV, JSON, databáze atd.)
- Plánování: DIY přes cron joby (vyžaduje server a údržbu)
- Cena: Zdarma a open-source, ale komerční použití může vyžadovat placenou úroveň API Redditu.
Nejlepší pro: Python vývojáře a datové vědce, kteří potřebují vlastní integrace s Redditem pro malé až střední projekty a mohou žít s limitem API.
4. Octoparse: Vizuální scraping Redditu stylem klikni a získáš
 Octoparse je bezkódový vizuální web scraper s rozhraním typu point-and-click. Na rozdíl od mnoha obecně zaměřených vizuálních scraperů má skutečně veřejnou šablonu Reddit Scraper — a to je důležité, protože struktura stránek Redditu spoustu nástrojů mate.
- Šablona pro Reddit: Vyžaduje
old.reddit.com, podporuje až 1 000 URL příspěvků Redditu na jedno spuštění a umí extrahovat vlákna komentářů a odpovědí. Šablona upozorňuje na chybějící sbalené komentáře nebo komentáře pod „load more“. Pro hlubší srovnání se podívejte na naši recenzi Octoparse a alternativu. - Stránkování a nekonečný scroll: Podporováno, i když dynamické načítání Redditu může být pořád složité.
- Export: CSV, Excel, JSON, HTML, XML, databáze, Google Sheets.
- Plánování: Dostupné na placených plánech, včetně monitoringu a rodičovských/potomků úkolů.
- Cena: Bezplatný plán zahrnuje 10 úkolů, 2 souběžná spuštění a až 10 000 řádků na export. Placené plány začínají zhruba na 69–75 USD/měsíc.
Nejlepší pro: Týmy, které potřebují univerzální scrapingový nástroj pro Reddit i další weby bez kódování. Reddit šablona je opravdová výhoda oproti generickým vizuálním scraperům.
5. Browse AI: Předpřipravení Reddit roboti se sledováním změn
 Browse AI jde na to jinak: místo tvorby scraperů od nuly používáte předpřipravené „roboty“ navržené pro konkrétní weby. Pro Reddit Browse AI výslovně uvádí robota pro domovskou stránku Redditu a scraping subreddit postů, robota pro výsledky vyhledávání na Redditu a automatizace pro monitorování Redditu.
- Monitoring: Nastavíte upozornění na nové příspěvky, zmínky klíčových slov nebo změny v konkrétních subredditech. Plánování podporuje hodinové, denní, týdenní, měsíční nebo vlastní vzory.
- Integrace: CSV, JSON, Google Sheets, Airtable, Zapier, Make, API a webhooks.
- Cena: Bezplatná úroveň zahrnuje 50 kreditů měsíčně, 2 weby a 3 uživatele. Placené plány od cca 49 USD/měsíc.
Nejlepší pro: Netechnické uživatele, kteří chtějí automatizované monitorování Redditu bez ruční práce. Silné pro sledování značky a upozornění na konkurenci. Více o tomto nástroji najdete v naší recenzi Browse AI a alternativě.
Poznámka: Nenašel jsem aktuální veřejný důkaz o hluboké rekonstrukci vnořených stromů odpovědí, takže je fér říct, že je silný pro monitoring a extrakci na úrovni příspěvku, ale pro hluboké komentáře jen částečný.
6. ScrapingBee: Reddit scraping přes API se správou proxy
 ScrapingBee není produkt určený pro Reddit. Je to obecné scrapingové API, které řeší headless prohlížeče, rotaci proxy a CAPTCHA. Pošlete URL a zpátky dostanete čisté HTML, Markdown nebo extrahované JSON.
- Renderování JavaScriptu: Zvládá dynamické stránky Redditu.
- Rotace proxy: Automatická, aby se předešlo blokacím.
- Formáty výstupu: HTML, Markdown, prostý text, extrahované JSON.
- Bez vestavěného plánovače: Integrace přes cron nebo automatizační nástroje.
- Cena: Zkušební verze s 1 000 API kredity, bez nutnosti karty. Plány od 49 USD/měsíc.
Nejlepší pro: Vývojáře, kteří chtějí spolehlivý přístup ke stránkám Redditu bez vlastní správy proxy. Není to specialista na Reddit — nemá vestavěný parser Redditu ani větvení komentářů. Kompletní rozbor najdete v naší recenzi ScrapingBee a alternativě.
7. Scrapy: Open-source Python framework pro vlastní Reddit pipeline
 Scrapy je nejflexibilnější volba, pokud chce váš tým vlastnit celý crawler stack. Je to výkonný open-source Python framework s 61,4 tisíci hvězdičkami na GitHubu a jeho nejnovější verze je v2.15.0 (duben 2026).
- Asynchronní zpracování: Rychlé crawlání s XPath/CSS selektory pro přesné cílení.
- Rozšiřitelnost: Middleware a pipeline pro stránkování, procházení komentářů, čištění dat, rotaci proxy, správu user-agentů a AutoThrottle.
- Export: JSON, JSON Lines, CSV, XML, Pickle a Marshal.
- Kritický bod: Scrapy samo od sebe nezvládá anti-bot ochranu Redditu. Musíte si sami přidat rotaci proxy, správu user-agentů a rate limiting.
- Cena: Zdarma a open-source.
Nejlepší pro: Zkušené Python vývojáře, kteří staví rozsáhlé vlastní scrapovací systémy pro Reddit. Pokud chcete maximum kontroly a zvládnete údržbu, Scrapy se těžko překonává. Srovnání Python scrapingových nástrojů najdete v našem průvodci nejlepší Python web scraping nástroje.
8. ScrapeStorm: AI desktop scraper pro Reddit pro začátečníky
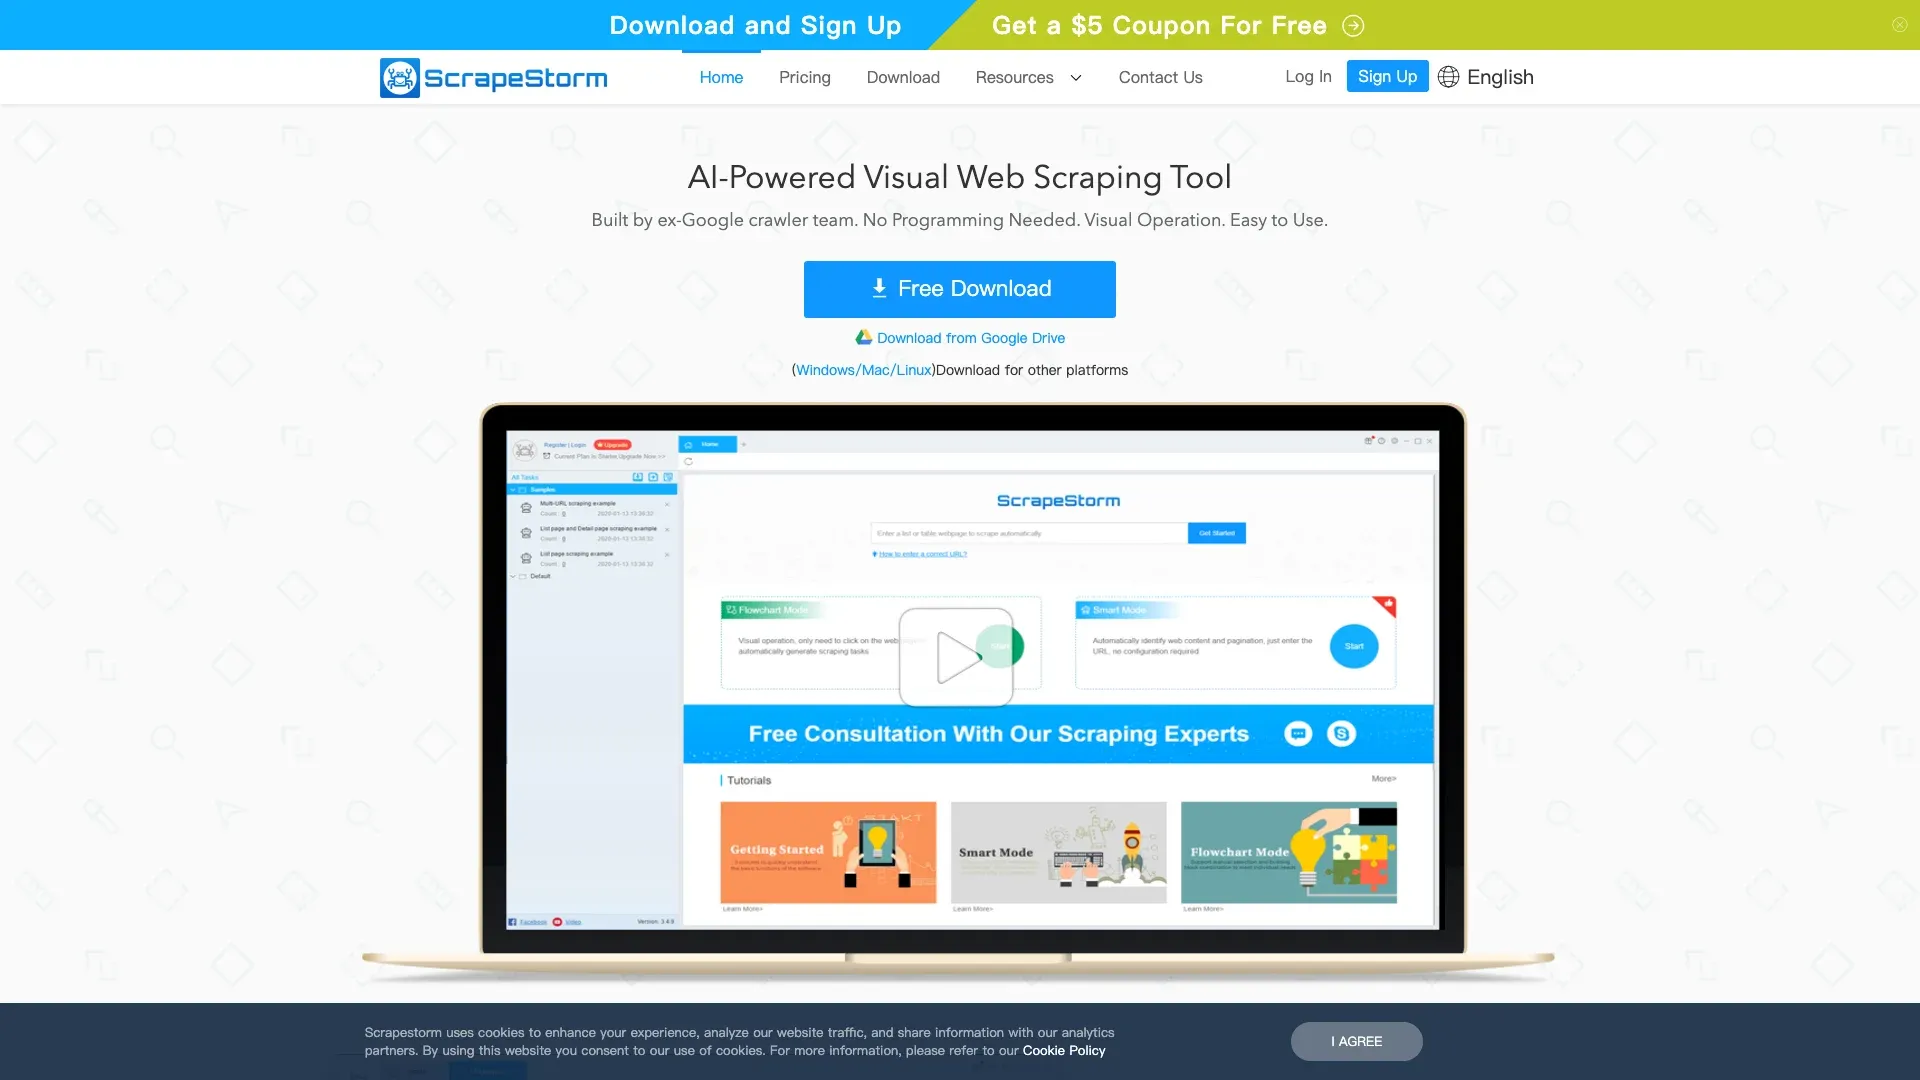 ScrapeStorm je AI desktopová aplikace, která automaticky rozpoznává datové vzory na libovolné webové stránce. Současná verze je v4.0.6 (prosinec 2025).
- Automatické rozpoznávání: AI identifikuje data příspěvků (názvy, skóre, autoři) bez ruční konfigurace.
- Vizuální rozhraní: Umožňuje upravit výběr, nastavit plánované scrapování (hodinové/denní/týdenní) a exportovat do Excelu, TXT, CSV, HTML, databází a Google Sheets.
- Cena: Navždy zdarma úroveň; placené plány od 49,99 USD/měsíc.
Nejlepší pro: Začátečníky, kteří chtějí AI asistovaný scraping Redditu bez kódu nebo složitého nastavování. Pro hlubší pohled se podívejte na naši recenzi ScrapeStorm a alternativu.
Poznámka: Nenašel jsem Reddit-specifickou dokumentaci, která by prokazovala hlubokou extrakci vnořených komentářů. Dobré pro scraping povrchu, ale hloubka vláken bude pravděpodobně omezená, pokud si nevytvoříte pečlivý flowchartový postup.
9. ParseHub: Vizuální desktop scraper pro složité stránky Redditu
 ParseHub je desktopová aplikace s vizuálním point-and-click rozhraním, která zvládá stránky náročné na JavaScript i dynamicky načítané stránky. Vyniká nad mnoha bezkódovými nástroji explicitní podporou rekurzivních / vnořených extrakčních vzorů.
- Vnořená data: ParseHub dokumentuje funkce Jump, Relative Select a CSV Wide pro zpracování extrakce komentářových vláken — silnější než většina no-code DOM nástrojů, pokud investujete čas do builderu.
- Plánování: Na placených plánech může běžet klidně každou minutu.
- Export: CSV, JSON, Excel, přístup přes API.
- Cena: Zdarma až pro 5 projektů; placené od cca 89 USD/měsíc.
Nejlepší pro: Uživatele, kteří potřebují scrapovat složité, na JavaScript bohaté struktury stránek Redditu bez kódování — zvlášť pokud jste ochotni naučit se pokročilejší funkce vizuálního builderu. Více najdete v naší recenzi ParseHub a alternativě.
10. Firecrawl: API pro webová data postavené pro AI a LLM pipeline
 Firecrawl je API navržené tak, aby procházelo libovolnou webovou stránku a převádělo ji na čistý Markdown nebo strukturovaná data, optimalizované pro krmení AI/LLM aplikací daty. Není to nativní scraper pro Reddit, ale pokud chcete dostat obsah z Redditu do RAG pipeline nebo znalostní báze, je to velmi vhodná volba.
- Formáty výstupu: Markdown, HTML, screenshot, odkazy, JSON, obrázky, branding, audio. Extrakce do JSON stojí více kreditů.
- Směrování přes proxy a renderování JS: Zdokumentováno a zajištěno.
- Bez vestavěného plánovače: Integrace přes automatizační nástroje.
- Cena: Bezplatná úroveň s 500 jednorázovými kredity; placené od cca 16 USD/měsíc.
Nejlepší pro: Technické týmy, které posílají data z Redditu do AI modelů, RAG pipeline nebo znalostních bází. Pro hlubší srovnání se podívejte na naši recenzi Firecrawl a alternativy.
Poznámka: Nemá nativní větvení komentářů na Redditu — dodává obsah stránky jako Markdown nebo strukturovaný JSON. Silný pro zachycení obsahu, ne pro analýzu stromově strukturovaných vláken.
11. Oxylabs: Reddit scraping v enterprise kvalitě s proxy infrastrukturou
 Oxylabs je web scraping a proxy služba zaměřená na enterprise. Nabízí jak surové proxy, tak strukturované Web Scraper API s plánováním, cloudovým doručením a obrovskými proxy pooly.
- Škála: Uvádí více než 177 milionů IP ve 195 zemích a 15 000+ partnerů.
- Plánovač: Zdokumentován; opakované úlohy mohou doručovat data do AWS S3 nebo GCS.
- Hodnocení na G2: 4,5/5 z 425 recenzí.
- Cena: Zkušební verze až do 2 000 výsledků; Web Scraper API od 49 USD/měsíc. Enterprise cena pak škáluje výš.
Nejlepší pro: Velké firmy nebo agentury, které potřebují vysoký objem a spolehlivou extrakci dat z Redditu ve velkém měřítku. Kompletní recenzi najdete v naší recenzi Oxylabs a alternativě.
Poznámka: Nenašel jsem Reddit-specifickou šablonu nebo parser od Oxylabs. Je to řešení infrastruktury — silné, ale Reddit-specific logiku si musíte postavit sami.
12. ScrapeGraphAI: Extrakce z Redditu řízená AI prompty
 ScrapeGraphAI je jeden z novějších AI-first nástrojů. V obyčejné angličtině popíšete, co chcete extrahovat, a AI se postará o zbytek — žádné selektory, žádná schémata.
- GitHub: 21,9 tisíce hvězdiček.
- Výstup: JSON, CSV, Markdown.
- Cena: Bezplatná úroveň s 50 API kredity a 10 požadavky/min; placené od cca 17 USD/měsíc.
Nejlepší pro: Uživatele, kteří chtějí scraping Redditu nejprve přes AI prompty, bez ruční definice selektorů či schémat. Více najdete v naší recenzi ScrapeGraphAI a alternativě.
Poznámka: Nenašel jsem veřejnou Reddit-specifickou dokumentaci, která by benchmarkovala přesnost jeho komentářových vláken. Je to silný obecný nástroj na prompt-based extrakci, ne specialista optimalizovaný přímo pro Reddit.
Problém vnořených komentářů: které Reddit scrapery zvládnou hluboká vlákna
Tohle je část, kterou většina seznamů „nejlepší Reddit scraper“ vynechá, a přitom je nejdůležitější pro seriózní výzkum. Konverzace na Redditu mají stromovou strukturu a ta je analyticky důležitá. Studie z roku 2024 v Applied Network Science ukázala, že modelování hierarchické struktury vláken Redditu je důležité pro pochopení společenských jevů. Preprint z roku 2022 uvádí medián hloubky komentáře 3 a maximum 828.
Pokud děláte analýzu sentimentu, sběr trénovacích dat pro AI nebo kvalitativní výzkum, potřebujete celý strom komentářů — ne jen odpovědi nejvyšší úrovně. Většina scraperů komentáře zplošťuje, protože čtou jen viditelný DOM nebo výchozí limit parametru API.
Takhle si stojí vedle sebe:
| Nástroj | Hloubka komentářů | Metoda |
|---|---|---|
| PRAW | Celý strom (s kódem) | API volání replace_more() — žere rate limit |
| Apify Deep Scraper | Celý strom | Vyhrazený actor |
| Thunderbit | Celé viditelné vlákno | Šablona pro Reddit komentáře + scraping podstránek jednotlivých URL příspěvků |
| ParseHub | Silný potenciál rekurze | Relative Select + Jump + CSV Wide |
| Octoparse | Lepší než běžně, ale nedokonalý | Reddit šablona s extrakcí komentářů a odpovědí; minula sbalené / load-more případy |
| Browse AI | Částečná | Dobré pro monitoring, slabší důkaz pro rekurzivní hloubku |
| ScrapeStorm | Částečná | Obecná extrakce DOM/prohlížeče |
| Firecrawl | Částečná | Dobré pro zachycení obsahu, ne specialista na stromová vlákna |
| Oxylabs | Částečná | Dá se postavit přes instrukce prohlížeče, ale bez Reddit-specifické dokumentace |
| ScrapeGraphAI | Částečná | Prompt/schéma extrakce z vykresleného obsahu |
Praktická rada: Pro hromadné scrapování na úrovni subredditu bývají zploštělá data často v pořádku. Pro konkrétní vysoce hodnotná vlákna (zpětná vazba k produktu, průzkum trhu, konkurenční inteligence) použijte nástroj, který navštíví jednotlivé stránky příspěvků a vytáhne celé vykreslené komentářové vlákno.
Monitoring Redditu nastavený jednou a hotovo: plánovaný scraping pro brand a market intel
Pro mnoho obchodních týmů není skutečná otázka „Dokážu Reddit jednou vyscrapovat?“ — ale „Dokážu každý den bez hlídání stahovat zmínky o značce a konkurenci?“. Uživatel v r/NoCodeSaaS popsal, jak si postavil živý dashboard s daty z Redditu pomocí Zapier + Airtable + Softr pro statistiky subredditů a růstové trendy, a to bez psaní backendového kódu. Přesně to je typ workflow, který umožňuje plánovaný scraping.
Případy použití
- Sledujte zmínky o své značce nebo konkurentech v r/SaaS, r/ecommerce, r/startups
- Monitorujte diskuze o cenách a srovnání produktů
- Zachycujte nové leady, kteří žádají o doporučení v niche subredditech
- Posílejte týdenní digesty z Redditu týmu do Slacku nebo e-mailu
Jak si vedou nástroje vedle sebe
| Nástroj | Vestavěné plánování | Obtížnost nastavení | Automatický export |
|---|---|---|---|
| Thunderbit | Ano — plánování přirozeným jazykem | Velmi snadné | Sheets, Airtable, Notion, CSV, JSON |
| Apify | Ano — cronový plánovač | Střední | Datasets, API, webhooks |
| Browse AI | Ano — monitorovací roboti | Snadné | CSV, JSON, Sheets, Airtable, integrace |
| PRAW + cron | Jen vlastní řešení | Těžké (server, údržba) | Cokoliv napíšete v kódu |
| Octoparse | Ano (placené plány) | Střední | CSV, Excel, JSON, databáze, Sheets |
| ParseHub | Ano (placené plány) | Střední | CSV, JSON, API |
Plánovaný scraper v Thunderbitu vám umožní napsat něco jako „každé pondělí v 9:00“, zadat URL subredditů a kliknout na Naplánovat. Data se automaticky exportují do Sheets, Airtable nebo Notionu, takže si váš tým může nastavit alerty nebo dashboardy, aniž by se musel ke scraperu vracet. Více o automatizaci sběru webových dat jsme sepsali v samostatném průvodci.
Srovnání vedle sebe: všech 12 Reddit scraperů na první pohled
| Nástroj | Přístup | Vyžaduje kód | Zvládá limity API? | Vnořené komentáře | Bezplatná úroveň | Startovní cena | Nejlepší pro |
|---|---|---|---|---|---|---|---|
| Thunderbit | AI scraper v prohlížeči/cloudu | Ne | Ano | Silné (šablona komentářů + podstránky) | Ano | Zdarma / cca 9 USD/měsíc | Netechnické obchodní týmy |
| Apify | Platforma pro aktyory | Nízké | Ano | Částečně až silně | Ano (omezené kredity) | Podle actoru / 49 USD/měsíc | Hromadné scrapování subredditů |
| PRAW | API wrapper | Ano | Částečně | Ano | Ano | Zdarma | Vývojáře, datové vědce |
| Octoparse | Vizuální scraper | Ne | Ano | Lepší než běžně, ale nedokonalý | Ano | cca 69–75 USD/měsíc | Bezkódové scrapování více webů |
| Browse AI | Monitorovací roboti | Ne | Ano | Částečně | Ano | cca 49 USD/měsíc | Monitoring a alerty |
| ScrapingBee | API služba | Nízké | Ano | Bez nativního větvení | Ano (1K kreditů) | 49 USD/měsíc | Vývojáře, kteří nechtějí řešit proxy |
| Scrapy | Python framework | Ano | Ne (vlastní řešení) | Ano (když si to vytvoříte) | Ano | Zdarma | Vlastní pipeline s plnou kontrolou |
| ScrapeStorm | AI desktop aplikace | Ne | Ano | Částečně | Ano | 49,99 USD/měsíc | Začátečníky |
| ParseHub | Vizuální desktop scraper | Ne | Ano | Silný potenciál rekurze | Ano (5 projektů) | cca 89 USD/měsíc | Složité dynamické stránky |
| Firecrawl | API pro webová data | Nízké | Ano | Částečně | Ano (500 kreditů) | cca 16 USD/měsíc | AI/LLM pipeline |
| Oxylabs | Web scraping API + proxy | Nízké–střední | Ano | Částečně | Zkušební verze (2K výsledků) | 49 USD/měsíc | Enterprise scale |
| ScrapeGraphAI | AI založené na promptech | Nízké–střední | Ano | Částečně | Ano (50 kreditů) | cca 17 USD/měsíc | AI workflow orientované na prompt |
Některé vzorce z toho jasně vyplývají. Bezkódové nástroje vyhrávají na rychlosti a přístupnosti. Kódové nástroje vyhrávají v možnostech úprav. Cloudové API nástroje vyhrávají ve škálování.
Pro hloubku specifickou pro Reddit — hlavně u vnořených komentářů — skutečně funguje jen hrstka nástrojů: PRAW, deep scraper od Apify, šablona komentářů v Thunderbitu a rekurzivní extrakce v ParseHubu.
Jak vybrat nejlepší Reddit scraper pro váš tým
Po otestování všech 12 bych to seřadil takto:
- Sales nebo marketingový tým bez vývojářů? Začněte s Thunderbitem nebo Browse AI. Thunderbit je nejrychlejší pro jednorázový i plánovaný scraping; Browse AI je nejsilnější pro monitorovací alerty.
- Potřebujete hromadná data ze subredditů a máte nějaké technické zdroje? Apify nebo Oxylabs. Ekosystém actorů v Apify vám dá Reddit-specifické možnosti; Oxylabs poskytuje enterprise infrastrukturu.
- Vývojář stavící vlastní pipeline? PRAW nebo Scrapy. PRAW pro workflow založený na API; Scrapy pro crawl s plnou kontrolou. Jen si vyhraďte rozpočet na údržbu a správu rate limitů.
- Data z Redditu pro AI/LLM aplikace? Firecrawl, ScrapeGraphAI nebo API Thunderbitu. Firecrawl vyniká v Markdown výstupu pro RAG; ScrapeGraphAI je skvělý pro extrakci pomocí promptů.
- Průběžný monitoring a alerty? Thunderbit Scheduled Scraper, Browse AI nebo plánování v Apify.
Krátká poznámka k právním a etickým aspektům
Podmínky Redditu jsou dnes přísnější. Komerční používání API vyžaduje schválení, Pushshift už není veřejný archiv a Reddit aktivně žaluje firmy za neoprávněný scraping. Scraping veřejných stránek je technicky možný, ale riziko z pohledu pravidel je reálné. Pokud váš tým sbírá osobní údaje, ukládá smazaný obsah nebo ve velkém měřítku buduje komerční monitoring, je na místě právní kontrola. Vždy respektujte Uživatelskou dohodu Redditu a Developer Terms.
Závěr
Data z Redditu jsou cennější než kdy dřív — a zároveň se k nim těžko dostává víc než dřív. Nástroje, které fungovaly v roce 2022, už v roce 2026 nefungují všechny.
Přístupy založené na API jsou dnes omezené rate limity a komerčními restrikcemi. Nástroje pro scraping v prohlížeči a v cloudu se staly praktickým standardem pro většinu obchodních týmů.
Pokud chcete vidět, jak vypadá moderní scraping Redditu bez psaní jediného řádku kódu, vyzkoušejte bezplatnou zkušební verzi Thunderbitu. A pokud Thunderbit není úplně ideální, zkuste pár dalších z tohoto seznamu. Nejlepší scraper je ten, který vám skutečně dodá data, která potřebujete, včas a bez toho, aby vám sežral víkend.
Přeji příjemné scrapování — a ať se vaše komentářové stromy vždycky plně rozbalí.
Vyzkoušej Thunderbit pro scraping Redditu Get Started Free
Časté dotazy
1. Je v roce 2026 legální scrapovat Reddit?
Uživatelská dohoda Redditu a Developer Terms jasně omezují scraping bez písemného souhlasu a komerční použití API vyžaduje schválení. Reddit žaloval firmy jako Anthropic a Perplexity za neoprávněné využití dat. Přístup k veřejným stránkám je technicky možný, ale riziko z pohledu pravidel i sporů je reálné. Pokud scrapujete ve větším měřítku nebo pro komerční účely, právní kontrola je dobrý nápad.
2. Dá se Reddit scrapovat bez kódování?
Ano. Nejsilnější bezkódové možnosti v roce 2026 jsou Thunderbit, Browse AI, Octoparse, ScrapeStorm a ParseHub. 2klikový AI postup Thunderbitu je pro netechnické uživatele nejrychlejší cesta — žádné API klíče, žádné nastavování, žádné skripty.
3. Jaký je nejlepší bezplatný Reddit scraper?
Pro vývojáře je PRAW stále nejlepší bezplatná kódová volba (s ohledem na limity API). Pro netechnické uživatele nabízejí Thunderbit, Browse AI a Octoparse smysluplné bezplatné úrovně. Thunderbit vám dá 6 stránek zdarma s plným exportem do Sheets, Excelu, Airtable i Notionu.
4. Jak obejdu limit 1 000 příspěvků na Redditu?
Obvykle ho nejde čistě obejít přes oficiální API — tenhle strop je pořád praktickým omezením pro listingové API workflow. Realističtější alternativou je scraping přes prohlížeč (Thunderbit, Octoparse), cloudové přístupy přes aktyory (Apify) nebo užší cílené dotazy. Pro hluboká historická data už starý workaround přes Pushshift není k dispozici.
5. Můžu scrapovat komentáře z Redditu spolu s příspěvky?
Ano, ale kvalita nástrojů se výrazně liší. PRAW umí projít celý strom komentářů (za cenu rate limitu API). Reddit Comments Deep Scraper od Apify je k tomu účelu přímo navržený. Šablona pro Reddit komentáře v Thunderbitu a scraping podstránek také vytáhnou celé vykreslené komentářové vlákno z jednotlivých stránek příspěvků. Rekurzivní extrakce v ParseHubu zvládne vnořené komentáře také, pokud ji pečlivě nastavíte.
Více k přečtení



