
網路成長的速度真的快到讓人追不上——到了 2026 年,幾乎有一半的網際網路流量來自機器人,而其中很大一部分其實是企業在抓取資料,用來支援銷售、營運與競爭研究。我親眼看過網頁爬蟲如何從「技術人員的加分工具」,變成銷售團隊、房地產經紀人等各行各業都離不開的必備利器。但問題是:不是每一家網頁爬蟲公司都一樣優秀,選錯工具,結果可能不是順暢的自動化流程,而是一整週無止盡的複製貼上地獄。
所以,我親自整理並深入研究了 2026 年最值得關注的網頁爬蟲公司。不論你是只想兩下點擊就拿到資料的非技術使用者,還是想要完全掌控流程的開發者,這份清單都能幫你快速找到最適合的工具——我也會老實說出每家公司的強項,以及它們不那麼完美的地方。那我們直接開始吧。
為什麼企業需要頂尖的網頁爬蟲公司
使用 AI 從任何網站抓取資料 Get Started Free
如果你曾經想過建立名單、追蹤競品價格,或從數十甚至數千個頁面中抓取產品資料,你一定懂手動收集資料有多痛苦:速度慢、容易出錯,而且老實說,沒人會覺得這件事有趣。也因為如此,網頁爬蟲已經發展成一個真正的產業,企業會把它用在潛在客戶開發、價格監控、市場研究與情緒分析等各種場景。
真正的關鍵在於:自動化。現代網頁爬蟲公司可以幫你做到:
- 自動化重複性的研究工作(再也不用無限複製貼上)
- 大規模擴展到數千個頁面,也不必額外加班
- 直接整合資料到你常用的工具中(Excel、Google Sheets、Notion、CRM 等)
- 比競爭對手更快取得更新、更完整的資料,保持領先
但選擇這麼多,該怎麼挑?這就是這篇指南要解決的問題。
我們如何評估這些頂尖網頁爬蟲公司
不是每一款爬蟲都適合同一種使用者,也不適合同一種任務。以下是我評估這些工具的標準:
- 易用性: 不懂程式的人能不能快速上手?介面直不直觀?
- 自動化與功能: 能不能處理分頁、子頁面、排程和動態內容?
- 擴展性: 能不能應付大型專案,還是只適合小型任務?
- 整合能力: 匯出資料或串接其他工具方不方便?
- 價格: 有沒有免費方案?對中小企業是否友善,對大型企業是否也能擴充?
- 支援與社群: 有沒有教學、範本,以及需要時能得到的實際幫助?
我也特別留意每家公司的獨特之處——因為有時候,「最好」的工具不一定是功能最多的,而是最符合你工作流程的那一個。
好,現在開始看名單。
1. Thunderbit
 Thunderbit 是我對 2026 年最期待的 AI 網頁爬蟲——不只是因為我參與打造它!Thunderbit 專為想要資料、不要麻煩的商務使用者設計。它的 Chrome 擴充功能可以讓你用自然語言提示詞和 AI 欄位建議,直接抓取任何網站。不用寫程式、不用模板、不用焦慮。
Thunderbit 的亮點:
- 一鍵抓取: 只要按下「One-Click Extract」,剩下交給 Thunderbit 的 AI。
- 支援子頁面與分頁: 先抓列表,再讓 AI 自動進入每個子頁面補充細節。
- 即時模板: 針對 Amazon、Zillow、Shopify 等熱門網站,可直接套用預建模板,一鍵抓取。
- 免費匯出資料: 可匯出到 Excel、Google Sheets、Notion 或 Airtable——你的資料不會被鎖住。
- AI 資料增強: 抓取時就能同時標記、分類與翻譯資料。
- 排程與雲端抓取: 可設定定期任務,或在雲端執行以提升速度。
- 完全免費方案: 可免費抓取最多 6 個頁面,或在試用加碼後抓 10 頁。付費方案從每月 15 美元起。
Thunderbit 受到全球超過20 萬名使用者信賴,從銷售團隊到電商營運都在用。如果你想在 2026 年體驗最簡單、最友善的網頁爬蟲,Thunderbit 幾乎很難被超越。
想看看它怎麼運作嗎?下載 Chrome 擴充功能親自試試看。
2. Scrapy
 Scrapy 是開發者最常用的開源 Python 框架,適合想要完全掌控流程的人。它強大、彈性高,經得起實戰考驗,無論是小型網站爬取,還是百萬級頁面抓取都能派上用場。
適合對象: 技術團隊、資料工程師,以及任何熟悉 Python 的人。
主要功能:
- 自訂規則建立: 可自行打造 spider,應對各種網站結構。
- 高擴展性與高速: 可處理大規模抓取,並具備強大的錯誤處理機制。
- 可整合 Python 生態系: 可接 Pandas、Jupyter 等工具。
- 免費且開源: 沒有授權費,社群資源也非常豐富。
提醒: Scrapy 有一定學習門檻。如果你不會寫程式,可能會想找別的工具;但對開發者來說,它絕對是個強力選擇(ScraperAPI)。
3. ParseHub
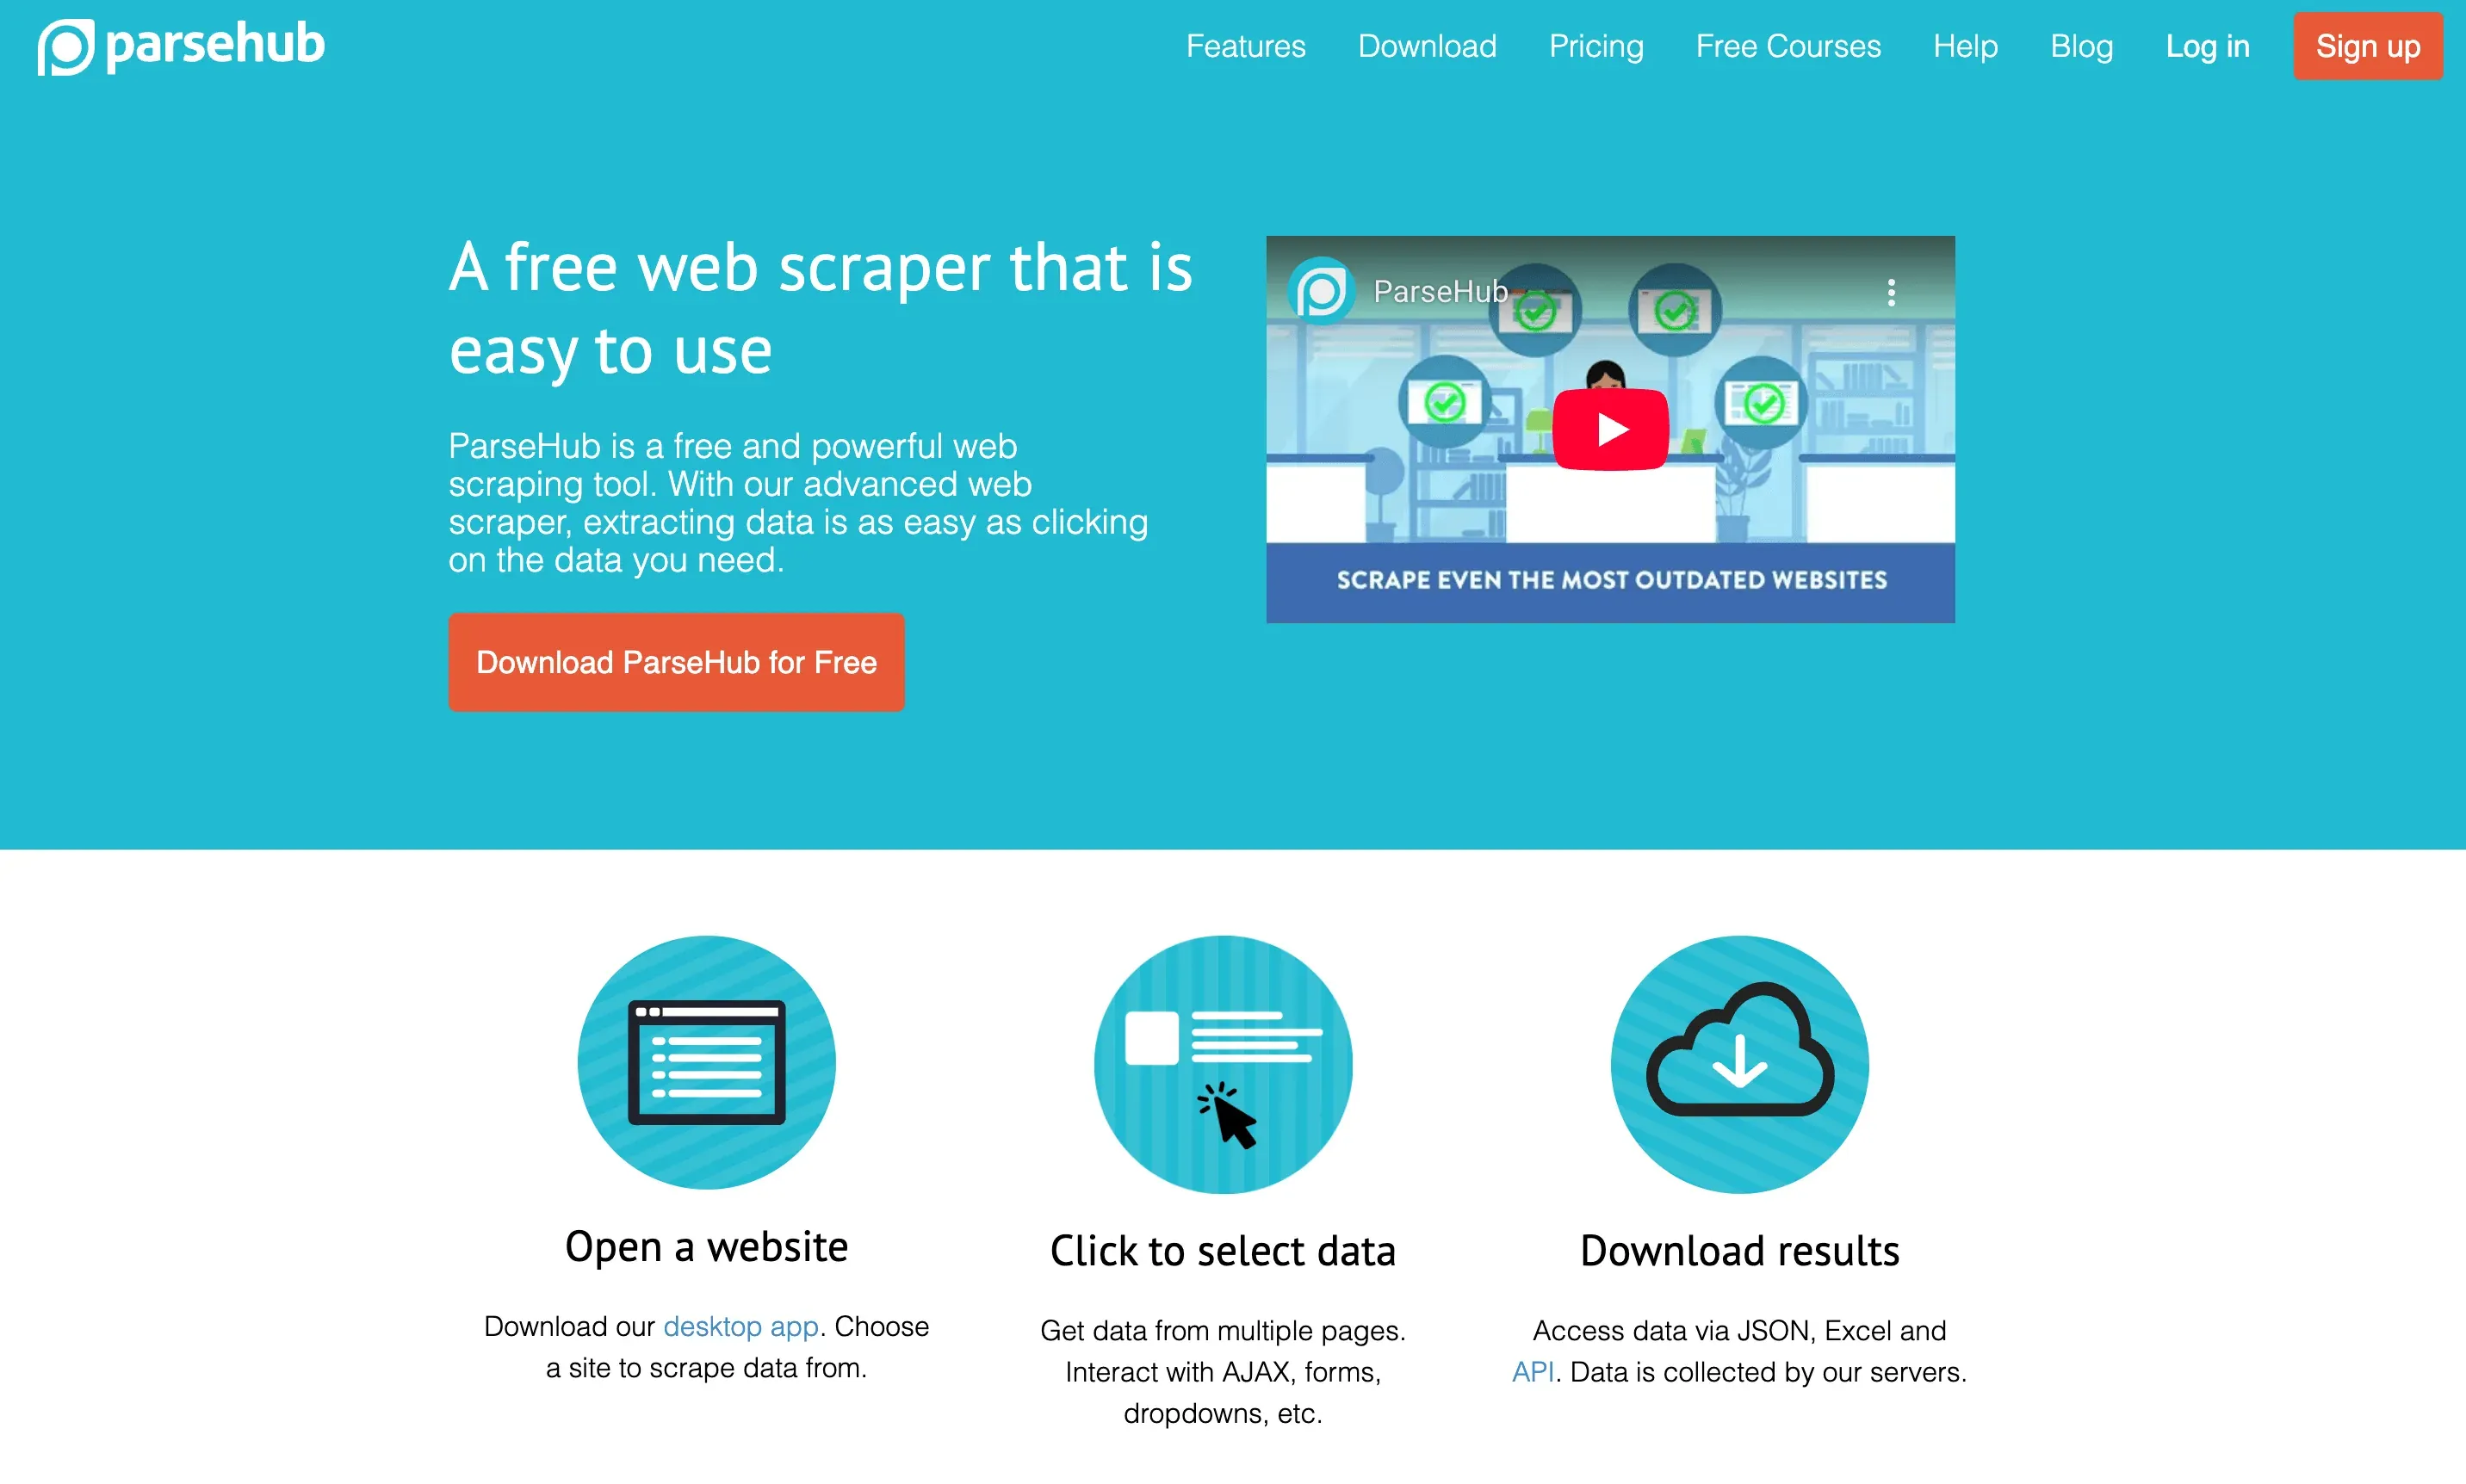 ParseHub 是一款桌面應用程式,讓網頁爬蟲變得更直覺、也更容易上手。它的點選式介面讓你不用寫程式就能建立爬蟲。
適合對象: 中小企業、研究人員,以及想要彈性但不會寫程式的人。
主要功能:
- 視覺化流程: 透過點擊選取資料,並建立分頁與子頁面邏輯。
- 雲端排程: 即使電腦關機,也能依排程自動執行抓取。
- 匯出選項: 可下載為 CSV、Excel 或 JSON。
- 免費方案: 5 個專案,每次執行最多 200 頁;付費方案每月 189 美元起。
ParseHub 特別適合抓取清單、評論與電商資料(ScraperAPI)。
4. Octoparse
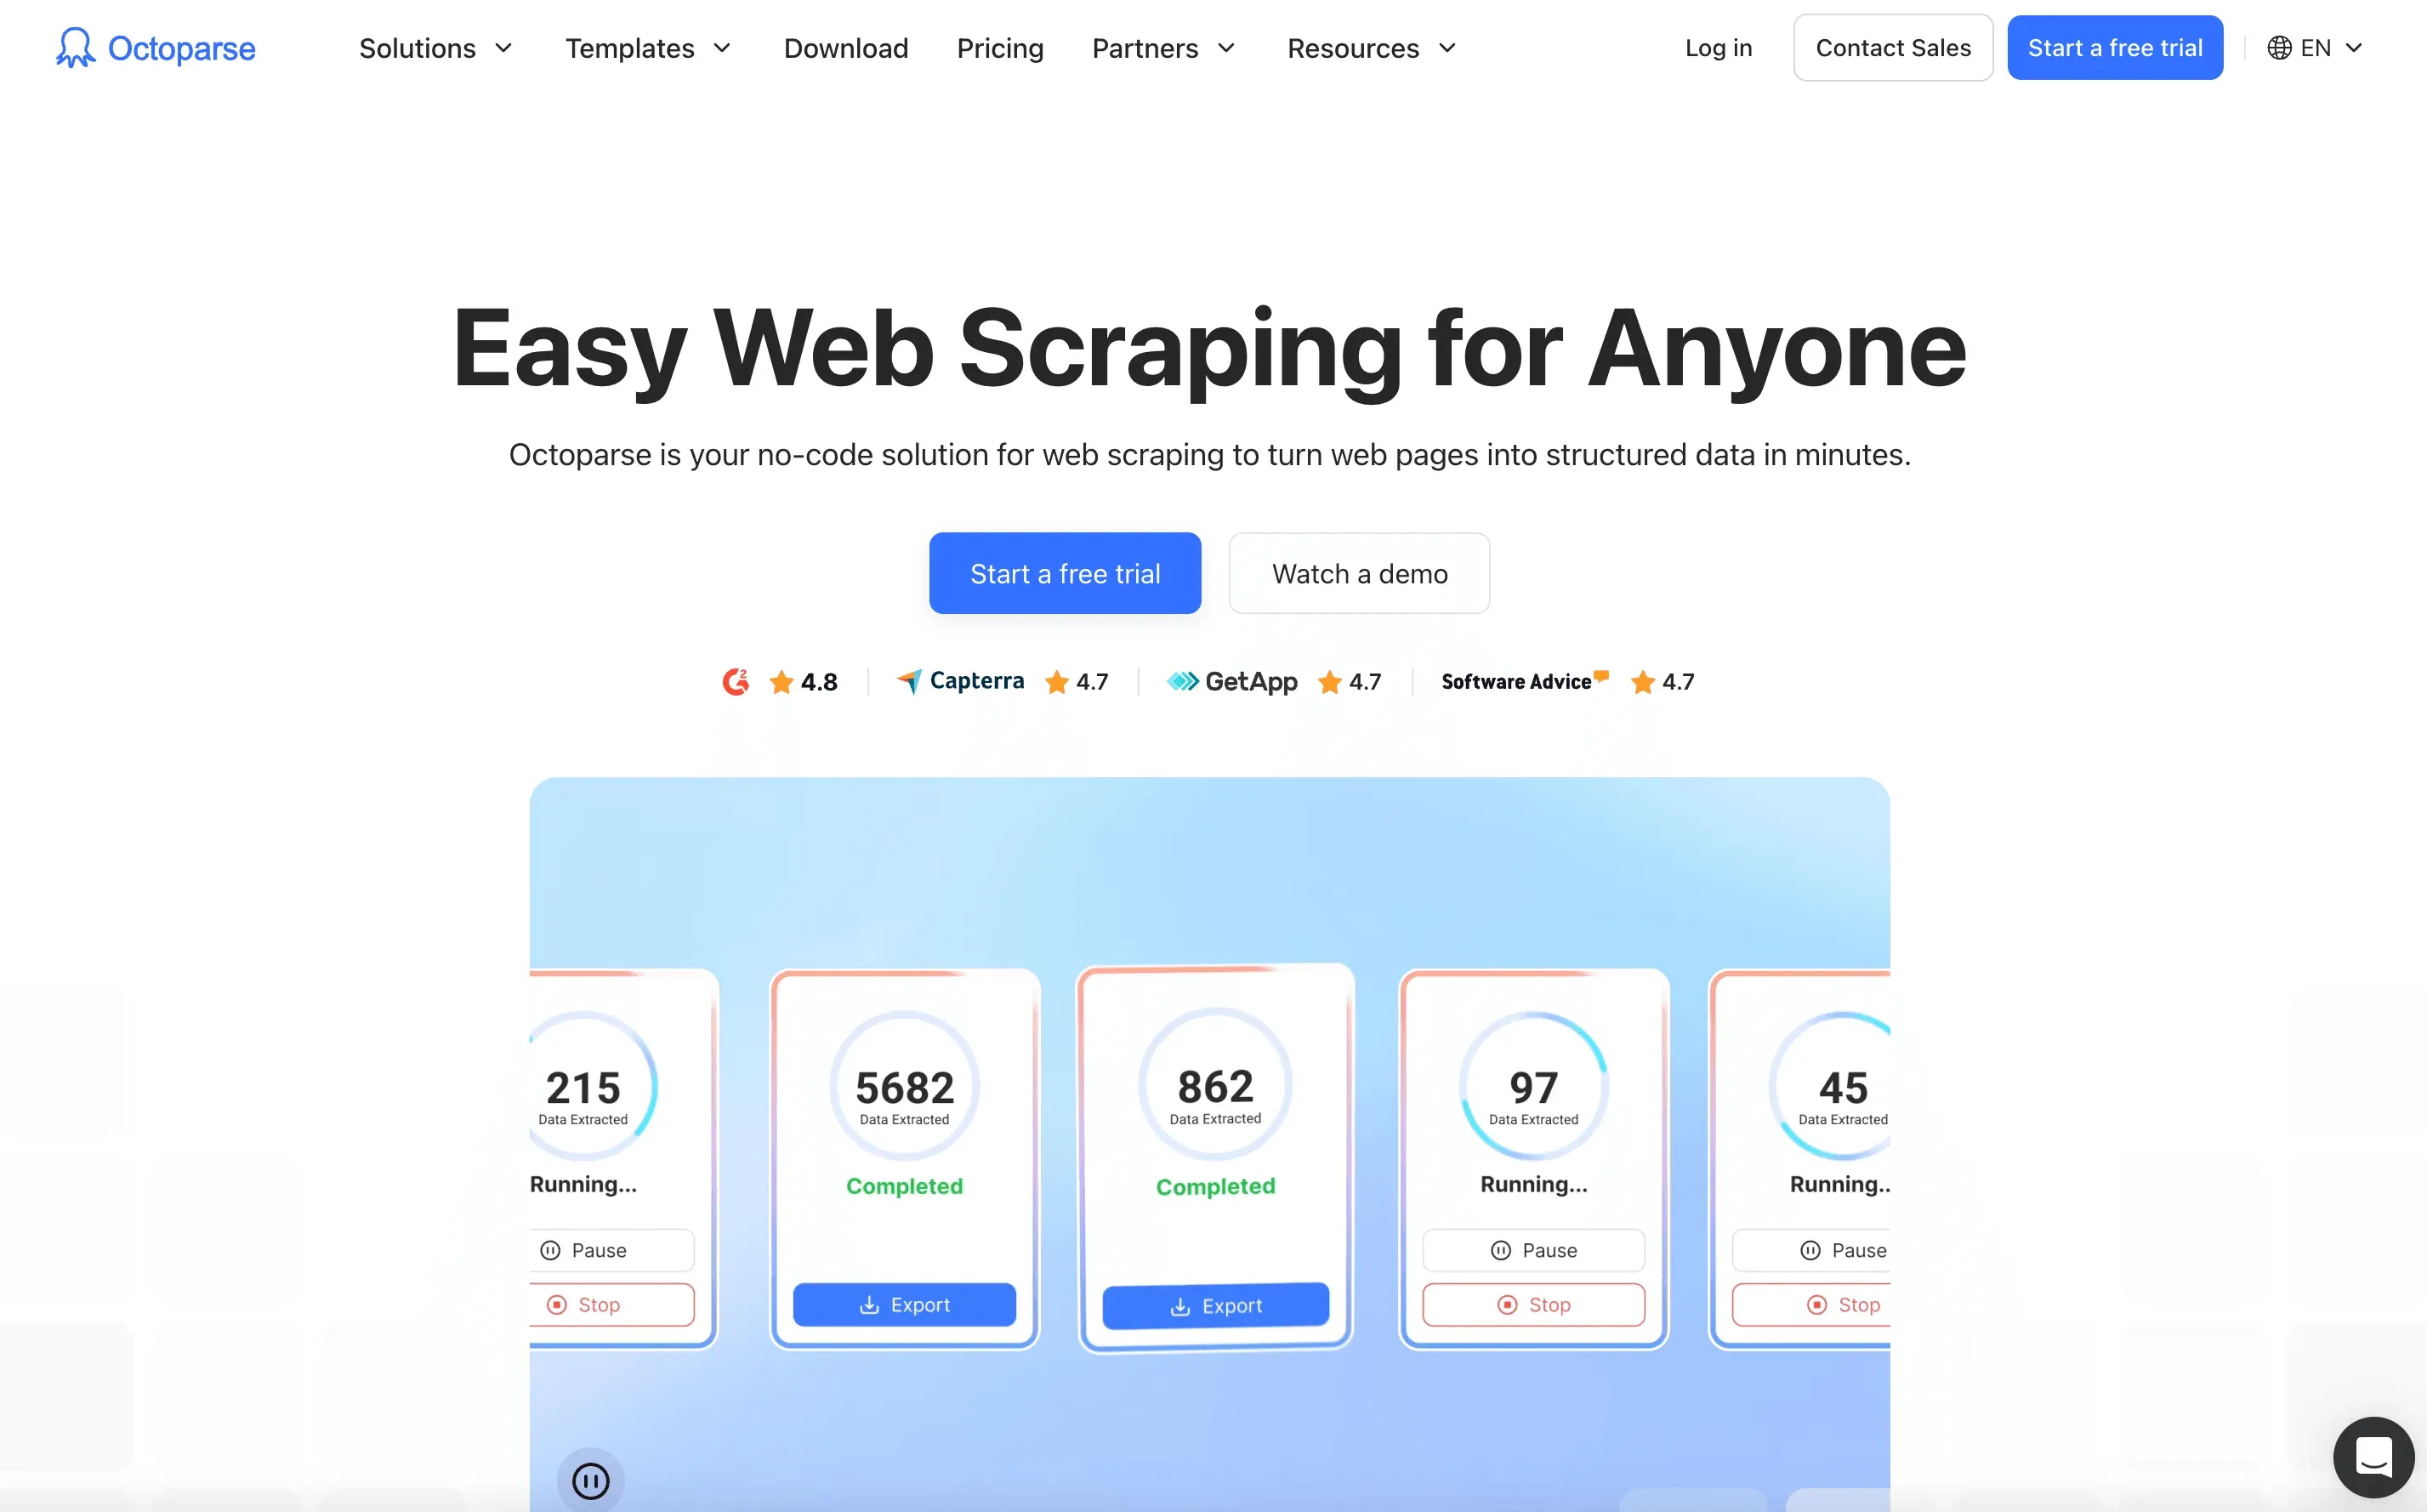 Octoparse 是一個免程式、拖拉式的網頁爬蟲平台,主打大規模自動化。對於想建立複雜任務、又不想寫腳本的團隊來說非常實用。
適合對象: 行銷、研究與營運團隊。
主要功能:
- 拖拉式工作流程: 可視化建立爬蟲,支援動態內容與無限滾動。
- 雲端抓取與排程: 可在雲端執行任務,並安排週期性工作。
- IP 輪替與防封鎖: 內建針對高難度網站的抓取功能。
- 可匯出到 Excel、Sheets、資料庫: 很容易整合到你的工作流程中。
- 免費方案: 每月最多 10,000 筆紀錄;付費方案每月 83 美元起,或按年計費每月 69 美元。
Octoparse 特別受到重視,原因在於它速度快,且能處理大型專案(ScraperAPI)。
5. DataMiner
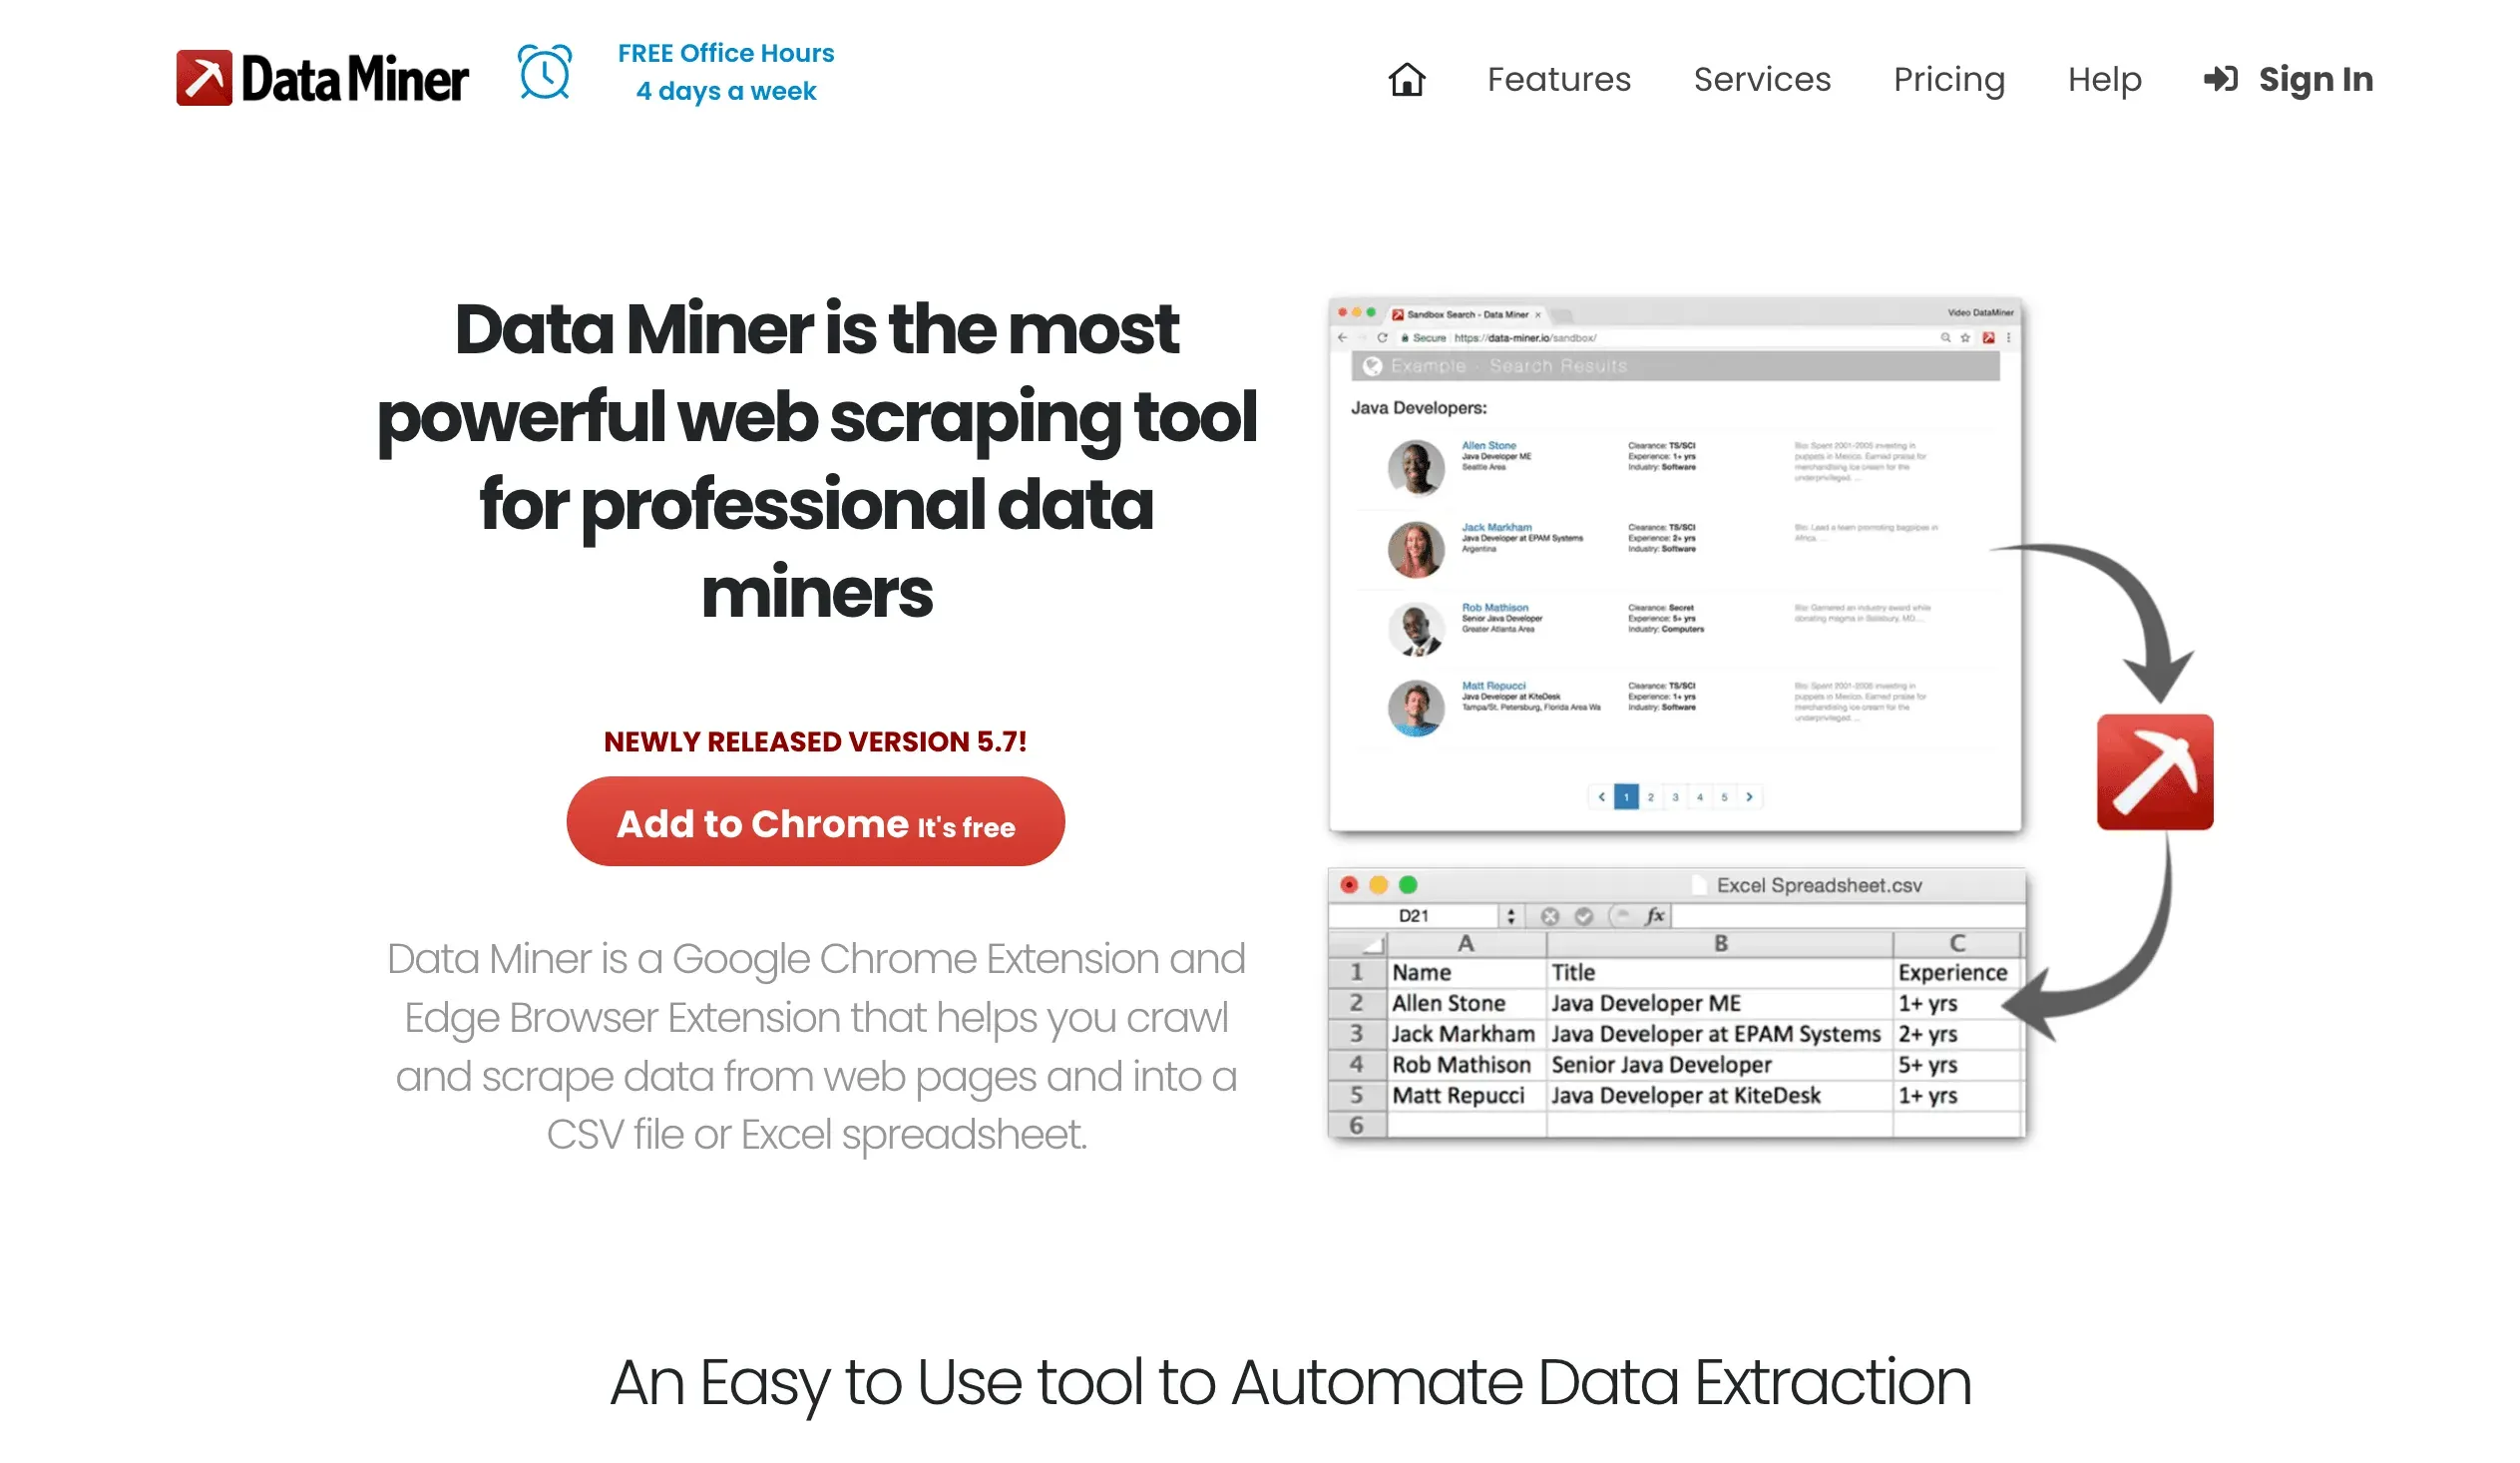 DataMiner 是一款 Chrome 擴充功能,直接把網頁爬蟲帶進瀏覽器裡。它非常適合快速、以模板為主的表格、清單與簡單網站抓取。
適合對象: 日常使用者、銷售營運,以及所有長時間使用 Chrome 的人。
主要功能:
- 模板市集: 內建超過 60,000 種熱門網站的現成配方。
- 點選式擷取: 透過視覺方式選取資料,不需要寫程式。
- 可匯出到 Excel / Google Sheets: 一鍵輸出。
- 免費方案: 每月 500 頁;付費方案每月 19 美元起。
DataMiner 很適合處理快速任務,也深受非技術使用者喜愛(DataMiner)。
6. Import.io
 Import.io 是一個企業級平台,專注把網頁內容轉換成可分析、可運用於商業智慧的結構化資料。
適合對象: 需要大量資料與整合能力的大型企業。
主要功能:
- 代管服務模式: Import.io 團隊可替你建立並維護爬蟲。
- 視覺化介面: 不寫程式也能建立擷取流程。
- API 存取: 可直接將抓取到的資料整合進應用程式與儀表板。
- 合規與安全: 具備企業級控管、PII 遮蔽等功能。
價格: 採客製報價,通常從每月約 199 美元起(PromptCloud)。
7. Apify
 Apify 是一個對開發者很友善的自動化平台,擁有大量預建的「Actors」(抓取機器人)市集,也能自己建立客製化工作流程。
適合對象: 開發者、代理商,以及需要高度彈性的團隊。
主要功能:
- Actor 市集: 內建熱門網站的現成爬蟲,也能自己打造。
- 雲端基礎架構: 可大規模執行抓取、設定排程,並透過 API 整合。
- GitHub 整合: 可用於自動化工作流程與 CI/CD。
- 按量付費: 提供免費額度,之後依使用量計費;付費方案每月 29 美元起。
Apify 很適合簡單與複雜專案並行使用(Black Bear Media)。
8. Diffbot
 Diffbot 結合 AI 與知識圖譜,將非結構化網頁內容轉成可供機器讀取的結構化資料。你可以把它想成網頁爬蟲界的「大腦」。
適合對象: 企業、研究人員,以及需要大規模自動化擷取的人。
主要功能:
- AI 驅動擷取: 可自動辨識文章、產品、組織等內容。
- 知識圖譜: 可透過 API 存取全球最大的網路資料圖譜。
- 資料增強: 取得相關實體、新聞與上下文資訊。
- API 優先: 可整合 BI 工具與資料管線。
價格: 每月 299 美元起(Diffbot Pricing)。
9. WebHarvy
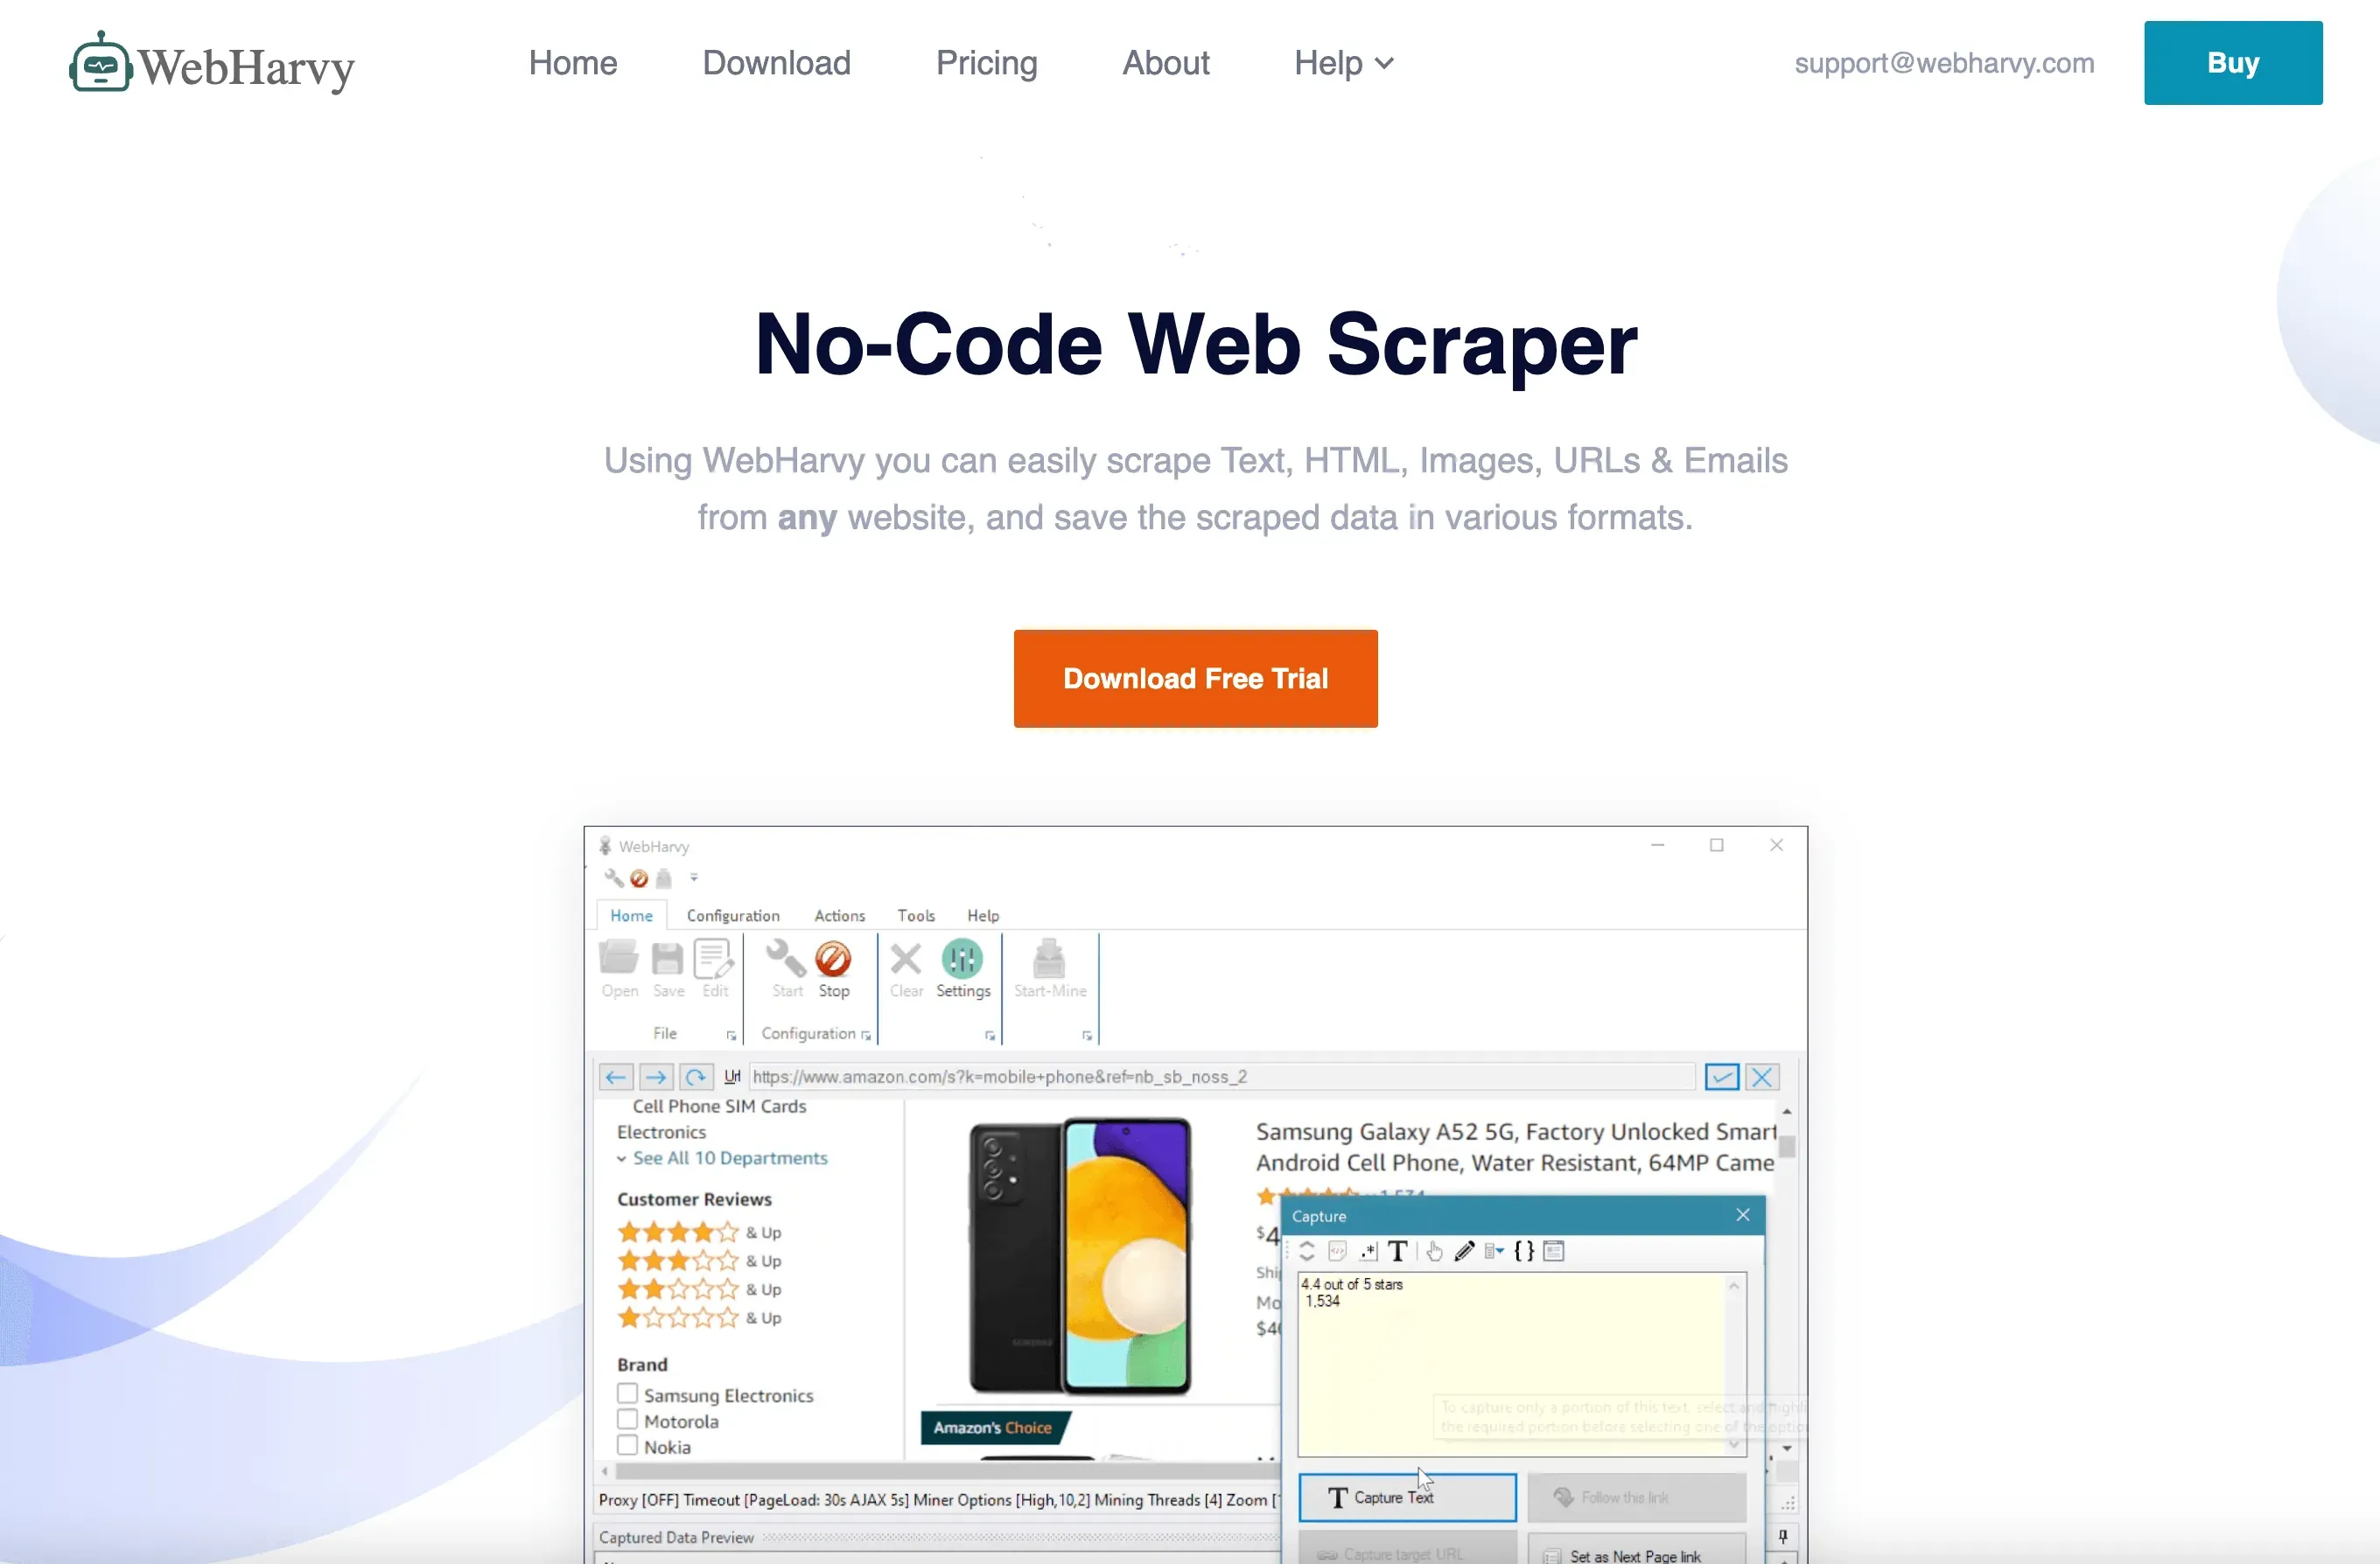 WebHarvy 是一款 Windows 桌面爬蟲,採用視覺化、點選式介面。適合不想寫程式、又偏好桌面應用程式的使用者。
適合對象: Windows 使用者、研究人員與中小企業。
主要功能:
- 視覺化選取: 直接點資料定義欄位,不需要寫程式。
- 支援圖片與多頁導覽: 可抓文字、圖片,也能自動翻頁。
- 可匯出到 Excel、XML、資料庫: 輸出形式彈性高。
- 一次性授權: 付一次就能永久使用(WebHarvy)。
WebHarvy 特別常用於電商與分類網站抓取(Thunderbit Blog)。
10. Mozenda
 Mozenda 是一個雲端平台,專為企業級資料擷取與自動化而打造。
適合對象: 大型組織、對合規要求高的產業。
主要功能:
- 雲端自動化: 可集中排程、監控並管理爬取任務。
- 資料轉換: 可清理、增強並以多種格式匯出資料。
- 團隊協作: 支援多使用者與工作流程管理。
- 企業支援: 包含合規性、穩定性與專屬協助(Appvizer)。
價格: 約每月 99 美元起,亦提供企業方案。
11. Sequentum(前身為 Content Grabber)
 Sequentum 是一款進階桌面/網頁爬蟲,適合資料專業人士與代理商。如果你以前認識它的名字是 Content Grabber,那現在已經改名了——Sequentum 已重新命名這項產品,而 contentgrabber.com 也已不再可用(Sequentum FAQ)。
適合對象: 資料專業人士、代理商,以及需要深度自動化的人。
主要功能:
- 進階腳本能力: 可自動化複雜的擷取邏輯。
- 報表與監控: 可追蹤任務、接收提醒並管理大型專案。
- 整合能力: 可匯出到資料庫、API 或雲端儲存。
- 沒有免費方案: 僅提供付費授權(DataOX)。
Sequentum 是為高流量、可高度客製化的擷取需求而設計。
12. Helium Scraper
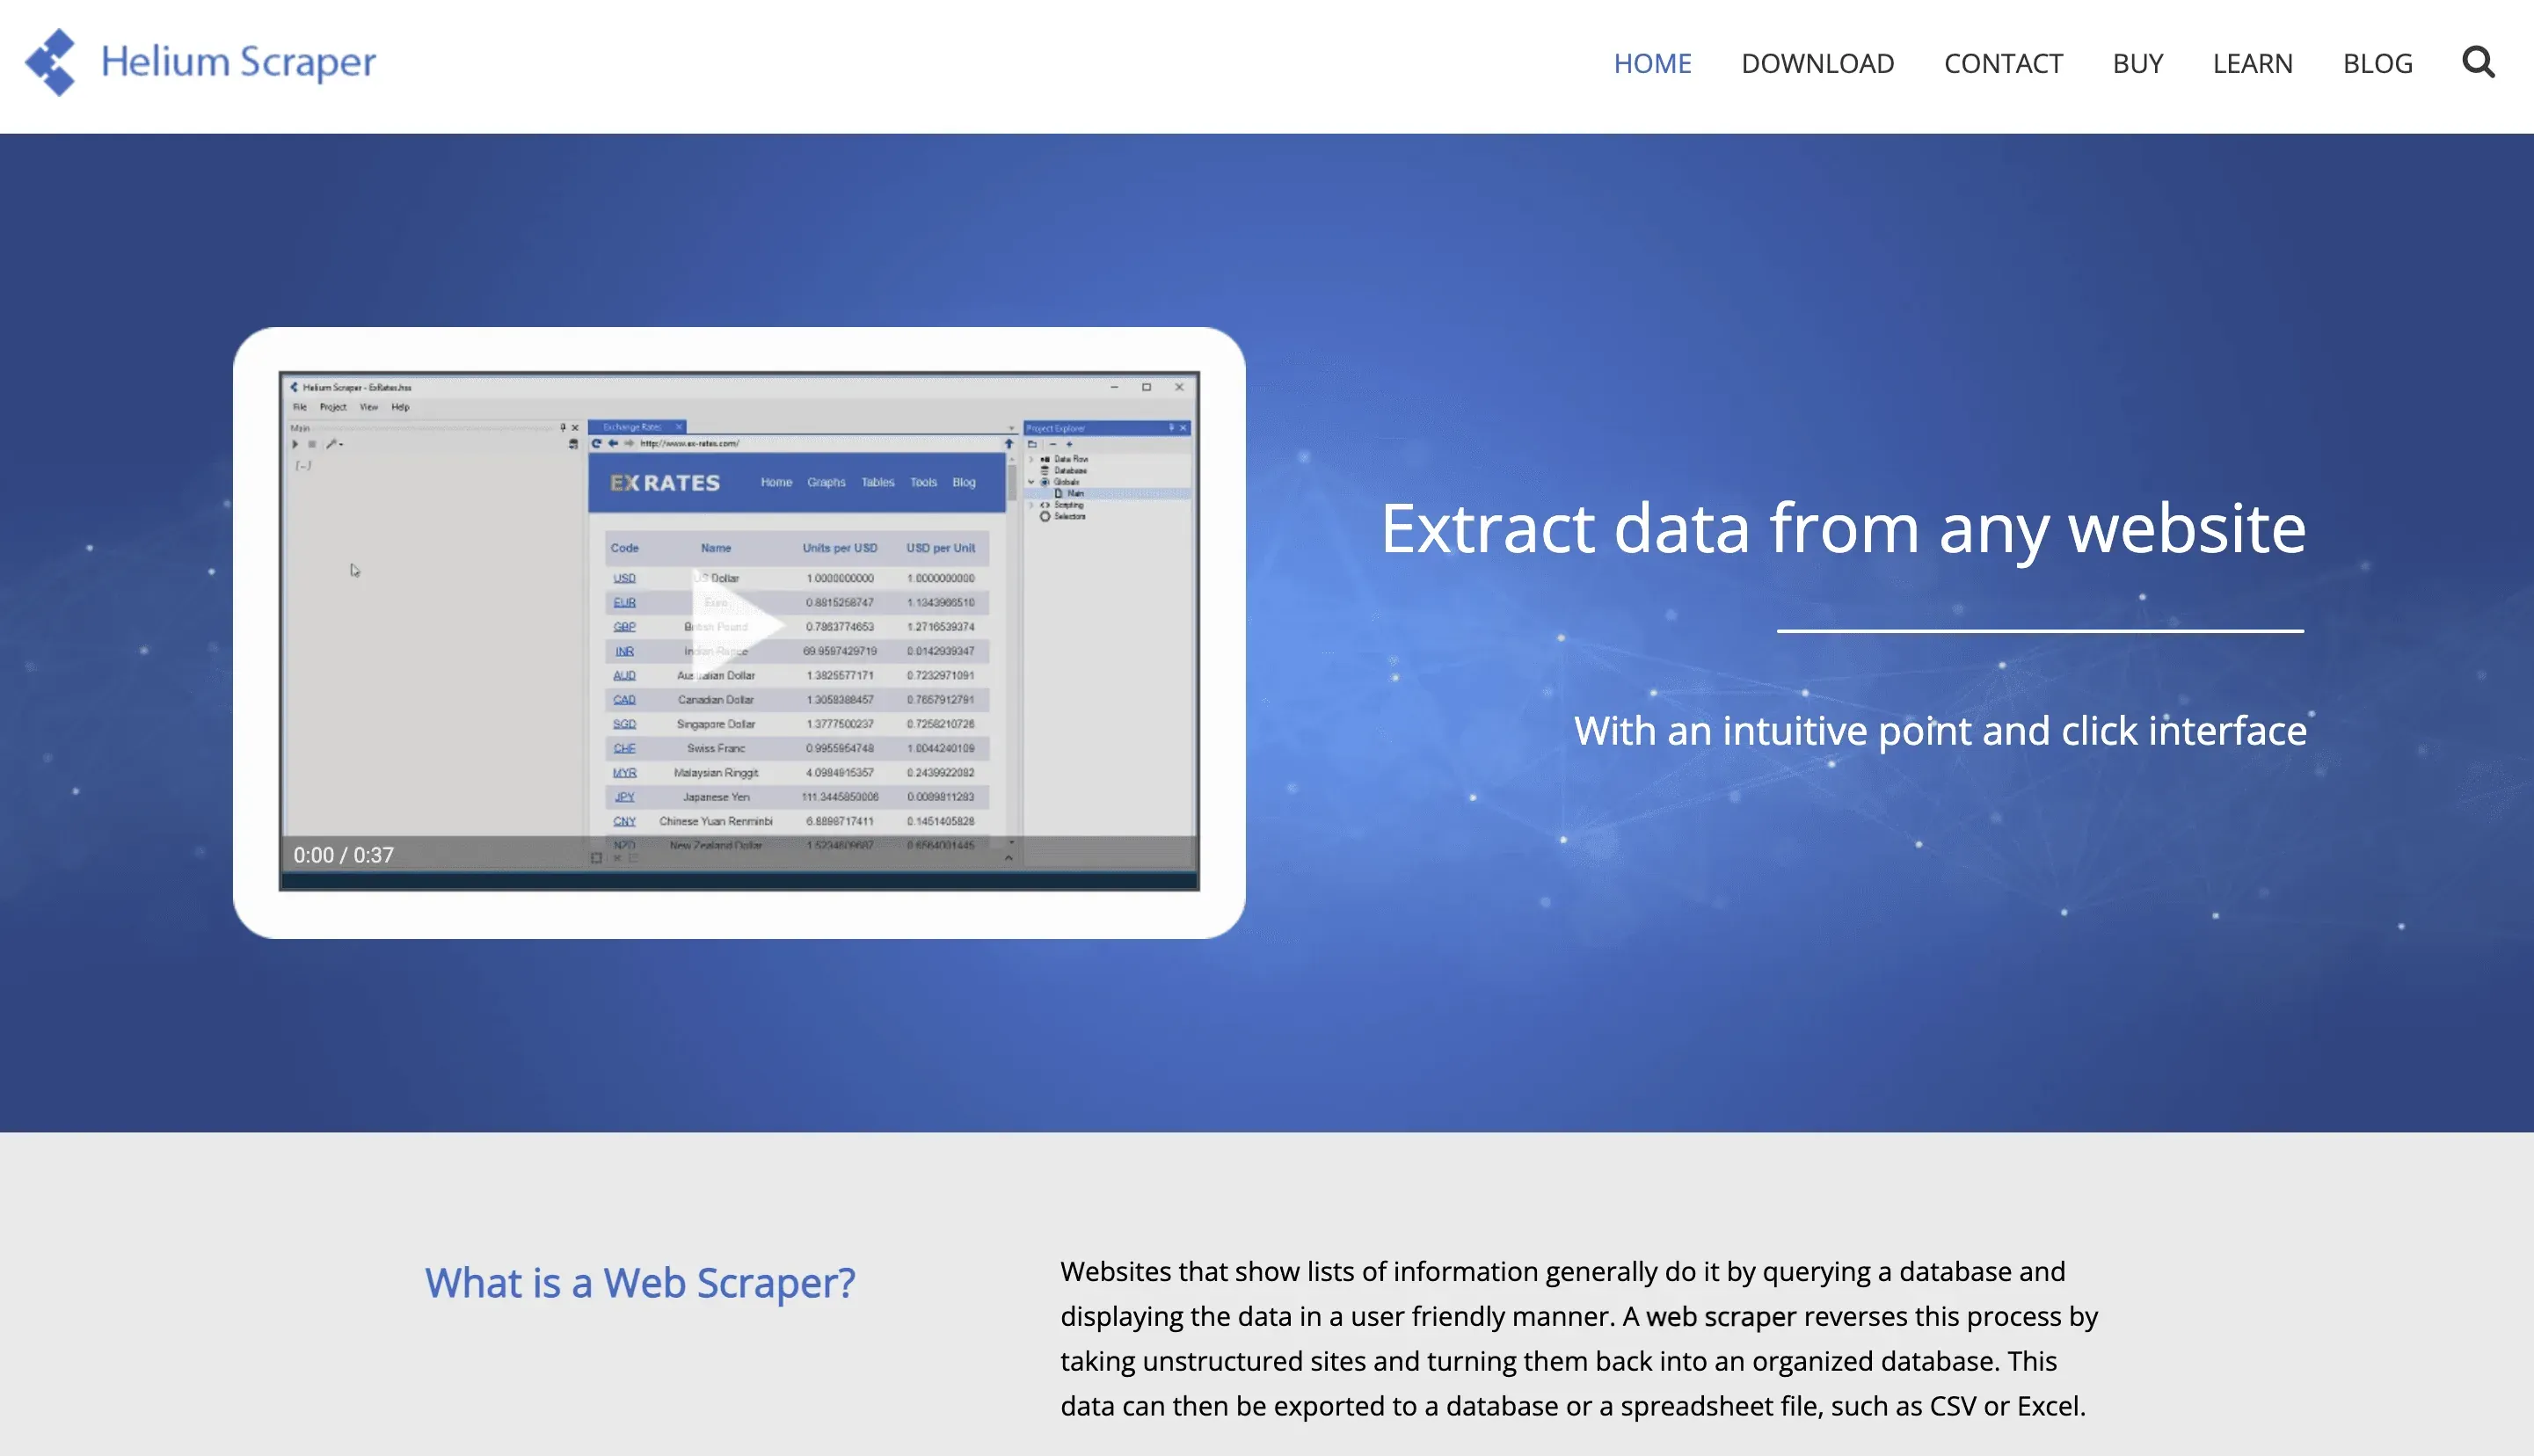 Helium Scraper 是一款桌面工具,內建視覺化流程建構器,非常適合從複雜、動態網站擷取資料。
適合對象: 進階使用者、分析師,以及想要彈性但不想寫程式的人。
主要功能:
- 視覺化工作流程: 透過拖放介面建立擷取邏輯。
- 支援動態內容: 可處理大量 JavaScript 的網站。
- 資料轉換: 在匯出前先清理並整理資料。
- 匯出選項: 支援 Excel、CSV、資料庫等多種格式。
- 一次性費用: 永久授權從 99 美元(Basic,1 位使用者)到 699 美元(Enterprise,10 位使用者)不等,沒有訂閱制(Helium Scraper)。
Helium Scraper 特別適合非標準網站與客製化工作流程。
比較頂尖網頁爬蟲公司:功能快速對照
下面這份快速比較表,可以幫你更快找到最適合的工具:
| 公司 | 最適合對象 | 易用性 | 自動化與 AI | 擴展性 | 匯出選項 | 免費方案 / 價格 |
|---|---|---|---|---|---|---|
| Thunderbit | 非技術使用者、中小企業 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel、Sheets、Notion | 免費(6 頁),每月 15 美元起 |
| Scrapy | 開發者 | ⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Python、CSV、資料庫 | 免費、開源 |
| ParseHub | 中小企業、研究人員 | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | CSV、Excel、JSON | 免費(5 個專案),$189 起 |
| Octoparse | 營運、行銷 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel、資料庫、API | 免費(1 萬筆資料),$69 起 |
| DataMiner | Chrome 使用者 | ⭐⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel、Sheets | 免費(500 頁),$19 起 |
| Import.io | 企業 | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API、資料庫、雲端 | 客製報價,$199/月起 |
| Apify | 開發者、代理商 | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API、資料庫、Sheets | 免費額度,$29/月起 |
| Diffbot | 研究、分析 | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API、知識圖譜 | $299/月起 |
| WebHarvy | Windows 使用者 | ⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel、XML、資料庫 | 一次性付款,$129 起 |
| Mozenda | 企業 | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Excel、API、雲端 | $99/月起,企業方案另計 |
| Sequentum | 資料專業人士、代理商 | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | 資料庫、API、雲端 | 僅付費授權 |
| Helium Scraper | 進階使用者、分析師 | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | Excel、CSV、資料庫 | 一次性付款,$99 起 |
快速推薦:
- 非技術使用者: Thunderbit、DataMiner、ParseHub、WebHarvy
- 開發者: Scrapy、Apify、Sequentum
- 企業: Import.io、Diffbot、Mozenda
- 重視視覺化與彈性流程: Thunderbit、Octoparse、Helium Scraper
結論:為你的業務挑選合適的網頁爬蟲合作夥伴
探索更多網頁爬蟲指南 Get Started Free
到了 2026 年,網頁爬蟲早就不只是技術人的玩具,而是任何需要資料來更快做出聰明決策的企業核心能力。選對網頁爬蟲公司,不只能幫你省下大量時間、提升投資報酬率,也能挖出競爭對手可能錯過的關鍵洞察。
我的建議是:
- 先看團隊適配度: 非技術使用者會喜歡 Thunderbit 或 DataMiner;開發者可以看看 Scrapy 或 Apify;企業則可評估 Import.io 或 Diffbot。
- 思考規模與整合: 你是否需要抓取成千上萬個頁面?你希望資料進到 Sheets、Notion,還是 CRM?
- 先從免費試用開始: 大多數工具都有免費方案,先拿真實專案測試再決定。
- 別怕混搭工具: 有時候最好的流程,反而是結合兩三個工具一起用。
如果你已經準備好體驗網頁爬蟲到底可以多簡單,不妨試試 Thunderbit。你的試算表,以及你的時間與心力,會感謝你。
想看更多深入分析、技巧與教學,歡迎前往 Thunderbit Blog。
常見問題
1. 什麼是網頁爬蟲?為什麼它在 2026 年對企業這麼重要?
網頁爬蟲是自動從網站擷取資料的過程。它對企業很重要,因為能以更快速度、大規模收集資料,用於潛在客戶開發、價格監控、市場研究等工作,進而節省時間並提升決策品質。
2. 哪一家網頁爬蟲公司最適合非技術使用者?
Thunderbit 和 DataMiner 是非程式使用者的首選,因為它們結合了 AI 與視覺化介面。兩者都能讓你在幾次點擊內完成資料擷取,不需要寫程式。
3. 我在選擇網頁爬蟲公司時應該注意哪些功能?
建議關注易用性、自動化能力(分頁、子頁面、排程)、擴展性、匯出選項(Excel、Sheets、API)以及客服支援。最重要的是,選一款符合你的技術程度與業務需求的工具。
4. 有免費的網頁爬蟲解決方案嗎?
有!Thunderbit、DataMiner、ParseHub 和 Octoparse 都提供免費方案。Scrapy 則是開源工具,開發者可免費使用。免費方案很適合小型專案,或在擴大使用前先做測試。
5. 在抓取資料時,如何確保合規且符合道德?
務必遵守網站的服務條款與隱私政策。只抓取公開可見的資料,避免對網站造成過大負載,也要留意 GDPR 等資料隱私法規。許多頂尖網頁爬蟲公司也提供合規功能與最佳實務指南。
準備好更聰明地開始抓取資料了嗎?免費試用 Thunderbit 或前往 Thunderbit Blog 探索更多指南。
試用 AI 網頁爬蟲 Get Started Free
延伸閱讀



