
De flesta artiklar om "Browse AI-alternativ" ger dig ett kort stycke om varje verktyg och sen är det klart. Jag ville ha något som faktiskt är mer användbart än så.
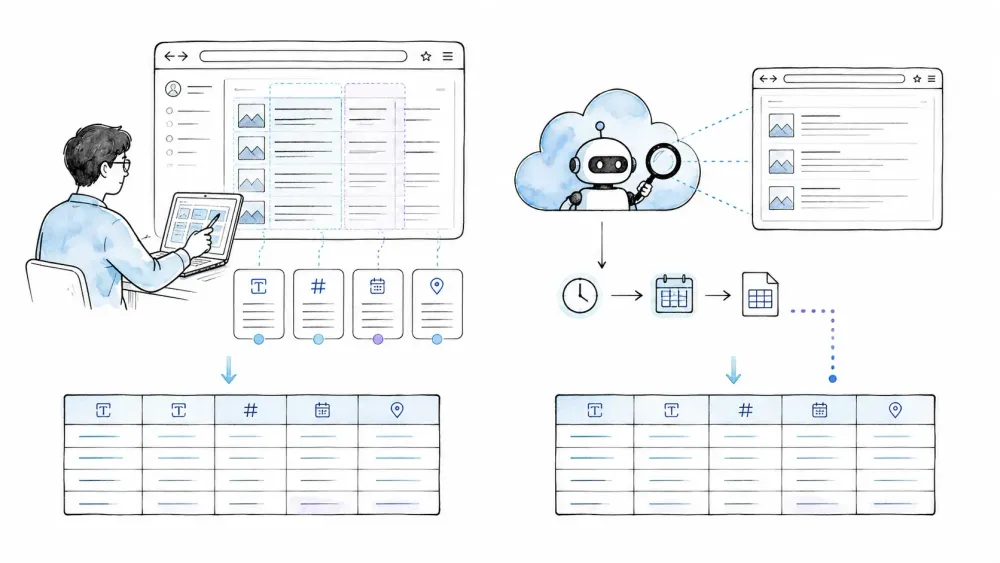
Så jag grävde i både Thunderbit och Browse AI — dokumentationen, arbetsflödena, prismodellerna, utvecklargränssnitten, användarrecensionerna — för att skapa den direkta jämförelse som inte fanns ännu. Båda verktygen lovar AI-drivet webbscraping utan kod, men de skiljer sig åt både i hur de är byggda och i hur de tänker kring användning, och det spelar faktiskt roll i vardagen. Thunderbit är byggt kring sidan du tittar på just nu. Browse AI är byggt kring en återanvändbar molnrobot som du konfigurerar en gång och sedan kör om och om igen. Den skillnaden påverkar allt: hur snabbt du får ditt första resultat, hur du hanterar inloggningar, hur du skalar upp och vad du betalar. Nedan går jag igenom varje aspekt — med en snabböversikt högst upp och en tydlig "välj detta om…"-rekommendation i slutet.
Thunderbit vs Browse AI i korthet: snabb jämförelsetabell
Innan vi går in i detaljerna, här är snabbversionen. Om du har bråttom är det här avsnittet för dig.
| Aspekt | Thunderbit | Browse AI |
|---|---|---|
| Produkttyp | AI-webbscraper & automationsplattform | AI-plattform för molnbaserad extrahering & övervakning |
| Huvudgränssnitt | Chrome/Edge-tillägg (live-sida) | Webbaserad Robot Studio (molnrobotar) |
| AI-metod för extraktion | One Click Extract → agentisk analys → Run Now eller automatisk start | AI-rekommenderade datamängder + visade åtgärder → körning i molnet |
| Hur lätt det är att göra första scrapen | Öppna sidan → agenten analyserar sidan → scrapar på några minuter | Bygg robot i Robot Studio → godkänn → kör i molnet |
| Inloggade sidor | Browser Mode använder din nuvarande inloggningssession | Krypterade uppgifter / sessionscookies; moln-, IP- och 2FA-begränsningar |
| Schemaläggning | Gratis: 1 per dag; Starter: varje timme; Pro: minst var 5:e minut | Gratis: varje timme; Personal/Pro: minst var 5:e minut |
| Övervakning / ändringsdetektering | Schemalagd extraktion; kontrollera djupet i den dedikerade övervakningen | Förstklassiga monitorer, ändringshistorik, aviseringar, webhooks |
| Hantering av bot-skydd | Hanterad rendering & anti-bot på stödjda sidor; inte universellt | Hanterade proxies, IP-rotation, pacing, visst CAPTCHA-stöd; inte universellt |
| Exportmål | Google Sheets, Airtable, Notion, Excel, CSV, JSON | Google Sheets, Airtable, CSV, JSON, S3, webhooks |
| Integrationer | API, MCP, CLI; downstream-integrationer möjliga | Zapier, Make, Pabbly, n8n, CRM-system, datalager, webhooks |
| API-åtkomst | Öppet API (Distill, Extract, Suggest Fields, batch) | v2 REST API (robotar, tasks, monitors, webhooks, bulk) |
| MCP / CLI | Officiell MCP-server + CLI-paket | Inget officiellt publikt MCP eller CLI hittades (per aug 2026) |
| Förbyggda mallar | Mallar för populära sajter + dedikerade verktyg för kontakt/bilder | 250+ förbyggda robotar |
| Gratisplan | 6 sidor/månad, 30 credits/sida, 1 daglig schemaläggning | 50 credits/månad, 2 webbplatser, 3 användare |
| Startpris för betalplan | $15/månad (Starter, 500 credits) | ~ $19/månad effektivt (Personal årsplan, 12K credits/år) |
Priser, credit-nivåer och plannamn ändras ofta. Kontrollera alltid Thunderbit Pricing innan du köper. Senast verifierat: augusti 2026.
Vad är Browse AI (och vem passar det för)?
Browse AI är en molnbaserad, kodfri plattform för webbaserad extraktion och övervakning. Grundidén är enkel: du skapar en återanvändbar "robot" som vet hur den ska gå till en sida, hitta informationen du vill ha och hämta tillbaka den — sedan kan du köra roboten vid behov, enligt schema eller via ett API.
Det rekommenderade arbetssättet 2026 är den webbaserade Robot Studio (Browse AIs Chrome-tillägg är utfasat). Du öppnar Robot Studio, går till målsidan, visar vilka handlingar och vilken data du vill fånga, och AI:n föreslår en märkt datamängd. Du justerar vid behov, godkänner roboten och den körs i Browse AIs moln.
Browse AIs främsta styrkor:
- Schemalagd övervakning och ändringsdetektering. Det här är sannolikt Browse AIs bästa funktion. Du ställer in ett intervall (ner till fem minuter på betalplaner), och Browse AI spårar förändringar, sparar historik, skickar aviseringar och triggar webhooks eller arbetsflöden längre ned i kedjan.
- 250+ förbyggda robotmallar för populära sajter (Amazon, LinkedIn, Indeed, Zillow och många fler). Om din målsajt redan har en mall går uppstarten snabbt.
- Formula AI (lanserad 2026) låter dig skriva transformationer med naturligt språk som skapar beräknade kolumner i Browse AIs Tables-lager — tänk "extrahera varumärket ur den här produkttiteln" eller "kategorisera den här annonsen efter prisklass."
- Brett integrations-ekosystem. Direkt synk till Google Sheets, Airtable, S3 samt Zapier, Make, Pabbly, n8n, CRM-system och datalager.
Browse AIs primära målgrupp: operations-, e-handels- och researchteam som behöver återkommande, schemalagda datahämtningar — konkurrentpriser, bevakning av jobbsajter, sammanslagning av listningar — utan att skriva kod. Om ditt flöde är "ställ in det och låt det rulla" är Browse AI byggt för just det.
På G2 har Browse AI ett betyg på 4,8/5 baserat på ungefär 60 recensioner, där användare lyfter fram den visuella no-code-uppsättningen och övervakningsfunktionerna. På Capterra ligger det på 4,6/5 baserat på 63 recensioner med 4,7 i användarvänlighet. Vissa recensenter påpekar CAPTCHA-/sajtrestriktioner, ofullständiga körningar på långa listor och svårigheter att förutse kreditförbrukning.
Vad är Thunderbit (och vem passar det för)?

Thunderbit är en agentisk web scraper och automationsplattform med ett Chrome/Edge-browsertillägg som primärt no-code-gränssnitt, plus en Web App, Open API, MCP Server och CLI för utvecklarflöden.
Thunderbit är en agentisk web scraper: på en kompatibel, auktoriserad sida klickar du på One Click Extract, och agenten upptäcker, läser och analyserar sidan för att avgöra vad som ska hämtas. Run Now startar direkt, men om du inte gör något startar uppgiften automatiskt — så standardupplevelsen kräver bara ett avsiktligt klick, utan kod, selektorer eller schemauppsättning.
Tanken är: du är på en webbsida, du klickar på en knapp, och agenten avgör vilken strukturerad data den tror att du vill ha. Agenten förbereder och startar extraktionen automatiskt; valfria fältinstruktioner kan fortfarande förfina transformationer som översättning, kategorisering eller rensning av URL:er. Datat hamnar i en tabell som du kan exportera till Google Sheets, Airtable, Notion, Excel, CSV eller JSON.
Thunderbits främsta styrkor:
- Browser-tillägg först. Du arbetar på sidan du redan tittar på, i din autentiserade webbläsarsession. Ingen robotkonfiguration, ingen molnuppsättning — öppna bara sidan och kör.
- One Click Extract med instruktioner på fältnivå. Agenten bestämmer semantiska output-kolumner utifrån sidans innehåll, och du kan styra varje fält med en prompt för att transformera data under själva extraktionen, inte bara efteråt.
- Dedikerade verktyg för att extrahera e-post, telefonnummer och bilder. Praktiskt för leadgenerering och kontaktberikning.
- Utvecklargränssnitt. Öppet API för backend-pipelines, MCP Server för AI-agentvärdar (Claude, Cursor, Windsurf) och CLI för terminal- och kodagentflöden. Dessa är separata från upplevelsen i browser-tillägget.
- Direkt export till Notion. En tydlig fördel — Browse AI har ingen primär inbyggd Notion-synk.
Thunderbits primära målgrupp: säljare, marknadsförare, frilansare och ops-team som behöver snabb, ad hoc-extraktion och leadgenerering, plus utvecklare och datateam som behöver API- eller agentbaserade pipelines. Om ditt arbetsflöde är "jag tittar på en sida just nu och behöver få in datan i ett kalkylark" är Thunderbit byggt för det.
I Chrome Web Store har Thunderbit 100 000+ användare och uppdaterades senast i augusti 2026. På Capterra har det 4,8/5 i betyg med positiva omdömen om snabb uppsättning och affärsflöden.
Browser-tillägg först vs moln först: därför spelar arkitekturen roll
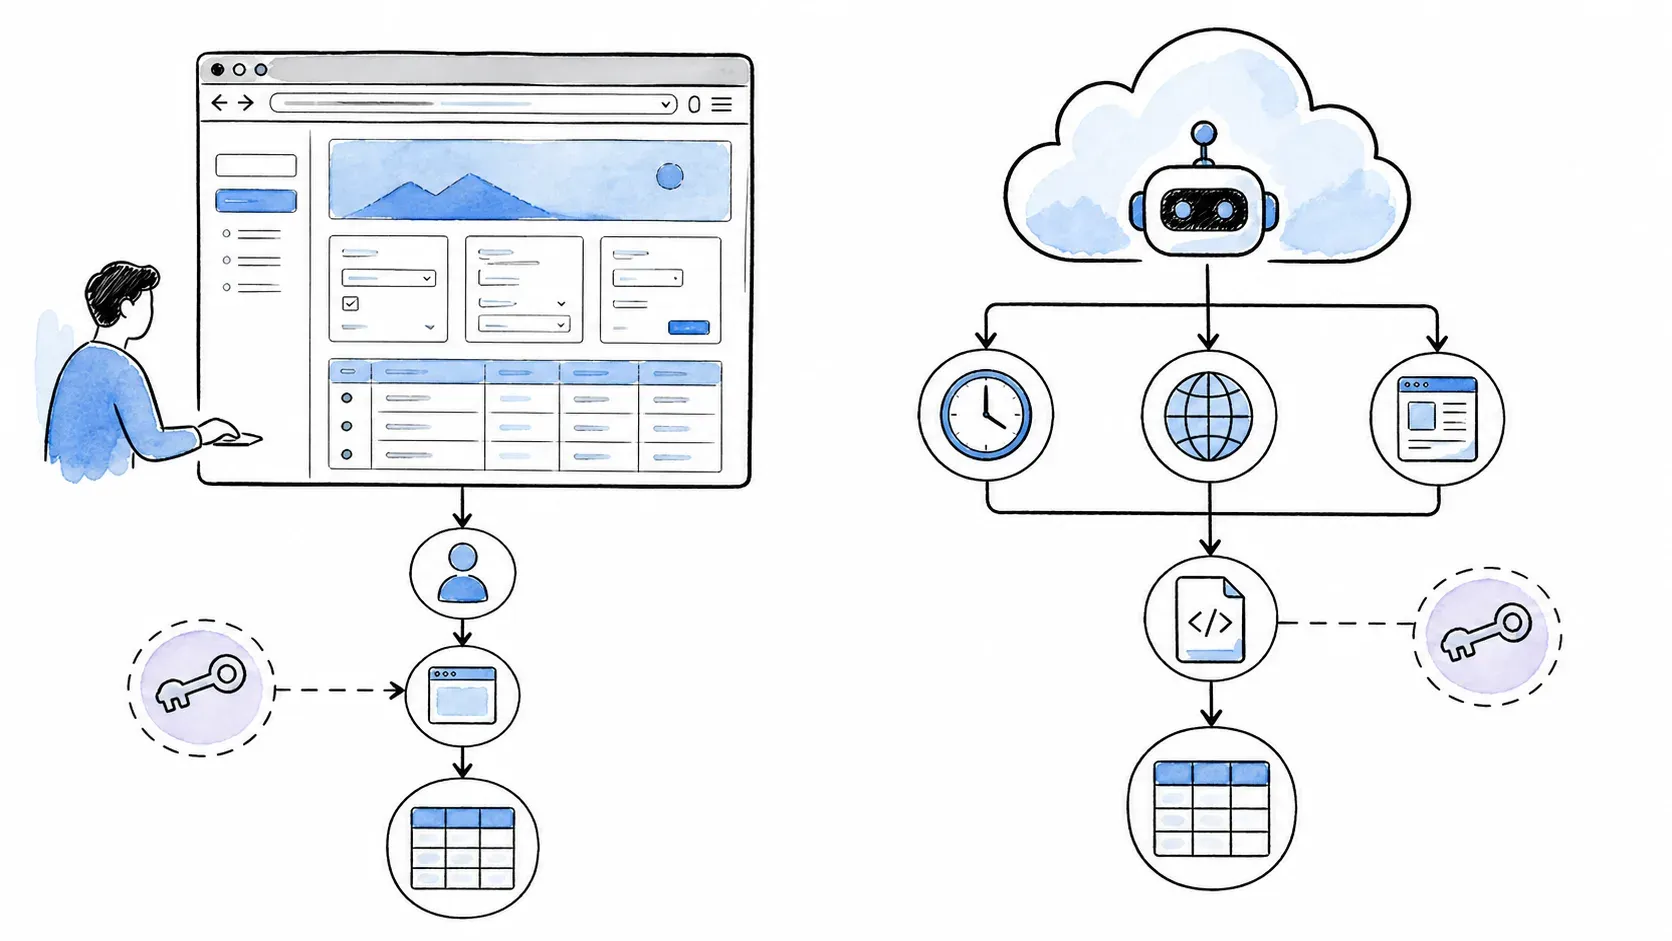
Det här är den grundläggande skillnaden mellan Thunderbit och Browse AI, och den påverkar nästan alla andra jämförelser. Om du förstår detta minskar risken att välja fel verktyg för ditt arbetsflöde.
Thunderbit är tilläggsbaserat först. Du öppnar en sida i Chrome, klickar på tillägget och arbetar med datan på den sidan — i din webbläsare, i din session, med dina cookies och inloggningar redan aktiva. One Click Extract låter agenten upptäcka, läsa och analysera sidan innan extraktionen startar automatiskt; Run Now finns om du vill att det ska ske direkt. Du kan också använda en molnkörningsväg för publikt, storskaligt eller schemalagt arbete, medan standardflödet i browser-tillägget utgår från live-sidan.
Browse AI är molnbaserat först. Du skapar en robot i den webbaserade Robot Studio, visar hur navigeringen och datainsamlingen ska fungera, godkänner roboten och den körs i Browse AIs moln. Det utfasade Chrome-tillägget var tidigare en del av robotträningen, men 2026 är Robot Studio det rekommenderade gränssnittet. Robotar körs på distans, enligt schema, via API eller i arbetsflöden.
Det här är ingen kvalitetsfråga. Det är en arbetsflödesfråga. Och det får reella konsekvenser.
Tid till första scrapen
Med Thunderbit är det dokumenterade flödet: öppna en sida → klicka One Click Extract → agentisk analys → Run Now eller automatisk start. På en kompatibel sida kan du ha strukturerad data i din exportdestination inom några minuter.
Med Browse AI är flödet: öppna Robot Studio → ange måladressen → navigera/demonstrera åtgärder → välj eller justera datan som ska fångas → konfigurera paginering och radgränser → godkänn roboten → kör den i molnet → se resultatet. Uppstarten är mer omfattande, men vinsten är en återanvändbar robot som du kan schemalägga, övervaka och anropa via API.
Vem gynnas av vad: Om du behöver data från en sida du tittar på just nu — en engångskoll av en konkurrent, en snabb leadlista eller en researchuppgift — tar Thunderbits interaktiva flöde dig dit snabbare. Om du behöver extrahera samma data från samma sajtmönster varje dag i sex månader, betalar sig Browse AIs initiala investering i robotbygge över tid.
(Jag ska också nämna: jag körde inte en stoppklocka på båda verktygen för exakt samma uppgift. Stegen bygger på dokumenterade arbetsflöden, inte ett kontrollerat benchmark.)
Hantering av inloggningsskyddade och spärrade sidor
Här blir arkitekturskillnaden praktisk.
Thunderbits Browser Mode körs i din befintliga webbläsarsession. Om du redan är inloggad på en sajt — ditt CRM, en betald databas, en medlemskatalog — kan tillägget extrahera från sidan utan extra konfiguration av inloggningsuppgifter. Du är redan autentiserad.
Browse AI stöder inloggade sidor via krypterade sparade uppgifter och sessionscookies. Lösenord beskrivs som AES-256-krypterade, och API:t kan uppdatera robotcookies. Men eftersom robotar körs i molnet med roterande IP-adresser kan sessioner löpa ut, inloggningsutmaningar dyka upp och MFA/2FA stöds inte. För vissa sajter fungerar det fint. För andra blir det mer friktion.
Inget av verktygen garanterar åtkomst till varje sajt. Men för sidor där du redan är inloggad tar Thunderbits tilläggsbaserade ansats bort ett konfigurationslager som Browse AIs molnrobotar kräver.
Hantering av anti-bot: vad varje verktyg kan och inte kan göra
Båda leverantörerna gör anspråk på anti-bot-hantering, och båda har tydliga begränsningar.
Thunderbit erbjuder hanterad rendering och anti-bot-hantering på stödjda, auktoriserade sidor. Det innebär inte universell framgång, CAPTCHA-bypass eller att blockeringar aldrig sker.
Browse AI dokumenterar automatisk pacing, rate limiting, residential proxies, IP-rotation, återförsök, mänskliga beteenden och viss standardlösning för CAPTCHA (inklusive reCAPTCHA/hCaptcha). De dokumenterar också begränsningar: egna CAPTCHA-lösningar, mycket stark bot-skydd, högsäkerhetsinloggningar, virtuella listor och sajtändringar kan misslyckas eller kräva ny träning.
Anti-bot-hantering är ett pågående kapprustningsspel för alla scrapingverktyg. Om din målsajt har aggressivt bot-skydd bör du testa båda verktygen på just den sajten innan du bestämmer dig. Användarrecensioner för båda produkterna nämner ibland blockeringar och CAPTCHA-problem — det är verkligheten för webbscraping 2026, inte en unik brist hos något av verktygen.
AI-extraktion jämfört: hur Thunderbit och Browse AI hittar din data
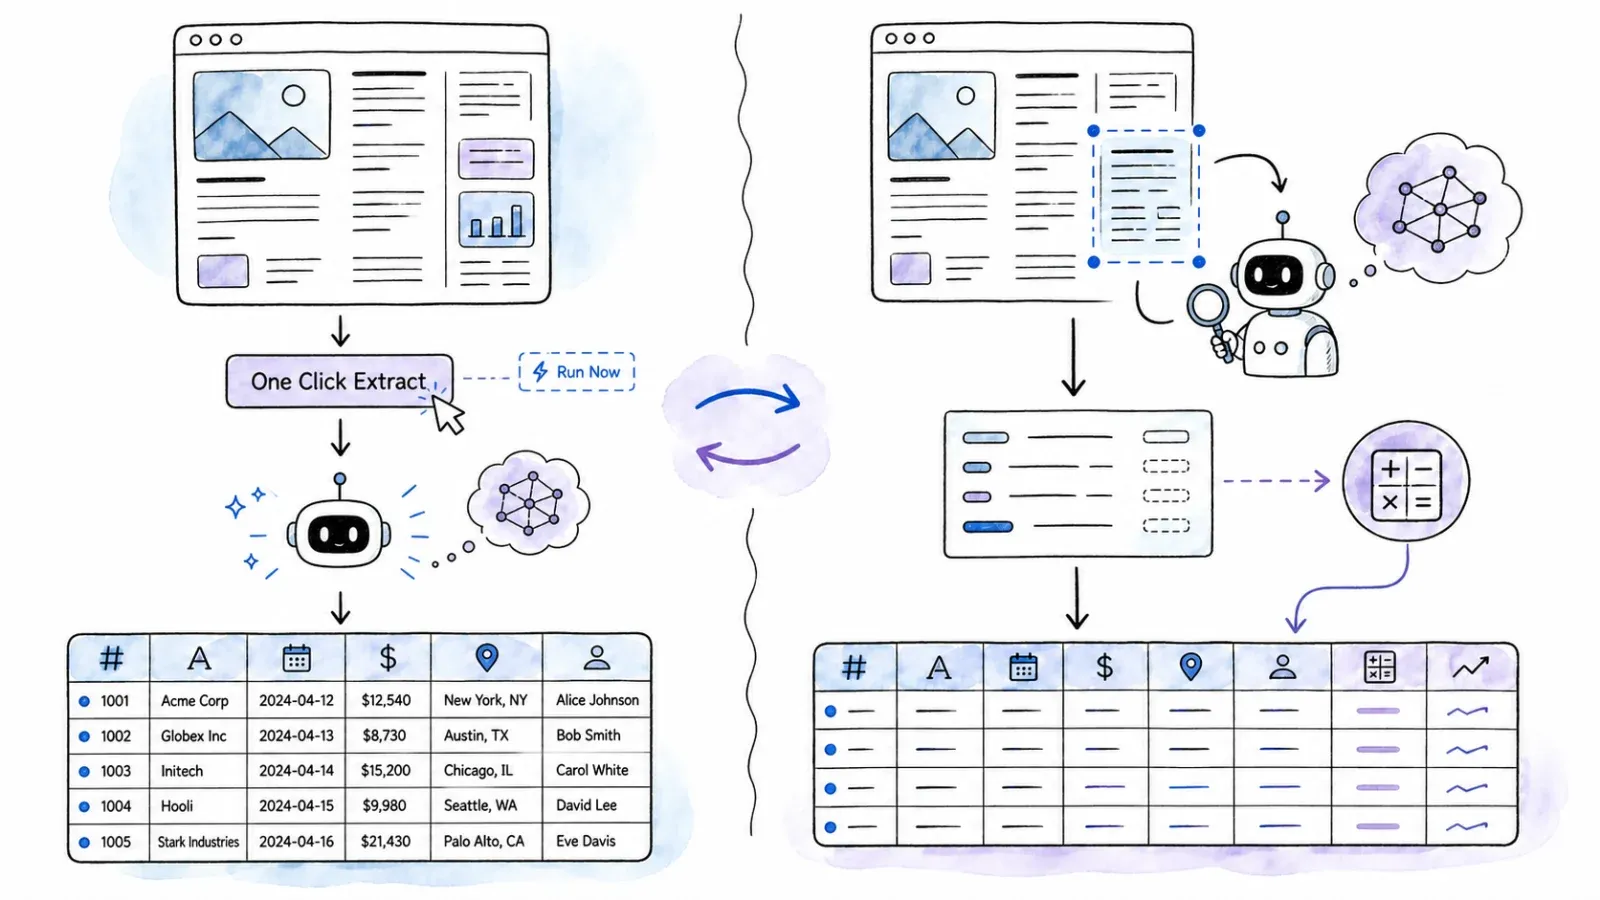
Båda verktygen använder AI för att hjälpa dig extrahera strukturerad data. Men AI:n spelar en olika roll i varje verktyg.
Thunderbit: One Click Extract och instruktioner på fältnivå
Thunderbits AI läser sidan du befinner dig på och föreslår en uppsättning semantiska output-kolumner — produktnamn, pris, betyg, URL, vad den nu identifierar som relevant. Den resulterande tabellen är fortfarande redigerbar, så du kan finjustera fält eller lägga till exempel när ett specialiserat resultat behöver extra vägledning.
Den utmärkande funktionen är Field AI Prompts. Du kan bifoga en instruktion i naturligt språk till vilket fält som helst under extraktionen. "Översätt detta till engelska." "Kategorisera detta som elektronik, kläder eller hem." "Hämta bara domänen från den här URL:en." "Sammanfatta detta i en mening." Dessa transformationer körs som en del av scrapen, inte som ett separat efterbehandlingssteg.
Thunderbit stöder också paginering och berikning av undersidor på kompatibla sidor — så att du kan skrapa en lista och sedan automatiskt besöka varje detaljsida för att hämta fler fält.
Browse AI: Robot Studio AI och Formula AI
Browse AIs Robot Studio innehåller en AI Assistant som kan upptäcka listor på en sida och rekommendera en märkt datamängd. Du kan förfina fälten manuellt genom att visa klick och markeringar. AI:n försöker också anpassa robotar till vanliga layoutändringar, även om större redesigns kan kräva omträning.
För transformation efter extraktion lanserade Browse AI Formula AI 2026. Du skriver en instruktion i vanligt språk — "extrahera varumärket från produkttiteln", "beräkna rabattprocenten" — och Formula AI skapar en beräknad kolumn i Browse AIs Tables-lager.
Den viktiga skillnaden: Thunderbits fältprompter transformerar data under extraktionen. Browse AIs Formula AI transformerar data efter extraktionen, i Tables. För mer öppna LLM-berikningar (sentimentanalys, entitetsextraktion, summering) beskriver Browse AI mönster med Zapier/Make/webhooks/API för att koppla in externa LLM:er.
Vilken metod känns bäst för icke-tekniska användare?
Thunderbit känns som: "Klicka en gång, så avgör agenten vad som ska extraheras från den här sidan." Du arbetar mot det levande innehållet medan agenten analyserar och startar extraktionen, med valfri kontroll på fältnivå för specialiserat resultat.
Browse AI känns som: "Visa verktyget vad du vill ha genom att navigera och markera, och låt sedan molnet sköta resten." Du bygger en återanvändbar automationsresurs som kör självständigt.
Båda är verkligen no-code. Men de passar olika sätt att tänka. Om du tänker i termer av "jag vill ha de här kolumnerna från den här sidan" klickar Thunderbits fält-först-ansats ofta snabbare. Om du tänker i termer av "jag vill ha en robot som gör det här på schema" kan Browse AIs robot-först-ansats kännas mer naturlig.
Samma uppgift, två verktyg: arbetsflöden sida vid sida
Här blir jämförelsen konkret. Jag gick igenom tre representativa scenarier med hjälp av varje verktygs dokumenterade arbetsflöden.
(En ärlig not: jag körde inte en stoppklocka eller mätte fältprecision i ett kontrollerat benchmark. Det här är genomgångar av dokumenterade arbetsflöden, inte labbresultat. Om du behöver mätta resultat bör du testa båda verktygen på just din målsajt.)
Scenario 1: Skrapa en produktsida med listning (e-handel)
Mål: Extrahera produktnamn, priser, betyg och URL:er från en kategorisida på en publik e-handelswebbplats.
Thunderbit-flöde:
- Öppna kategorisidan i Chrome.
- Klicka på Thunderbit-tillägget → One Click Extract.
- Förfina eventuellt de kolumner som skapas (Produktnamn, Pris, Betyg, URL) om du behöver ett mer specialiserat resultat.
- Run Now kan starta direkt; annars startar Thunderbit automatiskt och fyller tabellen.
- Om listningen spänner över flera sidor, använd kompatibel paginering för att fortsätta.
- Exportera till Google Sheets, Excel, Airtable eller Notion.
Browse AI-flöde:
- Öppna Browse AI-dashboarden → Build New Robot → Structured Extraction.
- Ange URL:en till kategorisidan → Robot Studio öppnas.
- Navigera på sidan, markera den återkommande produktlistan.
- Granska den AI-rekommenderade märkta datamängden. Förfina fälten vid behov.
- Konfigurera paginering (nästa/sidkontroll, ladda mer, oändlig scroll eller inget) och radgräns.
- Godkänn roboten → Kör i molnet.
- Se resultaten i Browse AI Tables → Exportera till Google Sheets, Airtable, CSV eller JSON.
Jämförelse:
- Thunderbits flöde har färre steg innan du ser data, eftersom du redan är på sidan och agenten analyserar den automatiskt.
- Browse AIs flöde skapar en återanvändbar robot. Om du behöver skrapa samma kategorisida varje vecka är roboten redo — schemalägg den, övervaka den eller trigga den via API.
- Pagineringen skiljer sig åt: Thunderbit stöder kompatibel paginering direkt i tillägget; Browse AI låter dig konfigurera pagineringstyp och radgränser under robotskapandet.
Scenario 2: Bygga en leadlista från en katalog
Mål: Extrahera företagsnamn, kontakt-e-post/telefon och URL:er från en företagskatalog.
Thunderbit-flöde:
- Öppna katalogsidan i Chrome.
- Klicka One Click Extract; agenten upptäcker, läser och analyserar sidan och bestämmer sedan kolumner som Företag, E-post, Telefon och URL.
- Använd eventuellt Thunderbits dedikerade verktyg för e-post/telefon för kontaktberikning.
- Använd eventuellt Scrape Subpages för att besöka varje företags detaljsida och hämta fler fält.
- Run Now kan starta direkt; annars startar extraktionen automatiskt. Exportera resultatet till Google Sheets, Airtable eller Notion.
Browse AI-flöde:
- Bygg en listrobot för katalogsidan i Robot Studio.
- Markera den återkommande listan och fälten (Företag, synlig E-post, Telefon, URL).
- Bygg eventuellt en andra detaljrobot och koppla ihop dem i ett Workflow för att besöka varje företagssida.
- Godkänn → Kör → Exportera till Google Sheets, Airtable eller via API.
Jämförelse:
- Thunderbits dedikerade verktyg för e-post/telefon är en tydlig fördel i kontaktfokuserade arbetsflöden. Browse AI fångar synliga kontaktfält, men har ingen motsvarande dedikerad kontaktprodukt.
- Thunderbits Scrape Subpages och Browse AIs Workflow (listrobot → detaljrobot) möjliggör båda berikning från detaljsidor, men mekaniken skiljer sig åt.
- För direkt output till Notion har Thunderbit en inbyggd destination; Browse AI skulle kräva mellanlager.
Scenario 3: Övervaka en sida för förändringar över tid
Mål: Följa veckovisa prisändringar på en konkurrents produktsida och få en avisering.
Browse AI-flöde:
- Bygg och godkänn en robot för produktsidan.
- Konfigurera en monitor med önskat intervall (veckovis, dagligen, varje timme — beroende på plan).
- Aktivera ändringsdetektering.
- Browse AI sparar historiska resultat, markerar förändringar och skickar e-postaviseringar eller webhook-/integrationshändelser.
Thunderbit-flöde:
- Ställ in en sparad scraper för produktsidan.
- Konfigurera ett schema (dagligen på Free, varje timme på Starter, minst var 5:e minut på Pro).
- Varje schemalagd körning skapar en ny resultatuppsättning i din exportdestination.
- Jämförelser eller aviseringar nedströms beror på destinationen och vilket ytterligare arbetsflöde du bygger.
Jämförelse:
- Browse AIs övervakning är en förstklassig produktfunktion: inbyggd ändringshistorik, detektering, aviseringar och workflow-triggers. Om återkommande övervakning är ditt huvudcase har Browse AI det mer tydliga och specialbyggda verktygset.
- Thunderbit stöder schemalagd extraktion, men dess dedikerade djup för ändringsövervakning kanske inte når Browse AIs nivå för just det här flödet. Kontrollera aktuella möjligheter för ditt exakta användningsfall.
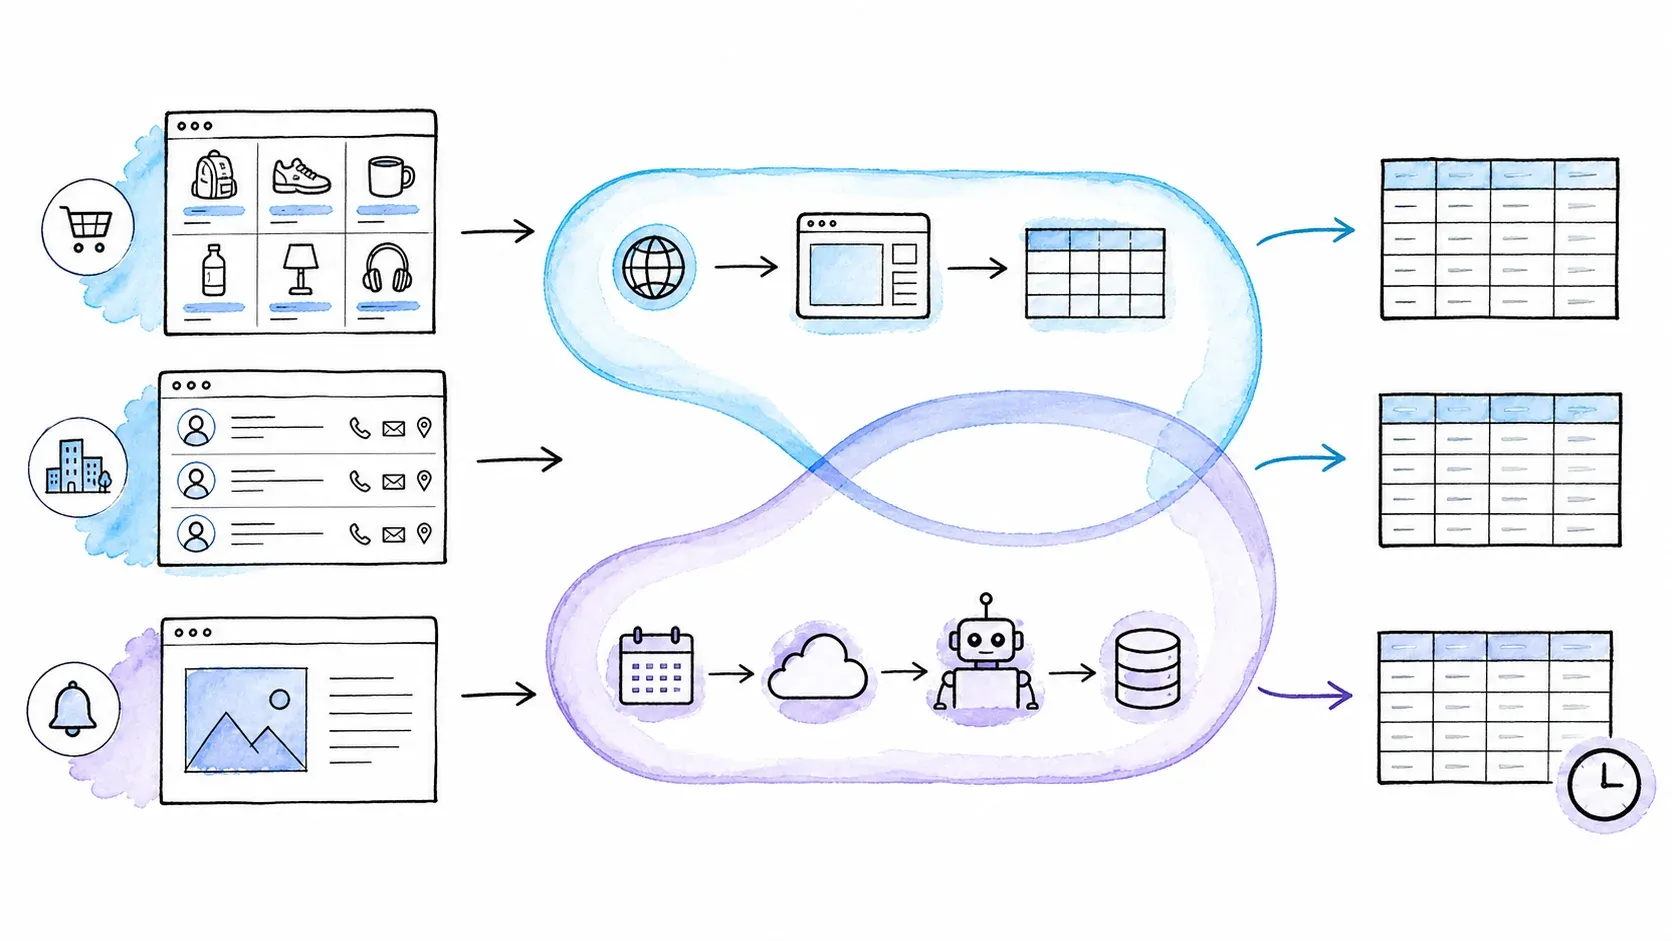
Thunderbit vs Browse AI-priser: vad du faktiskt betalar
Prissjämförelser för scrapingverktyg är knepiga eftersom credit-modellerna är olika. En "credit" i Thunderbit är inte samma enhet som en "credit" i Browse AI. Jämförelser mellan äpplen och päron är värre än oanvändbara — de blir direkt missvisande.
Här är vad jag kan säga om varje verktygs prismodell, med illustrativa uppskattningar för tre användningsnivåer. Alla siffror kommer från de officiella sidorna Browse AI Pricing och Thunderbit Pricing som kontrollerades den 13 augusti 2026. Verifiera innan köp.
Så fungerar credits
Thunderbit: En credit per vanlig outputrad. En rad med stöd för undersidor kostar två credits. Planerna är upplagda kring månatliga eller årliga credit-allowances.
Browse AI: Minst en credit per task. Tio list-rader = en credit. En skärmdump = en credit. Varje besök på en detaljsida är normalt en separat task med minst en credit. Premiumsajter får en 2–10x credit-multiplikator. Varje monitor-körning förbrukar workflowets credits igen. Det betyder att "1 000 sidor" kan bli 100 credits (en list-task med 1 000 rader) eller 1 000+ credits (1 000 separata detaljside-tasks), beroende på arbetsflöde.
Användarrecensioner för Browse AI nämner ofta svårigheter att förutse kreditförbrukning. Om ditt flöde innehåller många detaljsidebesök eller premiumsajter kan kostnaderna sticka iväg snabbare än väntat.
Prisnivåer efter användning
| Volymnivå | Exempelanvändare | Referensplan i Browse AI | Referensplan i Thunderbit | Viktig faktor |
|---|---|---|---|---|
| Låg (~1K detaljsidor/mån) | Frilansare, ensam marknadsförare | Personal annual: $19/månad effektivt (12K credits/år), eller $48/månad med 2K månatliga credits | Pro Tier 1: $38/månad (3K credits) eller $288/år (30K credits) | Credit-enheterna skiljer sig; jämför faktiska outputrader vs. tasks |
| Medel (~10K detaljsidor/mån) | Litet team, byrå | Professional annual: $69/månad effektivt (60K credits/år); ett val med högre credit eller Premium kan behövas | Pro Tier 3: $125/månad (10K credits) eller $1 152/år (120K credits) | Browse AI:s credits skalar efter task-typ; Thunderbits credits skalar efter rader |
| Hög (~50K+ detaljsidor/mån) | Ops-team, datapipeline | Premium: från $500/månad, med anpassade credits | Business/API: anpassad prissättning | Volymrabatter, API- kontra tilläggsfakturering kan skilja sig |
Viktiga förbehåll:
- Det här är illustrativa minimivärden som antar standardsajt och en detaljsida per task för Browse AI. Premiumsajter, skärmdumpar och komplexa flöden höjer kostnaden.
- Thunderbits uppskattningar utgår från standardrader utan berikning av undersidor. Rader med stöd för undersidor fördubblar credit-kostnaden.
- Inget av verktygens "credits" går att översätta rakt av till "sidor". Modellera alltid ditt specifika arbetsflöde innan du bestämmer dig.
Källor: Browse AI Pricing och Thunderbit Pricing. Senast verifierat: 13 augusti 2026.
Schemaläggning, export och integrationer
Schemaläggning och automatisering
| Funktion | Thunderbit | Browse AI |
|---|---|---|
| Gratis schema | 1 per dag | Minst varje timme |
| Miniminivå för betalschema | Starter: varje timme; Pro: 5 minuter | Personal/Pro: 5 minuter |
| Ändringshistorik/detektering | Schemalagda resultat; kontrollera dedikerad övervakning | Förstklassiga monitorer, historik, ändringshändelser, e-post/webhooks |
| Kedjning av arbetsflöden | Inte en primärt dokumenterad funktion | Workflows kopplar ihop robotar (lista → detalj → output) |
Browse AI vinner när det gäller djup i schemaläggning och övervakning. Om ditt arbetsflöde kretsar kring återkommande extraktion med ändringsdetektering och triggers längre ned i kedjan, är Browse AIs övervakningslager mer moget.
Exportmål och format
| Destination | Thunderbit | Browse AI |
|---|---|---|
| Google Sheets | Direkt | Direkt synk |
| Airtable | Direkt | Direkt synk |
| Notion | Direkt | Ingen primär inbyggd synk; mellanlager möjligt |
| Excel | Direkt/nedladdning | CSV öppnas i Excel; Excel-leverans via Zapier, inte nativ synk |
| CSV/JSON | Stöds | Stöds |
| Amazon S3 | Inte primärt | Stöds |
| Zapier/Make/Pabbly/n8n | Downstream möjligt; kontrollera exakt inbyggd väg | Utförligt dokumenterat |
| Webhooks | Händelser för batchjobb | Händelser för task success/error/data-change och tabeller |
Thunderbits direkta Notion-export är en verklig differentierare om Notion är teamets nav. Browse AIs bredare integrations-ekosystem (Zapier, Make, Pabbly, n8n, CRM-system, datalager) ger det ett övertag för mer komplex dirigering vidare i kedjan.
Utvecklar- och automationsflöden: jämförelsen ingen annan gör
Om du är produktansvarig och utvärderar verktyg för en datapipeline, en growth engineer som bygger ett AI-agentflöde, eller en dataledare som behöver programmatisk åtkomst — då är det här avsnittet för dig. Det är också den jämförelse som helt saknas i varje annan "Browse AI alternatives"-artikel jag hittade.
| Yta | Thunderbit | Browse AI |
|---|---|---|
| REST / Open API | Distill, Extract med schema, Suggest Fields, batchjobb | v2 REST API: robotar, tasks/data, monitors, webhooks, cookies, bulkkörningar |
| Modell för API-anrop | Anropa extraktion direkt mot URL:er med schema/instruktioner | Kör och hantera godkända robotar |
| Webhooks | Händelser för batchjobb | Händelser för task success/error/data-change och tabeller |
| MCP Server | Officiell @thunderbit/mcp-server för Claude, Cursor, Windsurf m.fl. | Ingen officiell publik MCP hittades (per aug 2026) |
| CLI | Officiell @thunderbit/thunderbit-cli | Ingen officiell publik CLI hittades (per aug 2026) |
| Automations-ekosystem | API, MCP, CLI, agentvärdar | API, Zapier, Make, Pabbly, n8n, CRM-system, datalager, externa LLM:er |
| API-rate limit | Kontrollera aktuella docs | 100 requests/minut/nyckel (dokumenterat) |
Thunderbits utvecklargränssnitt
Thunderbits Open API låter dig anropa Distill, schema-baserad Extract och Suggest Fields direkt mot URL:er — du behöver inte först skapa en sparad scraper eller robot. Det här är en viktig arkitektonisk skillnad: du kan definiera godtyckliga extraktionsscheman i kod och köra dem mot valfri URL.
MCPP-servern (@thunderbit/mcp-server) exponerar Thunderbit-verktyg för kompatibla AI-hostar — Claude, Cursor, Windsurf och andra. CLI:n (@thunderbit/thunderbit-cli) stödjer terminal- och kodagentflöden.
Det här är programstyrda, agentanropade verktyg. De är inte samma sak som att klicka på en knapp i webbläsartillägget. Men för team som bygger RAG-pipelines, AI-agentflöden eller backend-infrastruktur för data ger de en utbyggbarhet som Browse AIs nuvarande publika yta inte riktigt matchar.
Browse AIs utvecklargränssnitt
Browse AIs v2 REST API är omfattande: det hanterar robotar, tasks/captured data, monitors, webhooks, cookie-uppdateringar och bulk-körningar (upp till 1 000 tasks per API-anrop). API:t är byggt kring robotens livscykel — du skapar, konfigurerar och godkänner robotar, och kör dem sedan programatiskt.
Browse AIs integrations-ekosystem (Zapier, Make, Pabbly, n8n, CRM-system, datalager) är väl dokumenterat och moget. För team som vill skicka extraherad data vidare till andra verktyg utan egen kod är det här en riktig styrka.
Ingen officiell publik Browse AI MCP-server eller CLI hittades per augusti 2026. Det är en tidsbunden observation, inte ett evigt frånvarande stöd — kontrollera Browse AIs dokumentation om du läser detta senare.
Vad det här betyder för AI-agent- och pipelineflöden
Om du bygger arbetsflöden där en AI-agent behöver hämta data från godtyckliga URL:er med egna scheman — Claude Code som analyserar konkurrentsidor, Cursor som berikar en datamängd, en backend-pipeline som processar en kö av URL:er — då är Thunderbits API/MCP/CLI ett tydligare val.
Om du behöver schemalägga och hantera en svärm av godkända robotar, dirigera deras output till flera mål och trigga åtgärder när data ändras — då har Browse AI ett starkt robot-/monitor-API och ett bra integrations-ekosystem.
API:erna tjänar olika modeller för skapande och körning. Thunderbits API säger "extrahera detta från den här URL:en." Browse AIs API säger "kör den här godkända roboten och hantera dess livscykel." Ingen av dem är generellt bredare — de är optimerade för olika arbetsflöden.
Skalbarhet och volym: vilket verktyg hanterar tillväxt bäst?
Att skala från "jag skrapade en sida" till "jag behöver 50 000 sidor i månaden" blottar olika flaskhalsar i varje verktyg.
Thunderbit utmärker sig i interaktiv, ad hoc-utforskning via browser-tillägget. För volym erbjuder det en molnkörningsväg (leverantören anger upp till 50 samtidiga sidor) och batchjobb via API. Avvägningen: tillägget är snabbt för utforskning men är inte byggt för enorma schemalagda svärmar. API:t och molnvägen fyller den luckan, men prissättning och credit-ekonomi i skala beror på din faktiska volym av outputrader och användning av undersidor.
Browse AI är arkitektoniskt byggt för schemalagda, upprepbara jobb med definierade intervall. Molnrobotar kör självständigt, monitorer följer förändringar och workflows kedjar ihop robotar. Avvägningen: credit-baserad prissättning kan bli en flaskhals vid hög volym, särskilt med multiplikatorer för premiumsajter och många detaljside-tasker. Användarrecensioner nämner kreditoförutsägbarhet som en vanlig oro i skala.
Båda verktygen har gränser för skalning som beror på ditt specifika arbetsflöde, dina målwebbplatser och din budget. Om du utvärderar för högvolymproduktion bör du modellera din faktiska kreditförbrukning i båda verktygen innan du bestämmer dig.
Där varje verktyg vinner: omdöme för Thunderbit vs Browse AI
Välj Thunderbit om…
- Du behöver snabb, ad hoc-extraktion från en sida du redan tittar på — särskilt om den ligger bakom en inloggning. Browser Mode använder din aktuella session, så ingen credential-konfiguration behövs.
- Du vill ha agentisk sidanalys med transformationer under extraktionen. Field AI Prompts låter dig översätta, kategorisera, sammanfatta eller formatera data medan den scrapas — inte som ett separat steg efteråt.
- Du behöver utvecklarverktyg för pipelines eller AI-agentflöden. Open API, MCP Server och CLI ger en utbyggbarhet som Browse AIs nuvarande publika yta inte matchar.
- Du vill exportera direkt till Notion. Thunderbit har en inbyggd Notion-destination; Browse AI har det inte.
- Du föredrar ett browser-tilläggsbaserat arbetsflöde som inte kräver att du bygger och godkänner en robot innan du ser resultat.
- Du behöver dedikerade verktyg för att extrahera e-post, telefonnummer eller bilder för kontaktfokuserade arbetsflöden.
Välj Browse AI om…
- Ditt huvudsakliga användningsområde är schemalagd övervakning och ändringsdetektering. Browse AIs monitorer, ändringshistorik, aviseringar och workflow-triggers är byggda för detta. Det är den mer mogna produkten för återkommande extraktion.
- Du vill ha förbyggda robotmallar för populära sajter (Amazon, LinkedIn, Indeed, Zillow och 250+ till) med minimal uppsättning.
- Du föredrar en helt molnbaserad exekveringsmodell där inget körs i din lokala webbläsare efter att roboten skapats.
- Du behöver breda no-code-integrationer — Zapier, Make, Pabbly, n8n, CRM-system, datalager — med moget stöd för webhooks och event.
- Du vill bygga och hantera en flotta av återanvändbara robotar som körs enligt schema, i workflows eller via API-anrop.
- Du behöver Formula AI för beräknade kolumner efter extraktion i Browse AIs Tables-lager.
Slutsatsen
Thunderbit är ett tilläggsbaserat verktyg som är snabbt för interaktiv utforskning, starkt för extraktion från inloggade sidor och ovanligt utbyggbart för utvecklar- och AI-agentflöden. Browse AI är en molnbaserad övervakningsplattform som är specialbyggd för schemalagd återkommande extraktion, ändringsspårning och integrationsdriven automatisering.
Det bästa valet beror på ditt arbetsflöde, inte på en checklista med funktioner. Om du mest behöver "ge mig den här datan från den här sidan nu", börja med Thunderbit. Om du mest behöver "kör den här extraktionen varje dag och varna mig när något ändras", börja med Browse AI. Och om du behöver båda — ad hoc-utforskning och återkommande övervakning — kan det hända att du använder båda.
Vanliga frågor
Är Thunderbit eller Browse AI lättast för nybörjare?
Båda är no-code, men UX:en skiljer sig åt. Thunderbits One Click Extract analyserar sidan du tittar på och uppgiften startar automatiskt. Browse AIs Robot Studio låter dig skapa en återanvändbar robot med AI-rekommenderade datamängder och demonstrerade åtgärder. Browse AI har starka oberoende recensioner om användarvänlighet (4,7/5 på Capterra). Ingen av dem är generellt enklast; det beror på om du tänker i termer av "fält på den här sidan" eller "en robot som gör den här uppgiften".
Kan jag använda Thunderbit och Browse AI gratis?
Ja. Thunderbits gratisnivå inkluderar just nu 6 sidor/månad, max 30 credits per sida, ett dagligt schema, export, mallar samt verktyg för kontakt- och bildeextraktion. Browse AIs gratisnivå inkluderar 50 credits/månad, 2 webbplatser, 3 användare, obegränsat antal robotar och övervakning varje timme. Credit-enheter går inte att jämföra rakt av — modellera ditt specifika arbetsflöde för att förstå vad "gratis" faktiskt ger dig.
Har Browse AI ett API som Thunderbit?
Browse AI har ett omfattande v2 REST API för att hantera robotar, tasks, monitors, webhooks, cookies och bulk-körningar. Thunderbits Open API exponerar direkt Distill, schema-baserad Extract, Suggest Fields och batchjobb — plus officiella MCP- och CLI-paket. API:erna tjänar olika modeller: Thunderbits API kan anropa extraktion direkt mot URL:er med anpassade scheman; Browse AIs API kör och hanterar främst godkända robotar.
Vilket verktyg är bäst för att övervaka prisförändringar?
Browse AI. Dess övervakningslager är en kärnfunktion: konfigurerbara scheman (ner till fem minuter på betalplaner), ändringshistorik, detektering, e-postaviseringar, webhook-/integrationshändelser och workflow-triggers. Thunderbit stöder schemalagd extraktion, men Browse AIs dedikerade övervakningsdjup är mer moget för just det här användningsfallet.
Kan Thunderbit skrapa sidor som kräver inloggning?
Thunderbits Browser Mode körs i din nuvarande webbläsarsession, så det kan extrahera från sidor där du redan är inloggad — när det stöds och på kompatibla sajter. Browse AI stöder också inloggade sidor via krypterade uppgifter och sessionscookies, men molnkörning innebär begränsningar kring IP/session/2FA. För sidor där du redan är autentiserad tar Thunderbits tilläggsbaserade ansats bort ett konfigurationslager.
Vidare läsning och resurser
Om du vill fördjupa dig i något av verktygen eller relaterade ämnen:
- Hur du extraherar data från vilken webbsida som helst med Thunderbit — steg-för-steg-genomgång av One Click Extract-flödet.
- Bästa AI Web Scraper-verktygen — bredare jämförelse av AI-webbscrapinglandskapet.
- Browse AI-recension och alternativ — mer detaljer om Browse AIs styrkor och begränsningar.
- Bästa verktygen för automatiserad webbscraping — för team som utvärderar hela spektrumet av no-code- och low-code-alternativ.
- Thunderbits utvecklardokumentation: Open API | MCP Server | CLI
Läs mer



