
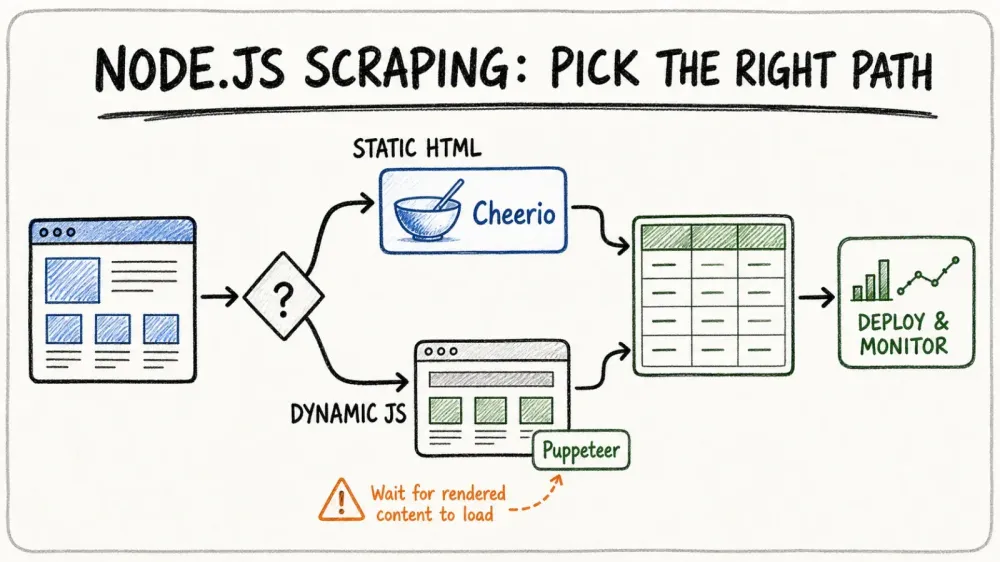
Вебу как никогда нужны данные, и в 2026 году Node.js задаёт темп для команд, которые хотят собирать данные умнее, а не в лоб. Неважно, занимаешься ли ты продажами, ecommerce или просто обожаешь данные так же, как я, — ты наверняка уже понял, что скрейпинг сегодня это не просто «добыть нужную информацию». Теперь важно делать это быстро, в больших объёмах и без риска угодить со своим IP в цифровую тюрьму. И спрос только растёт: публичные веб-данные незаметно стали основой для самых разных задач — от анализа цен до пайплайнов обучения LLM, а ставки и конкуренция выше, чем когда-либо.
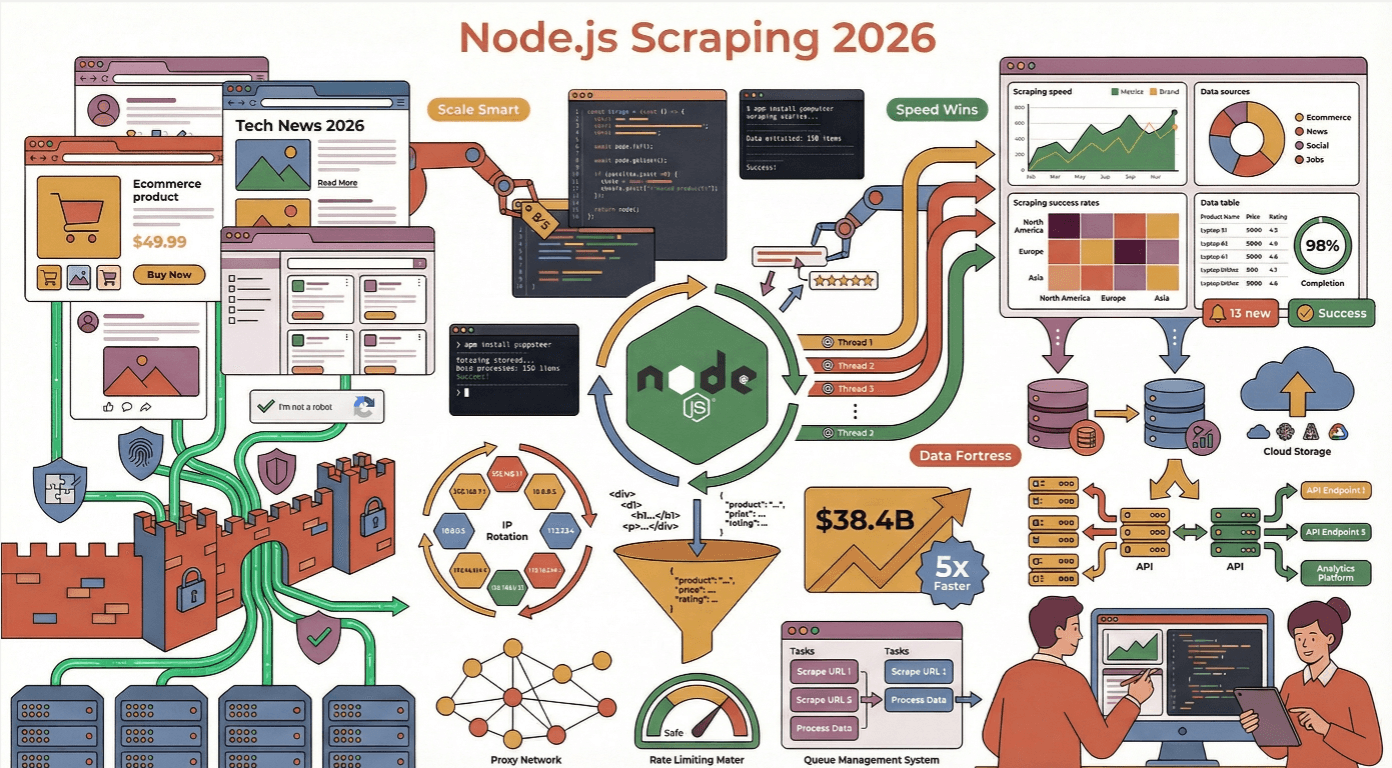
Но есть нюанс: современный веб — это крепость из динамического контента, ловушек для ботов и постоянно меняющихся макетов. Я видел больше падений скрейперов, чем хотелось бы признавать, — обычно потому, что игнорировались лучшие практики или недооценивалась изощрённость антискрейпинговой защиты. Так что давай разберём реальные лучшие практики для эффективного веб-скрейпинга на Node.js — с примерами из жизни, лёгким юмором и большим количеством практических советов.
Почему для эффективного веб-скрейпинга стоит выбрать Node.js?
Если ты хоть раз пытался скрейпить сотни или тысячи страниц одновременно, то знаешь: скорость и параллельность решают всё. Именно здесь Node.js особенно хорош. Его асинхронная неблокирующая модель I/O создана для обработки огромного числа одновременных сетевых запросов — по сути, это идеальный многозадачник для интернета (Node.js Docs). Пока другие языки «зависают» в ожидании ответа, Node.js спокойно крутит event loop и жонглирует запросами, как циркач на кофеине.
Я не раз видел, как Node.js обходит Python и Java в сценариях, где нужны обновления в реальном времени и массовый сбор данных, особенно если целевые сайты активно используют JavaScript. Более того, около 40% разработчиков сегодня используют Node.js для backend- и automation-задач, что делает его самой популярной веб-технологией в мире.
Node.js против других фреймворков для веб-скрейпинга
Немного занудства не повредит. Вот как Node.js выглядит на фоне конкурентов:
| Фреймворк | Сильные стороны | Слабые стороны | Лучшие сценарии |
|---|---|---|---|
| Node.js | Асинхронность, отличная параллельная обработка, огромная экосистема npm, нативный JS для динамических сайтов | Может потреблять много памяти, возможен callback hell (если не использовать async/await) | Сбор данных в реальном времени, JS-насыщенные сайты, масштабируемые микросервисы |
| Python | Много библиотек для скрейпинга (BeautifulSoup, Scrapy), простой синтаксис | Медленнее при высокой параллельности, хуже справляется с JS-рендерингом | Статический HTML, исследования, прототипирование |
| Java | Строгая типизация, надёжность для enterprise | Многословный код, менее удобен для быстрых скриптов | Крупномасштабный enterprise-скрейпинг |
| Go | Быстрый, эффективная параллельность | Меньшая экосистема, более высокий порог входа | Высокопроизводительный скрейпинг с низкой задержкой |
Для большинства бизнес-пользователей Node.js попадает в «золотую середину»: быстрый, гибкий и отлично подходит для современного веба на JavaScript (Thunderbit Blog).
Как настроить надёжную среду для веб-скрейпинга на Node.js
Хороший скрейпер начинается с прочного фундамента. Вот моя базовая схема:
- Структура проекта: Делай проект модульным. Используй папки вроде
/src,/libsи/config. Конфиденциальные данные (API-ключи, прокси) храни в переменных окружения черезdotenv(Thunderbit Guide). - HTTP-клиент: Используй axios, got или node-fetch для запросов.
- Парсинг HTML: Cheerio для статического HTML, Puppeteer или Playwright для динамического контента.
- Утилиты: Используй Lodash для обработки данных и validator.js или Joi для проверки данных.
- Тестирование и линтинг: Mocha для тестов, ESLint для качества кода (LogRocket).
Основные библиотеки Node.js для веб-скрейпинга
- HTTP-клиенты (axios / got / встроенный
fetch): Для отправки запросов. Важное замечание: начиная с Node.js v18 можно нативно использоватьfetchбез установки дополнительных пакетов, а в Node.js v22 он стал стабильным. Для нового проекта на свежей версии Node.js пакетnode-fetchчаще всего уже не нужен — достаточно напрямую вызыватьfetch. Я по-прежнему часто беру axios, когда нужны интерсепторы, автоматическая работа с JSON и привычный promise API и в Node, и в браузере, а got выбираю, когда из коробки нужны ретраи, потоки или HTTP/2. Берите то, что подходит вашему стеку; для простого скрипта нативныйfetchвполне достаточен. - Cheerio: Быстрый HTML-парсер в стиле jQuery. Отлично подходит для статических страниц — парсит примерно за 0,5 секунды (Oxylabs).
- Playwright / Puppeteer: Headless-автоматизация браузера для динамических сайтов с большим количеством JS. Медленнее (примерно 4 секунды на страницу), но необходима для сайтов, где контент подгружается после загрузки страницы (Bright Data). Если ты начинаешь с нуля в 2026 году, Playwright — выбор по умолчанию: кроссбраузерность «из коробки» (Chromium / Firefox / WebKit), встроенный trace viewer, а команда, которая изначально создала Puppeteer, теперь развивает его в Microsoft. Puppeteer всё ещё поддерживается для задач только под Chrome, но его релизы уже некоторое время больше сосредоточены на совместимости с Chrome, чем на новых возможностях.
- dotenv: Для управления переменными окружения.
- csv-writer/jsonfile: Для экспорта данных.
Как избежать типичных ошибок при веб-скрейпинге на Node.js
Я уже не помню, сколько раз видел, как скрейперы блокировали, ломали или просто превращали данные в хаотичную кашу. Вот на что стоит обратить внимание:
- Игнорирование robots.txt и Terms of Service: Всегда проверяй это до начала скрейпинга. Нарушение может привести к бану IP — или, хуже того, к юридическим проблемам (ScraperAPI).
- Перегрузка серверов: Не засыпай сайты запросами. Ограничивай скорость, добавляй случайные задержки (1–3 секунды), контролируй параллельность и не веди себя как гиперактивный робот (ScrapeGraphAI).
- Отсутствие обработки ошибок: Всегда оборачивай запросы в try/catch, обрабатывай HTTP-ошибки и логируй сбои. Временные ошибки повторяй с экспоненциальной задержкой (ScrapeGraphAI).
- Забытые заголовки запросов: Используй реалистичные User-Agent и периодически меняй их. Добавляй Accept-Language, Referer и другие заголовки, чтобы имитировать обычный браузер (ScrapeGraphAI).
Как обходить антискрейпинговые механизмы
Современные сайты вооружены антибот-защитой до зубов. Вот как я обхожу цифровые минные поля:
- Ротация прокси и IP: Используй пул прокси и меняй IP, чтобы избежать блокировок (Medium).
- Рандомизация заголовков: Меняй User-Agent, Accept-Language и другие заголовки для каждого запроса.
- Stealth в headless-браузере: Используй плагины вроде
puppeteer-extra-plugin-stealth, чтобы скрыть признаки автоматизации. - Имитация поведения человека: Добавляй случайные паузы, движения мыши, прокрутку и даже опечатки при вводе (ZenRows).
Имитация поведения человека в Node.js-скрейперах
Вот тут начинается самое интересное — и немного странное. Вместо мгновенных кликов и прокрутки настрой скрипт так, чтобы он:
- Ждал случайные интервалы между действиями (
await page.waitForTimeout(randomDelay)) - Двигал мышь небольшими дрожащими шагами (
page.mouse.move(x, y)) - Печатал с задержками и редкими опечатками (
page.type(selector, text, {delay: random(100,200)})) - Прокручивал страницу неровно, а не просто до самого низа
Такие приёмы могут заметно повысить успех на защищённых сайтах (ScraperAPI).
Как упростить сложный сбор данных с помощью Thunderbit
Собирайте данные с любого сайта с помощью ИИ Забудьте про шаблонный код: агентный веб-скрейпер Thunderbit считывает любую страницу и извлекает данные в один клик, без необходимости поддерживать Node.js-код. Get Started Free
Теперь поговорим о слоне в комнате: скрейпинг — это сложно. Но он не обязан быть таким. Именно поэтому мы создали Thunderbit.
Thunderbit — это Chrome Extension с агентным веб-скрейпером, который позволяет извлекать данные с любого сайта на обычном языке. Просто нажми “One Click Extract”, дай ИИ понять, что находится на странице, и нажми “Scrape”. Это как иметь младшего разработчика, который никогда не спит и не просит повышения.
И это ещё не всё: у Thunderbit есть API, так что его можно напрямую встроить в твои Node.js-процессы. Вместо тысяч строк скрейпингового кода ты можешь переложить на Thunderbit всю тяжёлую работу — динамический контент, подстраницы, пагинацию и всё остальное. Тебе останется только забрать структурированные данные в CSV, JSON или сразу отправить их в Google Sheets, Airtable, Notion — и спокойно заниматься другими задачами (Thunderbit Blog).
Попробуй расширение Thunderbit для Chrome бесплатно Установи бесплатное расширение Chrome и извлекай структурированные данные в один клик — или вызывай API Thunderbit из твоего Node.js-приложения. Get Started Free
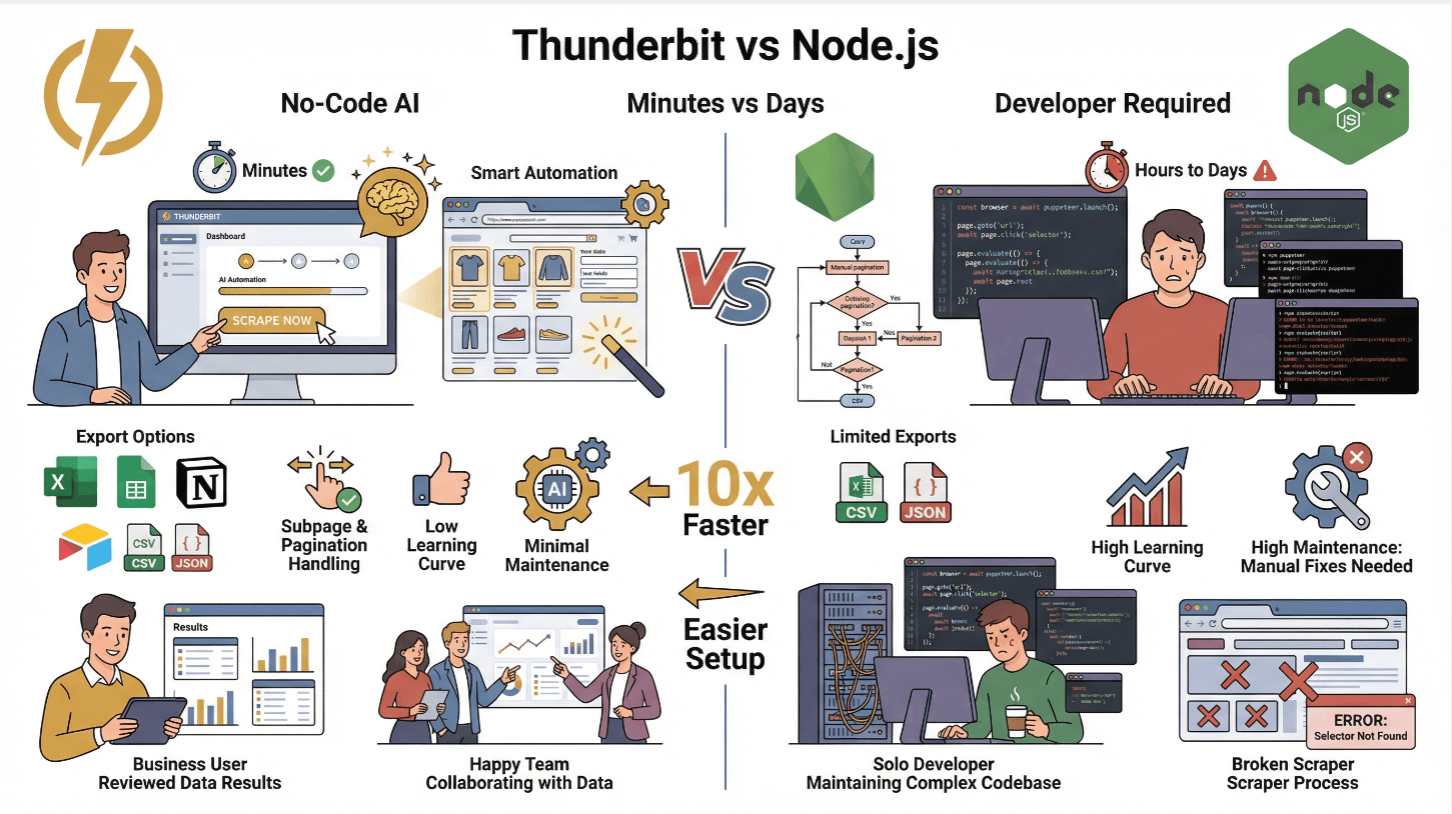
Thunderbit против традиционного Node.js-скрейпинга
| Функция | Thunderbit | Традиционный скрейпер на Node.js |
|---|---|---|
| Время настройки | Минуты (без кода) | От часов до дней (кодирование, тестирование) |
| Работа с динамическим контентом | Да (ИИ + браузер) | Да (через Puppeteer/Playwright) |
| Подстраницы и пагинация | В один клик | Требуется ручное программирование |
| Экспорт данных | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (своим кодом) |
| Порог входа | Низкий (для бизнес-пользователей) | Высокий (для разработчиков) |
| Поддержка и обслуживание | Минимальное (ИИ подстраивается) | Высокое (ручные правки при изменениях сайта) |
Thunderbit идеально подходит для нетехнических команд и для тех, кто хочет избавиться от рутинной работы и сосредоточиться на аналитике. А продвинутые пользователи могут использовать API Thunderbit, чтобы автоматизировать скрейпинг в масштабе (Thunderbit Docs).
Комбинация Cheerio и Puppeteer для динамического контента
Это моя любимая связка в Node.js-скрейпинге. Работает так:
- Используй Puppeteer, чтобы загрузить страницу и выполнить JavaScript (дождись
networkidle, чтобы убедиться, что весь контент подгрузился). - Получите HTML через
await page.content(). - Разберите его в Cheerio: передайте HTML в Cheerio для сверхбыстрого парсинга и извлечения данных в стиле jQuery.
Такой гибридный подход даёт лучшее из двух миров: мощь Puppeteer для динамического контента и скорость Cheerio для парсинга (Browserless).
Совет по производительности: выбирай только те элементы, которые действительно нужны. Cheerio загружает весь DOM в память, поэтому избегай слишком широких селекторов и кэшируй результаты, если регулярно скрейпишь одни и те же страницы (Oxylabs).
Как оптимизировать парсинг HTML и извлечение данных
- Используй точные селекторы: не бери
$('body *')— выбирай только нужные элементы. - Потоковая обработка больших страниц: если HTML огромный, рассмотрите стриминг или разбивку задачи на части.
- Кэшируй отрендеренный HTML: если ты повторно обращаешься к URL, кэш поможет избежать лишних запросов.
- Проверяй и очищай данные: используй библиотеки валидации, чтобы не засорять базу мусором (ScrapeGraphAI).
Масштабируемый деплой веб-скрейпера на Node.js в облаке
Скрейпинг в больших объёмах? Пора переходить на cloud-native.
- Упакуй скрейпер в Docker: создай
Dockerfile, скопируй код, установи зависимости и задай entrypoint. - Разверни в облаке: используй AWS EC2, Google Cloud Compute или Azure VM для простых задач. Для серьёзного масштаба применяй Kubernetes или управляемые сервисы вроде AWS ECS/EKS, Google Cloud Run или Azure Kubernetes Service (DigitalOcean).
- Оркестрация через Kubernetes: запускай несколько pod'ов, включай автоскейлинг по нагрузке и используй балансировщики, чтобы распределять URL.
- Планируй задания: используй облачные планировщики (CloudWatch Events, Cloud Scheduler) или cron-задачи для запуска скрейпа по расписанию.
В одном реальном кейсе увеличение числа Kubernetes pod'ов с 5 до 10 сократило сбор 400 страниц с нескольких минут до менее чем минуты (DigitalOcean).
Мониторинг и автоскейлинг вашей инфраструктуры для скрейпинга
- Логирование: отправляй логи в CloudWatch, Stackdriver или Datadog. Настрой оповещения на ошибки и замедления.
- Проверка здоровья: используй Prometheus и Grafana для метрик вроде числа страниц в минуту, процента ошибок и состояния pod'ов.
- Автоскейлинг: настрой Kubernetes HPA (Horizontal Pod Autoscaler), чтобы масштабировать pod'ы в зависимости от CPU или числа запросов.
Всегда добавляй ретраи с экспоненциальной задержкой, чтобы восстанавливаться после сетевых сбоев или временных блокировок.
Лучшие практики хранения и постобработки данных
После сбора данные нужно сохранить и привести в порядок:
- Небольшие задачи: экспортируй в CSV, JSON или отправляй в Google Sheets, Airtable или Notion (Thunderbit делает это из коробки).
- Крупные задачи: используй SQL (MySQL/PostgreSQL) для структурированных данных или NoSQL (MongoDB, DynamoDB) для полуструктурированных данных и меняющихся схем (ScrapeHero).
- Облачное хранилище: S3 или Google Cloud Storage для сырых файлов и резервных копий.
- Очистка данных: всегда проверяй поля, нормализуй форматы (даты, числа) и удаляй дубликаты. Используй валидаторы схем, чтобы поддерживать качество данных (ScrapeGraphAI).
Храни и сырые, и очищенные данные — никогда не знаешь, когда потребуется повторная обработка или отладка.
Заключение: главные выводы об эффективности веб-скрейпинга на Node.js
Откажитесь от кода для скрейпинга Посмотри, как агентный веб-скрейпер Thunderbit выглядит на фоне самостоятельной разработки и поддержки собственных скриптов. Get Started Free
Подведём итоги:
- Используй асинхронную мощь Node.js для массового параллельного скрейпинга — особенно на сайтах с большим количеством JavaScript.
- Комбинируй правильные инструменты: axios/got — для запросов, Cheerio — для статического HTML, Puppeteer — для динамического контента, а лучше сочетай их ради скорости и гибкости.
- Избегай антибот-ловушек: вращай прокси и заголовки, имитируй поведение человека и соблюдай robots.txt.
- Упрощай работу с Thunderbit: для бизнеса или быстрого прототипирования Thunderbit позволяет извлекать сложные данные с помощью ИИ и подключать их к твоему Node.js-стеку через API.
- Разворачивай в масштабе: упаковывай в Docker, оркестрируй через Kubernetes и следи за стабильностью всей системы.
- Храни и очищай данные: выбирай подходящее хранилище под задачу и всегда проверяй данные перед использованием.
Веб не становится проще, но с этими практиками твои Node.js-скрейперы будут работать быстро, надёжно и всегда опережать антибот-гонку. А если тебе когда-нибудь надоест отлаживать селекторы в 2 часа ночи, помни: ИИ Thunderbit никогда не спит.
Хочешь узнать больше? Загляни в Thunderbit Blog, чтобы почитать более глубокие разборы, или попробуй расширение Thunderbit для Chrome и убедись, насколько простым может быть скрейпинг.
Скрейпинг с Thunderbit Agentic Web Scraper API веб-скрейпера Thunderbit позволяет запускать извлечение данных прямо из твоего Node.js-кода, а бесплатный тариф поможет начать без риска. Get Started Free
Часто задаваемые вопросы
1. Почему Node.js особенно хорошо подходит для веб-скрейпинга в 2025 году?
Асинхронная событийная модель Node.js позволяет обрабатывать тысячи одновременных запросов, что делает его идеальным для сбора больших объёмов данных и обновлений в реальном времени. Огромная экосистема npm и нативная поддержка JavaScript отлично подходят для современных сайтов с большим количеством JS (Node.js Docs).
2. Как избежать блокировки при скрейпинге на Node.js?
Используй ротацию прокси, рандомизируй заголовки запросов, ограничивай частоту запросов случайными задержками и имитируй человеческое поведение — движения мыши, прокрутку, ввод текста — с помощью таких инструментов, как Puppeteer. Всегда соблюдай robots.txt и правила сайта (Medium).
3. Когда в Node.js-скрейпере использовать Cheerio, а когда Puppeteer?
Используй Cheerio для быстрого парсинга статического HTML, когда данные уже находятся в исходной разметке. Используй Puppeteer для сайтов, которые подгружают контент динамически через JavaScript. Для лучшего результата сначала рендерь страницу через Puppeteer, а затем разбирай HTML в Cheerio (Bright Data).
4. Как Thunderbit упрощает веб-скрейпинг на Node.js?
Thunderbit позволяет извлекать структурированные данные с любого сайта с помощью ИИ и текстовых подсказок — без написания кода. Он умеет работать с динамическим контентом, подстраницами и пагинацией, а также предлагает API для интеграции с Node.js. Данные можно сразу экспортировать в Excel, Google Sheets, Airtable или Notion (Thunderbit Blog).
5. Как лучше масштабировать и отслеживать Node.js-скрейперы в облаке?
Упакуй скрейпер в Docker, разверни его в Kubernetes или на управляемых облачных сервисах и используй автоскейлинг для пиковых нагрузок. Отслеживай логи и метрики с помощью CloudWatch или Prometheus и настраивай уведомления на ошибки и замедления (DigitalOcean).
Готов вывести веб-скрейпинг на новый уровень? Попробуй Thunderbit — и пусть твои скрейперы будут быстрыми, незаметными и всегда на шаг впереди.
Попробуйте агентный веб-скрейпер Get Started Free
Узнать больше




