
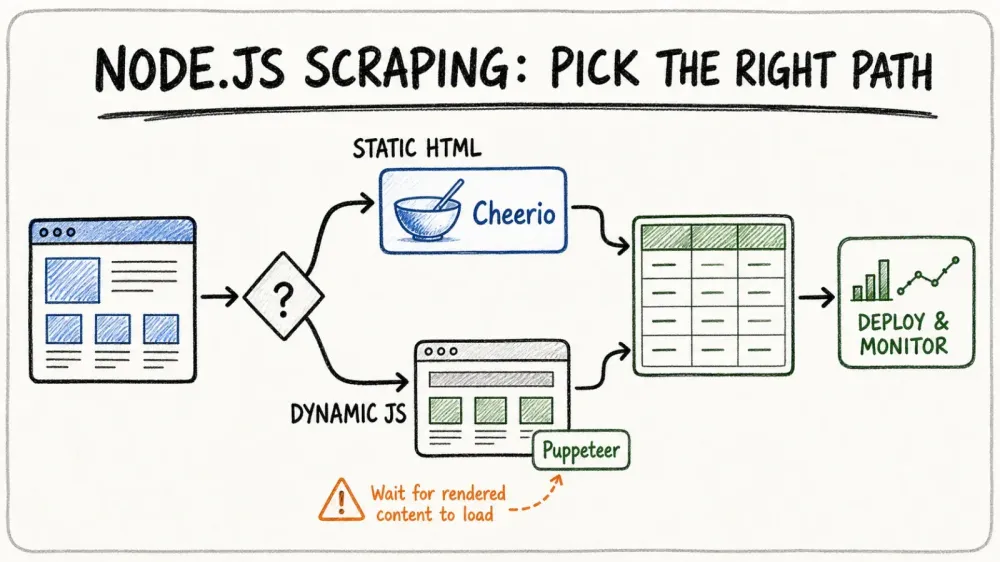
Internet jeszcze nigdy nie potrzebował tylu danych, co dziś, a w 2026 roku Node.js pozostaje jednym z głównych wyborów dla zespołów, które chcą scrapować sprytniej, a nie ciężej. Niezależnie od tego, czy pracujesz w sprzedaży, e-commerce, czy po prostu kochasz dane tak jak ja, pewnie zauważyłeś, że scraping to już dawno nie jest tylko „zbieranie danych”. Dziś liczy się tempo, skala i to, żeby nie trafić z adresem IP na cyfrową czarną listę. Popyt też nie słabnie — publiczne dane z internetu po cichu stały się podstawą dla wielu nowoczesnych zespołów, od analityki cen po pipeline’y do trenowania LLM, a stawka i konkurencja jeszcze nigdy nie były tak wysokie.
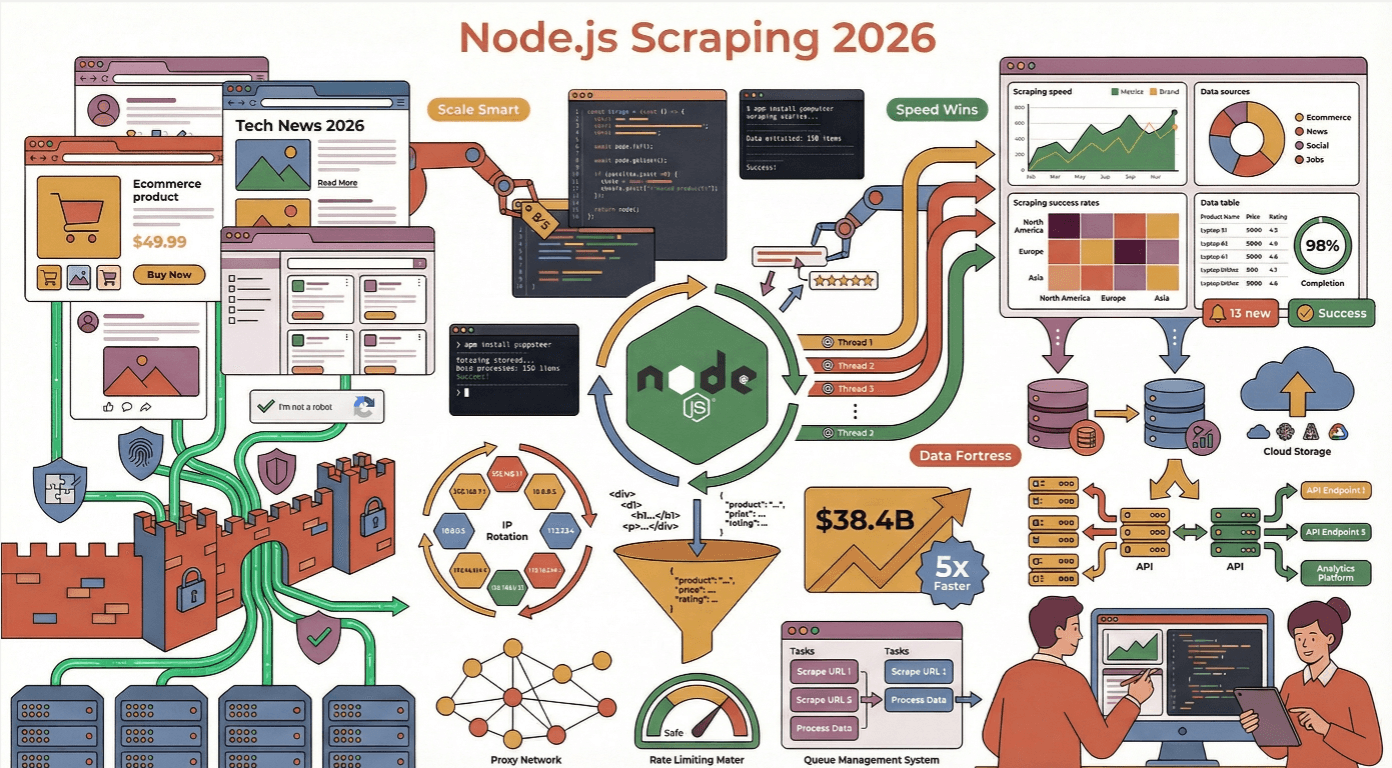
Jest jednak jeden haczyk: współczesna sieć to prawdziwa twierdza dynamicznych treści, pułapek antybotowych i zmieniających się układów stron. Widziałem więcej scraperów, które poległy spektakularnie, niż chciałbym przyznać — zwykle dlatego, że ignorowały dobre praktyki albo nie doceniały sprytu mechanizmów obronnych przeciw scrapingowi. Dlatego przyjrzyjmy się sprawdzonym w praktyce sposobom na zwiększenie efektywności web scrapingu w Node.js — z kilkoma historiami, odrobiną humoru i sporą dawką konkretnych wskazówek.
Dlaczego warto wybrać Node.js do wydajnego web scrapingu?
Jeśli kiedykolwiek próbowałeś zeskrobać setki albo tysiące stron naraz, wiesz, że kluczowe są szybkość i współbieżność. I właśnie tutaj Node.js naprawdę błyszczy. Jego asynchroniczny, nieblokujący model I/O został stworzony do obsługi ogromnej liczby równoczesnych żądań sieciowych — można go traktować jak idealnego specjalistę od internetowego multitaskingu (Node.js Docs). Podczas gdy inne języki potrafią utknąć na jednym żądaniu, Node.js po prostu dalej obraca swój event loop i żongluje requestami jak pobudzony artysta cyrkowy.
Widziałem, jak Node.js wyprzedza Pythona i Javę w scenariuszach wymagających aktualizacji w czasie rzeczywistym i ekstrakcji na dużą skalę — zwłaszcza wtedy, gdy strony docelowe są mocno oparte na JavaScript. Co więcej, ~40% programistów używa dziś Node.js do zadań backendowych i automatyzacji, co czyni go najpopularniejszą technologią webową na świecie.
Node.js kontra inne frameworki do web scrapingu
Zróbmy krótki techniczny przegląd. Oto jak Node.js wypada na tle konkurencji:
| Framework | Mocne strony | Słabe strony | Najlepsze zastosowania |
|---|---|---|---|
| Node.js | Asynchroniczny, świetny do współbieżności, ogromny ekosystem npm, natywny JS dla dynamicznych stron | Może być pamięciożerny, „callback hell” bez async/await | Scraping w czasie rzeczywistym, strony mocno oparte na JS, skalowalne mikroserwisy |
| Python | Mnóstwo bibliotek do scrapingu (BeautifulSoup, Scrapy), prosty składniowo | Wolniejszy przy dużej współbieżności, gorzej radzi sobie ze stronami renderowanymi przez JS | Statyczny HTML, badania, prototypowanie |
| Java | Silne typowanie, stabilność w środowiskach enterprise | Rozbudowany kod, mniejsza elastyczność przy szybkich skryptach | Duże wdrożenia, scraping klasy enterprise |
| Go | Szybki, wydajna współbieżność | Mniejszy ekosystem, wyższa bariera wejścia | Wysoka wydajność, scraping o niskich opóźnieniach |
Dla większości użytkowników biznesowych Node.js trafia w złoty środek: jest szybki, elastyczny i świetnie dopasowany do nowoczesnej sieci opartej na JavaScript (Thunderbit Blog).
Jak przygotować solidne środowisko do web scrapingu w Node.js
Dobry scraper zaczyna się od solidnych podstaw. Oto mój sprawdzony zestaw:
- Struktura projektu: Utrzymuj porządek i modularność. Korzystaj z folderów takich jak
/src,/libsi/config. Wrażliwe dane (klucze API, proxy) trzymaj w zmiennych środowiskowych zdotenv(Thunderbit Guide). - Klient HTTP: Do wysyłania żądań używaj axios, got albo node-fetch.
- Parsowanie HTML: Cheerio do statycznego HTML, a Puppeteer lub Playwright do treści dynamicznych.
- Narzędzia pomocnicze: Lodash do obróbki danych oraz validator.js albo Joi do walidacji.
- Testy i linting: Mocha do testów, ESLint do jakości kodu (LogRocket).
Niezbędne biblioteki do web scrapingu w Node.js
- Klienci HTTP (axios / got / wbudowany
fetch): Do wykonywania żądań. Warto od razu zaznaczyć, że od Node.js v18 można korzystać zfetchnatywnie, bez instalowania czegokolwiek, a w Node.js v22 uzyskał on status stabilnego. W nowym projekcie na aktualnej wersji Node’a prawdopodobnie nie potrzebujesz już pakietunode-fetch— wystarczy wywołaćfetchbezpośrednio. Nadal sięgam po axios, gdy zależy mi na interceptorach, automatycznej obsłudze JSON i znajomym API Promise zarówno w Node, jak i w przeglądarce. Z kolei got wybieram wtedy, gdy potrzebuję retry, streamów albo wsparcia dla HTTP/2 od razu po instalacji. Wybierz to, co pasuje do Twojego stacku; do szybkiego skryptu natywnyfetchw zupełności wystarczy. - Cheerio: Szybki parser HTML w stylu jQuery. Świetny do statycznych stron — analizuje dane w ok. 0,5 s (Oxylabs).
- Playwright / Puppeteer: Automatyzacja headless browserów do dynamicznych stron mocno opartych na JS. Wolniejsze rozwiązanie (ok. 4 s na stronę), ale niezbędne tam, gdzie treść ładuje się dopiero po renderowaniu (Bright Data). Jeśli zaczynasz świeży projekt w 2026 roku, domyślnym wyborem jest Playwright — działa w kilku przeglądarkach od razu po instalacji (Chromium / Firefox / WebKit), ma wbudowany trace viewer, a zespół, który pierwotnie stworzył Puppeteer, rozwija go dziś w Microsoft. Puppeteer nadal jest utrzymywany do pracy wyłącznie z Chrome, ale jego release notes od dłuższego czasu koncentrują się głównie na aktualizacjach zgodności z Chrome, a nie na nowych możliwościach.
- dotenv: Do zarządzania zmiennymi środowiskowymi.
- csv-writer/jsonfile: Do eksportu danych.
Jak unikać typowych pułapek web scrapingu w Node.js
Trudno zliczyć, ile razy widziałem scrapery blokowane, wysypywane albo zwracające zwykły śmietnik zamiast danych. Oto, na co trzeba uważać:
- Ignorowanie robots.txt i regulaminu: Zawsze sprawdzaj to przed scrapingiem. Łamanie tych zasad może skończyć się blokadą IP — albo, co gorsza, problemami prawnymi (ScraperAPI).
- Przeciążanie serwerów: Nie zasypuj ich żądaniami. Ogranicz prędkość scrapera losowymi opóźnieniami (1–3 sekundy), stosuj kontrolę współbieżności i nie zachowuj się jak robot na kofeinie (ScrapeGraphAI).
- Brak obsługi błędów: Zawsze opakowuj requesty w try/catch, obsługuj błędy HTTP i loguj niepowodzenia. Przy błędach przejściowych stosuj ponawianie z wykładniczym backoffem (ScrapeGraphAI).
- Zapominanie o nagłówkach: Używaj realistycznych User-Agentów i rotuj je. Dodawaj Accept-Language, Referer i inne nagłówki, by imitować prawdziwą przeglądarkę (ScrapeGraphAI).
Jak omijać mechanizmy antyscrapingowe
Nowoczesne strony internetowe są naszpikowane technologiami antybotowymi. Oto jak omijam cyfrowe miny:
- Rotacja proxy i IP: Używaj puli proxy i zmieniaj adresy IP, aby uniknąć blokad (Medium).
- Losowanie nagłówków: Rotuj User-Agent, Accept-Language i inne nagłówki przy każdym żądaniu.
- Stealth w headless browserach: Korzystaj z wtyczek typu
puppeteer-extra-plugin-stealth, aby ukryć ślady automatyzacji. - Symulowanie ludzkich zachowań: Dodawaj losowe opóźnienia, ruchy myszy, przewijanie, a nawet literówki przy pisaniu (ZenRows).
Symulowanie ludzkich zachowań w scraperach Node.js
Tu zaczyna się zabawa — i odrobina dziwności. Zamiast klikać i przewijać od razu, zaprogramuj scraper tak, by:
- czekał losowy czas między akcjami (
await page.waitForTimeout(randomDelay)), - poruszał myszą małymi, nieregularnymi krokami (
page.mouse.move(x, y)), - pisał z losowymi opóźnieniami i okazjonalnymi literówkami (
page.type(selector, text, {delay: random(100,200)})), - przewijał stronę nieregularnie, a nie po prostu do samego końca.
Takie triki potrafią znacząco zwiększyć skuteczność na chronionych stronach (ScraperAPI).
Jak uprościć złożoną ekstrakcję danych z Thunderbit
Zbieraj dane z dowolnej strony za pomocą AI Pomiń boilerplate: agentowy web scraper Thunderbit odczytuje dowolną stronę i wyciąga dane jednym kliknięciem, bez konieczności utrzymywania kodu Node.js. Get Started Free
Porozmawiajmy teraz o słoniu w pokoju: scraping jest trudny. Ale nie musi taki być. Właśnie dlatego stworzyliśmy Thunderbit.
Thunderbit to agentowy web scraper w formie rozszerzenia do Chrome, który pozwala wyciągać dane z dowolnej strony w zwykłym języku. Wystarczy kliknąć „One Click Extract”, pozwolić AI zrozumieć zawartość strony i nacisnąć „Scrape”. To jak junior developer, który nigdy nie śpi i nigdy nie prosi o podwyżkę.
Co więcej, Thunderbit oferuje API, więc możesz podłączyć go bezpośrednio do swoich workflow w Node.js. Zamiast pisać tysiące linii kodu do scrapingu, możesz pozwolić Thunderbitowi zrobić ciężką pracę — z dynamiczną treścią, podstronami, paginacją i wszystkim, co się z tym wiąże. Ty tylko pobierasz uporządkowane dane (CSV, JSON albo bezpośrednio do Google Sheets, Airtable, Notion) i zajmujesz się resztą dnia (Thunderbit Blog).
Wypróbuj rozszerzenie Thunderbit do Chrome za darmo Zainstaluj darmowe rozszerzenie Chrome i wyciągaj uporządkowane dane jednym kliknięciem — albo wywołuj API Thunderbit z aplikacji Node.js. Get Started Free
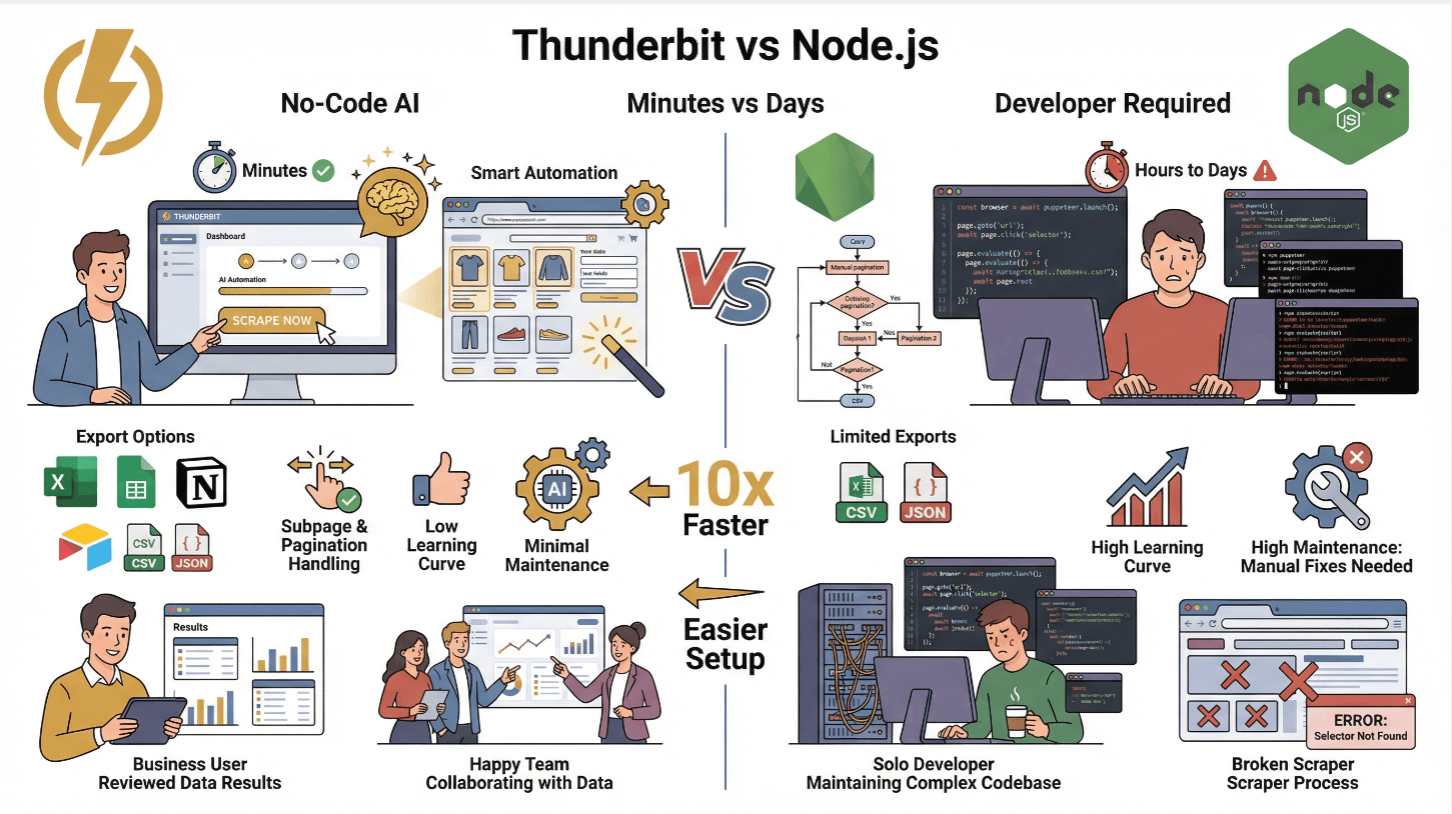
Thunderbit kontra tradycyjny scraping w Node.js
| Cecha | Thunderbit | Tradycyjny scraper Node.js |
|---|---|---|
| Czas konfiguracji | Minuty (bez kodu) | Godziny lub dni (pisanie i testy) |
| Obsługa dynamicznej treści | Tak (AI + przeglądarka) | Tak (z Puppeteer/Playwright) |
| Podstrony i paginacja | 1 kliknięcie | Wymaga ręcznego kodowania |
| Eksport danych | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (własny kod) |
| Krzywa uczenia się | Niska (użytkownicy biznesowi) | Wysoka (developerzy) |
| Utrzymanie | Minimalne (AI adaptuje się) | Wysokie (ręczne poprawki przy zmianach strony) |
Thunderbit jest idealny dla zespołów nietechnicznych albo dla każdego, kto chce ominąć żmudną robotę i skupić się na wnioskach. Bardziej zaawansowani użytkownicy nadal mogą korzystać z API Thunderbit, aby automatyzować scraping na dużą skalę (Thunderbit Docs).
Łączenie Cheerio i Puppeteer do pracy z dynamiczną treścią
To mój ulubiony duet do scrapingu w Node.js. Działa to tak:
- Użyj Puppeteer, aby załadować stronę i wykonać JavaScript (poczekaj na
networkidle, żeby mieć pewność, że cała zawartość się wczytała). - Pobierz HTML za pomocą
await page.content(). - Przeanalizuj go w Cheerio: przekaż HTML do Cheerio, aby błyskawicznie wyciągnąć dane w stylu jQuery.
To hybrydowe podejście daje najlepsze z obu światów: moc Puppeteer do dynamicznej treści i szybkość Cheerio przy parsowaniu (Browserless).
Wskazówka wydajnościowa: wybieraj tylko te elementy, których naprawdę potrzebujesz. Cheerio ładuje cały DOM do pamięci, więc unikaj zbyt szerokich selektorów i cache’uj wyniki, jeśli wielokrotnie scrapujesz te same strony (Oxylabs).
Jak zoptymalizować parsowanie HTML i ekstrakcję danych
- Używaj precyzyjnych selektorów: Unikaj
$('body *')— wybieraj tylko to, czego potrzebujesz. - Strumieniuj duże strony: Przy ogromnym HTML rozważ streaming albo podział zadania na części.
- Cache’uj renderowany HTML: Jeśli wracasz do tych samych URL-i, zapisuj HTML, by nie wykonywać zbędnych żądań.
- Waliduj i czyść dane: Korzystaj z bibliotek walidacyjnych, aby nie zapełniać bazy śmieciowymi rekordami (ScrapeGraphAI).
Skalowalne wdrożenie scrapera Node.js w chmurze
Scraping na dużą skalę? Czas przejść do chmury.
- Zrób z scrapera kontener Docker: przygotuj
Dockerfile, skopiuj kod, zainstaluj zależności i ustaw punkt startowy. - Wdróż do chmury: Do prostych zadań użyj AWS EC2, Google Cloud Compute albo maszyn wirtualnych Azure. Przy większej skali postaw na Kubernetes lub usługi zarządzane, takie jak AWS ECS/EKS, Google Cloud Run czy Azure Kubernetes Service (DigitalOcean).
- Orkiestracja w Kubernetes: Uruchamiaj wiele podów, skaluj automatycznie zależnie od obciążenia i rozdzielaj adresy URL przez load balancer.
- Harmonogram zadań: Używaj schedulerów chmurowych (CloudWatch Events, Cloud Scheduler) albo cronów do uruchamiania scrapingu w określonych odstępach.
W jednym z realnych przykładów przejście z 5 do 10 podów Kubernetes skróciło scraping 400 stron z kilku minut do mniej niż minuty (DigitalOcean).
Monitorowanie i autoskalowanie infrastruktury scrapingowej
- Logowanie: Przesyłaj logi do CloudWatch, Stackdriver albo Datadog. Ustaw alerty na błędy i spowolnienia.
- Kontrola zdrowia: Używaj Prometheus i Grafana do monitorowania takich metryk jak liczba stron na minutę, poziom błędów i kondycja podów.
- Autoskalowanie: Skonfiguruj Kubernetes HPA (Horizontal Pod Autoscaler), aby skalować pody na podstawie CPU lub liczby requestów.
Zawsze wdrażaj ponawianie z wykładniczym backoffem, żeby odzyskiwać działanie po chwilowych problemach z siecią albo tymczasowych blokadach.
Najlepsze praktyki przechowywania i przetwarzania danych po scrapingu
Gdy dane są już zebrane, trzeba je jeszcze dobrze zapisać i oczyścić:
- Małe zadania: Eksport do CSV, JSON albo wysyłka do Google Sheets, Airtable lub Notion (Thunderbit robi to od razu po instalacji).
- Duże zadania: Użyj SQL (MySQL/PostgreSQL) dla danych strukturalnych albo NoSQL (MongoDB, DynamoDB) dla danych półstrukturalnych lub schematów, które się zmieniają (ScrapeHero).
- Przechowywanie w chmurze: S3 lub Google Cloud Storage na surowe pliki i kopie zapasowe.
- Czyszczenie danych: Zawsze waliduj pola, normalizuj formaty (daty, liczby) i usuwaj duplikaty. Korzystaj z walidatorów schematów, aby utrzymać jakość danych (ScrapeGraphAI).
Przechowuj zarówno dane surowe, jak i oczyszczone — nigdy nie wiadomo, kiedy trzeba będzie coś przetworzyć jeszcze raz albo zdebugować.
Podsumowanie: kluczowe wnioski dotyczące efektywności web scrapingu w Node.js
Omiń pisanie kodu do scrapingu Zobacz, jak agentowy web scraper Thunderbit wypada na tle samodzielnego pisania i utrzymywania własnych skryptów do scrapingu. Get Started Free
Na koniec najważniejsze rzeczy:
- Wykorzystuj asynchroniczną moc Node.js do masowego scrapingu z dużą współbieżnością — szczególnie na stronach ciężkich od JavaScript.
- Łącz odpowiednie narzędzia: używaj axios/got do requestów, Cheerio do statycznego HTML, Puppeteer do dynamicznej treści i mieszaj je, aby uzyskać szybkość oraz elastyczność.
- Unikaj pułapek antybotowych: rotuj proxy i nagłówki, symuluj ludzkie zachowanie i respektuj robots.txt.
- Uprość pracę z Thunderbit: dla użytkowników biznesowych lub szybkiego prototypowania Thunderbit pozwala wyciągać złożone dane z pomocą AI i podłączać je do stacku Node.js przez API.
- Wdrażaj na dużą skalę: konteneryzuj, orkiestruj w Kubernetes i monitoruj wszystko pod kątem niezawodności.
- Przechowuj i czyść dane: wybierz odpowiednie miejsce składowania do swoich potrzeb i zawsze waliduj dane przed użyciem.
Sieć nie staje się prostsza, ale dzięki tym praktykom Twoje scrapery Node.js mogą pozostać szybkie, niezawodne i zawsze o krok przed wyścigiem z systemami antybotowymi. A jeśli kiedyś znudzi Ci się debugowanie selektorów o 2 w nocy, pamiętaj: AI Thunderbit jest zawsze na czuwaniu.
Chcesz dowiedzieć się więcej? Zajrzyj na Thunderbit Blog, aby przeczytać kolejne dogłębne poradniki, albo wypróbuj rozszerzenie Thunderbit do Chrome, żeby zobaczyć, jak proste może być scrapowanie.
Scrapuj z agentowym web scraperem Thunderbit API Web Scraper Thunderbit pozwala uruchamiać ekstrakcję z własnego kodu Node.js, a darmowy plan pozwala zacząć bez kosztów. Get Started Free
FAQ
1. Dlaczego Node.js jest szczególnie dobry do web scrapingu w 2025 roku?
Asynchroniczny, oparty na zdarzeniach model Node.js pozwala obsługiwać tysiące równoczesnych żądań, dzięki czemu świetnie nadaje się do zbierania dużych wolumenów danych albo aktualizacji w czasie rzeczywistym. Ogromny ekosystem npm i natywne wsparcie JavaScript są idealne dla nowoczesnych stron mocno opartych na JS (Node.js Docs).
2. Jak uniknąć blokady podczas scrapingu w Node.js?
Korzystaj z rotujących proxy, losuj nagłówki żądań, ograniczaj tempo requestów losowymi opóźnieniami i symuluj ludzkie zachowania — ruch myszy, przewijanie, pisanie — przy użyciu narzędzi takich jak Puppeteer. Zawsze respektuj robots.txt i regulaminy stron (Medium).
3. Kiedy używać Cheerio, a kiedy Puppeteer w scraperze Node.js?
Cheerio sprawdza się do szybkiego parsowania statycznego HTML, gdy dane są już obecne w surowym kodzie strony. Puppeteer jest lepszy dla serwisów, które ładują treść dynamicznie przez JavaScript. Najlepszy rezultat daje często najpierw renderowanie strony w Puppeteerze, a potem parsowanie HTML w Cheerio (Bright Data).
4. Jak Thunderbit upraszcza web scraping w Node.js?
Thunderbit pozwala wyciągać uporządkowane dane z dowolnej strony za pomocą AI i poleceń w naturalnym języku — bez kodowania. Obsługuje dynamiczną treść, podstrony i paginację, a także oferuje API do integracji z Node.js. Dane można eksportować bezpośrednio do Excel, Google Sheets, Airtable lub Notion (Thunderbit Blog).
5. Jaki jest najlepszy sposób na skalowanie i monitorowanie scraperów Node.js w chmurze?
Konteneryzuj scraper, wdrażaj go na Kubernetesie lub w zarządzanych usługach chmurowych i używaj autoskalowania, aby radzić sobie ze skokami obciążenia. Monitoruj logi i metryki za pomocą narzędzi takich jak CloudWatch czy Prometheus oraz konfiguruj alerty na błędy i spowolnienia (DigitalOcean).
Gotowy, by wejść poziom wyżej w web scrapingu? Wypróbuj Thunderbit i spraw, by Twoje scrapery były szybkie, dyskretne i zawsze o krok przed konkurencją.
Wypróbuj agentowy web scraper Get Started Free
Dowiedz się więcej
- Jak opanować web scraping w Node dla początkujących: przewodnik krok po kroku
- Jak efektywnie zbierać dane ze stron internetowych za pomocą najlepszych narzędzi
- Jak skutecznie crawlować stronę internetową: przewodnik krok po kroku
- Jak opanować crawlowanie w JavaScript: przewodnik dla początkujących
- Jak opanować web scraping do porównywania cen w 2026 roku




