Baidu 検索結果・記事用スクレイパー








Baidu の検索結果を、見やすく使いやすいデータに変換
検索結果と取得できる記事情報を、1つのわかりやすい表にまとめます。
収集しながら Baidu データを整理
Thunderbit は、見えているタイトル、URL、スニペット、日付、ソースを見やすい列に配置します。結果に項目が表示されていない場合、そのセルは空欄のままです。

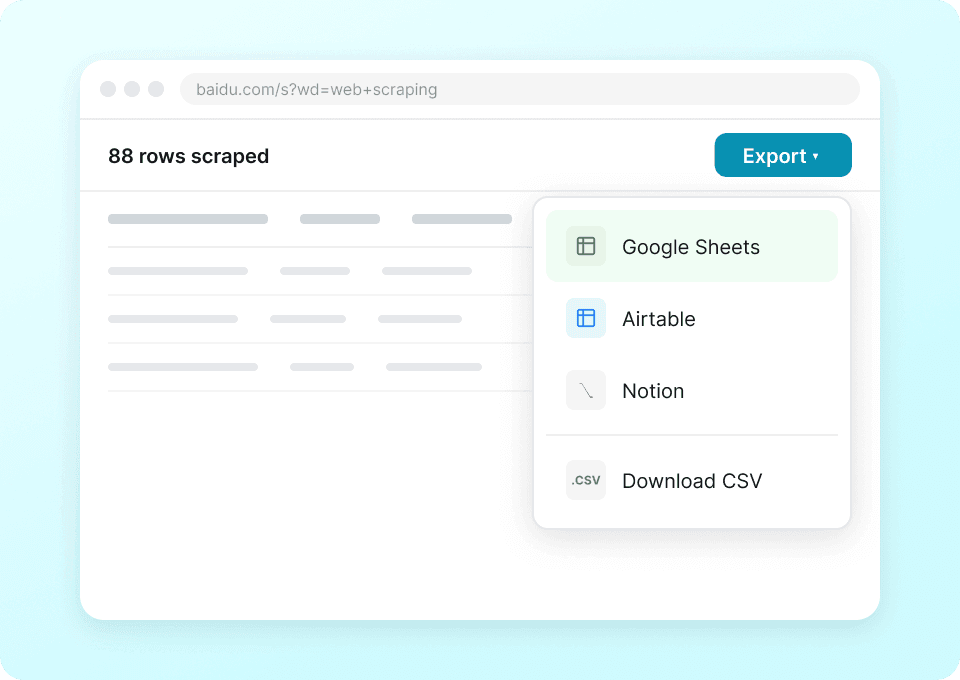
Baidu の調査結果をワンクリックでエクスポート
各実行結果を検索結果レビュー用のシートに送れます。順位、ソース、日付、リンク先ページの詳細が、対応する Baidu の結果の横にそのまま並びます。
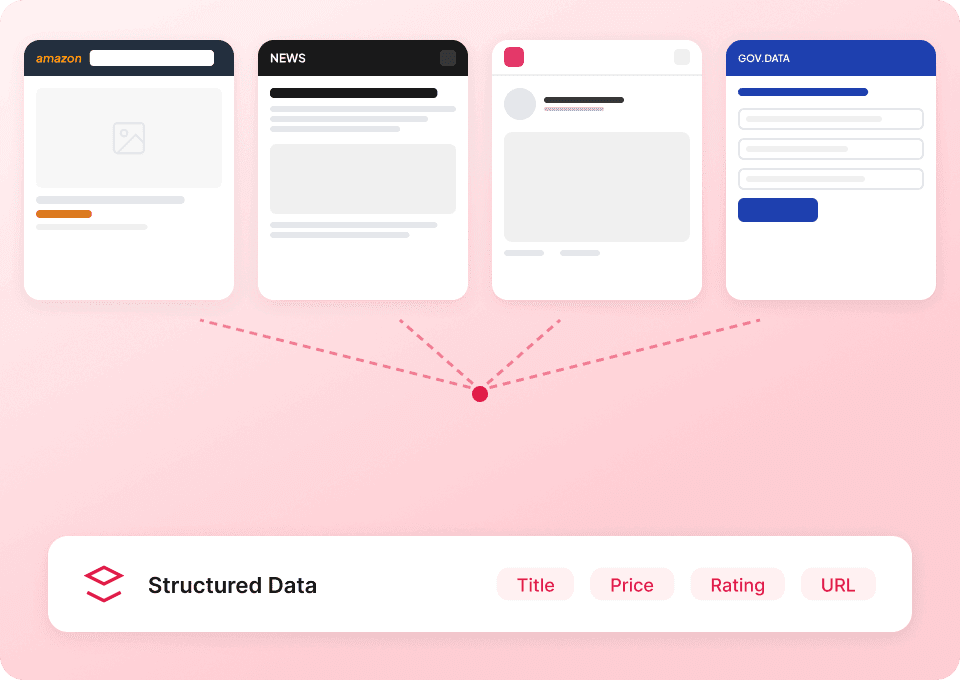
同じワークフローをあらゆるサイトで活用
Thunderbit は、Baidu 固有のレイアウトではなく、意味に基づいて項目を読み取ります。調査先が別の公開サイトに広がっても、同じ方法で利用できます。
Baidu の各結果の文脈をそのまま残す
リンク一覧だけでは文脈が失われます。Thunderbit は、表示されている詳細を各結果の横にまとめて保持します。
コピーしたリンクとメモだけの管理
結果の情報が分断されてしまう構造化された Baidu 調査
表示された文脈が各結果に紐づいたまま残るBaidu からどんなデータを抽出できますか?
公開されていて画面上に表示される項目から選べます。結果モジュールやリンク先ページでは、クエリごとにすべての項目が表示されるわけではありません。
- 検索クエリ
- 結果順位
- 結果タイトル
- 結果URL
- 表示URL
- 結果スニペット
- 結果日付
- 結果サイトアイコン
- 関連検索キーワード
- スペル修正候補
- ピンイン候補
- 検索結果ページ番号
- ソースサイト
- ソースドメイン
- 記事著者
- 記事公開日
- 記事要約
- 文書名
- 文書説明
- 文書パンくず
- 文書ジャンル
- 文書ファイル形式
- 文書ページ数
- 文書アップロード時刻
- 文書URL
- 結果コンテンツタイプ
- 画像サムネイル
- 動画サムネイル
- 所在地住所
- Baidu 機能モジュール
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.




Baidu の検索データ収集に関する質問
利用できる項目は、クエリ、結果タイプ、リンク先ページに表示される情報によって異なります。
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Flixster スクレイパー
ThunderbitのFlixsterスクレイパーを使えば、Flixsterの興行収入ランキングや近隣の劇場データを手軽に取得できます。AIによるフィールド提案機能で、映画タイトル、興行収入、評価、公開日、劇場名、所在地、上映中の映画などを素早く収集し、分析やリサーチに活用できます。
詳しく見る ->
olympustaff.com スクレイパー
Thunderbitのolympustaff.com スクレイパーを使えば、olympustaff.comのコミック一覧やコメントからデータを抽出できます。AIによるフィールド提案機能で、コミックのタイトル、著者、発売日、読者のフィードバックなどを素早く収集し、分析やリサーチに活用可能。マーケター、リサーチャー、コンテンツ制作者に最適な、olympustaff.comの構造化データ取得ツールです。
詳しく見る ->
Hatena スクレイパー
Thunderbitのはてなスクレイパーは、AIによるフィールド自動提案機能で、はてなブログやトピックリストからデータを簡単に抽出できます。ブログタイトル、著者名、公開日、記事要約、トレンドトピックなどを収集でき、リサーチやマーケティング、コンテンツ分析に最適です。マーケター、リサーチャー、コンテンツ制作者が、はてなの構造化データを効率よく取得したいときにおすすめです。
詳しく見る ->
namu.wiki スクレイパー
Thunderbitのnamu.wiki スクレイパーを使えば、namu.wikiから必要なページや最新ディスカッションのデータを抽出できます。AIによるフィールド提案機能で、ページタイトル、URL、最終編集日、ディスカッションテーマ、参加者名などを素早く収集でき、リサーチやコンテンツ制作、コミュニティ分析に役立ちます。
詳しく見る ->
NetEase Music スクレイパー
ThunderbitのNetEase Music スクレイパーは、NetEase Musicの検索結果やアーティスト作品ページからデータを抽出できます。AIによるフィールド提案機能で、曲名、アーティスト名、アルバム詳細、再生時間、楽曲URLなどを素早く収集可能。音楽分析やマーケティング、リサーチに最適な、構造化されたNetEase Musicデータを手軽に取得できます。
詳しく見る ->
QQミュージックスクレイパー
ThunderbitのQQ音楽スクレイパーは、QQ音楽の検索結果やアーティストの作品リストからデータを抽出できます。AIによるフィールド提案機能で、曲名やアーティスト名、アルバム情報、リリース日などを素早く収集し、分析やリサーチに活用可能。音楽アナリストやマーケター、音楽ファンに最適な、構造化されたQQ音楽データ取得ツールです。
詳しく見る ->データ抽出を一気に加速する準備はできた?
すでに20万人以上のプロがThunderbitでWebスクレイピング業務を自動化しています。
無料トライアルでは8ページ分の無制限クレジットを利用できます。



