
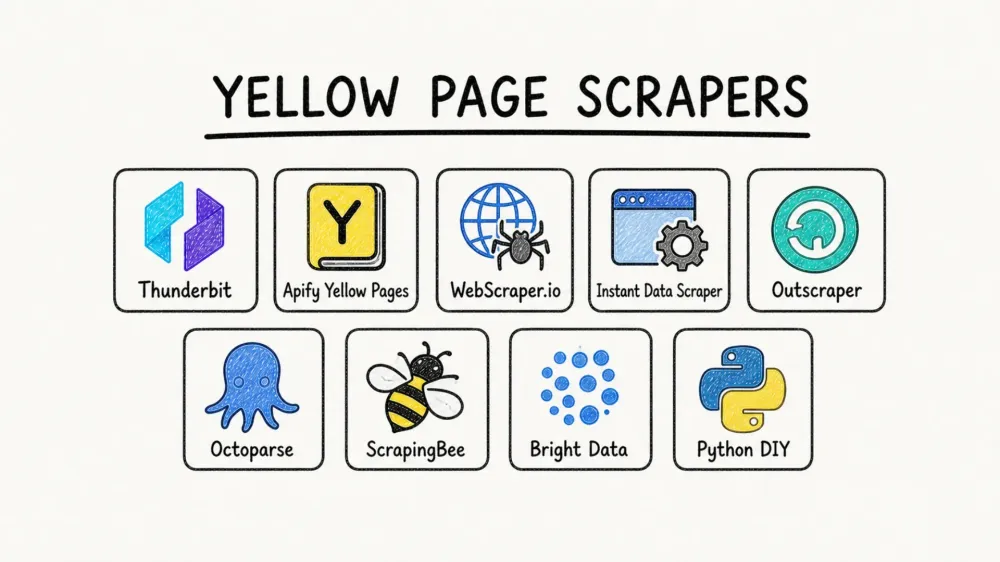
Tous les deux ou trois mois, quelqu’un poste sur Reddit une plainte à peu près identique : « J’ai extrait Yellow Pages et j’ai obtenu 500 lignes de numéros de téléphone et d’adresses… mais zéro e-mail. » C’est de loin la frustration que je vois le plus souvent dans les communautés de prospection, et après des années à construire des outils d’automatisation chez Thunderbit, je peux vous dire que le problème est structurel, pas un simple accident.
La plupart des extracteurs Yellow Pages récupèrent ce qui est visible sur la page de résultats — nom de l’entreprise, téléphone, adresse, parfois un lien vers le site web. Mais les e-mails ? Ils sont presque jamais affichés sur la fiche de résultat. Ils sont soit cachés dans les pages détaillées de chaque entreprise, soit tout simplement absents de Yellow Pages.
Si votre extracteur ne va pas explorer ces sous-pages, vous ratez la donnée de contact la plus précieuse. Cet article passe en revue 9 outils que j’ai étudiés et évalués selon leur vraie capacité à récupérer des e-mails depuis Yellow Pages — pas seulement des numéros de téléphone et des codes postaux. Je vais aussi couvrir la gestion anti-bot, les tarifs, et le type d’utilisateur auquel chaque outil convient.
Pourquoi la plupart des extracteurs Yellow Pages échouent à récupérer des e-mails
Avant d’entrer dans le détail des outils, il faut comprendre pourquoi ce problème existe dès le départ.
Les pages de résultats Yellow Pages sont pensées autour des numéros de téléphone, des adresses, des horaires d’ouverture et des liens vers les sites web. L’e-mail n’est pas un champ standard de la fiche de résultat. La documentation des extracteurs et les exemples de pages le montrent constamment : l’e-mail est généralement absent de la fiche de résultat et doit être trouvé soit sur la page détaillée de l’entreprise, soit sur son propre site.
L’extracteur ParseBird Yellow Pages d’Apify est particulièrement clair là-dessus. Il sépare explicitement le « mode liste » du « mode détail » et indique que le taux de récupération d’e-mails tourne généralement autour de 15 à 25 % des fiches, même quand l’extraction des pages détaillées est activée. Autrement dit, même dans le meilleur des cas, récupérer des e-mails sur Yellow Pages reste limité — et la plupart des outils ne tentent même pas de le faire.
Il y a trois échecs fréquents :
- L’extracteur lit uniquement la page de résultats. Pas de visite des sous-pages, donc pas d’e-mail.
- L’extracteur va sur la page détaillée mais n’analyse pas les champs e-mail. Toujours pas d’e-mail.
- L’entreprise n’a jamais publié d’e-mail sur Yellow Pages. Aucun outil ne peut extraire ce qui n’existe pas.
Certaines entreprises orientent aussi le contact via des formulaires ou des boutons « Email Business » plutôt que d’afficher une adresse e-mail brute. Un extracteur peut donc très bien fonctionner techniquement tout en vous renvoyant un résultat composé à 95 % de numéros et d’adresses.
À retenir : si l’extraction d’e-mails compte vraiment pour vous, la fonctionnalité clé à chercher est l’extraction de sous-pages — la capacité à visiter chaque fiche détaillée et à récupérer des données qui ne figurent pas sur la liste principale.
Ce qu’il faut rechercher dans les meilleurs extracteurs Yellow Pages
J’ai évalué les 9 outils selon sept critères, tous basés sur des problèmes bien réels remontés dans des discussions Reddit, des forums de scraping et des communautés de lead gen.
Fiabilité de l’extraction d’e-mails
C’est le cœur du sujet ici. L’outil renvoie-t-il vraiment des adresses e-mail, ou seulement des noms et des numéros de téléphone ? La capacité essentielle, c’est l’extraction de sous-pages — visiter chaque fiche d’entreprise pour trouver les e-mails cachés de la carte de résultat.
Gestion des protections anti-bot et des blocages
Yellow Pages utilise Cloudflare Bot Management, avec rendu JavaScript, empreintes navigateur, limitation de débit et CAPTCHA. Un test en direct que j’ai effectué le 27 avril 2026 a renvoyé une page de blocage Cloudflare en quelques secondes. Les outils qui ne gèrent pas ça nativement vous laisseront face à des pages d’erreur.
Tarifs et existence d’une offre gratuite
Plusieurs utilisateurs Reddit demandent explicitement « des extracteurs gratuits ou bon marché, idéalement ». Il existe un vrai fossé entre les extensions navigateur totalement gratuites, les outils cloud avec crédits de départ et les plateformes enterprise avec tarifs sur mesure.
Prise en charge de la pagination
Yellow Pages affiche environ 30 résultats par page, et les recherches larges peuvent retourner 500 à 2 000+ résultats. Un extracteur sans pagination automatique ne récupère qu’une petite partie des données disponibles.
Options d’export
Les équipes commerciales ont besoin d’exports compatibles CRM : CSV, Excel, Google Sheets, Airtable. Certains outils ne sortent que du JSON ou du HTML brut, ce qui impose une étape de traitement avant que la donnée soit exploitable.
Niveau technique requis
Le public est partagé. Les commerciaux et les responsables d’agence veulent des outils en deux clics. Les développeurs veulent un accès API et de la souplesse Python. J’ai noté chaque outil de Débutant à Expert.
Scoring des leads et enrichissement des données
Comme l’a dit un utilisateur Reddit : « des données brutes sans scoring, ce n’est qu’un tableur. » Les outils capables d’étiqueter, de classer ou d’enrichir les données pendant l’extraction font gagner des heures de post-traitement.
Aperçu rapide des meilleurs extracteurs Yellow Pages
Le comparatif complet des 9 outils est ci-dessous. Pour lire les symboles : ✅ signifie que l’outil gère bien cette fonctionnalité nativement, ⚠️ signifie que c’est possible mais avec une configuration supplémentaire ou certaines limites, et ❌ signifie que l’outil ne le prend pas en charge nativement.
| Outil | Type | Offre gratuite | E-mails ? | Anti-bot | Pagination | Niveau | Formats d’export | Idéal pour |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Extension Chrome + cloud | ✅ (6 pages/mois) | ✅ (sous-pages + extracteur d’e-mails) | ✅ Bascule cloud/navigateur | ✅ Automatique | Débutant | Excel, CSV, JSON, Sheets, Airtable, Notion | Équipes commerciales et ops non techniques |
| Apify YP Scraper | Actor cloud | ✅ (5 $ de crédits) | ⚠️ 15–25 % avec pages détaillées | ✅ Pool de proxy | ✅ Intégré | Intermédiaire | JSON, CSV, Excel, XML | Scraping cloud à grande échelle |
| WebScraper.io | Extension Chrome + cloud | ✅ (extension gratuite) | ⚠️ Configuration manuelle | ✅ Offres cloud | ✅ Basé sur des sélecteurs | Intermédiaire | CSV, XLSX, JSON, Sheets | Utilisateurs de scrapers visuels |
| Instant Data Scraper | Extension Chrome | ✅ Totalement gratuit | ❌ Peu fiable | ❌ Aucun | ⚠️ Manuel | Débutant | CSV, XLSX | Extractions ponctuelles rapides |
| Outscraper | API/Cloud | ✅ (500 entreprises) | ⚠️ Enrichissement nécessaire | ✅ Géré | ✅ Automatique | Débutant–Intermédiaire | CSV, JSON, XLSX | Projets de répertoires à petit budget |
| Octoparse | Application desktop + cloud | ✅ (10 tâches, 50K/mois) | ⚠️ Basé sur des modèles | ✅ Intégré | ✅ Détection auto | Intermédiaire | CSV, Excel, JSON, DB | Scraping visuel sur desktop |
| ScrapingBee | API | ✅ (1 000 appels) | ❌ HTML brut uniquement | ✅ Géré | ❌ Manuel | Avancé | JSON, HTML | Développeurs ayant besoin de HTML rendu |
| Bright Data | Plateforme | ✅ (5K enregistrements/mois) | ✅ Produits data | ✅ Niveau enterprise | ✅ Intégré | Avancé | JSON, CSV, NDJSON, S3, etc. | Grande échelle enterprise |
| Python DIY | Code | ✅ Gratuit (open source) | ⚠️ Parsing manuel | ❌ Géré par vous | ❌ Manuel | Expert | Tous formats | Ingénieurs avec besoins sur mesure |
1. Thunderbit — Le meilleur extracteur Yellow Pages pour les équipes non techniques

Essayer Thunderbit pour le scraping de Yellow Pages
Thunderbit est une extension Chrome dopée à l’IA que mon équipe et moi avons créée précisément pour rendre le scraping accessible aux non-développeurs. Au lieu de configurer des sélecteurs CSS ou d’écrire du code, vous cliquez une fois et l’IA lit la page, repère les données disponibles et les extrait sans vous faire attendre. Ou, si vous savez déjà exactement ce que vous voulez, décrivez-le simplement à l’IA et elle travaille à partir de vos instructions. C’est tout — un clic pour obtenir des données structurées.
Pour Yellow Pages en particulier, le workflow s’attaque directement au problème des e-mails. Après l’extraction de la page de résultats, vous pouvez prolonger l’extraction vers les sous-pages, et Thunderbit visite chaque fiche détaillée pour récupérer les e-mails, URL de site web, horaires, avis et autres champs invisibles sur la carte principale. Nous avons aussi créé un Extracteur d’Email et un Extracteur de Numéro de Téléphone dédiés, utilisables comme outils autonomes en un seul clic.
Comment Thunderbit gère l’extraction d’e-mails depuis Yellow Pages
Le vrai élément différenciant, c’est l’extraction de sous-pages. La plupart des scrapers s’arrêtent à la page de résultats et renvoient ce qui est visible — ce qui, sur Yellow Pages, veut dire aucun e-mail. La fonction de sous-pages de Thunderbit visite chaque profil d’entreprise et récupère les données de ce niveau plus profond. Vous pouvez aussi utiliser le Field AI Prompt pour ajouter des consignes comme « extraire l’e-mail depuis la section contact » ou « signaler les entreprises sans site web » afin d’améliorer la précision et d’ajouter du contexte pendant l’extraction.
D’après les structures de pages et la documentation des extracteurs actuels, les e-mails sur les cartes Yellow Pages sont en pratique inexistants. Les extracteurs de pages détaillées comme la fonction de sous-pages de Thunderbit récupèrent des e-mails pour environ 15 à 25 % des entreprises — ce qui correspond au plafond réaliste de récupération d’e-mails sur Yellow Pages en 2026. Ce n’est pas une limite de Thunderbit ; c’est une limite des données Yellow Pages.
Gestion anti-bot et pagination
Thunderbit propose deux modes d’extraction : scraping cloud (via des serveurs US/EU/Asie avec rotation automatique de proxy) et scraping navigateur (qui utilise votre session locale). Si le mode cloud est bloqué par Cloudflare, vous pouvez basculer en mode navigateur comme solution de secours — votre session authentifiée contourne souvent des protections qui bloquent les requêtes cloud headless.
La pagination est entièrement automatique. Thunderbit gère aussi bien les boutons « Suivant » que le défilement infini, sans configuration.
Tarifs et export
- Offre gratuite : 6 pages par mois
- Essai gratuit : 10 pages
- Formule Starter : à partir d’environ 9 $/mois facturés à l’année pour 500 crédits (1 crédit = 1 ligne)
- Export : Excel, CSV, JSON disponibles sur l’offre gratuite ; intégrations Google Sheets, Airtable et Notion sur les formules payantes
Vous pouvez consulter les derniers détails sur notre page tarifs.
Idéal pour : commerciaux, agences et équipes ops qui ont besoin rapidement de données de leads sans coder ni gérer des proxys.
2. Apify Yellow Pages Scraper — Le meilleur pour le scraping cloud à grande échelle
 Apify est une plateforme de scraping cloud avec une place de marché d’« actors » prêts à l’emploi — dont plusieurs sont conçus spécialement pour Yellow Pages. Vous configurez votre extraction dans la console Apify (mot-clé, localisation, nombre de résultats), et elle s’exécute dans le cloud sans navigateur local ni machine dédiée.
L’actor ParseBird Yellow Pages est le plus transparent que j’ai trouvé sur l’extraction d’e-mails. Il sépare explicitement le mode liste du mode détail et documente un rendement d’e-mails généralement de 15 à 25 % des fiches lorsque les pages détaillées sont activées. L’extraction en mode détail coûte environ 6 $ pour 1 000 entreprises contre 1 $ pour 1 000 en mode liste — ce qui reflète directement le calcul supplémentaire nécessaire pour visiter chaque sous-page.
- Pool de proxy inclus avec support des proxys résidentiels
- Pagination intégrée pour les résultats multi-pages
- Export : JSON, CSV, Excel, XML, HTML, RSS, JSONL
- Tarifs : offre gratuite avec 5 $ de crédits ; formules payantes à 29 $, 199 $ et 999 $/mois
Idéal pour : utilisateurs intermédiaires à avancés qui mènent des campagnes de lead gen plus volumineuses sur plusieurs villes ou catégories.
3. WebScraper.io — Le meilleur pour créer des sitemaps Yellow Pages sur mesure
 WebScraper.io propose une extension Chrome avec un assistant visuel « Sitemap Wizard » qui détecte automatiquement la structure des listes sur Yellow Pages. C’est l’outil derrière l’un des tutoriels Yellow Pages les mieux référencés, et ce n’est pas un hasard : il offre un contrôle très fin sur ce qui est extrait et sur la manière dont c’est fait.
Le compromis, c’est que ce contrôle demande de la configuration. L’extraction d’e-mails n’est pas automatique ; vous devez configurer manuellement des sélecteurs pour cibler les champs e-mail et faire en sorte que le scraper suive les liens vers les pages détaillées des entreprises. Bien configuré, l’outil fonctionne. Sinon, vous obtiendrez le même résultat téléphone-adresse que tous les autres.
Les notes de la place de marché WebScraper.io sont aussi remarquablement franches sur les défenses de Yellow Pages : elles mentionnent Cloudflare Bot Management, le rendu JavaScript et les empreintes navigateur comme obstacles précis.
- Pagination : prise en charge via configuration du bouton « Suivant » basée sur des sélecteurs
- Export : CSV, XLSX, JSON ; la version cloud ajoute Google Sheets, Dropbox, S3, Azure, API, webhooks
- Tarifs : extension Chrome gratuite ; offres cloud à partir de 50 $/mois
Idéal pour : utilisateurs à l’aise avec les outils de sélection point-and-click et qui veulent pouvoir personnaliser la structure de leur scraping.
4. Instant Data Scraper — Le meilleur extracteur Yellow Pages gratuit (avec réserves)
 Instant Data Scraper est la réponse à la question : « Que puis-je essayer tout de suite, gratuitement ? » C’est une extension Chrome entièrement gratuite — pas de compte, pas de crédits, pas de limites — qui détecte automatiquement les données tabulaires sur les pages web. Ouvrez une page de résultats Yellow Pages, cliquez sur l’icône de l’extension et elle détecte les données de listing.
Le problème, c’est tout ce qu’elle ne fait pas. Elle scrape ce qui est visible sur la page, donc pas de visite des sous-pages et pas d’extraction d’e-mails dans la plupart des usages réels. Elle n’a aucune gestion anti-bot, donc si Yellow Pages affiche un CAPTCHA ou bloque votre IP, vous êtes coincé. La pagination est basique — il faudra souvent cliquer manuellement sur « Suivant » ou compter sur un auto-scroll limité.
- Export : CSV, XLSX
- Tarifs : gratuit à vie
Idéal pour : débutants qui veulent une extraction rapide et gratuite d’une page de résultats et qui n’ont pas besoin d’e-mails. Pas adapté aux campagnes centrées sur l’e-mail ni à la génération de leads à grande échelle.
5. Outscraper — La meilleure API gérée pour Yellow Pages et Google Maps
 Outscraper est une plateforme cloud/API avec une infrastructure gérée pour scraper des annuaires comme Yellow Pages et Google Maps. Sa promesse est simple : vous n’avez pas à gérer les proxys, la logique anti-bot ni la pagination.
Pour Yellow Pages, les 500 premières entreprises sont gratuites, puis le tarif est d’environ 1 $ pour 1 000 entreprises. L’extraction d’e-mails depuis Yellow Pages se limite à ce qui est présent sur la page ; pour un enrichissement plus poussé, Outscraper propose des fonctionnalités d’enrichissement séparées que vous pouvez combiner avec l’extraction de base.
Là où Outscraper se distingue, c’est sur la prise en charge multi-annuaires. Si vous scrapez Yellow Pages et Google Maps pour la même campagne, vous pouvez tout gérer depuis une seule plateforme.
- Pagination automatique incluse
- Export : CSV, JSON, XLSX, API
- Tarifs : offre gratuite (500 entreprises) ; paiement à l’usage au-delà
Idéal pour : équipes ops commerciales qui veulent un scraping fiable, sans gestion technique, sur plusieurs annuaires.
6. Octoparse — La meilleure application desktop pour le scraping visuel de Yellow Pages
 Octoparse est une application desktop (Windows/Mac) avec un constructeur de workflow visuel en point-and-click. Elle propose des modèles prêts à l’emploi pour Yellow Pages et des sites d’annuaires similaires, ainsi que des fonctions anti-bot intégrées, dont la rotation d’IP, les proxys résidentiels et la résolution automatique de CAPTCHA.
L’extraction d’e-mails dépend du modèle. Lorsque le modèle est configuré pour visiter les pages détaillées ou les sites web liés, il peut récupérer des e-mails. Mais les modèles peuvent casser lorsque Yellow Pages modifie sa structure, et les utilisateurs signalent des résultats variables selon la catégorie et la zone géographique.
- Offre gratuite : 10 tâches, 50 000 exports par mois
- Détection automatique de la pagination
- Export : CSV, Excel, JSON, HTML, XML, bases de données, Google Sheets, API
- Tarifs : offre gratuite ; formules payantes pour l’exécution cloud
Idéal pour : utilisateurs intermédiaires qui préfèrent une application desktop avec un workflow visuel et qui acceptent un peu de réglage des modèles.
7. ScrapingBee — La meilleure API pour les développeurs qui ont besoin de HTML rendu
 ScrapingBee est un service de scraping web orienté API. Il gère le rendu JavaScript, la rotation de proxies et la résolution de CAPTCHA — puis renvoie du HTML brut, du JSON ou du Markdown. Il n’extrait pas les e-mails ni les champs structurés nativement. C’est à vous de le faire.
Le tutoriel Yellow Pages de ScrapingBee montre une pagination manuelle en ajoutant &page=n à l’URL, ce qui confirme qu’il s’agit d’un outil pour développeurs, pas d’une solution point-and-click.
- Offre gratuite : 1 000 crédits API
- Pas de pagination ni d’extraction de champs intégrées
- Export : JSON, HTML
- Tarifs : à partir de 49 $/mois
Idéal pour : développeurs qui ont besoin d’un HTML rendu fiable avec gestion anti-bot et qui sont à l’aise pour écrire leur propre logique d’analyse.
8. Bright Data — La meilleure plateforme enterprise pour le scraping à grande échelle
 Bright Data exploite le plus grand réseau de proxys du secteur et propose une suite complète d’API de scraping, d’outils navigateur et de jeux de données prêts à l’emploi. La solution est pensée pour les organisations qui ont besoin de collecter énormément de données avec des fonctions de conformité.
Pour Yellow Pages en particulier, le point fort de Bright Data, c’est l’infrastructure — proxys résidentiels, résolution de CAPTCHA, défense contre l’empreinte navigateur, ainsi que la livraison en aval vers JSON, CSV, NDJSON, S3, Snowflake, GCS, Azure et SFTP. Je n’ai pas trouvé de modèle Yellow Pages spécifique documenté à ce jour ; le positionnement ici est donc celui d’une plateforme enterprise, pas d’un produit dédié aux e-mails YP.
- Tarifs : l’API Web Scraper inclut une offre gratuite de 5 000 enregistrements/mois, puis 1,50 $ pour 1 000 enregistrements en paiement à l’usage ; 499 $/mois à grande échelle
- Pagination intégrée pour tous les outils de scraping
Idéal pour : grandes entreprises ou agences avec de gros budgets data qui ont besoin d’échelle, de conformité et d’une infrastructure de proxy robuste.
9. Python DIY (BeautifulSoup + Playwright) — Le meilleur pour un contrôle total
 C’est l’option open source : BeautifulSoup pour l’analyse HTML et Playwright pour l’automatisation du navigateur. Des bibliothèques gratuites, une flexibilité maximale, et le niveau technique le plus élevé de cette liste.
L’extraction d’e-mails exige d’écrire une logique de parsing personnalisée pour visiter chaque page détaillée d’entreprise et repérer les champs e-mail. La rotation des proxys, la gestion des CAPTCHA, la limitation de débit et la pagination doivent tous être implémentés ou achetés séparément. Comme l’a dit un utilisateur Reddit : « Une fois que tu as essayé Playwright, tu ne reviens jamais à Selenium » — mais tu ne cesseras pas non plus de déboguer ta config de proxy.
- Tarifs : gratuit (bibliothèques open source) ; coûts d’infrastructure en supplément
- Export : n’importe quel format que vous codez
- Aucun élément intégré — tout est à construire vous-même
Idéal pour : développeurs experts avec des besoins de scraping spécifiques qu’aucun outil prêt à l’emploi ne couvre, et à l’aise pour gérer l’infrastructure de bout en bout.
Ce qui se passe vraiment quand Yellow Pages vous bloque (réalité anti-bot)
Je veux m’arrêter un instant là-dessus, parce que c’est le problème n°1 en nombre de mentions dans les communautés de scraping, et la plupart des articles le balayent d’un « utilisez des proxys ».
Quand j’ai testé une requête scriptée basique vers une URL de recherche Yellow Pages le 27 avril 2026, la réponse était une page de blocage Cloudflare : « Sorry, you have been blocked. This website is using a security service to protect itself from online attacks. » C’est arrivé dès la première requête. Aucun avertissement, aucun ralentissement progressif — juste un mur.
La pile anti-bot de Yellow Pages comprend Cloudflare Bot Management, le rendu JavaScript, les empreintes navigateur, la limitation de débit et reCAPTCHA. Le guide de scraping d’IPRoyal ajoute que les symptômes peuvent inclure des blocages durs, des bans silencieux, des CAPTCHA, des redirections vers des splash pages, du suivi de session et des limites de requêtes.
Le contexte global n’arrange rien. Le rapport 2025 d’Imperva a montré que le trafic automatisé représentait 51 % de tout le trafic internet en 2024, et le rapport 2025 de DataDome, basé sur près de 17 000 sites, a révélé que seulement 2,8 % étaient totalement protégés. Les sites comme Yellow Pages qui investissent dans la protection deviennent meilleurs pour détecter les scrapers, pas moins bons.
Voici un résumé pratique de la manière dont chaque outil gère cela :
| Outil | Rotation de proxy | Gestion des CAPTCHA | Résilience aux limites de débit | Solution de secours en cas de blocage |
|---|---|---|---|---|
| Thunderbit | ✅ Mode cloud avec serveurs US/EU/Asie | ✅ Gérée via le cloud | ✅ Auto-throttle | Basculer vers le scraping navigateur |
| Apify | ✅ Avec proxys résidentiels | ✅ Via l’infrastructure des actors/navigateur | ✅ Configurable | Réessayer avec un nouveau proxy |
| WebScraper.io | ✅ Offres cloud + option proxy | ✅ Offres cloud | ✅ Solide | Utiliser l’exécution cloud |
| Instant Data Scraper | ❌ Aucun | ❌ Aucun | ❌ Faible | Réessai manuel ou arrêt |
| Outscraper | ✅ Backend géré | ⚠️ Documentation limitée | ✅ Modérée | Le service géré s’en occupe |
| Octoparse | ✅ Incluant les proxys résidentiels | ✅ Résolution automatique des CAPTCHA | ✅ Solide | Modèles cloud + anti-blocage |
| ScrapingBee | ✅ Proxys gérés | ✅ Intégré | ✅ Solide | Ajuster le code, proxys premium |
| Bright Data | ✅ Niveau enterprise | ✅ Intégré | ✅ Très forte | Réglage complet de l’infra |
| Python DIY | ❌ Géré par vous uniquement | ❌ Géré par vous uniquement | ❌ Variable | Tout ce que vous construisez |
Au-delà des données brutes : transformer les extractions Yellow Pages en leads prêts pour le CRM
Je vois ce scénario tout le temps : quelqu’un extrait 500 fiches Yellow Pages, les exporte dans un tableur, puis passe trois heures à chercher manuellement les e-mails sur Google, vérifier les sites web et décider quels prospects méritent d’être contactés. L’extraction a pris 10 minutes. L’enrichissement a pris tout l’après-midi.
C’est de là que vient la remarque « des données brutes sans scoring, ce n’est qu’un tableur ». Un export Yellow Pages brut ressemble à ceci :
| Nom de l’entreprise | Téléphone | Adresse | Site web | Catégorie |
|---|---|---|---|---|
| Example Plumbing Co. | 555-0199 | 123 Main St | exampleplumbing.com | Plombiers |
| NoSite HVAC | 555-0112 | 456 Oak Ave | Aucun | CVC |
Un tableau de leads enrichi — celui qui est réellement utile pour la prospection — ressemble plutôt à ceci :
| Nom de l’entreprise | Téléphone | Adresse | Site web | Avis | Site web présent ? | Note prospect | |
|---|---|---|---|---|---|---|---|
| Example Plumbing Co. | 555-0199 | 123 Main St | exampleplumbing.com | info@exampleplumbing.com | 42 | Oui | Page contact disponible |
| NoSite HVAC | 555-0112 | 456 Oak Ave | Aucun | Aucun | 8 | Non | Prospect potentiel pour une agence |
Utiliser l’extraction de sous-pages pour enrichir les leads
L’extraction de sous-pages de Thunderbit visite chaque fiche détaillée et ajoute des champs comme l’e-mail, l’URL du site web, les horaires, les avis et les catégories. Pour une extraction de 500 fiches, cela fait la différence entre 10 minutes de travail automatisé et plus de 3 heures de recherche manuelle.
L’extraction en mode détail d’Apify fait quelque chose de similaire, mais à un coût plus élevé par enregistrement (environ 6 $ pour 1 000 entreprises contre 1 $ pour 1 000 en mode liste).
Étiqueter et catégoriser les leads pendant l’extraction
Le Field AI Prompt de Thunderbit vous permet d’ajouter des instructions pendant l’extraction elle-même — par exemple « signaler les entreprises sans site web » ou « catégoriser selon la taille de l’entreprise ». L’IA applique ces labels au moment de l’extraction, ce qui vous donne une liste de leads déjà qualifiée au lieu d’un simple dump brut.
Une nuance issue des recherches mérite d’être signalée : l’absence de site web ne veut pas toujours dire qu’une entreprise est un bon prospect. C’est un signal utile pour la prospection d’agence, mais ça ne doit pas être le seul critère de qualification.
Workflow export vers CRM
Le workflow le plus courant que je vois chez nos utilisateurs :
- Thunderbit → Google Sheets ou Airtable → CRM (export direct, sans étape intermédiaire)
- Apify → Webhook → CRM (nécessite un peu de configuration)
- Outscraper → téléchargement CSV → import CRM (manuel mais simple)
Si votre CRM s’intègre à Google Sheets ou Airtable, l’export direct de Thunderbit supprime complètement l’étape de téléchargement de fichier. Vous pouvez en savoir plus sur le web scraping sans coder sur notre blog.
Meilleur extracteur Yellow Pages selon le cas d’usage : guide de recommandation rapide
Tous les outils ne conviennent pas à tous les profils. Mes recommandations par type d’utilisateur :
Meilleur choix pour les commerciaux non techniques et les dirigeants d’agence : Thunderbit (scraping IA en 1 clic, extracteur d’e-mails gratuit, extraction de sous-pages) et Instant Data Scraper (gratuit, simple — mais sans e-mails)
Meilleur choix pour les opérations de génération de leads à grande échelle : Apify (actors cloud, campagnes multi-villes, extraction d’e-mails sur pages détaillées) et Outscraper (API gérée, support multi-annuaires)
Meilleure option totalement gratuite : Instant Data Scraper (entièrement gratuit à vie) et l’offre gratuite de Thunderbit (6 pages/mois avec fonctions IA)
Meilleur choix pour les développeurs : Python DIY avec Playwright (contrôle maximal) et l’API ScrapingBee (rendu géré + proxys)
Meilleur choix pour l’entreprise / grande échelle : Bright Data (plus grand réseau de proxys, fonctions de conformité, tarification enterprise)
Nous avons aussi publié un tour d’horizon des meilleurs web scrapers IA et un guide plus complet sur la génération de leads avec l’IA si vous voulez aller plus loin.
Yellow Pages vs Google Maps vs autres annuaires : quand utiliser quoi
La plupart des professionnels de la lead gen ne se contentent pas de scraper Yellow Pages tout seul. Ils croisent plusieurs annuaires. Voici une comparaison rapide basée sur la disponibilité actuelle des données :
| Critère | Yellow Pages | Google Maps | Facebook Business |
|---|---|---|---|
| Disponibilité de l’e-mail | Faible (pages détaillées uniquement) | Très faible (pas un champ standard) | Moyenne (les pages peuvent inclure un e-mail) |
| Numéros de téléphone | ✅ Toujours présents | ✅ Toujours présents | ⚠️ Parfois masqués |
| Avis/notes | ✅ Disponibles | ✅ Données plus riches | ✅ Disponibles |
| Catégories/niches | ✅ Fort sur les niches locales | ✅ Large et riche | ⚠️ Inconstant |
| Meilleur outil de scraping | Thunderbit, actor YP d’Apify | Outscraper, actor Maps d’Apify | Thunderbit (l’IA identifie les champs sur n’importe quel site) |
Yellow Pages est particulièrement fort pour la couverture locale de niches — si vous devez trouver tous les plombiers d’une zone métropolitaine précise, difficile de faire mieux. Google Maps offre des avis plus riches et des signaux de fraîcheur. Les pages Facebook Business peuvent parfois dépasser les deux sur la visibilité directe des e-mails, parce que les propriétaires de pages y publient souvent leur adresse.
L’IA de Thunderbit identifie les champs sur n’importe quel site web, donc vous pouvez scraper Yellow Pages, Google Maps et Facebook avec la même extension. Cette polyvalence est précieuse quand vous construisez une liste de leads multi-sources. Notre guide sur ce qu’est le web scraping couvre les bases si vous débutez.
Considérations juridiques et éthiques pour le scraping de Yellow Pages
Cette section est courte, mais importante.
Les données Yellow Pages sont accessibles publiquement, mais les conditions d’utilisation de YP.com précisent explicitement que l’accès est réservé à des « usages individuels, non commerciaux et informatifs » et que les utilisateurs ne peuvent pas utiliser de « bots, scrapers, crawlers, spiders » pour extraire les données. Le cadre juridique américain autour du web scraping est nuancé — la visibilité publique peut réduire le risque CFAA par rapport à des pages derrière connexion, mais le droit des contrats, les règles de confidentialité (CCPA) et la conformité marketing restent applicables.
La FTC a envoyé des lettres d’avertissement à 21 acteurs du marketing de plans de santé et à des générateurs de leads en décembre 2024 au sujet de l’usage des informations consommateurs dans les workflows de lead gen. Le message à retenir : scrapez de façon responsable, respectez les limites de débit, ne revendez pas des données brutes sans comprendre le cadre légal, et utilisez les données extraites pour des finalités commerciales légitimes.
Cet article est fourni à titre informatif et ne constitue pas un conseil juridique.
Conclusion
La plupart des extracteurs Yellow Pages ratent les e-mails parce qu’ils s’arrêtent à la page de liste. Les outils qui font mieux sont ceux qui peuvent atteindre les pages détaillées des entreprises, suivre les liens vers leurs sites web, ou exécuter des workflows d’enrichissement au-dessus de l’extraction de base. Même dans ce cas, la disponibilité des e-mails sur Yellow Pages plafonne autour de 15 à 25 % des fiches — donc avoir des attentes réalistes compte autant que le choix du bon outil.
Si vous faites partie d’une équipe non technique qui a besoin de leads avec de vraies données de contact, essayez l’offre gratuite de Thunderbit — l’extraction de sous-pages et les fonctions d’extraction d’e-mails ont été conçues précisément pour ce problème. Si vous menez des campagnes plus importantes, Apify et Outscraper offrent une infrastructure cloud solide. Et si vous êtes développeur et que vous voulez un contrôle total, Python avec Playwright et ScrapingBee vous y mènera, même si vous devrez construire davantage du pipeline vous-même.
Commencez par le tableau comparatif ci-dessus, choisissez selon votre niveau et votre budget, et souvenez-vous : le meilleur extracteur est celui qui vous donne vraiment les données dont vous avez besoin pour la prospection, pas celui qui affiche la plus longue liste de fonctionnalités.
Vous pouvez aussi découvrir directement notre extension Chrome Thunderbit, ou consulter nos tutoriels sur notre chaîne YouTube.
FAQ
Peut-on vraiment extraire des e-mails depuis Yellow Pages ?
Oui, mais la plupart des e-mails se trouvent sur les pages détaillées (sous-pages) des entreprises, pas sur la carte principale de résultat. La documentation actuelle des extracteurs suggère qu’environ 15 à 25 % seulement des entreprises affichent un e-mail qu’un scraper de page détaillée peut récupérer. Il vous faut un outil capable d’extraire les sous-pages — comme Thunderbit ou les actors de mode détail d’Apify — pour obtenir les meilleurs résultats.
Quel est le meilleur extracteur Yellow Pages gratuit ?
Instant Data Scraper est entièrement gratuit, sans compte ni limite de crédits, mais il n’extrait pas les e-mails de façon fiable et ne propose aucune gestion anti-bot. Thunderbit offre une offre gratuite (6 pages/mois) avec scraping IA, accès aux sous-pages et extraction d’e-mails — une meilleure option si l’e-mail est important pour votre workflow.
Comment éviter d’être bloqué en scrapant Yellow Pages ?
Yellow Pages utilise Cloudflare Bot Management, des CAPTCHA, la limitation de débit et l’empreinte navigateur. Utilisez des outils avec rotation de proxy et gestion des CAPTCHA intégrées (Thunderbit, Apify, Octoparse, ScrapingBee, Bright Data). La bascule cloud-vers-navigateur de Thunderbit offre une solution pratique : si le scraping cloud est bloqué, le mode navigateur utilise votre session locale pour contourner certaines protections.
Extracteur Yellow Pages vs extracteur Google Maps — lequel est le meilleur pour générer des leads ?
Cela dépend de vos besoins. Yellow Pages a une meilleure couverture locale par niche et affiche les numéros de téléphone de façon très régulière. Google Maps propose des avis plus riches et des mises à jour plus fréquentes. Aucun des deux n’est idéal pour l’e-mail — les pages Facebook Business ont souvent une meilleure disponibilité d’e-mails. Idéalement, croisez plusieurs annuaires pour obtenir les profils de leads les plus complets.
Est-il légal de scraper Yellow Pages ?
Les données Yellow Pages sont accessibles publiquement, mais les conditions d’utilisation de YP.com restreignent la collecte automatisée et l’usage commercial des résultats de recherche. Le cadre juridique américain autour du scraping de données publiques évolue. Les utilisateurs doivent lire les conditions du site, respecter les règles de confidentialité applicables (CCPA, GDPR lorsque pertinent) et utiliser les données extraites de façon responsable. Cet article est informatif et ne constitue pas un conseil juridique.
Essayer Thunderbit pour le scraping de Yellow Pages Get Started Free
En savoir plus



