TechCrunch Scraper





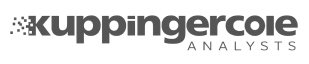





TechCrunch-Daten mit zwei Klicks freischalten
Einfaches TechCrunch-Scraping in zwei Klicks
Das manuelle Kopieren von Artikeltiteln, Autoren, Veröffentlichungsdaten oder vollständigen Artikeln von TechCrunch ist mühsam. Mit Thunderbit sparen Sie sich die Handarbeit komplett. Zeigen Sie einfach auf die benötigten Daten, und die KI erledigt den Rest. Mit zwei Klicks extrahieren Sie strukturierte Daten — ganz ohne eine einzige Zeile Code oder komplizierte Einrichtung.
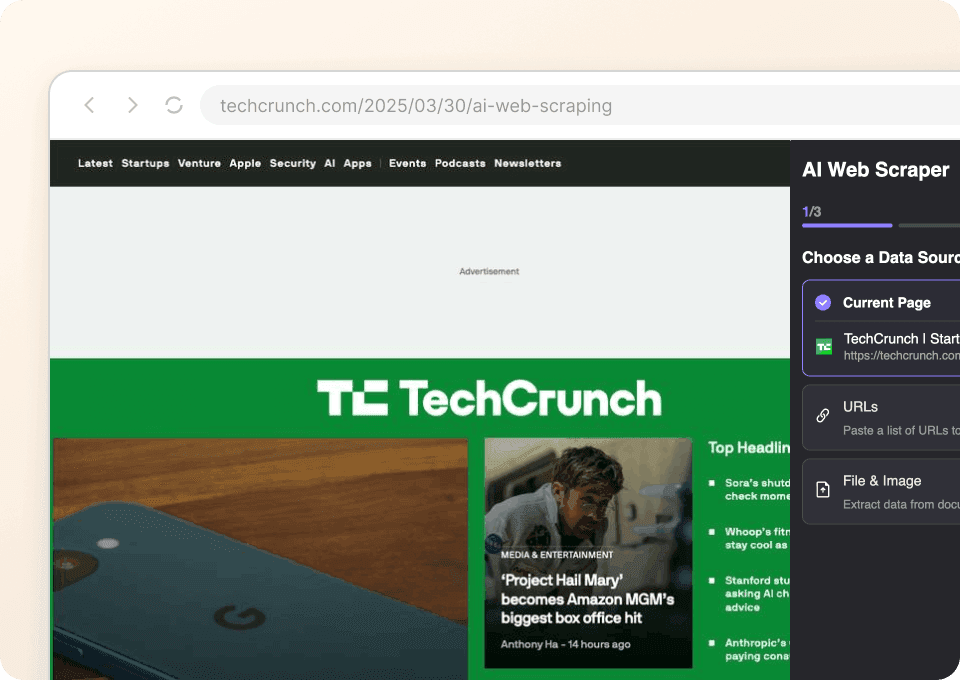
Saubere TechCrunch-Daten sofort erhalten
Rohes HTML von TechCrunch bringt Sie nicht weiter — Sie brauchen saubere, strukturierte Daten. Thunderbit bereinigt und formatiert die Daten automatisch während der Extraktion, sodass Sie Artikelkategorien sofort analysieren, Autoren verfolgen oder Veröffentlichungsdaten vergleichen können. Exportieren Sie die Daten direkt nach Google Sheets, Notion oder Airtable und arbeiten Sie sofort mit geordneten Informationen — ohne manuelle Nachbearbeitung.

Jede Website scrapen, nicht nur TechCrunch
Warum für jede Website ein neues Tool lernen? Thunderbit funktioniert mit nahezu jeder Seite, einschließlich TechCrunch. Mit über 50 vorgefertigten Vorlagen können Sie sogar noch schneller starten. Egal, ob Sie Artikelinhalte, Autorenprofile oder Veröffentlichungs-Tags erfassen möchten — Thunderbit ist Ihre Komplettlösung für Web-Datenextraktion im gesamten Web.
Schwierigkeiten, TechCrunch effizient zu scrapen?
Sehen Sie, wie Thunderbit die TechCrunch-Datenextraktion im Vergleich zu herkömmlichen Methoden vereinfacht.
Klassische Scraper
Die alte VorgehensweiseThunderbit
Die intelligentere LösungVerlass dich nicht nur auf unser Wort
Sieh dir an, was unsere Nutzer über Thunderbit sagen.
Häufig gestellte Fragen
Verwandt Anwendungsfälle
Entdecke weitere Anwendungsfälle für Thunderbits Web-Scraper.

4PDA-Scraper
Mit dem Thunderbit 4PDA Web-Scraper können Sie mithilfe von KI Daten aus 4PDA-Nachrichtenartikeln und Forenbeiträgen extrahieren. Sammeln Sie schnell Überschriften, Veröffentlichungsdaten, Autoren und Beitragsinhalte – ideal für Recherchen, Analysen oder das Monitoring technischer Diskussionen. Perfekt für Technikbegeisterte, Forschende und Marketer, die strukturierte 4PDA-Daten benötigen.
Mehr erfahren ->
Ptt-Scraper
Mit dem Thunderbit Ptt Web-Scraper können Sie mühelos Daten aus Ptt-Foren und Beiträgen extrahieren – dank KI-gestützter Felderkennung. Sammeln Sie Boardnamen, URLs, Beliebtheit, Beitragstitel, Autoren und Kommentare für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Ptt-Daten benötigen.
Mehr erfahren ->
Pizza-Marktplatz-Scraper
Mit dem Thunderbit Pizza Marketplace Scraper können Sie Daten aus den Nachrichtenlisten und Anbieterverzeichnissen von Pizza Marketplace extrahieren. Dank KI-gestützter Feldvorschläge sammeln Sie im Handumdrehen Schlagzeilen, Veröffentlichungsdaten, Autoren, Anbieternamen, Standorte und Kontaktdaten – ideal für Recherche, Marketing oder Analysen.
Mehr erfahren ->
Failory Scraper
Mit dem Thunderbit Failory-Scraper können Sie strukturierte Daten aus dem Startup Cemetery und den News-Artikeln von Failory extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie Startup-Namen, Gründungsjahre, Scheitergründe, Artikeltitel, Autoren und vieles mehr – perfekt für Recherche und Analyse. Ideal für Gründer, Investoren und Forschende, die wertvolle Einblicke aus Failory gewinnen möchten.
Mehr erfahren ->
Investing.com Web-Scraper
Extrahiere Börsendaten – Symbole, Kurse, Volumen und Marktkapitalisierung – aus Investing.com mit nur 2 Klicks und exportiere sie direkt nach Google Sheets, Notion oder Excel. Öffne einfach eine beliebige Investing.com-Seite und lass die KI die Felder für dich erkennen.
Mehr erfahren ->
Substack-Webscraper
Extrahieren Sie Substack-Abonnentenzahlen, Artikeltitel und Beschreibungen von Publikationen in nur 2 Klicks — und exportieren Sie die Daten anschließend nach Excel, Google Sheets oder Notion. Ganz ohne Code; Thunderbits KI übernimmt die Strukturierung für Sie.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.



