Substack-Webscraper










Schalten Sie Substack-Daten mit Thunderbit frei
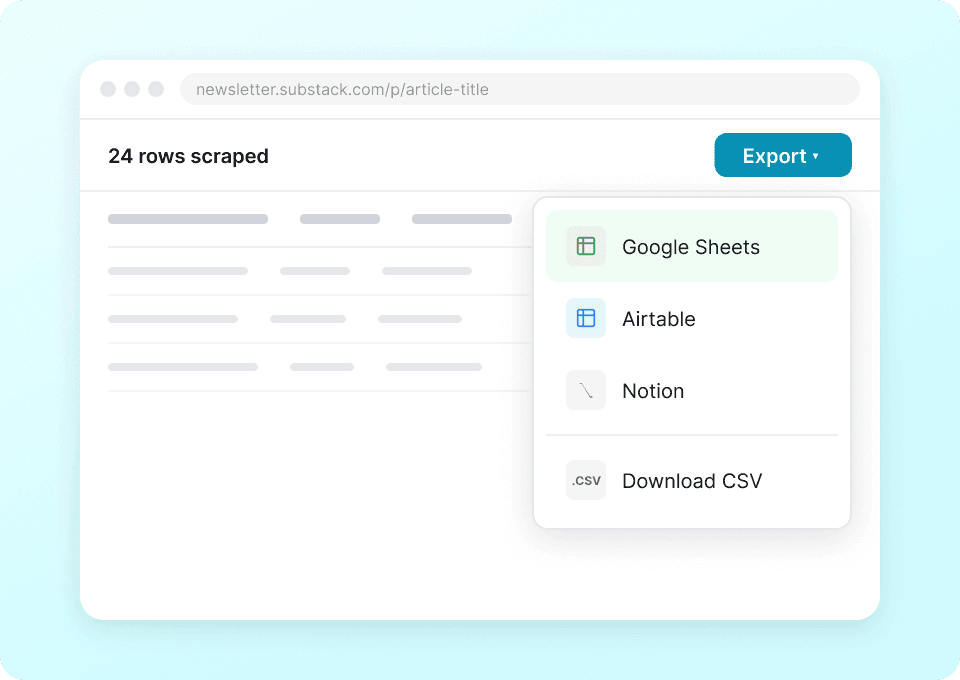
Senden Sie Substack-Daten direkt an Ihre Apps
Hören Sie auf, Substack-Publikationsdetails wie Autorennamen, Artikeltitel und Abonnentenzahlen manuell zu kopieren und einzufügen. Mit Thunderbit senden Sie Ihre extrahierten Daten mit einem einzigen Klick direkt an Google Sheets, Notion oder Airtable — so können Sie Publikationstrends und Content-Performance analysieren, ohne die mühsame Handarbeit.
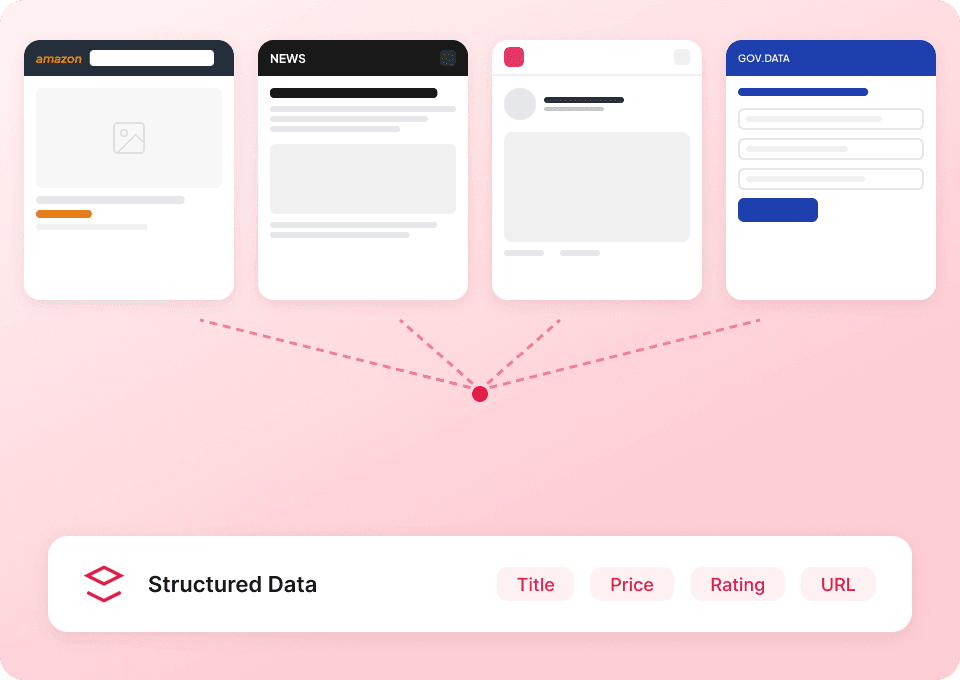
Ein Scraper für Substack und mehr
Sie brauchen nicht für jede Website ein anderes Tool. Thunderbit funktioniert auf Substack sofort und bietet über 50 vorgefertigte Vorlagen für weitere beliebte Plattformen. Extrahieren Sie Publikationsbeschreibungen, Artikelinhalte und mehr — und nutzen Sie dasselbe Tool anschließend, um Daten von jeder anderen Website zu sammeln.
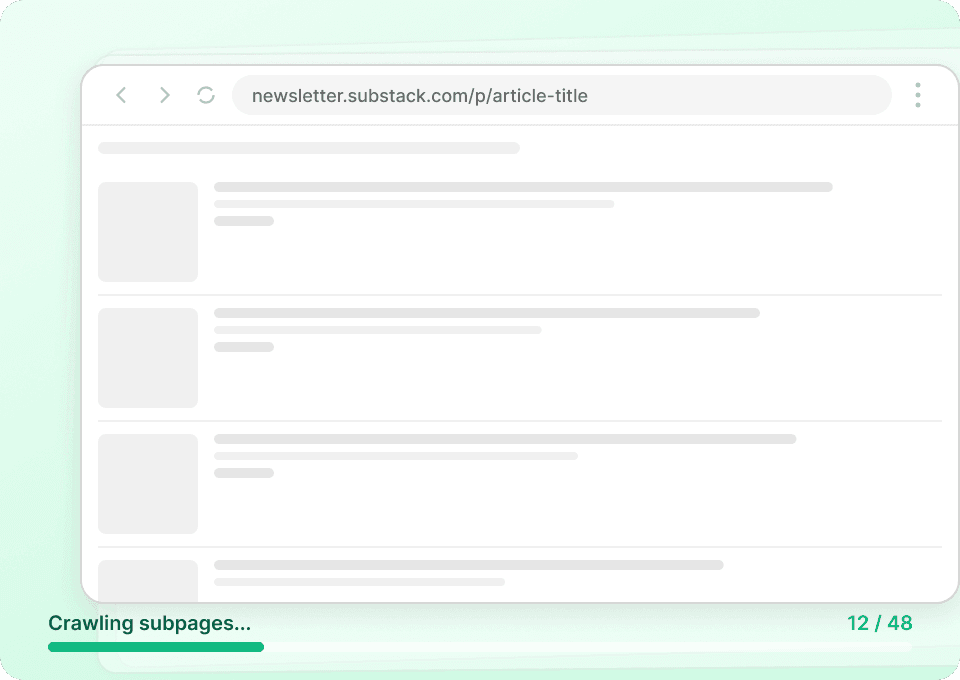
Erhalten Sie die vollständige Substack-Story
Auf Substack-Listingseiten werden nur Zusammenfassungen angezeigt. Thunderbit besucht automatisch jede Artikelseite, um den vollständigen Inhalt zu erfassen, und erstellt so in einem Durchlauf einen vollständigen Datensatz. Erfassen Sie Artikeltitel, Autorennamen, Publikationsnamen und den vollständigen Artikeltext — ganz ohne eine einzige Seite manuell zu öffnen.
Haben Sie Probleme, Substack effizient zu scrapen?
Sehen Sie, warum Thunderbit traditionelle Scraper für Substack-Daten übertrifft.
Traditionelle Scraper
Der alte WegThunderbit
Der smartere AnsatzVerlass dich nicht nur auf unser Wort
Sieh dir an, was unsere Nutzer über Thunderbit sagen.
Häufig gestellte Fragen
Verwandt Anwendungsfälle
Entdecke weitere Anwendungsfälle für Thunderbits Web-Scraper.

4PDA-Scraper
Mit dem Thunderbit 4PDA Web-Scraper können Sie mithilfe von KI Daten aus 4PDA-Nachrichtenartikeln und Forenbeiträgen extrahieren. Sammeln Sie schnell Überschriften, Veröffentlichungsdaten, Autoren und Beitragsinhalte – ideal für Recherchen, Analysen oder das Monitoring technischer Diskussionen. Perfekt für Technikbegeisterte, Forschende und Marketer, die strukturierte 4PDA-Daten benötigen.
Mehr erfahren ->
Ptt-Scraper
Mit dem Thunderbit Ptt Web-Scraper können Sie mühelos Daten aus Ptt-Foren und Beiträgen extrahieren – dank KI-gestützter Felderkennung. Sammeln Sie Boardnamen, URLs, Beliebtheit, Beitragstitel, Autoren und Kommentare für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Ptt-Daten benötigen.
Mehr erfahren ->
Pizza-Marktplatz-Scraper
Mit dem Thunderbit Pizza Marketplace Scraper können Sie Daten aus den Nachrichtenlisten und Anbieterverzeichnissen von Pizza Marketplace extrahieren. Dank KI-gestützter Feldvorschläge sammeln Sie im Handumdrehen Schlagzeilen, Veröffentlichungsdaten, Autoren, Anbieternamen, Standorte und Kontaktdaten – ideal für Recherche, Marketing oder Analysen.
Mehr erfahren ->
Failory Scraper
Mit dem Thunderbit Failory-Scraper können Sie strukturierte Daten aus dem Startup Cemetery und den News-Artikeln von Failory extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie Startup-Namen, Gründungsjahre, Scheitergründe, Artikeltitel, Autoren und vieles mehr – perfekt für Recherche und Analyse. Ideal für Gründer, Investoren und Forschende, die wertvolle Einblicke aus Failory gewinnen möchten.
Mehr erfahren ->
Investing.com Web-Scraper
Extrahiere Börsendaten – Symbole, Kurse, Volumen und Marktkapitalisierung – aus Investing.com mit nur 2 Klicks und exportiere sie direkt nach Google Sheets, Notion oder Excel. Öffne einfach eine beliebige Investing.com-Seite und lass die KI die Felder für dich erkennen.
Mehr erfahren ->
TechCrunch Scraper
Extrahieren Sie TechCrunch-Artikel, Startup-Updates, Titel, Links, Veröffentlichungsdaten, Autoren und Zusammenfassungen in nur 2 Klicks — ganz ohne Code. Exportieren Sie die Daten sofort nach Excel, Google Sheets oder Notion und verwandeln Sie unstrukturierte News in strukturierte, direkt nutzbare Informationen.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.



