
Web đang “khát” dữ liệu hơn bao giờ hết, và đến năm 2026, Node.js đang dẫn đầu cuộc chơi cho những đội ngũ muốn thu thập dữ liệu thông minh hơn, thay vì chỉ cắm đầu làm thủ công. Dù bạn làm sales, ecommerce, hay chỉ là một dân mê dữ liệu như tôi, hẳn bạn cũng nhận ra rằng scraping giờ không còn đơn thuần là “lấy được dữ liệu” nữa — mà là phải làm nhanh, làm ở quy mô lớn, và không để IP của mình bị ném vào “nhà giam số”. Nhu cầu cũng chẳng hề chậm lại — dữ liệu web công khai âm thầm trở thành đầu vào cho hầu hết các team hiện đại, từ phân tích giá cả đến pipeline huấn luyện LLM, và mức độ cạnh tranh thì chưa bao giờ cao đến thế.
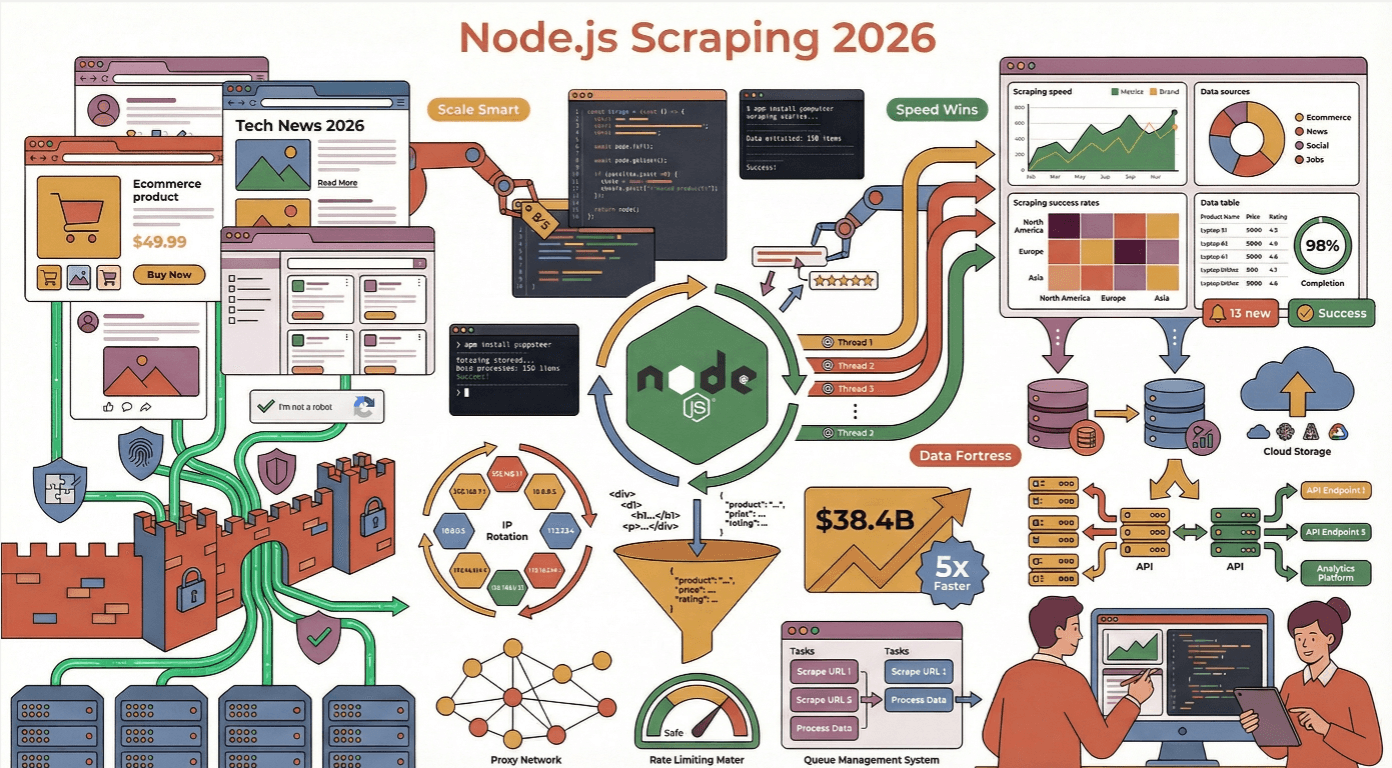
Nhưng vấn đề là: web hiện đại giống như một pháo đài đầy nội dung động, bẫy chống bot, và giao diện thay đổi liên tục. Tôi đã thấy không ít scraper “gãy gánh giữa đường” — thường là vì bỏ qua các thực hành tốt nhất hoặc đánh giá thấp mức độ tinh vi của các cơ chế chống scraping. Vì vậy, hãy cùng đi sâu vào những best practices thực chiến để tối ưu hiệu suất Web Scraping bằng Node.js, kèm vài câu chuyện thực tế, chút hài hước, và rất nhiều lời khuyên có thể áp dụng ngay.
Vì sao nên chọn Node.js cho Web Scraping hiệu quả?
Nếu bạn từng thử scrape hàng trăm, hay thậm chí hàng nghìn trang cùng lúc, bạn sẽ hiểu tốc độ và khả năng xử lý đồng thời quan trọng đến mức nào. Đó chính là lúc Node.js tỏa sáng. Mô hình I/O bất đồng bộ, không chặn của nó được sinh ra để xử lý số lượng lớn request mạng đồng thời — có thể xem nó như “tay đa nhiệm” tối thượng của thế giới web (Node.js Docs). Trong khi những ngôn ngữ khác có thể bị chậm lại vì phải chờ từng request hoàn tất, Node.js vẫn tiếp tục chạy event loop, xử lý request như một nghệ sĩ xiếc vừa nhanh vừa tỉnh táo.
Tôi đã thấy Node.js vượt Python và Java trong những tình huống cần cập nhật thời gian thực và trích xuất quy mô lớn, đặc biệt khi website đích được render bằng JavaScript. Thực tế, khoảng 40% developer hiện dùng Node.js cho backend và automation, biến nó thành một trong những công nghệ web phổ biến nhất thế giới.
Node.js so với các framework Web Scraping khác
Cùng “so kè” một chút cho dễ hình dung:
| Framework | Điểm mạnh | Điểm yếu | Trường hợp phù hợp nhất |
|---|---|---|---|
| Node.js | Bất đồng bộ, rất mạnh về concurrency, hệ sinh thái npm khổng lồ, JS gốc cho site động | Có thể tốn bộ nhớ, dễ rơi vào callback hell nếu không dùng async/await | Scraping thời gian thực, site nặng JS, microservice có khả năng mở rộng |
| Python | Rất nhiều thư viện scraping (BeautifulSoup, Scrapy), cú pháp dễ hiểu | Chậm hơn khi concurrency lớn, khó với site render bằng JS | HTML tĩnh, nghiên cứu, tạo prototype |
| Java | Kiểu dữ liệu mạnh, ổn định cho doanh nghiệp | Dài dòng, kém linh hoạt khi viết script nhanh | Scraping quy mô lớn, cấp doanh nghiệp |
| Go | Nhanh, concurrency hiệu quả | Hệ sinh thái nhỏ hơn, đường cong học tập dốc hơn | Scraping hiệu năng cao, độ trễ thấp |
Với đa số người dùng doanh nghiệp, Node.js rơi đúng “điểm vàng”: nhanh, linh hoạt, và rất hợp với web hiện đại chạy bằng JavaScript (Thunderbit Blog).
Thiết lập môi trường Node.js Web Scraping vững chắc
Một scraper tốt luôn bắt đầu từ nền tảng tốt. Đây là bộ setup tôi thường dùng:
- Cấu trúc dự án: Tách module rõ ràng. Dùng các thư mục như
/src,/libs, và/config. Lưu thông tin nhạy cảm (API key, proxy) trong biến môi trường vớidotenv(Thunderbit Guide). - HTTP Client: Dùng axios, got, hoặc node-fetch để gửi request.
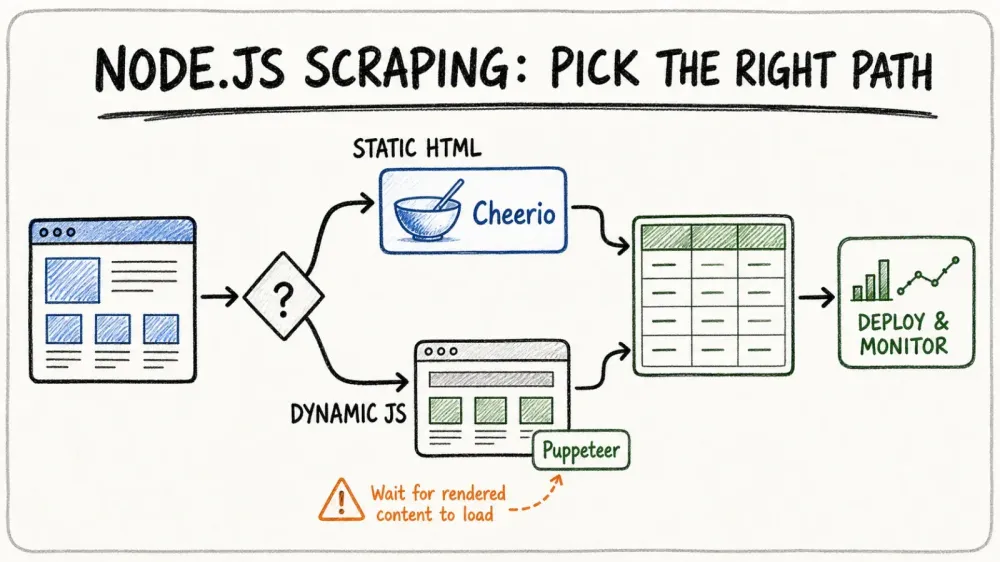
- Phân tích HTML: Cheerio cho HTML tĩnh, Puppeteer hoặc Playwright cho nội dung động.
- Tiện ích: Dùng Lodash để xử lý dữ liệu, và validator.js hoặc Joi để kiểm tra tính hợp lệ.
- Kiểm thử & linting: Mocha cho test, ESLint cho chất lượng code (LogRocket).
Các thư viện Node.js Web Scraping thiết yếu
- HTTP client (axios / got /
fetchtích hợp): Dùng để gửi request. Một điểm cần lưu ý ngay từ đầu: từ Node.js v18, bạn có thể dùngfetchgốc mà không cần cài thêm gì, và Node.js v22 đã đưa nó lên trạng thái ổn định. Với dự án mới trên bản Node hiện đại, nhiều khi bạn không cầnnode-fetchnữa — chỉ cần gọi thẳngfetch. Cá nhân tôi vẫn thích axios khi cần interceptor, xử lý JSON tự động, và API promise quen thuộc cả trong Node lẫn trình duyệt; còn got là lựa chọn tôi dùng khi cần retry, stream, hoặc HTTP/2 có sẵn. Hãy chọn công cụ phù hợp với stack của bạn; nếu chỉ viết script nhanh,fetchgốc là đủ. - Cheerio: Trình phân tích HTML nhanh, giống jQuery. Rất hợp cho trang tĩnh — phân tích chỉ khoảng 0,5 giây (Oxylabs).
- Playwright / Puppeteer: Tự động hóa trình duyệt headless cho site động, nặng JS. Chậm hơn (~4 giây mỗi trang), nhưng rất cần cho các site tải nội dung sau khi trang mở xong (Bright Data). Nếu bạn bắt đầu mới trong năm 2026, Playwright là lựa chọn mặc định — hỗ trợ đa trình duyệt ngay từ đầu (Chromium / Firefox / WebKit), có trace viewer tích hợp, và đội ngũ từng xây Puppeteer hiện đang phát triển nó tại Microsoft. Puppeteer vẫn được duy trì cho các nhu cầu chỉ nhắm đến Chrome, nhưng các bản phát hành gần đây chủ yếu nghiêng về cập nhật tương thích với Chrome hơn là bổ sung năng lực mới.
- dotenv: Quản lý biến môi trường.
- csv-writer/jsonfile: Xuất dữ liệu.
Tránh các lỗi phổ biến trong Node.js Web Scraping
Tôi không đếm nổi bao nhiêu lần tôi thấy scraper bị chặn, bị crash, hoặc đơn giản là đổ ra một đống dữ liệu lộn xộn. Đây là những thứ cần đặc biệt chú ý:
- Bỏ qua robots.txt và Điều khoản dịch vụ: Luôn kiểm tra trước khi scrape. Vi phạm có thể khiến IP của bạn bị chặn — hoặc tệ hơn là dính rắc rối pháp lý (ScraperAPI).
- Làm quá tải server: Đừng bắn request liên tục. Hãy giới hạn tốc độ scraper bằng các khoảng nghỉ ngẫu nhiên (1–3 giây), dùng kiểm soát concurrency, và đừng hành xử như một con robot tăng động (ScrapeGraphAI).
- Không xử lý lỗi: Luôn bọc request bằng try/catch, xử lý lỗi HTTP, và ghi log các lần thất bại. Với lỗi tạm thời, hãy retry theo chiến lược exponential backoff (ScrapeGraphAI).
- Quên header request: Dùng chuỗi User-Agent giống thật và xoay vòng chúng. Thêm Accept-Language, Referer, và các header khác để mô phỏng trình duyệt thực (ScrapeGraphAI).
Cách vượt qua cơ chế chống scraping
Các website hiện đại được trang bị đủ loại công nghệ chống bot. Đây là những cách tôi thường dùng để né “mìn số”:
- Xoay proxy/IP: Dùng proxy pool và luân phiên IP để tránh bị chặn (Medium).
- Ngẫu nhiên hóa header: Đổi User-Agent, Accept-Language và các header khác cho từng request.
- Ẩn dấu vết headless browser: Dùng plugin như
puppeteer-extra-plugin-stealthđể che các dấu hiệu tự động hóa. - Mô phỏng hành vi người dùng: Thêm độ trễ ngẫu nhiên, di chuyển chuột, cuộn trang, thậm chí gõ sai đôi chút rồi sửa lại (ZenRows).
Mô phỏng hành vi người dùng trong scraper Node.js
Đây là phần thú vị nhất — và cũng hơi “kỳ quặc” một chút. Thay vì click và cuộn ngay lập tức, hãy lập trình scraper của bạn để:
- Chờ ngẫu nhiên giữa các hành động (
await page.waitForTimeout(randomDelay)) - Di chuyển chuột từng chút một với độ lệch nhẹ (
page.mouse.move(x, y)) - Gõ văn bản với độ trễ ngẫu nhiên và thỉnh thoảng gõ nhầm (
page.type(selector, text, {delay: random(100,200)})) - Cuộn không đều, chứ không chỉ kéo thẳng xuống cuối trang
Những mẹo này có thể tăng đáng kể tỷ lệ thành công trên các site có bảo vệ (ScraperAPI).
Đơn giản hóa việc trích xuất dữ liệu phức tạp với Thunderbit
Trích xuất dữ liệu từ bất kỳ website nào bằng AI Bỏ qua phần boilerplate: web scraper dạng agent của Thunderbit có thể đọc bất kỳ trang nào và trích xuất dữ liệu chỉ với một cú nhấp, không cần phải bảo trì code Node.js. Get Started Free
Bây giờ đến “con voi trong phòng”: scraping rất khó. Nhưng nó không nhất thiết phải khó như vậy. Đó là lý do chúng tôi xây dựng Thunderbit.
Thunderbit là một Chrome Extension web scraper dạng agent cho phép bạn trích xuất dữ liệu từ bất kỳ website nào bằng ngôn ngữ tự nhiên. Chỉ cần bấm “One Click Extract”, để AI tự hiểu nội dung trang, rồi nhấn “Scrape”. Nó giống như có một junior developer không bao giờ ngủ và cũng chẳng bao giờ đòi tăng lương.
Tuyệt hơn nữa, Thunderbit còn có API, nên bạn có thể gắn thẳng vào workflow Node.js của mình. Thay vì viết hàng nghìn dòng code scraping, bạn có thể để Thunderbit xử lý phần nặng — nội dung động, trang con, phân trang, tất cả. Việc của bạn chỉ là lấy dữ liệu có cấu trúc (CSV, JSON, hoặc đẩy thẳng vào Google Sheets, Airtable, Notion) và tiếp tục công việc trong ngày (Thunderbit Blog).
Dùng thử miễn phí Thunderbit Chrome Extension Cài tiện ích Chrome miễn phí và trích xuất dữ liệu có cấu trúc chỉ với một cú nhấp — hoặc gọi Thunderbit API ngay từ ứng dụng Node.js của bạn. Get Started Free
Thunderbit so với scraping Node.js truyền thống
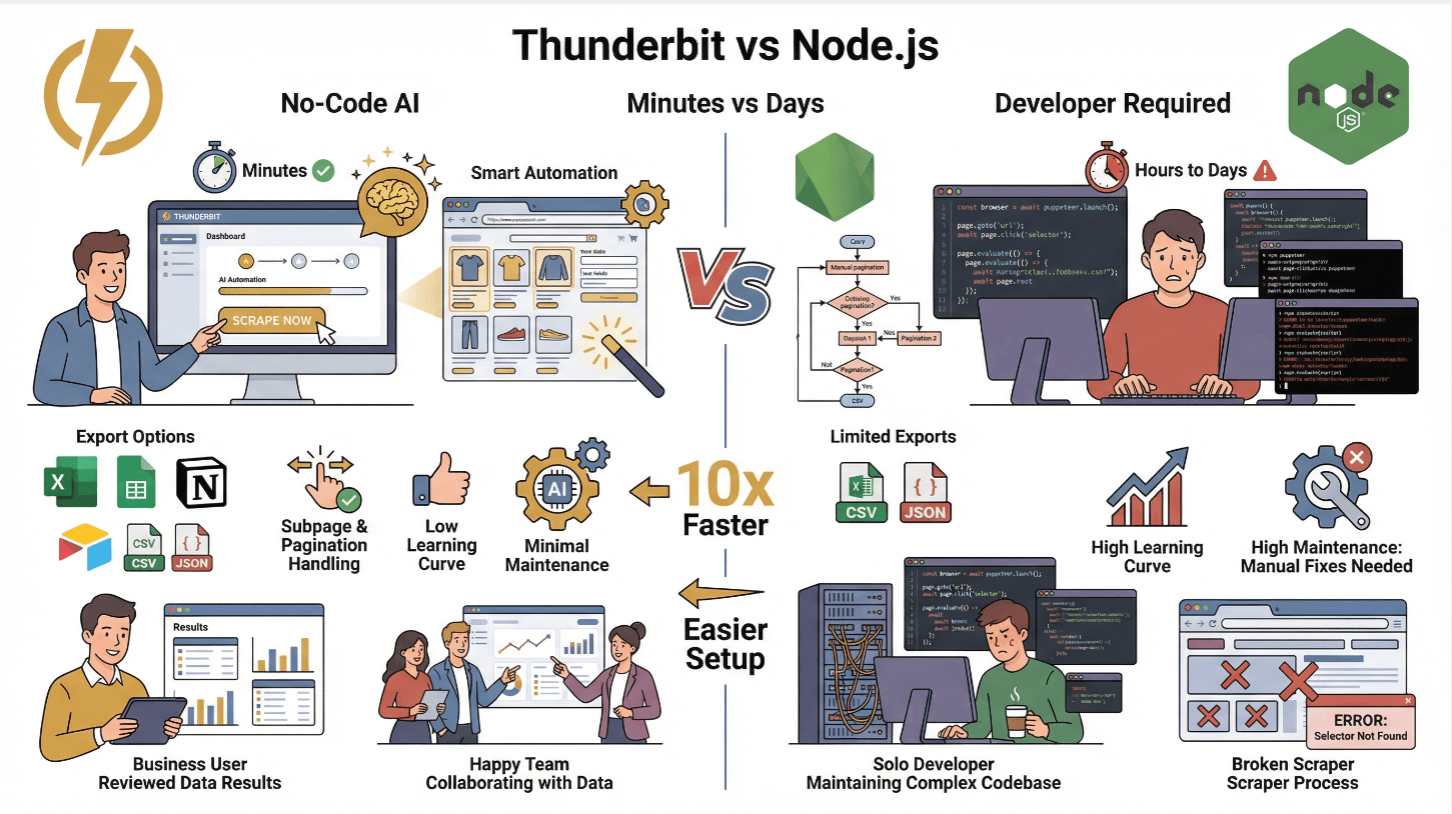
| Tính năng | Thunderbit | Scraper Node.js truyền thống |
|---|---|---|
| Thời gian thiết lập | Vài phút (không cần code) | Vài giờ đến vài ngày (viết code, test) |
| Xử lý nội dung động | Có (AI + browser) | Có (với Puppeteer/Playwright) |
| Trang con & phân trang | Một cú nhấp | Phải tự code thủ công |
| Xuất dữ liệu | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (code riêng) |
| Độ khó học | Thấp (người dùng business) | Cao (developer) |
| Bảo trì | Tối thiểu (AI tự thích nghi) | Cao (phải sửa tay khi site thay đổi) |
Thunderbit rất phù hợp cho các team không chuyên kỹ thuật hoặc bất kỳ ai muốn bỏ qua công việc lặp đi lặp lại để tập trung vào insight. Với người dùng nâng cao, bạn vẫn có thể dùng API của Thunderbit để tự động hóa scraping ở quy mô lớn (Thunderbit Docs).
Kết hợp Cheerio và Puppeteer cho nội dung động
Đây là bộ đôi Node.js scraping tôi thích nhất. Cách hoạt động như sau:
- Dùng Puppeteer để tải trang và chạy JavaScript (đợi
networkidleđể đảm bảo toàn bộ nội dung đã load xong). - Lấy HTML bằng
await page.content(). - Phân tích bằng Cheerio: đưa HTML vào Cheerio để parse và trích xuất dữ liệu cực nhanh theo kiểu jQuery.
Cách làm hybrid này cho bạn cả hai thế giới: sức mạnh của Puppeteer cho nội dung động, và tốc độ của Cheerio cho bước phân tích (Browserless).
Mẹo hiệu năng: Chỉ chọn đúng phần tử bạn cần. Cheerio nạp toàn bộ DOM vào bộ nhớ, nên hãy tránh selector quá rộng và cache kết quả nếu bạn scrape lặp lại cùng một nhóm trang (Oxylabs).
Tối ưu phân tích HTML và trích xuất dữ liệu
- Dùng selector cụ thể: Tránh
$('body *')— hãy nhắm đúng phần cần lấy. - Stream trang lớn: Với HTML khổng lồ, hãy cân nhắc streaming hoặc chia nhỏ công việc.
- Cache HTML đã render: Nếu truy cập lại URL nhiều lần, hãy cache HTML để tránh request thừa.
- Kiểm tra và làm sạch dữ liệu: Dùng thư viện validator để tránh đổ rác vào database (ScrapeGraphAI).
Triển khai Node.js Web Scraper quy mô lớn trên cloud
Muốn scrape ở quy mô lớn? Đã đến lúc chuyển sang cloud-native.
- Dockerize scraper của bạn: Viết
Dockerfile, copy code, cài dependency, và cấu hình entrypoint. - Triển khai lên cloud: Dùng AWS EC2, Google Cloud Compute hoặc Azure VM cho tác vụ đơn giản. Nếu cần quy mô lớn thực sự, hãy dùng Kubernetes hoặc các dịch vụ quản lý như AWS ECS/EKS, Google Cloud Run, hay Azure Kubernetes Service (DigitalOcean).
- Điều phối bằng Kubernetes: Chạy nhiều pod, autoscale theo nhu cầu, và dùng load balancer để phân phối URL.
- Lên lịch công việc: Dùng cloud scheduler (CloudWatch Events, Cloud Scheduler) hoặc cron job để kích hoạt scraping theo chu kỳ.
Trong một ví dụ thực tế, việc tăng từ 5 lên 10 Kubernetes pod đã rút ngắn một job scrape 400 trang từ vài phút xuống chưa tới một phút (DigitalOcean).
Giám sát và tự động mở rộng hạ tầng scraping
- Logging: Đẩy log lên CloudWatch, Stackdriver hoặc Datadog. Thiết lập cảnh báo khi có lỗi hoặc tốc độ chậm.
- Health checks: Dùng Prometheus và Grafana để theo dõi các chỉ số như số trang scrape mỗi phút, tỷ lệ lỗi, và tình trạng pod.
- Auto-scaling: Thiết lập Kubernetes HPA (Horizontal Pod Autoscaler) để scale pod theo CPU hoặc số lượng request.
Luôn triển khai retry với exponential backoff để phục hồi khi gặp lỗi mạng chập chờn hoặc bị chặn tạm thời.
Best practices cho lưu trữ và hậu xử lý dữ liệu
Sau khi scrape xong, bạn cần lưu trữ và làm sạch dữ liệu:
- Tác vụ nhỏ: Xuất ra CSV, JSON, hoặc đẩy vào Google Sheets, Airtable, Notion (Thunderbit làm sẵn phần này).
- Tác vụ lớn: Dùng SQL (MySQL/PostgreSQL) cho dữ liệu có cấu trúc, hoặc NoSQL (MongoDB, DynamoDB) cho dữ liệu bán cấu trúc hay schema thay đổi (ScrapeHero).
- Lưu trữ trên cloud: S3 hoặc Google Cloud Storage cho file thô và bản sao lưu.
- Làm sạch dữ liệu: Luôn kiểm tra field, chuẩn hóa định dạng (ngày tháng, số liệu), và loại bỏ bản ghi trùng. Dùng schema validator để đảm bảo chất lượng dữ liệu (ScrapeGraphAI).
Hãy giữ cả dữ liệu thô lẫn dữ liệu đã làm sạch — bạn sẽ không biết lúc nào cần quay lại xử lý hoặc debug.
Kết luận: Những điểm mấu chốt về hiệu suất Web Scraping với Node.js
Bỏ qua phần viết code scraper Xem Thunderbit web scraper dạng agent so sánh thế nào với việc tự viết và tự bảo trì script scraping của bạn. Get Started Free
Hãy chốt lại những ý chính:
- Tận dụng sức mạnh async của Node.js để scrape đồng thời ở quy mô lớn — đặc biệt trên các site nặng JavaScript.
- Kết hợp đúng công cụ: Dùng axios/got cho request, Cheerio cho HTML tĩnh, Puppeteer cho nội dung động, và phối hợp chúng để có tốc độ lẫn tính linh hoạt.
- Tránh bẫy chống bot: Xoay proxy và header, mô phỏng hành vi người dùng, và tôn trọng robots.txt.
- Đơn giản hóa với Thunderbit: Với người dùng business hoặc khi cần prototype nhanh, Thunderbit cho phép bạn trích xuất dữ liệu phức tạp bằng AI và kết nối vào stack Node.js qua API.
- Triển khai ở quy mô lớn: Dockerize, điều phối bằng Kubernetes, và giám sát mọi thứ để đảm bảo độ tin cậy.
- Lưu trữ và làm sạch dữ liệu: Chọn đúng loại storage cho nhu cầu của bạn, và luôn kiểm tra trước khi sử dụng.
Web sẽ không trở nên đơn giản hơn, nhưng với những best practices này, scraper Node.js của bạn có thể luôn nhanh, ổn định, và đi trước một bước trong cuộc đua chống bot. Và nếu một ngày nào đó bạn chán debug selector lúc 2 giờ sáng, hãy nhớ: AI của Thunderbit luôn thức.
Muốn tìm hiểu thêm? Hãy xem Thunderbit Blog để đọc thêm các bài phân tích chuyên sâu, hoặc thử Thunderbit Chrome Extension để thấy scraping có thể dễ đến mức nào.
Scrape với Thunderbit Agentic Web Scraper Thunderbit Web Scraper API cho phép bạn kích hoạt trích xuất ngay từ code Node.js của mình, với gói miễn phí để bắt đầu. Get Started Free
FAQs
1. Vì sao Node.js đặc biệt phù hợp cho web scraping vào năm 2025?
Mô hình bất đồng bộ, điều khiển theo sự kiện của Node.js cho phép nó xử lý hàng nghìn request đồng thời, rất lý tưởng để scrape khối lượng dữ liệu lớn hoặc cập nhật theo thời gian thực. Hệ sinh thái npm khổng lồ và hỗ trợ JavaScript gốc cũng rất phù hợp với các website hiện đại nặng JavaScript (Node.js Docs).
2. Làm sao để tránh bị chặn khi scrape bằng Node.js?
Hãy dùng proxy xoay vòng, random hóa header request, giới hạn tốc độ bằng độ trễ ngẫu nhiên, và mô phỏng hành vi người dùng thật (di chuyển chuột, cuộn trang, gõ phím) bằng các công cụ như Puppeteer. Luôn tôn trọng robots.txt và điều khoản của website (Medium).
3. Khi nào nên dùng Cheerio thay vì Puppeteer trong scraper Node.js?
Dùng Cheerio để phân tích nhanh HTML tĩnh (khi dữ liệu đã nằm sẵn trong HTML thô). Dùng Puppeteer cho các website tải nội dung động bằng JavaScript. Để có kết quả tốt nhất, hãy dùng Puppeteer để render trang rồi dùng Cheerio để parse HTML (Bright Data).
4. Thunderbit giúp đơn giản hóa web scraping Node.js như thế nào?
Thunderbit cho phép bạn trích xuất dữ liệu có cấu trúc từ bất kỳ website nào bằng AI và prompt ngôn ngữ tự nhiên — không cần viết code. Nó xử lý nội dung động, trang con, phân trang, và có API để tích hợp vào Node.js. Dữ liệu có thể được xuất thẳng sang Excel, Google Sheets, Airtable hoặc Notion (Thunderbit Blog).
5. Cách tốt nhất để scale và giám sát scraper Node.js trên cloud là gì?
Hãy Dockerize scraper, triển khai trên Kubernetes hoặc dịch vụ cloud quản lý, và dùng auto-scaling để xử lý các đợt tăng tải. Giám sát log và metric bằng công cụ như CloudWatch hoặc Prometheus, đồng thời thiết lập cảnh báo cho lỗi hoặc hiệu suất giảm (DigitalOcean).
Sẵn sàng nâng cấp kỹ năng web scraping? Hãy thử Thunderbit, và chúc cho scraper của bạn luôn nhanh, kín đáo, và đi trước một bước.
Dùng thử Agentic Web Scraper Get Started Free
Tìm hiểu thêm




