
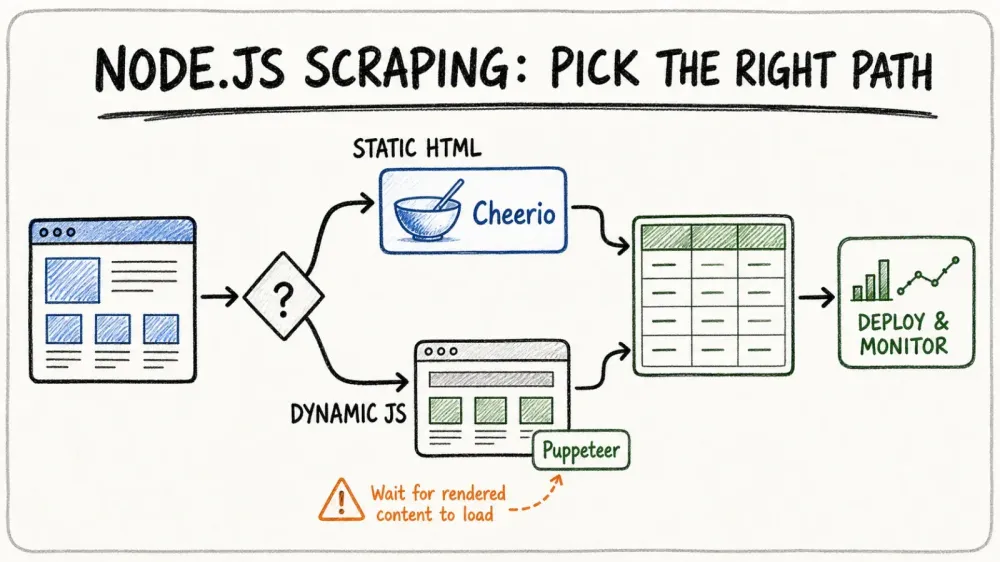
เว็บยุคนี้ต้องการข้อมูลมากกว่าสมัยก่อนเยอะ และในปี 2026 Node.js ก็ยังเป็นตัวหลักสำหรับทีมที่อยากดึงข้อมูลให้ “ฉลาดขึ้น” ไม่ใช่ “เหนื่อยขึ้น” ไม่ว่าคุณจะทำสายขายของ อีคอมเมิร์ซ หรือเป็นสายข้อมูลตัวจริงแบบผม คุณคงเห็นแล้วว่า การทำ scraping สมัยนี้ไม่ใช่แค่ “เอาข้อมูลออกมา” อีกต่อไป แต่มันคือการดึงให้เร็ว รองรับปริมาณเยอะ และไม่โดน IP ของตัวเองส่งเข้าคุกดิจิทัล ความต้องการก็ไม่ได้ลดลงเลย — ข้อมูลสาธารณะบนเว็บกลายเป็นวัตถุดิบที่ทีมสมัยใหม่เอาไปต่อยอดกันเงียบ ๆ ตั้งแต่ข้อมูลราคาคู่แข่งไปจนถึง pipeline สำหรับเทรน LLM และการแข่งขันก็เดือดกว่าที่เคย
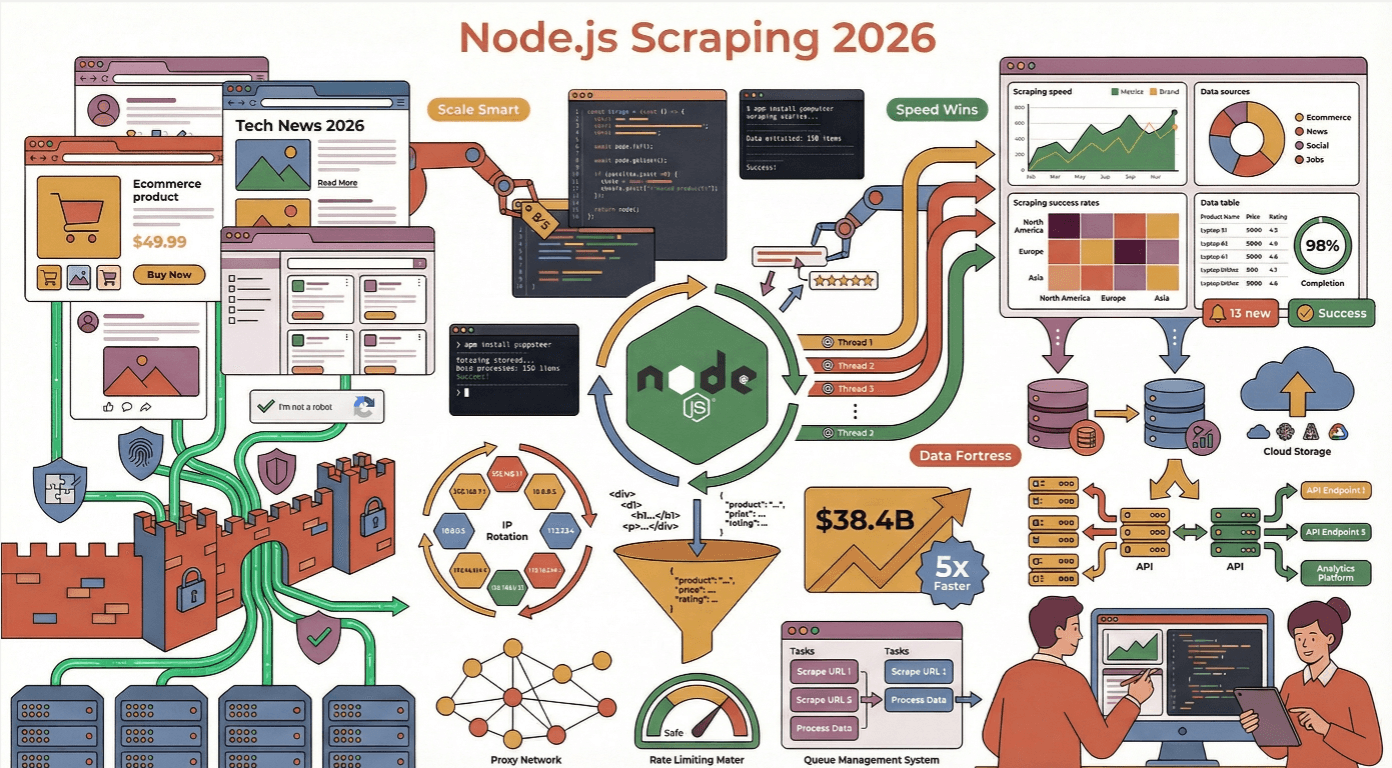
แต่ประเด็นสำคัญคือ เว็บยุคใหม่มันเหมือนป้อมปราการที่เต็มไปด้วยคอนเทนต์แบบไดนามิก ด่านกันบอท และเลย์เอาต์ที่เปลี่ยนไปเรื่อย ๆ ผมเห็น scraper พังมาจนจำแทบไม่ไหว—ส่วนใหญ่เพราะมองข้าม best practices หรือประเมินระบบป้องกันการ scraping ต่ำเกินไป งั้นเรามาเจาะลึกแนวทางปฏิบัติจริงสำหรับการทำ Node.js web scraping ให้มีประสิทธิภาพกันดีกว่า พร้อมเรื่องเล่าเล็ก ๆ มุกนิด ๆ และคำแนะนำที่เอาไปใช้ได้จริงแบบจัดเต็ม
ทำไมต้องเลือก Node.js สำหรับ Web Scraping ที่มีประสิทธิภาพ?
ถ้าคุณเคยพยายามดึงข้อมูลจากหน้าเว็บเป็นร้อยหรือเป็นพันหน้าในคราวเดียว คุณจะรู้เลยว่า “ความเร็ว” กับ “concurrency” คือของจริง และนี่แหละคือจุดแข็งของ Node.js ด้วย asynchronous, non-blocking I/O model ที่ออกแบบมาเพื่อรับมือกับ network requests จำนวนมหาศาล—เรียกได้ว่าเป็นสาย multitask ระดับเทพของโลกเว็บ (Node.js Docs) ในขณะที่ภาษาอื่นอาจยังติดอยู่กับการรอ request แต่ละตัวให้เสร็จ Node.js ก็ยังพา event loop เดินต่อได้เรื่อย ๆ เหมือนนักแสดงละครสัตว์ที่ซัดกาแฟมาเต็มแก้วแล้วหมุนงานพร้อมกันทุกมือ
ผมเคยเห็น Node.js ทำงานได้ดีกว่า Python และ Java ในเคสที่ต้องอัปเดตแบบเรียลไทม์และดึงข้อมูลขนาดใหญ่ โดยเฉพาะตอนเว็บเป้าหมายโหลดด้วย JavaScript หนัก ๆ ที่จริงแล้ว นักพัฒนาประมาณ 40% ตอนนี้ใช้ Node.js กับงาน backend และ automation ทำให้มันกลายเป็นหนึ่งในเทคโนโลยีเว็บที่ฮิตที่สุดในโลก
Node.js เทียบกับ Web Scraping Framework อื่น ๆ
มาลงลึกแบบสายเนิร์ดกันหน่อย นี่คือภาพเทียบ Node.js กับคู่แข่ง:
| Framework | จุดแข็ง | จุดอ่อน | เหมาะกับงานแบบไหน |
|---|---|---|---|
| Node.js | รองรับ async ดีมาก ทำ concurrency ได้เยี่ยม มี npm ecosystem ขนาดใหญ่ ใช้ JS แท้ ๆ กับเว็บไดนามิกได้เลย | กินหน่วยความจำค่อนข้างมาก และอาจเจอ callback hell ถ้าไม่ใช้ async/await | scraping แบบเรียลไทม์ เว็บที่ใช้ JavaScript หนัก ๆ microservices ที่ต้องสเกล |
| Python | มีไลบรารีสาย scraping เยอะมาก (BeautifulSoup, Scrapy) ไวยากรณ์อ่านง่าย | ความ concurrency ขนาดใหญ่ทำได้ช้ากว่า และรับมือเว็บที่ render ด้วย JS ได้ไม่ดีเท่า | HTML แบบ static งานวิจัย การทำต้นแบบ |
| Java | type ชัดเจน เสถียร เหมาะกับงานระดับองค์กร | ค่อนข้าง verbose และยืดหยุ่นน้อยสำหรับสคริปต์เร็ว ๆ | scraping ขนาดใหญ่ระดับ enterprise |
| Go | เร็ว และ concurrency มีประสิทธิภาพ | ecosystem ยังเล็กกว่า และต้องใช้เวลาเรียนรู้มากกว่า | งาน scraping ประสิทธิภาพสูง latency ต่ำ |
สำหรับคนทำธุรกิจส่วนใหญ่ Node.js ตอบโจทย์แบบพอดี ๆ: เร็ว ยืดหยุ่น และปรับเข้ากับเว็บยุคใหม่ที่ขับเคลื่อนด้วย JavaScript ได้ลงตัวสุด ๆ (Thunderbit Blog)
การตั้งสภาพแวดล้อม Node.js สำหรับ Web Scraping ให้แข็งแรง
scraper ที่ดีต้องเริ่มจากฐานที่แน่น นี่คือ setup ที่ผมใช้ประจำ:
- โครงสร้างโปรเจกต์: แยกโมดูลให้ชัด ใช้โฟลเดอร์อย่าง
/src,/libs, และ/configเก็บข้อมูลสำคัญ เช่น API keys และ proxy ไว้ใน environment variables ด้วยdotenv(Thunderbit Guide) - HTTP Client: ใช้ axios, got หรือ node-fetch สำหรับส่ง request
- การ parse HTML: ใช้ Cheerio สำหรับ HTML แบบ static และใช้ Puppeteer หรือ Playwright สำหรับคอนเทนต์แบบ dynamic
- เครื่องมือเสริม: ใช้ Lodash สำหรับจัดการและแปลงข้อมูล และใช้ validator.js หรือ Joi สำหรับตรวจสอบความถูกต้องของข้อมูล
- Testing & Linting: ใช้ Mocha สำหรับทดสอบ และ ESLint สำหรับคุณภาพโค้ด (LogRocket)
ไลบรารี Node.js ที่จำเป็นสำหรับ Web Scraping
- HTTP clients (axios / got / built-in
fetch): สำหรับส่ง request ขอย้ำก่อนว่า ตั้งแต่ Node.js v18 เป็นต้นมา คุณใช้fetchแบบ native ได้เลยโดยไม่ต้องติดตั้งอะไรเพิ่ม และ Node.js v22 ก็ทำให้มันเป็น stable แล้ว ดังนั้นถ้าเป็นโปรเจกต์ใหม่บน Node เวอร์ชันล่าสุด คุณอาจไม่ต้องใช้แพ็กเกจnode-fetchอีกต่อไป — แค่เรียกfetchตรง ๆ ก็พอ ผมยังเลือกใช้ axios เวลาต้องการ interceptors, JSON แบบอัตโนมัติ และ API แบบ promise ที่ใช้ได้ทั้งใน Node และ browser ส่วน got คือเครื่องมือที่ผมหยิบมาใช้เมื่ออยากได้ retries, streams หรือ HTTP/2 แบบพร้อมใช้ เลือกตัวที่เข้ากับ stack ของคุณที่สุด; ถ้าเป็นสคริปต์สั้น ๆfetchแบบ native ก็โอเค - Cheerio: HTML parser ที่เร็วและหน้าตาคล้าย jQuery เหมาะมากกับหน้าแบบ static—parse ได้ในราว 0.5 วินาที (Oxylabs)
- Playwright / Puppeteer: เครื่องมือ browser automation แบบ headless สำหรับเว็บไดนามิกหรือเว็บที่ใช้ JS หนัก ๆ ช้ากว่าเล็กน้อย (~4 วินาทีต่อหน้า) แต่จำเป็นมากสำหรับเว็บที่โหลดข้อมูลหลังหน้าเว็บเปิดแล้ว (Bright Data) ถ้าคุณเริ่มโปรเจกต์ใหม่ในปี 2026 Playwright คือค่าเริ่มต้นที่น่าใช้—รองรับหลายเบราว์เซอร์ตั้งแต่ต้น (Chromium / Firefox / WebKit), มี trace viewer ในตัว และทีมที่เคยสร้าง Puppeteer ก็เป็นทีมเดียวกับที่ดูแล Playwright ที่ Microsoft ตอนนี้ ส่วน Puppeteer ยังมีการดูแลอยู่สำหรับงานที่เน้น Chrome-only แต่ช่วงหลัง release notes จะเน้นอัปเดตเรื่องความเข้ากันได้กับ Chrome มากกว่าฟีเจอร์ใหม่ ๆ อยู่พอสมควร
- dotenv: สำหรับจัดการ environment variables
- csv-writer/jsonfile: สำหรับส่งออกข้อมูล
หลีกเลี่ยงกับดักที่พบบ่อยในการทำ Node.js Web Scraping
ผมจำไม่ได้แล้วว่ากี่ครั้งที่เห็น scraper โดนบล็อก ล่ม หรือไม่ก็ทิ้งข้อมูลเละเทะไว้เป็นกอง ต่อไปนี้คือสิ่งที่ควรระวัง:
- เมิน robots.txt และ Terms of Service: ตรวจสอบก่อนเสมอ การละเมิดอาจทำให้ IP ถูกแบน หรือแย่กว่านั้นคือมีปัญหาทางกฎหมายตามมา (ScraperAPI)
- ยิง request หนักเกินไป: อย่ารัว request แบบไม่ยั้ง ควร throttle scraper ด้วยดีเลย์แบบสุ่ม (1–3 วินาที), ใช้การควบคุม concurrency และอย่าทำตัวเหมือนหุ่นยนต์ที่คึกเกินเหตุ (ScrapeGraphAI)
- ไม่จัดการ error: ห่อ request ด้วย try/catch เสมอ รับมือ HTTP errors และ log ความผิดพลาดไว้ด้วย สำหรับ error ชั่วคราวให้ retry แบบ exponential backoff (ScrapeGraphAI)
- ลืมตั้ง request headers: ใช้ User-Agent ที่สมจริงและสลับเปลี่ยนบ่อย ๆ เพิ่ม Accept-Language, Referer และ header อื่น ๆ เพื่อเลียนแบบ browser จริง (ScrapeGraphAI)
วิธีหลบกลไกป้องกันการ Scraping
เว็บไซต์สมัยใหม่ติดอาวุธป้องกันบอทมาแน่นมาก นี่คือวิธีที่ผมใช้หลบกับดักดิจิทัลพวกนี้:
- สลับ proxy/IP: ใช้ proxy pool และหมุน IP ไปเรื่อย ๆ เพื่อลดโอกาสถูกแบน (Medium)
- สุ่ม headers: สลับ User-Agent, Accept-Language และ header อื่น ๆ ทุก request
- ทำให้ headless browser ดูไม่เหมือนบอท: ใช้ปลั๊กอินอย่าง
puppeteer-extra-plugin-stealthเพื่อซ่อนร่องรอย automation - จำลองพฤติกรรมมนุษย์: ใส่ดีเลย์แบบสุ่ม, การขยับเมาส์, การเลื่อนหน้า และแม้แต่การพิมพ์ผิดบ้างเป็นบางครั้ง (ZenRows)
การจำลองพฤติกรรมมนุษย์ใน Node.js Scraper
ตรงนี้แหละที่เริ่มสนุกและแปลกนิด ๆ แทนที่จะคลิกและเลื่อนแบบทันที ให้สคริปต์ scraper ของคุณทำแบบนี้:
- รอแบบสุ่มระหว่างแต่ละ action (
await page.waitForTimeout(randomDelay)) - ขยับเมาส์เป็นช่วงสั้น ๆ แบบสั่นนิด ๆ (
page.mouse.move(x, y)) - พิมพ์ด้วยดีเลย์สุ่ม และมีพิมพ์ผิดบ้างเป็นครั้งคราว (
page.type(selector, text, {delay: random(100,200)})) - เลื่อนหน้าจอแบบไม่สม่ำเสมอ ไม่ใช่เลื่อนลงล่างสุดทีเดียว
เทคนิคเหล่านี้ช่วยเพิ่มอัตราความสำเร็จบนเว็บที่มีการป้องกันสูงได้มาก (ScraperAPI)
ทำให้การดึงข้อมูลซับซ้อนง่ายขึ้นด้วย Thunderbit
ดึงข้อมูลจากทุกเว็บไซต์ด้วย AI ตัดขั้นตอนจุกจิกออกไป: Thunderbit's agentic web scraper อ่านหน้าเว็บใดก็ได้และดึงข้อมูลได้ในคลิกเดียว โดยไม่ต้องดูแลโค้ด Node.js เอง Get Started Free
มาคุยกันตรง ๆ เรื่องช้างในห้อง: scraping มันยาก แต่ไม่ได้แปลว่าต้องยากเสมอไป และนี่คือเหตุผลที่เราสร้าง Thunderbit
Thunderbit คือ Chrome Extension สำหรับ agentic web scraper ที่ให้คุณดึงข้อมูลจากเว็บไซต์ใดก็ได้ด้วยภาษาธรรมดา แค่คลิก “One Click Extract” ให้ AI ช่วยตีความว่าหน้านั้นมีอะไรอยู่ แล้วกด “Scrape” ก็จบ มันเหมือนมี junior developer ที่ไม่เคยหลับและไม่เคยขอขึ้นเงินเดือน
ที่ดีกว่านั้น Thunderbit มี API ให้เชื่อมเข้ากับ workflow ของ Node.js ได้ทันที แทนที่จะต้องเขียนโค้ด scraping เป็นพันบรรทัด คุณสามารถให้ Thunderbit รับงานหนักแทนได้—ทั้งคอนเทนต์แบบ dynamic, subpages, pagination และอื่น ๆ แล้วคุณก็แค่ดึงข้อมูลที่จัดโครงสร้างแล้วออกมาในรูป CSV, JSON หรือส่งตรงไป Google Sheets, Airtable, Notion แล้วไปทำงานต่อได้เลย (Thunderbit Blog)
ลองใช้ Thunderbit Chrome Extension ฟรี ติดตั้ง Chrome Extension ฟรี แล้วดึงข้อมูลแบบมีโครงสร้างได้ในคลิกเดียว — หรือเรียกใช้ Thunderbit API จากแอป Node.js ของคุณ Get Started Free
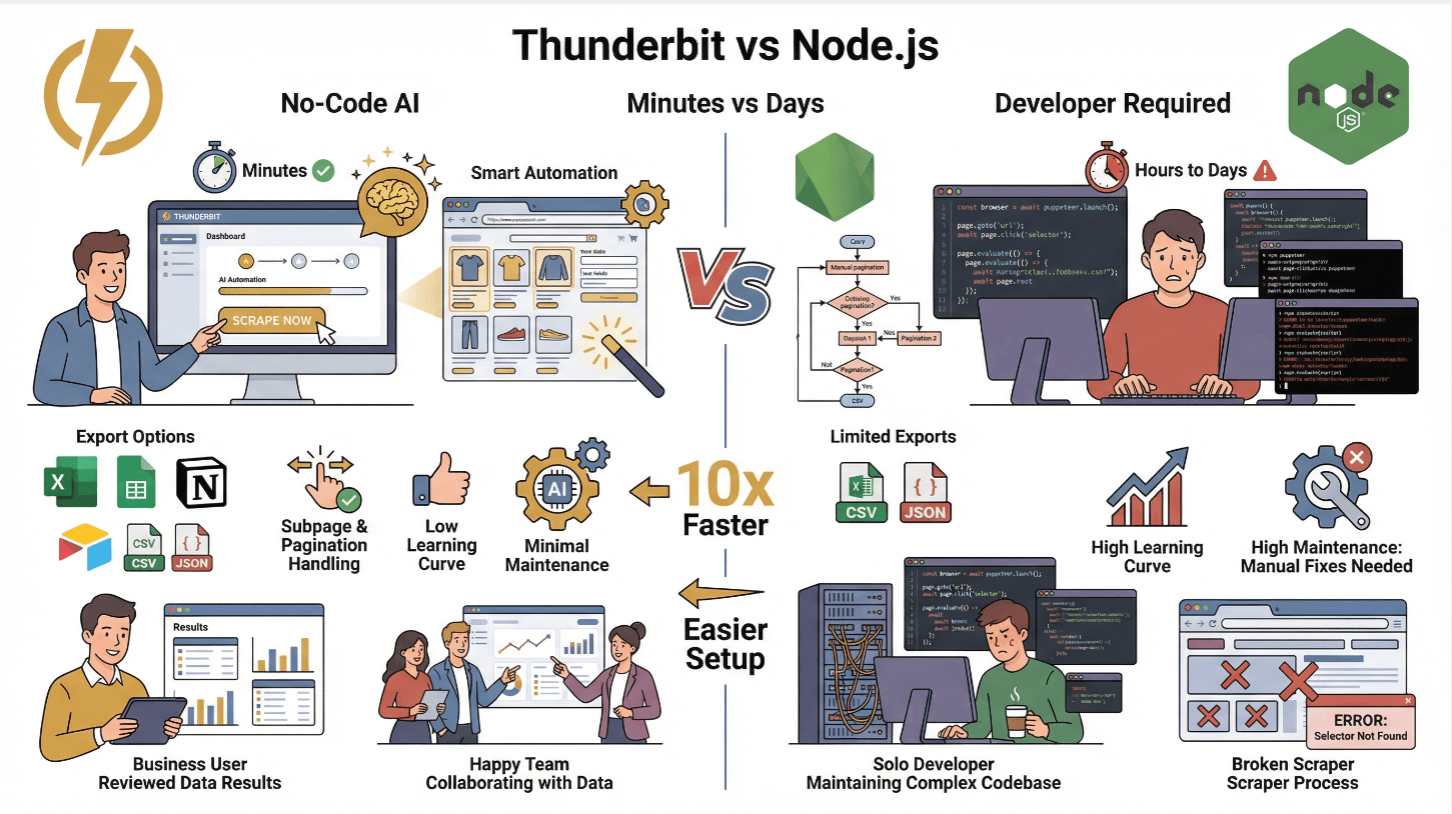
Thunderbit เทียบกับการ Scraping ด้วย Node.js แบบดั้งเดิม
| ฟีเจอร์ | Thunderbit | Node.js Scraper แบบดั้งเดิม |
|---|---|---|
| เวลาในการเริ่มต้น | ไม่กี่นาที (ไม่ต้องเขียนโค้ด) | หลายชั่วโมงถึงหลายวัน (เขียน ทดสอบ) |
| รองรับคอนเทนต์แบบไดนามิก | ได้ (AI + browser) | ได้ (ด้วย Puppeteer/Playwright) |
| Subpage & Pagination | คลิกครั้งเดียว | ต้องเขียนโค้ดเอง |
| การส่งออกข้อมูล | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (โค้ดกำหนดเอง) |
| ความยากในการเรียนรู้ | ต่ำ (เหมาะกับผู้ใช้สายธุรกิจ) | สูง (สำหรับนักพัฒนา) |
| การดูแลรักษา | น้อยมาก (AI ปรับตัวให้) | สูง (ต้องแก้โค้ดเมื่อเว็บเปลี่ยน) |
Thunderbit เหมาะมากสำหรับทีมที่ไม่ถนัดเทคนิค หรือใครก็ตามที่อยากข้ามงานจุกจิกไปโฟกัสกับ insight แทน สำหรับผู้ใช้ขั้นสูง คุณก็ยังใช้ API ของ Thunderbit เพื่ออัตโนมัติการ scraping ในสเกลใหญ่ได้เหมือนเดิม (Thunderbit Docs)
ผสาน Cheerio กับ Puppeteer สำหรับคอนเทนต์แบบ Dynamic
นี่คือคู่หูสุดโหดที่ผมชอบที่สุดสำหรับ Node.js scraping วิธีทำงานคือ:
- ใช้ Puppeteer โหลดหน้าเว็บและรัน JavaScript (รอ
networkidleเพื่อให้แน่ใจว่าคอนเทนต์โหลดครบ) - ดึง HTML ด้วย
await page.content() - parse ด้วย Cheerio: ป้อน HTML เข้า Cheerio เพื่อ parse และดึงข้อมูลแบบเร็วมากในสไตล์ jQuery
แนวทางแบบไฮบริดนี้ทำให้คุณได้ทั้งสองโลก: พลังของ Puppeteer สำหรับคอนเทนต์ไดนามิก และความเร็วของ Cheerio สำหรับการ parse (Browserless)
ทิปด้านประสิทธิภาพ: เลือกเฉพาะ element ที่ต้องใช้เท่านั้น Cheerio จะโหลด DOM ทั้งหมดเข้า memory ดังนั้นอย่าใช้ selector กว้างเกินไป และควร cache ผลลัพธ์ถ้าต้อง scrape หน้าเดิมซ้ำ ๆ (Oxylabs)
เพิ่มประสิทธิภาพ HTML Parsing และ Data Extraction
- ใช้ selector ให้เฉพาะเจาะจง: หลีกเลี่ยง
$('body *')— เลือกเฉพาะสิ่งที่ต้องการจริง ๆ - สตรีมหน้าใหญ่: ถ้า HTML ใหญ่มาก ให้พิจารณา streaming หรือแบ่งงานออกเป็นส่วน ๆ
- แคช HTML ที่ render แล้ว: ถ้าคุณกลับไปที่ URL เดิมบ่อย ๆ ให้เก็บ HTML ไว้เพื่อลด request ซ้ำ
- ตรวจสอบและทำความสะอาดข้อมูล: ใช้ validator library เพื่อกันไม่ให้ฐานข้อมูลเต็มไปด้วยขยะ (ScrapeGraphAI)
การ Deploy Node.js Web Scraper แบบสเกลใหญ่บนคลาวด์
ถ้าจะ scrape ระดับใหญ่ ก็ถึงเวลาขึ้นคลาวด์แล้ว
- ทำให้ scraper อยู่ใน Docker: เขียน
Dockerfile, copy โค้ดของคุณ, ติดตั้ง dependencies และตั้ง entrypoint - Deploy ไปคลาวด์: ใช้ AWS EC2, Google Cloud Compute หรือ Azure VM สำหรับงานที่ไม่ซับซ้อนมาก ถ้าต้องการสเกลจริงจัง ให้ใช้ Kubernetes หรือบริการจัดการอย่าง AWS ECS/EKS, Google Cloud Run หรือ Azure Kubernetes Service (DigitalOcean)
- จัดการด้วย Kubernetes: รันหลาย pod, autoscale ตาม demand และใช้ load balancer กระจาย URL
- ตั้งตารางงาน: ใช้ cloud scheduler (CloudWatch Events, Cloud Scheduler) หรือ cron job เพื่อเรียก scraping เป็นรอบ ๆ
ในตัวอย่างจากโลกจริง การขยายจาก 5 ไปเป็น 10 Kubernetes pods ช่วยลดเวลาการ scrape 400 หน้า จากหลายนาทีเหลือไม่ถึงหนึ่งนาที (DigitalOcean)
การมอนิเตอร์และ Auto-Scaling โครงสร้างพื้นฐานของ Scraping
- Logging: ส่ง log ไปที่ CloudWatch, Stackdriver หรือ Datadog และตั้งแจ้งเตือนเมื่อเกิด error หรือช้าลง
- Health checks: ใช้ Prometheus และ Grafana วัด metric เช่น จำนวนหน้าที่ scrape ได้ต่อนาที, อัตรา error และสถานะของ pod
- Auto-scaling: ตั้งค่า Kubernetes HPA (Horizontal Pod Autoscaler) เพื่อขยาย/ลด pod ตาม CPU หรือจำนวน request
อย่าลืมทำ retry ด้วย exponential backoff เสมอ เพื่อรับมือกับ network hiccups หรือการถูกบล็อกชั่วคราว
แนวทางที่ดีที่สุดสำหรับการเก็บและประมวลผลข้อมูลหลัง Scraping
เมื่อคุณดึงข้อมูลมาแล้ว ขั้นต่อไปคือเก็บและทำความสะอาดข้อมูล:
- งานขนาดเล็ก: ส่งออกเป็น CSV, JSON หรืออัปโหลดไป Google Sheets, Airtable หรือ Notion ได้เลย (Thunderbit ทำได้ตั้งแต่ต้น)
- งานขนาดใหญ่: ใช้ SQL (MySQL/PostgreSQL) สำหรับข้อมูลแบบมีโครงสร้าง หรือ NoSQL (MongoDB, DynamoDB) สำหรับข้อมูลกึ่งโครงสร้างหรือ schema ที่เปลี่ยนได้ (ScrapeHero)
- Cloud storage: ใช้ S3 หรือ Google Cloud Storage สำหรับไฟล์ดิบและ backup
- การทำความสะอาดข้อมูล: ตรวจสอบฟิลด์เสมอ ปรับรูปแบบให้เป็นมาตรฐาน (วันที่ ตัวเลข) และลบข้อมูลซ้ำ ใช้ schema validator เพื่อคุมคุณภาพข้อมูล (ScrapeGraphAI)
ควรเก็บทั้งข้อมูลดิบและข้อมูลที่ทำความสะอาดแล้วไว้ด้วย—เพราะคุณไม่มีวันรู้ว่าตอนไหนจะต้อง reprocess หรือ debug มัน
บทสรุป: ข้อสรุปสำคัญสำหรับประสิทธิภาพการ Web Scraping ด้วย Node.js
ข้ามขั้นตอนเขียนโค้ด Scraper ดูว่า Thunderbit's agentic web scraper เปรียบเทียบกับการเขียนและดูแลสคริปต์ scraping ของคุณเองอย่างไร Get Started Free
สรุปประเด็นหลักกันแบบเร็ว ๆ:
- ใช้พลัง async ของ Node.js สำหรับ scraping ปริมาณมากและ concurrency สูง โดยเฉพาะบนเว็บที่ใช้ JavaScript หนัก ๆ
- เลือกเครื่องมือให้เหมาะและผสมให้ลงตัว: ใช้ axios/got สำหรับ request, Cheerio สำหรับ HTML แบบ static, Puppeteer สำหรับคอนเทนต์ dynamic และผสมกันเพื่อได้ทั้งความเร็วและความยืดหยุ่น
- หลบกับดัก anti-bot: หมุน proxy และ headers, จำลองพฤติกรรมมนุษย์ และเคารพ robots.txt
- ทำให้ง่ายด้วย Thunderbit: สำหรับผู้ใช้ธุรกิจหรือการทำต้นแบบอย่างรวดเร็ว Thunderbit ช่วยให้คุณดึงข้อมูลซับซ้อนด้วย AI และเชื่อมเข้ากับ Node.js stack ผ่าน API ได้ทันที
- Deploy ให้สเกลได้: ใช้ Docker, orchestrate ด้วย Kubernetes และมอนิเตอร์ทุกอย่างเพื่อความเสถียร
- เก็บและทำความสะอาดข้อมูล: เลือกที่เก็บข้อมูลให้เหมาะกับงาน และตรวจสอบความถูกต้องก่อนใช้งานเสมอ
เว็บไม่ได้จะง่ายขึ้นเอง แต่ถ้าคุณใช้ best practices เหล่านี้ Node.js scrapers ของคุณก็จะเร็ว เสถียร และนำหน้าการแข่งขันด้าน anti-bot ไปอีกก้าว และถ้าวันไหนคุณเบื่อการ debug selector ตอนตีสอง ให้จำไว้ว่า AI ของ Thunderbit พร้อมทำงานอยู่ตลอดเวลา
อยากเรียนรู้ต่อไหม? ลองดู Thunderbit Blog สำหรับบทความเชิงลึกเพิ่มเติม หรือทดลองใช้ Thunderbit’s Chrome Extension เพื่อดูว่าการ scraping ทำได้ง่ายแค่ไหน
Scrape ด้วย Thunderbit Agentic Web Scraper Thunderbit's Web Scraper API ให้คุณสั่งเริ่มการดึงข้อมูลจากโค้ด Node.js ของคุณเองได้ พร้อมแพ็กเกจฟรีสำหรับเริ่มต้น Get Started Free
คำถามที่พบบ่อย
1. ทำไม Node.js ถึงเหมาะกับการทำ web scraping ในปี 2025 เป็นพิเศษ?
โมเดลแบบ asynchronous และ event-driven ของ Node.js ทำให้รองรับ request พร้อมกันได้เป็นพัน ๆ รายการ จึงเหมาะมากสำหรับการดึงข้อมูลจำนวนมากหรือข้อมูลอัปเดตแบบเรียลไทม์ npm ecosystem ที่ใหญ่ และการรองรับ JavaScript แบบ native ก็เข้ากันได้ดีกับเว็บไซต์ยุคใหม่ที่ใช้ JS หนัก ๆ (Node.js Docs)
2. จะหลีกเลี่ยงการถูกบล็อกเวลาทำ scraping ด้วย Node.js ได้อย่างไร?
ใช้ proxy แบบหมุนเวียน สุ่ม request headers ควบคุมความถี่ของ request ด้วยดีเลย์แบบสุ่ม และจำลองพฤติกรรมมนุษย์ เช่น การขยับเมาส์ เลื่อนหน้า และพิมพ์ ด้วยเครื่องมืออย่าง Puppeteer รวมถึงต้องเคารพ robots.txt และเงื่อนไขของเว็บไซต์เสมอ (Medium)
3. ควรใช้ Cheerio หรือ Puppeteer เมื่อไรใน Node.js scraper?
ใช้ Cheerio สำหรับ parse HTML แบบ static อย่างรวดเร็ว เมื่อข้อมูลอยู่ใน HTML ดิบอยู่แล้ว ใช้ Puppeteer สำหรับเว็บที่โหลดคอนเทนต์ด้วย JavaScript แบบ dynamic ถ้าอยากได้ผลลัพธ์ดีที่สุด ให้ใช้ Puppeteer render หน้าเว็บก่อน แล้วค่อยใช้ Cheerio parse HTML ต่อ (Bright Data)
4. Thunderbit ช่วยทำให้การ scraping ด้วย Node.js ง่ายขึ้นอย่างไร?
Thunderbit ให้คุณดึงข้อมูลแบบมีโครงสร้างจากเว็บไซต์ใดก็ได้ด้วย AI และ prompt ภาษาธรรมดา โดยไม่ต้องเขียนโค้ด มันรองรับคอนเทนต์แบบ dynamic, subpages และ pagination พร้อม API สำหรับเชื่อมกับ Node.js และสามารถส่งออกข้อมูลไป Excel, Google Sheets, Airtable หรือ Notion ได้โดยตรง (Thunderbit Blog)
5. วิธีที่ดีที่สุดในการสเกลและมอนิเตอร์ Node.js scraper บนคลาวด์คืออะไร?
ทำให้ scraper อยู่ใน Docker, deploy บน Kubernetes หรือบริการคลาวด์แบบ managed และใช้ auto-scaling เพื่อรองรับทราฟฟิกที่พุ่งขึ้น มอนิเตอร์ log และ metric ด้วยเครื่องมืออย่าง CloudWatch หรือ Prometheus และตั้ง alert สำหรับ error หรือความล่าช้า (DigitalOcean)
พร้อมยกระดับการทำ web scraping แล้วหรือยัง? ลองใช้ Thunderbit ดู แล้วขอให้ scraper ของคุณเร็ว แฝงตัวเก่ง และนำหน้าคู่แข่งเสมอ
ลองใช้ Agentic Web Scraper Get Started Free
เรียนรู้เพิ่มเติม




