
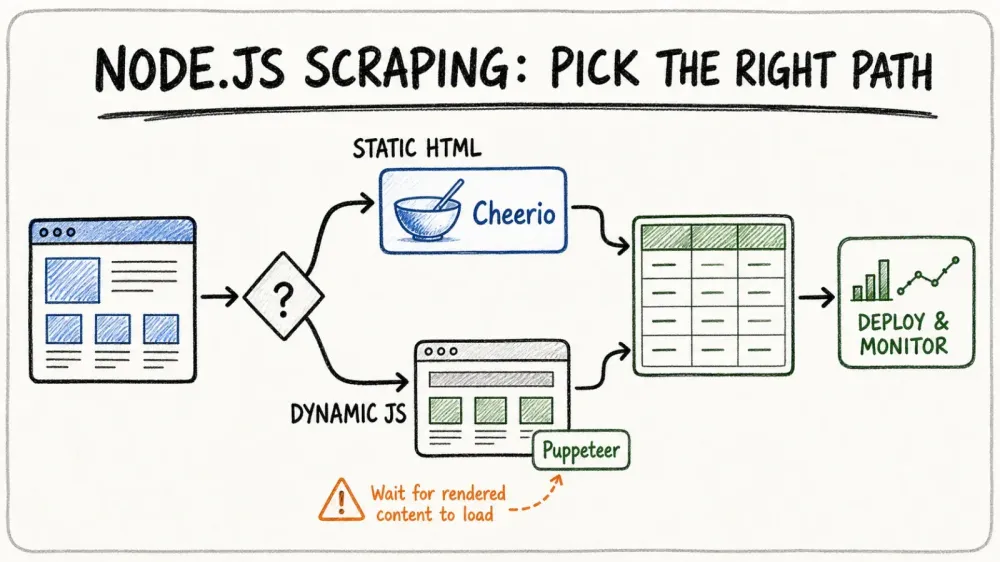
Webben är hungrigare efter data än någonsin, och 2026 ligger Node.js i framkant för team som vill skrapa smartare, inte bara hårdare. Oavsett om du jobbar med försäljning, e-handel eller bara är en datanörd som jag, har du säkert märkt att skrapning inte längre bara handlar om att “få fram grejerna” — det handlar om att göra det snabbt, i stor skala och utan att din IP hamnar i digital karantän. Efterfrågan minskar inte heller; offentliga webdata har i det tysta blivit grunden som många moderna team bygger vidare på, från prisintelligens till träningspipelines för LLM:er, och både insatserna och konkurrensen har aldrig varit högre.
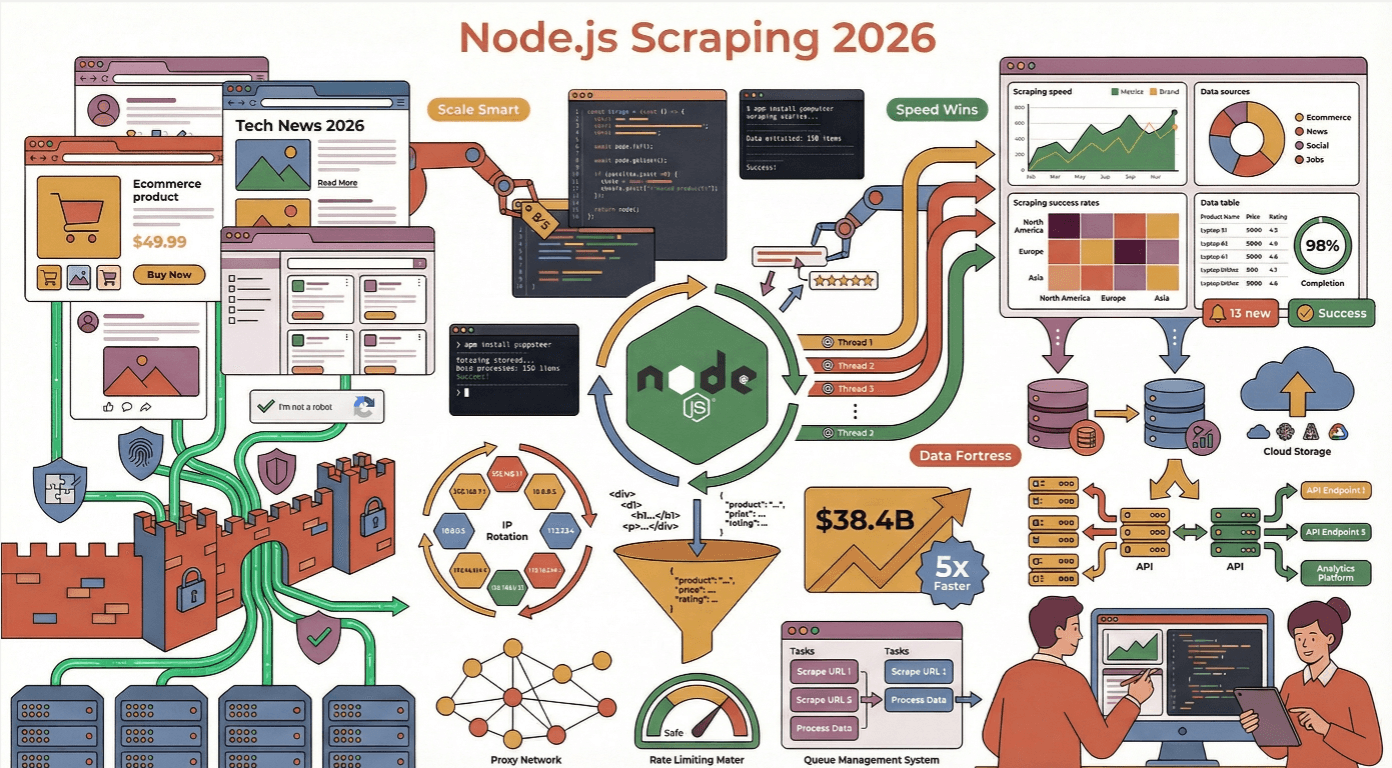
Men här kommer knuten: den moderna webben är en fästning av dynamiskt innehåll, anti-bot-fällor och layouter som ändras hela tiden. Jag har sett fler skrapare gå upp i rök än jag vill erkänna — oftast för att de struntade i bästa praxis eller underskattade hur smarta skydden mot skrapning har blivit. Så låt oss gå igenom verkliga bästa metoder för effektiv webbskrapning med Node.js, med några historier, en nypa humor och massor av konkret, användbar rådgivning.
Varför välja Node.js för effektiv webbskrapning?
Om du någon gång har försökt skrapa hundratals eller tusentals sidor samtidigt vet du att hastighet och samtidighet är allt. Där glänser Node.js. Dess asynkrona, icke-blockerande I/O-modell är byggd för att hantera enorma mängder samtidiga nätverksförfrågningar — tänk på det som webbsidornas ultimata multitaskmaskin. Medan andra språk kan fastna i väntan på att varje begäran ska bli klar, fortsätter Node.js bara att snurra sin event loop och jonglerar förfrågningar som en koffeindriven cirkusartist.
Jag har sett Node.js slå både Python och Java i scenarier där realtidsuppdateringar och storskalig extraktion krävs, särskilt när målsajterna är fulla av JavaScript. Faktum är att ~40% av utvecklare nu använder Node.js för backend- och automationsuppgifter, vilket gör det till världens mest populära webteknik.
Node.js jämfört med andra ramverk för webbskrapning
Låt oss bli lite nördiga en stund. Så här står sig Node.js mot konkurrenterna:
| Ramverk | Styrkor | Svagheter | Bästa användningsområden |
|---|---|---|---|
| Node.js | Asynkront, utmärkt för samtidighet, stort npm-ekosystem, inbyggd JS för dynamiska sajter | Kan bli minneshungrigt, callback-helvete (om du inte använder async/await) | Skrapning i realtid, JS-tunga sajter, skalbara mikrotjänster |
| Python | Massor av skrapbibliotek (BeautifulSoup, Scrapy), enkel syntax | Långsammare vid massiv samtidighet, har svårt med JS-renderade sajter | Statisk HTML, research, prototyper |
| Java | Stark typning, robust för enterprise | Verbos, mindre flexibelt för snabba skript | Storskalig skrapning på enterprise-nivå |
| Go | Snabbt, effektiv samtidighet | Mindre ekosystem, brantare inlärningskurva | Högpresterande skrapning med låg latens |
För de flesta affärsanvändare träffar Node.js mitt i prick: snabbt, flexibelt och perfekt anpassat till den moderna, JavaScript-drivna webben (Thunderbit Blog).
Så bygger du en robust miljö för webbskrapning med Node.js
En bra skrapare börjar med en stabil grund. Här är min favoritsetup:
- Projektstruktur: Håll det modulärt. Använd mappar som
/src,/libsoch/config. Lägg känslig information (API-nycklar, proxies) i miljövariabler meddotenv(Thunderbit Guide). - HTTP-klient: Använd axios, got eller node-fetch för förfrågningar.
- HTML-parsning: Cheerio för statisk HTML, Puppeteer eller Playwright för dynamiskt innehåll.
- Verktyg: Använd Lodash för datarensning och validator.js eller Joi för datavalidering.
- Testning och lintning: Mocha för tester, ESLint för kodkvalitet (LogRocket).
Viktiga bibliotek för webbskrapning med Node.js
- HTTP-klienter (axios / got / inbyggd
fetch): För att skicka förfrågningar. Värt att säga direkt: sedan Node.js v18 kan du användafetchnativt utan att installera något, och i Node.js v22 blev det stabilt. I ett nytt projekt på en modern Node-version behöver du troligen inte paketetnode-fetchalls — anropa barafetchdirekt. Jag använder fortfarande axios när jag vill ha interceptors, automatisk JSON-hantering och ett bekant promise-API som funkar både i Node och webbläsaren, medan got är mitt val när jag behöver retries, streams eller HTTP/2 direkt. Välj det som passar din stack; för ett snabbt skript räcker nativefetchfint. - Cheerio: Snabb HTML-parser med jQuery-lik känsla. Perfekt för statiska sidor — parsar på cirka 0,5 sekunder (Oxylabs).
- Playwright / Puppeteer: Headless browser-automation för dynamiska, JS-tunga sajter. Långsammare (~4 sekunder per sida), men nödvändigt för sajter som laddar innehåll efter sidladdning (Bright Data). Om du börjar från noll 2026 är Playwright standardvalet — det fungerar direkt i flera webbläsare (Chromium / Firefox / WebKit), har inbyggd trace viewer, och teamet som ursprungligen byggde Puppeteer driver nu utvecklingen hos Microsoft. Puppeteer underhålls fortfarande för jobb som bara riktar sig till Chrome, men versionsnotiserna har på sistone lutat mer åt kompatibilitetsuppdateringar för Chrome än nya funktioner.
- dotenv: För hantering av miljövariabler.
- csv-writer/jsonfile: För att exportera data.
Undvik vanliga fallgropar vid webbskrapning med Node.js
Jag har tappat räkningen på hur många gånger jag har sett skrapare bli blockerade, krascha eller bara spotta ur sig en hög med rörig data. Det här bör du hålla utkik efter:
- Ignorera robots.txt och användarvillkor: Kontrollera alltid innan du skrapar. Om du bryter mot detta kan din IP bli bannlyst — eller värre, du kan hamna i juridiskt trubbel (ScraperAPI).
- Överbelasta servrar: Skicka inte iväg för många förfrågningar på en gång. Begränsa din skrapare med slumpmässiga fördröjningar (1–3 sekunder), använd kontroll för samtidighet och bete dig inte som en hyperaktiv robot (ScrapeGraphAI).
- Hantera inte fel: Omslut alltid förfrågningar i try/catch, hantera HTTP-fel och logga misslyckanden. Försök igen vid tillfälliga fel med exponentiell backoff (ScrapeGraphAI).
- Glömma request headers: Använd realistiska User-Agent-strängar och rotera dem. Lägg till Accept-Language, Referer och andra headers för att efterlikna riktiga webbläsare (ScrapeGraphAI).
Så kringgår du anti-skrapningsmekanismer
Moderna sajter är beväpnade till tänderna med anti-bot-teknik. Så här undviker jag de digitala minorna:
- Rotera proxies/IP-adresser: Använd en proxy-pool och rotera IP:er för att undvika bannlysningar (Medium).
- Variera headers: Rotera User-Agent, Accept-Language och andra headers för varje förfrågan.
- Stealth i headless browser: Använd plugins som
puppeteer-extra-plugin-stealthför att dölja automationssignaturer. - Simulera mänskligt beteende: Lägg in slumpmässiga pauser, musrörelser, scrollning och till och med skrivfel (ZenRows).
Simulera mänskligt beteende i Node.js-skrapare
Det här är där det blir roligt — och lite märkligt. I stället för att klicka och scrolla direkt kan du låta din skrapare:
- Vänta slumpmässiga intervaller mellan åtgärder (
await page.waitForTimeout(randomDelay)) - Flytta musen i små, skakiga steg (
page.mouse.move(x, y)) - Skriva med slumpmässiga fördröjningar och ibland felskrivningar (
page.type(selector, text, {delay: random(100,200)})) - Scrolla ojämnt, inte bara hela vägen ner
De här knepen kan dramatiskt förbättra din träffsäkerhet på skyddade sajter (ScraperAPI).
Förenkla komplex datainsamling med Thunderbit
Skrapa data från vilken webbplats som helst med AI Hoppa över standardkoden: Thunderbits agentiska webbskrapare läser vilken sida som helst och extraherar data med ett klick, utan Node.js-kod att underhålla. Get Started Free
Nu till elefanten i rummet: skrapning är svårt. Men det behöver inte vara det. Därför byggde vi Thunderbit.
Thunderbit är ett agentiskt webbskrapartillägg för Chrome som låter dig extrahera data från vilken webbplats som helst med vanlig engelska. Klicka bara på “One Click Extract”, låt AI:n tolka sidan och tryck på “Scrape”. Det är som att ha en juniorutvecklare som aldrig sover och aldrig ber om löneförhöjning.
Ännu bättre: Thunderbit erbjuder ett API, så du kan koppla in det direkt i dina Node.js-flöden. I stället för att skriva tusentals rader skrapkod kan du låta Thunderbit ta hand om det tunga arbetet — dynamiskt innehåll, undersidor, paginering och allt däremellan. Du hämtar bara den strukturerade datan (CSV, JSON eller direkt till Google Sheets, Airtable, Notion) och går vidare med dagen (Thunderbit Blog).
Testa Thunderbit Chrome-tillägget gratis Installera det kostnadsfria Chrome-tillägget och extrahera strukturerad data med ett klick — eller anropa Thunderbits API från din Node.js-app. Get Started Free
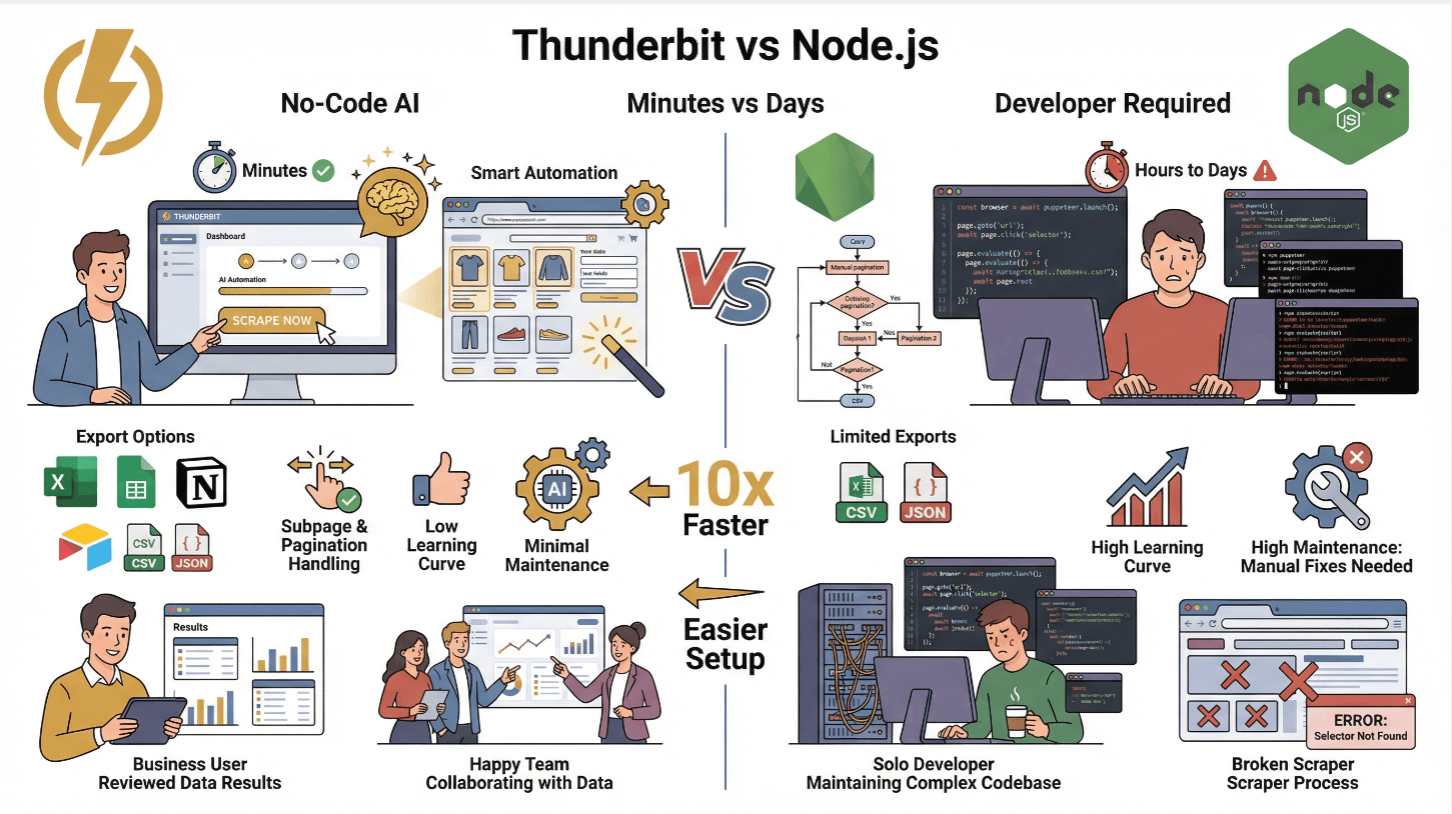
Thunderbit jämfört med traditionell Node.js-skrapning
| Funktion | Thunderbit | Traditionell Node.js-skrapare |
|---|---|---|
| Installationstid | Minuter (ingen kod) | Timmar till dagar (kodning, testning) |
| Hantera dynamiskt innehåll | Ja (AI + webbläsare) | Ja (med Puppeteer/Playwright) |
| Undersidor och paginering | Ett klick | Kräver manuell kodning |
| Dataexport | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (egen kod) |
| Inlärningskurva | Låg (affärsanvändare) | Hög (utvecklare) |
| Underhåll | Minimalt (AI anpassar sig) | Hög (manuella fixar vid sajtändringar) |
Thunderbit är perfekt för team utan teknisk bakgrund eller för alla som vill slippa grovjobbet och i stället fokusera på insikter. För avancerade användare går det fortfarande utmärkt att använda Thunderbits API för att automatisera skrapning i stor skala (Thunderbit Docs).
Kombinera Cheerio och Puppeteer för dynamiskt innehåll
Det här är min favoritkombo för Node.js-skrapning. Så här fungerar den:
- Använd Puppeteer för att ladda sidan och köra JavaScript (vänta på
networkidleså att allt innehåll hinner laddas). - Hämta HTML med
await page.content(). - Parsa med Cheerio: Mata HTML:en till Cheerio för ultrasnabb, jQuery-lik parsning och datautvinning.
Det här hybrida upplägget ger dig det bästa av två världar: Puppeteers styrka för dynamiskt innehåll och Cheerios hastighet för parsning (Browserless).
Prestandatips: Välj bara de element du faktiskt behöver. Cheerio lägger hela DOM:en i minnet, så undvik breda selektorer och cacha resultat om du skrapar samma sidor om och om igen (Oxylabs).
Optimera HTML-parsning och dataextraktion
- Använd specifika selektorer: Undvik
$('body *')— rikta in dig bara på det du behöver. - Strömma stora sidor: För enorm HTML kan du överväga streaming eller att dela upp jobbet.
- Cacha renderad HTML: Om du besöker samma URL:er igen, cacha HTML:en för att undvika onödiga anrop.
- Validera och rensa data: Använd valideringsbibliotek för att inte fylla databasen med skräp (ScrapeGraphAI).
Skala ut din Node.js-webbskrapare i molnet
Skrapa i stor skala? Då är det dags att tänka cloud-native.
- Dockerisera din skrapare: Skriv en
Dockerfile, kopiera in din kod, installera beroenden och ange entrypoint. - Distribuera i molnet: Använd AWS EC2, Google Cloud Compute eller Azure VMs för enklare jobb. För riktig skala, använd Kubernetes eller hanterade tjänster som AWS ECS/EKS, Google Cloud Run eller Azure Kubernetes Service (DigitalOcean).
- Orkestrera med Kubernetes: Kör flera pods, autoskala efter behov och använd lastbalanserare för att fördela URL:er.
- Schemalägg jobb: Använd molnschemaläggare (CloudWatch Events, Cloud Scheduler) eller cron-jobb för att trigga skrapningar med jämna mellanrum.
I ett verkligt exempel kapade man genom att skala från 5 till 10 Kubernetes-pods tiden för en skrapning av 400 sidor från flera minuter till under en minut (DigitalOcean).
Övervaka och autoskala din skrapinfrastruktur
- Loggning: Strömma loggar till CloudWatch, Stackdriver eller Datadog. Sätt larm för fel eller långsamhet.
- Hälsokontroller: Använd Prometheus och Grafana för mätvärden som sidor skrapade per minut, felfrekvens och poddhälsa.
- Autoskalning: Sätt upp Kubernetes HPA (Horizontal Pod Autoscaler) för att skala pods baserat på CPU eller antal förfrågningar.
Implementera alltid retries med exponentiell backoff för att återhämta dig från nätverksproblem eller tillfälliga blockeringar.
Bästa praxis för lagring och efterbearbetning av data
När du har skrapat datan behöver du lagra och städa den:
- Små jobb: Exportera till CSV, JSON eller skicka till Google Sheets, Airtable eller Notion (Thunderbit gör detta direkt).
- Stora jobb: Använd SQL (MySQL/PostgreSQL) för strukturerad data, eller NoSQL (MongoDB, DynamoDB) för halvstrukturerade eller föränderliga scheman (ScrapeHero).
- Molnlagring: S3 eller Google Cloud Storage för råfiler och säkerhetskopior.
- Datastädning: Validera alltid fält, normalisera format (datum, siffror) och ta bort dubbletter. Använd schema-validering för att säkerställa datakvalitet (ScrapeGraphAI).
Spara både rådata och rensad data — du vet aldrig när du behöver bearbeta om eller felsöka.
Slutsats: Viktiga lärdomar för effektiv webbskrapning med Node.js
Slipp skrapkodens slit Se hur Thunderbits agentiska webbskrapare står sig mot att skriva och underhålla dina egna skrapskript. Get Started Free
Låt oss avrunda med det viktigaste:
- Utnyttja Node.js asynkrona styrka för massiv, samtidig skrapning — särskilt på JS-tunga sajter.
- Kombinera rätt verktyg: Använd axios/got för förfrågningar, Cheerio för statisk HTML, Puppeteer för dynamiskt innehåll och blanda dem för fart och flexibilitet.
- Undvik anti-bot-fällor: Rotera proxies och headers, simulera mänskligt beteende och respektera robots.txt.
- Förenkla med Thunderbit: För affärsanvändare eller snabb prototypning låter Thunderbit dig extrahera komplex data med AI och koppla in den i din Node.js-stack via API.
- Skala upp smart: Dockerisera, orkestrera med Kubernetes och övervaka allt för stabil drift.
- Lagra och rensa din data: Välj rätt lagring för ditt behov och validera alltid innan du använder datan.
Webben blir inte enklare, men med de här bästa metoderna kan dina Node.js-skrapare förbli snabba, pålitliga och alltid ligga steget före kapprustningen mot anti-bot-skydd. Och om du någon gång tröttnar på att felsöka selektorer klockan 02:00: kom ihåg att Thunderbits AI aldrig sover.
Vill du lära dig mer? Kolla in Thunderbit Blog för fler fördjupningar, eller testa Thunderbits Chrome-tillägg för att se hur enkelt skrapning kan vara.
Skrapa med Thunderbit Agentic Web Scraper Thunderbits Web Scraper API låter dig trigga extraktion från din egen Node.js-kod, med en gratisnivå för att komma igång. Get Started Free
Vanliga frågor
1. Varför är Node.js särskilt bra för webbskrapning 2025?
Node.js asynkrona, händelsedrivna modell gör att det kan hantera tusentals samtidiga förfrågningar, vilket gör det idealiskt för att skrapa stora datamängder eller realtidsuppdateringar. Dess enorma npm-ekosystem och inbyggda JavaScript-stöd passar perfekt för moderna, JS-tunga webbplatser (Node.js Docs).
2. Hur undviker jag att bli blockerad när jag skrapar med Node.js?
Använd roterande proxies, slumpa request headers, begränsa dina förfrågningar med slumpmässiga pauser och simulera mänskligt beteende (musrörelser, scrollning, skrivande) med verktyg som Puppeteer. Respektera alltid robots.txt och sajtens villkor (Medium).
3. När bör jag använda Cheerio jämfört med Puppeteer i min Node.js-skrapare?
Använd Cheerio för snabb parsning av statisk HTML (när datan redan finns i rå-HTML:en). Använd Puppeteer för sajter som laddar innehåll dynamiskt med JavaScript. För bästa resultat, låt Puppeteer rendera sidan och använd sedan Cheerio för att parsa HTML:en (Bright Data).
4. Hur förenklar Thunderbit webbskrapning med Node.js?
Thunderbit låter dig extrahera strukturerad data från vilken webbplats som helst med AI och naturliga språkprompter — ingen kod krävs. Det hanterar dynamiskt innehåll, undersidor och paginering, och erbjuder ett API för integration med Node.js. Data kan exporteras direkt till Excel, Google Sheets, Airtable eller Notion (Thunderbit Blog).
5. Vad är bästa sättet att skala och övervaka Node.js-skrapare i molnet?
Dockerisera din skrapare, distribuera på Kubernetes eller hanterade molntjänster, och använd autoskalning för att hantera toppar i efterfrågan. Övervaka loggar och mätvärden med verktyg som CloudWatch eller Prometheus, och sätt upp larm för fel eller långsamhet (DigitalOcean).
Redo att ta din webbskrapning till nästa nivå? Testa Thunderbit och må dina skrapare vara snabba, diskreta och alltid ett steg före.
Testa agentisk webbskrapare Get Started Free
Läs mer




