
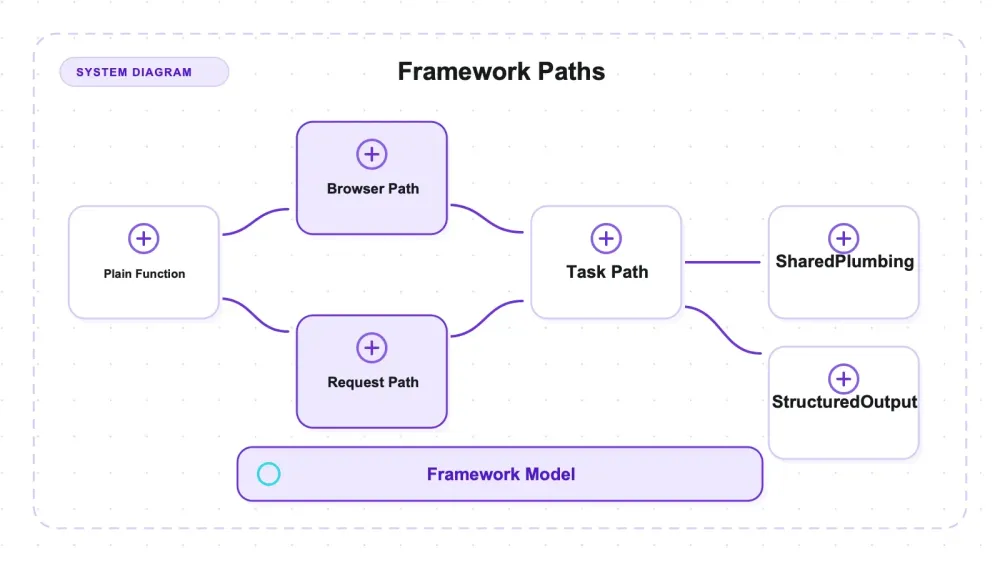
Botasaurus är ett Python-baserat webbskrapningsramverk från Omkar Cloud som marknadsförs som ett komplett paket för att bygga scrapers. Du skriver en vanlig funktion, lägger till @browser, @request eller @task, och ramverket kopplar in en webbläsardrivrutin, en webbläsarliknande HTTP-klient, cache, parallell körning och export i flera format runt den. Det är ett metapaket, och det är där det intressanta börjar: pip install botasaurus lägger inte bara till ett enda bibliotek i din miljö, utan bygger upp en liten familj av egna wheel-filer plus ett stort transitive beroendeträd. Den mekaniska detaljen visade sig vara det mest intressanta jag kunde mäta på ett ärligt sätt.
Botasaurus marknadsförs mycket med anti-detektion, och det är exakt den vinkeln den här recensionen inte granskar. Jag inventerade ramverket — vad som installeras, vad som importeras, vilka metoder som finns, hur stort det är och vilken licens det använder — i stället för att ställa det mot några skarpa skyddsmekanismer i verkligheten. Alla siffror om storlek och import längre ned kommer från pip, från python -c "import ..." och från introspektion av klasser som skapats men aldrig fått hämta någon sida; ingen webbläsare startades för att ta fram dem. Senare startade jag visserligen webbläsare, men bara mot sidor jag själv skrev och serverade på 127.0.0.1, för att se vad drivrutinen själv avslöjar och om den kan läsa innehåll från en sida som bygger upp sig med JavaScript. Inga riktiga webbplatser användes, inga anti-bot-tjänster kontaktades eller mättes, och inga CAPTCHA:er rördes. Effektivitet mot verkliga sajter ligger medvetet utanför ramen, och jag föredrar att säga det direkt i stället för att antyda ett test jag inte körde.
Med den gränsen på plats blir huvudresultatet en fråga om footprint, och det är ett rätt snällt resultat. En ren installation ger en 122,3 MB stor site-packages-katalog fördelad på 44 paket, på en maskin där webbläsardrivrutinen i centrum av allt bara är ungefär 4 MB. Ramverket är inte tungt för att drivrutinen är tung; det är tungt för att ”allt-i-ett” innebär att numpy, lxml, gevent och ett dussin andra paket följer med till en uppgift som i grunden handlar om att hämta HTML. Och den andra halvan av fyndet är en siffra som ofta citeras som en dygd men som man inte ska lita på: import botasaurus tar 0,08 ms, vilket låter som ett fjäderlätt ramverk men i praktiken mest är en tom entré.
Vad Botasaurus faktiskt är
Botasaurus — omkarcloud/botasaurus på GitHub, med 5 561 stjärnor, 486 forks och 58 öppna issues när jag hämtade metadata den 14 juli 2026 — är ett Python-ramverk, inte ett smalt specialbibliotek. Versionerna jag testade var botasaurus 4.0.97 för metapaketet och botasaurus-driver 4.0.92 för motorn under. Metapaketet deklarerar requires-python >=3.7 (drivrutinen >=3.5), och PyPI-klassificeringen säger stöd upp till 3.11. Det installerades och klarade ett import-smoketest på Python 3.14.2 på min maskin. Det säger något om just den här installationen, inte om att alla funktioner är garanterat kompatibla.
Det är värt att slå fast kategorin, eftersom den avgör vad som räknas som ”bra”. Botasaurus ligger i ramverks-änden av spektrumet, i samma kvarter som Scrapy och Crawlee — du tar över dess struktur, dess dekoratörer och dess konventioner, och i gengäld sköter det det underliggande maskineriet. Det är något annat än en fokuserad drivrutin som nodriver, som ger dig en Chrome DevTools Protocol-anslutning och sedan kliver undan. Botasaurus paketerar en drivrutin (det är botasaurus-driver) men lägger dessutom till en task runner, cachelager, serialisering för output och en request-klient. Du köper inte bara en drivrutin; du köper ett åsiktsstyrt arbetsflöde med en drivrutin inuti.
De tre dekoratörerna är hela designen i miniatyr, och alla tre ingångar finns på riktigt — jag bekräftade att botasaurus.browser.browser, botasaurus.request.request och botasaurus.task.task alla existerar och går att importera. @browser kör din funktion mot den ”humaniserade” webbläsardrivrutinen. @request kör den mot en lätt HTTP-klient byggd för att se webbläsarformad ut. @task är den generella omslutningen för allt som inte tydligt är de två första. Dekorera, och Botasaurus ordnar resten: parallell körning, återanvändning av drivrutin, cache av resultat samt skrivare för JSON, CSV, Excel och HTML. Det är en sammanhängande idé. Frågan är bara om du verkligen vill ha så mycket ramverk runt en scraper, och det är en smakfråga, inte en brist.
Slutsats, och gränsen runt den
Botasaurus är kompetent, välformad och gör det ramverk ska göra: den kortar ner det vanliga fallet. Dekoratörsmodellen är ren. MIT-licensen är genuint generös. Installationen fungerar utan drama. Om jag skulle bedöma hur lätt API-ytan är att jobba med, skulle den få ett bra omdöme.
Det jag hela tiden återkommer till är att ramverkets eget huvudbudskap — anti-detektion — är just det som en ansvarsfull recension inte kan uttala sig om utan att rikta det mot någons produktionsskydd. Drivrutinen har visserligen en uttryckligen anti-detektion-brandad API-yta: metoder vars existens jag bekräftade men vars beteende jag inte testade mot något mål. Det är allt jag vill påstå om det. Jag pekade den inte mot någon skyddad sajt, mätte ingen träffsäkerhet, reverse-engineerade ingen mekanism och tänker inte antyda något av det genom formuleringen. Metoderna finns i klassen. Vad de gör i det vilda är en annan recension, och det här är inte den.
Det som följer är därför en inventering av funktioner, installation, resurser och licens, plus vad drivrutinen gör på en sida jag själv kontrollerar — en snävare slutsats än de flesta recensioner av det här verktyget drar, och just den snävheten är poängen.
Vad det avslöjar om sig självt
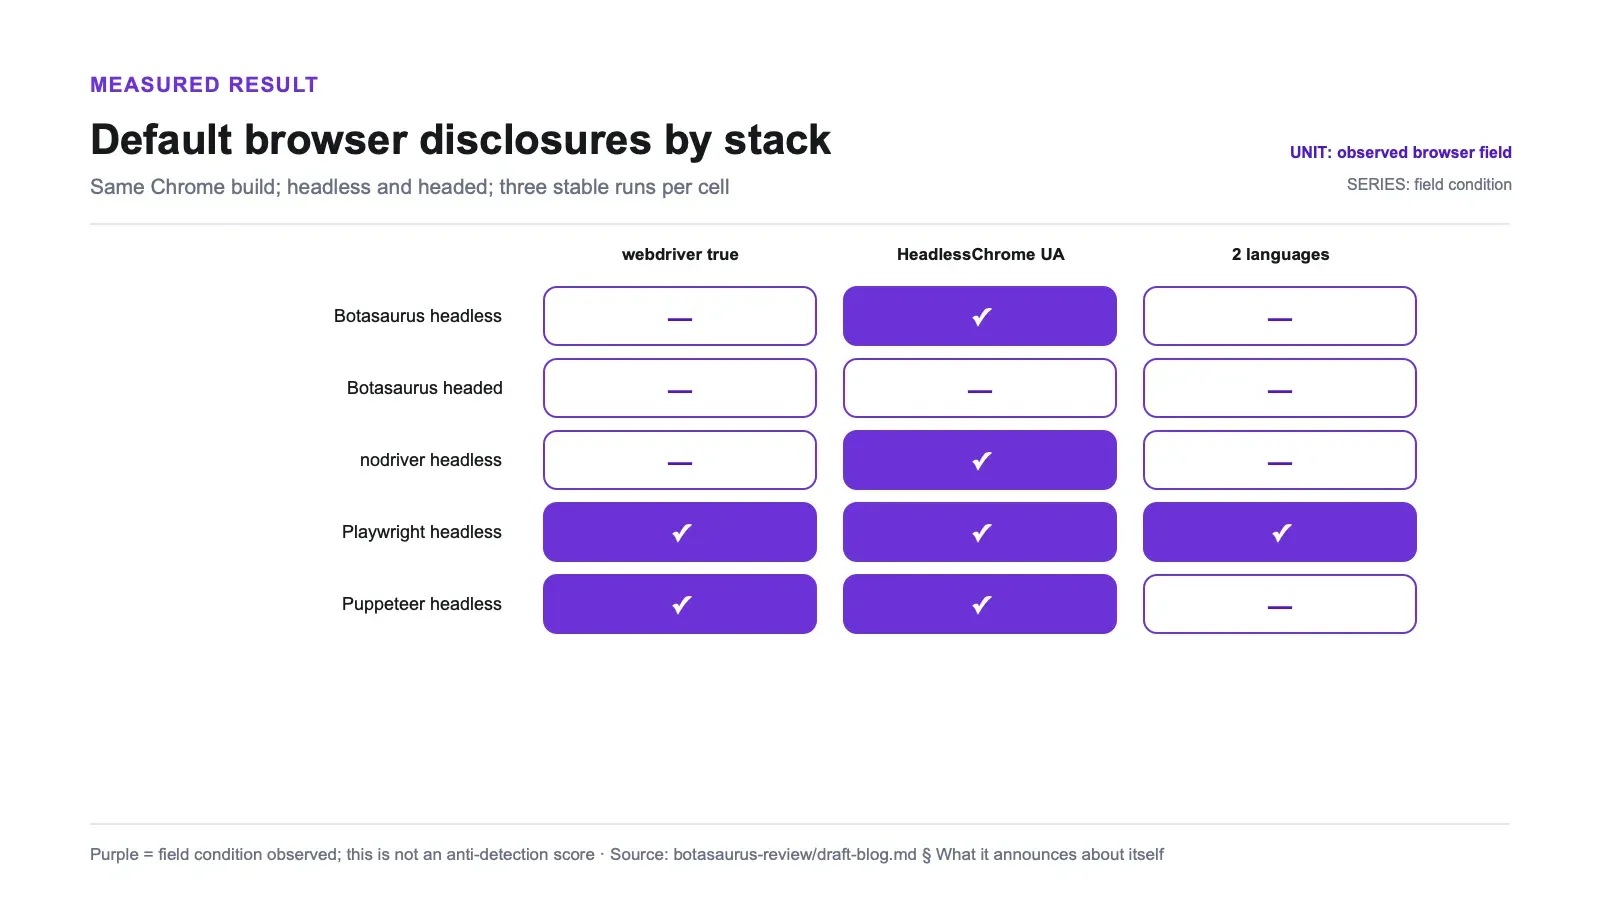
Här finns en fråga du kan besvara utan att gå i närheten av något verkligt skydd: när Botasaurus kör en webbläsare, vad berättar den webbläsaren frivilligt om sig själv för sidan den tittar på? Jag skrev en sida som läser de uppenbara sakerna — navigator.webdriver, user-agent, plattform, språk, antal plugin-moduler och hårdvarutrådar, formen på window.chrome, vad Permissions API säger, samt fönster- och skärmgeometri — serverade den på 127.0.0.1 och körde fyra stackar mot den: Botasaurus, nodriver samt standardversionerna av Playwright och Puppeteer som kontroller. Alla fyra körde samma Chrome-byggnad (Chrome for Testing 151.0.7922.10), så allt som skiljer sig är biblioteket, inte webbläsaren. Headless och headed, tre körningar vardera. Varje värde nedan höll i alla tre.
| Stack | Läget | navigator.webdriver | User-agent-token | navigator.languages |
|---|---|---|---|---|
| Botasaurus 4.0.92 | headless | false | HeadlessChrome/151.0.0.0 | ["en-US"] |
| Botasaurus 4.0.92 | headed | false | Chrome/151.0.0.0 | ["en-US"] |
| nodriver 0.50.3 | headless / headed | false | HeadlessChrome/151 / Chrome/151 | ["en-US"] |
| Playwright 1.56.0 | headless / headed | true | HeadlessChrome/151 / Chrome/151 | ["en-US","en"] |
| Puppeteer 24.16.0 | headless / headed | true | HeadlessChrome/151 / Chrome/151 | ["en-US"] |
Skillnaderna beror på vilken kontroll du jämför med. Mot standard-Puppeteer ändrade Botasaurus navigator.webdriver; språklistan och den nollstora fönstergeometrin matchade, medan user-agenten bara skilde sig i versionsformat. Mot standard-Playwright inkluderade de observerade skillnaderna också språklistan och fönstergeometrin. Mot nodriver matchade booleska värdet och språken, medan bara formatet i user-agenten skilde sig i de fält som visas här. Det här är observationer av standardexponering, inte ett anti-detektion-poäng.
Två detaljer gör det mer intressant än ett rent false. Den första är hur värdet uppstår. I alla fyra stackarna är egenskapen fortfarande webbläsarens egen native getter på Navigator.prototype — function get webdriver() { [native code] } — aldrig en egen egenskap som lagts på instansen, aldrig en ersatt funktion. Botasaurus skriver alltså inte om egenskapen efter att sidan laddats; värdet bestäms när webbläsaren startar, och själva egenskapen lämnas orörd.
Den andra detaljen är den som nyanserar marknadsföringen. I headless-läge annonserar Botasaurus fortfarande HeadlessChrome/151.0.0.0 i user-agenten — identiskt med standard-Puppeteer, identiskt med standard-Playwright. Kör man headed blir det Chrome/151.0.0.0, återigen på exakt samma sätt. Konstruktorn Driver tar parametern user_agent, så att sätta en egen är bara ett nyckelordsargument bort, men i standardkonfigurationen maskeras inte den mest kända självidentifierande strängen i webbläsarautomatisering.
Nästan allt annat var samma över alla fyra stackar, och det är värt att säga tydligt eftersom det snävar in bilden — alla egenskaper nedan hade samma värde i Botasaurus, nodriver, Playwright och Puppeteer:
| Egenskap | Värde, identiskt i alla fyra stackar |
|---|---|
platform | MacIntel |
vendor | Google Inc. |
| Plugins | fem |
| MIME-typer | två |
pdfViewerEnabled | true |
| Logiska kärnor | tolv |
| Rapporterat enhetsminne | 16 GB |
| Touch-punkter | noll |
window.chrome | finns, med app/csi/loadTimes och utan runtime |
| WebGL-renderersträng | identisk i alla fyra |
Den gamla klassikern där Permissions API och Notification.permission motsäger varandra dök inte upp någonstans — alla fyra rapporterade default och prompt i samförstånd. Jag letade också igenom document och window efter de cdc_-spår som äldre WebDriver-stackar är kända för: tomt i alla fyra.
En sista sak är värd att känna till innan du kör i gång: trots sina 122 MB levererar Botasaurus ingen egen webbläsare och laddar inte heller ner någon. find_chrome_executable() pekar på den Chrome som redan finns på maskinen — på min maskin /Applications/Google Chrome.app, version 150.0.7871.187 — och det är den versionen som sedan avslöjas i user-agenten. Din miljö annonserar alltså den Chrome-version som råkar vara installerad, vilket för ett så åsiktsstyrt ramverk är ett överraskande o-åsiktsstyrt standardval.
Säg vad detta är och vad det inte är. Det här är en redovisning av vad en automatiserad stack avslöjar när ingen har bett den att dölja något — användbart om du sitter på försvarssidan, användbart om du vill veta vad din egen tooling faktiskt sänder ut. Det är inte ett mått på om något av detta spelar roll för en viss tjänst. Det testade jag inte, och ingen rad ovan ska läsas som en antydan om ett utfall.
En mer generös standardläsning av test-fixturen
Att avslöja sig själv är en sak; att returnera rätt HTML är jobbet. Jag körde Botasaurus mot samma tre-kategoriers-fixtur som resten av det här benchmark-repot använder, så siffrorna går att jämföra rakt av med övriga verktyg. Sidan innehåller tre saker: A, en statisk länk vars markör är en literal i de serverade byten; B, en nod som byggs av ett inline-script under parsing, med markör och URL sammanfogade av fragment så att bara körning av JavaScript avslöjar dem; och C, en nod som injiceras 800 ms efter load-eventet, uppbyggd på samma sätt. Klass C är den adversariella — en avläsning vid load-eventet kan inte se den.
| Stack | Standardavläsning | Med uttrycklig väntan |
|---|---|---|
| Botasaurus 4.0.92 | 2 av 3 (A + B, missar C) | 3 av 3 |
| nodriver 0.50.3 | 2 av 3 | 3 av 3 |
| Playwright 1.56.0 | 2 av 3 | 3 av 3 |
| Puppeteer 24.16.0 | 2 av 3 | 3 av 3 |
Botasaurus landar där de tyngre verktygen landar. driver.get() följt direkt av driver.page_html är en snapshot vid load: JavaScript renderas korrekt — klass B bevisar det, eftersom klass B inte finns någonstans i de serverade byten — men vid 800 ms fördröjning missar den klass C. Lägg till driver.wait_for_element("#delayed-injected") så får du alla tre. Stabilt över tre upprepningar och tre separata körningar av hela testsviten, utan några flakiga resultat.
Det intressanta syns när man sveper injektionsfördröjningen för att se var varje stacks standardläsning ger upp:
| Klass C injicerad efter | Botasaurus | nodriver | Playwright | Puppeteer |
|---|---|---|---|---|
| 0 ms | hittad | hittad | hittad | hittad |
| 100 ms | hittad | — | — | — |
| 200 ms | hittad | — | — | — |
| 300 ms | hittad | — | — | — |
| 400 ms och uppåt | — | — | — | — |
Alla andra stackar tappar klass C så fort injektionen landar 100 ms eller mer efter load. Botasaurus fångar den fortfarande vid 300 ms och ger bara upp vid 400. Det här är ramverket som ramverk, och orsaken står mitt i konstruktorn: wait_for_complete_page_load=True är standard, så get() återkommer märkbart senare än ett rent load-event. Konkret kostar standardavläsningen 401–431 ms väggklocktid där nodriver ligger på 119–129 ms och Puppeteer på 125–171 ms.
På den här lokala delayade fixturen var bytet ungefär 250 ms per navigation för en senare standard-snapshot. Det fångade innehåll som injicerades upp till 300 ms efter load i dessa körningar; det bevisar inte att Botasaurus är mer korrekt på alla tänkbara sajter. Om du skriver snabba scrapers utan explicita väntelogiker kan marginalen hindra att sena noder missas. Vid hög navigationsvolym, eller när du redan väntar på ett exakt villkor, är det bara overhead.
Två till timingvärden för skala. Att få upp webbläsaren placerade Botasaurus ungefär i nivå med nodriver och Puppeteer, och tydligt efter Playwright:
| Stack | Webbläsarstart, över körningar |
|---|---|
| Botasaurus 4.0.92 | 986–1151 ms |
| nodriver 0.50.3 | 910–1583 ms |
| Puppeteer 24.16.0 | 969–1008 ms |
| Playwright 1.56.0 | 282–365 ms |
Och wait_for_element() kostar inget extra upp till 300 ms fördröjning — get() hade då redan kommit förbi injektionen — men hoppar sedan till cirka 1,42 s vid 400–800 ms och 2,43 s vid 1500 ms.
Frågan om 122 MB: vad ett metapaket faktiskt installerar
Här är matten, för det är det mest användbara jag kan ge dig. En ren pip install botasaurus i en ny virtuell miljö gav ett 122,3 MB stort site-packages-träd över 44 dist-info-paket. Tar man bort pip själv (10,9 MB, vilket är venv-overhead snarare än något Botasaurus bad om) landar man på ungefär 111 MB ramverk och beroenden. Webbläsardrivrutinen — komponenten som faktiskt gör webbläsarautomatiseringen — står för ungefär 4 MB av detta. Alltså är runt 107 MB allt det andra som metapaketet bestämde att du också behövde.
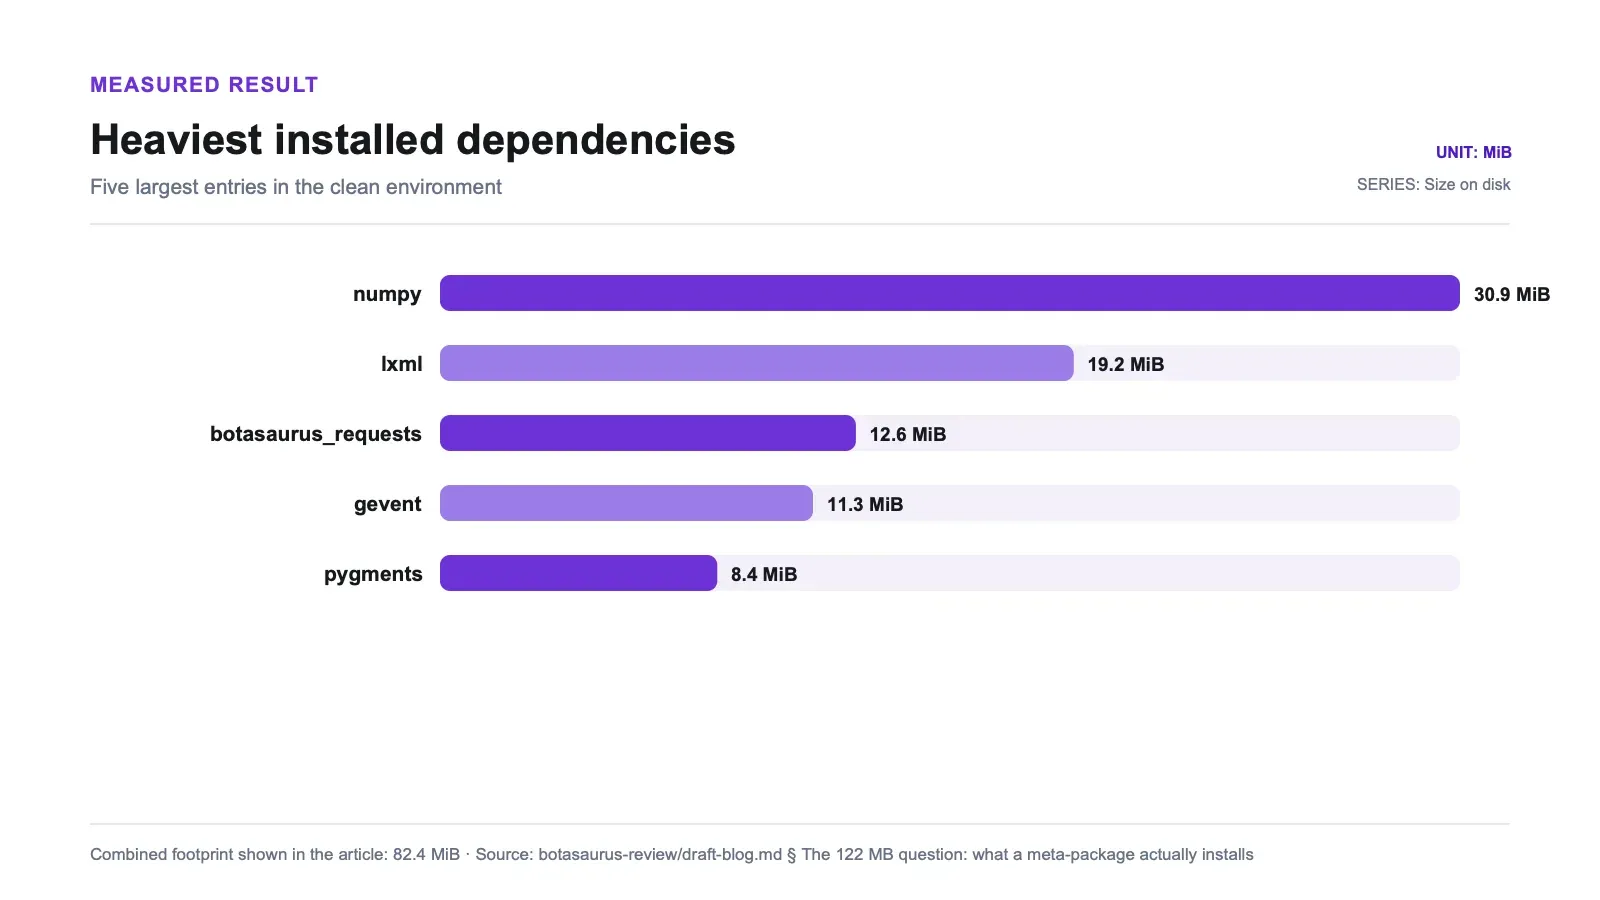
Var tar det vägen? De fem tyngsta transitive beroendena står ensamma för huvuddelen av det hela (varje rad är ett install_footprint.heaviest_deps_mb-värde i artifacts/raw/runs/resource_baseline.run1.json; totalen är min summering, inte ett eget fält i filen):
| Paket | Storlek på disk |
|---|---|
| numpy | 30,9 MB |
| lxml | 19,2 MB |
| botasaurus_requests | 12,6 MB |
| gevent | 11,3 MB |
| pygments | 8,4 MB |
| Fem paket tillsammans | 82,4 MB (30,9 + 19,2 + 12,6 + 11,3 + 8,4) |
Att numpy är den enskilt största posten var det som fick mig att höja på ögonbrynen — det är ett linjäralgebrapaket som hamnat inuti ett verktyg vars jobb är att hämta och tolka webbsidor. Det är inte direkt fel; ramverk samlar gärna på sig nyttoberoenden, och något i trädet verkar uppenbarligen vilja ha array-matematik. Det är bara mycket maskin för det här ärendet.
Som jämförelse väger den fokuserade drivrutinen nodriver ungefär 17,2 MB över 6 paket på samma maskin — alltså omkring 7x lättare. (Den siffran kommer inte från detta paket: det är install_footprint.site_packages_total_mb i nodrivers egen artifacts/raw/runs/resource_baseline.run1.json, mätt i en separat körning på samma host, och 122,3 ÷ 17,2 = 7,1.) Ingen av siffrorna är ett fel, och det här är ingen kapacitetsrankning; det är den mekaniska kostnadsskillnaden mellan ett batterier-inkluderat ramverk och en fokuserad drivrutin. I en container bidrar den uppmätta site-packages-storleken till applikationslagret. Det är inte hela avbildens storlek, och det här testet mätte inte byggtid eller kall-deploy-tid.
En liten extra detalj om footprint: under introspektionen utlöste första användningen av from botasaurus.request import request en engångsnedladdning på ungefär 12,8 MB. Den inspelade körningen identifierade inte artefakten och destinationen väl nog för att jag skulle betrakta siffran som en stabil del av den installerade footprinten. Den visar däremot att den här kodvägen kan kräva nätåtkomst vid första användning, vilket är värt att testa i din egen image innan du kör i en air-gappad miljö.
Import-siffran som luras
Kallstart vid import är platsen där ett slarvigt läst tal blir fel. Mätt över sju färska subprocess-importer landade import botasaurus på toppnivå på ett medianvärde av 0,08 ms. Citerar man bara det låter det som den lättaste ramen i kategorin.
Det är den inte. Den är snabb för att det nästan inte finns något där. Det översta botasaurus-paketet exponerar ingen __version__ och i princip inget publikt namn alls — att importera det gör nästan inget eftersom det nästan inte innehåller någonting. Den siffra som faktiskt spelar roll för ett CLI-verktyg eller en serverless kallstart är importen av motorn: from botasaurus_driver import Driver tar ungefär 135 ms, stabilt inom ett par millisekunder över körningar. Det är den verkliga fasta kostnaden du betalar innan en enda sida hämtas. Och när drivrutinsmodulen väl är importerad ligger resident minne på runt 29–30 MB — återigen, innan någon Chrome-process ens finns. Startar du en faktisk webbläsare växer det betydligt; jag mätte inte minne med en sådan igång, så jag sätter ingen siffra på det.
Lärdomen är liten men skarp: att import botasaurus är omedelbart beror på att topppaketet är ihåligt, inte på att ramverket är billigt. Om du dimensionerar en kallstart, mät den import du faktiskt kommer att vara beroende av.
API-form: 99 metoder bakom en nästan tom entré
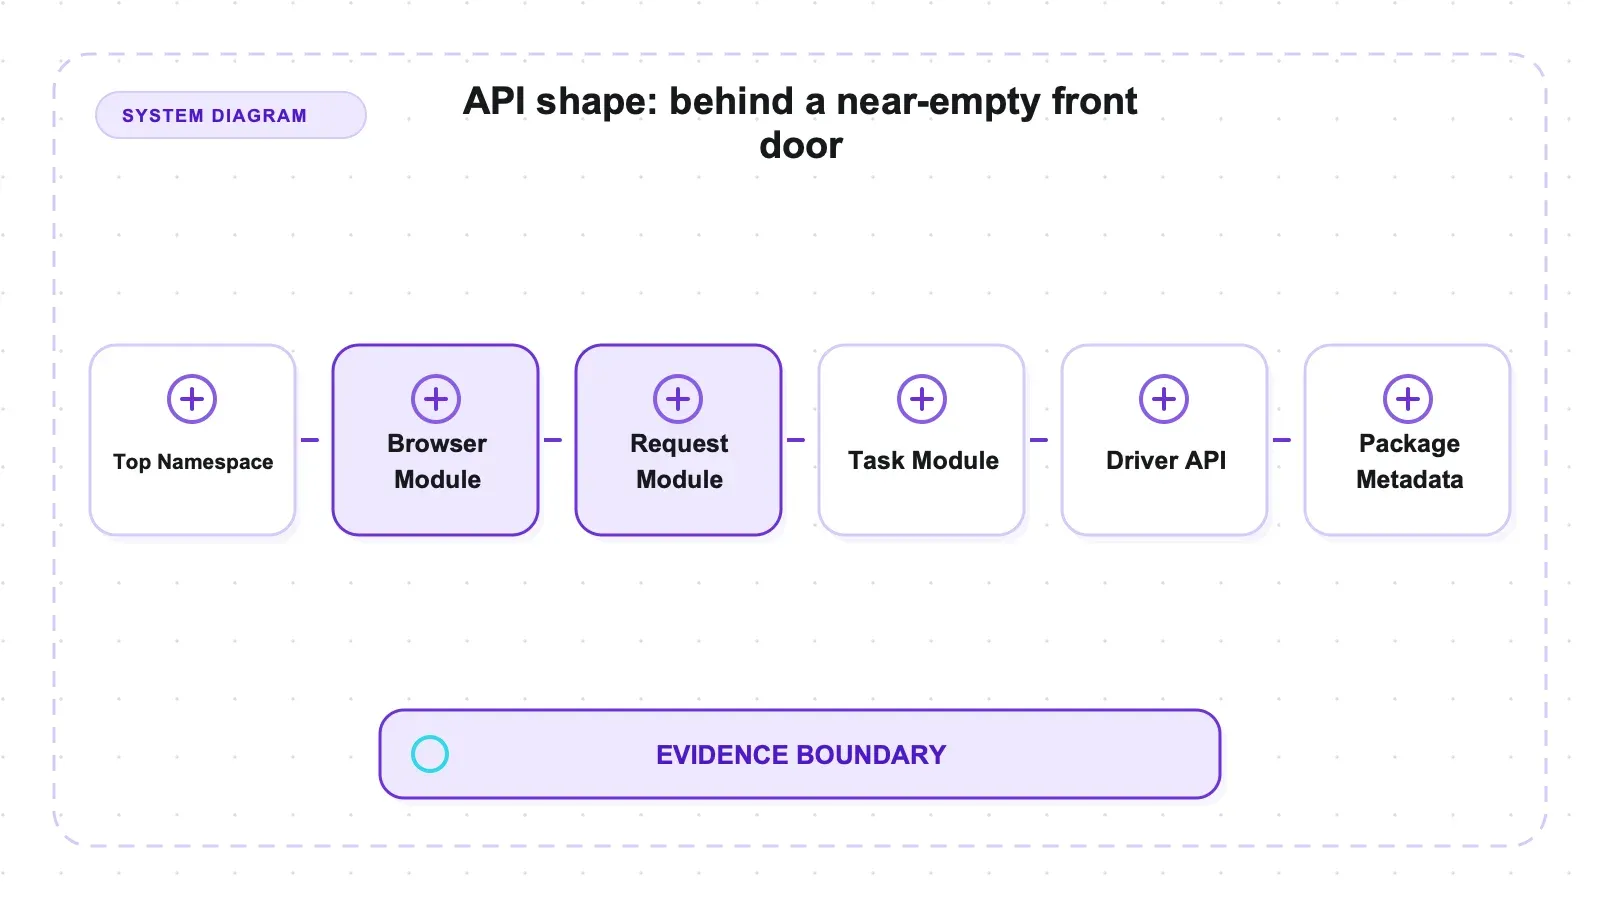
Motorns Driver-klass exponerar 99 publika metoder — en bred yta som täcker navigation, elementfrågor, cookies och local storage, mus- och tangentbordsaktioner, screenshots, tabbhantering, CDP-genomgång och filuppladdningar. Konstruktorn tar 18 parametrar, vilket ganska väl speglar den justerbara ytan: headless, proxy, profile, tiny_profile, block_images, block_images_and_css, wait_for_complete_page_load, chrome_executable_path, extensions, arguments, user_agent, window_size, lang och några till. Som API vid konstruktionstid täcker det de vanliga kontrollerna för en webbläsarwrapper.
Form-missen sitter högst upp och är ofarlig men verklig. import botasaurus ger dig ett nästan tomt namespace — ingen __version__, praktiskt taget inga publika namn på toppnivå. Allt du faktiskt använder ligger i submoduler: from botasaurus.browser import browser, Driver, from botasaurus.request import request, from botasaurus.task import task. Om du letar efter botasaurus.__version__ för att logga vilken build du kör, hittar du den inte; du får använda importlib.metadata i stället. Inget av detta bryter något. Det är bara inte den struktur de flesta Python-utvecklare förväntar sig reflexmässigt, och att känna till det sparar dig fem förvirrade minuter första dagen.
En dokumentationsobservation om metoderna jag nämnde tidigare är rimlig och håller sig inom min gräns: av de anti-detektion-namngivna metoder som finns har bara 2 någon inbyggd docstring. Resten beskriver sig själva genom namn, medan metodspecifik dokumentation ligger på den externa docs-sidan i stället för i den installerade källkoden. Det är en fråga om var informationen ligger, inte om kvalitet — många bra bibliotek håller sina prosatexter utanför koden — men om ditt arbetssätt är ”läs källkoden för att förstå metoden” kommer den här ytan mest ge dig namnet och inget mer.
Licens: MIT hela vägen ner till drivrutinen
Både metapaketet och botasaurus-driver anger MIT, med den vanliga klassificeringen License :: OSI Approved :: MIT License. MIT är permissiv: ingen copyleft, inget krav på att öppna din egen kod, minimalt friktion för kommersiell användning. Det är en verklig och inte obetydlig kontrast mot nodriver, den närliggande anti-detect-drivrutinen, som släpps under AGPL-3.0 — en copyleft-licens vars nätverksanvändningsklausul gör många juristavdelningar nervösa. Om licensfrågan är avgörande för dig är Botasaurus MIT-linje ett riktigt plus i kanten.
Men metapaketets form innebär en viktig brasklapp igen. Denna permissiva MIT gäller Botasaurus egna första parts-paket. Den säger inte automatiskt något om de ungefär 40 transitive paket som installeras, och vart och ett av dem har sin egen licens. Jag bekräftade MIT på toppnivå för paketen som Omkar Cloud publicerar; jag granskade inte licensen för varje beroende i trädet. För ett hobbyprojekt spelar den skillnaden sällan någon roll. För en hel-tree-adoption i ett företag som bryr sig om sin mjukvarubill of materials är ett 40-paketsträd något man bör köra genom sin egen licensscanner innan man bestämmer sig — inte för att jag hittade ett problem, utan för att jag inte tittade, och ett metapaket är precis där en oväntad licens kan gömma sig.
Fördelar och nackdelar
Fördelar:
- Ren design med tre dekoratörer (
@browser/@request/@task), och alla tre ingångar finns — ramverket gör det vanliga fallet kort. - MIT-licens för både metapaketet och drivrutinen, en tydlig kontrast mot AGPL-3.0 i en jämförbar drivrutin. Permissiv, kommersiellt vänlig och utan copyleft.
- Bred drivrutinsyta: 99 publika metoder och en konstruktor med 18 parametrar täcker de vanliga behoven för webbläsarautomatisering.
- Installerades och klarade import-smoketests på Python 3.14.2 och 3.12.13, alltså nyare än klassificeringarna anger (som stannar vid 3.11); full runtime-kompatibilitet är däremot inte etablerad.
- Den mest förlåtande standardläsningen av alla stackar jag mätte: den fångar fortfarande innehåll som injiceras 300 ms efter load, där nodriver, Playwright och Puppeteer tappar det redan vid 100 ms.
wait_for_complete_page_load=Truegör faktiskt arbete. - Rapporterar
navigator.webdriversomfalsesom standard där båda standardkontrollerna rapporterartrue, utan att patcha egenskapen — descriptorn är fortfarande webbläsarens egen native getter. - Batterier ingår som standard — cache, parallellism, återanvändning av drivrutin och JSON/CSV/Excel/HTML-output finns inbyggt, inte som tillägg.
Nackdelar:
- Tungt på disk: 122,3 MB över 44 paket, ungefär 7x en fokuserad drivrutin, drivet av beroenden som numpy (30,9 MB) och lxml (19,2 MB) snarare än av den ~4 MB stora drivrutinen.
- Den lugnande toppimporten på 0,08 ms är missvisande; den motorimport du faktiskt behöver ligger runt 135 ms, och efter import ligger minnet runt 29–30 MB innan någon webbläsare startar.
- Det bredare standardläsningsfönstret är inte gratis: 401–431 ms per navigera-och-läs mot 119–129 ms för en lätt drivrutin på samma sida och samma Chrome.
- Headless-körningar annonserar fortfarande
HeadlessChromei user-agenten som standard, precis som standardkontrollerna; konstruktorn haruser_agent, men inget sätter den åt dig. - Trots 122 MB levereras ingen webbläsare — den använder den Chrome som redan finns på hosten, så den version som exponeras är den som råkar vara installerad i din miljö.
- Första användningen av
@requestutlöste en engångsnedladdning på cirka 12,8 MB i den här körningen; artefakten och destinationen fångades inte tillräckligt väl för att kalla det en stabil footprintökning. - Toppaketet är nästan tomt och exponerar ingen
__version__; det verkliga API:t och versionen finns mindre uppenbart någon annanstans. - De flesta av de anti-detektion-namnade metoderna saknar inbyggd docstring, så källkoden visar namn men inte beteende.
Utanför allt detta, och därför inte testat här: allt som rör verklig anti-bot-effektivitet (medvetet utanför scope), minnesanvändning per sida, hantering av proxy och profiler, genomströmning i stor skala och alla andra plattformar än macOS arm64. Footprint- och importvärdena togs fram utan att en webbläsare startades alls; återgivnings- och exponeringsvärdena kommer från webbläsare som bara pratade med en fixtur på 127.0.0.1.
Vem det passar för, och vem som bör hoppa över det
Botasaurus passar om du vill ha ett ramverk snarare än en komponent. Om du startar ett scraping-projekt från en tom fil och hellre vill ta över en struktur än bygga en själv — dekoratörer för ingångarna, cache och parallellism hanteras, skrivare för output är inbyggda — är det här ett sammanhängande MIT-licensierat alternativ. MIT är permissiv, men din användning och distributionsmodell behöver fortfarande den vanliga compliance-granskningen. Team som redan tänker i Scrapy- eller Crawlee-termer kommer att känna igen upplägget.
Hoppa över det, eller åtminstone tänk efter två gånger, om din miljö är storlekssensitiv. En installation på 122 MB med numpy och gevent i trädet är mycket att packa in i en slimmad container när det enda du egentligen behöver är ”styr en webbläsare och hämta några fält”. En fokuserad drivrutin ger dig automationsdelen till en bråkdel av vikten, men då får du skriva det omgivande maskineriet själv. Och hoppa över det helt om du vill ha ett svar på anti-detektion-effektivitet, eftersom det är just den sak jag medvetet inte testade — du skulle annars lita på ett marknadsföringspåstående som jag varken bekräftade eller motbevisade.
Alternativ, och var Thunderbit passar in
Den ärliga ramen först: Botasaurus är gratis, MIT-licensierat och självhyst. Du driver miljön, du sköter uppdateringarna och du äger hela beroendeträdet — alla 44 paket — inklusive patchning, licenscompliance och vad numpy nu än gör i en framtida version. För många team är just det ägandet exakt vad de vill ha, och ingen managed tjänst slår ”ett ramverk du redan har” på rå kostnad.
Inom open source är de användbara jämförelserna de som liknar i form. Om du står i ramverksänden med Botasaurus är Scrapy och Crawlee de självklara jämförelserna att väga mot — mogna, åsiktsstyrda och med sina egna konventioner att anamma. Om du vill ha LLM-redo Markdown från en sida snarare än ett ramverk för att strukturera en crawler, är Crawl4AI och den innehållsfokuserade Trafilatura mer direkt riktade mot det jobbet. Om du gillar Python- och anti-detect-spåret men vill ha något lättare än ett metapaket, är Scrapling värt en titt, och om ett kompilerat språk är aktuellt byter Go-biblioteket Colly bort JavaScript-rendering mot fart och ett litet footprint. Alla webbläsarstyrande alternativ, inklusive Botasaurus, ärver den kostnadsprofil som vår jämförelse mellan Playwright och Puppeteer visar — riktiga webbläsare är inte billiga att köra, och det är en del av varför ramverket runt dem väger som det gör.
När en managed API-lösning kommer in i bilden är det en annan punkt i samma kedja. Botasaurus är den självhysta utvecklarstacken; Thunderbit säljer den managed varianten, riktad till samma utvecklare. Open API:t har två endpoints. POST /distill (1 kredit) returnerar en sida som ren, LLM-redo Markdown, med rendering och anti-bot hanterat på serversidan, så du behöver varken provisionera en webbläsare eller ett beroendeträd. POST /extract (20 krediter) returnerar strukturerad JSON enligt ett JSON Schema du själv definierar, med renderMode satt till none, basic eller full beroende på hur mycket webbläsare sidan faktiskt behöver. Båda finns också i batchversioner för upp till hundra URL:er åt gången. Det finns en MCP-server för agenter och kodassistenter — thunderbit_suggest_fields är gratis och visar vad en sida exponerar innan du betalar något — samt en CLI via npx @thunderbit/thunderbit-cli för cron och CI. För icke-utvecklare som hellre inte vill röra något av detta finns Chrome-tillägget, som kör samma motor som ett no-code-verktyg, och guiderna på Thunderbits YouTube-kanal täcker vanliga arbetsflöden.
Avvägningen handlar om var arbetet ligger, inte vilket verktyg som är ”bäst”. Botasaurus behåller ramverket, webbläsarflottan, beroendena, infrastrukturen och underhållet på din sida av linjen utan någon leverantörsavgift per request; beräkning, bandbredd, proxies och drift kostar ändå pengar. Ett managed API tar rendering och schemaformaterad output av din tallrik och tar betalt per anrop — du kan ställa det mot en egen lösning på prissidan.
Testa Thunderbit för utvinning av webdata
Slutsats
Botasaurus är ett rimligt val om du vill ha ett allt-i-ett-Python-ramverk och accepterar dess beroendefotavtryck. Den tre-dekoratörsdesignen är ren, drivrutinens API-yta är bred, och den klarade install- och import-smoketests på Python-versioner nyare än vad klassificeringarna anger. På min lokala fixtur fångade dess standardsnapshot också innehåll som injicerades 300 ms efter load, där de andra testade stackarna missade det vid 100 ms; det är ett resultat för fixturen, inte en allmän rangordning.
Men siffrorna måste tolkas rätt. Det är en installation på 122 MB och 44 paket där drivrutinen bara är ungefär 4 MB och resten består av numpy, lxml, gevent med flera — ungefär 7x en fokuserad drivrutin, och den vikten följer med in i din containerimage och din kall-deploy-tid. Toppimporten på 0,08 ms är en ihålig entré, inte ett lätt ramverk; motorimporten på runt 135 ms är det du faktiskt betalar. Den generösa standardläsningen kostar ungefär 250 ms per navigation. Och på den fråga om standardexponering som jag faktiskt kunde besvara är bilden snävare än marknadsföringen antyder: en boolesk egenskap skiljer sig från standard-Puppeteer, headless-user-agenten säger fortfarande HeadlessChrome, och alla andra egenskaper jag mätte var identiska över alla fyra stackar. Anti-detektion-löftet som säljer verktyget är just det som den här recensionen inte betygsätter — jag bekräftade att metoderna finns, körde drivrutinen mot en sida på min egen maskin och stannade där medvetet. Känn till footprintet, ignorera den smickrande importtiden och behandla stealth-marknadsföringen som en öppen fråga, så är Botasaurus ett hederligt ramverk som gör precis vad ett ramverk ska göra. Förvänta dig en fjäderlätt drivrutin och du kommer att bli förvånad vid docker build.
Testa Thunderbit för utvinning av webdata Get Started Free
Vanliga frågor
Är Botasaurus gratis och vilken licens har det?
Det är gratis och MIT-licensierat — både botasaurus-metapaketet och botasaurus-driver-motorn har den OSI-godkända MIT-klassificeringen. MIT är permissiv, så det finns ingen copyleft-skyldighet och den passar kommersiell användning väl, vilket är en tydlig kontrast mot jämförbara anti-detect-drivrutiner som släpps under AGPL-3.0. En brasklapp: MIT täcker Omkar Clouds egna paket, men inte automatiskt de ungefär 40 transitive beroenden som installeras, så kör gärna en egen licensscan innan ett helt trädföretagsinförande.
Hur stor är en Botasaurus-installation, och varför ser import botasaurus så snabbt ut?
En ren pip install botasaurus gav ett site-packages-träd på 122,3 MB fördelat på 44 paket på min maskin. Själva webbläsardrivrutinen är bara ungefär 4 MB — vikten kommer av att metapaketet drar in ett brett beroendeträd, lett av numpy (30,9 MB), lxml (19,2 MB), botasaurus_requests (12,6 MB), gevent (11,3 MB) och pygments (8,4 MB). Det är ungefär 7x fotavtrycket för en fokuserad drivrutin som nodriver på samma maskin. Inget av detta är ett fel; det är kostnaden för ”batterier ingår”, och det spelar störst roll för containerstorlek. Det är importtiden som döljer fotavtrycket: import botasaurus ligger runt 0,08 ms, men bara för att toppaketet nästan är tomt — ingen __version__, nästan inga publika namn, så importen gör nästan ingenting. Den import som faktiskt kostar är motorn, from botasaurus_driver import Driver, på ungefär 135 ms, med resident minne runt 29–30 MB efter den importen och innan någon webbläsare startas. Dimensionerar du en serverless kallstart? Mät motorimporten, inte den tomma toppimporten.
Vad avslöjar Botasaurus om sig självt, och testades det mot riktiga anti-bot-system?
Första delen mättes; den andra delen testades medvetet inte. På en sida jag serverade från 127.0.0.1, med samma Chrome-byggnad som kontrollerna: navigator.webdriver kommer tillbaka som false, medan standard-Playwright och standard-Puppeteer båda rapporterar true. Det värdet sätts vid webbläsarstart, inte genom att patcha egenskapen — descriptorn är fortfarande Chromes egen native getter. Utöver den booleanska egenskapen matchade nästan allt kontrollerna exakt: samma plattformssträng, fem plugins, tolv kärnor, 16 GB rapporterat enhetsminne, samma window.chrome-form, ingen Permissions API-motsägelse och inga cdc_-liknande rester på document eller window. Headless-körningar annonserar fortfarande HeadlessChrome/151.0.0.0 i user-agenten, precis som båda kontrollerna — Driver-konstruktorn har visserligen parametern user_agent, men inget sätter den åt dig. När det gäller effektivitet: jag riktade aldrig drivrutinen mot en live-sajt, kontaktade aldrig någon anti-bot-tjänst och rörde aldrig en CAPTCHA. Drivrutinen innehåller dessutom en uppsättning metoder som är namngivna för anti-detektion, vars existens jag bekräftade, men jag använde dem inte, testade inte deras beteende mot något mål, mätte ingen träffsäkerhet och beskrev ingen mekanism. Exponeringstabellen ovan visar vad stacken själv avslöjar, och inget om vem som lyssnar eller vad de gör med det.
Hanterar Botasaurus JavaScript-renderat innehåll korrekt?
Ja, och standardbeteendet är mer förlåtande än hos de flesta. På en fixtur med tre innehållsklasser gav driver.get() + driver.page_html 2 av 3 vid 800 ms injektionsfördröjning — den renderar JavaScript korrekt, men läser innan väldigt sent innehåll har hunnit landa — och driver.wait_for_element() gav 3 av 3. Det särskilda är var standardläsningen ger upp: Botasaurus fångar fortfarande innehåll som injiceras 300 ms efter load, där nodriver, Playwright och Puppeteer alla tappar det redan vid 100 ms. Det beror på wait_for_complete_page_load=True i konstruktorn, och kostar ungefär 250 ms per navigation.
Hur importerar och använder jag Botasaurus efter installation?
Inte på det sättet du kanske tror. Topp-namespacet botasaurus är nästan tomt, så det verkliga API:t ligger i submodulerna: from botasaurus.browser import browser, Driver, from botasaurus.request import request och from botasaurus.task import task. Du dekorerar en vanlig funktion med @browser, @request eller @task, och ramverket hanterar den omgivande drivrutinen, cache och output. Eftersom det inte finns någon botasaurus.__version__ får du använda importlib.metadata om du vill logga vilken build du kör.




