Парсер TechCrunch













Откройте данные TechCrunch всего за два клика
Простой сбор данных TechCrunch за два клика
Вручную копировать заголовки статей, имена авторов, даты публикации или полный текст материалов с TechCrunch — долго и утомительно. Thunderbit полностью избавляет от этой рутины. Просто укажите нужные данные, а ИИ сам разберётся с остальным. Два клика — и вы уже извлекаете структурированные данные без единой строчки кода и без сложной настройки.
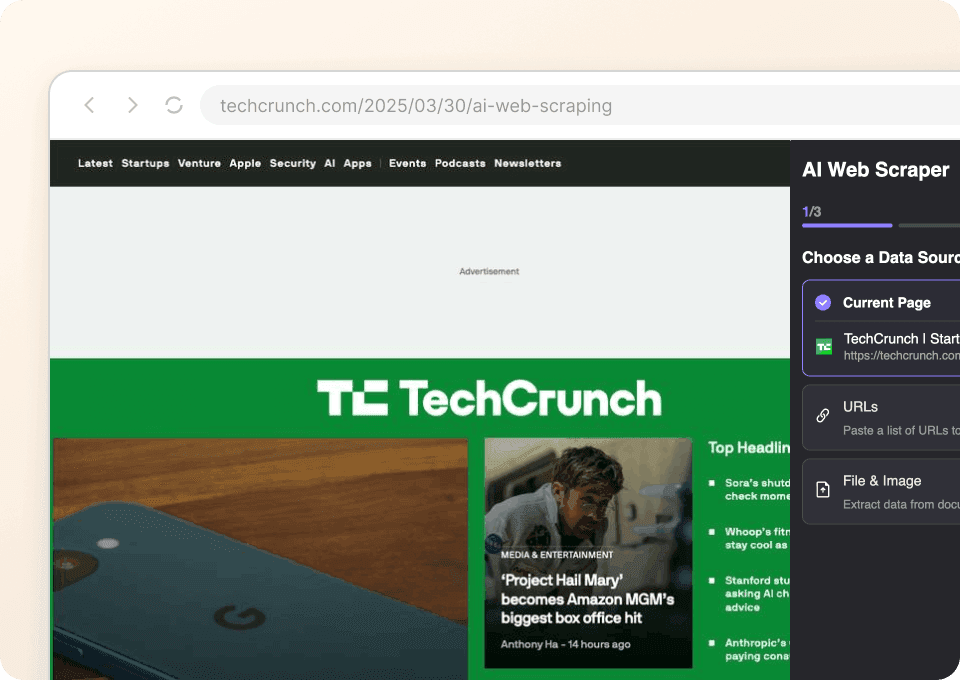
Получайте чистые данные TechCrunch мгновенно
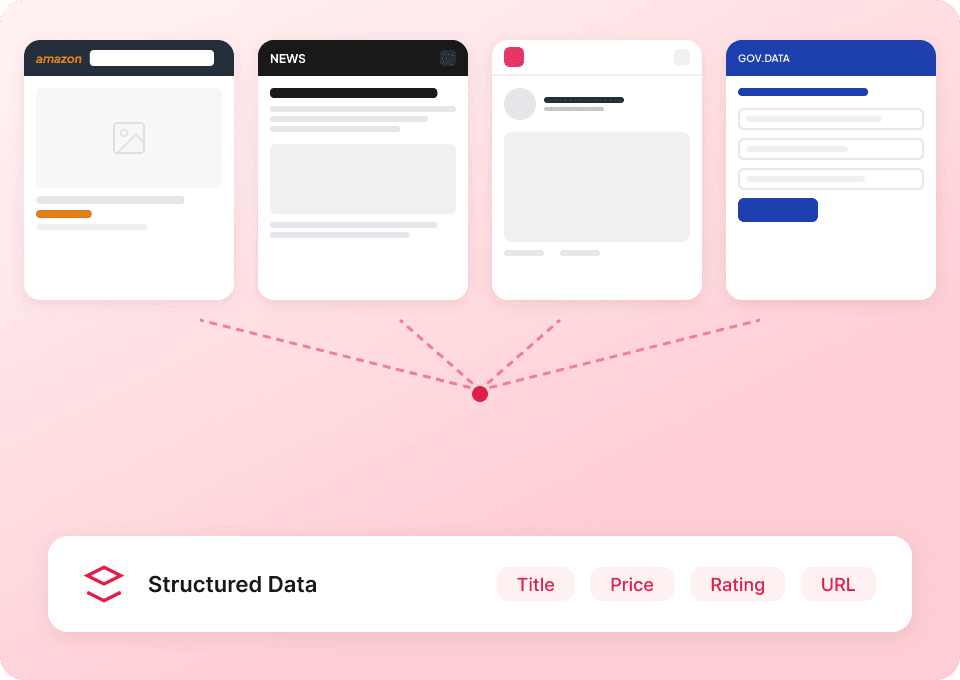
Сбор сырого HTML с TechCrunch мало чем поможет — нужны чистые, структурированные данные. Thunderbit автоматически очищает и форматирует данные прямо в процессе извлечения, поэтому вы сразу можете анализировать категории статей, отслеживать авторов или сравнивать даты публикации. Экспортируйте данные напрямую в Google Sheets, Notion или Airtable и начинайте работать с организованной информацией без ручной обработки.

Собирайте данные не только с TechCrunch, но и с любого сайта
Зачем изучать новый инструмент для каждого сайта отдельно? Thunderbit работает практически с любыми сайтами, включая TechCrunch. А благодаря более чем 50 готовым шаблонам вы можете начать ещё быстрее. Собираете ли вы контент статей, профили авторов или теги публикаций — Thunderbit станет универсальным решением для извлечения веб-данных по всему интернету.
Трудно эффективно собирать данные TechCrunch?
Посмотрите, как Thunderbit упрощает сбор данных TechCrunch по сравнению с традиционными методами.
Традиционные парсеры
Старый способ работыThunderbit
Более умный подход

Часто задаваемые вопросы
Похожие сценарии использования
Изучи больше сценариев использования веб-скрапера Thunderbit.

Парсер Investing.com
Извлекайте биржевые данные — тикеры, цены, объем и рыночную капитализацию — с Investing.com всего в 2 клика, а затем сразу экспортируйте их в Google Sheets, Notion или Excel. Откройте любую страницу Investing.com, и AI сам определит нужные поля.
Подробнее ->
Парсер Substack
Извлекайте количество подписчиков Substack, заголовки статей и описания публикаций всего в 2 клика — затем экспортируйте в Excel, Google Sheets или Notion. Код не нужен: Thunderbit с помощью AI сам всё структурирует за вас.
Подробнее ->
Простой ESPN scraper
Отслеживайте имена спортсменов, даты игр и счёт из ESPN всего в 2 клика с AI от Thunderbit — без кода и без настройки. Сразу экспортируйте данные в Excel, Google Sheets или Notion и начинайте использовать спортивную аналитику без лишних шагов.
Подробнее ->
PubMed 爬虫
Thunderbit 的 PubMed 爬虫可借助 AI 帮你从 PubMed 搜索结果和文章页面中提取结构化数据。轻松抓取热门医学研究、临床试验证据、摘要、作者、机构、发表日期和链接,并可导出到 Excel、Google Sheets、Airtable 或 Notion。
Подробнее ->
Парсер статей для текста, авторов и дат
Собирайте заголовки, имена авторов, даты, краткие описания, основной текст, ссылки и медиа с публичных страниц статей. Сохраняйте все данные по каждой статье в одной понятной строке, даже если на новостных сайтах используются разные макеты.
Подробнее ->
Парсер новостей: от заголовков к полным данным статьи
Собирайте заголовки со страниц тем, разделов или поиска, а затем открывайте ссылки на статьи, чтобы получить видимые имя автора, дату публикации, краткое описание, раздел и URL источника. До запуска просто опишите Thunderbit по-английски, какие данные по статье вам нужны.
Подробнее ->Готов вывести извлечение данных на новый уровень?
Присоединяйся к более чем 200 000 профессионалов, которые уже используют Thunderbit для автоматизации веб-скрапинга.
Бесплатный пробный период дает безлимитные кредиты для 8 веб-страниц.



