Простой ESPN scraper













Извлекайте данные ESPN без лишних хлопот
Thunderbit позволяет легко собирать спортивные данные с ESPN всего за несколько кликов.
Два клика — и данные ESPN у вас
Забудьте о коде и сложной настройке. С Thunderbit вы просто выделяете нужные данные — имя спортсмена, счёт, дату игры, любую статистику — и получаете их в 2 клика. Никаких CSS-селекторов и запутанных API. Просто укажите, нажмите и заберите нужные данные ESPN.
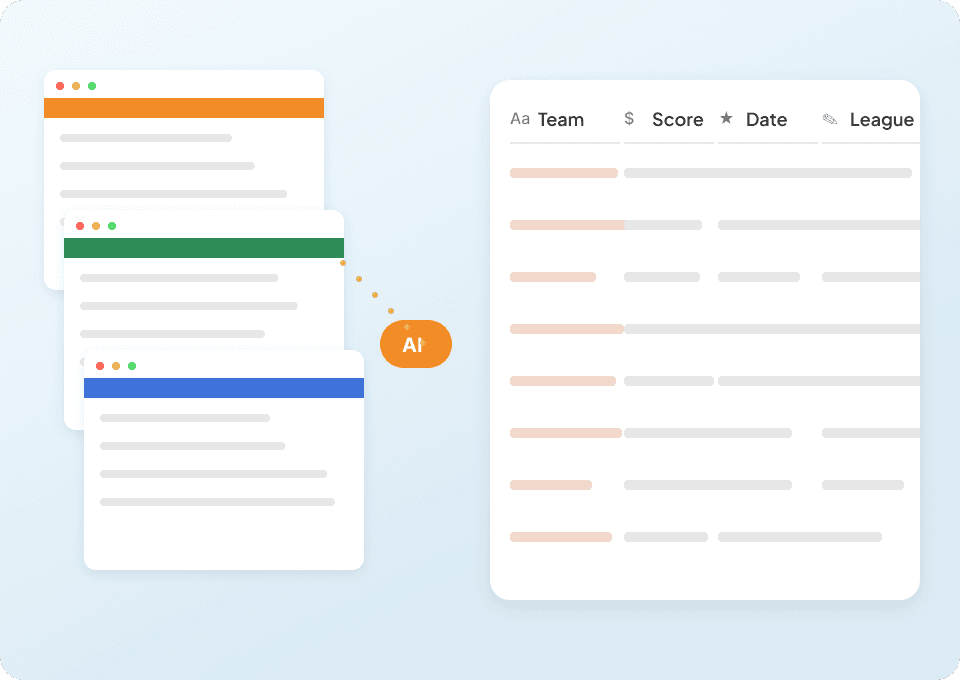
Чистые данные ESPN сразу после сбора
Сырые данные ESPN часто приходят в разном формате и неудобны для работы. Thunderbit автоматически очищает и структурирует всё в процессе сбора — статистику спортсменов, названия команд, статус матча — поэтому результат сразу готов к анализу или отчётности. Ручная обработка не нужна.
Собирайте данные сразу со многих страниц ESPN
Сбор данных ESPN постранично отнимает часы, которых у вас нет. Thunderbit автоматически открывает и извлекает информацию с сотен страниц ESPN за один запуск, переходя по ссылкам на страницы команд, профили игроков или разборы отдельных игр. Просто задайте стартовые URL — остальное Thunderbit сделает сам.
Чем Thunderbit отличается от традиционных ESPN scrapers?
Извлекайте спортивные данные без усилий, даже если ESPN неожиданно меняет интерфейс.
Традиционные скраперы
Старый подход к работеThunderbit AI
Более умный подход

Часто задаваемые вопросы
Похожие сценарии использования
Изучи больше сценариев использования веб-скрапера Thunderbit.

Парсер Investing.com
Извлекайте биржевые данные — тикеры, цены, объем и рыночную капитализацию — с Investing.com всего в 2 клика, а затем сразу экспортируйте их в Google Sheets, Notion или Excel. Откройте любую страницу Investing.com, и AI сам определит нужные поля.
Подробнее ->
Парсер Substack
Извлекайте количество подписчиков Substack, заголовки статей и описания публикаций всего в 2 клика — затем экспортируйте в Excel, Google Sheets или Notion. Код не нужен: Thunderbit с помощью AI сам всё структурирует за вас.
Подробнее ->
Парсер TechCrunch
Извлекайте статьи TechCrunch, новости стартапов, заголовки, ссылки, даты, имена авторов и краткие сводки всего за 2 клика — без кода. Сразу экспортируйте данные в Excel, Google Sheets или Notion и превращайте сырые новости в структурированную, полезную информацию.
Подробнее ->
PubMed 爬虫
Thunderbit 的 PubMed 爬虫可借助 AI 帮你从 PubMed 搜索结果和文章页面中提取结构化数据。轻松抓取热门医学研究、临床试验证据、摘要、作者、机构、发表日期和链接,并可导出到 Excel、Google Sheets、Airtable 或 Notion。
Подробнее ->
Парсер статей для текста, авторов и дат
Собирайте заголовки, имена авторов, даты, краткие описания, основной текст, ссылки и медиа с публичных страниц статей. Сохраняйте все данные по каждой статье в одной понятной строке, даже если на новостных сайтах используются разные макеты.
Подробнее ->
Парсер новостей: от заголовков к полным данным статьи
Собирайте заголовки со страниц тем, разделов или поиска, а затем открывайте ссылки на статьи, чтобы получить видимые имя автора, дату публикации, краткое описание, раздел и URL источника. До запуска просто опишите Thunderbit по-английски, какие данные по статье вам нужны.
Подробнее ->Готов вывести извлечение данных на новый уровень?
Присоединяйся к более чем 200 000 профессионалов, которые уже используют Thunderbit для автоматизации веб-скрапинга.
Бесплатный пробный период дает безлимитные кредиты для 8 веб-страниц.



