Парсер новостей: от заголовков к полным данным статьи





Свяжите заголовки новостей с полными статьями
Превратите список заголовков в записи со статьями и контекстом источника.
Открывайте статьи для получения полных данных
Начните со страницы темы, раздела или результатов поиска. Thunderbit может открыть каждую связанную публикацию и добавить имя автора, время публикации, раздел, краткое описание и URL статьи, если они отображаются на странице.
Обработайте список URL статей
Вставьте ссылки, отобранные редактором или исследователем. Каждая доступная статья станет отдельной строкой, а источник и данные публикации будут привязаны к нужному заголовку.
Обновляйте новостной watchlist
Запланируйте повторный запуск по тем же страницам-источникам позже. Новая таблица покажет статьи и данные заголовков, видимые на тот момент.
Создайте новостной watchlist без разработки парсера
Переходите от заголовков к автору, дате, разделу и данным источника в одной таблице.
Ручные списки или инструменты на селекторах
Больше настроек для каждого источникаAI-агент Thunderbit
Откройте новостную страницу и начнитеПоля статьи и списка в области извлечения
Извлекаются только те данные, которые видны в вашей сессии.
- headline
- article_url
- outlet_name
- author_name
- author_profile_url
- byline
- publication_date
- publication_time
- updated_date
- updated_time
- section
- subsection
- tags
- summary
- lead_paragraph
- body_text_snippet
- dateline_location
- estimated_read_time
- image_url
- image_caption
- image_credit
- video_url
- video_title
- video_duration
- gallery_image_count
- comment_count
- share_count
- related_titles
- related_urls
- publisher_logo_url
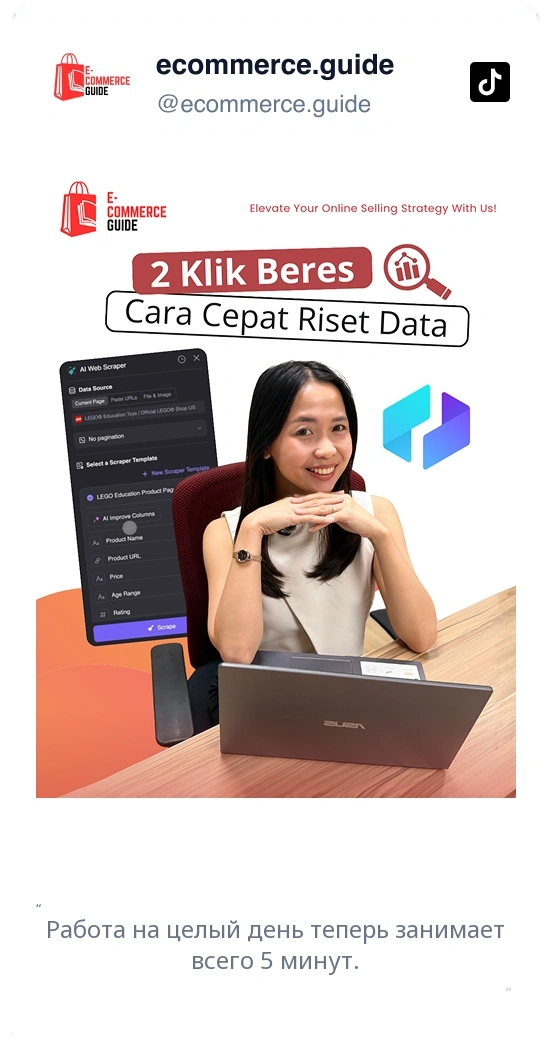
Watch news researchers build a usable watchlist
In user videos, news teams show how they match headlines with article details and check each row.

Вопросы о переходе от заголовков к контексту
Краткие ответы для новостных списков и статей.
Continue from headlines to source research
Collect author pages, press releases, publication archives, or topic feeds that support the same news question.
Парсер Investing.com
Извлекайте биржевые данные — тикеры, цены, объем и рыночную капитализацию — с Investing.com всего в 2 клика, а затем сразу экспортируйте их в Google Sheets, Notion или Excel. Откройте любую страницу Investing.com, и AI сам определит нужные поля.
Подробнее ->
Парсер Substack
Извлекайте количество подписчиков Substack, заголовки статей и описания публикаций всего в 2 клика — затем экспортируйте в Excel, Google Sheets или Notion. Код не нужен: Thunderbit с помощью AI сам всё структурирует за вас.
Подробнее ->
Парсер TechCrunch
Извлекайте статьи TechCrunch, новости стартапов, заголовки, ссылки, даты, имена авторов и краткие сводки всего за 2 клика — без кода. Сразу экспортируйте данные в Excel, Google Sheets или Notion и превращайте сырые новости в структурированную, полезную информацию.
Подробнее ->
Простой ESPN scraper
Отслеживайте имена спортсменов, даты игр и счёт из ESPN всего в 2 клика с AI от Thunderbit — без кода и без настройки. Сразу экспортируйте данные в Excel, Google Sheets или Notion и начинайте использовать спортивную аналитику без лишних шагов.
Подробнее ->
PubMed 爬虫
Thunderbit 的 PubMed 爬虫可借助 AI 帮你从 PubMed 搜索结果和文章页面中提取结构化数据。轻松抓取热门医学研究、临床试验证据、摘要、作者、机构、发表日期和链接,并可导出到 Excel、Google Sheets、Airtable 或 Notion。
Подробнее ->
Парсер статей для текста, авторов и дат
Собирайте заголовки, имена авторов, даты, краткие описания, основной текст, ссылки и медиа с публичных страниц статей. Сохраняйте все данные по каждой статье в одной понятной строке, даже если на новостных сайтах используются разные макеты.
Подробнее ->Готов вывести извлечение данных на новый уровень?
Присоединяйся к более чем 200 000 профессионалов, которые уже используют Thunderbit для автоматизации веб-скрапинга.
Бесплатный пробный период дает безлимитные кредиты для 8 веб-страниц.


