Парсер статей для текста, авторов и дат













Собирайте данные из статей даже при изменении макета страниц
Считывайте поля по смыслу, запускайте сбор повторно по расписанию и используйте один и тот же сценарий на публичных сайтах.
Адаптируйтесь, когда меняется оформление статьи
Thunderbit считывает видимые заголовки, подписи авторов, даты, краткие описания и текст статьи по смыслу. Такой подход меньше зависит от фиксированного расположения элементов, когда новостной сайт меняет свой макет.
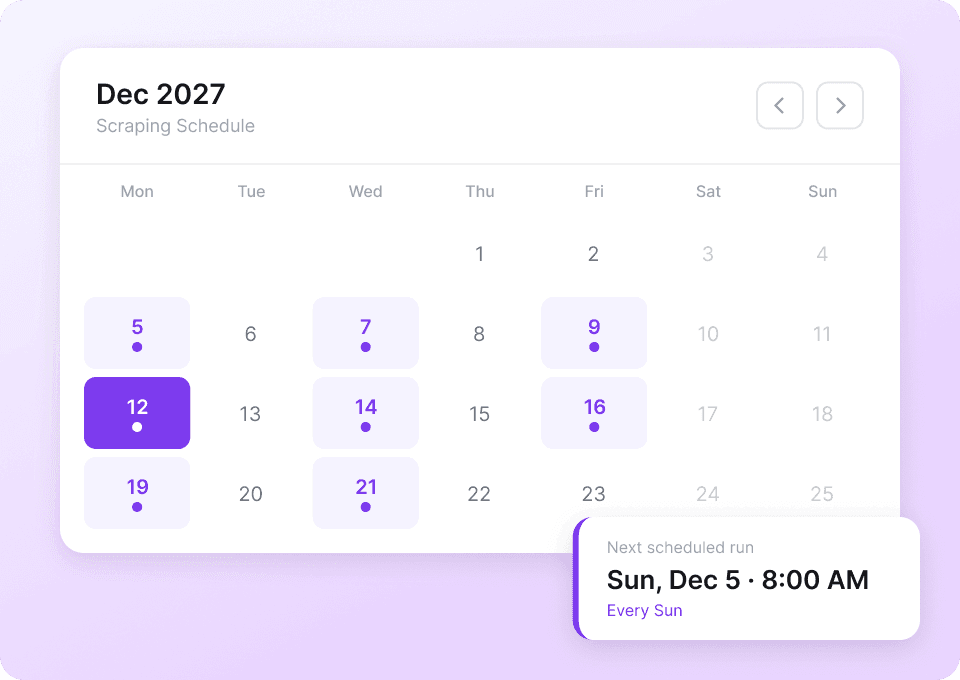
Запускайте сбор статей по расписанию
Настройте повторный запуск для публичной страницы новостей, блога или раздела, к которой вы возвращаетесь. Thunderbit может собирать свежие видимые статьи и отправлять новые строки в выбранный файл или приложение.
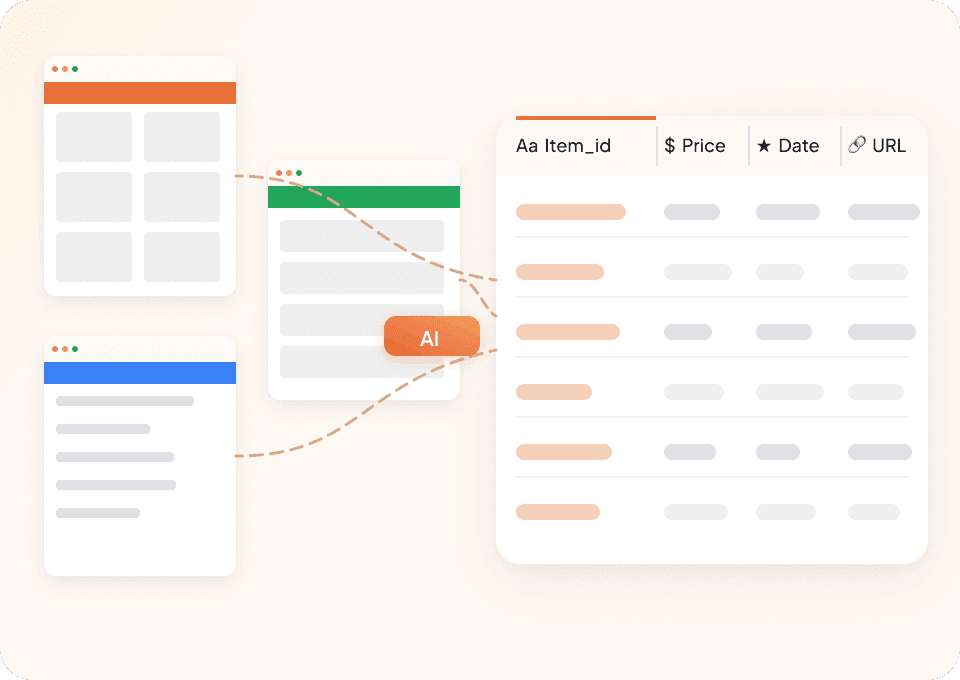
Используйте один сценарий на любом публичном сайте
Применяйте один и тот же процесс на любом публичном сайте со статьями. Укажите нужные поля, а Thunderbit разместит данные со каждой страницы в одинаковых столбцах.
Один сценарий для статей при разном оформлении страниц
Жесткие селекторы ориентируются на позиции. AI от Thunderbit ищет поля статьи, которые вы указали.
Схема селекторов для каждого издателя
Каждый дизайн страницы требует отдельного сопровожденияПоля статьи, упорядоченные Thunderbit
Запрашиваемая запись остается неизменнойКакие данные можно извлечь из статьи?
Выберите из 30 видимых полей: контент, автор, издатель, дата, ссылки, темы, медиа и метаданные страницы.
- Заголовок
- Альтернативный заголовок
- Основной текст статьи
- Краткое содержание статьи
- Имя автора
- URL автора
- Организация автора
- Название издателя
- URL издателя
- Дата публикации
- Дата изменения
- Раздел статьи
- Ключевые слова
- Количество слов
- Язык
- Канонический URL
- URL основной сущности
- URL изображения
- Подпись к изображению
- Авторство изображения
- URL видео
- URL аудио
- Датлайн
- Темы
- Упоминания
- Ссылки на цитаты
- URL лицензии
- Ссылки на связанные статьи
- Заголовок страницы
- Метаописание
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.
Вопросы о сборе публичных статей
Новостные сайты используют разные макеты и детали страницы, поэтому набор полей зависит от конкретной статьи.
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

Парсер Investing.com
Извлекайте биржевые данные — тикеры, цены, объем и рыночную капитализацию — с Investing.com всего в 2 клика, а затем сразу экспортируйте их в Google Sheets, Notion или Excel. Откройте любую страницу Investing.com, и AI сам определит нужные поля.
Подробнее ->
Парсер Substack
Извлекайте количество подписчиков Substack, заголовки статей и описания публикаций всего в 2 клика — затем экспортируйте в Excel, Google Sheets или Notion. Код не нужен: Thunderbit с помощью AI сам всё структурирует за вас.
Подробнее ->
Парсер TechCrunch
Извлекайте статьи TechCrunch, новости стартапов, заголовки, ссылки, даты, имена авторов и краткие сводки всего за 2 клика — без кода. Сразу экспортируйте данные в Excel, Google Sheets или Notion и превращайте сырые новости в структурированную, полезную информацию.
Подробнее ->
Простой ESPN scraper
Отслеживайте имена спортсменов, даты игр и счёт из ESPN всего в 2 клика с AI от Thunderbit — без кода и без настройки. Сразу экспортируйте данные в Excel, Google Sheets или Notion и начинайте использовать спортивную аналитику без лишних шагов.
Подробнее ->
PubMed 爬虫
Thunderbit 的 PubMed 爬虫可借助 AI 帮你从 PubMed 搜索结果和文章页面中提取结构化数据。轻松抓取热门医学研究、临床试验证据、摘要、作者、机构、发表日期和链接,并可导出到 Excel、Google Sheets、Airtable 或 Notion。
Подробнее ->
Парсер новостей: от заголовков к полным данным статьи
Собирайте заголовки со страниц тем, разделов или поиска, а затем открывайте ссылки на статьи, чтобы получить видимые имя автора, дату публикации, краткое описание, раздел и URL источника. До запуска просто опишите Thunderbit по-английски, какие данные по статье вам нужны.
Подробнее ->Готов вывести извлечение данных на новый уровень?
Присоединяйся к более чем 200 000 профессионалов, которые уже используют Thunderbit для автоматизации веб-скрапинга.
Бесплатный пробный период дает безлимитные кредиты для 8 веб-страниц.



