Парсер Substack













Откройте данные Substack с Thunderbit
Отправляйте данные Substack прямо в ваши приложения
Хватит вручную копировать и вставлять сведения о публикациях Substack — имена авторов, заголовки статей и количество подписчиков. С Thunderbit достаточно одного клика, чтобы отправить извлечённые данные напрямую в Google Sheets, Notion или Airtable — и анализировать тренды публикаций и эффективность контента без утомительной ручной работы.
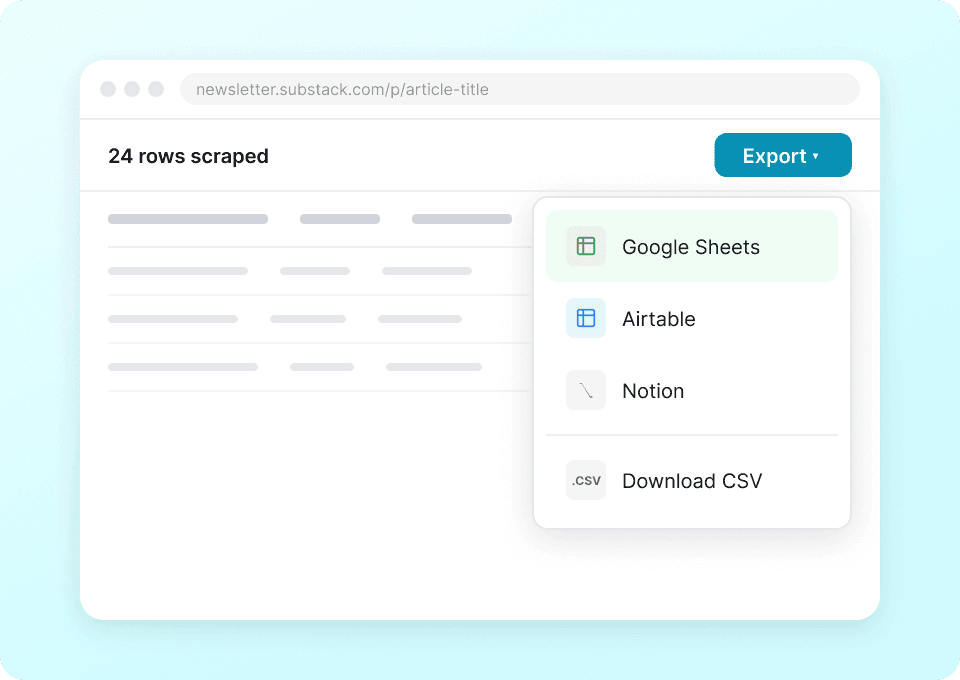
Один парсер для Substack и не только
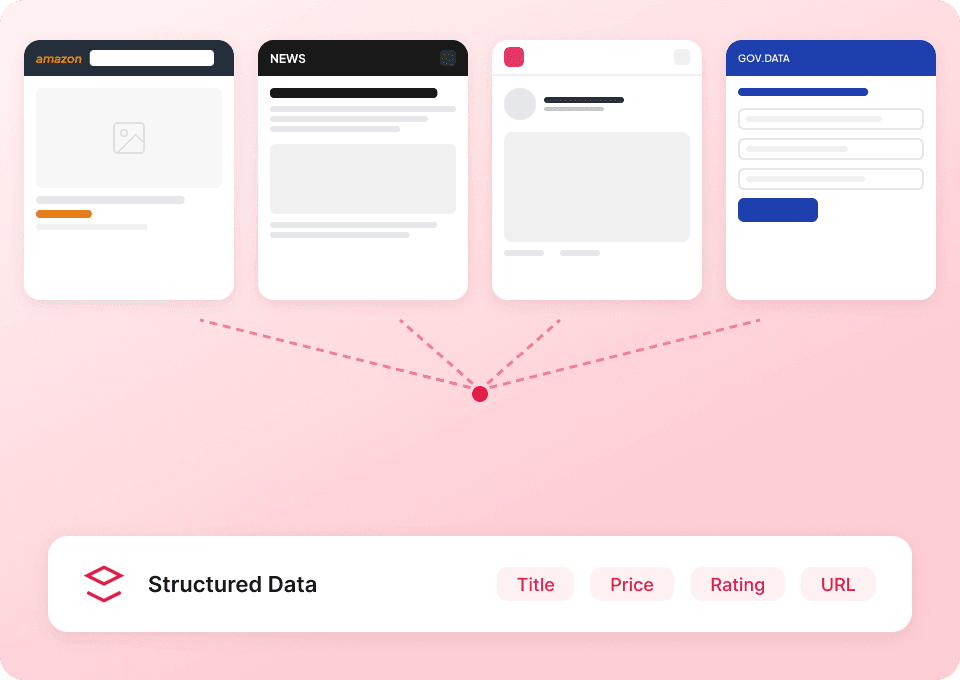
Не нужно держать отдельный инструмент для каждого сайта. Thunderbit работает с Substack из коробки и включает более 50 готовых шаблонов для других популярных платформ. Извлекайте описания публикаций, контент статей и многое другое — а затем используйте тот же инструмент для сбора данных с любых других сайтов.
Получите полную картину Substack
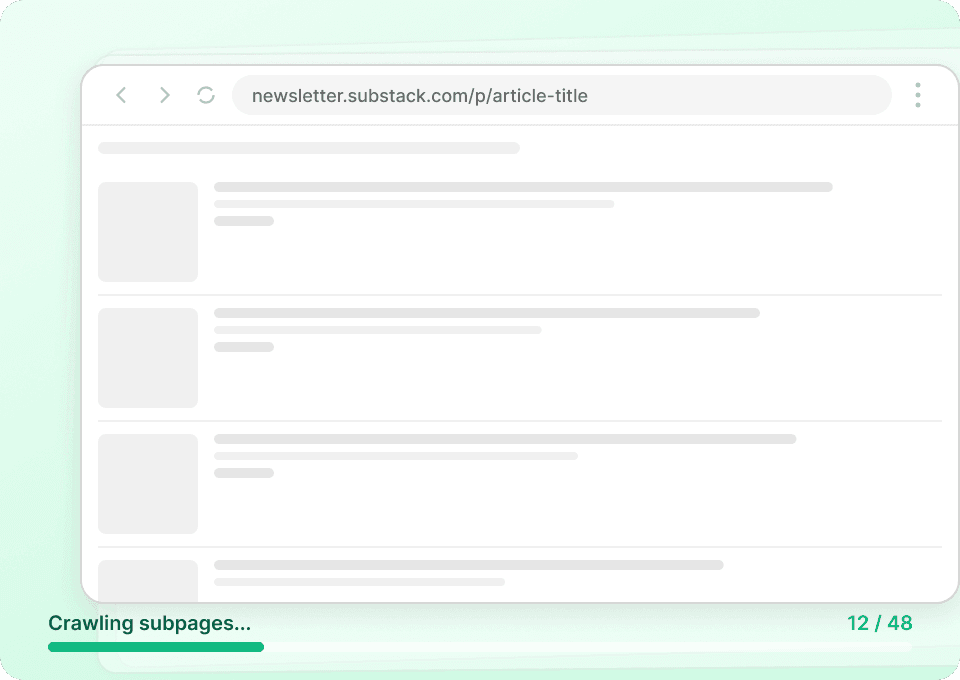
На страницах списков Substack видны только краткие сводки. Thunderbit автоматически открывает каждую страницу статьи, чтобы собрать полный текст и за один проход сформировать полноценный набор данных. Захватывайте заголовки статей, имена авторов, названия публикаций и полный текст — без ручного открытия страниц.
Сложно эффективно парсить Substack?
Посмотрите, почему Thunderbit превосходит традиционные парсеры для данных Substack.
Традиционные парсеры
Старый способ работыThunderbit
Более умный подход

Часто задаваемые вопросы
Похожие сценарии использования
Изучи больше сценариев использования веб-скрапера Thunderbit.

Парсер Investing.com
Извлекайте биржевые данные — тикеры, цены, объем и рыночную капитализацию — с Investing.com всего в 2 клика, а затем сразу экспортируйте их в Google Sheets, Notion или Excel. Откройте любую страницу Investing.com, и AI сам определит нужные поля.
Подробнее ->
Парсер TechCrunch
Извлекайте статьи TechCrunch, новости стартапов, заголовки, ссылки, даты, имена авторов и краткие сводки всего за 2 клика — без кода. Сразу экспортируйте данные в Excel, Google Sheets или Notion и превращайте сырые новости в структурированную, полезную информацию.
Подробнее ->
Простой ESPN scraper
Отслеживайте имена спортсменов, даты игр и счёт из ESPN всего в 2 клика с AI от Thunderbit — без кода и без настройки. Сразу экспортируйте данные в Excel, Google Sheets или Notion и начинайте использовать спортивную аналитику без лишних шагов.
Подробнее ->
PubMed 爬虫
Thunderbit 的 PubMed 爬虫可借助 AI 帮你从 PubMed 搜索结果和文章页面中提取结构化数据。轻松抓取热门医学研究、临床试验证据、摘要、作者、机构、发表日期和链接,并可导出到 Excel、Google Sheets、Airtable 或 Notion。
Подробнее ->
Парсер статей для текста, авторов и дат
Собирайте заголовки, имена авторов, даты, краткие описания, основной текст, ссылки и медиа с публичных страниц статей. Сохраняйте все данные по каждой статье в одной понятной строке, даже если на новостных сайтах используются разные макеты.
Подробнее ->
Парсер новостей: от заголовков к полным данным статьи
Собирайте заголовки со страниц тем, разделов или поиска, а затем открывайте ссылки на статьи, чтобы получить видимые имя автора, дату публикации, краткое описание, раздел и URL источника. До запуска просто опишите Thunderbit по-английски, какие данные по статье вам нужны.
Подробнее ->Готов вывести извлечение данных на новый уровень?
Присоединяйся к более чем 200 000 профессионалов, которые уже используют Thunderbit для автоматизации веб-скрапинга.
Бесплатный пробный период дает безлимитные кредиты для 8 веб-страниц.



