
Thunderbit — это Chrome-расширение AI Web Scraper, которое помогает бизнес-пользователям собирать данные с веб-сайтов с помощью ИИ. Главный вопрос здесь такой: то, что на странице тарифов ScrapingBee выглядит доступно, в реальной продакшн-нагрузке может обернуться совсем другой суммой, когда кредиты сгорают в 5×–75× быстрее базовой ставки. В этом обзоре я разберу пять аспектов, которые чаще всего упускают другие статьи: реальную стоимость на масштабе, извлечение по селекторам против ИИ-экстракции, удобство для не-разработчиков, постобработку данных после парсинга и показатели надежности за 2026 год. Если ты оцениваешь ScrapingBee для своей команды — будь ты разработчиком, руководителем sales ops или основателем — здесь ты найдешь именно тот разбор, который нужен.
Что такое ScrapingBee? Краткий обзор
ScrapingBee — это API для веб-скрейпинга, которое берет на себя ротацию прокси, рендеринг JavaScript и обход CAPTCHA, чтобы разработчики могли извлекать данные с сайтов без собственной инфраструктуры для парсинга. Ты отправляешь HTTP-запрос с параметрами и получаешь HTML (а для некоторых endpoint'ов — JSON) в ответ. Визуального интерфейса или конструктора на кликах для настройки парсинга здесь нет.
Ключевые возможности:
- Ротация и премиум-прокси (classic, premium, stealth, residential)
- Рендеринг headless-браузера (полный Chrome, включен по умолчанию)
- Автоматический обход CAPTCHA
- Google Search API (структурированный JSON: органическая выдача, реклама, карты, knowledge graph, People Also Ask, изображения, новости)
- Снимки экрана (обычный, полноэкранный или по CSS-селектору)
- Геотаргетинг через параметр country_code
- Правила извлечения по CSS/XPath (декларативный JSON-формат, возвращает структурированный JSON)
- Отдельные API для парсинга Amazon, Walmart, YouTube и ChatGPT
- ИИ-извлечение (добавлено примерно в 2024–2025): параметры ai_query, ai_extract_rules, ai_selector (+5 кредитов за запрос)
- CLI-утилита (запущена примерно в 2025–2026): пакетная обработка, краулинг, разбор sitemap, обогащение CSV, запланированные cron-задачи, усиление прокси
Основанная в 2019 году во Франции, ScrapingBee к началу 2026 года выросла примерно до $5 million ARR и обслуживала более 2,500 клиентов (SAP, Zapier, Deloitte, Zillow) — и все это без внешних инвестиций, силами команды из 4–6 человек. В июне 2025 года Oxylabs Group приобрела ScrapingBee в сделке на восьмизначную сумму. При этом бренд и руководство остались независимыми, а команда поддержки более чем удвоилась ради лучшего покрытия по часовым поясам.
Важно: у ScrapingBee по-прежнему нет нативного визуального конструктора, интерфейса с point-and-click и встроенного планировщика в веб-панели. Планирование возможно только через CLI, cron-задачи или сторонние инструменты автоматизации (Zapier, Make, n8n). Их материалы о "no-code" на самом деле про интеграции с Make и Zapier — а не про собственный no-code интерфейс.
Для кого на самом деле создан ScrapingBee?
ScrapingBee рассчитан на разработчиков, которым комфортно писать Python- или cURL-вызовы, читать HTML и собирать CSS/XPath-селекторы. Документация здесь очень кодо-ориентированная, с упором на примеры для Python и cURL. Один из авторов отзывов на Capterra отметил, что там "нет примеров на JavaScript", а другой назвал документацию "громоздкой, на ее изучение уходит от одного дня до недели".
Но аудитория, которая ищет обзор ScrapingBee в 2026 году, шире, чем backend-разработчики. Это и маркетологи, собирающие списки лидов, и sales ops-команды, обогащающие CRM-данные, и ecommerce-операции, отслеживающие цены конкурентов, и основатели, сравнивающие инструменты для своей команды. В каждом разделе ниже я отдельно отмечу, относится ли ограничение или функция к разработчикам, бизнес-пользователям или к обеим группам.
Тарифы ScrapingBee с первого взгляда
Актуальные тарифы ScrapingBee (на апрель 2026 года):
| План | Ежемесячная цена | API-кредиты/месяц | Одновременные запросы |
|---|---|---|---|
| Freelance | $49 | 250,000 | 10 |
| Startup | $99 | 1,000,000 | 50 |
| Business | $249 | 3,000,000 | 100 |
| Business+ | $599 | 8,000,000 | 200 |
| Enterprise | Свяжитесь с отделом продаж | 41M+ | Индивидуально |
При годовой оплате действует скидка 17%. Бесплатная пробная версия дает 1,000 API-кредитов без привязки банковской карты. После поглощения стоимость Google Search API недавно была снижена с 25 до 15 кредитов за один вызов.
На бумаге эти цифры выглядят щедро. Но реальность сложнее.
Таблица множителей кредитов
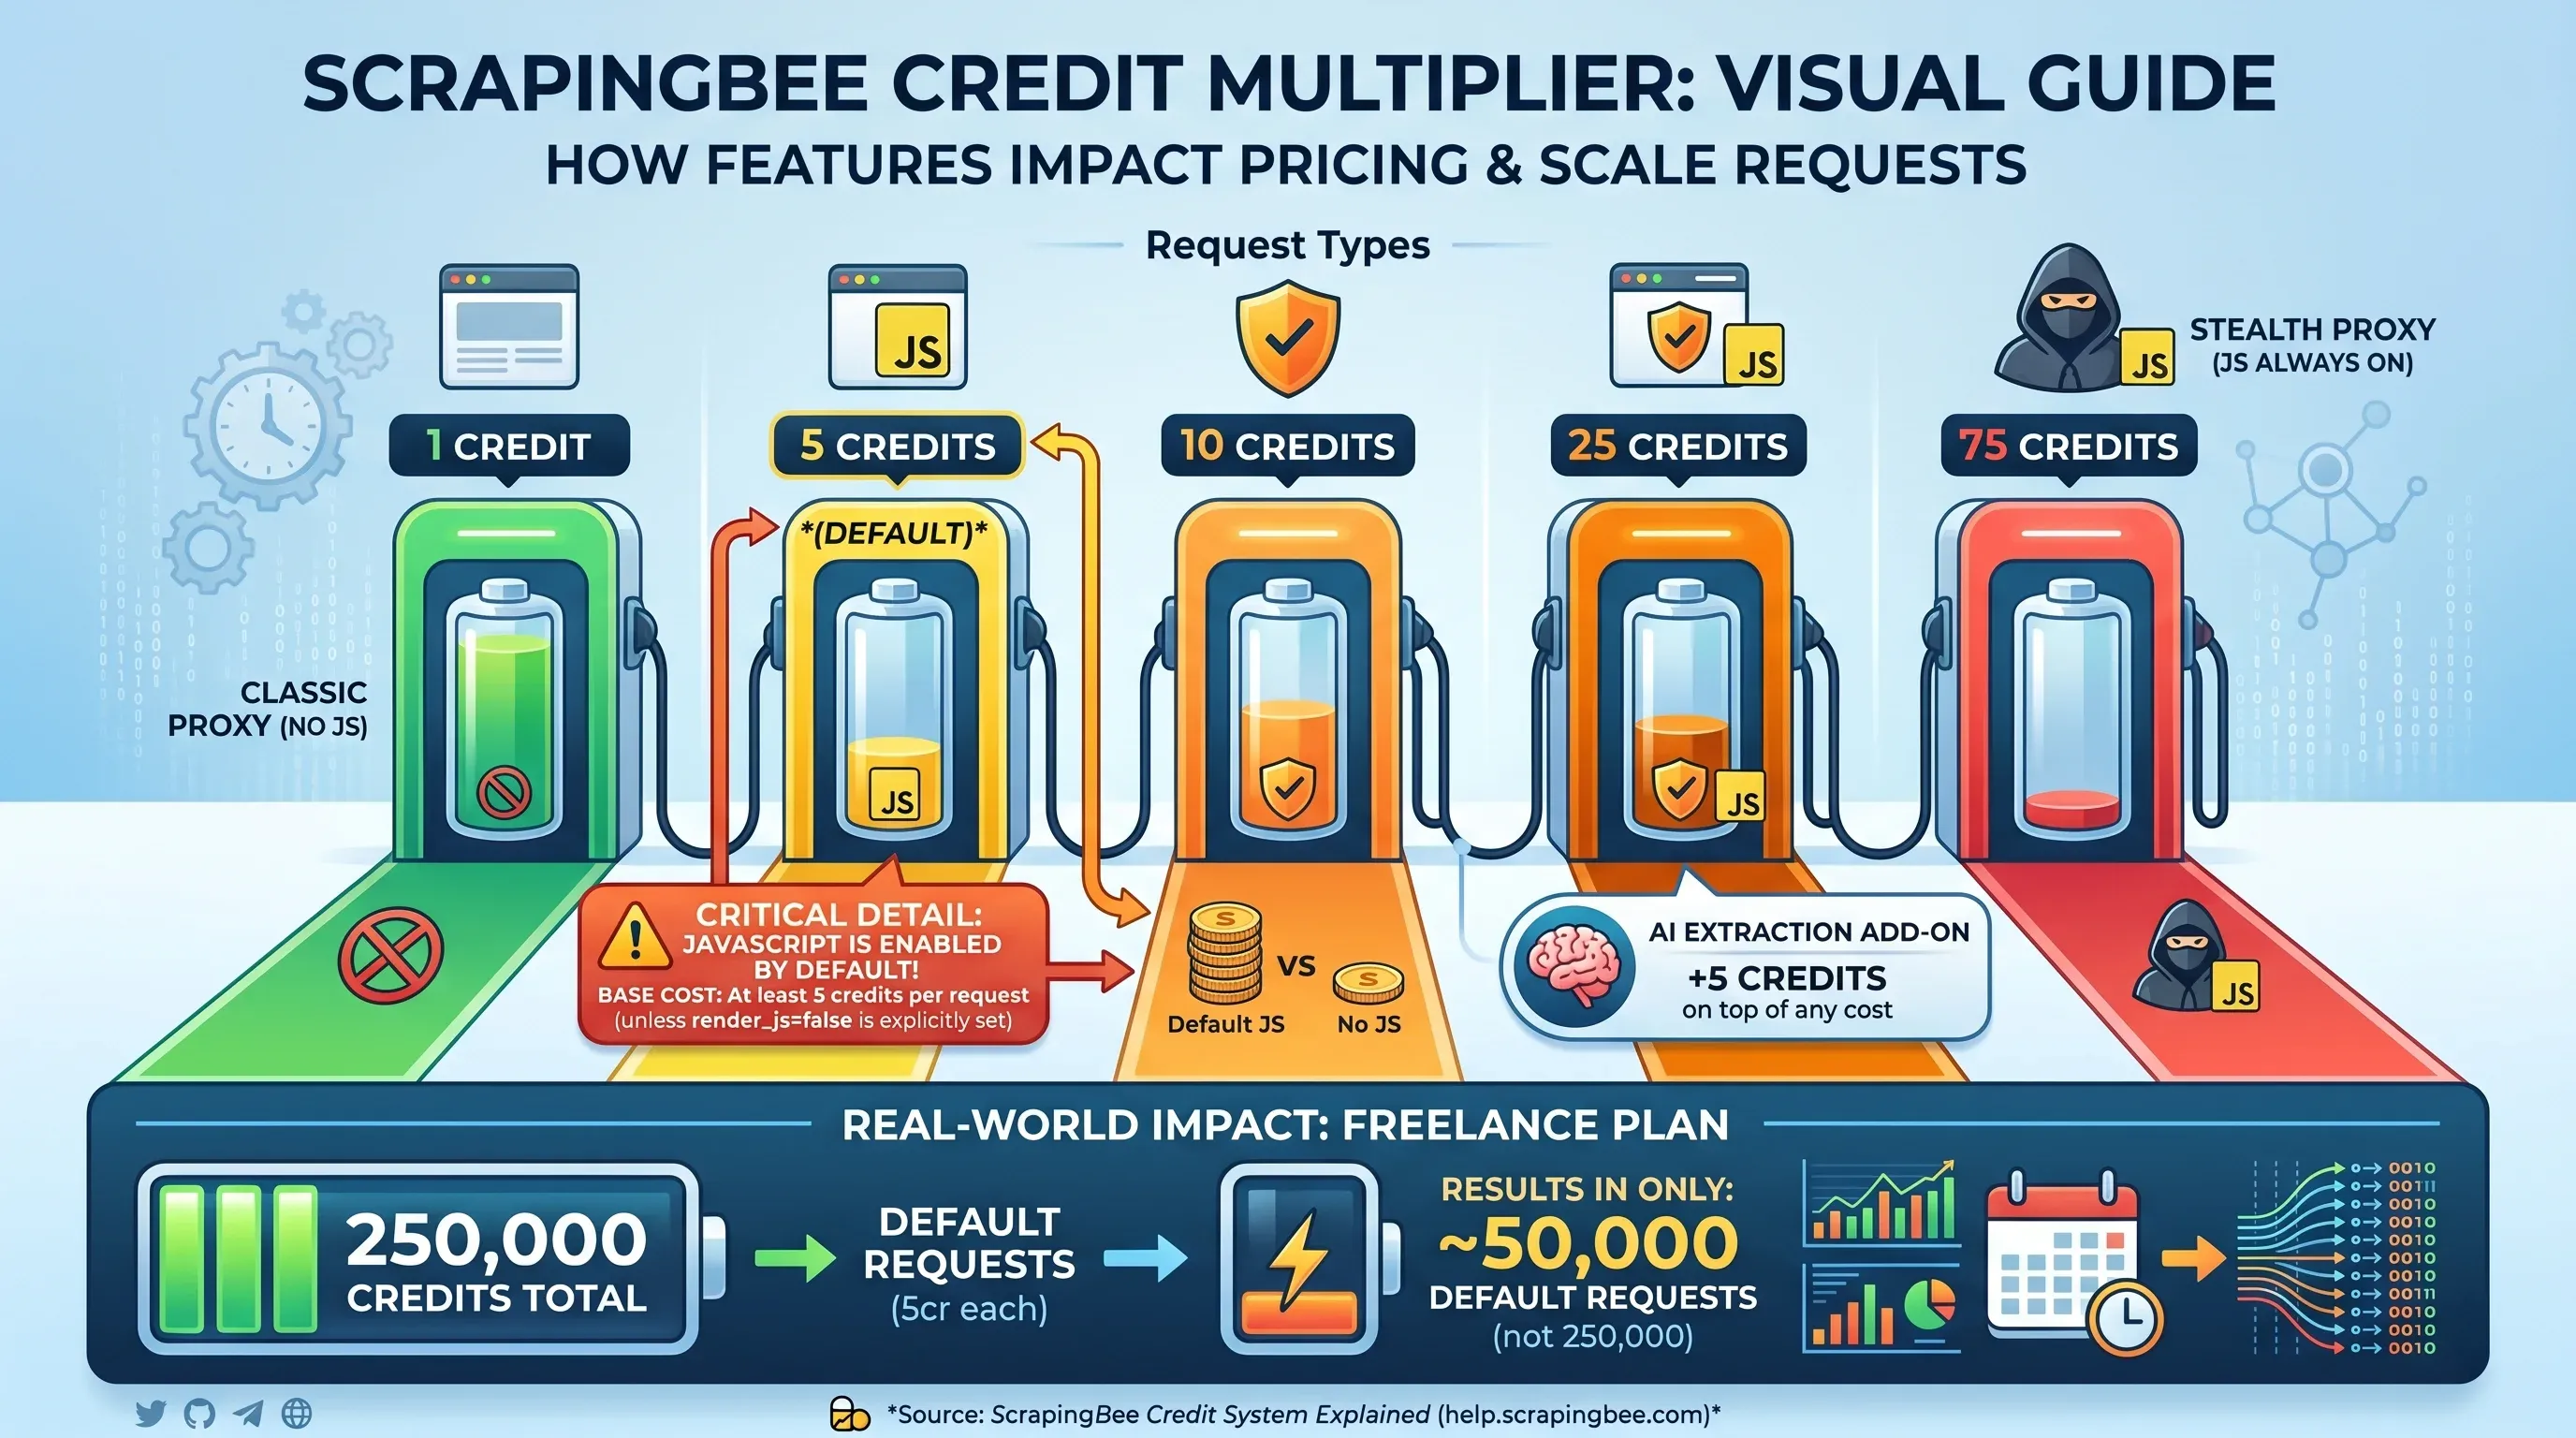
Вот где у ScrapingBee начинается ценовая сложность. Указанное количество кредитов — это не количество страниц, которые ты сможешь просканировать. Все зависит от того, какие функции ты включаешь в каждом запросе:
| Тип запроса | Кредитов за запрос |
|---|---|
Classic proxy, без рендеринга JS (render_js=false) | 1 кредит |
| Classic proxy, с рендерингом JS (по умолчанию) | 5 кредитов |
| Premium proxy, без рендеринга JS | 10 кредитов |
| Premium proxy, с рендерингом JS | 25 кредитов |
| Stealth proxy (JS всегда включен) | 75 кредитов |
| Дополнение AI extraction | +5 кредитов сверху |
Критически важная деталь: рендеринг JavaScript включен по умолчанию. Если явно не указать render_js=false, каждый запрос будет стоить минимум 5 кредитов. Это значит, что 250,000 кредитов в плане Freelance фактически хватает только на 50,000 стандартных запросов — а не на 250,000.
Скрытая математика кредитов, которую вам обычно не показывают
Вот сколько на самом деле стоит ScrapingBee для 10,000 страниц в разных сценариях и на разных тарифах:
| Сценарий | Нужно кредитов | Freelance ($49/250K) | Startup ($99/1M) | Business ($249/3M) |
|---|---|---|---|---|
| 10K страниц (статичный HTML, 1 cr) | 10,000 | ✅ Хватает ($0.20/1K) | ✅ Хватает ($0.10/1K) | ✅ Хватает ($0.08/1K) |
| 10K страниц (JS render, 5 cr) | 50,000 | ✅ Хватает ($0.98/1K) | ✅ Хватает ($0.50/1K) | ✅ Хватает ($0.42/1K) |
| 10K страниц (premium proxy + JS, 25 cr) | 250,000 | ⚠️ Ровно впритык ($4.90/1K) | ✅ Хватает ($2.48/1K) | ✅ Хватает ($2.08/1K) |
| 10K страниц (stealth proxy, 75 cr) | 750,000 | ❌ Сильно превышает лимит | ✅ Едва хватает ($7.43/1K) | ✅ Хватает ($6.23/1K) |
Одни и те же 10,000 страниц могут стоить от $0.20 до $7.43 за тысячу — в зависимости от прокси и настроек рендеринга. И заранее не всегда понятно, какая конфигурация тебе понадобится.
Бюджетный сценарий: лидогенерация на 10,000 страниц в месяц
Представь sales-команду, которая собирает данные с 10,000 страниц компаний в месяц для лидогенерации. Большинство современных B2B-сайтов работают на React или Vue, поэтому нужен JS-рендеринг:
- Нужно кредитов: 50,000 (10K × 5 кредитов)
- План Freelance ($49): хватает, остается 200K кредитов
- Но если целевые сайты требуют premium proxy: 250,000 кредитов — ровно лимит одного Freelance-плана, без запаса
- Если нужны stealth-прокси: 750,000 кредитов — нужен план Startup за $99/месяц
Бюджетный сценарий: мониторинг цен в ecommerce на 100,000 страниц в месяц
Команда ecommerce отслеживает 100,000 карточек товаров на сайтах конкурентов:
| Конфигурация | Нужно кредитов | Нужный план | Ежемесячная стоимость |
|---|---|---|---|
| Статичный HTML (1 cr) | 100,000 | Freelance | $49 |
| JS rendering (5 cr) | 500,000 | Startup | $99 |
| Premium proxy + JS (25 cr) | 2,500,000 | Business | $249 |
| Stealth proxy (75 cr) | 7,500,000 | Business+ | $599 |
Одна и та же задача может стоить от $49 до $599 в месяц. Это не погрешность округления — это разница в 12 раз в зависимости от конфигурации.
"Стартовая цена $49 — самый вводящий в заблуждение показатель на рынке scraping API." — Prospeo
"Кредиты сгорают очень быстро, когда используешь рендеринг JavaScript или продвинутые функции, поэтому инструмент сложнее оправдать для небольших проектов или команд с непредсказуемыми объемами скрейпинга." — Nick S, Manager, Computer Software, Capterra
И неиспользованные кредиты не переносятся на следующий месяц.
Как стоимость ScrapingBee выглядит на фоне конкурентов
Сравнение на базе тарифов среднего уровня:
| Сценарий (на 1K страниц) | ScrapingBee ($99/1M) | ScraperAPI ($149/1M) | Scrapfly ($100/1M) |
|---|---|---|---|
| Статичный HTML | $0.10 | $0.15 | $0.10 |
| Страницы с JS-рендерингом | $0.50 | $1.64 | $0.60 |
| Premium + JS | $2.48 | $3.73 | $3.00 |
| Stealth/ultra premium + JS | $7.43 | $11.18 | N/A |
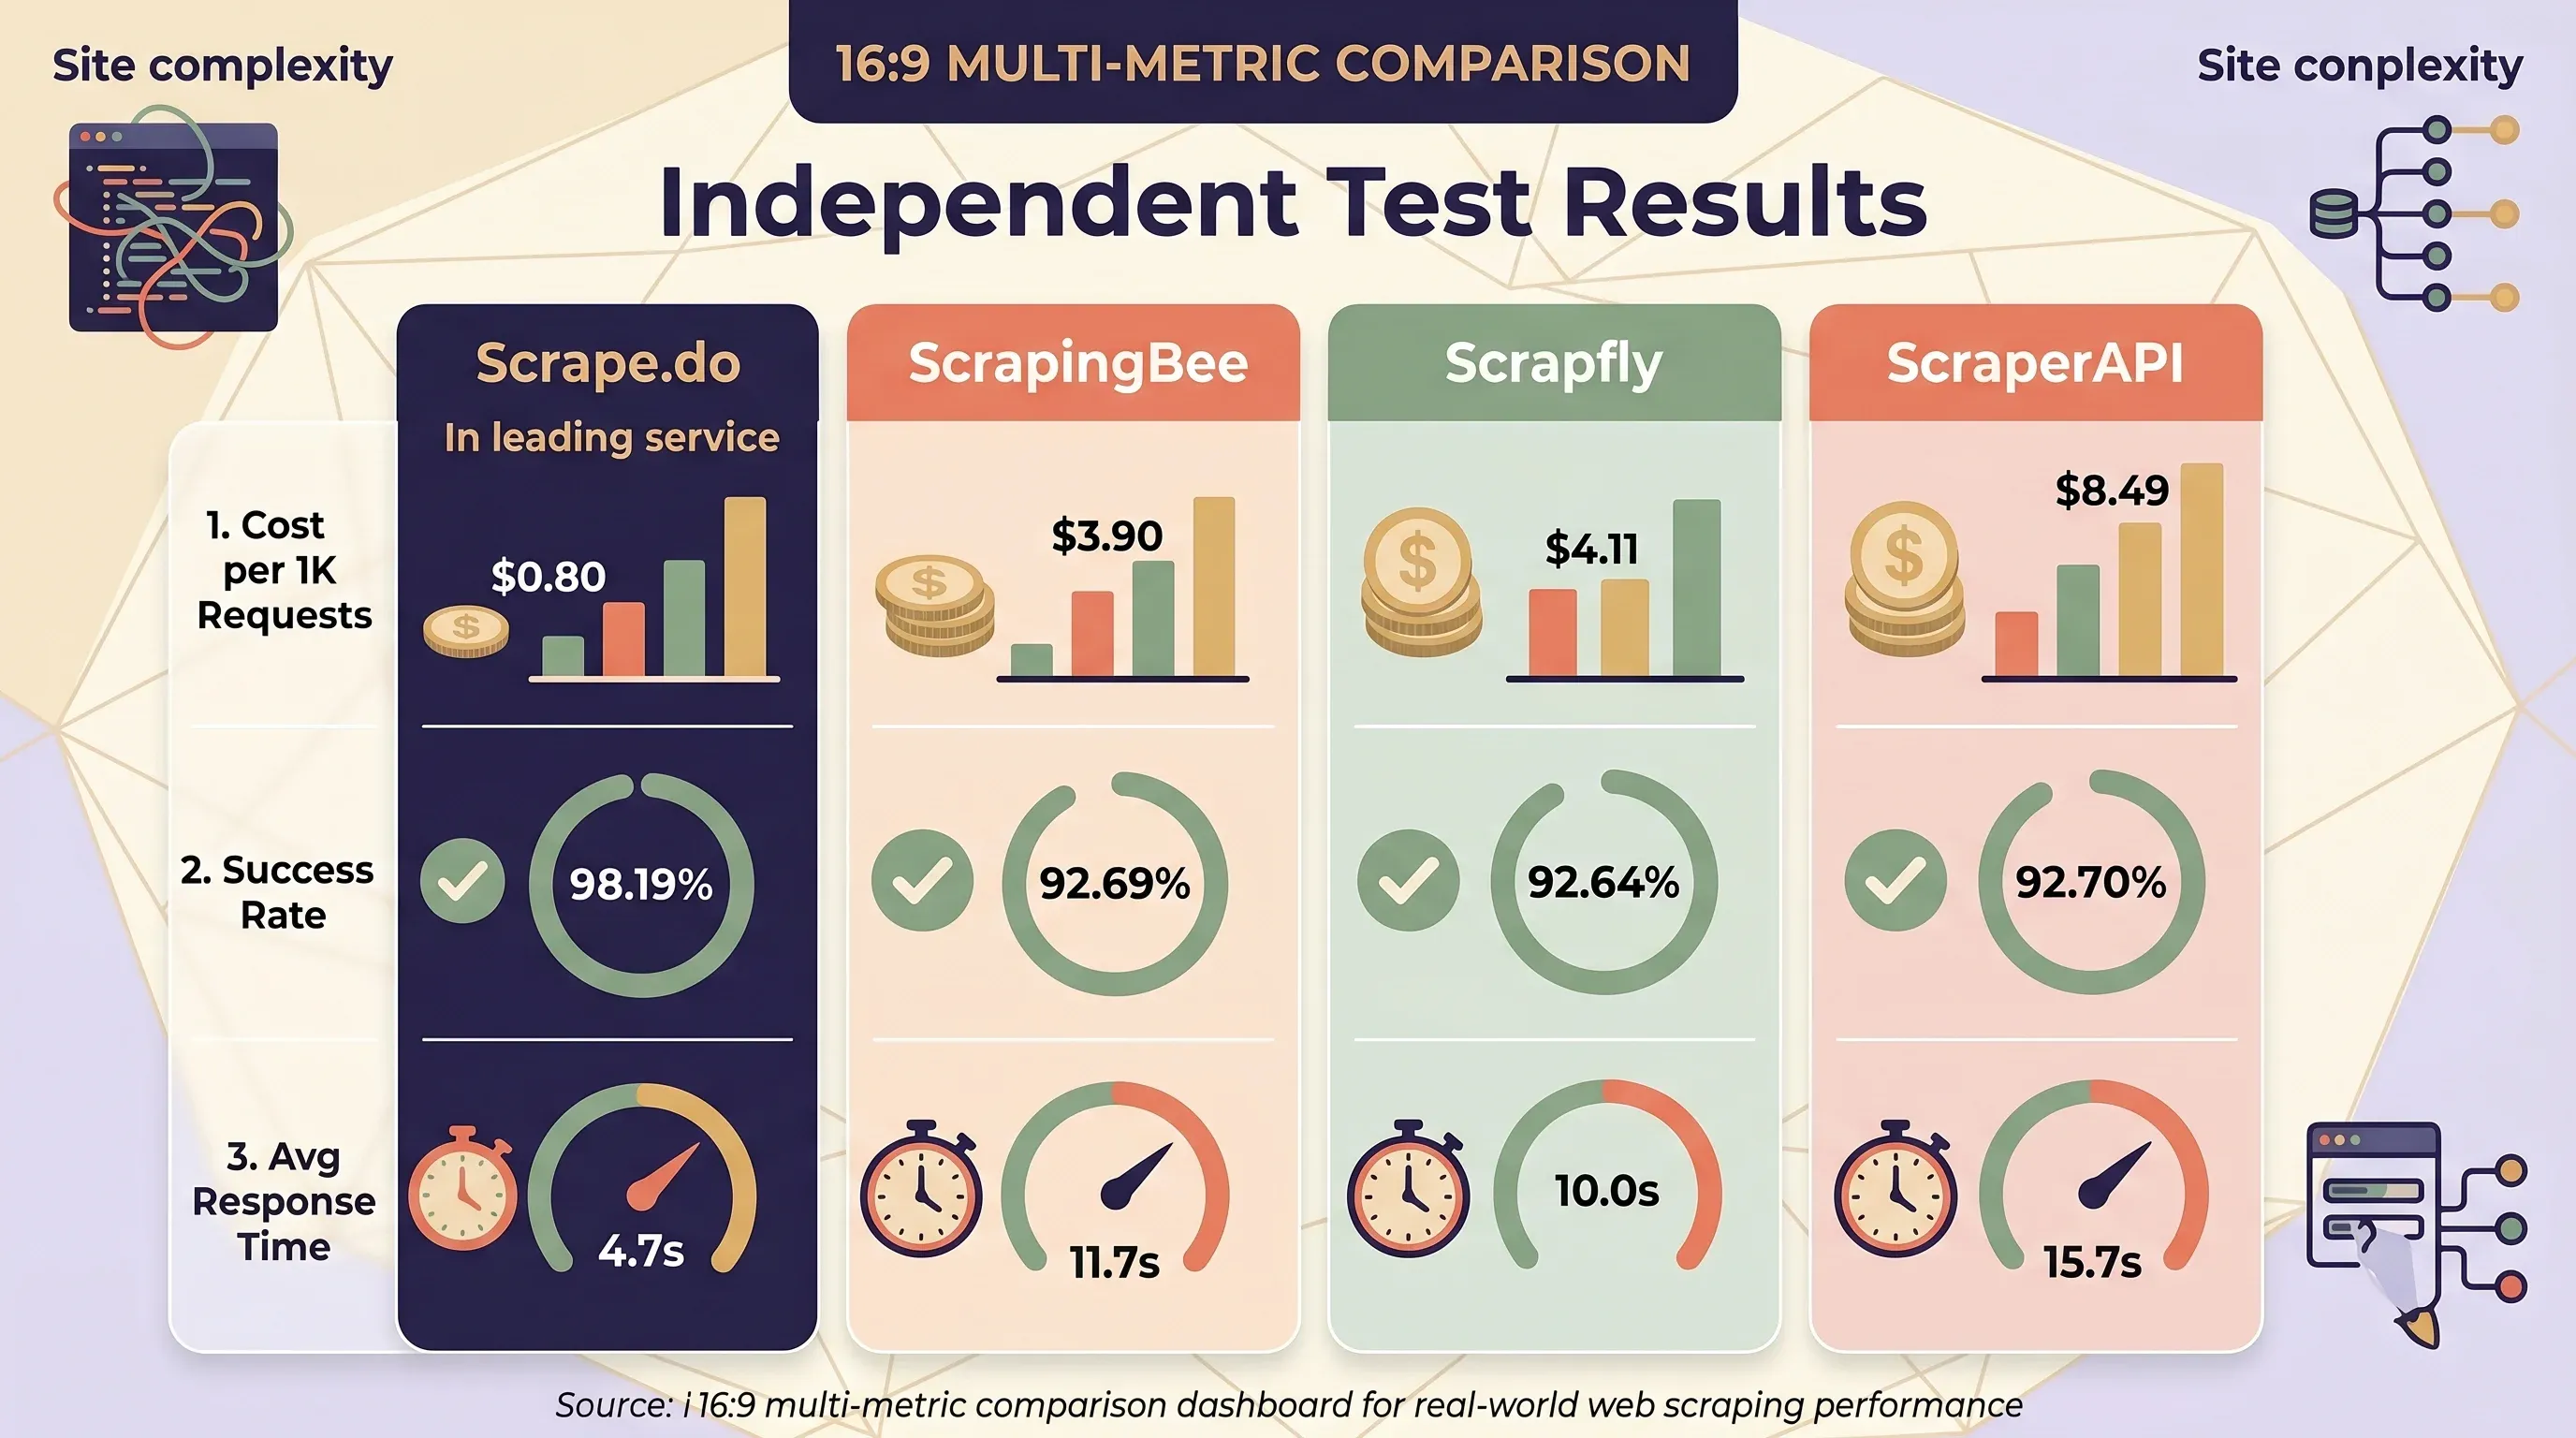
ScrapingBee обычно либо самый дешевый, либо делит первое место по цене для статичных и JS-рендеренных страниц. ScraperAPI стабильно оказывается самым дорогим — у него JS-рендеринг стоит +10 кредитов против +5 у ScrapingBee и Scrapfly. Но независимое тестирование от Scrape.do показывает другую картину, если учитывать реальную сложность сайтов:
| Сервис | Средняя цена за 1K запросов | Процент успешности | Среднее время ответа |
|---|---|---|---|
| Scrape.do | $0.80 | 98.19% | 4.7s |
| ScrapingBee | $3.90 | 92.69% | 11.7s |
| Scrapfly | $4.11 | — | — |
| ZenRows | $4.48 | 92.64% | 10.0s |
| ScraperAPI | $8.49 | 92.70% | 15.7s |
Модель кредитов Thunderbit: другой подход
Thunderbit использует принципиально более простую модель ценообразования: 1 кредит = 1 строка результата, без множителей за JS-рендеринг, тип прокси или домен цели. Парсинг подстраниц стоит 2 кредита за строку.
| План | Ежемесячная цена | Кредиты | Стоимость за строку |
|---|---|---|---|
| Free | $0 | 6 страниц/месяц | Бесплатно |
| Starter | $15 | 500 | $0.030 |
| Pro 1 | $38 | 3,000 | $0.013 |
| Pro 2 | $75 | 6,000 | $0.013 |
| Pro 3 | $125 | 10,000 | $0.013 |
| Pro 4 | $249 | 20,000 | $0.012 |
Пользователь Thunderbit, который собирает 10,000 товарных карточек с ecommerce-сайтов с тяжелым JS, платит $125 в месяц — независимо от того, нужен ли этим сайтам JS-рендеринг, premium-прокси или обход антибот-защиты. В ScrapingBee та же работа может стоить от $49 до $599 в зависимости от конфигурации. Предсказуемость бюджета — это реальная ценность.
CSS-селекторы против ИИ-экстракции: скрытая стоимость поддержки, о которой стоит знать
Большинство обзоров ScrapingBee вообще не затрагивает эту тему. А зря: для тех, кто планирует скрейпить сайтами месяцами или годами, это, пожалуй, один из самых важных факторов.
ScrapingBee использует CSS/XPath-селекторы для извлечения данных из HTML. Ты задаешь правила извлечения в JSON-объектах, указывая CSS-селекторы, и ScrapingBee возвращает совпавшие данные. Сначала это работает хорошо. Проблема начинается потом.
Проблема поломки селекторов
Когда сайт-цель меняет верстку — имена классов, структуру DOM, версию фреймворка — ваши CSS-селекторы ломаются. В зрелых скрейпинг-системах, которые одновременно ведут 2,500+ активных задач, исследования показывают 1–2% еженедельной поломки, что означает 30–35 исправлений в неделю только для поддержания работы экстракторов. Для организаций, скрейпящих 50 сайтов, годовая поддержка занимает 850–1,300 часов и обходится в $64,000–$156,000 при полной стоимости инженерного часа.
Команды регулярно недооценивают этот фактор. На старте обычно закладывают 10–15 часов поддержки в месяц, но в реальности нагрузка оказывается в 4–6 раз выше — 40–90 часов в месяц. Один незаметный сбой, когда селектор ломается, но продолжает возвращать пустые данные без сигналов тревоги, может стоить примерно $38,000–$57,000 из-за потери продаж, восстановления позиций и времени сотрудников.
Типичные причины: переименование CSS-классов после обновления фреймворка, добавление новых контейнеров вокруг нужных элементов, обновления React/Vue/Angular, меняющие DOM, A/B-тесты с динамическими классами и антискрейпинг-обфускация.
ИИ-извлечение сокращает поддержку на 60–80%
Исследование DataRobot за 2025 год показало, что ИИ-скрейперы после редизайна сайтов требуют на 70% меньше поддержки, чем классические селекторные скрейперы. Соотношение времени фактически переворачивается:
| Показатель | Традиционный подход (CSS-селекторы) | На базе ИИ |
|---|---|---|
| Поддержка после редизайна | Базовый уровень | на 70% меньше |
| Распределение времени (настройка : поддержка) | 20% : 80% | 5% : 95% по данным |
| Общее снижение затрат на поддержку | Базовый уровень | 60–80% reduction |
| Скорость на страницах с тяжелым JS | Базовый уровень | на 30–40% быстрее |
Время настройки: писать селекторы вручную или получать поля от ИИ
Настройка ScrapingBee: открыть исходный код страницы → найти CSS-селекторы → прописать правила извлечения в JSON → протестировать и отладить → учесть крайние случаи для вариаций страницы → следить за поломками → исправлять сломанные селекторы после обновлений сайта.
Настройка Thunderbit: открыть страницу в Chrome → нажать "AI Suggest Fields" → ИИ читает страницу и предлагает столбцы с нужными типами данных → нажать "Scrape". Без написания селекторов, без изучения исходного кода. ИИ Thunderbit работает на нескольких фундаментальных моделях (ChatGPT, Gemini, Claude, DeepSeek R1), которые визуально читают веб-страницы почти как человек.
Функция Field AI Prompts в Thunderbit добавляет еще один слой: для каждого столбца можно задать собственную ИИ-инструкцию, которая преобразует данные прямо во время извлечения — форматировать даты, переводить текст, классифицировать товары, разбивать имена, нормализовать телефоны. Это убирает отдельный этап постобработки, который пользователям ScrapingBee приходится строить самостоятельно.
Структурированный результат: сырой HTML или готовые к работе строки
| Параметр | ScrapingBee (на основе селекторов) | Thunderbit (на базе ИИ) |
|---|---|---|
| Формат по умолчанию | Сырой HTML | Структурированные строки с типизированными столбцами |
| Структурированное извлечение | Требует CSS/XPath-правил или AI-дополнения (+5 кредитов) | ИИ автоматически определяет поля |
| Поддерживаемые типы данных | Текст (нужен разбор HTML) | Текст, число, дата, URL, email, телефон, изображение |
| Устойчивость к изменениям верстки | ⚠️ Нужны ручные обновления селекторов | ✅ ИИ заново читает страницу каждый раз |
| Требуемый уровень навыков | Python/cURL, CSS-селекторы, понимание HTML | Никаких — Chrome-расширение с двухшаговым процессом |
| Поддержка со временем | Постоянная (1–2% еженедельной поломки) | Минимальная (ИИ адаптируется автоматически) |
ScrapingBee добавил функции ИИ-извлечения (ai_query, ai_extract_rules), которые частично решают проблему поддержки селекторов. Но они добавляют +5 кредитов к каждому запросу поверх базовой стоимости, а сам инструмент по-прежнему остается API-first без визуального интерфейса.
ScrapingBee для не-разработчиков: честная проверка удобства
ScrapingBee не создан для нетехнических пользователей. Это API. Чтобы им пользоваться, нужно писать код. Если ты маркетинг-менеджер или руководитель sales ops и читаешь это, то этим сказано почти все.
Вот что реально испытывает нетехнический пользователь при работе со ScrapingBee:
- Написать API-вызов на Python, cURL или другом языке
- Разобраться в HTTP-параметрах вроде
render_js=true,premium_proxy=true,country_code=us - Разобрать сырой HTML-ответ с помощью библиотеки вроде BeautifulSoup
- Написать CSS-селекторы для нужных полей
- Обработать пагинацию через собственную логику краулинга (ScrapingBee обрабатывает только одиночные запросы к страницам)
- Построить data pipeline для очистки, структурирования и хранения данных
Здесь нет drag-and-drop конструктора. Нет интерфейса с кликами. Нет визуального предпросмотра того, что ты собираешь.
"Там есть кривая обучения. И документация громоздкая, на ее изучение уходит от одного дня до недели." — Arvind K, Proprietor, Financial Services, Capterra
"Их система очень специфична, и нужно время, чтобы разобраться в их кодах и структуре." — Capterra review
Разработчикам это нравится. Один из рецензентов назвал продукт "полностью API-based: очень современный и элегантный: просто работает". Но "удобство использования" для разработчика, выбирающего API, — это совсем не то же самое, что "удобство" для человека, который пытается собрать список лидов без написания кода.
Когда no-code альтернатива имеет больше смысла
Thunderbit Chrome Extension предлагает принципиально другой опыт:
- Открой страницу в Chrome с установленным расширением
- Нажми "AI Suggest Fields" — ИИ сканирует страницу и предлагает столбцы (Product Name, Price, Rating, URL и т. д.) с подходящими типами данных
- Проверь и настрой — добавляй, удаляй или переименовывай столбцы; добавляй Field AI Prompts для преобразований
- Нажми "Scrape" — данные извлекаются в структурированные строки
- Экспортируй — одним кликом в Google Sheets, Airtable, Notion, Excel, CSV или JSON (все экспорты бесплатны)
Никаких API-вызовов, селекторов и кода. По состоянию на апрель 2026 года Thunderbit поддерживает 55 языков.
Для популярных сайтов Thunderbit также предлагает мгновенные шаблоны скрейпинга — готовые, поддерживаемые шаблоны для Amazon, Zillow, Shopify, LinkedIn, Google Maps, Instagram, eBay, Apollo и других. Тебе даже не нужно ждать, пока ИИ предложит поля; шаблон уже готов.
Плюс, в Thunderbit есть несколько бесплатных навсегда инструментов, которые не требуют плана: email extractor, phone number extractor и image extractor — удобно для sales и маркетинга, когда нужен быстрый сбор данных.
Матрица решений: кому что подойдет
| Если вы… | Лучший вариант |
|---|---|
| Разработчик, уверенно работающий с API и разбором HTML | ScrapingBee или ScraperAPI |
| Технический пользователь, которому нужны структурированные данные без ручной работы с селекторами | Thunderbit API (Extract endpoint) |
| Бизнес-пользователь (sales, marketing, ecommerce ops) без навыков кодинга | Thunderbit Chrome Extension |
| Команда, которой нужен плановый мониторинг без DevOps | Thunderbit Scheduled Scraper (планирование на естественном языке) |
| Строите LLM/RAG-пайплайны и нужен чистый markdown | Thunderbit Distill API или Firecrawl |
| Хотите предсказуемый бюджет и не любите множители кредитов | Thunderbit (1 кредит = 1 строка) |
Что происходит после скрейпинга: куда попадают данные?
Сбор данных — это только половина задачи. Вторая половина — довести эти данные до места, где ими реально можно пользоваться. И вот здесь большинство обзоров ScrapingBee замолкают.
ScrapingBee: на выходе сырой HTML, пайплайн строите сами
ScrapingBee по умолчанию возвращает сырой HTML. Дальше вам нужно:
- Разобрать HTML с помощью BeautifulSoup или lxml
- Убрать навигацию, футеры, скрипты и стили, которые составляют 80–90% типичного содержимого страницы
- Извлечь нужные поля данных
- Преобразовать их в структурированный формат
- Обработать пагинацию и ошибки
- Сохранить и разослать данные дальше
"ScrapingBee возвращает сырой HTML. AI-агентам нужен чистый markdown, семантический поиск и вебхуки." — KnowledgeSDK
У ScrapingBee есть и альтернативы по запросу — return_page_markdown=true и return_page_text=true, а Google Search API возвращает структурированный JSON. Но основной сценарий — и общий пользовательский опыт — это сырой HTML, который нужно обрабатывать самостоятельно.
Обычно пользователям требуются дополнительные инструменты: BeautifulSoup/lxml для парсинга, Pandas для очистки данных, cron/Airflow для расписаний, собственная логика краулинга для многостраничного сбора и отдельное облачное хранилище. Между "я это собрал" и "я могу этим пользоваться" возникает очень много инженерной работы.
Thunderbit: структурированный результат со встроенным экспортом
Thunderbit возвращает структурированные строки с заданными типами данных (text, number, date, URL, email, phone, image), готовые к экспорту. Все варианты экспорта бесплатны на всех тарифах:
| Куда экспортировать | Стоимость |
|---|---|
| Excel (.xlsx) | Бесплатно |
| Google Sheets | Бесплатно (прямая интеграция) |
| Airtable | Бесплатно (прямая интеграция) |
| Notion | Бесплатно (прямая интеграция) |
| CSV | Бесплатно |
| JSON | Бесплатно |
Для команд, которые уже используют Google Sheets или Airtable как CRM или операционный центр, это убирает целый слой инженерной работы. При экспорте в Notion или Airtable изображения загружаются в библиотеку изображений, чтобы их можно было видеть прямо в карточке — вроде бы мелочь, но на практике это очень важно.
Экосистема интеграций ScrapingBee
У ScrapingBee есть сторонние интеграции: Zapier (8,000+ приложений), Make (3,000+ приложений), n8n и Microsoft Power Automate. Они помогают связать сырой HTML с вашими целевыми инструментами — но добавляют стоимость, сложность и еще одну точку отказа.
Для разработчиков: открытый API Thunderbit
Для тех, кому все же нужны программные пайплайны, Thunderbit предлагает Open API с двумя ключевыми endpoint'ами:
- Distill endpoint — преобразует страницы в чистый Markdown, идеально для LLM/RAG-пайплайнов (1 кредит за вызов)
- Extract endpoint — возвращает структурированный JSON по схеме, заданной пользователем (20 кредитов за вызов)
- Пакетная обработка — до 100 URL за один запрос
Иными словами, Thunderbit закрывает потребности и no-code пользователей (Chrome Extension), и разработчиков (Open API) на одном AI-движке. Вопрос не только в том, "может ли оно скрейпить", а в том, "куда потом идут данные".
Проверка надежности в 2026 году: выдерживает ли ScrapingBee продакшн?
Старые ветки Reddit (2021–2023) содержат жалобы на надежность ScrapingBee. Остаются ли они актуальными в 2026 году? Я собрал данные из шести независимых бенчмарков. Результаты неоднозначны — и местами противоречивы.
Двухнедельный бенчмарк Scrapeway (апрель 2026)
Итог: 33.3% успешности — 7-е место из 9 протестированных сервисов.
| Сайт | Процент успеха |
|---|---|
| Amazon | 48% |
| 41% | |
| Indeed | 38% |
| Etsy | 21% |
| Booking | 17% |
| Realtor | 0% |
| StockX | 0% |
| Twitter/X | 0% |
| Zillow | 0% |
| Walmart | 0% |
| 0% |
Прямое сравнение Scrapingdog (2025)
| Сайт | ScrapingBee | Scrapingdog | ScraperAPI |
|---|---|---|---|
| Amazon | 100% | 100% | 100% |
| Glassdoor | 0% | 100% | 100% |
| eBay | 100% | 100% | 100% |
| Walmart | 40% | 100% | 100% |
| 90% | 100% | 80% |
Бенчмарк Proxyway (декабрь 2025)
- 84.47% success at 2 requests/second
- 72.98% success at 10 requests/second — падение на 12 пунктов под нагрузкой
- 25.46s average response time — самый медленный результат в группе
Бенчмарк Scrape.do (2025–2026)
- 92.69% overall success rate
- Сильные результаты на отдельных сайтах: Amazon 99.11%, Indeed 99.29%, GitHub 100%, X/Twitter 99.6%
- Слабое место — Capterra: только 59% успеха и ответы по 36 секунд
Что показывает эта картина
Данные складываются в понятный паттерн:
- ScrapingBee хорошо работает на массовых, умеренно защищенных сайтах — Amazon, eBay, GitHub и Indeed стабильно показывают 90–100% успеха
- ScrapingBee полностью проваливается на сильно защищенных сайтах — LinkedIn, Zillow, Realtor.com, StockX и Twitter регулярно дают 0% в разных бенчмарках
- Под нагрузкой качество резко падает — с 84% при 2 req/s до 73% при 10 req/s
- Результаты бенчмарков сильно зависят от методики — от 33.3% (Scrapeway, широкий микс сайтов) до 92.69% (Scrape.do, умеренные цели)
Рейтинг ScrapingBee на Capterra 4.9/5 (137 отзывов) — хороший знак, но высокие оценки за простоту первого запуска не всегда отражают долговременную надежность в продакшене на масштабе. Те, кто уходит с платформы, чаще всего называют рост числа сбоев и стоимости, а не сложность начальной настройки.
"Очень положительный опыт. ScrapingBee стабилен, предсказуем и легко интегрируется в production." — Verified Reviewer, CEO, Capterra
ScrapingBee демонстрировал "нестабильную надежность", в частности показывая "0% success rate on Glassdoor" и "40% on Walmart."
Как ИИ-скрейпинг иначе решает вопрос надежности
ИИ Thunderbit читает отрендеренную страницу в реальном времени, подстраиваясь под антибот-защиту и изменения верстки в каждом сеансе. Два режима скрейпинга закрывают разные сценарии надежности:
- Cloud scraping — работает на облачных серверах Thunderbit, обрабатывает до 50 страниц за раз, лучше всего подходит для крупных публичных задач на сайтах вроде Amazon, Zillow и Shopify
- Browser scraping — работает локально в Chrome пользователя, используя его авторизованную сессию — идеально для сайтов с логином (LinkedIn, приватные панели, SaaS-платформы), к которым API-инструменты вроде ScrapingBee не могут добраться за авторизацию
Thunderbit также предлагает мгновенные шаблоны скрейпинга для популярных сайтов — готовые и поддерживаемые, чтобы они продолжали работать даже при изменении структуры сайта. Для тех сайтов, где ScrapingBee показывает 0% успеха (LinkedIn, Zillow), режим browser scraping в Thunderbit — с использованием твоей собственной авторизованной сессии — это принципиально другой подход.
ScrapingBee против топовых альтернатив: сравнение в лоб
| Параметр | ScrapingBee | Thunderbit | ScraperAPI | Scrapfly |
|---|---|---|---|---|
| Тип | Только API | Chrome Extension + API | Только API | Только API |
| Стартовая цена | $49/мес | Бесплатно ($0) | $49/мес | $30/мес |
| Модель кредитов | Множители (1×–75×) | 1 кредит = 1 строка (без множителей) | Множители (1×–75×) | Множители (1×–30×) |
| ИИ-извлечение | Да (+5 кредитов/запрос) | Встроено (AI Suggest Fields) | Нативного ИИ нет | Да |
| No-code вариант | Нет (только API) | Да (Chrome Extension) | Нет (только API) | Нет (только API) |
| Структурированный вывод | Требует CSS-правил или AI-дополнения | По умолчанию (типизированные столбцы) | Структурированные endpoint'ы для отдельных сайтов | Зависит от сценария |
| Куда экспортировать | Сырой HTML/JSON (строите сами) | Excel, Sheets, Airtable, Notion, CSV, JSON (все бесплатно) | Сырой HTML/JSON | Сырой HTML/JSON |
| Парсинг подстраниц | Вручную (пишете crawl-логику) | Встроено (2 кредита/строка) | Вручную | Вручную |
| Плановый скрейпинг | Только CLI (без scheduler в панели) | Встроено (на естественном языке) | Нет встроенного | Нет встроенного |
| Бесплатный тариф | 1,000 кредитов trial | 6 страниц/месяц (навсегда) | 5,000 кредитов (7-дневный trial) | 1,000 кредитов |
| JS-рендеринг по умолчанию | ВКЛ (5× стоимость) | Включен (без доплаты) | ВЫКЛ | ВЫКЛ |
| Кривая обучения | Высокая (API + селекторы) | Низкая (2 клика) | Высокая (API + селекторы) | Высокая (API) |
| Лучше всего подходит | Разработчикам, которым нужен контроль прокси | Бизнес-пользователям и разработчикам | Разработчикам и структурированным endpoint'ам | Разработчикам, которым нужен обход ASP |
| Рейтинг Capterra | 4.9/5 (137 отзывов) | — | 4.6/5 (62 отзыва) | 4.9/5 (221 отзыв) |
ScrapingBee против Thunderbit: ключевые различия
Главные различия сводятся к архитектуре и аудитории:
- Только API против Chrome Extension + API: ScrapingBee требует код для каждого действия. Thunderbit предлагает Chrome Extension для no-code пользователей и Open API для разработчиков — один и тот же AI-движок, два интерфейса.
- Извлечение по селекторам против AI-подхода: ScrapingBee требует писать и поддерживать CSS/XPath-селекторы. ИИ Thunderbit автоматически предлагает поля и адаптируется к изменениям сайтов.
- Сырой HTML против структурированных строк с бесплатным экспортом: ScrapingBee возвращает HTML, который нужно парсить. Thunderbit возвращает типизированные, размеченные строки, которые можно экспортировать в Excel, Google Sheets, Airtable или Notion в один клик.
- Парсинг подстраниц: Thunderbit с помощью ИИ посещает каждую детальную страницу и обогащает основную таблицу — это встроено, без собственной crawl-логики. ScrapingBee требует написать эту логику самому.
- Мгновенные шаблоны: У Thunderbit есть готовые шаблоны для популярных сайтов (Amazon, Zillow, Shopify, LinkedIn, Google Maps, eBay), которые работают из коробки. У ScrapingBee есть отдельные API для Amazon и Walmart, но тебе все равно нужно писать код для их использования.
Другие заметные альтернативы
- Scrape.do — самая низкая независимая стоимость: $0.80/1K запросов при 98.19% успеха; старт от $29/мес
- Apify — платформа на базе actors, 415+ отзывов на G2 (4.7/5), но "Pricing Issues" — жалоба №1
- Firecrawl — AI/LLM-native, возвращает markdown и на 67% экономит токены по сравнению с сырым HTML; open-source core; старт от $16/мес
- Bright Data — enterprise-уровень с 72M+ IP, старт от $499/мес; фиксированное ценообразование
- ZenRows — 55M residential IP, готовые скрейперы для Amazon/Walmart/Zillow, старт от $69/мес
Какой инструмент для скрейпинга подходит вашей команде?
Рекомендации по сценариям:
- Если ты разработчик и строишь собственный scraping pipeline, а также хочешь тонкий контроль над прокси → ScrapingBee или ScraperAPI. Ты получишь точные HTTP-параметры, выбор типа прокси и полный контроль над рендерингом. Просто заложи в бюджет множители кредитов.
- Если ты sales- или marketing-команда и тебе нужны лиды с сайтов без написания кода → Thunderbit Chrome Extension. Два клика до структурированных данных, один клик до Google Sheets. Без API, селекторов и парсинга.
- Если тебе быстро нужны структурированные данные с популярных сайтов → Thunderbit Instant Templates. Amazon, Zillow, Shopify, LinkedIn — уже готовы и поддерживаются, без настройки ИИ.
- Если тебе нужен мониторинг цен или запасов по расписанию без DevOps → Thunderbit Scheduled Scraper. Опиши интервал простым языком ("каждый понедельник в 9:00") и запусти.
- Если ты строишь LLM/RAG-пайплайны и нужен чистый Markdown на масштабе → Thunderbit Distill API или Firecrawl. Оба возвращают markdown, оптимизированный для AI-потребления.
- Если важна предсказуемость бюджета и ты не хочешь множителей кредитов → Thunderbit. 1 кредит = 1 строка, независимо от JS-рендеринга или типа прокси.
Общая стоимость владения — это не только цена API. Это еще и время на настройку + часы поддержки + инженерия парсинга + процесс экспорта данных. У ScrapingBee привлекательная цена на витрине; полная стоимость владения — уже нет.
Ключевые выводы из этого обзора ScrapingBee
Пять выводов, которые стоит запомнить:
- Кредитные расходы быстро множатся на масштабе. Стартовая цена $49 может превратиться в $599+ , если нужен JS-рендеринг и premium-прокси. Модель Thunderbit с фиксированным принципом 1 кредит = 1 строка убирает эту непредсказуемость.
- CSS-селекторы несут постоянные расходы на поддержку, которых ИИ-извлечение избегает. Ожидай 60–80% меньших затрат на поддержку с AI-инструментами и нулевых поломок селекторов при обновлении сайта.
- Не-разработчикам ScrapingBee дается тяжело. Это API-only инструмент, который требует кодинга, проверки HTML и построения селекторов. Бизнес-пользователям лучше смотреть на no-code альтернативы.
- Экспорт данных требует собственной инженерии. ScrapingBee возвращает сырой HTML; пайплайн ты строишь сам. Thunderbit бесплатно экспортирует структурированные данные в Excel, Sheets, Airtable и Notion.
- Надежность хороша для одних сайтов, но нестабильна для других. ScrapingBee хорошо работает на Amazon и eBay, но показывает 0% на LinkedIn, Zillow и ряде других сильно защищенных целей.
ScrapingBee остается рабочим инструментом для разработчиков, которым нужен HTTP-доступ через управляемые прокси с тонким контролем. Но рынок веб-скрейпинга в 2026 году сместился в сторону AI-инструментов без кода — и Thunderbit создан именно под этот сдвиг. Попробуй бесплатный тариф (6 страниц бесплатно, а с trial — больше), чтобы увидеть разницу на практике.
Попробовать Thunderbit бесплатно
FAQ
Стоит ли использовать ScrapingBee в 2026 году?
Это зависит от твоих технических навыков и масштаба задач. Для разработчиков, которые собирают статичные страницы в умеренном объеме, ScrapingBee предлагает надежный и хорошо документированный API с отзывчивой поддержкой и рейтингом 4.9/5 на Capterra. Для бизнес-пользователей, больших объемов скрейпинга или команд, которым нужны структурированные данные без программирования, AI-альтернативы вроде Thunderbit дают лучшее соотношение цены и качества и заметно более низкую общую стоимость владения.
Можно ли пользоваться ScrapingBee без кода?
Нет. ScrapingBee — это API-only инструмент, для которого нужно писать код (Python, cURL или аналогичный) и понимать HTTP-параметры. Визуального интерфейса для настройки скрейпов здесь нет. Нетехническим пользователям стоит рассмотреть no-code варианты, например Thunderbit Chrome Extension, который позволяет собирать и экспортировать данные без написания ни одной строки кода.
Сколько ScrapingBee реально стоит за страницу?
Это зависит от включенных функций. Статичная HTML-страница стоит 1 кредит. Страница с JS-рендерингом (по умолчанию) стоит 5 кредитов. Страница с premium-прокси и JS — 25 кредитов. Страница со stealth-прокси — 75 кредитов. AI extraction добавляет +5 кредитов сверху. В плане Freelance ($49/250K кредитов) это соответствует $0.20 за 1,000 статичных страниц или $14.70 за 1,000 страниц через stealth-прокси. Полный разбор есть в таблицах выше.
Какие лучшие альтернативы ScrapingBee в 2026 году?
Среди лучших альтернатив — Thunderbit (на базе ИИ, no-code Chrome Extension + API, 1 кредит = 1 строка), ScraperAPI (API для разработчиков со структурированными endpoint'ами для отдельных сайтов), Scrapfly (developer API с сильным обходом антибот-защиты), Scrape.do (самая низкая цена за запрос в независимых тестах) и Firecrawl (AI/LLM-native, возвращает чистый markdown). У каждого инструмента своя сильная сторона — Thunderbit для бизнес-пользователей и предсказуемого бюджета, ScraperAPI и Scrapfly для контроля прокси на уровне разработчика, Firecrawl для LLM-пайплайнов.
Может ли ScrapingBee скрейпить сайты с тяжелым JavaScript?
Да, но это стоит в 5× дороже базовых кредитов с rotating proxy или в 25× дороже с premium proxy. Рендеринг JavaScript включен по умолчанию, так что ты уже платишь по ставке 5×, если явно не отключишь его. Thunderbit обрабатывает JS-рендеринг автоматически и без множителей кредитов — 1 кредит за строку, независимо от того, как устроена страница.
Узнать больше



