
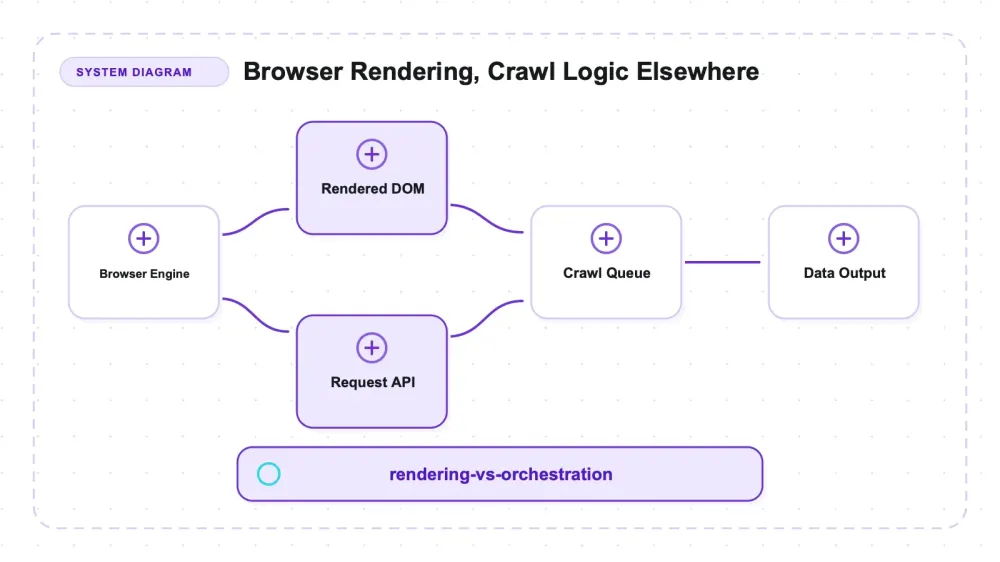
Playwright — это фреймворк Microsoft для автоматизации браузера: библиотека на TypeScript с лицензией Apache-2.0, которая запускает настоящий браузер, управляет им через единый API и возвращает страницу уже после выполнения JavaScript. Его продвигают как end-to-end фреймворк для тестирования, но именно движок под капотом часто тихо выбирают тогда, когда HTTP-запрос возвращает пустую оболочку там, где должны быть данные. По своей сути он конкурирует с Puppeteer и Selenium — это не HTTP-клиенты для парсинга, а настоящие браузеры, которыми вы управляете через код.
Я прогнал microsoft/playwright версии 1.56.0 через фиксированный набор тестов на извлечение данных — статический каталог с пагинацией, статью, каталог, отрисованный JavaScript, JSON API, сломанный ответ 500, небольшой граф обхода и два публичных тренировочных сайта — на Node v22.22.3, macOS arm64, только Chromium. Часть, связанная с рендерингом, отработала без проблем. А вот часть, отвечающая за обход сайта, в инструменте просто отсутствует, и именно это важно понять до того, как вы решите на него ставить.
Что особенно бросилось в глаза
На вершине списка оказались два результата, и каждый показывает инструмент с немного другой стороны.
Первый — ожидаемый результат браузера, ограниченный теми ожиданиями, которые я задал. После page.goto(..., { waitUntil: 'domcontentloaded' }) динамический тест ждал появления #dynamic-products article.product-card, а публичный тест Quotes to Scrape — селектор .quote. Как только эти специфичные для приложения селекторы появились, прогон вернул 8 из 8 элементов в фикстуре и 10 цитат с публичного сайта; для фикстуры полнота составила 1.0 по эталону из восьми объектов. Отдельный цикл опроса был не нужен, но Playwright не убрал проблему готовности страницы — условие завершения пришлось задавать в самом тесте. Полноэкранный скриншот тоже сохранился с первого раза.
Второй результат использовал browserContext.request: а именно ctx.request.get(...) после того, как Chromium уже был запущен и браузерный контекст существовал. Он напрямую вызвал JSON-эндпоинт фикстуры и вернул 8 из 8 товаров без создания и рендеринга страницы. Это позволяет убрать работу с DOM, но не убирает стоимость самого браузерного процесса в этом сценарии. Привязанный к контексту клиент запросов может делить cookie-состояние со страницами браузера; отдельный playwright.request.newContext() не требует браузерного контекста, но автоматически не разделяет с ним сессию. В этом тесте проверялся только первый путь.
У Playwright также нет очереди обхода, записи датасета или автоматического троттлинга. Мой тест на граф обхода — пройти по внутренним ссылкам, отслеживать глубину и не посещать страницы повторно — дошёл до 12 страниц на глубинах {0:1, 1:4, 2:7}, но сам обход в ширину был написан мной в тестовом коде. Playwright открывает страницы и читает их; хранение фронтира, политика URL, повторы и планирование — это уже уровень выше.
Что такое Playwright на самом деле
Этот инструмент — microsoft/playwright на GitHub — написан на TypeScript, распространяется под лицензией Apache-2.0 и поддерживается Microsoft. Проверенная здесь сборка — 1.56.0 от 9 июля 2026 года. Результаты относятся именно к этой версии и не являются обещанием совместимости с более поздними релизами.
Официальное позиционирование предельно точное: это фреймворк для веб-тестирования и автоматизации, который управляет Chromium, Firefox и WebKit через единый API. Основной сценарий Playwright — тест-раннер с фикстурами, ассерциями и trace viewer. Если использовать его как базовый инструмент для скрапинга, нужно идти по документированному Library mode: chromium.launch(), затем context, затем page, вне тестовой обвязки. Во всех примерах этого обзора использовался именно этот публичный API. Я не проводил кросс-версионную проверку совместимости, так что это не утверждение о том, что все протестированные сценарии стабильны во всех релизах.
Документированная широта возможностей — главный аргумент инструмента везде, где его обсуждают, поэтому скажу аккуратно. Playwright управляет тремя движками — Chromium, Firefox и WebKit — через один API и дополнительно предлагает нативные клиенты на Python, Java и .NET поверх JavaScript. Это описано в документации и действительно является его самым сильным отличием по охвату. Но в этом прогоне проверялась лишь более узкая часть:
| Возможность | Статус в этом обзоре |
|---|---|
| Движок Chromium | Проверено — все тесты здесь запускались в Chromium |
| Движок Firefox | Описано в документации, здесь не проверялось |
| Движок WebKit | Описано в документации, здесь не проверялось |
| Единый API для трёх движков | Описано в документации, здесь не проверялось |
| Клиенты Python, Java и .NET | Описано в документации, здесь не проверялось |
| Прокси | Не тестировалось |
| Масштабирование на множество контекстов | Не тестировалось |
| Перехват сети для API-first скрапинга | Не тестировалось |
Если целевой сайт иначе отображается в WebKit Safari или ваша команда пишет на Python, эта широта — сильный аргумент Playwright. Просто не воспринимайте мои результаты как доказательство паритета Firefox или WebKit, потому что я их не тестировал.
Как это устроено под капотом
Ментальная модель здесь — это движок браузера, которым вы управляете через код. chromium.launch() запускает процесс браузера. context — это изолированная сессия со своими cookies, хранилищем и кэшем; page — это вкладка внутри этого контекста. Вы вызываете page.goto(url), ждёте условие, которое означает готовность приложения, и читаете итоговый DOM с помощью помощников вроде page.$$eval. Это ближе к обычному браузеру пользователя, чем к разбору HTTP-ответа, но это не полная идентичность среды: headless-режим, viewport, локаль, шрифты, состояние профиля, TLS-сеть и защитные механизмы сайта всё ещё могут менять то, что вы получаете. В этом обзоре не проверялись антибот-защита и паритет с полноценным браузером в продакшене.
page.screenshot() сохраняет отрендеренную страницу — целиком или с обрезкой — и в моём прогоне сработал с первого вызова. А упомянутый API запросов — context.request.get — использует cookies того же контекста, но пропускает рендеринг, так что в одном скрипте можно сочетать «загрузить страницу и прочитать DOM» и «просто дернуть JSON-эндпоинт» без перехода на другой инструмент.
Чего под капотом нет — так это механизмов обхода. Здесь нет планировщика запросов, сохранённого множества посещённых URL, политики вежливости или конвейера экспорта. Ограниченный обход набросать легко, но надёжный фронтир требует также нормализации URL, обработки редиректов, повторных попыток, ограничений по области, троттлинга и восстановления после ошибок. Этот слой вы строите сами или берёте фреймворк, который оборачивает браузерный движок.
Реальность установки и запуска
Установка состоит из двух шагов, и второй из них несёт основную нагрузку при развёртывании. npm install playwright устанавливает саму библиотеку; отдельная команда npx playwright install загружает сборки браузеров (в моём случае Chromium). Закладывайте место на диске, время загрузки, кэширование браузеров в CI и очистку процессов, а не воспринимайте npm-пакет как полностью готовую исполняемую систему.
Если установить Playwright в ожидании именно скрапера и пойти по учебнику по тестированию, вы начнёте с тестовых файлов и ассерций expect(). Код для скрапинга, напротив, использует API библиотеки напрямую. Оба подхода документированы, но это различие важно, когда вы ищете примеры и выбираете команды для развёртывания.
В этом запуске полезная ergonomics была вполне конкретной: браузерные контексты изолировали состояние сессии, асинхронные вызовы хорошо компоновались, скриншот делался одним вызовом, а HTTP 500 можно было спокойно изучить через объект ответа. Сложность была не синтаксической, а операционной: сборку браузера нужно было установить и управлять её жизненным циклом отдельно от библиотеки.
Практические результаты
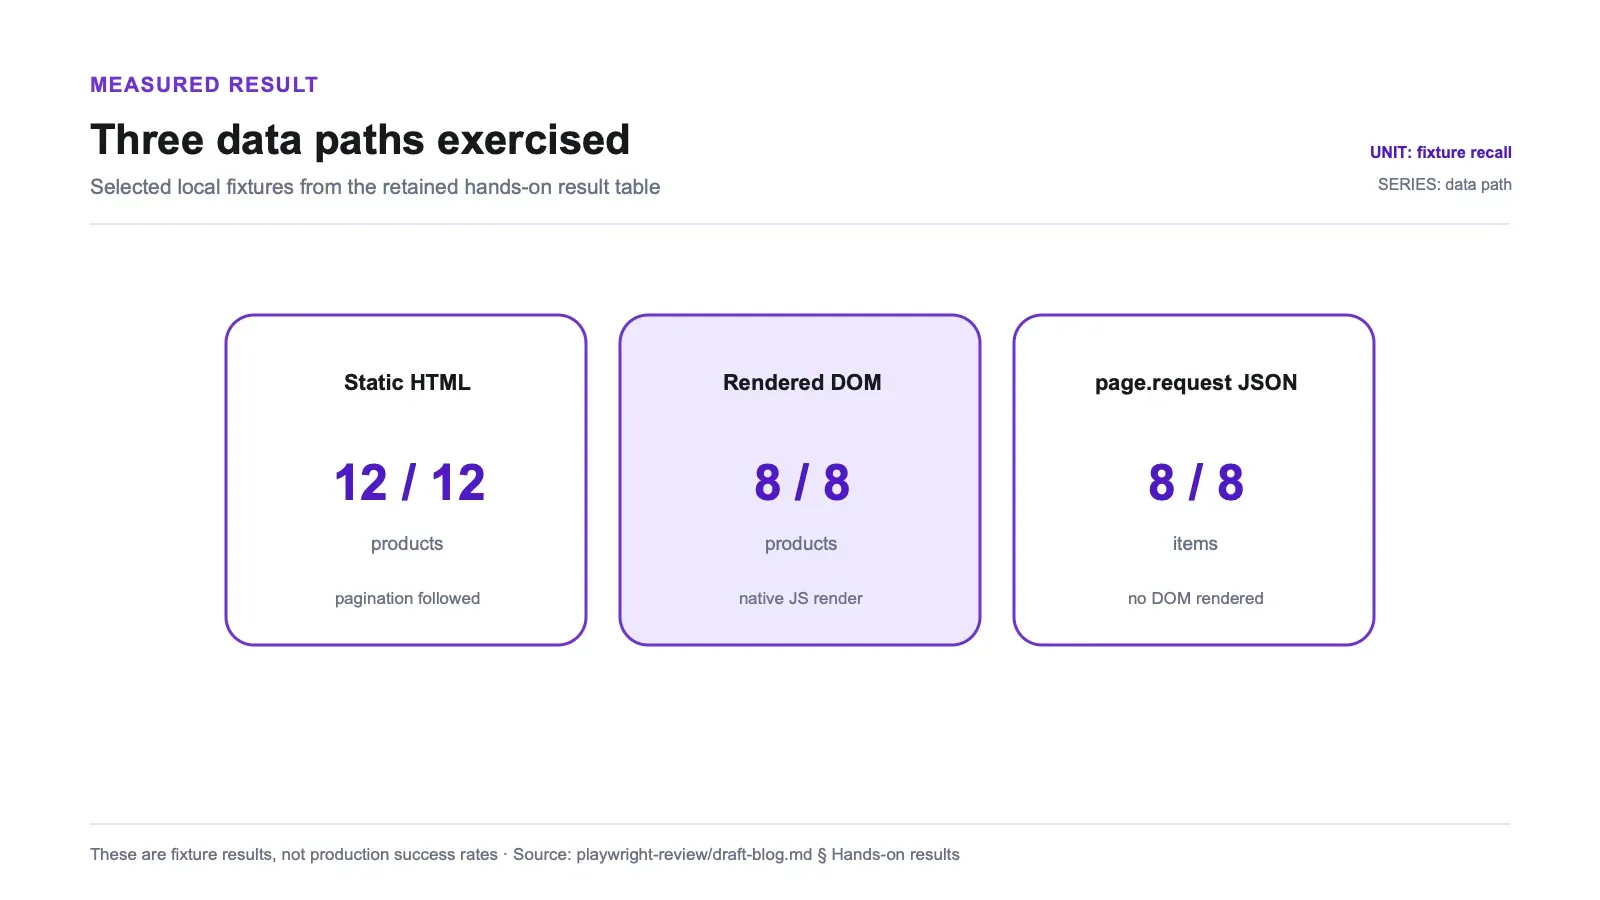
Все локальные числа были получены на сервере-фикстуре на 127.0.0.1, где эталон был записан заранее до обхода. Точный набор тестов находится в run_playwright_material_tests.mjs, а зафиксированные сырьевые артефакты включают эталон и результаты по каждому тесту. Это по-прежнему наблюдения автора с одной машины и одного прогона; ссылки показывают, как воспроизвести результат, но не превращают его в широкий бенчмарк.
| Тест | Цель | Результат |
|---|---|---|
| Статический каталог + пагинация | локальная фикстура | 12/12 товаров, полнота 1.0 |
| Извлечение статьи | локальная фикстура | заголовок + 3/3 абзаца, служебный текст выделен отдельно |
| Динамическая JS-страница (нативный рендер) | локальная фикстура | 8/8, полнота 1.0, сохранён полный скриншот |
Динамический JSON API (page.request) | локальная фикстура | 8/8, полнота 1.0, DOM не рендерился |
| Обработка HTTP 500 | локальная фикстура | статус 500 можно было изучить, навигация не падала с исключением |
| Граф обхода (ручной BFS) | локальная фикстура | 12 страниц, глубины {0:1, 1:4, 2:7} |
| Books to Scrape | публичный демо-сайт | 20 товаров |
| Quotes JS (рендер через JS) | публичный демо-сайт | 10 цитат, отрендерено нативно |
Цикл пагинации явно переходил по ссылке next; Playwright сам страницы не находил. Селектор для статьи отделял навигацию и текст футера от результата по основному тексту. На ветке с ошибкой навигация вернула объект ответа со статусом 500 вместо того, чтобы выбросить исключение, оставив вызывающему коду выбор — логировать, повторять или продолжать. Два публичных тренировочных сайта вернули те числа, что указаны в таблице.
Есть один важный предел, который стоит проговорить прямо: всё здесь запускалось в Chromium, на одной машине, один раз. В таблице возможностей документированная широта отделена от реально проверенного поведения. Я не прогонял набор на другой сборке Playwright, поэтому выводов о кросс-версионной стабильности делать нельзя. Времена по каждому тесту также не приводятся как бенчмарк: один замер на одном ноутбуке не годится для сравнения скорости.
Готовность — часть договора на извлечение данных
Результаты на динамических страницах зависели от ожиданий, которые отражали нужные мне данные, а не просто факт перехода в браузер. Для локального каталога хранилище переходило с waitUntil: 'domcontentloaded', а затем вызывало waitForSelector('#dynamic-products article.product-card') с таймаутом 15 секунд. В публичном прогоне Quotes JS использовалась та же стадия навигации и ожидание .quote с таймаутом 20 секунд. Извлечение происходило только после появления этих селекторов.
Это различие важно, когда вы адаптируете скрипт. domcontentloaded означает лишь, что исходный документ разобран; это не говорит, что пришёл задержанный API-ответ, завершилась гидратация, перестал расти бесконечный список или виртуализированная строка попала в область видимости. Селектор полезен, когда достаточно наличия одного подходящего элемента. Если же полнота зависит от известного ответа, количества элементов, состояния приложения или тишины в сети, нужно ждать именно это условие. Условие должно быть связано с контрактом на результат: «есть хотя бы одна карточка» и «загружены все ожидаемые страницы» — это разные утверждения.
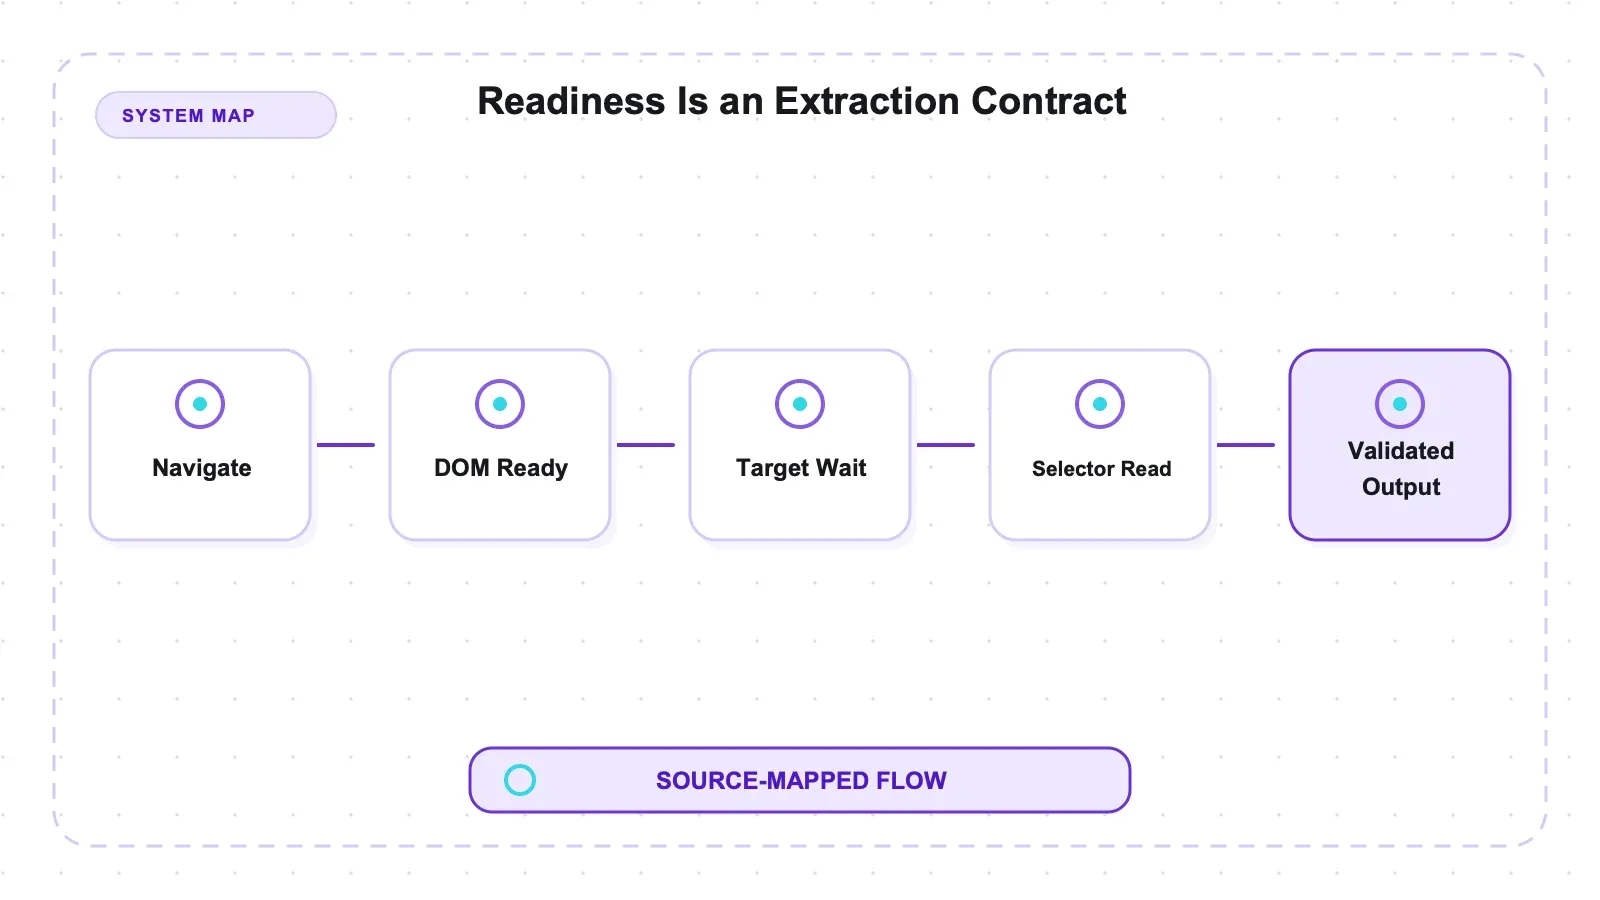
Обработка таймаутов тоже лежит на вызывающей стороне. В тесте использовались конечные таймауты для селекторов, но не изучалась политика повторов и не различалась медленная страница и навсегда изменившийся селектор. Продакшн-обёртка должна записывать, какое именно условие готовности не выполнилось, сохранять достаточно состояния страницы для диагностики и решать, безопасна ли ещё одна попытка навигации. Playwright даёт события и DOM, но не умеет сам понимать, что для вашей задачи значит «данные готовы».
Этот предел должен быть задокументирован рядом с каждым экстрактором, а не оставаться неявным таймаутом.
У API-пути есть свой аналогичный контракт. ctx.request.get был уместен, потому что браузерный контекст уже существовал и полезно было разделять сессии. Если задача обнаружит, что нужный endpoint работает вообще без браузерной сессии, отдельный request context — это уже другая архитектура с другим жизненным циклом и поведением cookies. В этом прогоне эти два варианта не сравнивались. Считайте фактом только то, что DOM не рендерился, а затем отдельно решайте, нужен ли браузерный процесс для более широкой рабочей схемы.
Вопрос обхода сайта
Результат с графом обхода — тот самый случай, который определяет, как вообще следует думать о Playwright. Двенадцать страниц, три уровня глубины, корректно — и всё управление обходом было моим. Playwright дал только половину задачи: «открой этот URL и прочитай его»; очередь, множество посещённых страниц и отслеживание глубины написал я.
Для небольших, ограниченных задач это не проблема. Но на уровне полноценного обхода это значит, что вы либо строите crawler поверх браузерной библиотеки, либо сочетаете Playwright с чем-то, что уже делает эту работу. Документированный вариант — Crawlee, который оборачивает Playwright (и Puppeteer) реальной очередью запросов, хранилищем датасета и автоматическим троттлингом — вы оставляете себе рендеринг Playwright и берёте оркестрацию. Если вам нужна очередь, встроенная прямо в сам фреймворк, а не добавленная сверху, то в этом и состоит вся идея Scrapy, хотя Scrapy ориентирован на HTTP и сам по себе не рендерит JavaScript. Смысл не в том, что Playwright «недотягивает», а в том, что «автоматизация браузера» и «обход сайта» — это две разные задачи, и Playwright заявляет только одну из них.
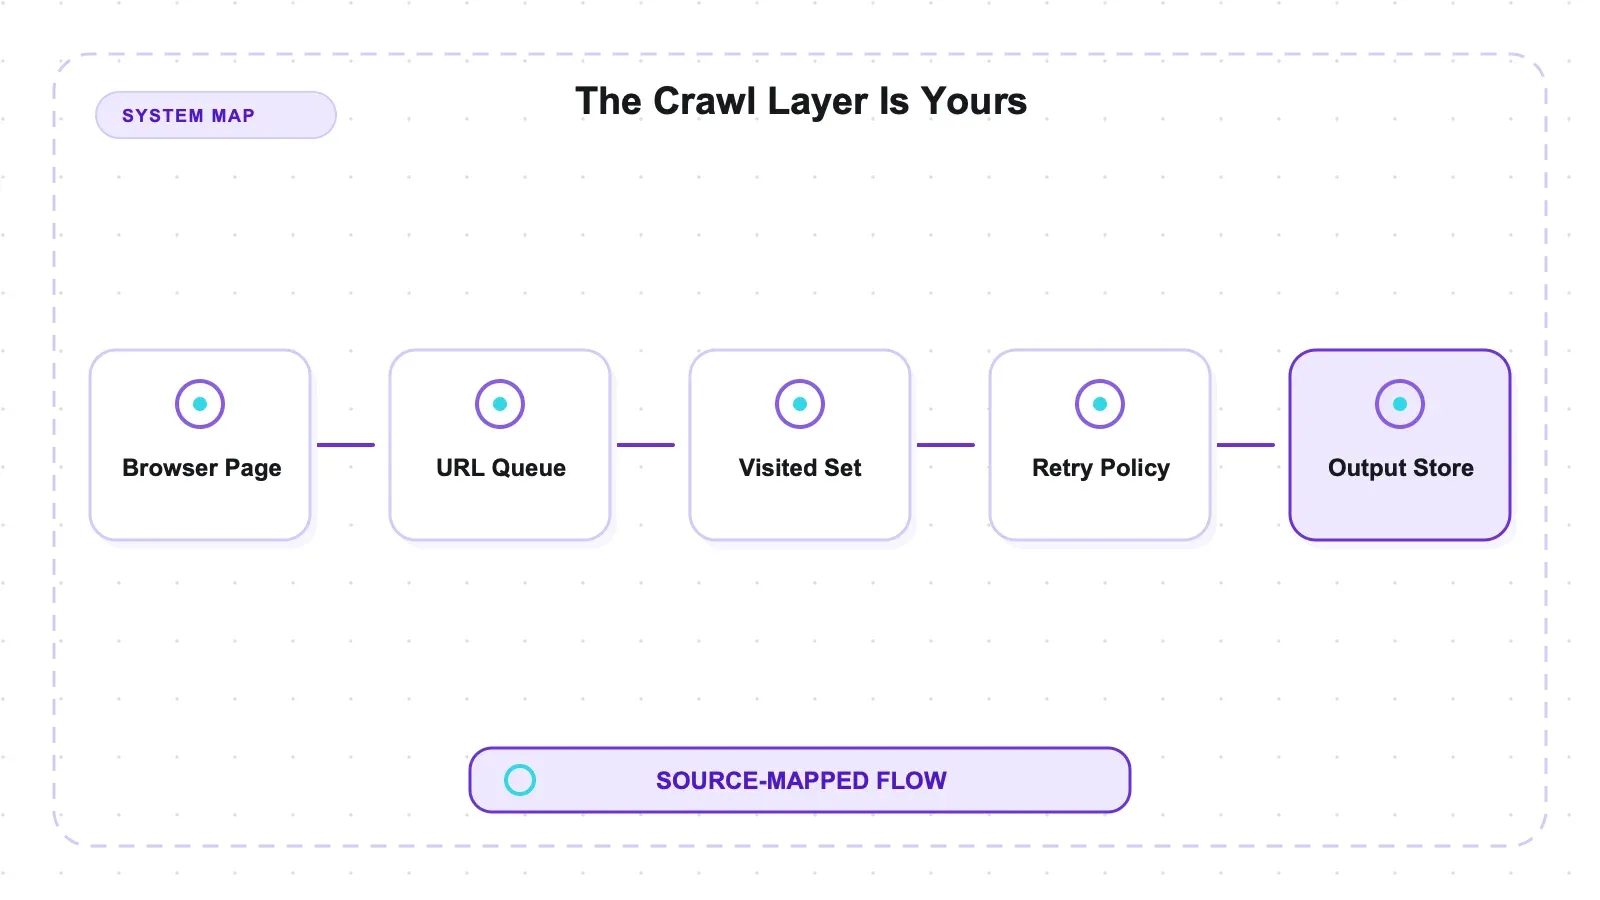
BFS на 12 страниц делает границу ответственности очень наглядной. Он обеспечил очередь, множество посещённых страниц и отслеживание глубины для контролируемого графа. В production-фронтире всё равно нужно определить каноникализацию URL, обработку редиректов, разрешённые хосты, дубликаты ключей, повторы, конкуррентность, задержку на хост, сохранение состояния и семантику перезапуска. Экспорт — это ещё один выбор: фикстура писала JSON и CSV потому, что так делал harness, а не потому что Playwright предоставляет абстракцию датасета.
Схема сессий тоже влияет на обёртку. Один браузер может содержать несколько контекстов с изолированными cookies и хранилищем, но этот обзор не измерял масштабирование на множество контекстов и изоляцию отказов. Повторное использование контекста может сохранить логин и сократить время на подготовку; отдельные контексты могут предотвратить утечку состояния между задачами. Это уже политика уровня crawler, хотя Playwright и даёт примитив контекста. Проверять жизненный цикл нужно на той сборке браузера и в той среде развёртывания, где вы действительно будете работать.
Плюсы и минусы
Плюсы:
- Выполнение JavaScript через настоящий движок Chromium; оба динамических сценария дошли до селекторов, использованных как условия готовности.
- Полноэкранный скриншот сохранился с первого вызова.
- Селекторы корректно извлекли ожидаемые поля из статического каталога и статьи в контролируемых фикстурах.
browserContext.requestдостучался до JSON-эндпоинта без рендеринга страницы, при этом уже запущенный браузерный процесс оставался частью сценария.- Устойчивость при плохом ответе: HTTP 500 можно было изучить, и навигация не падала с исключением.
- Документированная поддержка трёх движков (Chromium, Firefox, WebKit) через единый API, а также клиенты Python, Java и .NET (это описано в документации; здесь проверялся только Chromium).
- Лицензия Apache-2.0 и поддержка Microsoft.
- Удобный опыт разработки в library mode: единый API для всех движков, нормальная асинхронная модель, скриншоты в один вызов.
Минусы:
- Нет встроенной очереди обхода, датасета или автотроттлинга — на уровне crawler это либо ваш код, либо обёртка вроде Crawlee.
- Тяжёлый браузер: загрузка бинарников и стоимость каждого рендера — это реальная цена по сравнению с HTTP-only инструментом.
- По умолчанию инструмент подан как тест-раннер; чтобы скрапить, нужно знать про library mode и сознательно уйти с маркетингового пути.
- В этом обзоре проверялись только Playwright 1.56.0 и Chromium; кросс-версионный и кросс-движковый паритет не тестировались.
- Нет собственного структурированного JSON-вывода по схеме; селекторы и форму данных вы задаёте сами.
Кому подойдёт, а кому лучше пройти мимо
Если ваша задача — отрисовка страниц, где данные появляются только после выполнения JavaScript, или если вам нужны скриншоты вместе с DOM-данными, Playwright вполне разумно протестировать на ваших целевых страницах. Команды, которые уже используют тесты Playwright, могут переиспользовать те же принципы и навыки работы с селекторами в library mode. Клиенты для Python, Java и .NET — документированные варианты, но в этом обзоре проверялись только Node и Chromium.
В трёх случаях стоит подумать о другом слое. Если нужные данные уже есть в HTTP-ответе, HTTP-first инструмент избавляет от запуска браузера и затрат на рендеринг; Colly — это crawler-библиотека в этой категории, а Trafilatura ориентирована на извлечение статей. Если нужны очередь, сохранение состояния и троттлинг, используйте crawler-фреймворк или обёртку над Playwright. Если нужен вывод в форме схемы без ручного поддержания селекторов, сравните управляемые сервисы извлечения данных. В этом обзоре ни одна из этих альтернатив не бенчмарковалась.
Если вы специально выбираете между Playwright и Puppeteer, это уже отдельное сравнение; наше сопоставление бок о бок прогоняет оба инструмента через одни и те же фикстуры и показывает, где реально проходит граница выбора.
Альтернативы и место управляемого извлечения
Playwright бесплатен, распространяется под Apache-2.0 и предполагает самостоятельное развёртывание. Вы сами отвечаете за установку браузера, селекторы, условия готовности, код обхода, обновления и обработку ошибок. В этом обзоре не измерялась устойчивость к антибот-защите и не сравнивалась общая стоимость владения с управляемым сервисом.
В open source полезнее всего сравнивать инструменты по задаче. Для обхода сайтов на уровне browser crawling Crawlee добавляет то, чего не хватает Playwright: очередь и датасет. Если вашей целью является Markdown, пригодный для LLM, а не вручную сформированные строки, Crawl4AI запускает браузер и выдаёт Markdown для такого пайплайна. А если вы одновременно выбираете между несколькими такими вариантами, наш обзор open-source скраперов раскладывает категории рядом друг с другом.
Раскрытие информации: Thunderbit — продукт издателя, и в эту фикстуру Playwright он не запускался. Он относится к категории управляемого извлечения: сервис сам выполняет рендеринг и возвращает текст страницы или записи по схеме, тогда как Playwright оставляет браузер и логику селекторов разработчику. Поэтому сравнение здесь касается модели хостинга, формата результата и модели затрат — а не измеренного в этом обзоре быстродействия.
Попробовать Thunderbit для извлечения веб-данных
Итог
Используйте Playwright, когда вашей цели нужен именно браузерный движок и вы готовы сами отвечать за условия готовности, селекторы и оркестрацию обхода. Таблица результатов показывает, что его Chromium library mode в этом авторском прогоне уверенно справился со статическими, динамическими, API-ориентированными, скриншотными и аварийными фикстурами.
Важно не выходить за границы доказательств: проверялся только Chromium и Node, обход на 12 страниц зависел от ручного BFS, browserContext.request пропускал рендеринг страницы, но не уже запущенный браузерный процесс, а каждое динамическое извлечение использовало явно заданный селектор готовности. При таких условиях в этом обзоре Playwright — это браузерный примитив, а не измеренная end-to-end система обхода сайтов.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Частые вопросы
Нужны ли ожидания при скрапинге с Playwright?
Да. Само выполнение браузера не сообщает скрипту, когда данные приложения уже готовы. В этих тестах переход шёл до domcontentloaded, а затем перед извлечением ожидался селектор, специфичный для цели. На продакшн-страницах может понадобиться другой сигнал — например, ответ сети, состояние локатора или событие приложения.
Может ли Playwright сам обойти весь сайт? Не из коробки. Встроенных очередей запросов, записи датасета и автоматического троттлинга нет — мой тест на граф обхода дошёл до 12 страниц на глубинах {0:1, 1:4, 2:7} только потому, что обход в ширину я написал вручную. Для задач на уровне crawler лучше сочетать Playwright с Crawlee, который оборачивает его полноценным слоем обхода, либо использовать отдельный crawler-фреймворк.
Когда использовать browserContext.request, а когда отдельный request context?
Используйте browserContext.request, если HTTP-запросы должны разделять cookies со страницами уже существующего браузерного контекста. Используйте playwright.request.newContext(), если нужен только API-контекст без запуска браузера и без автоматического разделения cookies с браузерными страницами. В этом обзоре проверялся только первый путь.
Проверялись ли здесь Firefox и WebKit? Нет. Все тесты запускались в Chromium, на одной машине, в одном прогоне. Поддержка трёх движков в Playwright (Chromium, Firefox, WebKit) и клиенты Python, Java и .NET — это задокументированные возможности, которые я здесь привожу как заявленные, но не верифицированные. Паритет Firefox и WebKit, прокси, масштабирование, перехват сети — всё это за пределами того, что покрывают эти числа.
Какая среда использовалась в обзоре? Playwright 1.56.0, Node v22.22.3, macOS arm64 и только Chromium. Firefox, WebKit, прокси, масштабирование, антибот-защита и более поздние версии Playwright в прогон не входили. Для установки потребовалась сама библиотека и отдельная загрузка сборки браузера.




