
Почти все подборки «лучших open-source скраперов» грешат одной тихой проблемой: никто не гоняет инструменты по одним и тем же страницам. Scrapy тестируют на новостной статье, Playwright — на каком-нибудь демо интернет-магазина, Colly — на том, что автор нашёл под рукой, а потом их ставят в один ряд, будто эти цифры вообще можно сравнивать напрямую. На самом деле такой рейтинг говорит о страницах, а не об инструментах.
Поэтому я сделал скучную, но очевидную вещь, которую обычно пропускают списки: собрал один набор тестовых страниц и прогнал через него все девять инструментов — статический каталог, каталог, отрисовываемый JavaScript, статью, спрятанную за меню и футером, намеренно сломанный HTTP 500, небольшой граф внутренних ссылок, плюс два публичных тренировочных сайта. Одинаковая эталонная разметка, одинаковые метрики, каждый запуск. Скрипты и сырые результаты лежат в открытом репозитории бенчмарка, так что вы можете повторить любой тест сами. Итог оказался совсем не таким аккуратным лидербордом, который обещают обзоры: единого победителя нет. Есть три разных задачи, и девять инструментов почти сами собой раскладываются по ним.
Попробовать Thunderbit для извлечения веб-данных
Как устроен бенчмарк и одно ограничение, о котором я скажу прямо
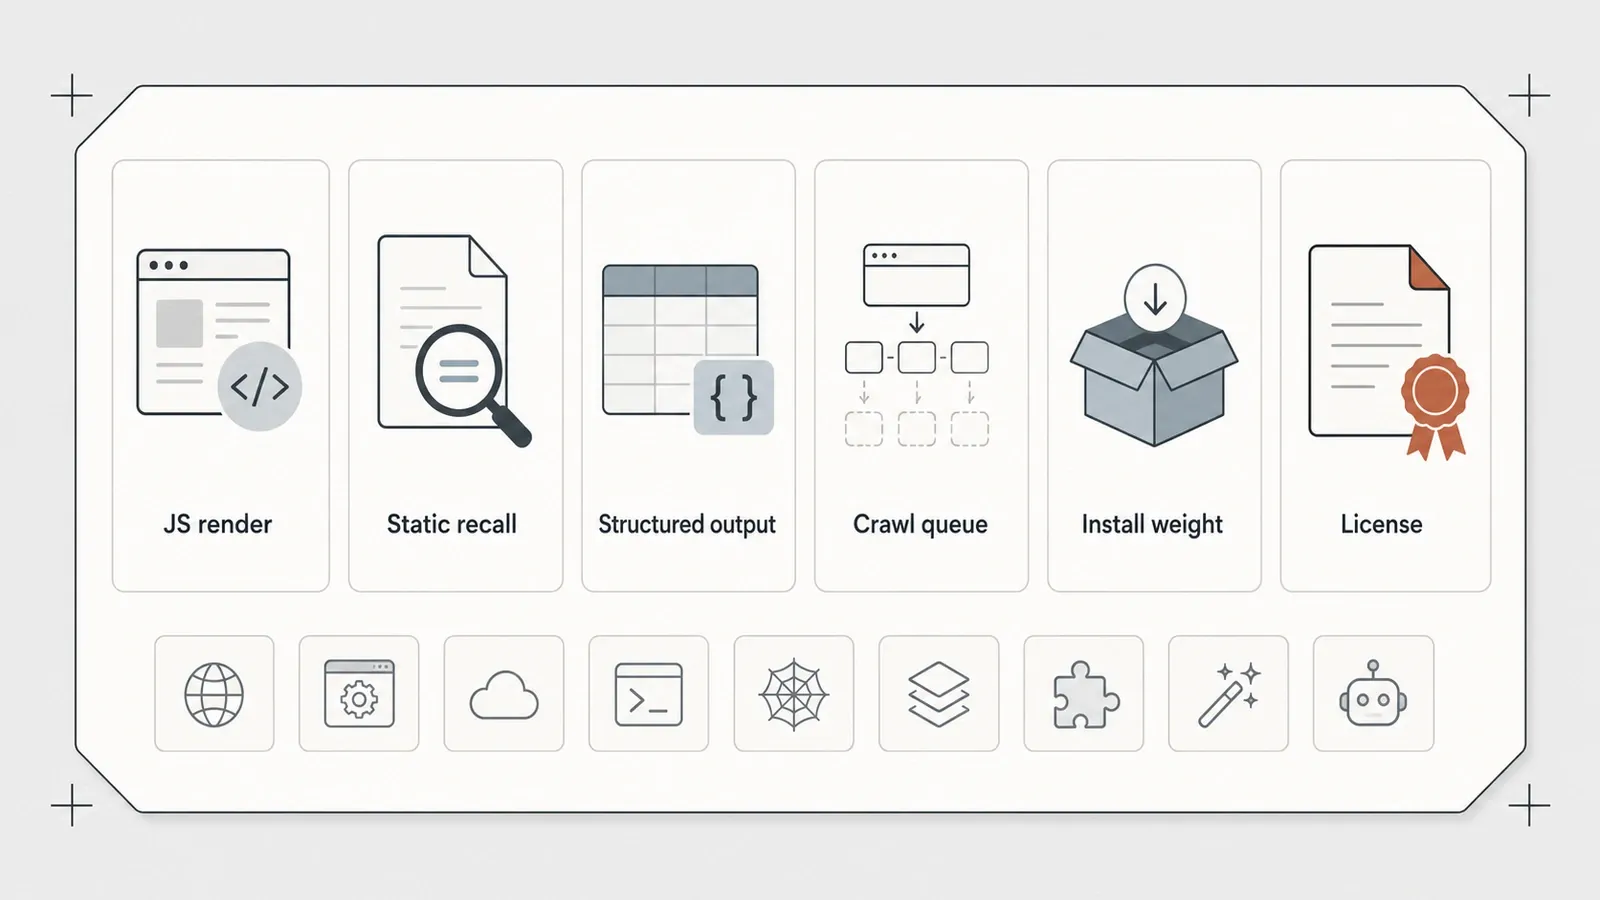
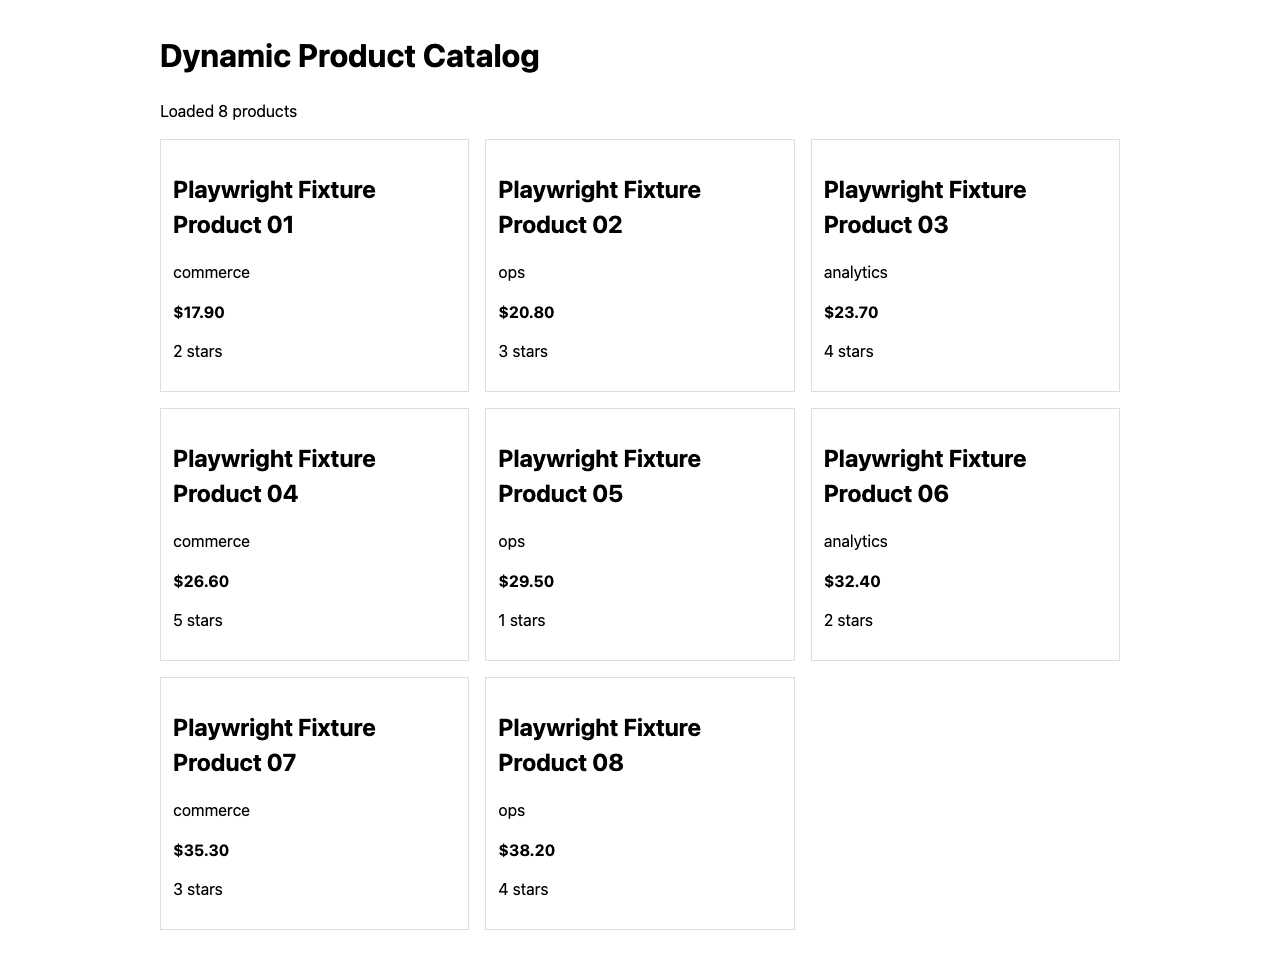
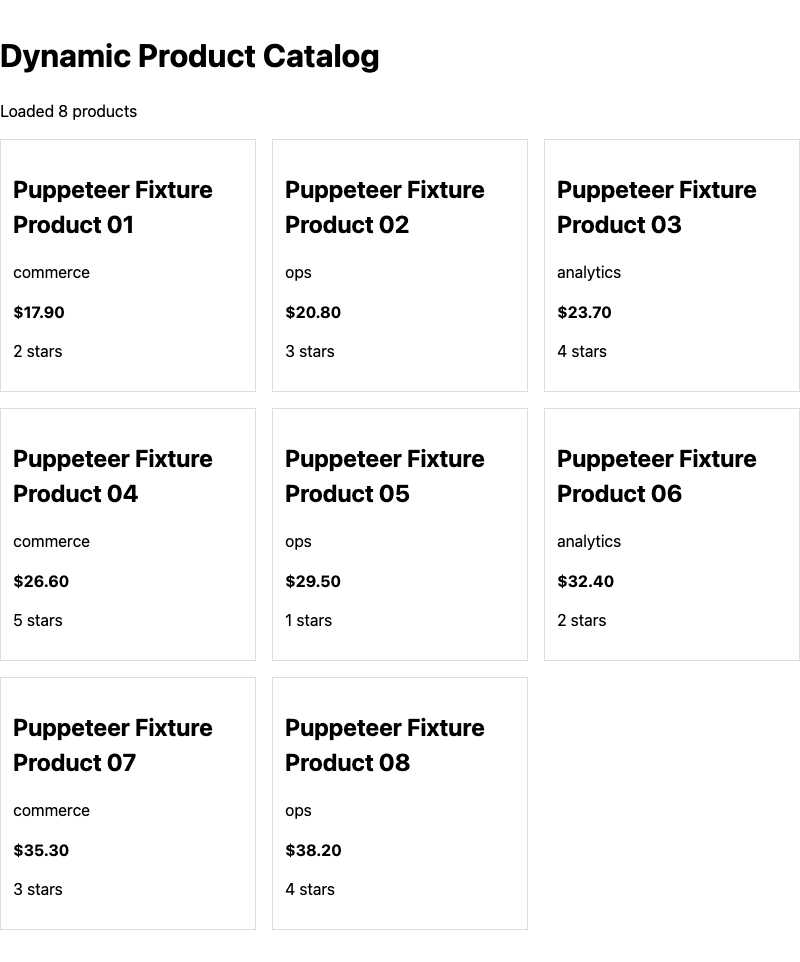
Каждый инструмент прогонялся по одинаковым типам тестовых страниц: 12 статических товаров на двух страницах, 8 товаров, подгружаемых JavaScript после задержки, статья с тремя настоящими абзацами, обёрнутая в навигацию и футер, намеренный серверный 500 и граф внутренних ссылок. Именно это делает результаты сопоставимыми: «8/8 динамических товаров» означает одно и то же, независимо от того, получил результат Puppeteer или Crawlee.
Но есть граница, которую большинство обзоров обходят стороной. У каждого инструмента свой набор файлов, соответствующий этим же фикстурам, поэтому абсолютные значения по количеству символов нельзя строго сравнивать между инструментами — читайте их только как сигнал внутри одного инструмента, а не как межинструментальный балл. Сопоставимы между собой recall (считайте это долей успеха), прохождение JavaScript и структурное поведение. И ещё одно замечание того же рода: в прогоне Crawl4AI статический каталог покрывал только первую страницу, поэтому его 6/6 — это полный recall на более узком срезе, тогда как другие инструменты обходили обе страницы и показывали 12/12 — меньший охват, а не частичный промах. Подробное объяснение по каждой фикстуре есть в описании методологии.
Ещё одна оговорка перед цифрами. У каждого набора данных есть и предварительная исследовательская оценка, но я сознательно не вывожу её в виде таблицы рейтинга. Это был внутренний инструмент для проверки каждого инструмента на его же собственных доказательствах, а не официальный список лидеров — и публикация в таком виде только воспроизвела бы ту самую ложную точность, от которой и призван уйти этот эксперимент. Ниже — синтез того, что показал бенчмарк, а не турнирная таблица.
Вся поляна в одном бенчмарке
Посмотрите только на два столбца этой таблицы — «Рендерит JS?» и «Встроенная очередь обхода» — и три задачи практически сами себя обозначают.
| Инструмент | Язык | Рендерит JS? | Recall для статики | Структурированный вывод | Встроенная очередь обхода | Вес установки | Лицензия |
|---|---|---|---|---|---|---|---|
| Crawl4AI | Python | Да (браузер) | 6/6 (страница 1) | CSS-схема | Встроенный BFS/DFS | Тяжёлая (2 браузерных стека) | Apache-2.0 |
| Firecrawl | Самостоятельный хостинг | Да (playwright-service) | Полный Markdown | Да | /v1/crawl | Самая тяжёлая (6 контейнеров) | AGPL-3.0 |
| trafilatura | Python | Нет | 3/3 статьи | Нет (только текст) | Нет | Лёгкая | Apache-2.0 |
| Crawlee | Node/TS | Зависит от движка | 12/12 | Через extraction | Да (RequestQueue) | Средняя (+~80 MiB) | Apache-2.0 |
| Playwright | Node/мульти | Да | 12/12 | Вручную | Нет (ручной BFS) | Средняя (браузер) | Apache-2.0 |
| Puppeteer | Node | Да (Chrome) | 12/12 | Вручную | Нет (ручной BFS) | Средняя (Chrome) | Apache-2.0 |
| Scrapy | Python | Нет | 12/12 | Экспорт ленты (JSON/CSV/XML) | Да (встроенная) | Средняя (зависимости Twisted) | BSD-3 |
| Colly | Go | Нет | 12/12 | Через callbacks | Контроль глубины | Лёгкая (1 бинарник + Go) | Apache-2.0 |
| Scrapling | Python | Нет (HTTP-fetcher) | 12/12 | Да | Нет | Средняя ([fetchers]) | BSD-3 |
Небольшая оговорка по метаданным в таблице и дальше по тексту: количество звёзд и версии были зафиксированы в начале июля 2026 года, а потом всё быстро меняется. Перед тем как считать эти данные актуальными, перепроверьте их на GitHub и на странице пакета каждого проекта.
Индекс обзоров по каждому инструменту
У каждого проекта из этой подборки есть отдельный глубокий разбор:
- Обзор Crawl4AI
- Обзор Firecrawl
- Обзор trafilatura
- Сравнение Playwright и Puppeteer
- Обзор Crawlee
- Обзор Scrapy
- Обзор Colly
- Обзор Scrapling
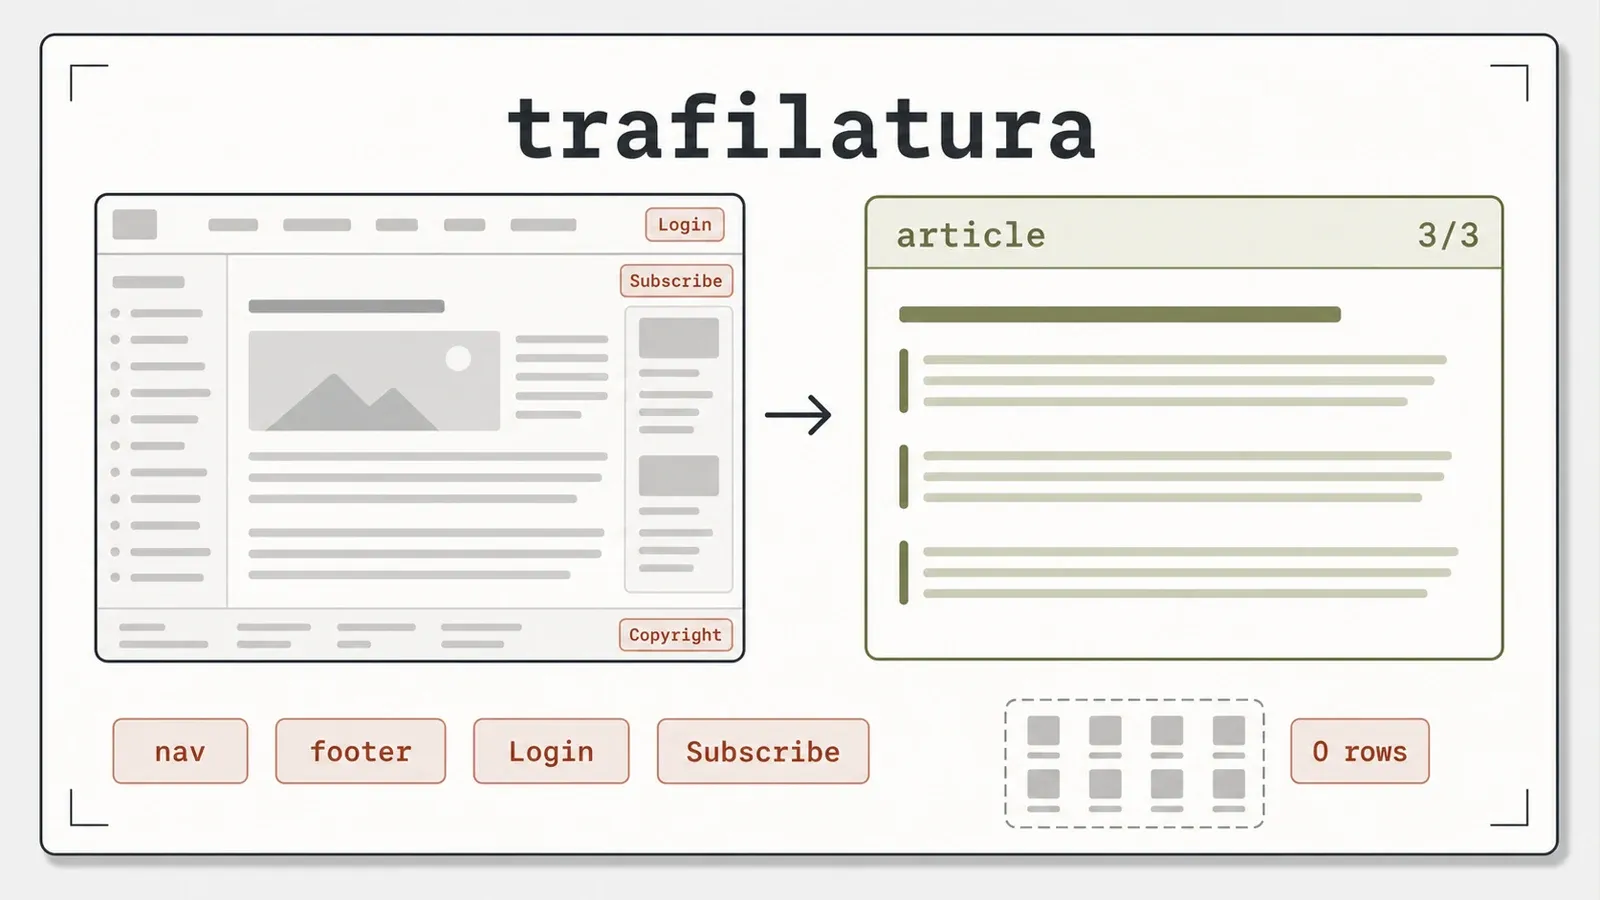
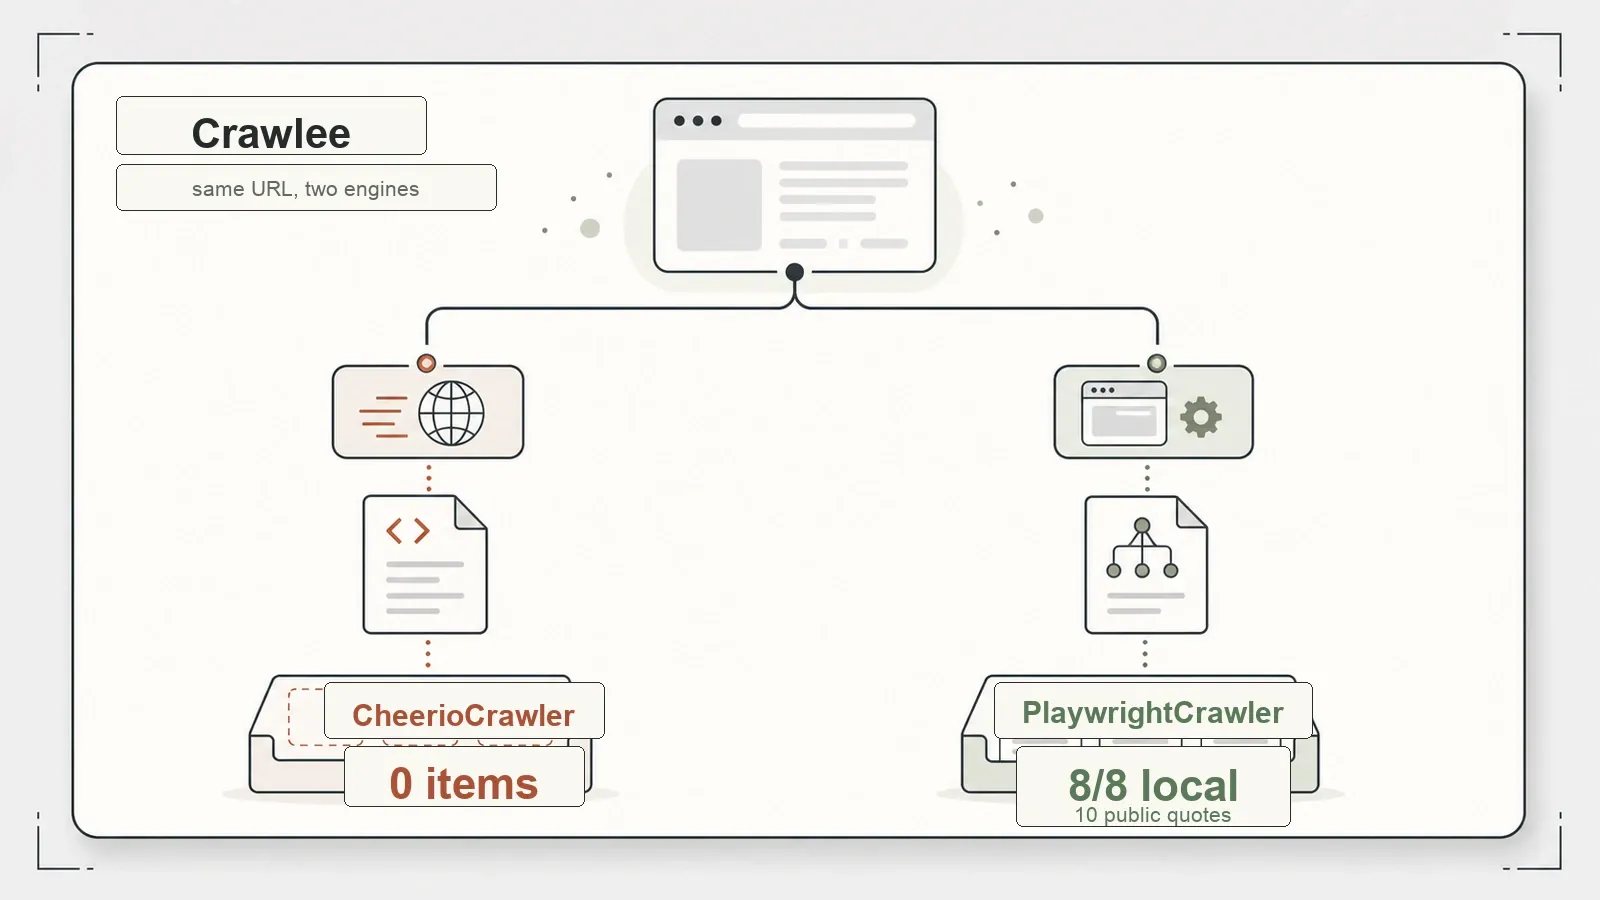
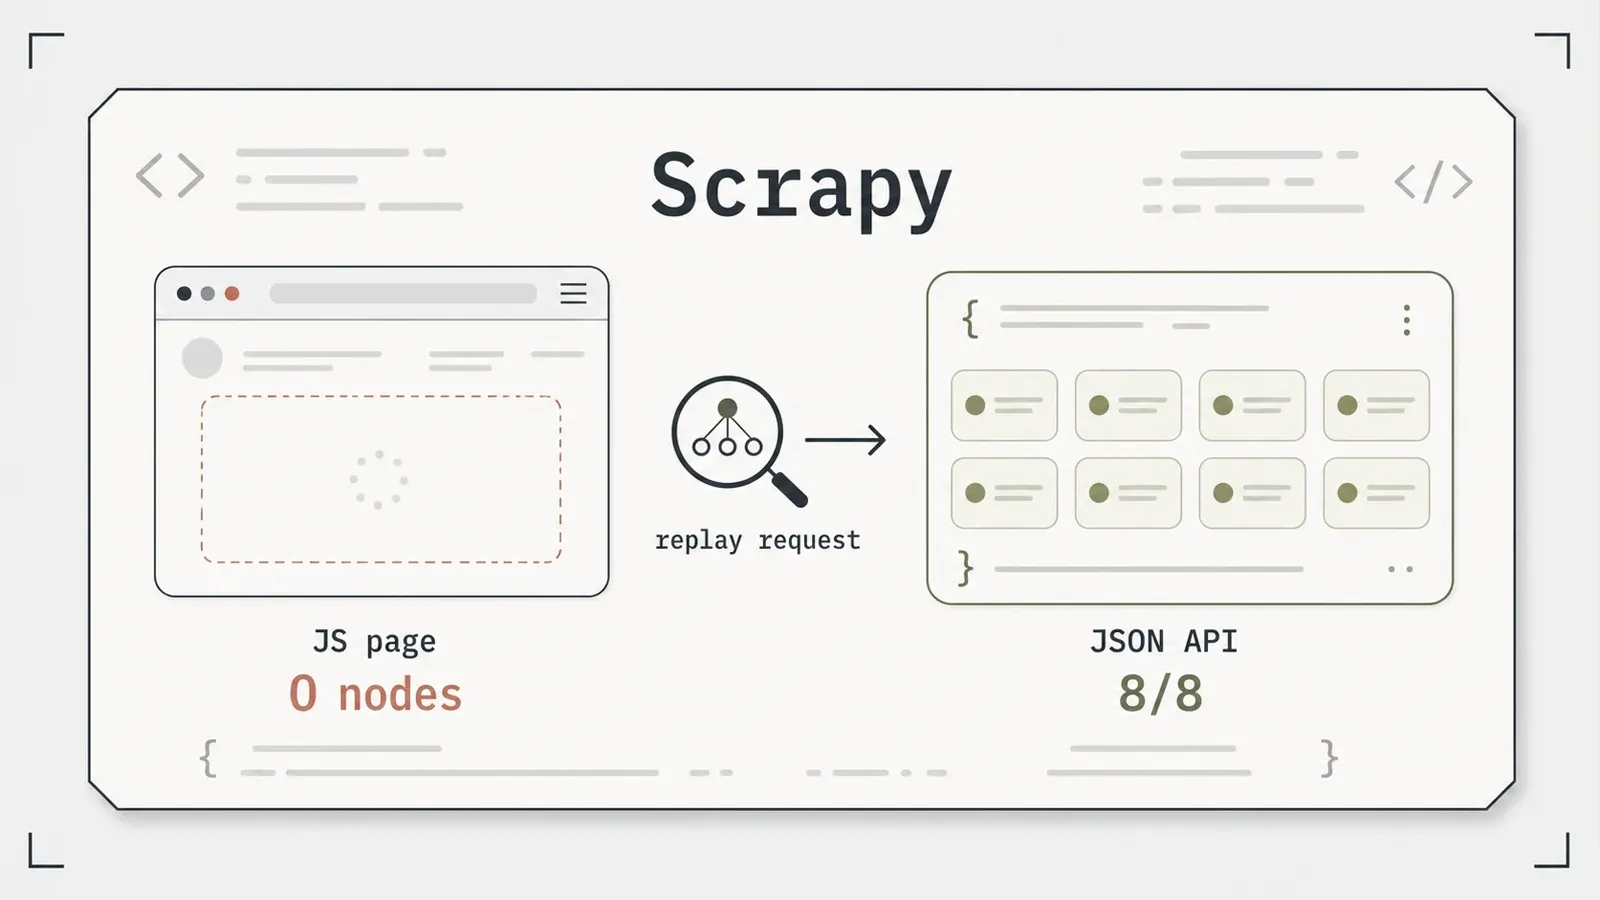
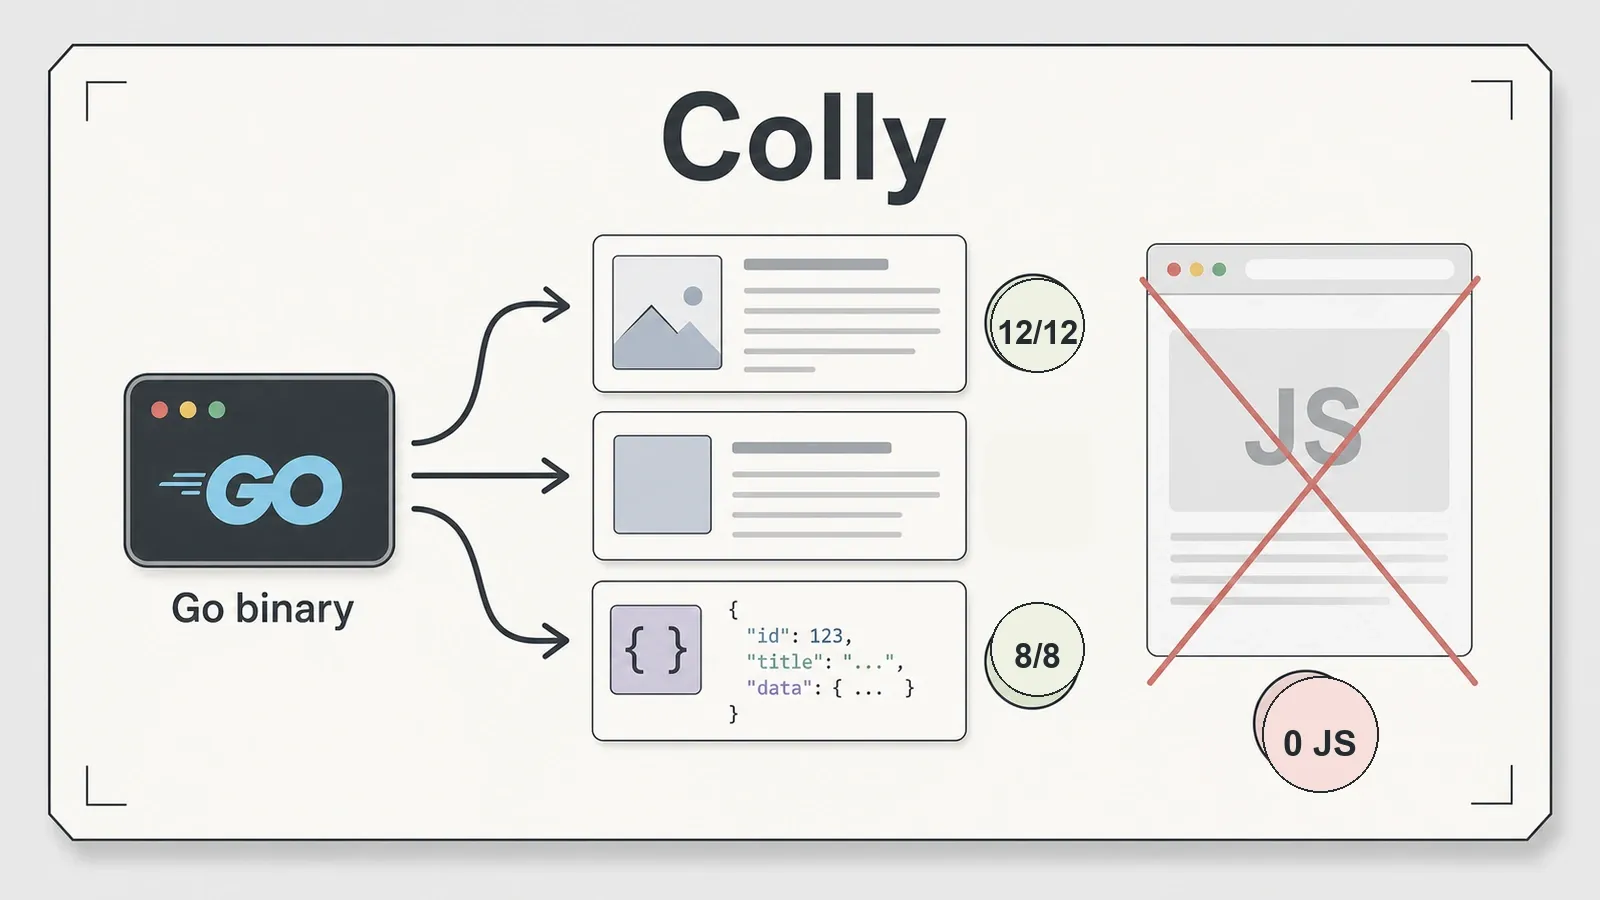
Вот их обложки — плюс два настоящих скриншота из теста с рендерингом JavaScript, чтобы утверждение про «8/8 dynamic» было не просто цифрой на странице.
Задача №1: превратить страницу в текст, готовый для LLM
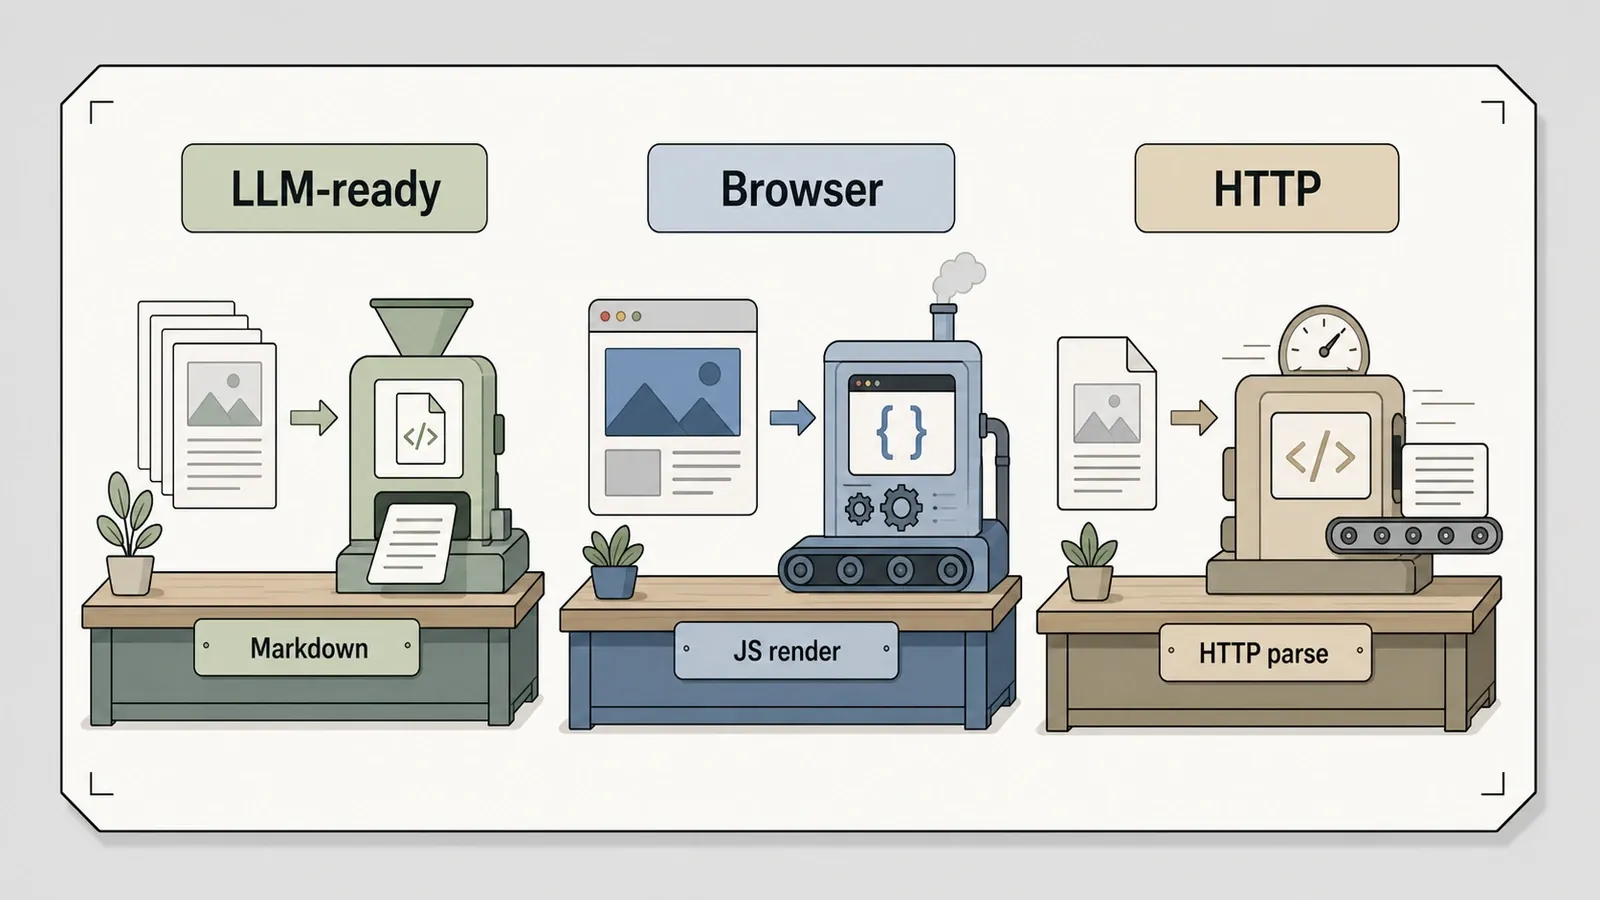
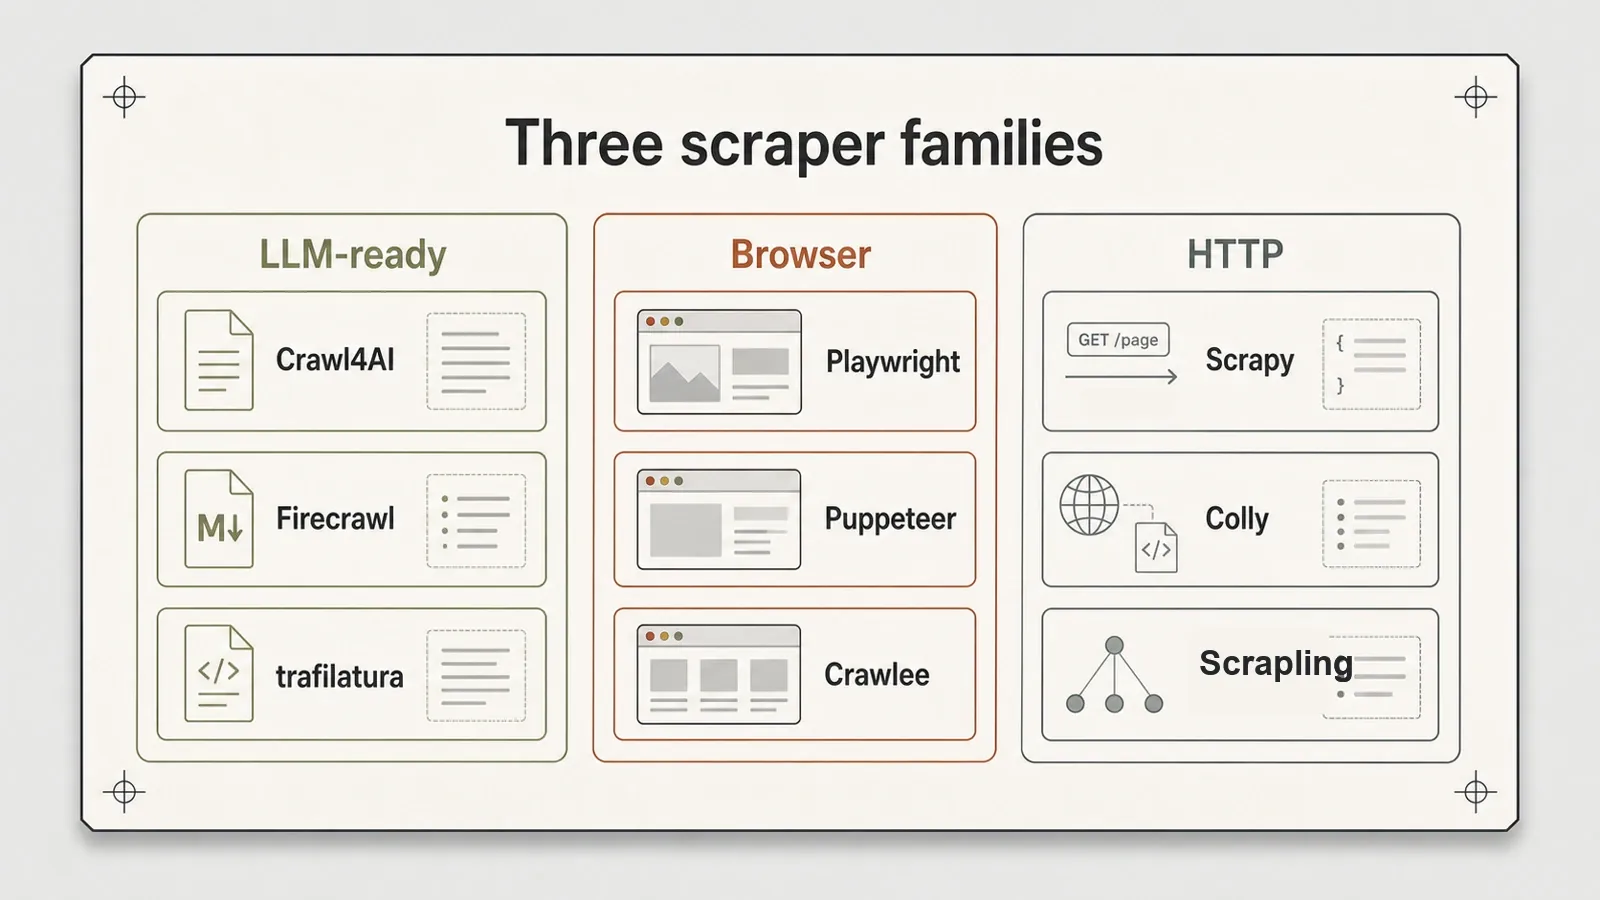
Если вам нужен чистый Markdown для подачи в RAG-пайплайн, за эту задачу конкурируют три инструмента — и по характеру они устроены совершенно по-разному.
Crawl4AI по сути, если отбросить маркетинг, — это генератор Markdown на базе браузера. Стоит развеять историю про «adaptive intelligence self-learning selector», которая тянется за ним в поиске: никакого такого механизма там нет — это фокус совсем другой библиотеки (к ней мы ещё вернёмся в разделе про Scrapling). Но то, что он реально делает, работает хорошо. На тренировочном сайте Books to Scrape он выдал 13 476 символов Markdown, умеет извлекать структуру через CSS-схему, а встроенный глубокий обход BFS прошёл 5 страниц на графе внутренних ссылок, одновременно отрендерив JavaScript-страницу и сделав скриншот. Но есть и два заметных минуса. В «сыром» Markdown остаётся служебный текст страницы, если не включить фильтр контента, а намеренный 500 вернулся как success=false — не потому, что Crawl4AI аккуратно поймал HTTP-ошибку, а потому, что собственная эвристика контента посмотрела на крошечное тело ошибки и пометила его как minimal_text ... blocked. Плюс установка тащит на диск две браузерные связки. Версия 0.9.0, Apache-2.0, примерно 71 тыс. звёзд на начало июля.
Firecrawl — тяжеловес, и самостоятельный хостинг у него действительно работает. Говорю «действительно», потому что стек из шести контейнеров (api, playwright-service, redis, rabbitmq, nuq-postgres и foundationdb) реально поднялся и выдал 9 222 символа LLM-ready Markdown с той же страницы Books to Scrape. Он отрисовал JavaScript-страницу через встроенный playwright-service, а цитата Эйнштейна, появляющаяся уже после скриптов, действительно оказалась в результате — значит, рендер был настоящим. Две проблемы, с которыми я столкнулся, были связаны не с Firecrawl, а с окружением, и я уточняю это намеренно, чтобы никто не повторил неверное исправление: сборка из исходников споткнулась о сбой snapshotter в containerd под colima (я переключился на готовые образы), а диапазон DNS 198.18.x.x в colima сработал как триггер для SSRF-защиты Firecrawl, которую я обошёл через ALLOW_LOCAL_WEBHOOKS=true — это локальный workaround для разработки, а не то, что стоит отключать в продакшене. У self-hosted-ядра также нет Fire-engine — облачного антиблокировочного слоя, — и облачный API я не тестировал. Более серьёзный момент — лицензия: self-hosted-ядро Firecrawl распространяется под AGPL-3.0, а это уже полноценная юридическая проверка перед коммерческим использованием, а не примечание мелким шрифтом. Примерно 148 тыс. звёзд на начало июля.
trafilatura — контрпример во всей группе и тот самый инструмент, который списки под AI-хайпом постоянно забывают. Никакого браузера. Никаких структурированных строк. Только быстрый и чистый текст статьи на чистом Python. На тестовой статье он вытащил заголовок и все 3 из 3 настоящих абзацев, полностью убрал служебную обвязку — никакие «Login», «Subscribe» или «Copyright» не протекли в результат — и дополнительно восстановил автора и дату. На публичной странице товара он вернул 1 324 символа чистого текста. Его пределы ровно такие, каких и ждёшь от такого дизайна: если подать ему каталог, он отдаст 12 названий товаров как текст, но 0 структурированных строк — текст есть, структуры нет, и JavaScript он не рендерит. Версия 2.1.0 (текущий релиз), Apache-2.0, около 6,2 тыс. звёзд. Для чистого извлечения статей это мой первый выбор.
Эти два значения длины Markdown — 13 476 у Crawl4AI и 9 222 у Firecrawl — получены со одной и той же публичной страницы, но не читайте их как показатель качества. Они отражают разные стратегии формирования Markdown (сколько именно служебной оболочки страницы каждый инструмент сохраняет), а не вердикт о том, чей результат лучше. Это как раз тот самый сигнал внутри одного инструмента, о котором говорилось выше.
Задача №2: надёжно отрендерить JavaScript
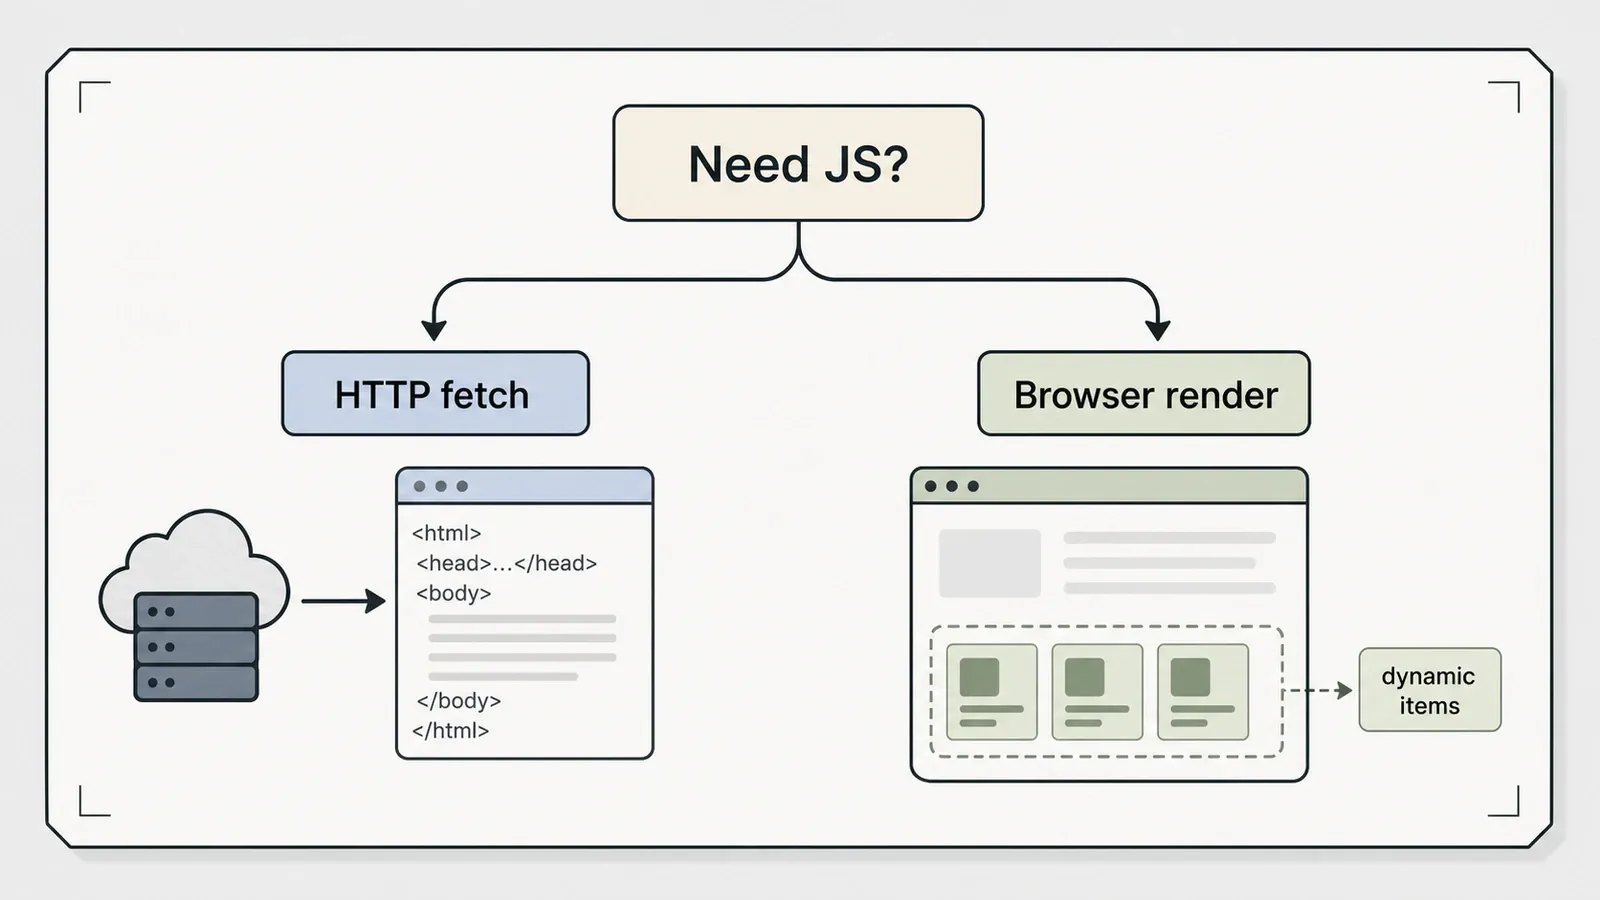
Часть данных просто не существует в HTML, пока не отработают скрипты, и в этот момент настоящий браузер перестаёт быть опцией «по желанию». Эту задачу закрывают три инструмента — и два из них оказались почти одним и тем же инструментом.
Playwright и Puppeteer на всех моих тестах пришли к ничьей. Оба отрендерили 8/8 динамических товаров в локальной фикстуре и 10 на публичном Quotes JS site, оба показали 12/12 для статического контента и оба корректно обработали 500 (Puppeteer возвращает объект response вместо того, чтобы бросать исключение). Ни один из них не поставляется со своей очередью обхода, поэтому для обоих пришлось писать ручной BFS, который прошёл 12 страниц на глубине 0–2 в графе обхода. Реальная разница только в охвате: Playwright управляет Chromium, Firefox и WebKit и поддерживает Python и .NET, а Puppeteer ориентирован на Chrome и работает только с Node. Две важные оговорки, потому что версии в этой области меняются быстро: я тестировал Playwright 1.56.0 против актуальной на тот момент 1.61.1 и использовал только Chromium; Puppeteer был 24.16.0 против текущей 25.3.0 — учитывайте это при повторении теста или интерпретации результатов. Оба Apache-2.0; примерно 92 тыс. и 95 тыс. звёзд соответственно.
Crawlee — это инструмент, который решает проблему очереди, оставленную двумя предыдущими. Он объединяет движок Cheerio (HTTP) и движок Playwright (браузер) под единым API, и контраст на одной и той же странице здесь сам по себе показывает идею: движок Cheerio увидел 0 элементов, подгружаемых JavaScript, а движок Playwright — все 8/8 локально (и 10 на публичном сайте), причём переключение между ними — это одна строка кода. Плюс он даёт настоящую RequestQueue, и именно это обеспечивает ему место в этой задаче, а не в третьей. Но есть нюанс, который обычно не попадает в заголовки: для браузерного движка нужен отдельный npx playwright install, а это примерно 80 МиБ, которые npm install crawlee сам за вас не скачает. Версия 3.17.0, TypeScript, Apache-2.0, около 24,6 тыс. звёзд.
Задача №3: быстро обходить страницы без браузера
Если на странице нет JavaScript, браузер — это дорогая избыточность. Здесь соревнуются три HTTP-first инструмента, каждый со своей языковой философией, и их различия оказываются очень любопытными.
Scrapy — самый инженерный фреймворк из всей группы: spider’ы, экспорт лент в JSON/CSV/XML, AutoThrottle и всё прочее. Он показал 12/12 на статике, вытащил 3/3 абзаца статьи, прошёл 11 страниц по графу ссылок на глубинах 0–2 и поймал 500 через handle_httpstatus_list. Самое интересное у него — философия: он не рендерит страницу, а воспроизводит запрос. Если направить его на JavaScript-страницу, он получит 0 узлов — зато JSON API, который стоит за этой же страницей, отдаст ему 8/8. В этом и есть подход Scrapy: найти запрос, который делает страница, и повторить его, а не водить по ней браузером. Цена — довольно тяжёлый стек зависимостей (Twisted, lxml, parsel), и я тестировал его только на небольших фикстурах. Версия 2.17.0, BSD-3-Clause, около 63 тыс. звёзд.
Colly — это Go-ответ на ту же задачу, и он удивительно честно говорит о том, чем является: один статически собранный бинарник, callback-логика через OnHTML, OnResponse и OnError, плюс контроль глубины. Он безошибочно взял 12/12 статических страниц, достал 8/8 через JSON API с помощью OnResponse, поймал 500 через OnError и дошёл до 17 страниц при обходе глубины 2 — и я формулирую это именно так, потому что это количество страниц посчитано самим тестовым каркасом, а не является гарантией полноты со стороны Colly. Чего он не делает — так это JavaScript: динамическая фикстура и Quotes JS site оба вернули 0, и это ожидаемо. Для сборки нужен Go toolchain, а версия модуля (v2.3.0) сейчас опережает помеченный релиз (v2.2.0). Apache-2.0, примерно 25 тыс. звёзд.
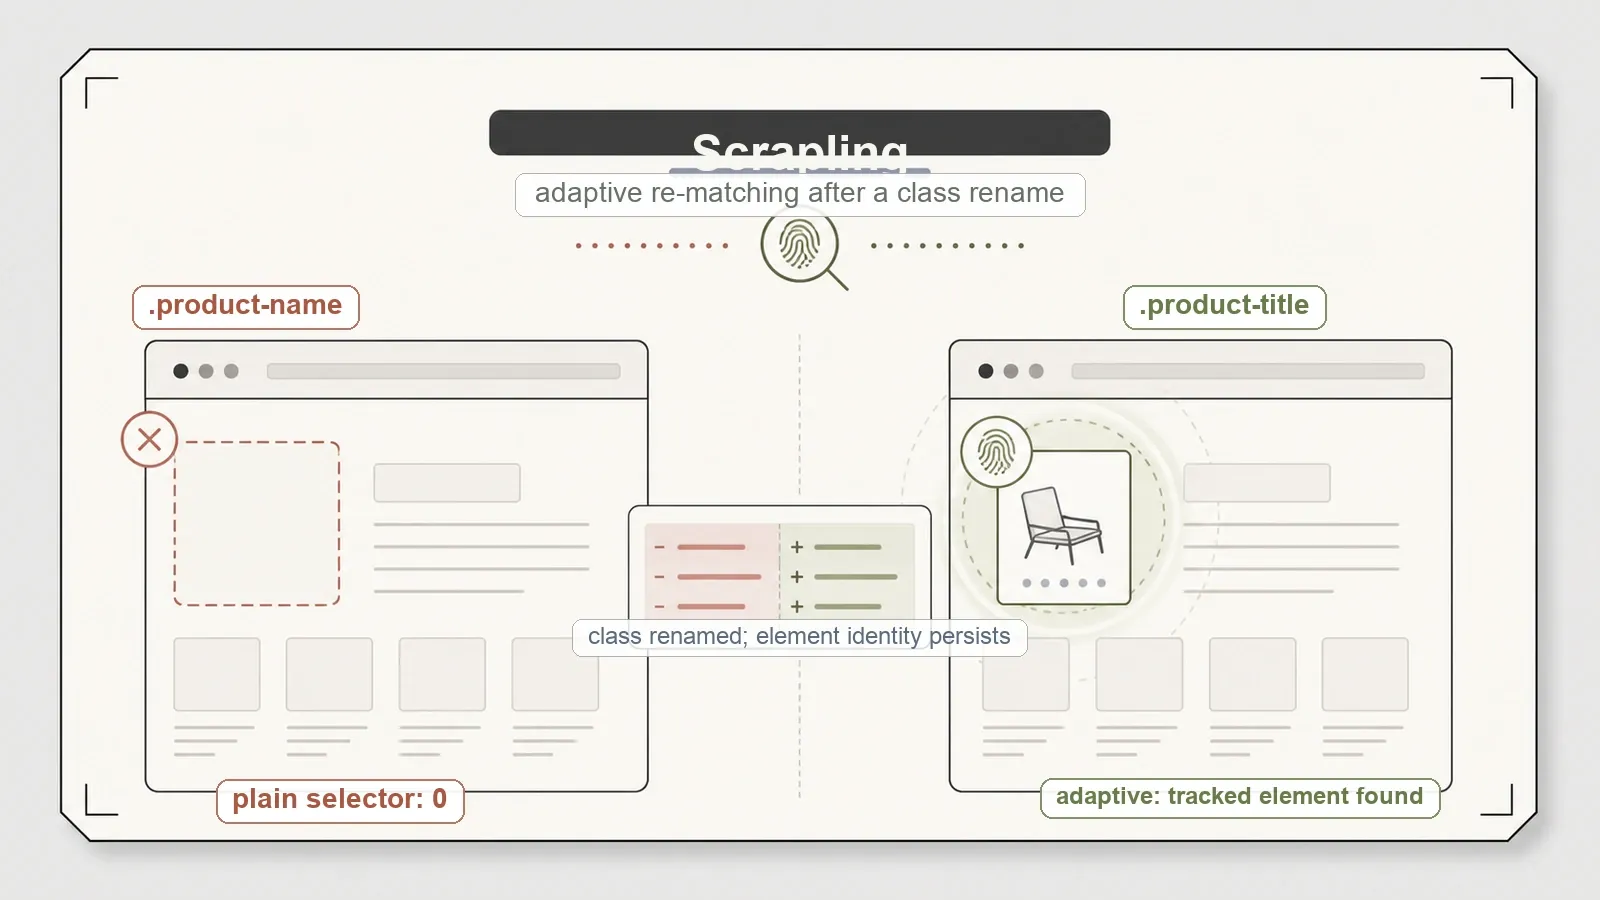
Scrapling — специализированный инструмент, и своё название он оправдывает. Его адаптивные селекторы умеют заново находить элемент после изменения разметки: когда я переименовал CSS-класс цели с product-name на product-title, обычный селектор дал 0, а адаптивный повторный матч всё равно восстановил отслеживаемый элемент. При обычном HTTP-извлечении он показал 12/12 на статике и 8/8 на JSON API. Но в его собственных документах скрывать нечего: в синтетическом тесте с несколькими элементами он восстановил только 1 из 3 — это устойчивое отслеживание элементов, а не полное восстановление, так что не стоит мысленно приписывать ему больше, чем он умеет. Для базовой установки pip install scrapling ещё нужен extra [fetchers], а StealthyFetcher — это скорее оговорка по совместимости, чем фича, которую стоит выносить на слайд. Версия 0.4.10 (текущий релиз), BSD-3-Clause, около 68,7 тыс. звёзд.
Паттерн, который виден за тремя задачами
Если выстроить все девять инструментов в ряд, становится видно нечто очень чёткое. Полный статический recall — ровные 12/12 — это базовый уровень для любого HTTP-first инструмента; никто не провалил простую задачу, так что это не конкурентное преимущество. Браузерные инструменты оправдывают свой дополнительный вес только тогда, когда JavaScript действительно участвует в работе, и за это они платят на этапе установки: браузерный стек, дополнительная установка или целый контейнерный флот. А столбец «встроенная очередь обхода» — это, по сути, граница между фреймворком и движком: Scrapy и Crawlee дают оркестрацию, а Playwright и Puppeteer заставляют писать BFS вручную. Вот как выглядит эта область. Никто не побеждает в целом, потому что никто не играет в одну и ту же игру.
Так что же выбирать на практике
Бенчмарк отказывается назначать одного победителя, потому что правильный ответ — это не инструмент, а вопрос: какую из трёх задач вы решаете?
- Нужен Markdown, готовый для LLM? Берите trafilatura, если вам нужен чистый текст статьи; Crawl4AI — если вместе с этим важны CSS-извлечение и рендер JavaScript в одной библиотеке; Firecrawl — если вам нужен именно self-hosted сервис и вы готовы принять и лицензию AGPL-3.0, и вес в шесть контейнеров.
- Нужно рендерить JavaScript? Для самого рендера — Playwright или Puppeteer; выбирайте по движку и языку, потому что в остальном это ничья. А Crawlee берите тогда, когда вам ещё нужна оркестрация обхода, а не ручная сборка.
- Нужно быстро и в масштабе обходить статические страницы или повторяемые API? Scrapy — если нужен полноценный Python-фреймворк, Colly — если важны скорость Go и один бинарник, Scrapling — если ваша постоянная боль это переживание изменений разметки.
Сопоставьте инструмент с задачей — и каждый из них будет вполне оправданным выбором. Возьмите инструмент не из той категории — браузерный для статических страниц или HTTP-парсер для JavaScript-приложения — и даже самый высоко оценённый в интернете пакет вас не спасёт.
Где вместо этого уместен managed AI API
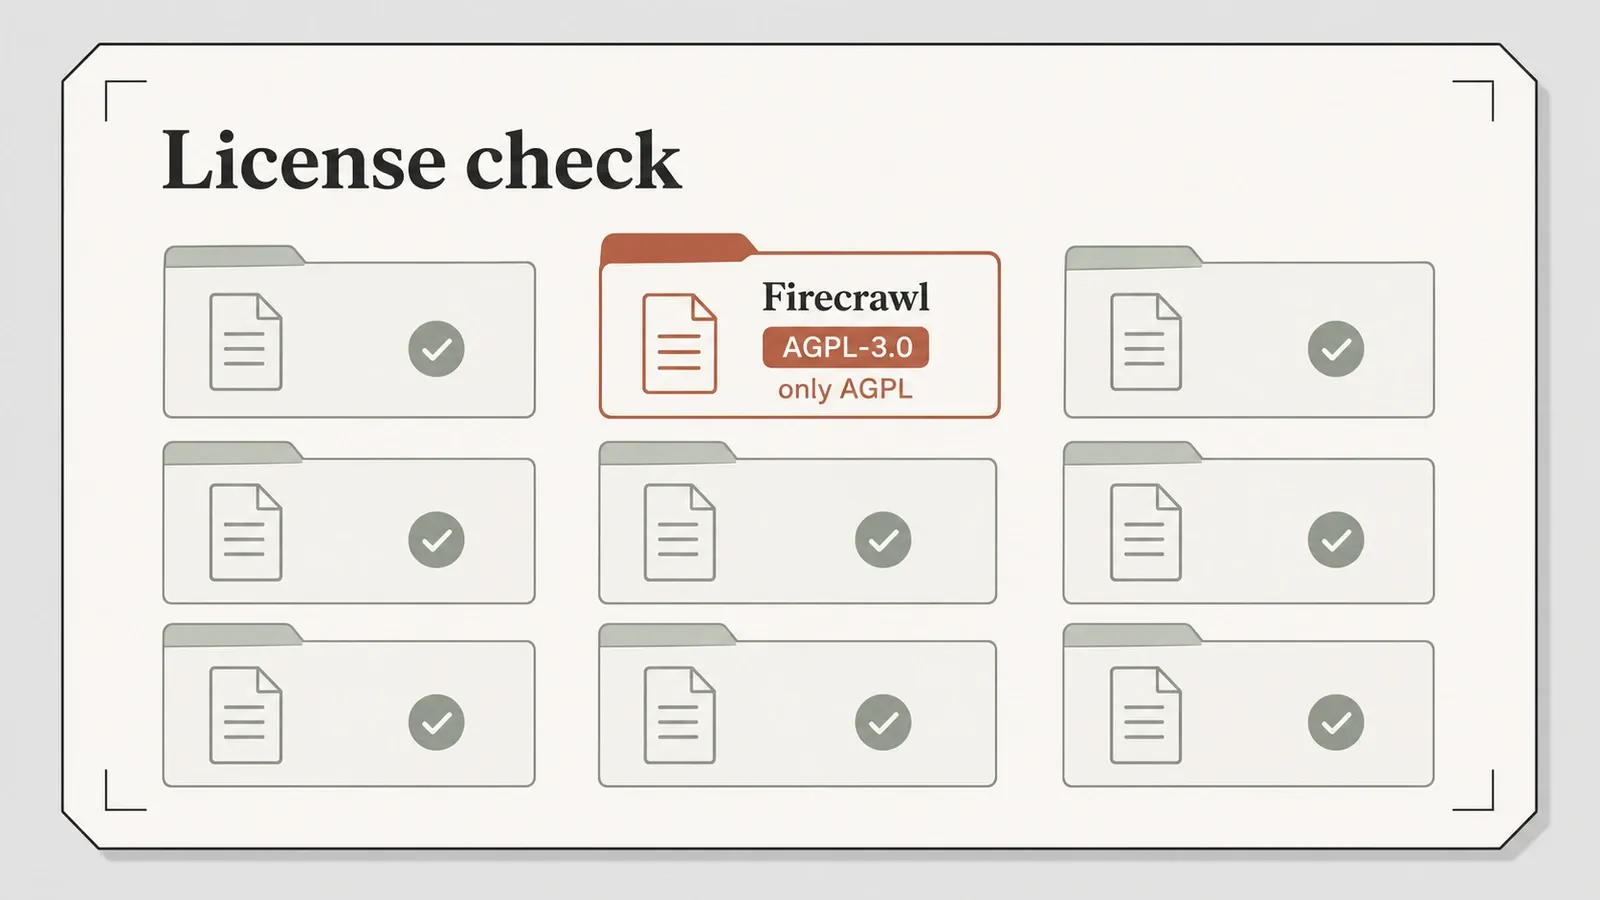
Все инструменты выше бесплатны, open-source и полностью в вашем распоряжении. Но именно в этом и общий компромисс, который показывает бенчмарк: вы сами отвечаете за браузерное окружение, код обхода, гонку вооружений с антиботами и вообще за всю поддержку. Для многих команд такой контроль — это как раз и есть цель, а карта лицензий важна именно в этот момент: у большинства участников лицензии permissive (Apache-2.0 у Crawl4AI, Crawlee, Playwright, Puppeteer и Colly; BSD-3 у Scrapy и Scrapling), а вот self-hosted-ядро Firecrawl под AGPL-3.0 требует реальной юридической оценки перед коммерческим использованием.
Но обратите внимание и на другое, что тоже показал бенчмарк: чего эти инструменты не делают. Рендер, обход, структурирование и обход блокировок — редко всё сразу и никогда без вашей поддержки. Managed AI API сводит весь этот стек к одному вызову. Наш собственный developer surface в Thunderbit — один из вариантов, и для технической аудитории важны именно API, MCP-сервер и CLI, а не расширение браузера. POST /distill возвращает чистый Markdown, а POST /extract — JSON по заданной схеме; JavaScript-рендер и антибот-защита выполняются на сервере, а не на вашей машине. Есть официальный MCP-сервер для агентов и coding assistant’ов — thunderbit_suggest_fields работает бесплатно и помогает спланировать извлечение, а затем thunderbit_distill (1 кредит) и thunderbit_extract (20 кредитов) выполняют работу — и есть CLI, который можно подключить через npx @thunderbit/thunderbit-cli для терминала и cron-задач. Для нетехнических сотрудников команды есть ещё no-code расширение Chrome, а цены покрывают оба сценария.
Компромисс здесь тот же, что проходит через весь этот бенчмарк: либо вы сами запускаете и поддерживаете до девяти библиотек при нулевой цене за запрос, либо отдаёте инфраструктурную часть наружу и платите за каждый запрос. Ни один из вариантов не плохой. Всё упирается в то, какой частью стека вы действительно хотите владеть. Если хотите посмотреть, как это выглядит на практике, YouTube-канал Thunderbit показывает это шаг за шагом.
Итог
Единого лучшего open-source скрапера не существует, и любой список, который уверенно выдаёт вам один-единственный ответ, тихо прячет главный вопрос: какую из трёх задач вы решаете? Превратить страницу в текст, отрендерить JavaScript или быстро обходить страницы без браузера — поле аккуратно делится на эти группы, и внутри каждой выбор сводится к языку и весу установки, а не к какому-то универсальному чемпиону.
Если вынести из этого текста одну привычку, то вот она: тестируйте на своих страницах, прежде чем на что-то подписываться. Все цифры здесь воспроизводимы в репозитории бенчмарка именно по этой причине — потому что инструмент, который выигрывает в общем обзоре, и инструмент, который выдерживает ваши реальные страницы, далеко не всегда один и тот же.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Частые вопросы
Какой open-source веб-скрапер лучший? Единственного лучшего нет — всё зависит от задачи. Для текста, готового для LLM, подойдут trafilatura или Crawl4AI; для рендера JavaScript — Playwright, Puppeteer или Crawlee; для быстрого HTTP-краулинга — Scrapy или Colly. На одном и том же бенчмарке каждый инструмент сильнее всего проявлял себя в своей категории и заметно слабее — за её пределами, поэтому универсальные рейтинги часто вводят в заблуждение.
Какие open-source скраперы умеют рендерить JavaScript? JavaScript рендерят Crawl4AI, Firecrawl, Playwright, Puppeteer и Playwright-движок в Crawlee. Scrapy, Colly, trafilatura и стандартный HTTP-fetcher в Scrapling этого не делают — им либо нужен воспроизводимый API за страницей (подход Scrapy, который взял 8/8 через JSON endpoint), либо отдельный браузерный режим.
Нужен ли headless-браузер, чтобы скрапить сайт? Только если данные появляются после выполнения JavaScript. Если обычный HTTP-запрос плюс парсер уже достают нужный контент, браузер будет дорогой и избыточной тяжестью — для такого случая Scrapy, Colly или Scrapling будут намного легче и быстрее.
У какого из них лицензия удобнее для коммерческого использования? У большинства лицензии permissive: Apache-2.0 (Crawl4AI, Crawlee, Playwright, Puppeteer, Colly) или BSD-3-Clause (Scrapy, Scrapling). Исключение — self-hosted-ядро Firecrawl под AGPL-3.0, которое требует серьёзной проверки лицензии, если вы строите на нём коммерческий продукт.
Можно ли воспроизвести эти результаты бенчмарка? Да. Все раннеры, фикстуры и сырые результаты лежат в публичном репозитории под лицензией MIT. Но есть одна важная оговорка: recall и структурные результаты можно сравнивать между инструментами, а вот абсолютные значения по числу символов — только внутри одного инструмента, потому что у каждого набора свои копии фикстур, а не один канонический источник. Поэтому сравнивайте доли и pass/fail, а не «сырые» суммы символов.




