
На прошлой неделе коллега прислал мне 47-страничный договор с поставщиком и попросил «просто перенести таблицы с ценами в таблицу Excel». Я посмотрел на PDF примерно три секунды, затем закрыл его и вместо ручной возни открыл PDF scraper. Это было не из лени — просто за годы я слишком часто видел, как люди тратят целые полдня, пытаясь вытащить данные из файлов, которые изначально не предназначены для такого использования.
Цифры подтверждают, что проблема реальна. В исследовании Airbase за 2024 год среди 745 специалистов по финансам выяснилось, что 38% команд тратят более четверти всего рабочего времени на ручные задачи. Отчёт SAP Concur по автоматизации AP добавляет, что 60% вводов счетов в ERP- или бухгалтерские системы по-прежнему выполняются вручную.
PDF-файлы везде — счета, договоры, финансовая отчётность, отсканированные чеки — а слишком большая часть работы всё ещё сводится к copy-paste. В 2026 году PDF scraper’ы варьируются от бесплатных Python-библиотек до AI-инструментов без кода, и неправильный выбор может стоить вам дней вместо экономии времени. Я протестировал 12 лучших PDF scraper’ов по извлечению таблиц, OCR, цене и удобству, чтобы вы могли за несколько минут найти подходящий вариант.
Что такое PDF scraper и зачем он вообще нужен?
PDF scraper — это программа, которая автоматически извлекает текст, таблицы, поля и структурированные данные из PDF-файлов. Если вы хоть раз пытались скопировать таблицу из PDF в Excel и видели, как столбцы схлопываются в одну нечитаемую строку, вы уже понимаете, в чём проблема.
PDF scraper’ы и web scraper’ы часто путают, поэтому короткое различие будет полезным. Web scraper читает HTML, где хотя бы есть структурные теги — заголовки, таблицы, div-элементы. PDF scraper начинает с формата визуального описания страницы. В документации Adobe прямо сказано: PDF создан, чтобы сохранять внешний вид страницы одинаковым на разных устройствах, а не для удобного табличного или семантического извлечения. Поэтому при copy-paste ломаются строки, столбцы и порядок чтения.
Где PDF scraping реально экономит время?
- Обработка счетов: извлечение названия поставщика, номера счёта, итогов, налогов и строк позиций
- Финансовые отчёты: извлечение таблиц из годовых отчётов, балансов и раскрытий
- Сканированные документы: восстановление контактных данных или транзакционной информации из PDF, где есть только изображение
- Миграция архивов: перевод старых архивов в формат поиска и структурированных записей
Влияние на бизнес выходит далеко за рамки одного процесса. Gartner по-прежнему оценивает плохое качество данных как фактор, который обходится организациям в среднем минимум в $12,9 млн в год. А в феврале 2025 Gartner сообщила, что 63% организаций либо не имеют, либо не уверены, что имеют правильные практики управления данными для AI. По прогнозу Gartner, к 2026 году организации откажутся от 60% AI-проектов, которые не поддерживаются AI-ready data. Если значительная часть сырых данных всё ещё хранится в PDF, качество извлечения документов напрямую связано с готовностью к AI.
В опросе Adobe 2025 года среди финансовых специалистов выяснилось, что 61% регулярно редактируют PDF-документы, а 64% — регулярно их подписывают. PDF Association также отмечает, что PDF занял 3-е место среди самых популярных форматов файлов в интернете по данным CommonCrawl. PDF никуда не исчезнут.
Как мы оценивали лучшие PDF scraper’ы
Прежде чем перейти к инструментам, вот рамка, которой я пользовался. Восемь критериев ниже напрямую отражают самые частые боли, которые я вижу на форумах, в GitHub issues и отзывах пользователей:
| Критерий | Что он измеряет | Почему это важно пользователю |
|---|---|---|
| Поддерживаемые типы PDF | Нативный текст, сканы/только изображение, смешанный формат | Многие инструменты ломаются ещё до начала извлечения |
| Точность извлечения таблиц | Простые, без границ, многостраничные, с объединёнными ячейками | Проблема №1 при работе с PDF |
| Возможности OCR | Встроенный, как дополнение или отсутствует | Сканированные PDF бесполезны без OCR |
| Форматы вывода/экспорта | Excel, CSV, JSON, Sheets, Notion, API | Данные бесполезны, если их нельзя нормально вывести из инструмента |
| Сложность настройки | Без кода, с минимумом кода или code-first | Командам нужен разный уровень контроля |
| Цена / бесплатный тариф | Публичная цена, пробный период, реальный порог входа | Модели оплаты сильно отличаются |
| Автоматизация / интеграции | Zapier, API, расписание, webhooks | Ручной экспорт не масштабируется |
| Лучший сценарий применения | Для чего инструмент действительно хорош | Почти ни один инструмент не универсален — всё зависит от задачи |
Чтобы материал было легче читать, 12 инструментов я разделил на три категории: AI scraper’ы без кода, шаблонные или SaaS-парсеры документов и developer-библиотеки / API / open-source инструменты.
12 лучших PDF scraper’ов в одном обзоре
Ниже — сводная таблица, чтобы вы могли быстро найти свой сценарий и перейти к нужному разделу:
| Инструмент | Тип | Извлечение таблиц | Встроенный OCR | Без кода | Бесплатный тариф | Лучше всего подходит для |
|---|---|---|---|---|---|---|
| Thunderbit | AI scraper без кода | ✅ На базе AI | ✅ Да | ✅ Да | ✅ Бесплатные кредиты | Бизнес-пользователи, разные макеты |
| Tabula | Open-source desktop | ✅ Хорошо (текстовые PDF) | ❌ Нет | ✅ GUI | ✅ Полностью бесплатно | Простые текстовые PDF с таблицами |
| Parseur | Гибридный SaaS | ⚠️ Шаблоны + AI | ✅ Да | ✅ Да | ⚠️ Ограниченно | Повторяющиеся счета / email-парсинг |
| Nanonets | AI IDP SaaS | ✅ Сильное | ✅ Да | ✅ Low-code | ⚠️ Пробные кредиты | Массовая автоматизация документов |
| Adobe Acrobat | PDF-продуктивный пакет | ⚠️ Базовое | ✅ Да | ✅ Да | ❌ Экспорт платный | Редкий PDF-to-Excel |
| PyMuPDF | Python-библиотека | ⚠️ Ручной парсинг | ❌ Нет (Tesseract опционально) | ❌ Нужен код | ✅ Полностью бесплатно | Разработчики, текстовые PDF |
| Camelot | Python-библиотека для таблиц | ✅ Сильное (lattice + stream) | ❌ Нет | ❌ Нужен код | ✅ Полностью бесплатно | Разработчики, сложные таблицы |
| Docparser | Шаблонный SaaS | ⚠️ На основе шаблонов | ✅ Да | ✅ Да | ⚠️ Триал | Повторяющиеся документы + Zapier workflows |
| pdfplumber | Python-библиотека | ✅ Хорошее (гранулярное) | ❌ Нет | ❌ Нужен код | ✅ Полностью бесплатно | Разработчики, тонкая настройка |
| AWS Textract | Cloud API | ✅ Сильное | ✅ Да | ❌ Нужен API | ⚠️ Ограниченный free tier | Enterprise-пайплайны |
| Docling | Open-source Python | ✅ Хорошее | ✅ Через интеграцию | ❌ Нужен код | ✅ Полностью бесплатно | LLM/RAG пайплайны |
| Parsio | Гибридный SaaS | ⚠️ С поддержкой AI | ✅ Да | ✅ Да | ⚠️ Ограниченно | Повторяющиеся типы документов |
Нужен нулевой порог входа? Смотрите на no-code или SaaS-инструменты. Нужен максимальный контроль? Тогда начинайте с developer-инструментов. Работаете со сканированными PDF? Сразу исключайте всё, где OCR = No.
1. Thunderbit
 Thunderbit — это PDF scraper, который я бы посоветовал любому, кто говорит: «Мне просто нужно достать данные из этого PDF», и не хочет слышать про Python, шаблоны или API-ключи. Это AI web data agent — расширение для Chrome, которое читает PDF, изображения и сайты, а затем выдаёт структурированные данные. Без шаблонов, без кода.
Мы сделали Thunderbit для сценария, который ломает большинство инструментов: у вас есть PDF от пяти разных поставщиков, у каждого немного свой макет, а вам нужны одни и те же поля из каждого файла. AI заново читает каждый документ, предлагает названия столбцов и типы данных через функцию "AI Suggest Fields", а затем извлекает информацию в структурированную таблицу. Встроенный OCR обрабатывает отсканированные PDF и изображения нативно, с поддержкой 34 языков.
Ключевые возможности:
- One Click Extract определяет столбцы и типы данных для любого макета PDF — без ручной настройки
- Встроенный OCR для сканированных PDF и изображений
- Экспорт в Excel, Google Sheets, Airtable, Notion, CSV и JSON — всё бесплатно
- AI-метки и переформатирование: AI может переводить, классифицировать или перестраивать данные прямо во время извлечения, а не только после
- Извлечение таблиц работает по визуальному восприятию макета, как человек, и адаптируется к таблицам без границ, нестандартным и разным по структуре форматам
Как извлечь данные из PDF с помощью Thunderbit:
- Установите Thunderbit Chrome Extension
- Откройте PDF или загрузите его в браузер
- Нажмите "One Click Extract" — AI прочитает документ и определит названия столбцов и типы
- Нажмите "Scrape" — данные будут извлечены в структурированную таблицу
- Экспортируйте в Google Sheets, Excel, Airtable, Notion, CSV или JSON
Цена: Бесплатный тариф с кредитами (примерно 6 страниц бесплатно, 10 со trial). Starter-план — около ~$15/месяц или примерно ~$9/месяц при годовой оплате. Кредиты считаются по строкам (1 кредит = 1 строка результата). Подробности см. на странице Thunderbit Pricing.
Лучше всего подходит для: Нетерехнических пользователей, которые работают с разными PDF-макетами (счета от нескольких поставщиков, отчёты в смешанных форматах) и хотят получить результат одним нажатием.
Плюсы: Самая простая настройка в этом списке; встроенный OCR; прямой экспорт в Sheets, Notion, Airtable и Excel; работает с разными макетами без шаблонов.
Минусы: Модель оплаты по кредитам требует времени, чтобы перевести её в стоимость на страницу; меньше сторонних отзывов, чем у крупных SaaS-вендоров.
Попробуйте Thunderbit для PDF scraping Загрузите счета от пяти разных поставщиков, и AI сам определит столбцы для каждого макета — без настройки шаблонов. Get Started Free
2. Tabula
 Tabula — классический бесплатный вариант для извлечения таблиц из текстовых PDF, но при этом уже заметно устаревший. В репозитории указано, что проект поддерживается волонтёрами, а десктопное приложение вряд ли получит обновления в ближайшем будущем. Последняя версия desktop — 1.2.1, выпущенная в 2018 году, а tabula-java последний раз обновлялся до 1.0.5 в 2021 году.
Ключевые возможности:
- GUI с point-and-click для выбора областей таблицы
- Работает локально — данные не покидают ваш компьютер
- Без аккаунта, подписки и регистрации
Цена: Полностью бесплатно, навсегда. Open source.
Лучше всего подходит для: Пользователей с простыми текстовыми PDF и хорошо очерченными таблицами, которым нужен бесплатный локальный инструмент.
Плюсы: Бесплатно; локально; очень просто для базовых таблиц.
Минусы: Нет OCR (сканированные PDF не подходят); плохо работает с таблицами без границ; нет автоматизации и API; нет облачной версии; фактически проект не развивается.
3. Parseur
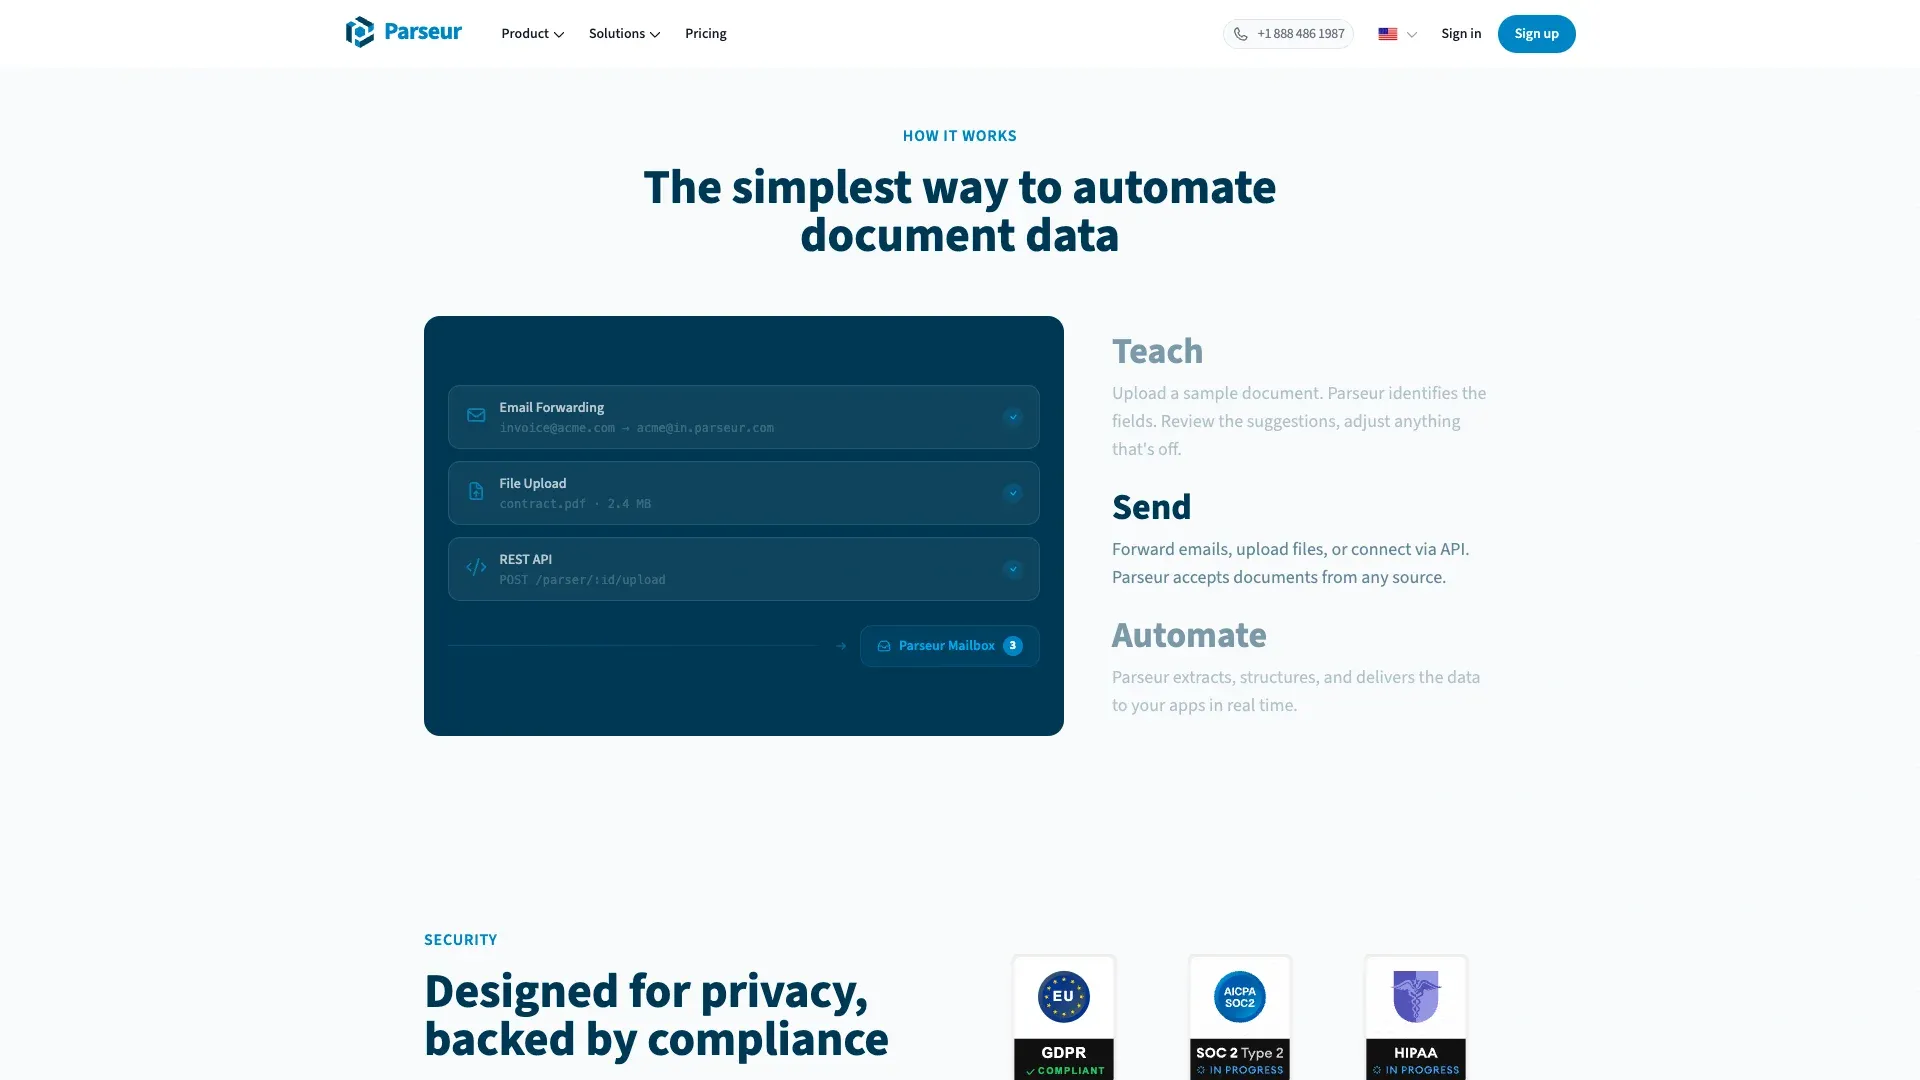 Parseur — самый сильный гибрид среди SaaS-инструментов, потому что сочетает AI parsing, шаблонный парсинг и dynamic OCR. Из-за этого он гибче, чем чисто зональный парсер, но всё же более структурирован, чем универсальный AI scraper.
Ключевые возможности:
- Встроенный OCR с поддержкой 60+ языков (160+ экспериментально)
- Интеграции с Zapier, Make, Power Automate, API, webhooks, Google Sheets
- Хорошо подходит для счетов, накладных, подтверждений заказов и повторяющихся типов документов
Цена: Бесплатный тариф примерно на 20 страниц в месяц. Самый доступный платный self-serve план — около ~$39/месяц. Нормализованная стоимость на самом маленьком плане составляет примерно $390 за 1,000 страниц, хотя при большем объёме эффективная ставка падает.
Лучше всего подходит для: Команд, которые регулярно получают одни и те же типы документов и хотят автоматизацию без кода.
Плюсы: Встроенный OCR; сильный стек автоматизации; хорошо работает с повторяющимися макетами.
Минусы: Для каждого нового или «плавающего» макета может понадобиться шаблонная настройка или fallback на AI; сложные таблицы всё ещё даются труднее.
4. Nanonets
 Nanonets ближе к платформе интеллектуальной обработки документов (IDP), чем к простому PDF scraper’у — и в этом одновременно его сила и сложность. Компания изменила цены 31 января 2025 года, перейдя на предоплаченные usage credits вместо простой модели оплаты за страницы.
Ключевые возможности:
- AI-извлечение таблиц и определение полей
- Встроенный OCR с поддержкой 40+ языков
- Автоматизация workflow с этапами согласования
- Широкий набор enterprise-интеграций
Цена: Кредиты при регистрации. Оплата по использованию. Грубая оценка на основе публичной документации по блочным тарифам — около $300–$380 за 1,000 страниц для простого сценария извлечения.
Лучше всего подходит для: Команд среднего и крупного размера, которые обрабатывают тысячи документов в месяц (автоматизация AP, логистика, страховые претензии).
Плюсы: Сильное AI-извлечение; enterprise-интеграции; автоматизация процессов.
Минусы: Стоимость сложнее предсказать; более высокая кривая обучения для продвинутых workflow; ограниченный бесплатный тариф.
5. Adobe Acrobat
 Adobe Acrobat — это базовый PDF-инструмент, который узнаёт почти каждый. Он силён в OCR и конвертации, но по сути это не scraper в том же смысле, что и остальные инструменты из списка.
Ключевые возможности:
- Встроенный OCR в Pro-версии
- Экспорт в Word, Excel, PowerPoint, HTML, TXT и форматы изображений
- Широкая поддержка OCR для разных языков
Цена: Acrobat Standard — $14.99/месяц; Acrobat Pro — $19.99/месяц. Reader бесплатный, но функции экспорта доступны только в платном плане.
Лучше всего подходит для: Пользователей, которым иногда нужно преобразовать PDF в Word или Excel и у которых уже есть подписка Adobe.
Плюсы: Широко известен; встроенный OCR; у многих уже установлен.
Минусы: Извлечение таблиц на сложных макетах довольно базовое; нет автоматизации или API для пакетной обработки; не создавался как «scraper».
6. PyMuPDF
 PyMuPDF (также известный как "fitz") остаётся самой быстрой универсальной Python-библиотекой для извлечения данных из PDF в этом обзоре. Текущий релиз — 1.27.2.2 от марта 2026 года, а бенчмарки по-прежнему показывают, что он заметно быстрее многих других Python PDF-библиотек.
Ключевые возможности:
- Очень быстрое извлечение сырого текста
- Извлечение изображений и доступ к метаданным
- OCR опционально через Tesseract (хотя в документации отмечается, что OCR примерно в 1,000 раз медленнее стандартного извлечения)
- Обнаружение таблиц через
find_tables()
Цена: Полностью бесплатно, open source.
Лучше всего подходит для: Разработчиков, которые строят пайплайны и в основном работают с текстовыми, нативными PDF.
Плюсы: Очень быстрый; лёгкий; активное сообщество; сильное извлечение текста.
Минусы: Нет встроенного OCR; извлечение таблиц требует ручной логики парсинга; нужен код.
7. Camelot
 Camelot по-прежнему остаётся одним из самых узнаваемых Python-инструментов для извлечения таблиц, потому что он ориентирован именно на таблицы, а не на документы вообще. Репозиторий активно поддерживается, и версия v1.0.9 вышла в августе 2025 года.
Ключевые возможности:
- Два режима извлечения:
latticeдля таблиц с границами иstreamдля таблиц без границ / по пробелам - Метрики точности в отчёте парсинга — одна из самых полезных функций Camelot для workflow автоматизации
- Вывод в pandas DataFrame, CSV, JSON, Excel
Цена: Полностью бесплатно, open source.
Лучше всего подходит для: Разработчиков, которым нужно точное извлечение таблиц из структурированных текстовых PDF.
Плюсы: Отличная точность таблиц; два режима извлечения; scoring точности.
Минусы: Нет OCR; только текстовые PDF; нужен код; на больших документах может работать медленно.
8. Docparser
 Docparser — самый явно rule-driven SaaS-инструмент в этом списке. Он использует зональный OCR, ключевые слова-якоря и правила парсинга фиксированного макета вместо того, чтобы пытаться вести себя как универсальный AI-ридер.
Ключевые возможности:
- Встроенный OCR
- Интеграции с Zapier, Workato, Power Automate, Google Sheets, Salesforce и REST API
- Хорошо подходит для передачи извлечённых данных в бизнес-процессы
Цена: Starter за $39/месяц; Professional за $74/месяц; Business за $159/месяц. Бесплатный trial на 14 дней. Оплата идёт по документам, поэтому нормализованная стоимость за 1,000 страниц зависит от длины документа — примерно $78–$390 на Starter-тарифе.
Лучше всего подходит для: Команд, которым нужно автоматизировать повторяющиеся документные процессы с тесной интеграцией в Zapier или Salesforce.
Плюсы: Встроенный OCR; сильные интеграции для workflow; хорош для стабильных макетов.
Минусы: Основан на шаблонах — для каждого нового макета нужна настройка; извлечение таблиц зависит от определения зон; особенно силён на первой странице.
9. pdfplumber
 pdfplumber остаётся самой гранулярной библиотекой для разработчиков в этом наборе. Текущий релиз — 0.11.9 от января 2026 года, а в репозитории указано, что проект активно развивается.
Ключевые возможности:
- Тонкий контроль над объектами символов, линиями, прямоугольниками и стратегиями поиска таблиц
- Crop-based фильтрация и визуальная отладка
- Вывод данных в виде Python list/dict для удобной дальнейшей обработки
Цена: Полностью бесплатно, open source.
Лучше всего подходит для: Python-разработчиков, которым нужна гранулярная и настраиваемая логика извлечения таблиц.
Плюсы: Отличный низкоуровневый контроль; хорошая точность на сложных таблицах; активная разработка.
Минусы: Нет OCR; сложнее в освоении, чем Camelot; нужен код.
10. AWS Textract
 AWS Textract — самый enterprise-native API в этом списке. Он создан для масштаба, разнообразия документов и программного использования, а не ради удобного GUI.
Ключевые возможности:
- AI-извлечение таблиц и форм
- Встроенный OCR с поддержкой рукописного текста (лучший вариант в этом списке, хотя всё ещё неидеальный)
- Enterprise-масштабируемость
- Гладкая интеграция в экосистему AWS
Цена: Оплата за страницу. Бесплатный тариф: 1,000 страниц в месяц в течение 3 месяцев. Затем: OCR только текста — $1.50 за 1,000 страниц; таблицы — $15 за 1,000 страниц; формы + таблицы — $65 за 1,000 страниц; expense documents — $10 за 1,000 страниц.
Лучше всего подходит для: Enterprise-команд, которые обрабатывают 10,000+ документов в месяц через API-пайплайн.
Плюсы: Точное извлечение форм и таблиц; встроенный OCR; enterprise-масштаб.
Минусы: Только API; нет визуального интерфейса; стоимость быстро растёт на продвинутых режимах; привязка к экосистеме AWS.
11. Docling
 Docling — самый «заглядывающий в будущее» open-source инструмент в этом обзоре, потому что он прямо нацелен на document-to-LLM пайплайны. Текущий релиз — 2.90.0 от 17 апреля 2026 года, и проект быстро развивается.
Ключевые возможности:
- Вывод в Markdown, HTML, WebVTT, DocTags и lossless JSON
- Поддержка OCR через несколько встроенных движков
- Создан для LangChain, LlamaIndex, CrewAI, Haystack и похожих экосистем
- Быстро растущее сообщество
Цена: Полностью бесплатно, open source.
Лучше всего подходит для: Разработчиков, создающих LLM/RAG-приложения и которым нужно преобразовать PDF в структурированный Markdown, готовый для AI.
Плюсы: Чистый Markdown-вывод; OCR через интеграцию; создан для современных AI-workflow; активная разработка.
Минусы: Нужен код; в первую очередь ориентирован на разработчиков; GUI и экспортные возможности менее отполированы по сравнению с SaaS-инструментами.
12. Parsio
 Parsio — это гибридный SaaS-парсер, который сочетает шаблоны, OCR, AI parsing и GPT-парсинг. По духу он находится между Parseur и Docparser: гибче, чем чисто зональные решения, но всё же оптимизирован для повторяющегося приёма документов.
Ключевые возможности:
- Встроенный OCR
- AI-помощь в определении полей
- Интеграции с Google Sheets, webhooks, API, Zapier, Make, n8n, Pabbly
Цена: Sandbox на 30 credits. Starter — $41/месяц за 1,000 credits; Growth — $124/месяц; Business — $249/месяц. Один разобранный документ или PDF-страница может стоить 1, 2 или 5 credits в зависимости от режима парсинга, поэтому нормализованная оценка для Starter-тарифа составляет примерно $41–$205 за 1,000 страниц.
Лучше всего подходит для: Небольших и средних команд, которые обрабатывают повторяющиеся типы документов (счета, чеки) и хотят no-code SaaS-решение с лёгким AI.
Плюсы: Встроенный OCR; широкое покрытие типов документов; широкий стек автоматизации.
Минусы: Мало подробных сторонних отзывов; стоимость менее прозрачна между режимами парсинга; не настолько отчётливо выделяется, как Parseur или Nanonets.
Сравнение качества извлечения таблиц: как лучшие PDF scraper’ы справляются с реальными таблицами
Извлечение таблиц — это самый обсуждаемый источник боли среди пользователей PDF scraper’ов, и это неудивительно. Недавние бенчмарки, такие как OmniDocBench (1,651 страниц, 10 типов документов) и академические работы по извлечению гетерогенных таблиц, подтверждают, что «извлечение таблиц» — это не одна задача. Это целый спектр.
Простые таблицы (чёткие границы, одна страница)
С ними большинство инструментов справляется нормально. Tabula, Camelot, pdfplumber, Thunderbit и AWS Textract здесь показывают хорошие результаты. Если в ваших PDF только простые таблицы с границами, почти любой инструмент из списка подойдёт.
Таблицы без границ и с выравниванием по пробелам
Вот тут различия становятся очевидными. Без линий-разделителей rule-based парсеры с трудом определяют границы столбцов. Режим stream у Camelot и тонкая настройка параметров в pdfplumber сильны для разработчиков, которые могут подстроить настройки. AI-инструменты вроде Thunderbit, Nanonets и AWS Textract визуально интерпретируют макет, а это обычно лучше работает для нетехнических пользователей, которые имеют дело с непоследовательными форматами.
Многостраничные таблицы, переходящие на следующую страницу
Очень частый сценарий отказа. Шаблонные инструменты и простые экстракторы часто считают каждую страницу отдельной таблицей, если только workflow специально не соединяет их обратно. AI-first инструменты здесь в выигрыше, потому что могут интерпретировать непрерывность семантически, а не только геометрически — хотя идеальным в этой категории не стоит считать ни одного вендора.
Объединённые ячейки и вложенные заголовки
Самый сложный сценарий. Статья EMNLP 2024 по извлечению информации из гетерогенных таблиц сообщает, что F1 колеблется от 74.2 до 96.1 в зависимости от метода и сценария. AI-инструменты (Thunderbit, Nanonets, AWS Textract) обычно превосходят rule-based парсеры в таких случаях, потому что интерпретируют макет семантически, а не полагаются только на линии-разделители.
OCR в сравнении: какие PDF scraper’ы работают со сканированными документами?
OCR — это граница между инструментами, которые справляются с реальными бизнес-PDF, и инструментами, которые умеют работать только с идеальными машинно-сгенерированными документами. Вот матрица:
| Инструмент | Нативный OCR | Поддержка сканов | Многоязычный OCR | Поддержка рукописного текста |
|---|---|---|---|---|
| Thunderbit | ✅ Встроенный | ✅ Да | ✅ 34 языка | ⚠️ Ограниченно |
| Adobe Acrobat | ✅ Встроенный | ✅ Да | ✅ Сильная | ⚠️ Ограниченно |
| AWS Textract | ✅ Встроенный | ✅ Да | ✅ Несколько основных языков | ✅ Ближе всего, но неидеально |
| Nanonets | ✅ Встроенный | ✅ Да | ✅ 40+ языков | ⚠️ Ограниченно |
| Parseur | ✅ Встроенный | ✅ Да | ✅ 60+ языков | ❌ Нет |
| Parsio | ✅ Встроенный | ✅ Да | ✅ Многоязычный | ⚠️ Ограниченно |
| Docparser | ✅ Встроенный | ✅ Да | ✅ Да | ⚠️ Ограниченно |
| Docling | ✅ Через интеграцию | ✅ Да | Зависит от движка | ⚠️ Ограниченно |
| Tabula | ❌ Нет | ❌ Нет | N/A | N/A |
| PyMuPDF | ❌ Нет (Tesseract опционально) | ❌ Нужна доп. интеграция | Зависит от движка | Зависит от движка |
| Camelot | ❌ Нет | ❌ Нет | N/A | N/A |
| pdfplumber | ❌ Нет | ❌ Нет | N/A | N/A |
Ни один инструмент не умеет стабильно и надёжно работать с рукописным текстом во всех случаях в 2026 году. AWS Textract — ближайший enterprise-API к этому уровню, но к рукописному тексту всё равно стоит относиться осторожно. Если ваши PDF сканированные, но напечатанные, вам подойдёт любой инструмент с встроенным OCR. Если они рукописные, ожидания должны быть реалистичными.
AI-powered vs rule-based vs template-based: три поколения PDF scraping
Проще всего понять рынок PDF scraper’ов в 2026 году как три поколения:
Поколение 1: rule-based (Tabula, Camelot, pdfplumber)
Они лучше всего работают со структурированными текстовыми PDF и постоянным макетом. Для разработчиков это мощные инструменты, но при изменении макета становятся хрупкими. Если документы предсказуемы, они по-прежнему отличны — и бесплатны.
Поколение 2: template-based (Parseur, Docparser, Parsio)
Пользователь задаёт зоны или поля для каждого типа документа. Отлично подходит для повторяющихся форматов, например счетов от одного и того же поставщика. Но есть нюанс: каждый новый макет или даже небольшое изменение макета требует настройки или обслуживания.
Поколение 3: AI/LLM-powered (Thunderbit, Nanonets, AWS Textract, Docling для LLM-пайплайнов)
AI семантически читает документ, адаптируется к новым макетам без шаблонов и может одновременно размечать и преобразовывать данные. Именно туда движется рынок. Оценка IDP от Everest Group за 2025 год и мультимодальные исследования таблиц ACL 2025 оба указывают на LLM- и agent-based extraction как на следующий стандарт.
Для нетехнических пользователей это практично: если PDF приходят из множества разных источников (поставщики, партнёры, клиенты), template-based инструменты превращаются в постоянную поддержку. AI-инструменты справляются с разнообразием сразу из коробки. Именно под такую задачу и был создан Thunderbit — для бизнес-пользователей, у которых много разных PDF и совсем нет желания писать Python или поддерживать шаблоны извлечения.
AI PDF scraping для разных макетов Один шаблон не обязан подходить каждому поставщику — AI сам читает документ и определяет его структуру. Get Started Free
Разбор цены: сколько на самом деле стоят лучшие PDF scraper’ы
Это сравнение обычно никто не публикует, хотя именно его пользователи спрашивают чаще всего. Вот честная картина:
| Инструмент | Бесплатный тариф | Стартовая цена | Оценка стоимости за 1,000 страниц | Open source? |
|---|---|---|---|---|
| Thunderbit | ✅ Бесплатные кредиты | ~$15/мес ($9/мес при годовой оплате) | ~$18–$30 | Нет |
| Tabula | ✅ Без ограничений | Бесплатно навсегда | $0 | Да |
| Camelot | ✅ Без ограничений | Бесплатно навсегда | $0 | Да |
| PyMuPDF | ✅ Без ограничений | Бесплатно навсегда | $0 | Да |
| pdfplumber | ✅ Без ограничений | Бесплатно навсегда | $0 | Да |
| Docling | ✅ Без ограничений | Бесплатно навсегда | $0 | Да |
| Parseur | ⚠️ ~20 страниц/мес | ~$39/мес | ~$390 (нижний тариф) | Нет |
| Nanonets | ⚠️ Кредиты при регистрации | По модели usage-based | ~$300–$380 | Нет |
| Docparser | ⚠️ 14-дневный trial | $39/мес | ~$78–$390 | Нет |
| Parsio | ⚠️ 30 credits | $41/мес | ~$41–$205 | Нет |
| Adobe Acrobat | ❌ (экспорт платный) | Pro $19.99/мес | Не считается по страницам | Нет |
| AWS Textract | ⚠️ 1,000 страниц/мес (3 месяца) | Pay-per-use | $1.50–$65 | Нет |
Скрытый компромисс по стоимости важнее, чем ценник на сайте. Open-source Python-инструменты бесплатны в долларах, но требуют времени разработчика на настройку, поддержку и отладку. Template SaaS-инструменты просты при небольшом разнообразии, но становятся дорогими, когда макеты начинают меняться. AI-инструменты без кода вроде Thunderbit стоят кредитов за строку, но резко сокращают время настройки. Cloud API вроде AWS Textract — самые дешёвые на масштабе, но только если у вас уже выстроена инженерная инфраструктура.
Когда я думаю о «реальной стоимости», я обязательно учитываю зарплату человека, который выполняет работу. Один час времени аналитика данных, потраченный на настройку шаблонов или написание Python-кода, не бывает бесплатным, даже если сам софт ничего не стоит.
Какой PDF scraper выбрать?
Вот короткое руководство по выбору:
| Ваша ситуация | Рекомендуемый инструмент(ы) |
|---|---|
| Не технический пользователь, разные макеты PDF, нужен быстрый результат | Thunderbit, Nanonets |
| Повторяющиеся счета/чеки в одном формате | Parseur, Docparser, Parsio |
| Разработчик, строящий data pipeline | PyMuPDF, Camelot, pdfplumber |
| Enterprise, 10,000+ документов в месяц, нужен API | AWS Textract, Nanonets |
| Создаёте LLM/RAG-приложение | Docling |
| Редкий PDF-to-Excel, уже есть Adobe | Adobe Acrobat |
| Бесплатно, локально, только таблицы, без кода | Tabula |
Если вы бизнес-пользователь и вам нужно просто достать данные из PDF без кода и без шаблонов, начните с Thunderbit. Он заново читает каждый PDF с помощью AI и экспортирует данные в инструменты, которыми вы уже пользуетесь. Если документы повторяются в узнаваемых макетах, лучше подойдут Parseur или Docparser. А если вам нужен инженерный контроль, open-source стек по-прежнему остаётся минимальной планкой по стоимости.
Итоги
PDF scraping в 2026 году — это уже не одна задача с одним ответом. Правильный инструмент зависит от того, кто вы — разработчик, бизнес-аналитик или enterprise-команда — и от того, ваши PDF аккуратные текстовые файлы или хаотичные сканы от десятка поставщиков.
Если хотите посмотреть, как AI-извлечение данных из PDF работает на практике, попробуйте бесплатный тариф Thunderbit. Думаю, вас удивит, сколько данных можно вытащить из PDF всего за несколько кликов. А если Thunderbit не идеально подходит, попробуйте несколько других инструментов из этого списка. Сейчас как никогда легко перестать копировать данные из PDF вручную и начать реально использовать то, что в них уже есть.
Чтобы узнать больше о извлечении данных и автоматизации, посмотрите наши руководства: как извлекать данные с веб-сайтов в Excel, лучшие инструменты для извлечения данных, AI-извлечение данных для бизнеса и как конвертировать изображения в Excel. Также вы можете посмотреть пошаговые разборы на Thunderbit YouTube Channel.
Попробуйте Thunderbit бесплатно Таблицы, OCR и отчёты со смешанными форматами за один проход. Бесплатного плана достаточно, чтобы проверить, подходит ли он для ваших документов. Get Started Free
FAQs
1. Какой PDF scraper лучший и бесплатный?
Для пользователей без кода Tabula — самый простой полностью бесплатный GUI-инструмент для текстовых PDF-таблиц. Для разработчиков хорошими бесплатными вариантами будут Camelot, pdfplumber, PyMuPDF и Docling. Если нужен no-code вариант с бесплатным тарифом, Thunderbit — лучший старт.
2. Могут ли PDF scraper’ы работать со сканированными документами?
Только инструменты со встроенным OCR могут напрямую работать со сканированными PDF. К ним относятся Thunderbit, Adobe Acrobat, AWS Textract, Nanonets, Parseur, Docparser, Parsio и Docling (с интегрированными OCR-движками). Tabula, Camelot и pdfplumber сами по себе не умеют работать со сканами — их нужно сочетать с внешним OCR вроде Tesseract.
3. Насколько точным бывает извлечение таблиц из PDF?
Это сильно зависит от сложности таблицы. С простыми таблицами с границами большинство инструментов справляется хорошо. Таблицы без границ, с объединёнными ячейками и многостраничные таблицы — значительно сложнее. AI-инструменты вроде Thunderbit, Nanonets и AWS Textract обычно превосходят rule-based парсеры на разнообразных макетах, тогда как rule-based инструменты всё ещё могут быть отличны на стабильных текстовых PDF.
4. Нужны ли навыки программирования, чтобы извлекать данные из PDF?
Нет. Thunderbit, Parseur, Docparser, Parsio, Nanonets и Adobe Acrobat можно использовать без кода. У Tabula тоже есть GUI. Python-библиотеки вроде PyMuPDF, Camelot, pdfplumber и Docling требуют кода.
5. Можно ли напрямую экспортировать данные из PDF в Excel или Google Sheets?
Большинство инструментов поддерживают экспорт хотя бы в CSV или Excel. Thunderbit также бесплатно экспортирует прямо в Google Sheets, Airtable и Notion. Parseur, Docparser и Parsio поддерживают экспорт в бизнес-workflow через интеграции вроде Zapier, webhooks и API.
Попробуйте AI PDF scraping с Thunderbit Get Started Free
Узнать больше



