
Thunderbit to rozszerzenie Chrome typu AI Web Scraper, które pomaga użytkownikom biznesowym wyciągać dane ze stron internetowych z pomocą AI. Sedno sprawy jest proste: to, co na stronie cenowej ScrapingBee wygląda zachęcająco, w praktyce może wyglądać zupełnie inaczej, gdy odpalisz produkcyjne obciążenie i zobaczysz, jak kredyty znikają w tempie od 5× do 75× względem stawki bazowej. Ta recenzja omawia pięć obszarów, które większość artykułów pomija: rzeczywisty koszt przy dużej skali, ekstrakcję opartą na selektorach kontra AI, wygodę dla osób nietechnicznych, proces pracy z danymi po scrapingu oraz benchmarki niezawodności na 2026 rok. Jeśli oceniasz ScrapingBee dla swojego zespołu — jako programista, osoba odpowiedzialna za sales ops czy founder — to właśnie ten przegląd pomoże Ci podjąć decyzję.
Czym jest ScrapingBee? Krótki przegląd
ScrapingBee to API do web scrapingu, które ogarnia rotację proxy, renderowanie JavaScript i rozwiązywanie CAPTCHA, dzięki czemu programiści mogą pobierać dane ze stron bez stawiania własnej infrastruktury do scrapingu. Wysyłasz żądanie HTTP z parametrami i dostajesz w odpowiedzi HTML (albo w niektórych endpointach JSON). Nie ma tu wizualnego interfejsu ani narzędzia typu kliknij-i-wybierz do budowania scraperów.
Najważniejsze możliwości obejmują:
- Rotacyjne i premium proxy (classic, premium, stealth, residential)
- Renderowanie w przeglądarce headless (pełny Chrome, domyślnie włączony)
- Automatyczne obchodzenie CAPTCHA
- Google Search API (ustrukturyzowany JSON: wyniki organiczne, reklamy, mapy, knowledge graph, People Also Ask, obrazy, wiadomości)
- Zrzuty ekranu (standardowe, pełnostronicowe lub wskazane selektorem CSS)
- Targetowanie geograficzne przez parametr country_code
- Reguły ekstrakcji CSS/XPath (deklaratywne, oparte na JSON, zwracają ustrukturyzowany JSON)
- Dedykowane API do scrapingu Amazon, Walmart, YouTube i ChatGPT
- Ekstrakcja AI (dodana ok. 2024–2025): ai_query, ai_extract_rules, ai_selector (+5 kredytów za każde żądanie)
- Narzędzie CLI (uruchomione ok. 2025–2026): przetwarzanie wsadowe, crawling, parsowanie sitemap, wzbogacanie CSV, zaplanowane zadania cron, eskalacja proxy
Założone w 2019 roku we Francji, ScrapingBee urosło do około $5 milionów ARR na początku 2026 roku, zdobywając ponad 2 500 klientów (SAP, Zapier, Deloitte, Zillow) — wszystko bez finansowania zewnętrznego i z zespołem liczącym 4–6 osób. W czerwcu 2025 Oxylabs Group przejęło ScrapingBee w transakcji ośmiocyfrowej. Marka i kierownictwo pozostały niezależne, a zespół wsparcia ponad dwukrotnie się powiększył dla lepszego pokrycia stref czasowych.
Ważna uwaga: ScrapingBee nadal nie ma natywnego wizualnego kreatora, interfejsu typu point-and-click ani wbudowanego harmonogramu w panelu webowym. Planowanie zadań wymaga narzędzia CLI, cron jobs albo automatyzacji zewnętrznej (Zapier, Make, n8n). Publikowane przez nich materiały „no-code” dotyczą integracji z Make i Zapier — nie natywnego interfejsu bez kodowania.
Dla kogo naprawdę zbudowano ScrapingBee?
ScrapingBee jest projektowane dla programistów, którzy swobodnie piszą w Pythonie lub cURL, czytają HTML i tworzą selektory CSS/XPath. Dokumentacja jest mocno techniczna, z naciskiem na przykłady w Pythonie i cURL. Jeden z recenzentów na Capterra zauważył, że „nie udostępniają przykładów w JavaScript”, a inny opisał dokumentację jako „ciężką, zajmuje od jednego dnia do tygodnia, żeby ją przeczytać”.
Ale odbiorcy szukający w 2026 roku hasła „ScrapingBee review” są szersi niż tylko inżynierowie backendu. To także managerowie marketingu budujący listy leadów, zespoły sales ops wzbogacające dane w CRM, działy ecommerce monitorujące ceny konkurencji i founderzy oceniający narzędzia dla swoich zespołów. W każdej sekcji poniżej zaznaczę, czy dana funkcja lub ograniczenie ma znaczenie dla developerów, użytkowników biznesowych, czy obu grup.
Plany cenowe ScrapingBee w skrócie
Oto aktualne plany ScrapingBee (stan na kwiecień 2026):
| Plan | Cena miesięczna | Kredyty API/miesiąc | Jednoczesne żądania |
|---|---|---|---|
| Freelance | $49 | 250 000 | 10 |
| Startup | $99 | 1 000 000 | 50 |
| Business | $249 | 3 000 000 | 100 |
| Business+ | $599 | 8 000 000 | 200 |
| Enterprise | Kontakt ze sprzedażą | 41M+ | Niestandardowe |
Rozliczenie roczne daje 17% rabatu. Darmowy okres próbny zapewnia 1 000 kredytów API bez podawania karty. Google Search API zostało niedawno obniżone z 25 do 15 kredytów za wywołanie po przejęciu.
Na pierwszy rzut oka te liczby wyglądają hojnie. Ale nie mówią całej prawdy.
Tabela mnożników kredytów
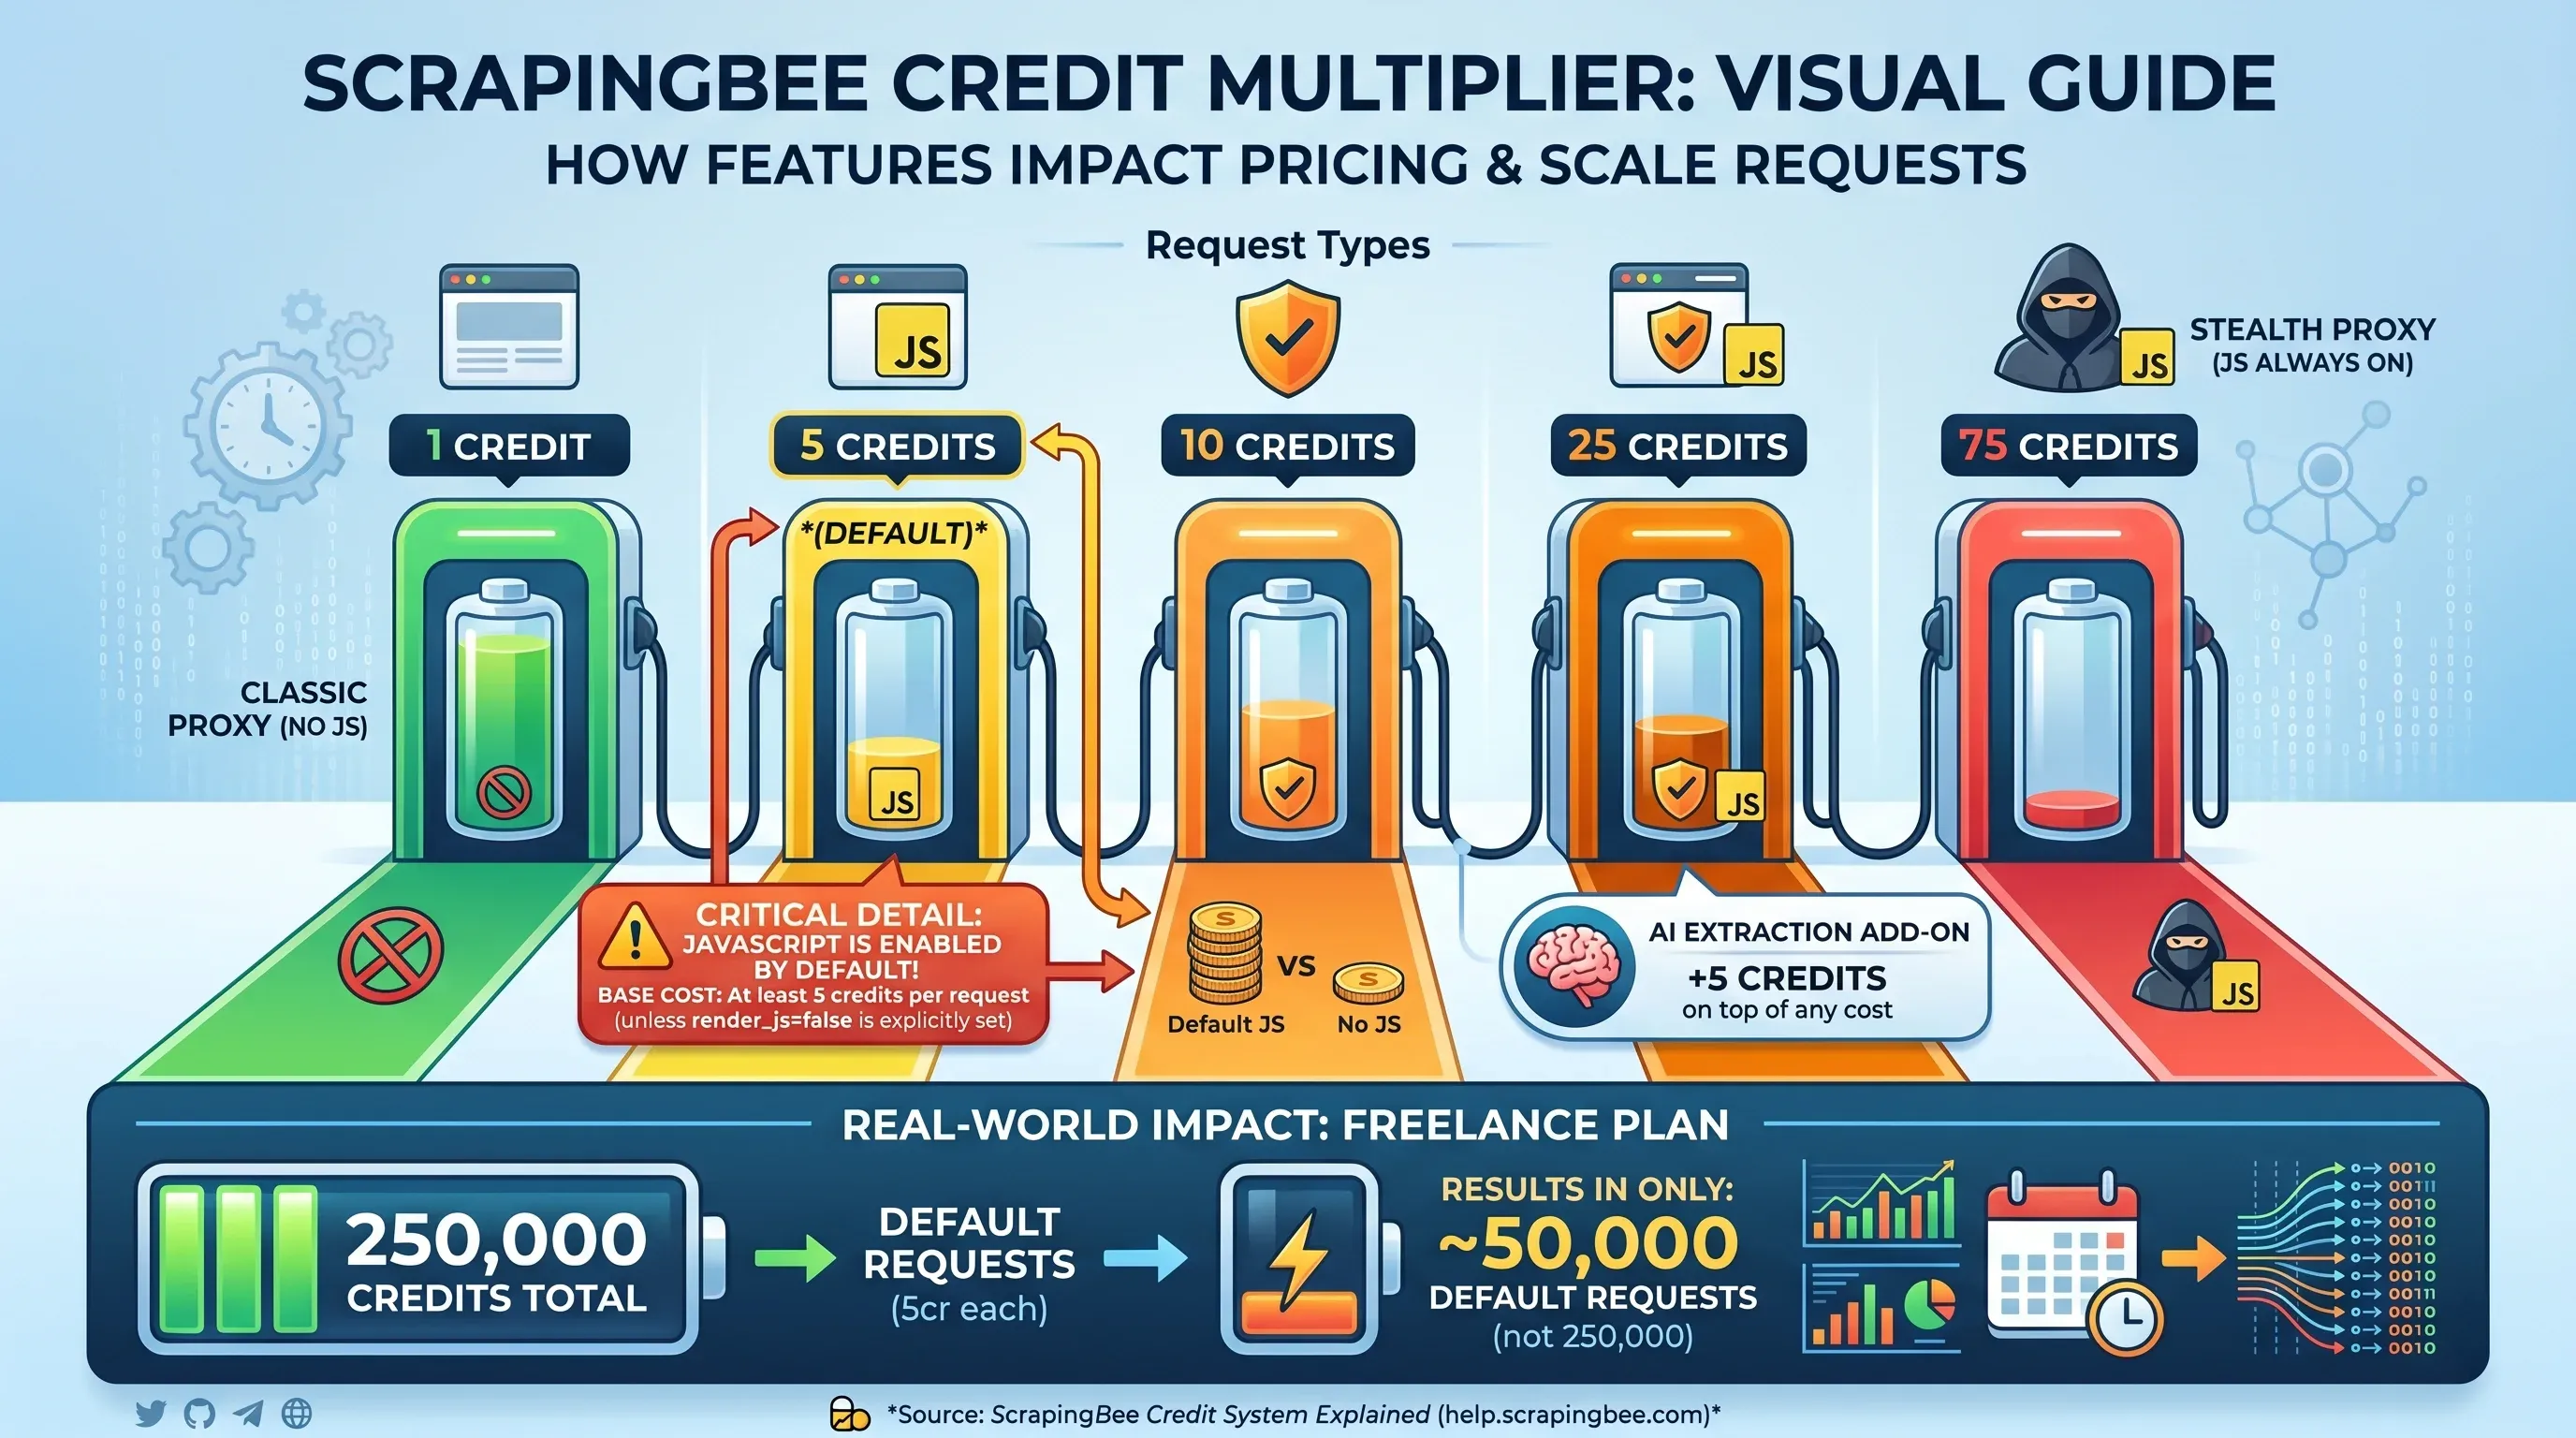
I tu właśnie cenowa logika ScrapingBee robi się bardziej skomplikowana. Liczba kredytów widoczna w planie nie oznacza liczby stron, które możesz pobrać — wszystko zależy od funkcji włączonych w danym żądaniu:
| Typ żądania | Kredyty za żądanie |
|---|---|
Classic proxy, bez renderowania JS (render_js=false) | 1 kredyt |
| Classic proxy, renderowanie JS (domyślnie) | 5 kredytów |
| Premium proxy, bez renderowania JS | 10 kredytów |
| Premium proxy, renderowanie JS | 25 kredytów |
| Stealth proxy (JS zawsze włączony) | 75 kredytów |
| Dodatek AI extraction | +5 kredytów ponad podstawę |
Kluczowy szczegół: renderowanie JavaScript jest włączone domyślnie. Jeśli nie ustawisz explicite render_js=false, każde żądanie kosztuje co najmniej 5 kredytów. To oznacza, że plan Freelance z 250 000 kredytów obejmuje w praktyce tylko 50 000 domyślnych żądań — a nie 250 000.
Ukryta matematyka kredytów, której nikt nie pokazuje
Oto, ile ScrapingBee naprawdę kosztuje przy 10 000 stron w różnych scenariuszach i planach:
| Scenariusz | Potrzebne kredyty | Freelance ($49/250K) | Startup ($99/1M) | Business ($249/3M) |
|---|---|---|---|---|
| 10K stron (statyczny HTML, 1 cr) | 10 000 | ✅ Pokryte ($0,20/1K) | ✅ Pokryte ($0,10/1K) | ✅ Pokryte ($0,08/1K) |
| 10K stron (JS render, 5 cr) | 50 000 | ✅ Pokryte ($0,98/1K) | ✅ Pokryte ($0,50/1K) | ✅ Pokryte ($0,42/1K) |
| 10K stron (premium proxy + JS, 25 cr) | 250 000 | ⚠️ Dokładnie na limicie ($4,90/1K) | ✅ Pokryte ($2,48/1K) | ✅ Pokryte ($2,08/1K) |
| 10K stron (stealth proxy, 75 cr) | 750 000 | ❌ Znacznie ponad limit | ✅ Ledwo pokryte ($7,43/1K) | ✅ Pokryte ($6,23/1K) |
Te same 10 000 stron mogą kosztować od $0,20 do $7,43 za tysiąc — w zależności od proxy i konfiguracji renderowania. I nie zawsze wiesz, jakiej konfiguracji potrzebujesz, dopóki nie przetestujesz.
Scenariusz budżetowy: generowanie leadów przy 10 000 stron/miesiąc
Zespół sprzedaży scrapujący 10 000 stron firm miesięcznie na potrzeby lead generation. Większość nowoczesnych witryn B2B używa Reacta lub Vue, więc wymagane jest renderowanie JS:
- Potrzebne kredyty: 50 000 (10K × 5 kredytów)
- Plan Freelance ($49): Wystarcza, zostaje 200K kredytów zapasu
- Ale jeśli cele wymagają premium proxy: 250 000 kredytów — dokładnie cały limit jednego planu Freelance, bez bufora
- Jeśli potrzebne są stealth proxy: 750 000 kredytów — wymagany plan Startup za $99/miesiąc
Scenariusz budżetowy: monitorowanie cen ecommerce przy 100 000 stron/miesiąc
Zespół ecommerce monitorujący 100 000 kart produktów na stronach konkurencji:
| Konfiguracja | Potrzebne kredyty | Wymagany plan | Koszt miesięczny |
|---|---|---|---|
| Statyczny HTML (1 cr) | 100 000 | Freelance | $49 |
| Renderowanie JS (5 cr) | 500 000 | Startup | $99 |
| Premium proxy + JS (25 cr) | 2 500 000 | Business | $249 |
| Stealth proxy (75 cr) | 7 500 000 | Business+ | $599 |
To samo zadanie kosztuje od 49 do 599 dolarów miesięcznie. To nie jest drobna różnica — to 12-krotna rozbieżność kosztów wynikająca z konfiguracji.
„Cena wejścia 49 dolarów to najbardziej myląca liczba na rynku scraping API.” — Prospeo
„Kredyty zużywają się bardzo szybko przy renderowaniu JavaScript lub użyciu zaawansowanych funkcji, co utrudnia uzasadnienie kosztów mniejszym projektom lub zespołom z trudną do przewidzenia skalą scrapingu.” — Nick S, Manager, Computer Software, Capterra
Niewykorzystane kredyty nie przechodzą na kolejny miesiąc.
Jak koszty ScrapingBee wypadają na tle konkurencji
Dla uczciwego porównania używamy planów ze średniego segmentu:
| Scenariusz (na 1K stron) | ScrapingBee ($99/1M) | ScraperAPI ($149/1M) | Scrapfly ($100/1M) |
|---|---|---|---|
| Statyczny HTML | $0,10 | $0,15 | $0,10 |
| Strony renderowane JS | $0,50 | $1,64 | $0,60 |
| Premium + JS | $2,48 | $3,73 | $3,00 |
| Stealth/ultra premium + JS | $7,43 | $11,18 | N/A |
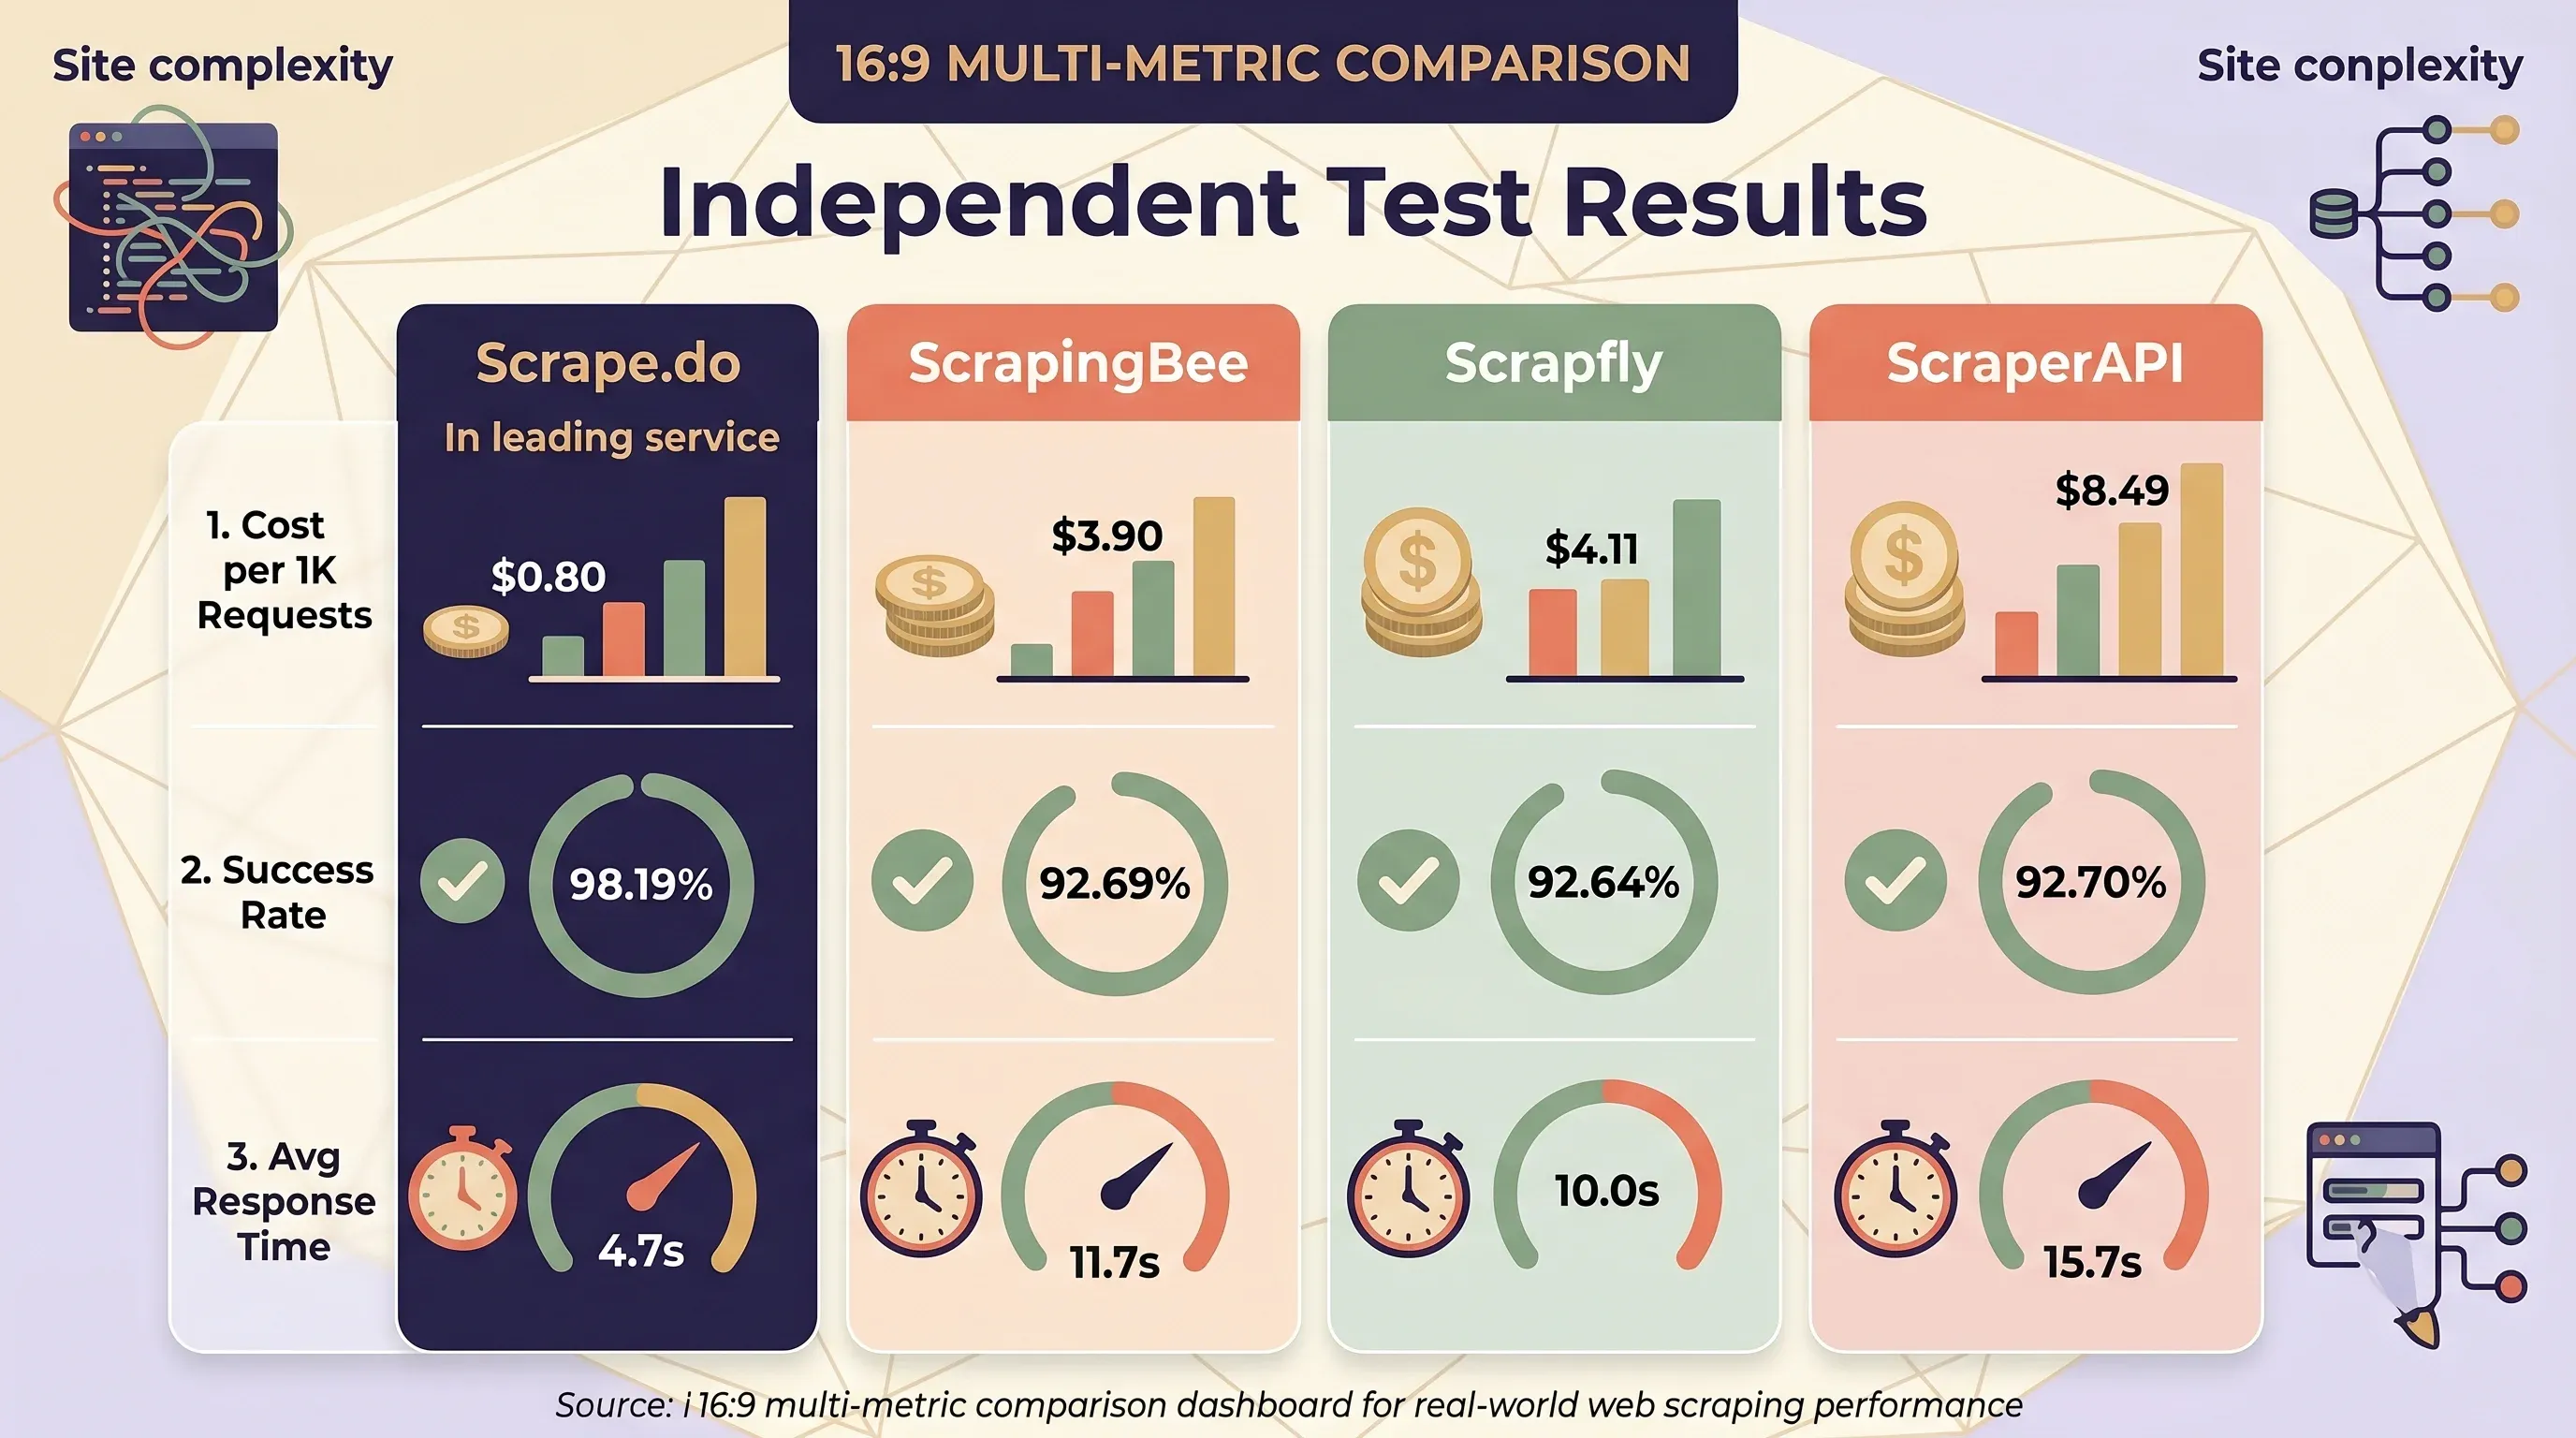
ScrapingBee jest zazwyczaj najtańsze albo współdzieli pierwsze miejsce przy stronach statycznych i renderowanych przez JS. ScraperAPI jest konsekwentnie najdroższe — jego renderowanie JS kosztuje +10 kredytów, podczas gdy ScrapingBee i Scrapfly liczą +5. Jednak niezależne testy Scrape.do pokazują inny obraz, gdy uwzględni się rzeczywistą złożoność stron:
| Usługa | Średni koszt za 1K żądań | Skuteczność | Średni czas odpowiedzi |
|---|---|---|---|
| Scrape.do | $0,80 | 98,19% | 4,7 s |
| ScrapingBee | $3,90 | 92,69% | 11,7 s |
| Scrapfly | $4,11 | — | — |
| ZenRows | $4,48 | 92,64% | 10,0 s |
| ScraperAPI | $8,49 | 92,70% | 15,7 s |
Model kredytowy Thunderbit: inne podejście
Thunderbit korzysta ze znacznie prostszego modelu cenowego: 1 kredyt = 1 wiersz wyjściowy, bez mnożników za renderowanie JS, typ proxy czy domenę docelową. Scraping podstron kosztuje 2 kredyty za wiersz.
| Plan | Cena miesięczna | Kredyty | Koszt za wiersz |
|---|---|---|---|
| Free | $0 | 6 stron/miesiąc | Bezpłatnie |
| Starter | $15 | 500 | $0,030 |
| Pro 1 | $38 | 3 000 | $0,013 |
| Pro 2 | $75 | 6 000 | $0,013 |
| Pro 3 | $125 | 10 000 | $0,013 |
| Pro 4 | $249 | 20 000 | $0,012 |
Użytkownik Thunderbit scrapujący 10 000 list produktów z mocno JS-owych serwisów ecommerce płaci $125/miesiąc niezależnie od tego, czy strony wymagają renderowania JavaScript, premium proxy czy obejścia antybota. W ScrapingBee to samo zadanie może kosztować od $49 do $599, zależnie od konfiguracji. Przewidywalność budżetu naprawdę ma znaczenie.
Selektory CSS kontra ekstrakcja AI: koszt utrzymania, który musisz znać
Większość recenzji ScrapingBee całkowicie pomija ten temat. A to prawdopodobnie najważniejsza rzecz dla każdego, kto planuje scrapować na dużą skalę przez miesiące albo lata.
ScrapingBee używa selektorów CSS/XPath do ekstrakcji danych z HTML. Definiujesz reguły ekstrakcji jako obiekty JSON z selektorami CSS, a ScrapingBee zwraca pasujące dane. Na początku to działa dobrze. Problem zaczyna się później.
Problem psujących się selektorów
Gdy strona docelowa zmienia układ — klasy CSS, strukturę DOM, wersję frameworka — selektory przestają działać. W dojrzałych systemach scrapujących działających na ponad 2 500 aktywnych zadaniach badania pokazują 1–2% tygodniowy wskaźnik awarii, co oznacza 30–35 poprawek tygodniowo tylko po to, by ekstraktory nadal działały. Dla organizacji scrapujących 50 serwisów roczny nakład na utrzymanie wynosi 850–1 300 godzin, czyli $64 000–$156 000 przy pełnym koszcie inżyniera.
Zespoły regularnie to zaniżają. Początkowe szacunki zwykle mówią o 10–15 godzinach utrzymania miesięcznie, ale rzeczywistość jest 4–6× większa (40–90 godzin/miesiąc). Jedna cicha awaria — gdy selektor się psuje, ale nadal zwraca puste dane bez alarmu — kosztuje szacunkowo $38 000–$57 000 utraconej sprzedaży, czasu na odzyskiwanie pozycji i pracy zespołu.
Najczęstsze przyczyny: zmiana nazw klas CSS przy aktualizacji frameworka, dodanie nowych kontenerów wokół docelowych elementów, aktualizacje React/Vue/Angular przebudowujące DOM, testy A/B z dynamicznymi nazwami klas oraz obfuskacja antyscrapingowa.
Ekstrakcja oparta na AI obniża koszty utrzymania o 60–80%
Badanie DataRobot z 2025 roku wykazało, że scraperom opartym na AI potrzeba 70% mniej utrzymania niż tradycyjnym scraperom opartym na selektorach po redesignie strony. Proporcja czasu de facto się odwraca:
| Metryka | Tradycyjne (selektory CSS) | AI-powered |
|---|---|---|
| Utrzymanie po redesignie | Poziom bazowy | 70% mniej |
| Podział czasu (wdrożenie : utrzymanie) | 20% : 80% | 5% : 95% przy użyciu danych |
| Ogólna redukcja utrzymania | Poziom bazowy | 60–80% mniej |
| Prędkość na stronach ciężkich JS | Poziom bazowy | 30–40% szybciej |
Czas konfiguracji: pisanie selektorów kontra pola sugerowane przez AI
Konfiguracja ScrapingBee: sprawdź kod źródłowy strony → znajdź selektory CSS → zapisz reguły ekstrakcji jako JSON → testuj i debuguj → obsłuż przypadki brzegowe dla wariantów stron → monitoruj awarie → poprawiaj uszkodzone selektory po aktualizacjach serwisu.
Konfiguracja Thunderbit: otwórz stronę w Chrome → kliknij „AI Suggest Fields” → AI czyta stronę i proponuje kolumny z odpowiednimi typami danych → kliknij „Scrape”. Bez pisania selektorów, bez zaglądania do kodu źródłowego. AI Thunderbit działa na kilku modelach bazowych (ChatGPT, Gemini, Claude, DeepSeek R1), które wizualnie czytają strony jak człowiek.
Dodatkową warstwę dają Field AI Prompts: każda kolumna może mieć własną instrukcję AI, która przekształca dane już podczas ekstrakcji — formatowanie dat, tłumaczenie tekstu, kategoryzowanie produktów, dzielenie imion i nazwisk, normalizacja numerów telefonów. To eliminuje osobny etap postprocessingu, który użytkownicy ScrapingBee muszą budować samodzielnie.
Dane wyjściowe: surowy HTML kontra gotowe wiersze
| Wymiar | ScrapingBee (oparte na selektorach) | Thunderbit (AI-powered) |
|---|---|---|
| Domyślny format wyjścia | Surowy HTML | Ustrukturyzowane wiersze z typowanymi kolumnami |
| Ekstrakcja strukturalna | Wymaga reguł CSS/XPath lub dodatku AI (+5 kredytów) | AI automatycznie wykrywa pola |
| Obsługiwane typy danych | Tekst (wymaga parsowania HTML) | Tekst, liczba, data, URL, e-mail, telefon, obraz |
| Odporność na zmiany układu | ⚠️ Wymaga ręcznej aktualizacji selektorów | ✅ AI odczytuje stronę od nowa przy każdym uruchomieniu |
| Wymagane umiejętności techniczne | Python/cURL, selektory CSS, znajomość HTML | Brak — rozszerzenie Chrome z 2-krokowym procesem |
| Utrzymanie w czasie | Ciągłe (1–2% tygodniowego breakage rate) | Minimalne (AI dostosowuje się automatycznie) |
ScrapingBee dodało funkcje AI extraction (ai_query, ai_extract_rules), które częściowo rozwiązują problem utrzymania selektorów. Ale podnoszą one koszt o +5 kredytów za każde żądanie ponad bazową stawkę, a narzędzie nadal pozostaje przede wszystkim API-first, bez wizualnego interfejsu.
ScrapingBee dla osób nietechnicznych: uczciwy test użyteczności
ScrapingBee nie jest stworzone dla użytkowników nietechnicznych. To API. Używa się go przez kod. Jeśli jesteś managerem marketingu albo osobą odpowiedzialną za sales ops i czytasz ten tekst, to właściwie już jest odpowiedź.
Oto, co naprawdę oznacza korzystanie ze ScrapingBee dla osoby nietechnicznej:
- Zapisanie wywołania API w Pythonie, cURL albo innym języku
- Zrozumienie parametrów HTTP takich jak
render_js=true,premium_proxy=true,country_code=us - Parsowanie surowych odpowiedzi HTML za pomocą biblioteki takiej jak BeautifulSoup
- Pisanie selektorów CSS do wyciągania konkretnych pól danych
- Obsługa paginacji przez własną logikę crawlingu (ScrapingBee obsługuje tylko pojedyncze żądania do stron)
- Budowa pipeline’u danych do czyszczenia, strukturyzowania i przechowywania pobranych informacji
Nie ma tu kreatora drag-and-drop. Nie ma interfejsu point-and-click. Nie ma wizualnego podglądu tego, co scrapujesz.
„Jest pewna krzywa uczenia się. A dokumentacja jest ciężka, przeczytanie jej zajmuje od jednego dnia do tygodnia.” — Arvind K, właściciel, usługi finansowe, Capterra
„Ich system jest bardzo specyficzny i zajmuje trochę czasu, żeby nauczyć się ich kodów i struktury.” — recenzja Capterra
Programiści to lubią. Jeden z recenzentów nazwał to rozwiązanie „w całości oparte na API: bardzo nowoczesne i eleganckie: po prostu działa”. Ale „łatwość użycia” dla programisty oceniającego API to zupełnie co innego niż „łatwość użycia” dla kogoś, kto chce zbudować listę leadów bez pisania kodu.
Kiedy alternatywa no-code ma więcej sensu
Thunderbit Chrome Extension oferuje zupełnie inne doświadczenie:
- Otwórz stronę w Chrome z zainstalowanym rozszerzeniem
- Kliknij „AI Suggest Fields” — AI analizuje stronę i proponuje kolumny (nazwa produktu, cena, ocena, URL itd.) z odpowiednimi typami danych
- Sprawdź i dostosuj — dodaj, usuń albo zmień nazwy kolumn; dodaj Field AI Prompts do transformacji
- Kliknij „Scrape” — dane zostają wyciągnięte do ustrukturyzowanych wierszy
- Eksportuj — jednym kliknięciem do Google Sheets, Airtable, Notion, Excel, CSV lub JSON (wszystkie eksporty są darmowe)
Bez wywołań API, bez selektorów, bez kodu. Thunderbit obsługuje 55 języków na kwiecień 2026.
Dla popularnych serwisów Thunderbit oferuje też natychmiastowe szablony scraperów — gotowe, utrzymywane szablony dla Amazon, Zillow, Shopify, LinkedIn, Google Maps, Instagram, eBay, Apollo i innych. Nie musisz nawet czekać, aż AI zaproponuje pola; szablon jest gotowy od razu.
Dodatkowo Thunderbit zawiera kilka narzędzi zawsze darmowych, które nie wymagają żadnego planu: email extractor, phone number extractor i image extractor — przydatne dla zespołów sprzedaży i marketingu, które potrzebują szybkiego pobierania danych.
Ramy decyzyjne: kto powinien używać czego
| Jeśli jesteś… | Najlepszy wybór |
|---|---|
| Programistą swobodnie pracującym z API i parsowaniem HTML | ScrapingBee lub ScraperAPI |
| Użytkownikiem technicznym, który chce ustrukturyzowanych danych bez ręcznego tworzenia selektorów | Thunderbit API (endpoint Extract) |
| Użytkownikiem biznesowym (sprzedaż, marketing, ecommerce ops) bez umiejętności kodowania | Thunderbit Chrome Extension |
| Zespołem potrzebującym zaplanowanego monitoringu bez DevOps | Thunderbit Scheduled Scraper (planowanie językiem naturalnym) |
| Budujesz pipeline LLM/RAG i potrzebujesz czystego Markdown | Thunderbit Distill API lub Firecrawl |
| Liczy się dla Ciebie przewidywalny budżet i brak mnożników kredytów | Thunderbit (1 kredyt = 1 wiersz) |
Po scrapingu: dokąd właściwie trafiają dane?
Scraping to tylko połowa pracy. Druga połowa — doprowadzenie tych danych do miejsca, gdzie da się je wykorzystać — to etap, o którym większość recenzji ScrapingBee milczy.
ScrapingBee: wychodzi surowy HTML, pipeline budujesz sam
ScrapingBee domyślnie zwraca surowy HTML. Potem trzeba:
- Sparsować HTML za pomocą BeautifulSoup albo lxml
- Usunąć nawigację, stopki, skrypty i style (które stanowią 80–90% treści typowej strony)
- Wyodrębnić konkretne pola danych
- Przekształcić wszystko do ustrukturyzowanych formatów
- Obsłużyć paginację i stany błędów
- Przechowywać i dystrybuować dane
„ScrapingBee zwraca surowy HTML. Agenci AI potrzebują czystego Markdown, semantycznego wyszukiwania i webhooków.” — KnowledgeSDK
ScrapingBee oferuje też opcjonalnie return_page_markdown=true i return_page_text=true, a Google Search API zwraca ustrukturyzowany JSON. Ale domyślny workflow — i ogólne doświadczenie scrapingu — opiera się na surowym HTML, który musisz przetworzyć samodzielnie.
Zazwyczaj potrzebne są dodatkowe narzędzia: BeautifulSoup/lxml do parsowania, Pandas do czyszczenia danych, cron/Airflow do harmonogramów, własna logika crawlingu do wielu stron oraz oddzielna chmura do przechowywania danych. To bardzo dużo inżynierii pomiędzy „pobrałem dane” a „mogę ich użyć”.
Thunderbit: ustrukturyzowane dane z wbudowanym eksportem
Thunderbit zwraca ustrukturyzowane wiersze z określonymi typami danych (tekst, liczba, data, URL, e-mail, telefon, obraz), gotowe do eksportu. Wszystkie eksporty są darmowe we wszystkich planach:
| Miejsce eksportu | Koszt |
|---|---|
| Excel (.xlsx) | Darmowy |
| Google Sheets | Darmowy (integracja bezpośrednia) |
| Airtable | Darmowy (integracja bezpośrednia) |
| Notion | Darmowy (integracja bezpośrednia) |
| CSV | Darmowy |
| JSON | Darmowy |
Dla zespołów, które już używają Google Sheets albo Airtable jako CRM lub centrum operacyjnego, eliminuje to całą warstwę inżynierii. Podczas eksportu do Notion lub Airtable obrazy są przesyłane do biblioteki obrazów, dzięki czemu użytkownicy mogą widzieć je inline — drobny detal, który w praktyce ma duże znaczenie.
Ekosystem integracji ScrapingBee
ScrapingBee oferuje integracje zewnętrzne: Zapier (ponad 8 000 aplikacji), Make (ponad 3 000 aplikacji), n8n i Microsoft Power Automate. Mogą one połączyć surowy HTML z docelowymi narzędziami — ale dodają koszt, złożoność i kolejny punkt awarii.
Dla programistów: Open API Thunderbit
Dla czytelników, którzy chcą budować pipeline’y programistycznie, Thunderbit oferuje Open API z dwoma kluczowymi endpointami:
- Endpoint Distill — zamienia strony na czysty Markdown, idealny do pipeline’ów LLM/RAG (1 kredyt za wywołanie)
- Endpoint Extract — zwraca ustrukturyzowany JSON zgodny ze schematem zdefiniowanym przez użytkownika (20 kredytów za wywołanie)
- Przetwarzanie wsadowe — do 100 URL-i na żądanie
To oznacza, że Thunderbit obsługuje zarówno użytkowników no-code (Chrome Extension), jak i programistów (Open API) na tym samym silniku AI. Nie pytaj tylko „czy to potrafi scrapować” — zapytaj „dokąd trafiają dane?”.
Test niezawodności 2026: czy ScrapingBee daje radę w produkcji?
Starsze wątki na Reddicie (2021–2023) zawierają skargi na niezawodność ScrapingBee. Czy nadal odzwierciedlają rzeczywistość w 2026? Zebrałem dane z sześciu niezależnych benchmarków. Wyniki są mieszane — i czasem sprzeczne.
Dwutygodniowy benchmark Scrapeway (kwiecień 2026)
Łącznie: 33,3% skuteczności — 7. miejsce na 9 testowanych usług.
| Strona | Skuteczność |
|---|---|
| Amazon | 48% |
| 41% | |
| Indeed | 38% |
| Etsy | 21% |
| Booking | 17% |
| Realtor | 0% |
| StockX | 0% |
| Twitter/X | 0% |
| Zillow | 0% |
| Walmart | 0% |
| 0% |
Test porównawczy Scrapingdog (2025)
| Strona | ScrapingBee | Scrapingdog | ScraperAPI |
|---|---|---|---|
| Amazon | 100% | 100% | 100% |
| Glassdoor | 0% | 100% | 100% |
| eBay | 100% | 100% | 100% |
| Walmart | 40% | 100% | 100% |
| 90% | 100% | 80% |
Benchmark Proxyway (grudzień 2025)
- 84,47% skuteczności przy 2 żądaniach/s
- 72,98% skuteczności przy 10 żądaniach/s — spadek o 12 punktów pod obciążeniem
- 25,46 s średniego czasu odpowiedzi — najwolniej w grupie benchmarkowej
Benchmark Scrape.do (2025–2026)
- 92,69% ogólnej skuteczności
- Mocne wyniki na pojedynczych stronach: Amazon 99,11%, Indeed 99,29%, GitHub 100%, X/Twitter 99,6%
- Słabe wyniki na Capterra: tylko 59% skuteczności przy 36-sekundowych czasach odpowiedzi
Wzorzec
Dane pokazują wyraźny schemat:
- ScrapingBee dobrze radzi sobie na popularnych, umiarkowanie chronionych stronach — Amazon, eBay, GitHub i Indeed konsekwentnie pokazują 90–100% skuteczności
- ScrapingBee całkowicie zawodzi na mocno chronionych stronach — konsekwentne 0% na LinkedIn, Zillow, Realtor.com, StockX i Twitterze w wielu benchmarkach
- Wydajność mocno spada pod obciążeniem — 84% przy 2 req/s spada do 73% przy 10 req/s
- Wyniki benchmarków bardzo się różnią w zależności od metodologii — od 33,3% (Scrapeway, szeroki miks stron) do 92,69% (Scrape.do, umiarkowane cele)
Ocena 4,9/5 na Capterra (137 recenzji) jest pozytywnym sygnałem, ale wysokie noty za łatwość początkowej konfiguracji nie zawsze odzwierciedlają długoterminową niezawodność w produkcji na dużą skalę. Użytkownicy, którzy odchodzą od narzędzia, często wskazują rosnący wskaźnik błędów i rosnące koszty — nie trudność pierwszej konfiguracji.
„Bardzo pozytywnie. ScrapingBee było stabilne, przewidywalne i łatwe do wdrożenia w produkcji.” — Zweryfikowany recenzent, CEO, Capterra
ScrapingBee wykazywało „niespójną niezawodność”, w szczególności osiągając „0% skuteczności na Glassdoor” i „40% na Walmart”.
Jak AI-powered scraping inaczej podchodzi do niezawodności
AI Thunderbit odczytuje wyrenderowaną stronę w czasie rzeczywistym, dostosowując się do zabezpieczeń antybotowych i zmian układu przy każdej sesji. Dwa tryby scrapingu rozwiązują różne problemy z niezawodnością:
- Cloud scraping — działa na serwerach Thunderbit, obsługuje do 50 stron jednocześnie, najlepszy do dużych publicznych zadań na stronach takich jak Amazon, Zillow czy Shopify
- Browser scraping — działa lokalnie w przeglądarce Chrome użytkownika, korzystając z jego własnej zalogowanej sesji — idealny do stron po zalogowaniu (LinkedIn, prywatne dashboardy, platformy SaaS), do których narzędzia API jak ScrapingBee nie mają dostępu za uwierzytelnieniem
Thunderbit oferuje też natychmiastowe szablony scraperów dla popularnych stron, które są gotowe od razu i stale utrzymywane, dzięki czemu działają nawet wtedy, gdy serwis zmienia strukturę. W przypadku stron, na których ScrapingBee pokazuje 0% skuteczności (LinkedIn, Zillow), tryb browser scraping Thunderbit — z użyciem własnej zalogowanej sesji — to zupełnie inne podejście.
ScrapingBee vs. najlepsze alternatywy: porównanie obok siebie
| Wymiar | ScrapingBee | Thunderbit | ScraperAPI | Scrapfly |
|---|---|---|---|---|
| Typ | Tylko API | Rozszerzenie Chrome + API | Tylko API | Tylko API |
| Cena startowa | $49/mies. | Free ($0) | $49/mies. | $30/mies. |
| Model kredytów | Mnożniki (1×–75×) | 1 kredyt = 1 wiersz (bez mnożników) | Mnożniki (1×–75×) | Mnożniki (1×–30×) |
| Ekstrakcja AI | Tak (+5 kredytów/żądanie) | Wbudowana (AI Suggest Fields) | Brak natywnej AI | Tak |
| Opcja no-code | Nie (tylko API) | Tak (Chrome Extension) | Nie (tylko API) | Nie (tylko API) |
| Ustrukturyzowane wyjście | Wymaga reguł CSS albo dodatku AI | Domyślnie (typowane kolumny) | Ustrukturyzowane endpointy dla konkretnych stron | Zależnie od przypadku |
| Miejsca eksportu | Surowy HTML/JSON (budujesz sam) | Excel, Sheets, Airtable, Notion, CSV, JSON (wszystko darmowe) | Surowy HTML/JSON | Surowy HTML/JSON |
| Scraping podstron | Ręczny (piszesz logikę crawl) | Wbudowany (2 kredyty/wiersz) | Ręczny | Ręczny |
| Planowany scraping | Tylko CLI (bez scheduler dashboard) | Wbudowany (język naturalny) | Brak wbudowanego | Brak wbudowanego |
| Darmowy tier | 1 000 kredytów trial | 6 stron/miesiąc (na zawsze) | 5 000 kredytów (7-dniowy trial) | 1 000 kredytów |
| Domyślne renderowanie JS | WŁ. (5× koszt) | Wliczone (bez dodatkowego kosztu) | WYŁ. | WYŁ. |
| Krzywa uczenia się | Wysoka (API + selektory) | Niska (proces 2 kliknięć) | Wysoka (API + selektory) | Wysoka (API) |
| Najlepsze dla | Developerów chcących kontrolować proxy | Użytkowników biznesowych i developerów | Developerów + endpointów strukturalnych | Developerów chcących obejść antyboty |
| Ocena Capterra | 4,9/5 (137 recenzji) | — | 4,6/5 (62 recenzje) | 4,9/5 (221 recenzji) |
ScrapingBee vs. Thunderbit: najważniejsze różnice
Największe różnice sprowadzają się do architektury i odbiorców:
- Tylko API vs. Chrome Extension + API: ScrapingBee wymaga kodu przy każdej interakcji. Thunderbit oferuje Chrome Extension dla użytkowników no-code oraz Open API dla developerów — ten sam silnik AI, dwa interfejsy.
- Ekstrakcja oparta na selektorach vs. AI-powered: ScrapingBee wymaga pisania i utrzymywania selektorów CSS/XPath. AI Thunderbit automatycznie proponuje pola i dostosowuje się przy zmianach stron.
- Surowy HTML vs. ustrukturyzowane wiersze z darmowym eksportem: ScrapingBee zwraca HTML, który trzeba parsować. Thunderbit zwraca typowane, opisane wiersze, które można wyeksportować do Excel, Google Sheets, Airtable lub Notion jednym kliknięciem.
- Scraping podstron: AI Thunderbit odwiedza każdą stronę szczegółową i wzbogaca główną tabelę — wbudowane, bez własnej logiki crawl. ScrapingBee wymaga napisania tej logiki samodzielnie.
- Natychmiastowe szablony: Thunderbit ma gotowe szablony dla popularnych stron (Amazon, Zillow, Shopify, LinkedIn, Google Maps, eBay), które działają od razu. ScrapingBee ma dedykowane API dla Amazon i Walmart, ale nadal trzeba napisać kod, by z nich korzystać.
Inne warte uwagi alternatywy
- Scrape.do — najniższy niezależnie zmierzony koszt: $0,80/1K żądań przy 98,19% skuteczności; od $29/mies.
- Apify — platforma oparta na actorach z 415+ recenzjami G2 (4,7/5), ale „Pricing Issues” to najczęstsza skarga
- Firecrawl — natywny dla AI/LLM, zwraca markdown z 67% mniejszą liczbą tokenów niż surowy HTML; open-source core; od $16/mies.
- Bright Data — klasa enterprise z ponad 72M IP, od $499/mies.; ceny ryczałtowe
- ZenRows — 55M residential IP, gotowe scrapery dla Amazon/Walmart/Zillow, od $69/mies.
Które narzędzie do scrapingu będzie najlepsze dla Twojego zespołu?
Rekomendacje zależne od scenariusza:
- Jeśli jesteś developerem i budujesz własny pipeline scrapingowy z granularną kontrolą proxy → ScrapingBee lub ScraperAPI. Dostaniesz precyzyjne parametry HTTP, wybór typu proxy i pełną kontrolę nad renderowaniem. Tylko uwzględnij mnożniki kredytów w budżecie.
- Jeśli jesteś zespołem sprzedaży albo marketingu i potrzebujesz leadów ze stron bez pisania kodu → Thunderbit Chrome Extension. Dwa kliknięcia do ustrukturyzowanych danych, jedno kliknięcie do Google Sheets. Bez API, bez selektorów, bez parsowania.
- Jeśli potrzebujesz szybko ustrukturyzowanych danych z popularnych stron → Thunderbit Instant Templates. Amazon, Zillow, Shopify, LinkedIn — gotowe i utrzymywane, bez konfiguracji AI.
- Jeśli chcesz monitorować ceny lub stany magazynowe według harmonogramu bez DevOps → Thunderbit Scheduled Scraper. Opisz interwał prostym językiem („w każdy poniedziałek o 9:00”) i uruchom.
- Jeśli budujesz pipeline LLM/RAG i potrzebujesz czystego Markdown na dużą skalę → Thunderbit Distill API lub Firecrawl. Oba zwracają markdown zoptymalizowany pod AI.
- Jeśli liczy się przewidywalność kosztów i nie chcesz mnożników kredytów → Thunderbit. 1 kredyt = 1 wiersz, niezależnie od renderowania JS czy typu proxy.
Całkowity koszt posiadania to nie tylko cena API. To czas konfiguracji + godziny utrzymania + inżynieria parsowania + workflow eksportu danych. Cennik ScrapingBee wygląda konkurencyjnie; pełny obraz kosztów już nie.
Kluczowe wnioski z tej recenzji ScrapingBee
Pięć rzeczy, które warto zapamiętać:
- Koszty kredytów rosną bardzo szybko wraz ze skalą. Cena wejścia $49 może zamienić się w $599+ gdy potrzebne są renderowanie JS i premium proxy. Model Thunderbit 1 kredyt = 1 wiersz eliminuje tę nieprzewidywalność.
- Selektory CSS generują stały koszt utrzymania, którego AI extraction unika. Przy narzędziach AI można spodziewać się 60–80% mniej utrzymania i braku problemów z selektorami po zmianach stron.
- Osoby nietechniczne mają z ScrapingBee stromą krzywą uczenia się. To narzędzie API-only, wymagające kodowania, analizy HTML i budowy selektorów. Użytkownicy biznesowi powinni rozważyć alternatywy no-code.
- Eksport danych wymaga własnej inżynierii. ScrapingBee zwraca surowy HTML; pipeline tworzysz samodzielnie. Thunderbit eksportuje ustrukturyzowane dane do Excel, Sheets, Airtable i Notion za darmo.
- Niezawodność jest dobra dla części stron, ale niespójna dla innych. ScrapingBee działa dobrze na Amazon i eBay, ale pokazuje 0% na LinkedIn, Zillow i kilku innych mocno chronionych serwisach.
ScrapingBee pozostaje solidnym narzędziem dla developerów, którzy chcą kontrolowanego przez proxy dostępu HTTP z granularną kontrolą. Ale krajobraz web scrapingu w 2026 roku przesunął się w stronę narzędzi AI i no-code — a Thunderbit został zaprojektowany właśnie pod tę zmianę. Wypróbuj darmowy tier (6 stron gratis lub więcej w ramach darmowego triala), żeby samemu zobaczyć różnicę.
FAQ
Czy ScrapingBee jest warte uwagi w 2026 roku?
To zależy od Twoich umiejętności technicznych i skali. Dla programistów scrapujących statyczne strony przy umiarkowanym wolumenie ScrapingBee oferuje solidne, dobrze udokumentowane API z responsywnym wsparciem i oceną 4,9/5 na Capterra. Dla użytkowników biznesowych, scrapingu o dużej skali lub zespołów, które chcą ustrukturyzowanych danych bez kodowania, alternatywy AI takie jak Thunderbit oferują lepszą wartość i znacznie niższy całkowity koszt posiadania.
Czy ScrapingBee działa bez kodowania?
Nie. ScrapingBee to narzędzie API-only, które wymaga pisania kodu (Python, cURL lub podobnie) i rozumienia parametrów HTTP. Nie ma wizualnego interfejsu do tworzenia scraperów. Użytkownicy nietechniczni powinni rozważyć opcje no-code, takie jak Thunderbit Chrome Extension, które pozwalają scrapować i eksportować dane bez napisania ani jednej linijki kodu.
Ile naprawdę kosztuje ScrapingBee za stronę?
To zależy od włączonych funkcji. Statyczna strona HTML kosztuje 1 kredyt. Strona renderowana przez JS (domyślnie) kosztuje 5 kredytów. Strona z premium proxy + JS kosztuje 25 kredytów. Strona ze stealth proxy kosztuje 75 kredytów. Ekstrakcja AI dodaje kolejne +5 kredytów. W planie Freelance ($49/250K kredytów) daje to $0,20 za 1 000 stron statycznych albo $14,70 za 1 000 stron ze stealth proxy. Zobacz powyższe szczegółowe tabele kosztów, aby poznać pełny rozkład.
Jakie są najlepsze alternatywy dla ScrapingBee w 2026 roku?
Najlepsze alternatywy to Thunderbit (AI-powered, no-code Chrome Extension + API, 1 kredyt = 1 wiersz), ScraperAPI (API dla developerów z ustrukturyzowanymi endpointami dla konkretnych stron), Scrapfly (API dla developerów z mocnym obejściem antybotów), Scrape.do (najniższy koszt za żądanie w niezależnych testach) oraz Firecrawl (natywny dla AI/LLM, zwraca czysty markdown). Każde narzędzie ma swój optymalny scenariusz — Thunderbit dla użytkowników biznesowych i przewidywalności kosztów, ScraperAPI i Scrapfly dla kontroli proxy przez developerów, Firecrawl dla pipeline’ów LLM.
Czy ScrapingBee potrafi scrapować strony ciężkie od JavaScriptu?
Tak, ale kosztuje to 5× podstawowych kredytów przy rotating proxy albo 25× przy premium proxy. Renderowanie JavaScript jest włączone domyślnie, więc i tak płacisz stawkę 5×, chyba że ręcznie je wyłączysz. Thunderbit obsługuje renderowanie JS automatycznie, bez mnożników kredytów — 1 kredyt za wiersz niezależnie od tego, jak zbudowana jest strona.
Dowiedz się więcej



