Wikipediaのインフォボックス、引用、セクションを抽出するスクレイパー








Wikipedia記事を調査用に整理
記事の基本情報、インフォボックスの値、引用、セクションの文脈を別々のフィールドで保持できます。
Wikipediaデータをワンクリックで抽出
開いたページに合わせて列を提案し、1回の実行で収集まで完了します。必要なら自然な言葉で項目を調整・名称変更してから、再実行できます。
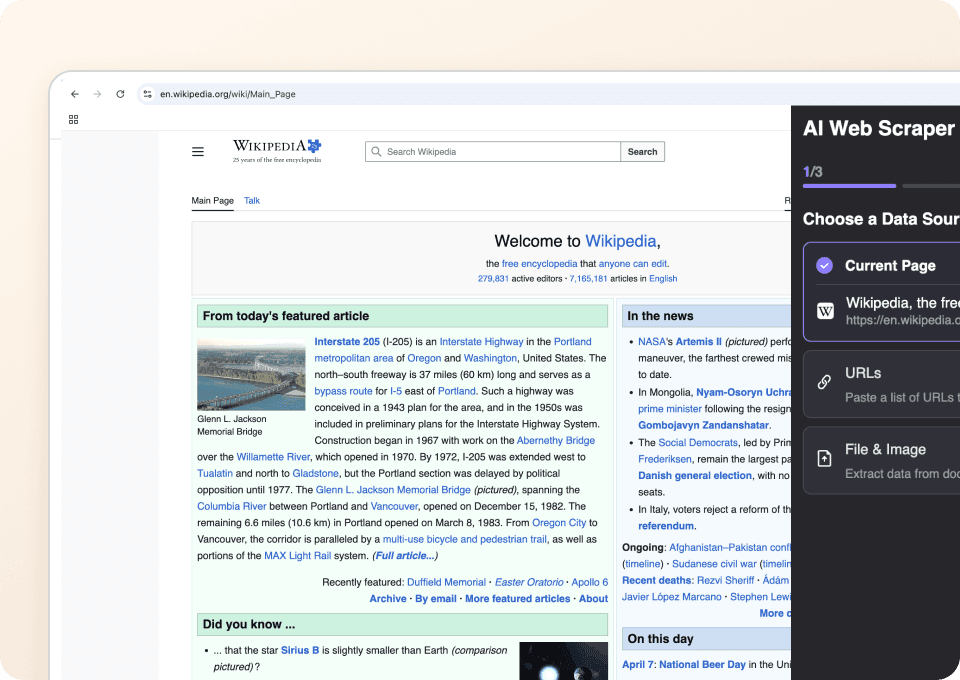
さまざまなWikipediaページ形式に対応
エージェントは、見えているラベル、見出し、セクションタイトルを読み取り、アクセスできるページ上の値を対応付けます。項目が存在しない場合、その列は空欄のままです。
Wikipediaデータをそのままエクスポート
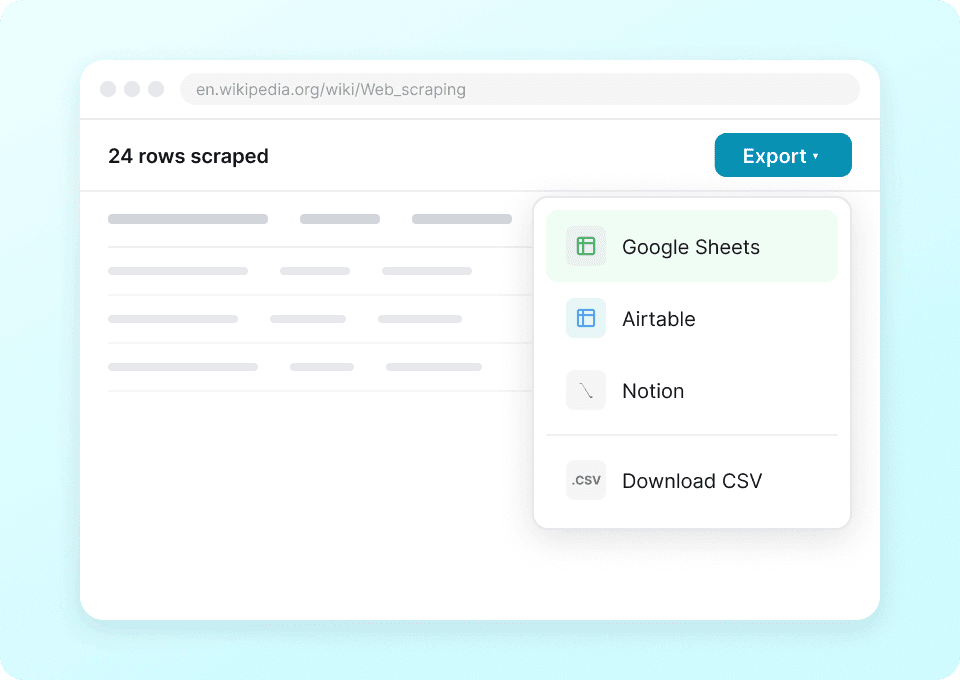
Google Sheets、Excel、Airtable、Notion、またはダウンロードしたCSVへ、そのまま調査を引き継げます。
スクレイパーを作らずにWikipedia調査データを収集
Wikipedia調査のためのセレクタ管理を削減。
手作業またはセレクタベースの設定
ルールの保守にかかる時間Thunderbit AI エージェント
項目提案と1回の実行記事の基本情報、インフォボックス、引用、セクション用の列
表示中のページで確認できる項目だけが列として現れます。
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.



Wikipedia調査の実行に関する質問
Wikipedia の Agent Mode に関する簡潔な回答です。
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Flixster スクレイパー
ThunderbitのFlixsterスクレイパーを使えば、Flixsterの興行収入ランキングや近隣の劇場データを手軽に取得できます。AIによるフィールド提案機能で、映画タイトル、興行収入、評価、公開日、劇場名、所在地、上映中の映画などを素早く収集し、分析やリサーチに活用できます。
詳しく見る ->
olympustaff.com スクレイパー
Thunderbitのolympustaff.com スクレイパーを使えば、olympustaff.comのコミック一覧やコメントからデータを抽出できます。AIによるフィールド提案機能で、コミックのタイトル、著者、発売日、読者のフィードバックなどを素早く収集し、分析やリサーチに活用可能。マーケター、リサーチャー、コンテンツ制作者に最適な、olympustaff.comの構造化データ取得ツールです。
詳しく見る ->
Hatena スクレイパー
Thunderbitのはてなスクレイパーは、AIによるフィールド自動提案機能で、はてなブログやトピックリストからデータを簡単に抽出できます。ブログタイトル、著者名、公開日、記事要約、トレンドトピックなどを収集でき、リサーチやマーケティング、コンテンツ分析に最適です。マーケター、リサーチャー、コンテンツ制作者が、はてなの構造化データを効率よく取得したいときにおすすめです。
詳しく見る ->
namu.wiki スクレイパー
Thunderbitのnamu.wiki スクレイパーを使えば、namu.wikiから必要なページや最新ディスカッションのデータを抽出できます。AIによるフィールド提案機能で、ページタイトル、URL、最終編集日、ディスカッションテーマ、参加者名などを素早く収集でき、リサーチやコンテンツ制作、コミュニティ分析に役立ちます。
詳しく見る ->
NetEase Music スクレイパー
ThunderbitのNetEase Music スクレイパーは、NetEase Musicの検索結果やアーティスト作品ページからデータを抽出できます。AIによるフィールド提案機能で、曲名、アーティスト名、アルバム詳細、再生時間、楽曲URLなどを素早く収集可能。音楽分析やマーケティング、リサーチに最適な、構造化されたNetEase Musicデータを手軽に取得できます。
詳しく見る ->
QQミュージックスクレイパー
ThunderbitのQQ音楽スクレイパーは、QQ音楽の検索結果やアーティストの作品リストからデータを抽出できます。AIによるフィールド提案機能で、曲名やアーティスト名、アルバム情報、リリース日などを素早く収集し、分析やリサーチに活用可能。音楽アナリストやマーケター、音楽ファンに最適な、構造化されたQQ音楽データ取得ツールです。
詳しく見る ->データ抽出を一気に加速する準備はできた?
すでに20万人以上のプロがThunderbitでWebスクレイピング業務を自動化しています。
無料トライアルでは8ページ分の無制限クレジットを利用できます。


