

ThunderbitのPubMedスクレイパーを使えば、PubMedのページをAIで整理された構造化データに変換できます。注目の医学研究、臨床試験のエビデンス、要旨、著者、所属機関、公開日、PMID、論文リンクを抽出し、そのままExcel、Google Sheets、Airtable、Notionへ出力できます。ChromeでPubMedを開き、AIに最適な列を提案させてからスクレイピングするだけです。
🧬 PubMedスクレイパーとは
PubMedスクレイパーは、PubMed | US National Library of Medicine向けに作られたAI Web Scraperです。Thunderbit(AI web scraperのChrome拡張機能)を使えば、PubMedの任意の結果ページに移動してAI Suggest Columnsをクリックし、続けてScrapeを押すだけで、コードを書かずに構造化データを抽出できます。
🔎 PubMedで何がスクレイプできるのか
PubMedには価値の高い生物医学メタデータが豊富にありますが、そのままでは分析しづらいこともあります。ThunderbitのAI Web Scraper(https://thunderbit.com/)を使えば、PubMedの一覧情報を収集・整理できるうえ、**Subpage Scraping**で各論文ページを巡回して、要旨、所属機関、DOIなどの詳細情報も補完できます。
ここでは、数分で実行できる代表的な2つのワークフローを紹介します。
📈 PubMedの注目医学研究を監視する
PubMedのトレンドページで、医学研究の注目動向を追うためのワークフローです。最新情報の把握、社内向けダイジェスト作成、競合論文の追跡、文献モニタリングの仕組みづくりに役立ちます。
移動先ページの例: PubMed Trending
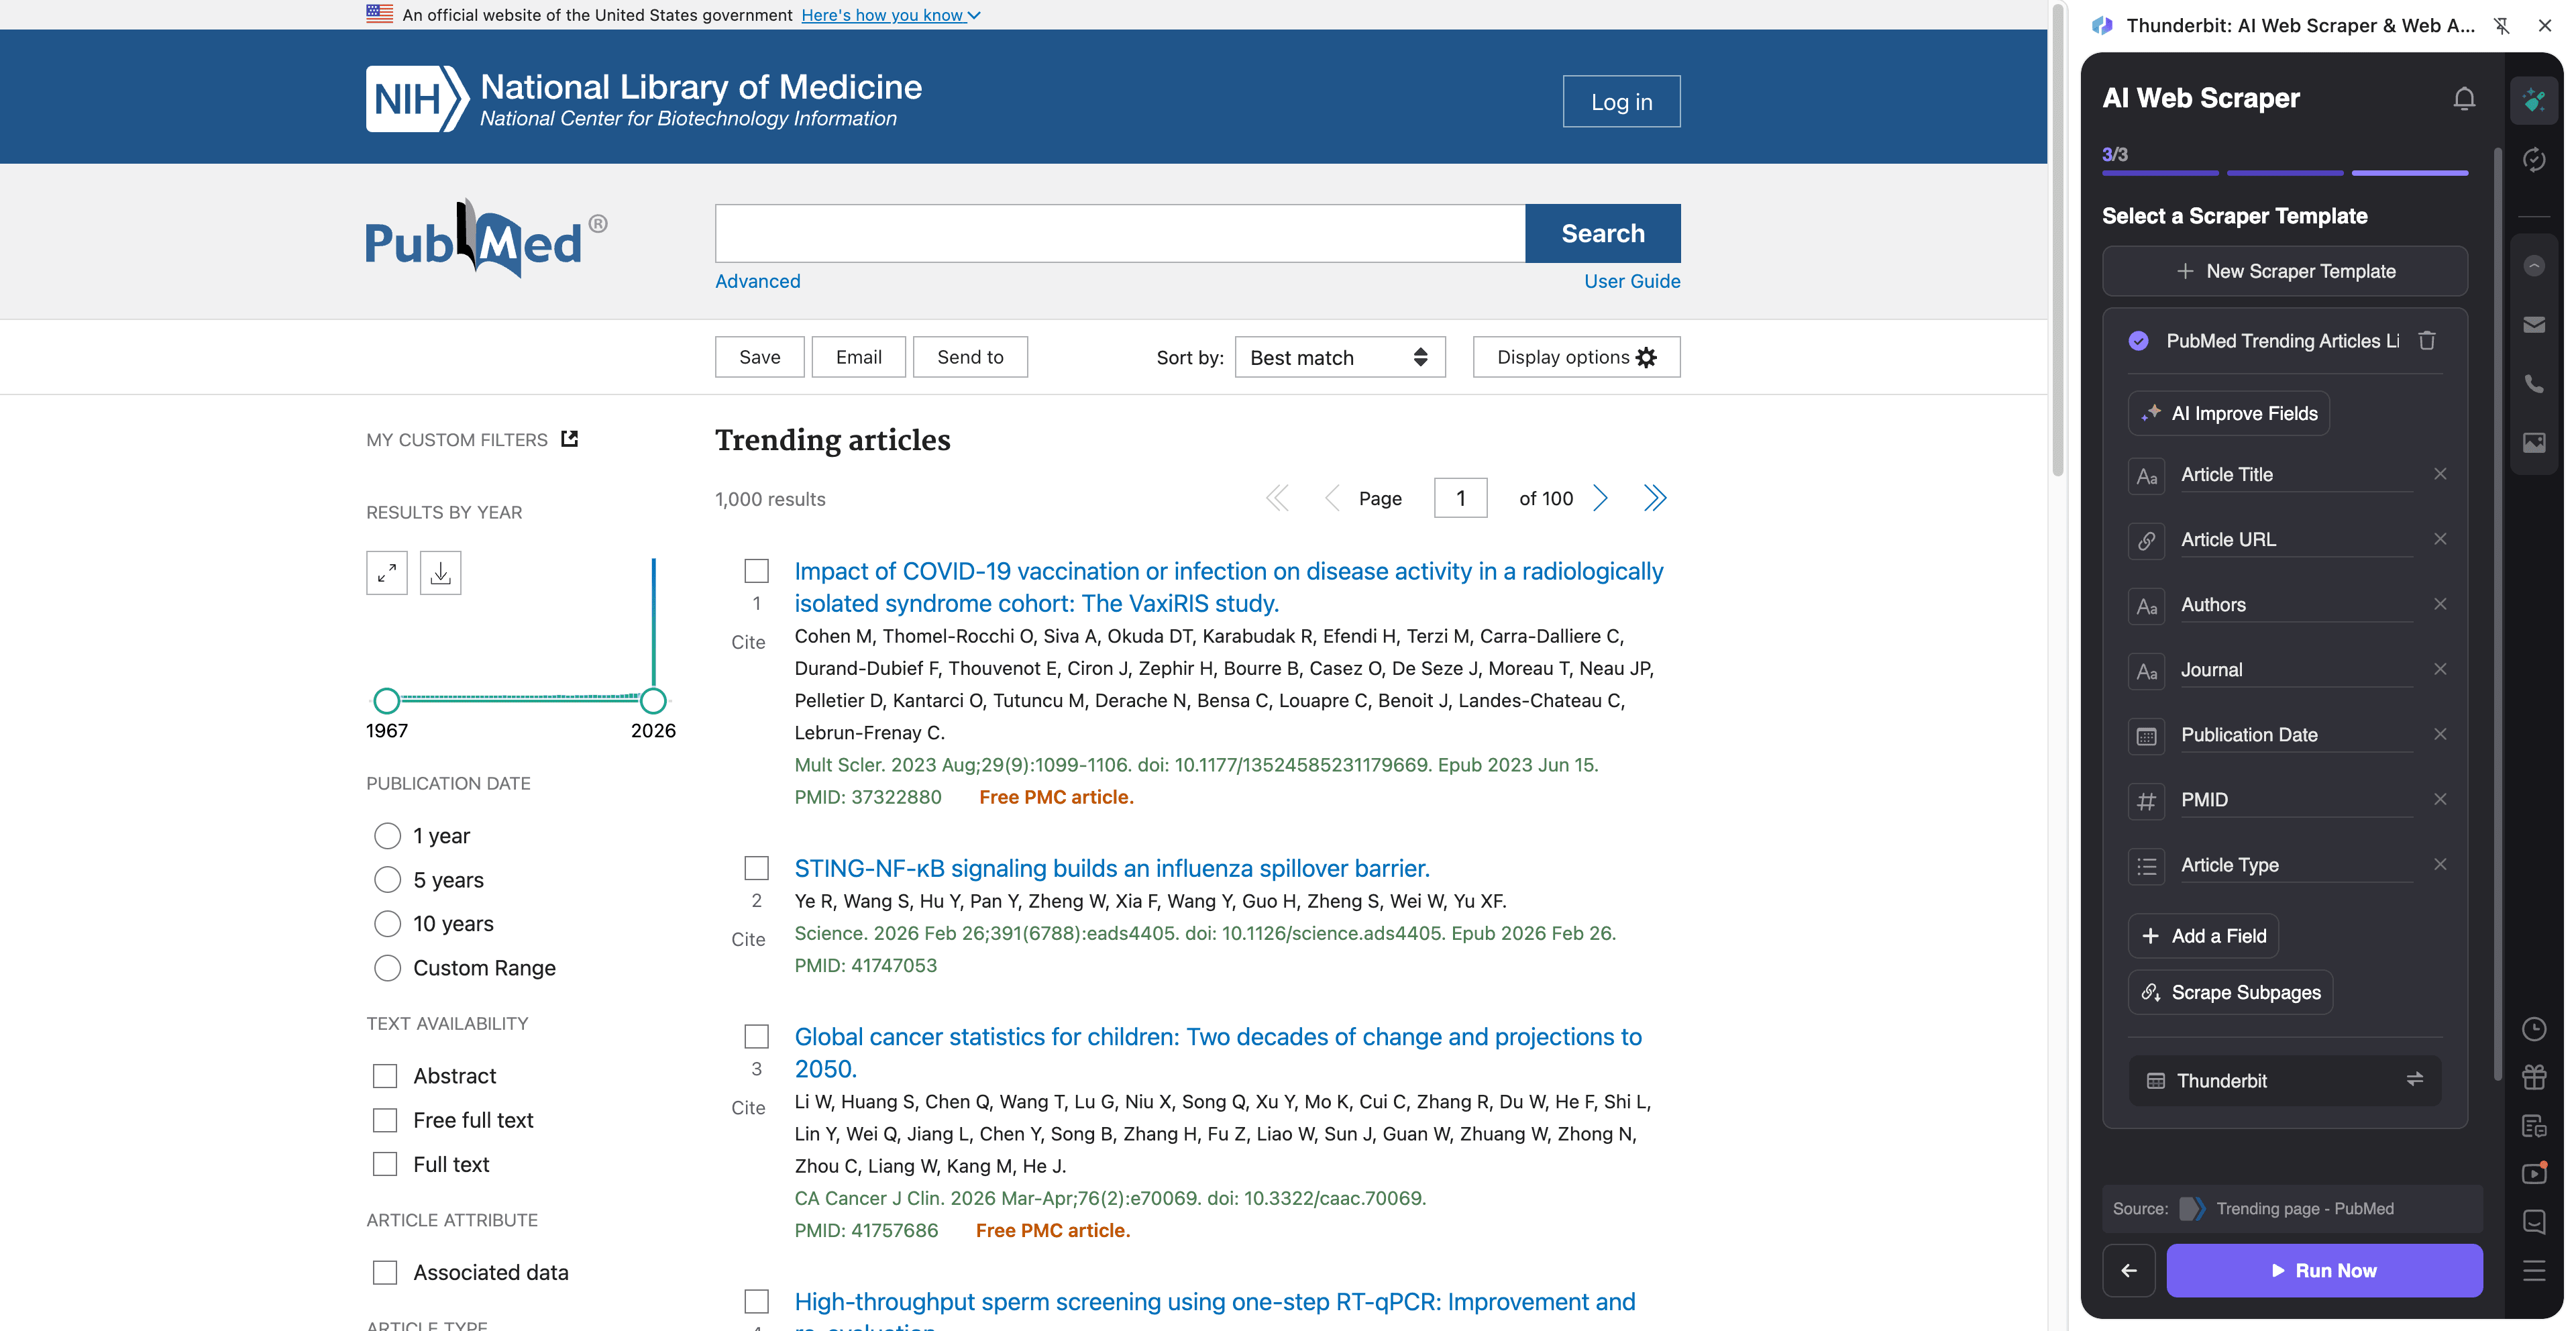
手順:
- Thunderbit Chrome Extensionをダウンロードしてアカウント登録します。
- 例として、PubMed Trendingのような移動先ページを開きます。
- AI Suggest Columnsをクリックして、AIに最適な列名とデータ型を提案させます。
- Scrapeをクリックしてデータを抽出し、Excel、Google Sheets、Airtable、Notionへエクスポートします。
列名
| 列 | 説明 |
|---|---|
| 🧾 論文タイトル | 注目のPubMed論文のタイトル。 |
| 🔗 論文URL | PubMedレコードページへの直接リンク。 |
| 🆔 PMID | レコードのPubMed識別子(安定したキーとして便利)。 |
| 🏛️ ジャーナル | 論文が掲載されている雑誌名。 |
| 📅 公開日 | 一覧に表示される公開日。 |
| ✍️ 著者 | 検索結果カードに表示される著者情報。 |
| 🧪 論文タイプ | 利用可能な場合の出版種別(例: Review、Clinical Trial)。 |
| 🏷️ キーワード / トピック | 一覧に表示されるトピックタグやキーワード(あれば)。 |
| 📝 スニペット / 要約 | 一覧に表示される短い説明文(あれば)。 |
| 🧷 DOI | DOI(通常はサブページスクレイピングで取得するのが最適)。 |
| 🧑🔬 所属機関 | 著者の所属機関情報(通常はサブページスクレイピングで抽出)。 |
| 📄 要旨 | 要旨本文(通常はサブページスクレイピングで抽出)。 |
🧫 PubMedの臨床試験エビデンスを抽出する
PubMedの検索結果から臨床試験関連のエビデンスを抽出し、各行を論文ページで補強して、要旨、試験 シグナル、レビューに必要なメタデータを集めるためのワークフローです。
移動先ページの例: Clinical trial search results
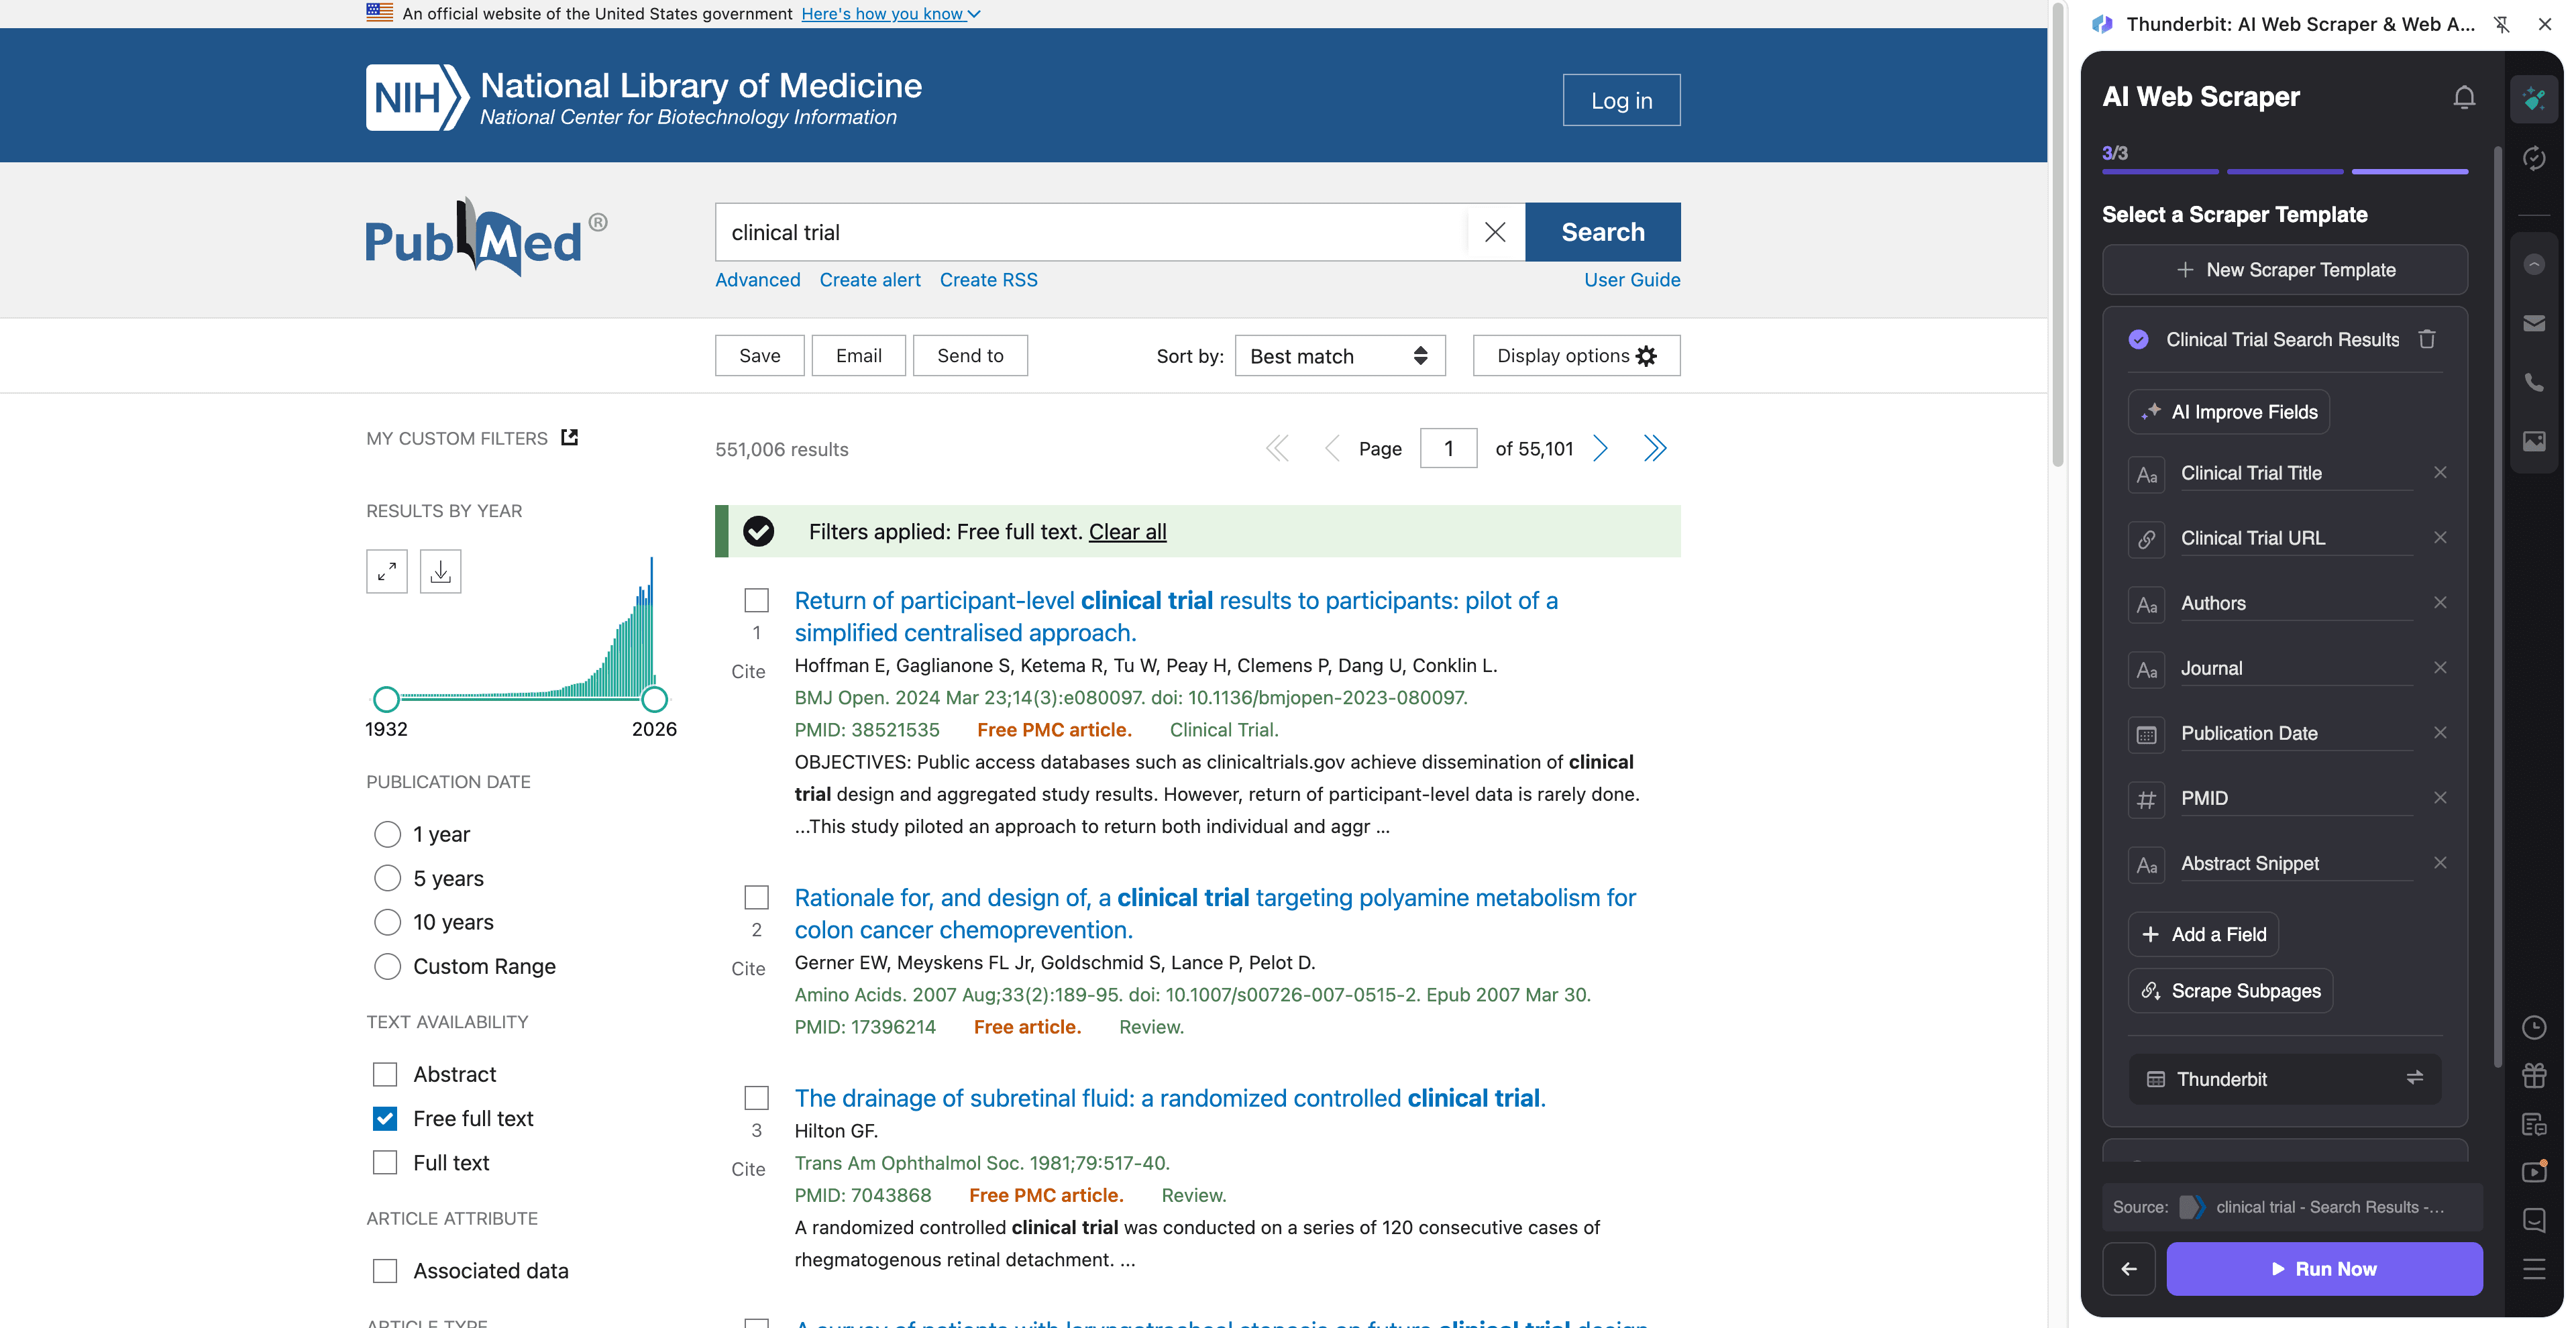
手順:
- Thunderbit Chrome Extensionをダウンロードしてアカウント登録します。
- 例として、Clinical trial search resultsのような移動先ページを開きます。
- AI Suggest Columnsをクリックして推奨フィールドを生成します(必要に応じて名前の変更や追加も可能です)。
- Scrapeで結果を収集し、その後Scrape Subpagesを使って各行に要旨、所属機関、DOIなどを補完します。
列名
| 列 | 説明 |
|---|---|
| 🧾 タイトル | 検索結果に表示される論文タイトル。 |
| 🔗 PubMed URL | サブページ拡張用のPubMed論文ページリンク。 |
| 🆔 PMID | 重複排除や参照に使えるPubMed識別子。 |
| 🧑⚕️ 著者 | 結果スニペットに表示される著者一覧。 |
| 🏛️ ジャーナル | 検索結果に表示される雑誌名と引用情報。 |
| 📅 日付 | 一覧に表示される公開日(またはePub日)。 |
| 🧪 出版種別 | Clinical Trial、Randomized Controlled Trial、Meta-Analysisなどの シグナル(論文ページのほうが明確なことが多い)。 |
| 🧾 要旨 | 完全な要旨本文(サブページスクレイピングが最適)。 |
| 🧬 MeSH用語 | 利用可能な場合のMedical Subject Headings(論文ページにあることが多い)。 |
| 🧷 DOI | 出版社ページや文献管理ツールへのリンク用DOI。 |
| 🏥 所属機関 | 機関分析のための著者所属情報(サブページスクレイピング)。 |
| 🌍 国 / 機関 | Field AI Promptsを使って所属機関情報から解析した項目(任意)。 |
| 🔍 臨床試験キーワード | “randomized”“double-blind”“placebo”などのAIラベル(Field AI Promptで任意設定)。 |
| 📎 全文リンク | 存在する場合の出版社サイトまたは無料全文への外部リンク。 |
🎯 PubMedツールを使う理由
PubMedのスクレイピングは、スピード、整合性、そして研究データをワークフロー全体で使える形にすることが目的です。引用情報を1件ずつコピーする代わりに、フィルタ、タグ付け、共有しやすい構造化データベースを作れます。
PubMedをスクレイプする主な理由:
- メディカルアフェアーズ & 製薬チーム: 治療領域の新規論文を追跡し、競合試験を監視し、社内レビュー用のエビデンステーブルを作成する。
- バイオテック & 臨床運用チーム: 試験関連の論文を収集し、機関や研究者を整理し、継続的な文献リストを維持する。
- ヘルスケアマーケティング & コンテンツチーム: トレンドテーマ、影響力の高いジャーナル、伸びているキーワードを把握し、コンテンツ企画に活かす。
- 研究者 & 図書館員: 文献レビュー用データセットを作り、PMIDで重複排除し、スクリーニング用にスプレッドシートへ出力する。
- データチーム: 分析、ダッシュボード、社内ナレッジベース向けの構造化入力を作成する。
Thunderbitは、一覧ページだけでは足りないときに特に便利です。Subpage Scrapingを使えば、要旨、所属機関、DOI、MeSH用語、全文リンクを大規模に抽出できます。
🧩 PubMed Chrome拡張機能の使い方
- Thunderbit Chrome Extensionをインストール: Chrome Web Storeから入手し、アカウントを作成します。
- PubMedページへ移動: PubMed、Trendingのようなトレンドページ、またはclinical trial resultsのような検索ページを開きます。
- AI搭載スクレイパーを起動: AI Suggest Columnsをクリックしてフィールドを生成し、データ型(text/date/url)を調整し、必要に応じてField AI Promptsを追加します(ラベル付け、整形、試験シグナルの抽出など)。
- スクレイプしてエクスポート: Scrapeをクリックします。要旨や所属機関、MeSHが必要な場合はScrape Subpagesを実行して各行を補完し、その後Excel、Google Sheets、Airtable、Notionへ出力します。
繰り返し使えるワークフローを作るなら、以下も参考になります:
💳 PubMedの料金
Thunderbitはシンプルなクレジット制を採用しています:
- 1クレジット = 結果テーブルの1行(例: PubMedレコード1件)。
- データのエクスポートは無料: CSV/JSONのダウンロード、またはExcel、Google Sheets、Airtable、Notionへの送信が可能です。
利用開始時は以下のプランがあります:
- 無料プラン: 月に6ページまでスクレイピング可能(Freeではページ単位の上限)。
- 無料トライアル: 10ページを無料でスクレイプでき、PubMed Trendingページやいくつかの臨床試験結果ページの検証に最適です。
定期的にスクレイプする場合(毎週の監視、エビデンス更新、大規模クエリなど)は、有料プランのほうがより多くのクレジットを利用できます。年額プランは月払いより割引があり、通常はよりコスト効率に優れています。
プランはThunderbit Pricingで確認できます。
❓ FAQ
-
AI搭載のPubMedスクレイパーとは何ですか?
AI搭載のPubMedスクレイパーは、Thunderbit内でPubMedの検索結果や論文ページから構造化データを抽出するワークフローです。AIで列を提案し、一覧をスクレイプし、さらに論文サブページを開いて要旨、所属機関、DOIなどを補完できます。 -
Thunderbitとは何ですか?
Thunderbitは、ウェブサイトから構造化データを取得したい業務・研究用途向けに設計されたAI web scraperのChrome拡張機能です。スクレイピング用のスクリプトを作成・保守せずに、データの抽出、ラベル付け、エクスポートを素早く行えます。 -
PubMedのTrendingページや通常の検索結果もスクレイプできますか?
はい。PubMed Trendingページ、通常のキーワード検索、フィルタ付き結果ページ(臨床試験重視の検索など)すべて対応できます。ThunderbitのAIはページを読み取り、フィールドを提案することで、レイアウトの違いに適応します。 -
要旨、所属機関、MeSH用語も抽出できますか?
はい。特にSubpage Scrapingが有効です。まず結果一覧を取得し、その後Thunderbitが各PubMedレコードページを開いて、要旨本文、所属機関、MeSH用語、DOIなどを同じテーブルに追加できます。 -
PubMedのページネーションや無限スクロールにはどう対応しますか?
Thunderbitは「次のページ」形式を含むページネーションのスクレイピングに対応しています。PubMedの読み込み方式が変わっても、AIベースの抽出は毎回ページ構造を再読込するため、固定セレクタ方式よりも柔軟です。 -
PubMedデータはどの形式でエクスポートできますか?
CSVまたはJSONで出力できるほか、Excel、Google Sheets、Airtable、Notionへ直接送信できます。スクリーニング作業、エビデンステーブル、ダッシュボード、共同作業に便利です。 -
無料で何件のPubMedレコードをスクレイプできますか?
無料プランでは月6ページまでスクレイプできます。小規模なモニタリングには十分なことが多いです。無料トライアルでは10ページまで無料で試せるため、列設定やサブページ補完の方法を検証できます。 -
特定のエビデンス抽出ニーズに合わせて列をカスタマイズできますか?
はい。列名の変更、データ型(text/date/url)の設定、Field AI Promptsの追加ができます。これにより、試験デザインのキーワード、対象集団、介入、比較対象、アウトカム、所属機関から国名などを抽出・ラベル付けできます。単なるスクレイピングを超えて、構造化されたエビデンス作成に役立ちます。 -
PubMedをスクレイプしても問題ありませんか?
PubMedは公開リソースであり、多くのチームが研究・分析目的で文献メタデータを収集しています。ただし、適用される法律やサイト規約を守り、特に大量・高頻度の処理を行う場合は責任あるスクレイピングを心がけてください。
📚 さらに学ぶ
- 拡張機能を入手: Thunderbit Chrome Extension Download Page
- Thunderbit Blogでガイドを読む
- 基本を学ぶ: データスクレイピングとは?2025年版のやり方
- リストワークフローを構築: リストクローリングとは?AIで行う方法
- スプレッドシートへ出力: AIを使ってWebサイトのデータをExcelに取り込む方法
- 研究業務でPDFもスクレイプする場合: AIを使ってPDFからデータを抽出する方法










