
Yellow Pagesには、なんだか妙に変わらない魅力があります。私の実家に最後の電話帳が届いてから何十年もたった今でも、デジタル版のYellow Pagesは、営業やマーケティング担当者にとってまさに宝の山です。ただし、ひとつ違うのは、昔よりデータ量は増えたのに、実際に集めて使いこなすのはずっとややこしくなったこと。企業情報をひたすらコピペするだけで何時間も溶かして、最後に残るのは散らかったスプレッドシートと取りこぼした商談だけ——そんなチームを何度も見てきました。だからこそ私は、Thunderbit のような賢いツールを使って、Yellow Pagesのデータを本当の競争力に変えるべきだと強く思っています。
Thunderbit Yellow Pages Scraper を試す 無料プランで月6ページまで利用可能。クレジットカード不要なので、本格導入前にYellow Pagesの抽出を気軽に試せます。 Get Started Free
このガイドでは、なぜYellow Pagesの抽出が今でもリード獲得に欠かせないのか、データ要件をどう整理すればいいのか、そしてできるだけクリーンで実用的なデータを手に入れるためのベストプラクティス、さらに現場で身についたコツまでまとめて解説します。経験豊富な営業担当の方も、手作業のデータ入力にうんざりしている方も、Yellow Pages Scraperを使って効率と成果をどう最大化できるのか、一緒に見ていきましょう。
Yellow Pagesとは?営業・マーケティングにおけるデータ価値を引き出す
Yellow Pagesは、ただのアナログ時代の名残ではありません。世界でも有数の大規模かつ網羅的なビジネスディレクトリで、今では完全にデジタル化され、むしろ以前より重要な存在になっています。YP.com、Yell、PagesJaunesなどのデジタルYellow Pages系プラットフォームには、あらゆる業種にまたがって、世界中の数百万件の企業情報が載っています。
では、Yellow Pagesがなぜここまで価値があるのでしょうか。答えは、情報の深さと広さにあります。企業名、電話番号、メールアドレス、所在地、Webサイト、業種カテゴリ、営業時間、さらには顧客レビューまでそろっています。営業・マーケティングチームにとっては、次のような用途にそのまま使える宝庫です。
- リード獲得: ターゲット市場で、実在して営業中の企業を見つけられる
- 市場調査: 競合を分析し、市場の飽和度を把握し、未開拓のニッチを見つける
- 地域ターゲティング: 市区町村、州、郵便番号単位で絞り込み、超ローカルな施策に活用する
- B2Bアプローチ: テレアポ、メール施策、DM用のリストを目的別に作成する
しかも、適当に集めたリストと違って、Yellow Pagesのデータは一般的により最新で、実際に営業していて問い合わせにも反応しやすい企業にフォーカスされています(BrowserAct)。つまり、無駄な作業が減って、反応率も上がりやすいということです。
Yellow Pages Scraperを使う前に、必要なデータを明確にする
Yellow Pages Scraperを開く前に、まず「本当に必要なものは何か」をはっきりさせておきましょう。このひと手間で、あとから不要なデータに埋もれるのを防げます。
対象条件を定義する
次の点を自問してみてください。
- どの業界・業種を狙うのか?(例:レストラン、歯科医院、自動車修理)
- どの地域が重要か?(市、州、郵便番号、国単位など)
- どの規模の企業が対象か?(一部のディレクトリでは従業員数や創業年が含まれる)
- 気にしたいキーワードや専門分野はあるか?(例:「ヴィーガンベーカリー」「太陽光設置業者」)
ここで条件をしぼっておけば、結局使わない何千件もの連絡先を集めてしまう、よくある失敗を避けられます。大事なのは数より質です。
抽出したい主なデータ項目
多くの営業・マーケティングチームが欲しいのは、次のような項目です。
- 企業名
- 電話番号
- メールアドレス(取得できる場合)
- 住所(番地、都市、州、郵便番号)
- WebサイトURL
- 業種・カテゴリ
- 説明文や専門分野
- 営業時間
- 評価やレビュー
必要な項目を先に決めておくと、精度を最大化するようにスクレイパーを設定しやすくなります(Octoparse)。
Yellow Pages Scraperに合ったフィルターを選ぶ
Yellow Pages系サイトには、たいてい強力な検索・絞り込み機能があります。どんどん活用しましょう。たとえば:
- 業種+地域: 「San Diego, CA」の「Plumbers」
- キーワード+カテゴリ: 「Restaurants」内の「Vegan」
- 企業規模: 「small business」や「enterprise」で絞る(対応していれば)
フィルターを具体的にすればするほど、結果の関連性が高まり、あとでのクリーンアップも楽になります(Apify)。
AIでYellow Pagesのデータを抽出 Thunderbitのエージェント型Webスクレイパーを使えば、ワンクリックでYellow Pagesから企業リードを抽出できます。 Get Started Free
こうしたフィルターを使えば、データの関連性と扱いやすさを両立できて、効率的な抽出と実用的なインサイトにつながります。
複雑なYellow Pagesページをどう攻略するか:効率的な抽出方法
ここからが少し厄介です。Yellow Pagesのサイトは、人が見るために作られていて、大量データの一括抽出には向いていません。次のような壁にぶつかります。
- 複数ページにまたがる一覧: 何百件もの結果が何十ページにも分かれている
- 動的コンテンツ: スクロールや「次へ」クリックで読み込まれる一覧
- 詳細が階層化された構造: メールや説明文などの重要情報が、企業詳細ページの奥に隠れている
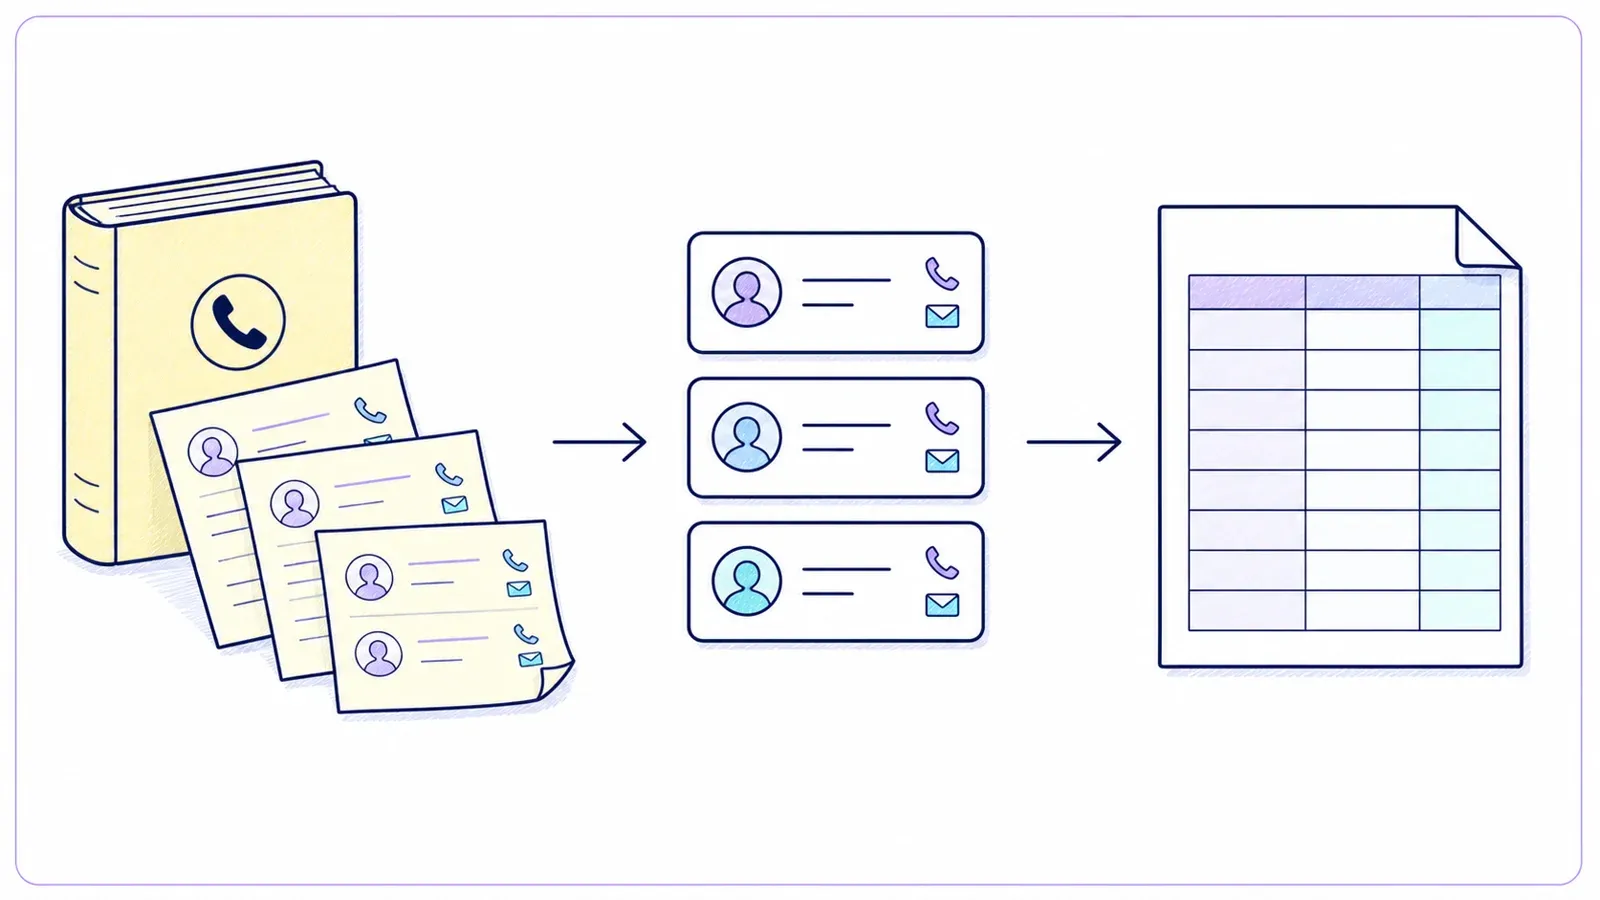 手作業での抽出? それはかなりきついです。100件の連絡先を手で集めるだけで3〜5時間かかるうえ、一般的な営業チームではその1時間ごとに2,500ドル分の機会損失が発生すると言われています。
だからこそ私は、こうした課題に真正面から対応できるThunderbitのような、最新のAI搭載ツールを高く評価しています。
「ワンクリック抽出」で、より賢くデータを取り出す
Thunderbit なら、良い結果を出すのにデータサイエンティストである必要はありません。Chrome拡張機能を開いてYellow Pagesの検索結果ページへ移動し、「One Click Extract」を押すだけです。ThunderbitのAIがページを読み取り、「Business Name」「Phone」「Address」「Website」など、関連性の高い列を自動で見つけます(Thunderbit Yellow Pages Scraper)。
メリットは次の通りです。
- コーディング不要、手動設定も不要
- AIがレイアウト変更に対応(サイト更新でテンプレートが壊れる心配が減る)
- 非エンジニアでも数分で使い始められる
提案された項目は自由に調整できて、カスタム列を追加したり、AIプロンプトを使って必要な形式でデータを抽出・ラベル付けしたりもできます。
「サブページ抽出」で、詳細情報まで取り込む
多くのYellow Pages掲載情報では、最初に見えるのは基本情報だけです。本当に価値のあるメールアドレス、詳しいプロフィール、専門分野などは、各企業の詳細ページに隠れていることがよくあります。Thunderbitの「Subpage Scraping」機能を使えば、各サブページを自動で巡回し、メイン表に追加情報を補完できます(Thunderbit Yellow Pages Scraper)。
たとえば、レストラン一覧を抽出したあとにサブページ抽出を使えば、次のような情報を取り込めます。
- オーナー名や店長名
- 直通メールアドレス
- SNSリンク
- メニューの特徴や名物
何時間もかけて一件ずつクリックしなくても、より充実した実用的なリードリストを作れるのはかなり大きな強みです。
データ処理の重要ステップ:クレンジング、整形、連携
スクレイピングはあくまで最初の一歩です。実際に使える状態にし、うっかりミスを防ぐには、CRMやアウトリーチツールに入れる前にデータを整える必要があります。
クレンジングと重複排除
- 重複を削除する: どんなに優れたスクレイパーでも、複数カテゴリに掲載されている企業を二重に拾うことがあります
- 不完全な行を除外する: 電話やメールなど重要情報が欠けている行は、後で補完する予定がなければ削除する
- メールと電話番号を検証する: 内蔵ツールや外部の検証サービスを使って、 টাইポや書式ミスを見つける(Perfect Data Entry)
Thunderbitでデータ整形とタグ付けを自動化する
ThunderbitのAIなら、次の処理を自動で行えます。
- 電話番号の標準化(例:CRM互換のE.164形式)
- 住所の整形(番地、市、州、郵便番号に分割)
- キーワード、地域、業種に応じたタグ付け・分類
- 説明文の翻訳や要約によるセグメント分けの効率化
これで、リストのセグメント化、担当者への割り当て、自動ワークフローの起動がずっとやりやすくなります。
Yellow Pagesをリードリストに変える ワンクリックで企業名、電話番号、住所、カテゴリをきれいな表に取り込みます。Email and Phone Extractorは無料で、クレジットも消費しません。 Get Started Free
CRMへ取り込むための準備
- フィールドを対応付ける: 抽出した列がCRMの必須項目に合っているか確認する(例:「Business Name」→「Account Name」)
- 適切な形式でエクスポートする: ThunderbitはGoogle Sheets、Airtable、Notion、CSV、Excelへ直接エクスポートできます
- 少量でテストする: いきなり全件を入れる前に、サンプルでマッピングや書式の問題を確認する
Yellow Pagesの抽出効率を高める5つの実践テクニック
もっと賢く、もっとラクに抽出したいですか? 私のおすすめを5つ紹介します。
| ヒント | 説明 |
|---|---|
| 1. 混雑しない時間帯にスクレイピングを実行する | 多くのサイトは営業時間中にスクレイパーを制限・ブロックします。Thunderbitなら、夜間や週末にジョブを予約でき、よりスムーズで高速な結果が得られます。 |
| 2. IPローテーションやシークレットモードを使う | IPを切り替えたり、ブラウザをプライベートモードで動かしたりしてブロックを回避しましょう。大量処理では、VPNやプロキシサービスの利用も検討してください(ScrapingBee)。 |
| 3. リクエスト速度を抑える | 人が閲覧する速度に近づけるように設定しましょう。短時間に大量アクセスすると、ボット対策に引っかかる可能性があります。 |
| 4. スクレイピングテンプレートを定期的に更新する | AIを使っていても、大きなサイト更新の後は設定を見直すのが賢明です。ThunderbitのAIは自動で適応しますが、軽く確認しておくに越したことはありません。 |
| 5. 抽出データを監視・検証する | 特に長時間の実行や大規模ジョブの後は、結果をサンプルチェックして精度を確認しましょう。Thunderbitのプレビューや検証機能を使えば、問題を早めに見つけられます(Perfect Data Entry)。 |
Yellow Pages Scraperのタスクをスケジュールして自動化する
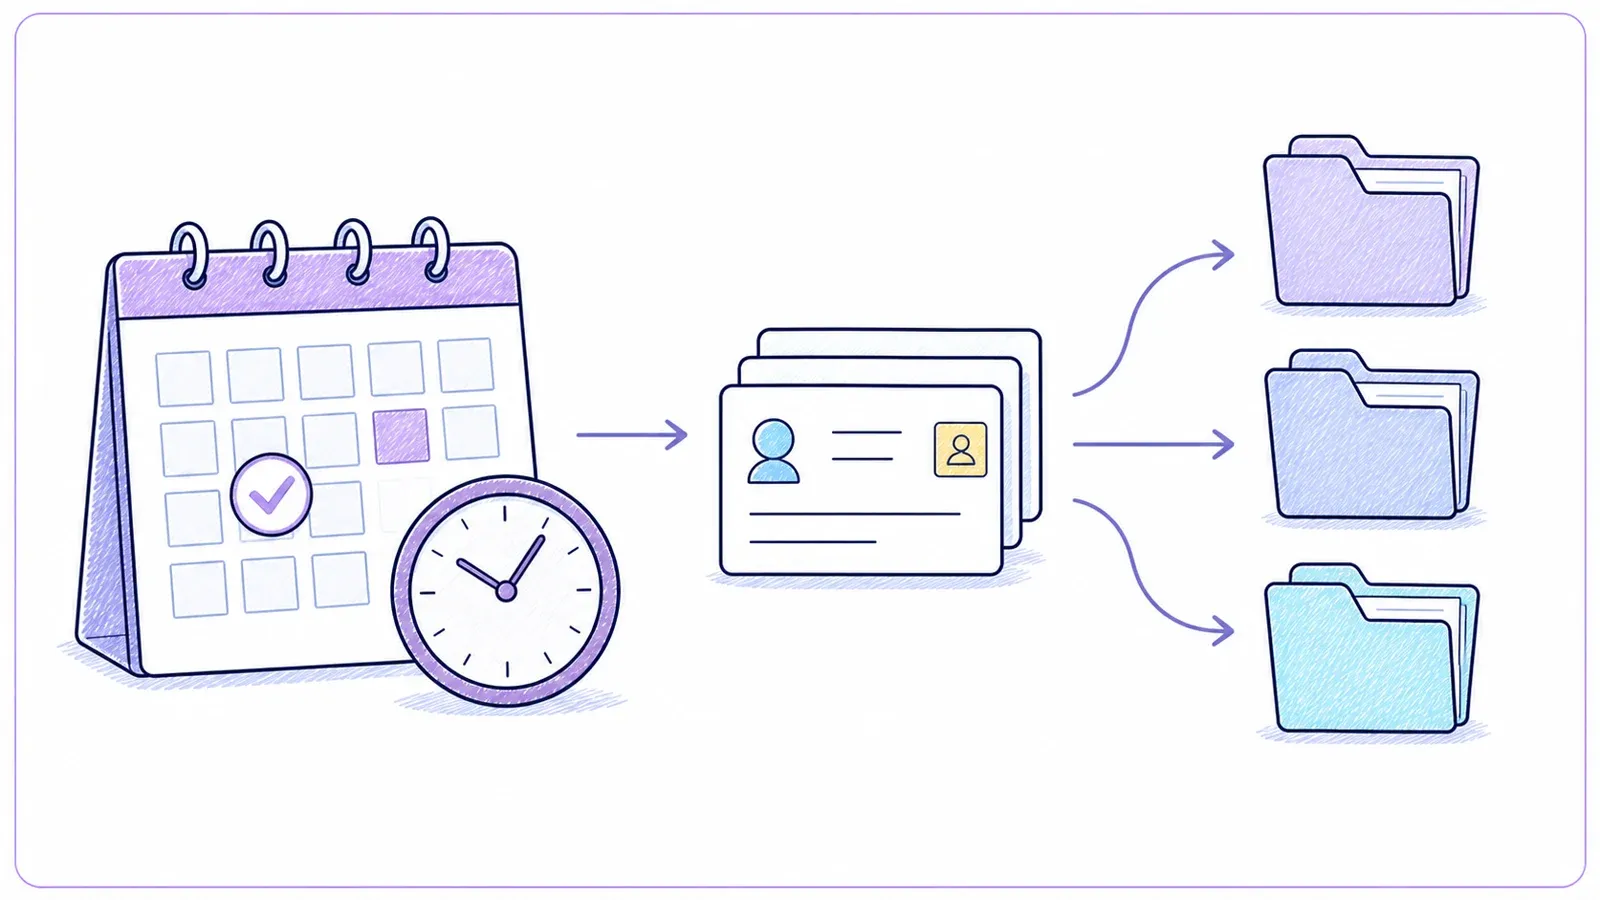 Thunderbitのスケジュール機能は、定期的に新しいリードが必要なチームにとってかなり頼れる機能です。希望の間隔(毎日、毎週、毎月)を設定するだけで、Thunderbitが自動で抽出・更新してくれます。手作業は一切不要。これは次のような場面にぴったりです。
- 営業チーム: 常に最新の連絡先でアプローチできる
- EC運営: 新店舗の開店や競合リストを継続的に把握する
- 代理店: クライアントのリードリストを手を動かさずに最新化する
Yellow Pages Scraperの結果を営業ワークフローに統合する
データが整って書式もそろったら、いよいよ実運用です。Thunderbitは、営業・マーケティングチームがよく使う主要ツールへの直接エクスポートに対応しています。
- Google Sheets: すばやい共同作業と分析に
- Airtable: より高度なデータベース型ワークフローに
- Notion: プロジェクト管理とCRMを一体化するために
- CSV/Excel: Salesforce、HubSpot、Zoho、またはお使いのCRMへ一括インポートするために
プロのコツ: フィールドの対応付けは必ず再確認し、テストインポートを行って、データの上書きや誤ラベルを防ぎましょう。
エージェント型Webスクレイピングの仕組みを見る ThunderbitのAIは、人間のようにビジネスディレクトリのページを読み取り、CSSセレクタ不要でワンクリック抽出します。 Get Started Free
Yellow Pagesのデータをワークフローへ直接つなげば、アウトリーチを加速し、ターゲティングを改善し、チーム全体の成果を高められます。
Yellow Pages Scraperを使う際によくある失敗
どんなに優れたツールでも、ありがちなミスまでは防げません。次の点に注意しましょう。
- 関係のないデータを抽出する: フィルター設定が甘いと、膨らんだ使いにくいリストになる
- 重複を整理しない: 同じ連絡先が重なると時間の無駄になり、見込み客にも嫌がられる
- 法的な確認を怠る: 抽出前に、必ずYellow Pagesの利用規約と地域のデータ保護法を確認する(Apify)
- サイトに負荷をかけすぎる: 短時間に大量アクセスするとブロックされることがあるため、ペースを守る
- データ検証を省く: 抽出結果が完璧だと思い込まないこと。必ず確認してから取り込む
Thunderbitのワンクリック抽出、重複排除、エクスポート検証といった標準機能を使えば、こうした悩みの多くを最初から避けられます。
まとめ:Yellow Pages Scraperの効率を最大化するポイント
Yellow Pagesの抽出は、今でも営業・マーケティング向けに、ターゲットを絞った高品質なリードリストを作るうえで、かなり有効な方法のひとつです。ただし、効率を本当に最大化し、ありがちな失敗を避けるには、次の点が欠かせません。
- 作業前にデータ目標とフィルターを明確にする
- One Click Extractやサブページ抽出などの高度な機能を活用する
- データをクレンジング・整形・タグ付けしてCRMに取り込みやすくする
- 抽出を自動化・定期化して、データの鮮度を保つ
- 各ステップで監視・検証・コンプライアンス確認を行う
ThunderbitのYellow Pages Scraperを使えば、何時間もかかっていた手作業の入力が、ワンクリックで実用的なリードリストに変わります。もし私が何年も前に欲しかったツールがあるとしたら、まさにこれです。しかも今では、世界中の何千ものチームが「がんばる」より「賢く働く」ために活用しています。
ThunderbitのChrome拡張機能をダウンロード 無料のChrome拡張機能をインストールして、Yellow Pagesの一覧抽出をワンクリックで始めましょう。 Get Started Free
実際に試してみませんか? ThunderbitのChrome拡張機能をダウンロードして、今日から次の高成約率リードリストづくりを始めましょう。さらにWebスクレイピングのベストプラクティスを深掘りしたい方は、Thunderbit Blog の各種ガイドもぜひ見てください。
AIでYellow Pagesの抽出を始める Get Started Free
FAQ
1. Yellow Pagesのデータを抽出するのは合法ですか?
公開されているビジネスディレクトリの抽出は、一般的には業務利用の範囲で合法ですが、必ず対象サイトの利用規約を確認し、地域の個人情報保護法を守ってください。個人データの抽出や、抽出情報を使ったスパム行為は避けましょう。
2. Yellow Pagesを抽出する際にブロックされにくくする最善策は何ですか?
混雑しない時間帯に実行し、シークレットモードやIPローテーションを使い、人の閲覧速度に近いリクエスト頻度に抑えましょう。Thunderbitのスケジュール機能とブラウザ抽出オプションは、ブロックリスクの低減に役立ちます。
3. 営業リード用にYellow Pagesからどの項目を抽出すべきですか?
企業名、電話番号、メールアドレス、住所、Webサイト、業種カテゴリ、そしてキャンペーンに関連する専門情報を重視しましょう。Thunderbitの「One Click Extract」を使えば、役立つ列を自動で見つけられます。
4. 抽出したYellow PagesデータをCRMへ取り込むにはどうすればよいですか?
ThunderbitからCSV、Excel、Google Sheets、Airtable、Notionとしてエクスポートします。各フィールドをCRMの要件に合わせ、まずは少量でテストしてから全件を取り込みましょう。
5. Yellow Pagesのリードリストを最新状態に保つにはどうすればよいですか?
Thunderbitのスケジュール機能を使って、定期的な抽出を自動化しましょう。これで、リストの鮮度と関連性を常に保てます。継続的な営業活動や市場モニタリングにぴったりです。
快適な抽出を。そして、あなたのリードリストがいつも整理され、最新で、チャンスにあふれていますように。



