
ECの商品管理がやっかいなのは、同じ商品でもショップによって名前の付け方、型番の書式、説明文の粒度がばらばらだという点です。価格比較や在庫統合を始める前に、まずは「これとこれは同じ商品なのか」を特定しなければなりません。「リンゴ」と「2023年産オーガニック赤い果実3個パック」ほど表現の粒度が違うと、文字列を単純に突き合わせるだけでは判定できないのです。
商品数と販売チャネルが増えるほど、この問題は膨らみます。オンラインストアは2,500万店超、Amazonだけでも6億点以上という規模になると、商品情報を人力だけで整理し続けるのはもう現実的ではありません。
AIであらゆるウェブサイトから商品データを抽出 Get Started Free
商品データの収集にウェブスクレイピングを使うなら、対象サイトの利用規約、著作権、個人情報の扱い、アクセス頻度やサーバー負荷にも目を配る必要があります。取得できる情報であっても、利用目的や保存方法まで含めて運用のルールを決めておくことが欠かせません。
SaaSと自動化の現場に長く関わってきて、商品データのズレがチームの作業効率、価格管理、顧客体験にじわじわ響く場面を数えきれないほど見てきました。だからこそThunderbitでは、商品データの収集と構造化を効率化し、プロダクトマッチングの下準備を進めやすくすることを目指しています。本記事では、プロダクトマッチングの定義、仕組み、活用例、導入時の課題、そしてThunderbitを使ったデータ準備の流れを順に見ていきます。
プロダクトマッチングをひとことで言うと
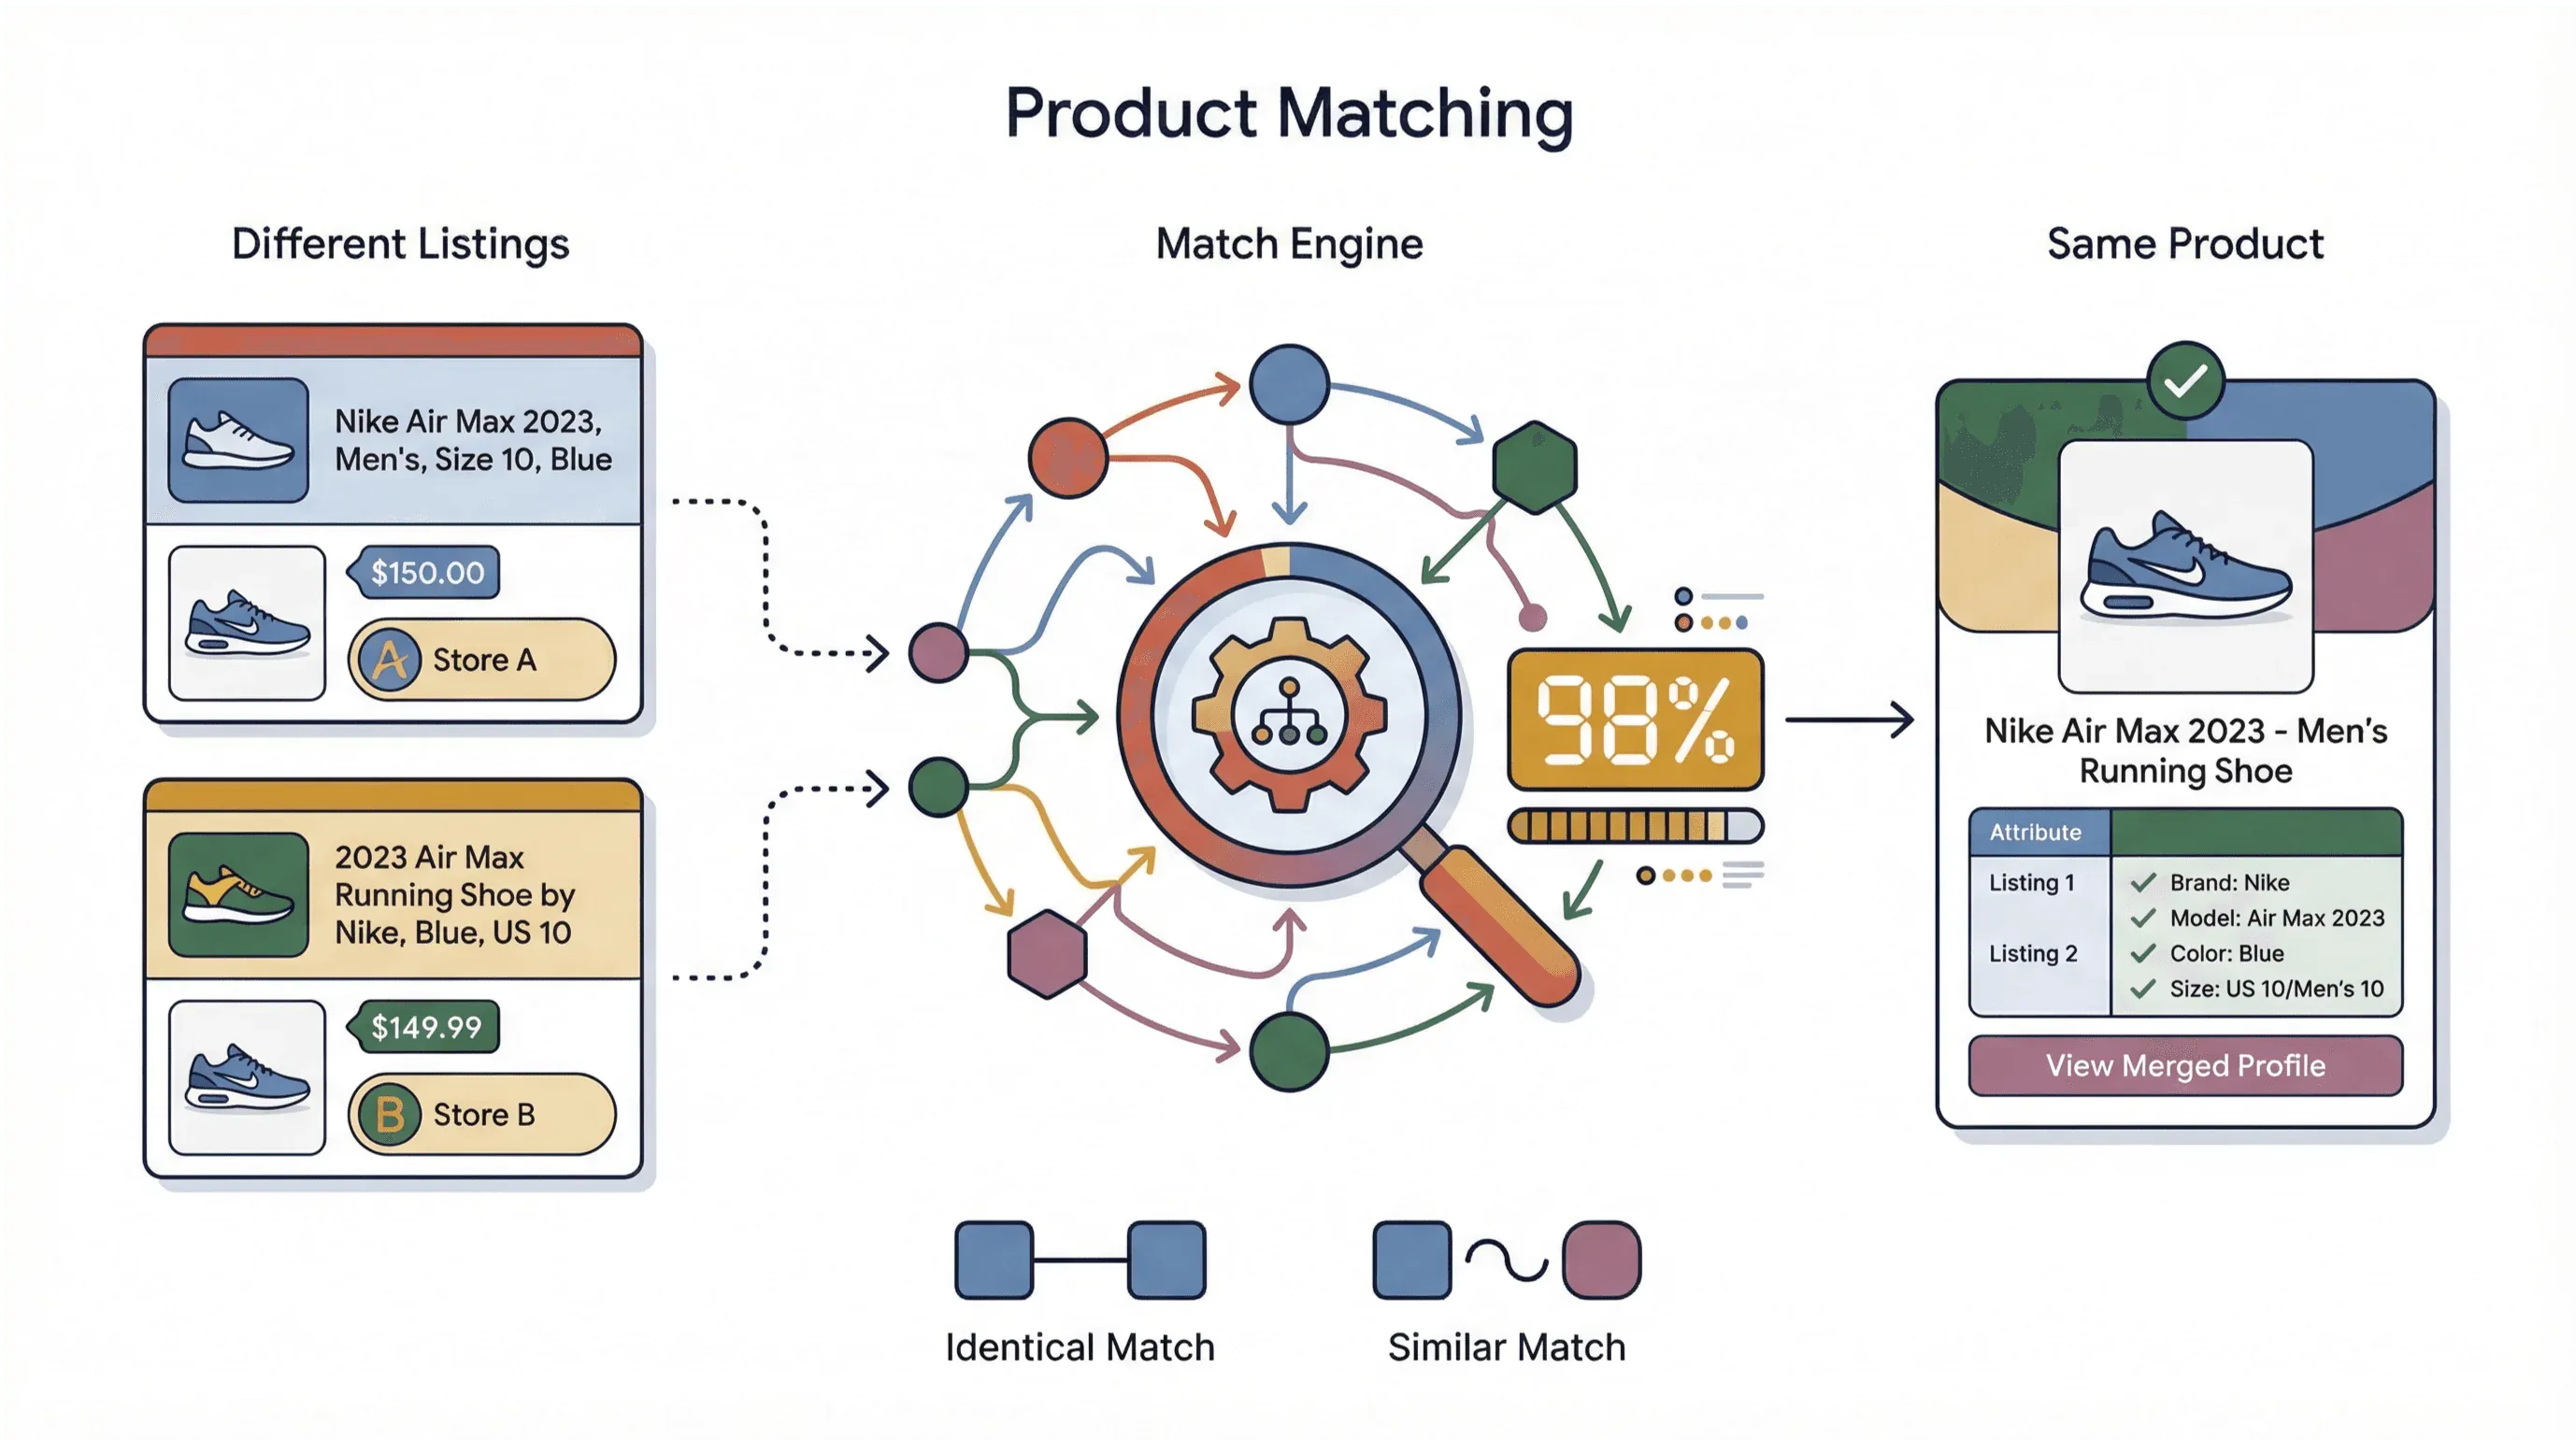
プロダクトマッチングとは、異なるショップやカタログに登録された商品情報を見比べ、同じ商品または条件の近い商品を結びつける作業です。商品名だけを見るのではなく、ブランド、型番、サイズ、色、商品コードなどを組み合わせて判定します。
たとえば、次の2件の商品情報があったとしましょう。
- 「Nike Air Max 2023 メンズ 10サイズ ブルー」
- 「2023年製 Nike ランニングシューズ Air Max ブルー US10」
表記の順序も単位も違いますが、ブランド、シリーズ、色、サイズを照合すれば、同じスニーカーを指している可能性が高いと分かります。プロダクトマッチングは、こうした表記ゆれをまず標準化し、あらかじめ定めた基準に沿って対応関係を付ける作業だと言えます。
タイプは大きく2つに分かれます。
- 完全一致マッチング:ブランド、型番、仕様、UPCやSKUなどを突き合わせて同一商品を特定します。
- 類似(同等)マッチング:同一とは限らないものの、用途や主要な特徴が近い商品を結びつけます(例:500mLのステンレスボトルと16.9ozの保温ボトル)。
前者は価格比較や在庫統合のように同一性を厳密に見る場面で、後者は代替品の提案のように用途や特徴の近さを重視する場面で、それぞれ使い分けます。
なぜ今プロダクトマッチングが求められるのか
競合価格の比較、カタログの整理、在庫管理、商品提案——これらの業務はどれも同じ商品データを土台にしています。プロダクトマッチングは、その土台をそろえるための仕組みです。
| 活用シーン | ビジネス上のメリット |
|---|---|
| 競合価格のモニタリング | 取得頻度に応じて他社価格を比較し、ダイナミックプライシングや利益率管理の検討材料にできる |
| 品揃え最適化 | 競合との商品重複や品揃えの差を可視化し、ラインナップ計画に活用できる |
| 在庫管理・データ品質 | 重複データを統合し、二重登録や発注ミスを減らしやすくする |
| パーソナライズ・レコメンド | 商品の対応関係を整え、関連性の高い提案やCVR改善施策の基礎データにできる |
たとえばLevi'sのジーンズを扱う店舗なら、型番やサイズをそろえて他店の商品と対応づけることで価格差が見えやすくなります。在庫管理では重複登録を統合すれば、別コードによる二重発注を防げます。顧客向けには重複表示を減らし、関連性の高い商品提案につなげられます。
Amazonのレコメンドは、精度の高い商品データとマッチングに支えられ、売上のおよそ35%を稼ぎ出しているという推計もあります。ただし売上への寄与はマッチングだけで決まるものではなく、商品構成、顧客データ、表示ロジックを含めた仕組み全体の成果として見る必要があります。
プロダクトマッチングはどう動くのか
プロダクトマッチングは、商品データを集めて標準化し、属性を比較したうえで判定結果を検証する一連の工程です。一般的には次の流れで進めます。
- 情報を集める:商品タイトル、説明、仕様、画像、価格、SKU、UPCなど判定に必要な情報をかき集めます。取得元はウェブスクレイパー、データベース出力、サプライヤーフィードなど様々です。
- 表記をそろえる:単位を統一し(「16.9oz」→「500mL」)、ブランド表記を寄せ(「P&G」⇔「プロクター&ギャンブル」)、色や仕様の呼び方も正規化します(「スカイブルー」⇔「ブルー」)。
- 属性を突き合わせる:ブランド、型番、サイズ、色、商品コードなどを照合し一致度を数値化します。完全一致ではUPCや型番を重視し、類似マッチングでは特徴や意味の近さも判定材料にします。
- AI・機械学習で補う:テキスト、画像、属性を組み合わせ、「4Kテレビ」と「ウルトラHDテレビ」のような言い回しの近さや商品画像の類似性まで判定候補に加えます。
- 人が確認する:判定結果を確信度や業務上の重要度で振り分けます。基準を満たすものは自動処理に回し、境界線上や高リスクの商品だけ担当者がチェックします。
この一連の流れによって、カタログ間や競合間の商品を共通の基準で対応づけられます。精度を保つ鍵は、使う属性、判定の閾値、人が見直す条件を業務目的に合わせて設計することです。
従来型プロダクトマッチングが抱える限界
かつてのプロダクトマッチングは、担当者による目視確認や単純な一致ルールが中心でした。代表的な手法は次のとおりです。
- 目視でのチェック:担当者が商品情報を1件ずつ見比べます。
- 単純な一致ルール:SKU、UPC、商品名がぴったり一致するかどうかだけで判定します。
- スプレッドシート転記:複数のカタログから情報を書き写して並べ、目で比較します。
こうしたやり方には、次のような壁があります。
- 表記のゆらぎ:略記や属性の抜け、誤字があると、単純な一致判定ではすり抜けてしまいます。
- 属性の欠落:型番などのキーとなる情報がなければ、追加調査や人の判断に頼るしかありません。
- かかる手間:ある比較例では、1,000件の手作業に16時間超かかる一方、AIを使った検索では2分で済んだと紹介されています(QL2)。実際の所要時間はデータ品質、判定基準、確認工程で変わります。
- 判断のブレ:担当者ごとに基準が変われば、結果もそれだけばらつきます。
- 処理が追いつかない:商品数や更新頻度が増えるほど、目視だけでは限界が来ます。
- 情報が古びる:確認に時間をかけている間に、価格や在庫が変わってしまうこともあります。
手作業や単純ルールは、例外処理や最終判断の場面では今も有効です。ただし商品数や更新頻度が高い業務では、標準化・自動判定・人による検証を組み合わせる必要が出てきます。
AIがプロダクトマッチングにもたらすもの
AIは、表記ゆれや画像の違いを含む大量の商品データから対応候補を絞り込む用途で活きてきます。ただし処理速度や精度は、データ品質、商品カテゴリ、学習データ、判定基準によって変わります。
主な特徴は次のとおりです。
- 桁違いの処理量:事例によっては数千〜数百万件を数分で処理でき、AI導入で手作業の負担が30〜40%減るという報告もあります。対象データや検証範囲が違えば結果も変わります。
- 見る角度が増える:自然言語処理(NLP)や画像認識を組み合わせれば、文字列の一致だけでなく文脈、意味の近さ、画像の似具合まで比較材料にできます。
- 代替品も拾える:完全一致だけでなく、代替品や類似品の候補提示にも使えます。
- 使うほど賢くなる:人が修正した結果を判定ルールやモデル改善に反映する設計なら、新しいカテゴリや例外への対応力も上がっていきます。
- 変化を追い続ける:データ取得とマッチングを定期実行すれば、価格や在庫の変化も追いやすくなります。頻度はデータ取得条件と運用設定次第です。
AIは候補抽出と一次判定を効率化してくれますが、同一性の基準や例外処理まで自動で決めてくれるわけではありません。業界記事では「戦略的必須事項」と位置づける例もありますが、導入判断ではデータ量、誤判定の影響、運用コストを比較したうえで決めるべきです。
Thunderbitでプロダクトマッチング用データを準備する
ここからは、プロダクトマッチングの前工程にあたる商品データの収集と構造化にThunderbitを使う方法を紹介します。
ThunderbitはAIを活用したウェブスクレイパーのChrome拡張機能です。ECの商品一覧や詳細ページから、比較に必要な項目を表形式で整理したい場面に向いています。マッチング判定そのものの精度は、抽出後のデータ品質、照合基準、使う分析方法次第です。
- AIサジェスト機能:ページを読み取り、「商品名」「価格」「画像」「SKU」などの候補をワンクリックで提示します。HTMLやセレクタの知識がなくても基本設定を進められますが、ページ構造によっては列や結果の調整が必要です。
- サブページ自動取得:商品詳細へのリンクをたどれるページでは、スペックやレビューなどを追加取得できます。取得範囲はログイン、アクセス制限、ページ構造次第です。
- ページネーション・テンプレート:複数ページや無限スクロールに対応するページネーションに加え、AmazonやShopifyなどのテンプレートもそろっています(提供対象やページ構造による)。
- 構造化エクスポート:結果をExcel、Googleスプレッドシート、Airtable、Notion、CSVへ出力できます。
- スケジューリング:定期スクレイピングを設定すれば、商品情報の変化も追跡できます。実行頻度や結果はプラン・対象サイト・アクセス条件に左右されます。
第三者サイトから商品情報を取得する際は、利用規約、著作権、個人情報、アクセス制限を踏まえて対象項目と実行頻度を決めてください。まず必要な列と照合基準を定め、取得結果がカタログ管理の目的に合っているかを検証することが大切です。
Thunderbitを使ったプロダクトマッチングの流れ
商品データを準備し、照合工程につなげる基本ステップです。
- 自社の商品一覧を開く:AIサジェストで商品名・SKU・価格などの主要属性を取得してGoogleスプレッドシートへ出力します。提案された列は自社の照合基準に合わせて見直しましょう。
- 競合サイトも同じ手順で:同じ属性構成で競合サイトからもデータを取得します。ページネーションやサブページの可否はページ構造次第で、対象サイトの規約とアクセス条件は必ず守ってください。
- 型番や名称で候補を作る:スプレッドシート上で型番、商品名、ブランド、サイズなどを手がかりに対応候補を作ります。AIプロンプトを使えば表記の標準化や属性補完も支援できますが、曖昧なケースは元の商品ページと突き合わせます。
- 差を可視化して使う:対応関係が固まったら、価格差や品揃えのギャップを洗い出し、価格設定や仕入れの判断材料にします。
- 回し続ける仕組みにする:対応プランとページでは競合データの定期取得を組んで更新差分を追跡し、判定基準や例外商品も折に触れて見直していきます。
条件がそろえば、これまで数日かかっていた作業をノーコードで1〜2時間に縮められることもあります。実際の所要時間は商品数、ページ構造、データの欠落、照合後の人手確認によって変わります。
プロダクトマッチングが顧客体験を底上げする
データスクレイピングとは?2026年に実践する方法 Get Started Free
商品情報を統一すると、社内業務だけでなく顧客に見せるカタログや商品提案の品質も整いやすくなります。
- 同じ商品が何度も出てこない:重複表示を減らし、比較しやすいカタログにします。
- 的を射た提案になる:対応関係をもとに、代替品やセット商品を提示します。
- 表示が関心に寄っていく:統一した商品データで、メール・検索結果・サイト表示を顧客の興味に合わせます。
- レビューが一箇所にまとまる:同一商品と判定したレビューをまとめ、購入判断の材料を見やすくします。
パーソナライズ施策についてはCVRが15〜30%伸びたり客単価が上がったりする傾向も紹介されていますが、結果は商品構成、顧客データ、表示方法、検証設計によって変わります。プロダクトマッチングは、こうした施策で一貫した商品情報を使うための土台です。
現場ではどう使われているか
プロダクトマッチングは、取得するデータ、更新頻度、最終的な判断を組み合わせて運用されます。代表的な活用例は次のとおりです。
- 競合価格モニタリング:自社商品と競合商品を対応づけ、取得頻度に応じて価格差を追跡します。ある食品小売では、自動化によってデータ管理コストを40%削減し、価格分析力を2倍に高めましたと報告されています。
- 品揃え戦略:ファッション小売では、競合との重複を洗い出し、独自コレクションについてサプライヤーと交渉する材料に使われています(Centric Software)。
- 在庫最適化:卸売業者はサプライヤーカタログと自社カタログを突き合わせ、重複発注や商品コードの不整合を減らします。
- パーソナライズマーケティング:同一商品と関連商品の関係を整え、「よく一緒に買われる商品」やクロスセル候補の精度改善に活用します。
共通するのは、商品を正しく対応づけることで、価格、品揃え、在庫、顧客提案の判断に使うデータをそろえられるという点です。収益や顧客満足への効果は、マッチング後の施策と運用条件によって変わります。
つまずきやすいポイントと対策
ツールさえ入れれば商品データの穴や判定基準のブレが自然に消えるわけではなく、運用側で埋めるべき溝がいくつか残ります。
- 抜けや表記ゆれを埋める:抜けている属性や表記のゆらぎは、そのつど補って形をそろえます。
- 「同じ」の線引きを決めておく:どこまでを「同一」「類似」と見なすかは、使い道ごとにチーム内で合意を取っておきます。
- 粒度を詰めておく:SKUや型番、色、サイズをどの粒度で比べるかを詰めておかないと、セット商品と単品を取り違えるようなミスが起きます。
- 人の目で仕上げる:データそのものの質が不安なら、Thunderbitのようなツールで属性を構造化しつつ、元ページとの突き合わせや欠損チェックを人の目で補うのが実用的です。
- 一度きりで終わらせない:価格や在庫、商品構成は動き続けるものなので、定期的な取得と点検をセットで回す前提で設計しておきましょう。
自動判定の確信度が低い商品や、誤判定の影響が大きい商品には人による最終確認を残しましょう。修正内容を記録すれば、判定ルールやモデルを見直す材料にもなります。
まとめ:プロダクトマッチングを導入する前に
プロダクトマッチングは、複数のカタログを扱うEC事業者にとって、価格比較、在庫統合、品揃え分析、商品提案を支えるデータ管理工程です。商品数や更新頻度が高いなら手作業だけでの対応は難しくなるため、ルール、AI、人による検証を組み合わせるのが現実的なやり方です。
AIは表記ゆれや画像を含む候補の絞り込みを支援してくれますが、必要な精度や自動化範囲は商品カテゴリと業務目的によって変わります。Thunderbitのようなツールは、Webページから商品情報を集めて照合に使える表データへ整理する前工程で力を発揮します。マッチング精度そのものを保証するものではないため、属性の選び方、判定基準、例外商品の扱いは別途設計してください。
導入時は、まず対象ページを1つ選び、必要な属性が取得できるか、表記を標準化できるか、出力形式が後続の照合工程に合うかを検証すると進めやすくなります。第三者サイトが対象なら、利用規約、権利関係、アクセス負荷も運用設計に含めましょう。
Thunderbitの実例やウェブスクレイパー・データ自動化のノウハウはThunderbitブログでも紹介しています。実際のページで取得項目と出力結果を確かめてから、定期運用や対象商品の拡大を検討してください。
よくある質問(FAQ)
1. プロダクトマッチングとは簡単に言うと?
違うショップやカタログに載っている商品を突き合わせ、「これは同じ商品」「これは近い商品」と関係づけていく作業を指します。データ統合やレコメンドに使う商品データを整える下ごしらえだと考えてください。
2. ECや小売でプロダクトマッチングが重要な理由は?
価格比較にも在庫統合にも品揃え分析にもレコメンドにも、結局は同じ商品データを土台として使い回すことになるからです。土台がそろっていなければ、その先の施策の精度もデータ品質と運用の仕方に左右されてしまいます。
3. 従来型マッチングの主な課題は?
人の目とシンプルな一致ルールだけに頼ると、表記ゆれや情報の抜け、担当者ごとの判断のブレ、商品数の増加についていけません。だからこそ標準化・自動判定・人の検証を組み合わせる発想が要ります。
4. AIはどのようにマッチングを改善する?
自然言語処理や画像認識、機械学習を組み合わせることで、文字列の一致だけでは拾いきれない候補まで見つけ出せます。ただし精度は商品カテゴリや学習データ、使う属性次第で変わるので、判断に迷うケースは人に委ねる設計にします。
5. Thunderbitはどのように役立つ?
ThunderbitはAI搭載のウェブスクレイパーとして、商品ページからマッチングに必要な情報を拾い、表形式にまとめる前段階を担います。AIサジェスト、サブページ取得、テンプレート、定期スクレイピングといった機能は対象ページ、プラン、設定によって使える範囲が変わります。マッチング自体の判定精度は、その後の標準化や照合基準、検証のやり方にかかっています。
商品データの管理を見直したいなら、まず対象ページを1つ選び、Thunderbit Chrome拡張機能をダウンロードして、必要な項目を取得できるか、出力形式が照合工程に合うかを確かめてみてください。
ThunderbitでAIプロダクトマッチングを体験 Get Started Free
さらに詳しく知りたい方へ



