
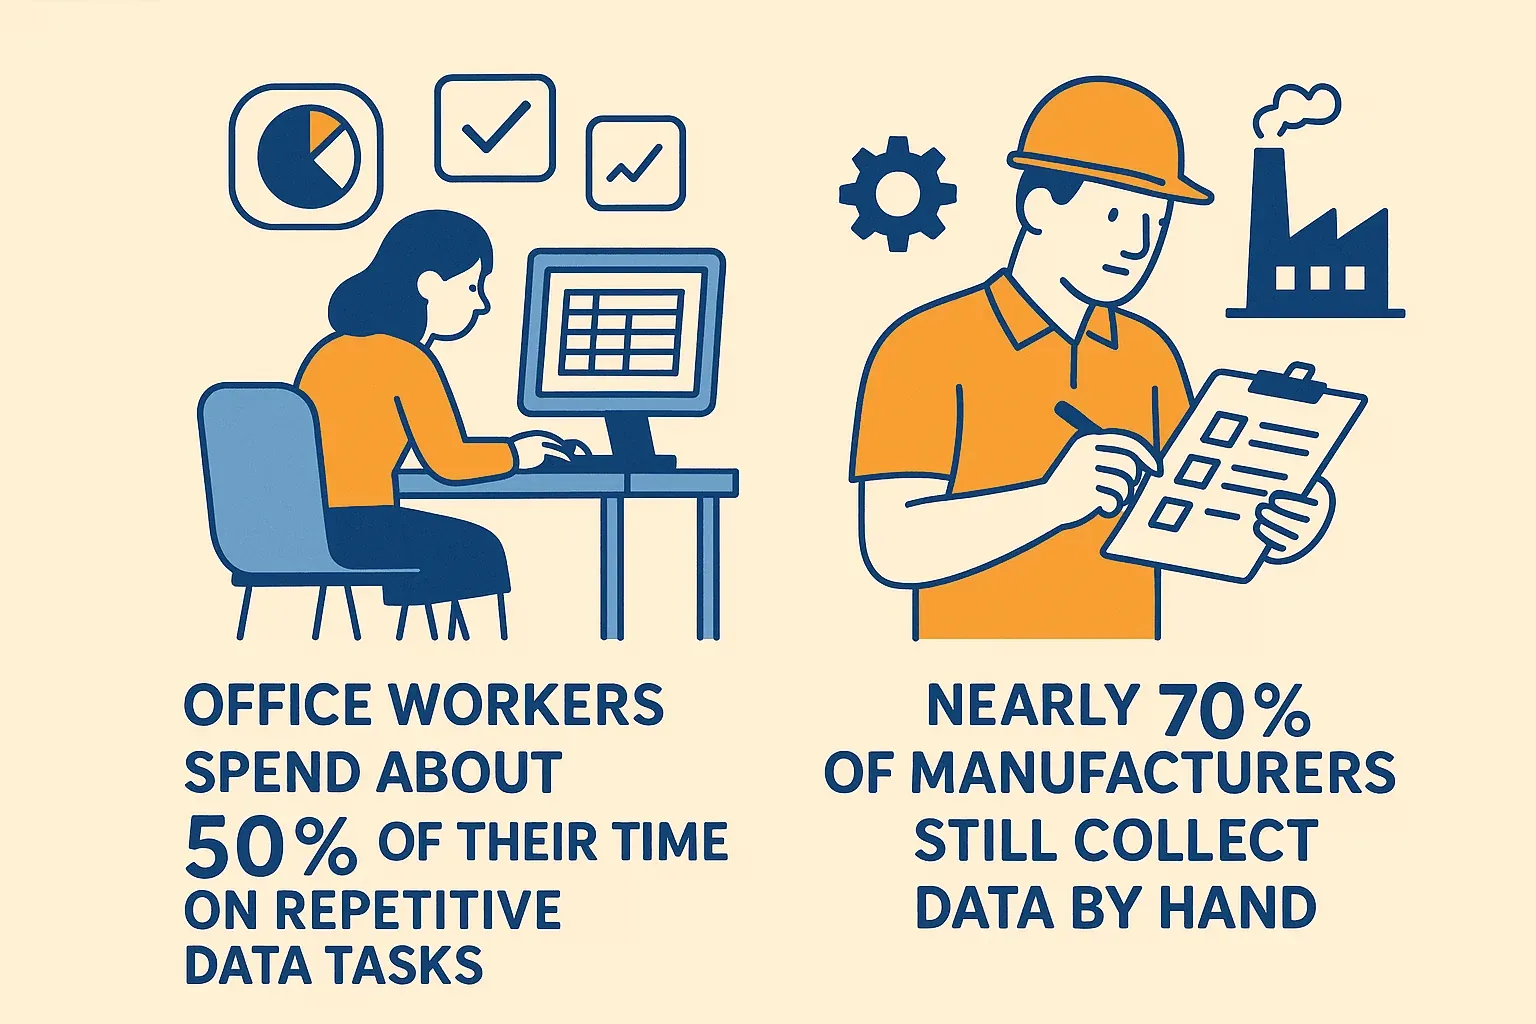
「このデータ、今どこまで反映されてる?」——複数のデータベース、SaaS、API、ウェブサイトを行き来する業務では、この確認だけで一日が終わることもあります。データ量自体も増え続けており、2025年には181ゼタバイトが生成されると予測されています。オフィスワーカーの約50%の時間が繰り返しのデータ作業に消え、製造業の約70%がいまだに手作業でデータを集めているという調査もあるほどです。
この状態を解消する仕組みがデータパイプラインです。情報源からデータを集め、整形・保存し、業務で使うシステムへ自動的に届けます。SaaSと自動化の現場を見ていると、データ連携の設計が甘いだけで業務全体が滞る場面は珍しくありません。この記事では、データパイプラインの仕組みと構成要素、処理方式を整理したうえで、ThunderbitのようなAIウェブスクレイパーをデータ収集工程に組み込む方法まで見ていきます。
データパイプラインを一言で言うと
データを収集元から保存先・利用先まで自動で運び、途中で整形・変換する仕組み——それがデータパイプラインです。イメージがつかみにくければ、次の2つの例が助けになります。
- 配管: 貯水池から蛇口まで水道管が水を運び、途中でろ過するのと同じように、生データも情報源(データベース、API、ウェブサイトなど)からダッシュボードやウェアハウスへ運ばれ、使いやすい形に加工されます(IBM)。
- 工場のライン: ピザ工場が生地・ソース・トッピング・焼成・箱詰めという工程を経るのと同じで、生データも各工程で整形・統合され、分析可能な状態に仕上がっていきます(Medium)。
つまり、複数の情報源から集めたデータを加工し、チームがすぐ使える形で自動的に届ける仕組みです。まとめて動かすバッチ方式と、継続的に低遅延で動かすリアルタイム方式があり、業務要件に合わせて選びます。
3つの工程で成り立つ
- 収集(インジェスト): データベース、API、ファイル、ウェブスクレイパーからデータを取得
- 加工・変換: クリーニング、標準化、リストの統合、合計値の算出など
- 保存・配信: 加工済みデータをウェアハウスやダッシュボード、アプリへ格納し、すぐ使える状態にする
これがないと、手作業のエクスポート、積み上がる一方のスプレッドシート、「このデータ本当に最新?」という不安が常について回ります。
ビジネス側にとっての意味
AIであらゆるウェブサイトからデータを抽出 Get Started Free
データパイプラインはIT部門だけのものではありません。営業、マーケティング、財務、オペレーションなど各現場が、必要な頻度で同じ指標を参照するための土台になります。
- リードへの反応が速くなる: 引用先では、5分以内の連絡と成約率が21倍という関係が紹介されていますが、実際の効果は商材や条件次第です。
- サイロ化を抑えられる: 部門間で指標と更新ルールをそろえれば、数字の食い違いによる調整作業が減ります。ビジネスリーダーの83%がサイロ化を課題視しているという調査もあります。
- 定型業務を自動化できる: 収集・集計・レポート作成の手間が減ります。あるマーケティングチームの例では、レポート関連作業が月80時間削減されました。
- 現場がデータに直接触れられる: 権限のある担当者が更新済みデータへ直接アクセスできれば、IT部門への都度依頼が減ります。
- 投資対効果が見込める場合も: 近代的な統合基盤を導入した企業で3年で170〜295%のROIという事例が紹介されていますが、幅は導入範囲や算定方法によって変わります。
部門別に見ると、恩恵の中身は次のように変わります。
| チーム | パイプラインのメリット | 具体的な効果例 |
|---|---|---|
| 営業 | リアルタイムのリード・顧客データ、CRMの自動更新 | 引用先では、迅速な対応時にリード成約率21倍(Voiso) |
| オペレーション | 統合された最新指標 | 正確な在庫管理で欠品減・予測精度向上(Aampe) |
| マーケティング | 分析の統合・キャンペーン最適化 | レポート作成で月80時間削減(Coupler) |
| 財務 | 自動集計・迅速なレポート作成 | 利益のリアルタイム把握、月次決算の迅速化 |
| 分析/BI | 分析用にクリーンなデータを一元化 | データ整備の手間削減、インサイト提供に集中 |
データパイプラインは、散らばったデータを日々の判断材料へ変え続けるための基盤です。
手作業のままだと何が起きるか
データ連携を人手に頼ると、処理速度・更新頻度・品質のどこかで無理が出てきます。
- 手作業でのやり取り: CSVのエクスポート、メール送信、コピー&ペーストは時間がかかるうえ入力ミスの温床です。オフィス業務の50%がこうした反復作業に費やされているとされています。
- 部門ごとのサイロ: データの定義や更新時点がバラバラだと、レポート同士のズレを調整する作業だけが増えます。経営層の83%がサイロ化を実感しているという調査もあります。
- 更新が遅い: 週次・月次更新のままでは直近の変化を意思決定に反映しづらく、小売業では半数がリアルタイムの売上データを持っていません。
- ミスが混入しやすい: コピー&ペーストの誤り、古いファイルの参照、ロジックの不備などが起きやすく、新規データの47%に重大なエラーが含まれるという調査もあります。
- 変更対応に時間がかかる: 新しい指標やレポートが必要になるたびに個別対応が発生し、提供まで数週間かかることもあります。
データ量や接続先が増えるほど、人手だけで速度と品質を両立させるのは難しくなっていきます。
導入前と導入後で何が変わるか
週次の売上レポートを手作業で作っているケースを例に、変化を見てみましょう。
手作業の場合:
- レポート作成に8時間かかる
- データは常に1週間遅れ
- 依頼が増えるほどミスも手間も増える
パイプライン導入後:
- 要件に応じて毎日、あるいはリアルタイムでデータを自動収集・加工・配信
- レポート更新を自動化し、深夜のExcel作業を削減
- 監視ルールでエラーを早期検出し、更新時点がそろったデータを共有
小売業なら、売上・在庫・マーケティングの状況を毎朝ダッシュボードで確認できるようにするだけで、急落した商品への対応を1週間後ではなく当日に検討できるようになります。
構成要素を分解すると
どんなパイプラインも、次の要素の組み合わせでできています。
- データソース: データベース、アプリ、ファイル、API、ウェブサイトなどの出どころ
- インジェスト/抽出: ソースからパイプラインへデータを取り込む工程
- 変換/加工: クリーニング、統合、フォーマット変換
- 保存: 加工済みデータをウェアハウスやデータベースへ格納
- 配信(消費): ダッシュボード、レポート、アプリでの活用
流れにするとソース → インジェスト → 変換 → 保存 → 配信です。営業パイプラインなら、ウェブサイトからリードを取得(ソース)、抽出(インジェスト)、電話番号を整形(変換)、CRMに保存(保存)、担当者へ通知(配信)という具合になります。
バッチかリアルタイムか
| 項目 | バッチパイプライン | リアルタイムパイプライン |
|---|---|---|
| データ頻度 | 定期的(毎日・毎時・毎週など) | 継続的(秒単位・ミリ秒単位) |
| レイテンシ | 数分~数時間が目安(処理量や設定で変動) | ほぼ即時を目指す(構成や接続先で変動) |
| 主な用途 | 定期レポート、月次集計、大量データの一括処理 | ライブダッシュボード、不正検知、リアルタイムパーソナライズ |
| メリット | 構成が比較的シンプルで、定期集計や過去分析に向く | 低遅延が必要な対応や分析に向く |
| 課題 | 実行間のデータが古くなる可能性 | 複雑で堅牢なストリーミング基盤が必要 |
給与計算や過去分析にはバッチ処理、株取引や在庫管理、不正検知など更新の遅れが業務へ直結する用途にはリアルタイム処理——多くの企業は、必要な更新頻度と運用コストを見ながら両者を組み合わせています。
ウェブスクレイピングはどこに位置づくのか
必要なデータが常に整ったデータベースやAPIで提供されるとは限りません。ウェブサイトやPDF、画像の中に情報が埋まっていて、別途抽出と整形が必要になる場合もあります。
ウェブスクレイパーは、そうしたページなどから情報を抽出する技術です。パイプラインの中では外部の非構造データを取り込むインジェスト手段にあたり、Thunderbitはこの工程をノーコードで進めたい場合の選択肢の一つです。
第三者サイトが対象になる場合は、利用規約や著作権、個人情報の扱い、アクセス頻度を踏まえて収集方法を設計する必要があります。
実務での使いどころ
- 競合価格のモニタリング: 競合サイトの価格を自動収集し、自社価格の調整材料にする(DataHen)
- リード獲得: 利用条件の範囲内でディレクトリやLinkedIn、イベントサイトから見込み客情報を抽出しCRMへ登録
- 市場調査: レビューやフォーラム、SNSコメントを集めて感情分析やトレンド把握に使う(自動分類の結果は人による文脈確認が必要)
- 不動産: 複数サイトの物件情報を集約し、地域ごとの市場動向分析や独自データベース構築に活用(Outscraper)
- 公共データの収集: 政府や学術機関、公共ポータルから、公開条件と利用目的に沿って研究・法令遵守用のデータを取得
ウェブスクレイパーは、外部の非構造データをパイプラインへ取り込む入口です。取得後は出典・更新時点・利用条件を記録し、業務判断に使える構造へ整えることが欠かせません。
Thunderbitでデータ収集の工程を組む
Thunderbit AIウェブスクレイパーを試す 2クリックであらゆるウェブサイトからデータ抽出。 Get Started Free
Thunderbitは、営業リスト作成やEC商品情報の取得、競合情報の整理など、ウェブ上のデータを短時間で表形式にしたい非エンジニア向けのAIウェブスクレイパーです。実際の取得可否や精度はページ構造、アクセス制限、ログイン状態、対象サイトの条件によって変わります。大規模基盤の構築や複雑なAPI連携が必要な場合は、開発者向けの手段も含めて比較してください。
何ができるか
- AIサジェストで2クリック抽出: 「AIサジェストフィールド」を使うと、AIがページを解析して「商品名」「価格」「評価」などのカラム候補を提示します。ページに合わせて内容を見直してから抽出でき、コーディングやセレクタ設定は基本的に不要です(Skywork)。
- ウェブだけでなくPDF・画像も: 対応形式では、AI OCRでPDFや画像からも抽出でき、34言語に対応します(精度はファイル品質・文字種・レイアウト次第)。
- サブページ・ページネーションも自動巡回: 構造と設定が対応していれば、個別プロフィールや商品詳細ページもたどって結果に統合できます。
- 主要サイト向けテンプレート: Amazon、Zillow、LinkedInなど、用意されたテンプレートから選べる場合があります(利用可否はサイトや提供状況次第)。
- 各種ツールへ直接エクスポート: Excel、Google Sheets、Airtable、Notionへの直接出力とCSV/JSONダウンロードに対応(出力先や条件はプランにより変動)。
- 定期スクレイピング: 「毎週月曜9時」のようなスケジュールを設定でき、手動更新の頻度を減らせます。
- AIデータ加工: フィールドAIプロンプトで抽出時のラベル付け、分類、翻訳を設定可能。精度はデータとプロンプト次第なので用途に応じた検証が必要です。
具体例:競合レビュー監視パイプライン
マーケティング担当者が競合3サイトのレビューを追う場合、次のような構成が考えられます。
- 各サイトを開き拡張機能を起動、AIサジェストで「レビュー内容」「評価」「日付」を抽出
- 対応していれば週次スクレイピングを予約し、最新レビューをGoogle Sheetsへ出力
- AIプロンプトで感情(ポジティブ/ネガティブ/ニュートラル)をタグ付けし、サンプルを人が確認
- 収集・分類済みのレビューを毎週ダッシュボードへ反映し、転記作業を削減
ページ構造や件数次第では、何時間もかかっていた収集が数分で終わることもあります。ただし定期運用に移す前には、抽出精度・重複・分類結果・更新時刻の検証を必ず挟んでください。
AIが加わったパイプラインの広がり
AIを組み込んだパイプラインでは、データを動かすだけでなく、途中で整形・分類・異常検知まで行う構成が増えています。
- 自動データ加工: 「地域ごとに売上と天気データを組み合わせて」といった自然言語の指示でクレンジングや結合を進められる構成もあります(Airbyte)。結果はデータ定義と品質基準に照らした検証が必要です。
- リアルタイム分析: ストリーミング基盤と判定ルール、通知先を連携すれば、処理中に異常を検知し、競合の値下げを即座に営業へ知らせるといった対応も可能になります。
- AIによる仮説提示: 「X地域の売上が15%減、競合のプロモーションが原因かもしれない」のような仮説を提示できますが、因果関係は元データや担当者の分析で確認する必要があります。
- 自然言語インターフェース: 作りたいパイプラインを言葉で説明し、構成案を生成してもらう使い方も今後広がっていくと見られます。
Thunderbitでは現時点で、AIフィールドサジェスト、抽出時のデータ加工、自然言語によるスケジュール設定が使えます。範囲は対象ページ、設定、プランによって変わるため、AIの提案を人が検証する運用と組み合わせることで、収集そのものより次の業務判断につなげやすくなります。
まとめ
- データパイプラインは、複数の情報源と利用先をつなぎ、収集・加工・保存を経てすぐ使える状態にする仕組みです。
- 手作業やサイロ化、更新の遅れを減らせますが、効果は対象業務やデータ品質、運用設計次第で変わります。
- 部門ごとに使い道は異なります。営業はリード対応、マーケティングは分析、オペレーションは在庫把握、経営層は指標の一元化に使えます。
- ウェブスクレイパーは外部の非構造データを取り込む手段の一つで、ThunderbitのようなAIツールはウェブデータを表形式にしてパイプラインへ渡したい場合の候補になります。
- AIは加工や分析の補助にも使えますが、自動処理の結果には人による検証と運用ルールが欠かせません。
コピー&ペースト作業に今も時間を取られているなら、まず週次レポート1本、あるいは対象ページ1つに絞って自動化の範囲を決めるところから始めると進めやすくなります。Thunderbitを試す場合も、取得精度・更新頻度・出力形式を確認してから対象業務を広げるのが現実的です。
もっと詳しく知りたい方は、Thunderbitブログのガイドや、AIを使ってWebサイトのデータをExcelに取り込む方法、賢いリードリストの作り方も参考にしてください。
よくある質問
1. データパイプラインを簡単に説明すると?
複数の情報源からデータを自動で集め、必要な加工をして保存先・利用先へ届ける仕組みです。会社の中を流れる配管をイメージすると理解しやすくなります。
2. なぜビジネスチームにとって重要なのか?
定型的なデータ作業を減らし、更新時点や指標をそろえやすくなるためです。意思決定の速度やROIへの効果は、導入範囲やデータ品質、運用方法によって変わります。
3. ウェブスクレイパーはパイプラインのどこに関係する?
APIやエクスポート手段のない外部データを取り込むインジェスト手段の一つです。競合価格やレビュー、公開ディレクトリの収集に使えますが、利用規約や著作権、個人情報、アクセス頻度への配慮は必須です。
4. Thunderbitはどんな場面のデータ収集に向いている?
ウェブページ上の情報をコードなしで表形式に整理したい場合です。対応ページではAIによるフィールド提案と2クリックの操作で構造化データを抽出でき、サブページやテンプレート、各種ツールへの出力にも対応します。範囲はページ構造や設定、プラン次第です。
5. AI時代のデータパイプラインはどう変わっていく?
データの移動に加え、加工・分類・異常検知・分析補助にもAIが使われるようになります。自然言語による構成支援も広がる見込みですが、リアルタイムの自動判断には品質基準・監視・人による検証が引き続き必要です。
パイプラインへの組み込みを試す場合は、Thunderbitをダウンロードし、まず1ページで抽出項目・精度・出力形式を確認してから定期運用を検討してください。
さらに詳しく
AIウェブスクレイパーで手間なくデータパイプラインを構築 Get Started Free



