
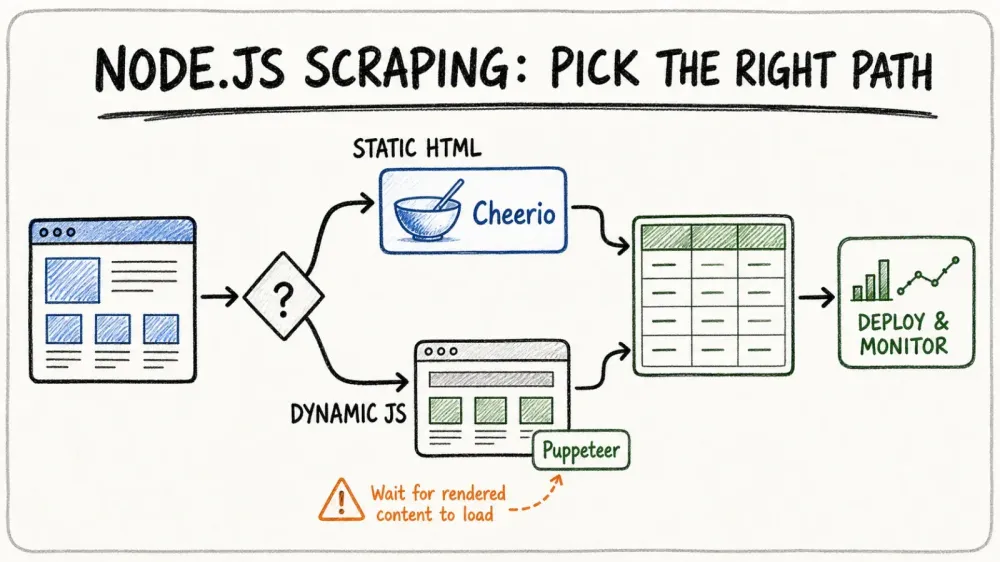
ウェブ上で扱われるデータ量はかつてないほど増えており、2026年の今、Node.js は「力任せではなく、賢く web scraping したい」チームを引っ張る存在になっています。営業、EC、あるいは私のようなデータ好きなら、スクレイピングはもう“必要な情報を取る”だけの作業じゃないと感じているはずです。どれだけ速く、どれだけ大規模に、そしてIPをデジタルの監獄送りにしないかが勝負です。需要は衰えておらず、公開Webデータは静かに、でも着実に、価格分析からLLM学習パイプラインまで、現代の多くのチームが土台として使う入力データになっています。そのぶん、競争も重要性もこれまでになく高まっています。
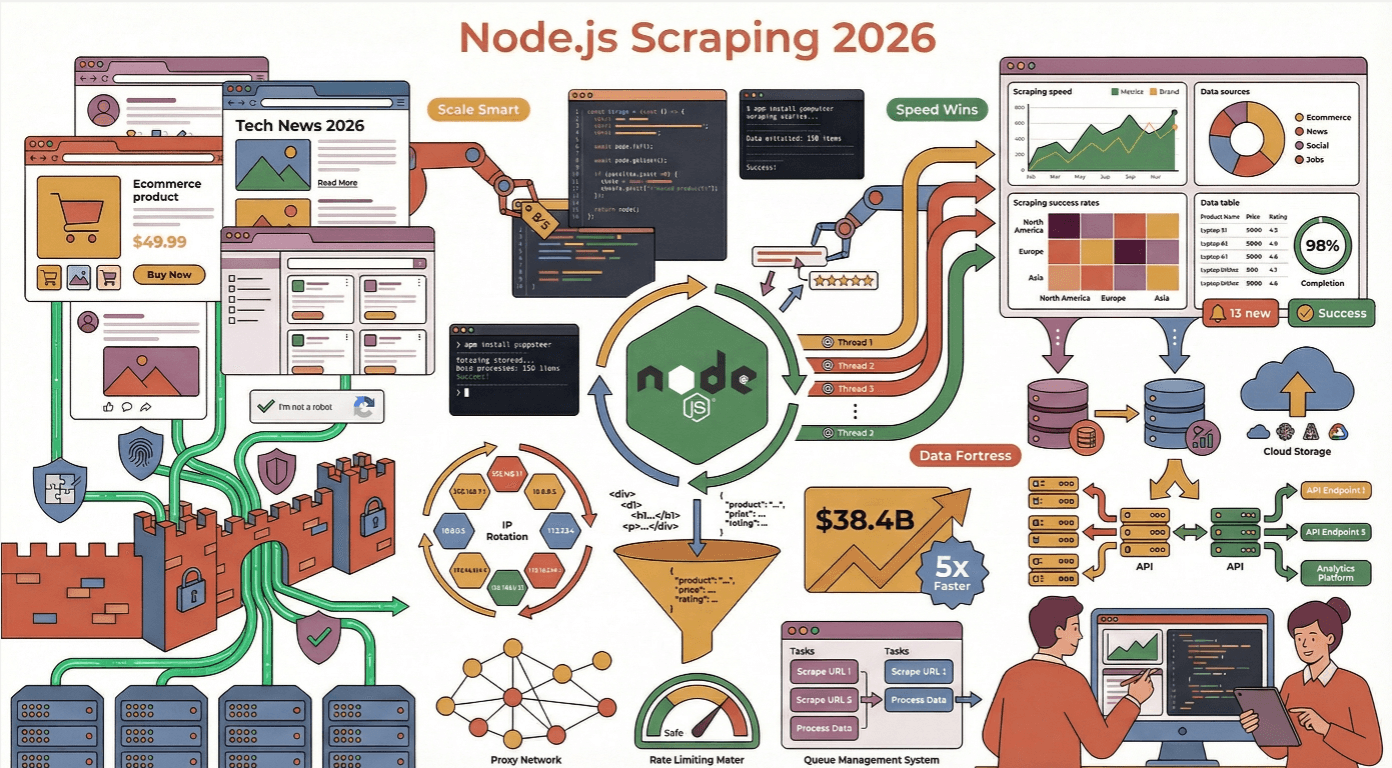
ただし、ここで厄介なのが現代のWebです。動的コンテンツ、ボット対策の罠、そして頻繁に変わるレイアウトが立ちはだかる要塞みたいなもの。私も数え切れないほどスクレイパーが失敗する現場を見てきましたが、その多くはベストプラクティスを無視したり、アンチスクレイピング対策を甘く見たりしたせいでした。そこで今回は、Node.js による Webスクレイピングの効率化について、実践的なベストプラクティスを、少しの失敗談とユーモア、そしてたっぷりの実践ノウハウを交えて解説します。
Webスクレイピングの効率化に Node.js を選ぶ理由
何百、何千というページを一気に取得しようとしたことがあるなら、速度と並列処理がすべてだとわかるはずです。そこで真価を発揮するのが Node.js です。非同期でブロッキングしない I/O モデルは、大量の同時ネットワークリクエストをさばくために作られており、まさにWeb界の究極のマルチタスク選手と言えます(Node.js Docs)。他の言語が1件ずつの完了待ちで詰まりがちな場面でも、Node.js はイベントループを回し続け、カフェインを入れたサーカス芸人みたいにリクエストをさばいていきます。
リアルタイム更新や大規模抽出が必要なシナリオ、とくに対象サイトが JavaScript で動的に描画される場合には、Node.js が Python や Java を上回るケースを何度も見てきました。実際、約40%の開発者 がバックエンドや自動化タスクに Node.js を使っており、世界で最も人気のあるWeb技術になっています。
Node.js と他の Webスクレイピングフレームワークの比較
少しマニアックな話をしましょう。Node.js が競合と比べてどうなのか、整理するとこんな感じです。
| フレームワーク | 強み | 弱み | 主な用途 |
|---|---|---|---|
| Node.js | 非同期処理が得意、並列処理に強い、npm エコシステムが豊富、動的サイトにネイティブな JS を活用可能 | メモリ消費が大きいことがある、async/await を使わないとコールバック地獄になりやすい | リアルタイムスクレイピング、JavaScript 多用サイト、拡張性の高いマイクロサービス |
| Python | スクレイピング用ライブラリが豊富(BeautifulSoup、Scrapy)、書きやすい | 大量並列処理はやや苦手、JavaScript レンダリングサイトに弱い | 静的HTML、調査、プロトタイピング |
| Java | 型安全性が高く、エンタープライズ用途に強い | コードが冗長、素早いスクリプトには不向き | 大規模・企業向けスクレイピング |
| Go | 高速で並列処理に効率的 | エコシステムが比較的小さく、習得のハードルが高め | 高性能・低遅延のスクレイピング |
多くのビジネスユーザーにとって、Node.js はちょうどいいバランスです。高速で柔軟、そして JavaScript 主導の現代的なWebにぴったり(Thunderbit Blog)。
堅牢な Node.js Webスクレイピング環境の構築
良いスクレイパーは、しっかりした土台から始まります。私がよく使う構成は次の通りです。
- プロジェクト構成: モジュール化を徹底します。
/src、/libs、/configのようなフォルダを使いましょう。APIキーやプロキシなどの機密情報は、dotenvを使って環境変数に保存します(Thunderbit Guide)。 - HTTPクライアント: リクエスト送信用には axios、got、または node-fetch を使います。
- HTML解析: 静的HTMLなら Cheerio、動的コンテンツなら Puppeteer や Playwright が便利です。
- 補助ツール: データ整形には Lodash、バリデーションには validator.js や Joi を使います。
- テストとLint: テストは Mocha、コード品質は ESLint で担保します(LogRocket)。
必須の Node.js Webスクレイピングライブラリ
- HTTPクライアント(axios / got / 標準
fetch): リクエスト送信用です。先に補足すると、Node.js v18 以降ではfetchを追加インストールなしでネイティブに使え、Node.js v22 では安定版になりました。新しめの Node.js で新規開発するなら、node-fetchは基本的に不要で、fetchをそのまま呼べば十分です。私は、インターセプター、自動JSON処理、Node とブラウザで共通の Promise API が欲しいときは axios を選び、リトライ、ストリーム、HTTP/2 をすぐ使いたいときは got を選びます。用途に合うものを使えばOKで、短いスクリプトならネイティブfetchで問題ありません。 - Cheerio: jQueryライクで高速なHTMLパーサー。静的ページに最適で、約0.5秒で解析できます(Oxylabs)。
- Playwright / Puppeteer: 動的で JavaScript 依存の強いサイト向けのヘッドレスブラウザ自動化ツールです。1ページあたり約4秒とやや遅いものの、ページ読み込み後にコンテンツが表示されるサイトでは必須です(Bright Data)。2026年にゼロから始めるなら、Playwright が標準的な選択肢です。Chromium / Firefox / WebKit をすぐ扱え、トレースビューアも内蔵、そして元々 Puppeteer を作ったチームが Microsoft で主導しています。Puppeteer は今も Chrome 専用の用途で保守されていますが、最近のリリースノートは新機能より Chrome 互換アップデート中心です。
- dotenv: 環境変数の管理用。
- csv-writer/jsonfile: データ出力用。
よくある Node.js Webスクレイピングの落とし穴を避ける
スクレイパーがブロックされたり、落ちたり、ひどく汚いデータを吐き出したりする場面を、私はもう何度も見てきました。注意すべきポイントは次の通りです。
- robots.txt と利用規約を無視する: スクレイピング前には必ず確認しましょう。これを破るとIPをBANされるだけでなく、法的トラブルに発展することもあります(ScraperAPI)。
- サーバーに負荷をかけすぎる: リクエストを連打しないこと。1〜3秒のランダム遅延でスロットルし、並列数を制御し、過剰に動き回るロボットのような振る舞いは避けましょう(ScrapeGraphAI)。
- エラー処理をしない: リクエストは必ず try/catch で包み、HTTPエラーを処理し、失敗をログに残しましょう。一時的なエラーは指数バックオフで再試行します(ScrapeGraphAI)。
- リクエストヘッダーを忘れる: 現実的な User-Agent を使い、ローテーションさせます。Accept-Language、Referer なども追加して、本物のブラウザに近づけましょう(ScrapeGraphAI)。
アンチスクレイピング対策を回避する方法
現代のWebサイトは、ボット対策技術でがっちり武装しています。そこで、私がデジタルの地雷原を避けるときの方法を紹介します。
- プロキシ / IP のローテーション: プロキシプールを使い、IPを切り替えてBANを避けます(Medium)。
- ヘッダーのランダム化: 1リクエストごとに User-Agent、Accept-Language などを変えます。
- ヘッドレスブラウザのステルス化:
puppeteer-extra-plugin-stealthのようなプラグインで、自動化の痕跡を隠します。 - 人間らしい挙動の再現: ランダム遅延、マウス移動、スクロール、さらには টাইポのような入力ミスまで再現します(ZenRows)。
Node.js スクレイパーで人間らしい挙動を再現する
ここからが少し面白く、少し変わった部分です。クリックやスクロールを即座に実行するのではなく、スクレイパーに次のような動きをさせます。
- 操作の合間にランダムな間隔を入れる(
await page.waitForTimeout(randomDelay)) - マウスを小刻みに動かす(
page.mouse.move(x, y)) - ランダムな遅延や軽い টাইपोを混ぜて入力する(
page.type(selector, text, {delay: random(100,200)})) - ただ一気に最下部まで行かず、ムラのあるスクロールをする
こうした工夫で、保護されたサイトでの成功率は大きく上がります(ScraperAPI)。
Thunderbit で複雑なデータ抽出をもっと簡単に
AIであらゆるサイトからデータを抽出 面倒な前処理は不要。Thunderbit のエージェント型 Webスクレイパーなら、どんなページでも読み取り、ワンクリックでデータを抽出できます。Node.js の保守コードも不要です。 Get Started Free
ここで本音を言うと、スクレイピングは大変です。でも、そうである必要はありません。だからこそ私たちは Thunderbit を作りました。
Thunderbit は、エージェント型の Webスクレイパー Chrome拡張機能 で、自然な日本語だけで任意のサイトからデータを抽出できます。まず「One Click Extract」をクリックし、AIにページ内容を理解させたうえで「Scrape」を押すだけ。寝ずに働いて、昇給も要求しないジュニア開発者がいるようなものです。
さらに、Thunderbit には API もあるので、Node.js のワークフローにそのまま組み込めます。何千行ものスクレイピングコードを書く代わりに、動的コンテンツ、サブページ、ページネーションまで Thunderbit に任せられます。あとは構造化データを CSV、JSON、または Google Sheets / Airtable / Notion に直接出力して、いつもの仕事に戻るだけです(Thunderbit Blog)。
Thunderbit Chrome拡張機能を無料で試す 無料のChrome拡張機能をインストールして、ワンクリックで構造化データを抽出しましょう。Node.jsアプリから Thunderbit のAPIを呼び出すこともできます。 Get Started Free
Thunderbit と従来の Node.js スクレイピングの比較
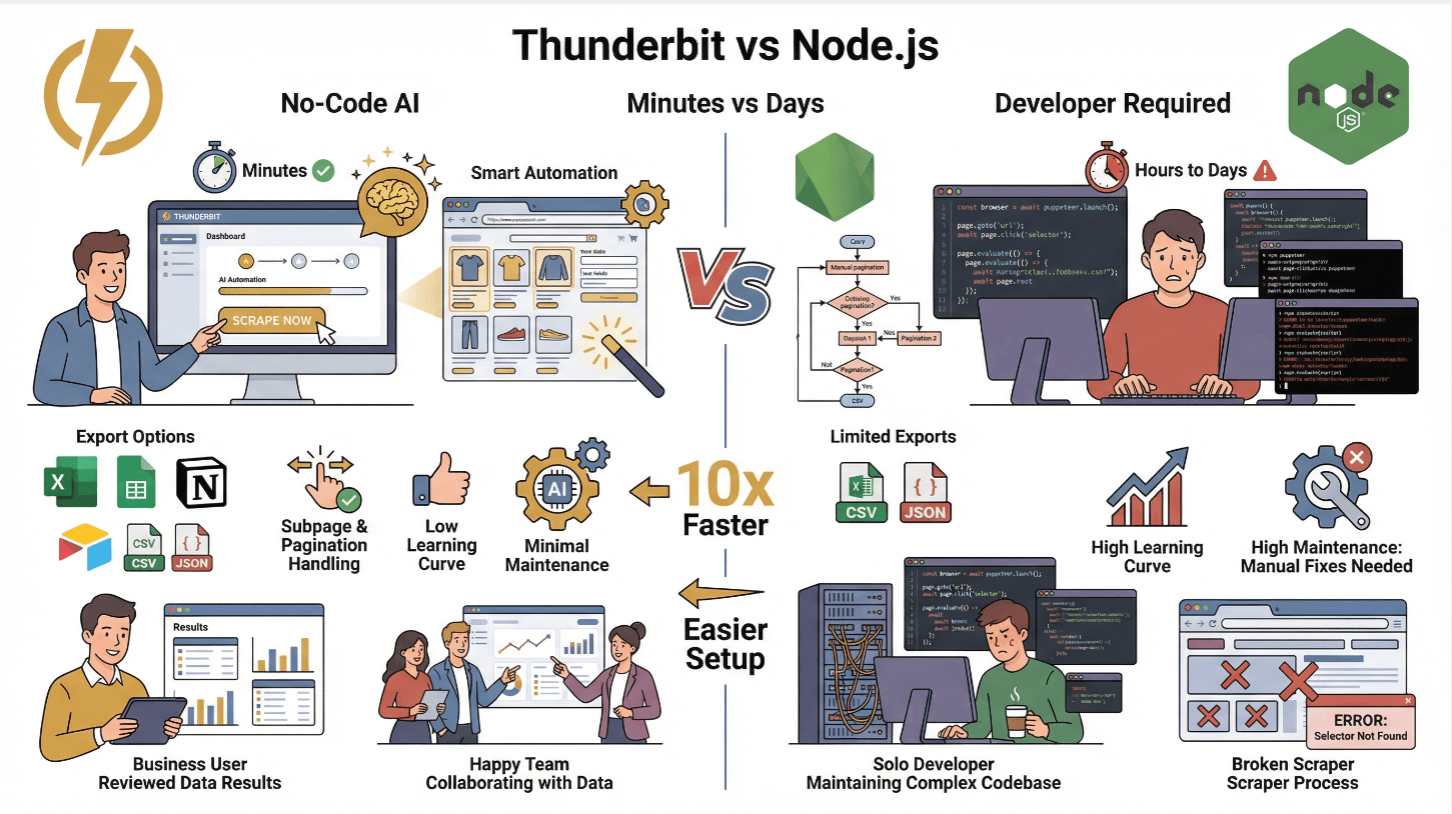
| 機能 | Thunderbit | 従来の Node.js スクレイパー |
|---|---|---|
| 導入時間 | 数分(コード不要) | 数時間〜数日(実装・テストが必要) |
| 動的コンテンツ対応 | あり(AI + ブラウザ) | あり(Puppeteer / Playwright 使用) |
| サブページ・ページネーション | ワンクリック | 手動実装が必要 |
| データ出力 | Excel、Sheets、Notion、Airtable、CSV、JSON | CSV / JSON(カスタム実装) |
| 学習コスト | 低い(ビジネスユーザー向け) | 高い(開発者向け) |
| 保守性 | 最小限(AI が変化に適応) | 高い(サイト変更ごとの修正が必要) |
Thunderbit は、非エンジニアのチームや、面倒な実装を飛ばして素早くインサイトを得たい人に最適です。上級者であれば、Thunderbit の API を使って大規模スクレイピングを自動化することもできます(Thunderbit Docs)。
Cheerio と Puppeteer を組み合わせて動的コンテンツに対応する
これは私が一番気に入っている Node.js スクレイピングの組み合わせです。やり方はこうです。
- Puppeteer でページを読み込み、JavaScript を実行する(
networkidleを待って、全コンテンツの読み込みを確認)。 - HTMLを取得するために
await page.content()を使う。 - Cheerio で解析する。HTML を Cheerio に渡せば、jQuery 風の高速な解析とデータ抽出ができます。
このハイブリッド方式なら、動的コンテンツには Puppeteer の力を、解析速度には Cheerio の速さを使えるので、両方のいいとこ取りができます(Browserless)。
パフォーマンスのコツ: 必要な要素だけを選びましょう。Cheerio は DOM 全体をメモリに読み込むため、広すぎるセレクタは避け、同じページを繰り返し取得するなら結果をキャッシュしてください(Oxylabs)。
HTML解析とデータ抽出を最適化する
- 具体的なセレクタを使う:
$('body *')のような広すぎる指定は避け、必要な部分だけを狙いましょう。 - 大きなページはストリーミング処理: 非常に大きなHTMLは、分割して処理するかストリーミングを検討します。
- レンダリング済みHTMLをキャッシュ: 同じURLを再訪するなら、HTMLを保存して無駄な再取得を防ぎます。
- データの検証と整形: バリデーションライブラリを使って、ゴミデータがDBに入るのを防ぎます(ScrapeGraphAI)。
クラウドでスケールする Node.js Webスクレイパーのデプロイ
大規模にスクレイピングしたいなら、クラウドネイティブ化するタイミングです。
- スクレイパーを Docker 化:
Dockerfileを作成し、コードをコピーして、依存関係をインストールし、エントリーポイントを設定します。 - クラウドにデプロイ: 小規模なら AWS EC2、Google Cloud Compute、Azure VM を使います。本格的にスケールさせるなら、Kubernetes や AWS ECS/EKS、Google Cloud Run、Azure Kubernetes Service のような管理サービスが向いています(DigitalOcean)。
- Kubernetes でオーケストレーション: 複数の Pod を起動し、需要に応じてオートスケールし、ロードバランサーでURLを分散します。
- ジョブをスケジュール: CloudWatch Events や Cloud Scheduler、あるいは cron ジョブで定期実行します。
ある実例では、Kubernetes Pod を5から10に増やしただけで、400ページのスクレイピング時間が数分から1分未満に短縮されました(DigitalOcean)。
スクレイピング基盤の監視と自動スケーリング
- ログ管理: ログを CloudWatch、Stackdriver、Datadog に送ります。エラーや遅延に対してアラートを設定しましょう。
- ヘルスチェック: 1分あたりの取得ページ数、エラー率、Podの健全性などを Prometheus と Grafana で可視化します。
- オートスケーリング: Kubernetes の HPA(Horizontal Pod Autoscaler)を使い、CPU 使用率やリクエスト数に応じて Pod を増減させます。
ネットワークの一時的な不調や短時間のBANから復旧できるよう、指数バックオフ付きの再試行は必ず入れてください。
データ保存と後処理のベストプラクティス
データを取得したら、保存とクリーニングが必要です。
- 小規模ジョブ: CSV、JSON に出力するか、Google Sheets、Airtable、Notion に送ります(Thunderbit なら標準機能で対応できます)。
- 大規模ジョブ: 構造化データなら SQL(MySQL/PostgreSQL)、半構造化データやスキーマ変更の多いデータなら NoSQL(MongoDB、DynamoDB)が向いています(ScrapeHero)。
- クラウドストレージ: 生データやバックアップには S3 または Google Cloud Storage を使います。
- データクリーニング: フィールドの検証、日付や数値の正規化、重複削除は必ず行いましょう。スキーマバリデータでデータ品質を担保します(ScrapeGraphAI)。
生データと整形後データの両方を残しておくことが大切です。あとで再処理やデバッグが必要になることは珍しくありません。
結論: Node.js Webスクレイピング効率化の要点
スクレイピングコードは不要 Thunderbit のエージェント型 Webスクレイパーが、自作スクレイピングスクリプトの作成・保守とどう違うのかをご覧ください。 Get Started Free
最後に、重要なポイントをまとめます。
- Node.js の非同期性能を活用することで、大量かつ並列なスクレイピングが可能になります。とくに JavaScript 多用サイトで威力を発揮します。
- 適切なツールを組み合わせる: リクエストには axios/got、静的HTMLには Cheerio、動的コンテンツには Puppeteer を使い、速度と柔軟性を両立させましょう。
- ボット対策を避ける: プロキシやヘッダーをローテーションし、人間らしい挙動を再現し、robots.txt を尊重します。
- Thunderbit でシンプルに: ビジネスユーザーや素早い検証なら、Thunderbit で AI を使って複雑なデータを抽出し、API で Node.js スタックに接続できます。
- 大規模運用に備える: Docker 化し、Kubernetes で制御し、監視を徹底して信頼性を高めましょう。
- データを保存し、整える: 用途に合った保存先を選び、使う前に必ず検証してください。
Web はこれからも複雑になる一方ですが、今回のベストプラクティスを押さえれば、Node.js スクレイパーは高速で安定し、アンチボット対策の競争でも一歩先を行けます。もし深夜2時のセレクタデバッグに疲れたら、思い出してください。Thunderbit の AI はいつでも起きています。
もっと学びたい方は、詳しい解説が満載の Thunderbit Blog をチェックするか、Thunderbit の Chrome拡張機能 を試して、スクレイピングの簡単さを体験してみてください。
Thunderbit エージェント型 Webスクレイパーで抽出 Thunderbit の Web Scraper API を使えば、自分の Node.js コードから抽出処理を起動できます。無料プランも用意されています。 Get Started Free
FAQ
1. 2025年に Node.js が Webスクレイピングに特に向いているのはなぜですか?
Node.js の非同期でイベント駆動のモデルは、数千件規模の同時リクエストを処理できるため、大量データやリアルタイム更新のスクレイピングに最適です。巨大な npm エコシステムとネイティブ JavaScript 対応も、現代的な JavaScript 多用サイトにぴったりです(Node.js Docs)。
2. Node.js でスクレイピングするときにブロックされない方法は?
プロキシをローテーションし、リクエストヘッダーをランダム化し、ランダム遅延でリクエストを抑制し、Puppeteer などでマウス移動・スクロール・ টাইピングといった人間らしい挙動を再現します。robots.txt とサイトの規約は必ず守りましょう(Medium)。
3. Node.js スクレイパーでは Cheerio と Puppeteer をどう使い分ければいいですか?
静的HTMLを高速に解析したいときは Cheerio を使います。JavaScript で動的にコンテンツが読み込まれるサイトには Puppeteer が向いています。最も効果的なのは、Puppeteer でページを描画し、その後 Cheerio でHTMLを解析する方法です(Bright Data)。
4. Thunderbit は Node.js Webスクレイピングをどう簡単にしますか?
Thunderbit は、AI と自然言語プロンプトを使って、任意のWebサイトから構造化データを抽出できます。コーディングは不要です。動的コンテンツ、サブページ、ページネーションにも対応し、Node.js との連携用APIも提供しています。データは Excel、Google Sheets、Airtable、Notion に直接出力できます(Thunderbit Blog)。
5. クラウドで Node.js スクレイパーをスケールし、監視する最適な方法は?
スクレイパーを Docker 化して Kubernetes などのクラウド管理サービスにデプロイし、オートスケーリングで需要の急増に対応します。ログやメトリクスは CloudWatch や Prometheus で監視し、エラーや遅延に対するアラートも設定しましょう(DigitalOcean)。
Webスクレイピングを次のレベルへ進める準備はできましたか? Thunderbit をぜひ試して、あなたのスクレイパーが速く、ステルス性が高く、常に一歩先を行けるようにしましょう。
エージェント型 Webスクレイパーを試す Get Started Free
詳しくはこちら




