
営業やマーケティングの現場で「データを外から買う」という選択肢が出るたびに、必ず議論になるのが鮮度と出所の問題です。データドリブンな手法を取り入れた企業ではマーケティングROIが最大5倍に伸びたという調査もありますが、これは施策とデータ品質が噛み合った場合の話です。逆に扱いを誤れば、プライバシー違反で数百万ドル規模の制裁金を科された企業の例が示す通り、ブランドへのダメージは軽くありません。
 このガイドは、消費者データを購入・取得する立場の営業、マーケティング、リサーチ担当者に向けて、データ種別ごとの調達ルート、品質と出所の検証手順、プライバシー面の注意点を一通り整理したものです。あわせて、仲介を挟まずに公開Webデータを自社で集める手段としてThunderbitがどこまで使えて、どこからは自分で判断すべきかも実務目線でまとめます。
消費者データ購入の基礎知識と見落としがちなリスク
データスクレイピングとは?2026年に実践する方法 Get Started Free
消費者データの購入を一言でいうと、年齢・性別・所在地・購買履歴・レビューといった個人に紐づく情報を外部から取得し、事業判断の材料にする行為です。扱うデータの種類は、大きく次の4つに分かれます。
- 属性データ: 年齢、性別、所在地、収入、学歴
- 行動データ: 購買履歴、サイト訪問履歴、アプリ利用状況
- 心理属性データ: 興味関心、価値観、ライフスタイル
- エンゲージメントデータ: メール開封、SNS反応、レビュー投稿
購入の流れ自体は単純で、必要なデータを定義し、プロバイダーを選び、価格を交渉し、スプレッドシートやAPI経由で受け取る、というだけです。難しいのはここからで、ヨーロッパのGDPRやカリフォルニア州のCCPAといった規制が、データの入手元・保存方法・利用目的にそれぞれ制約をかけてきます。
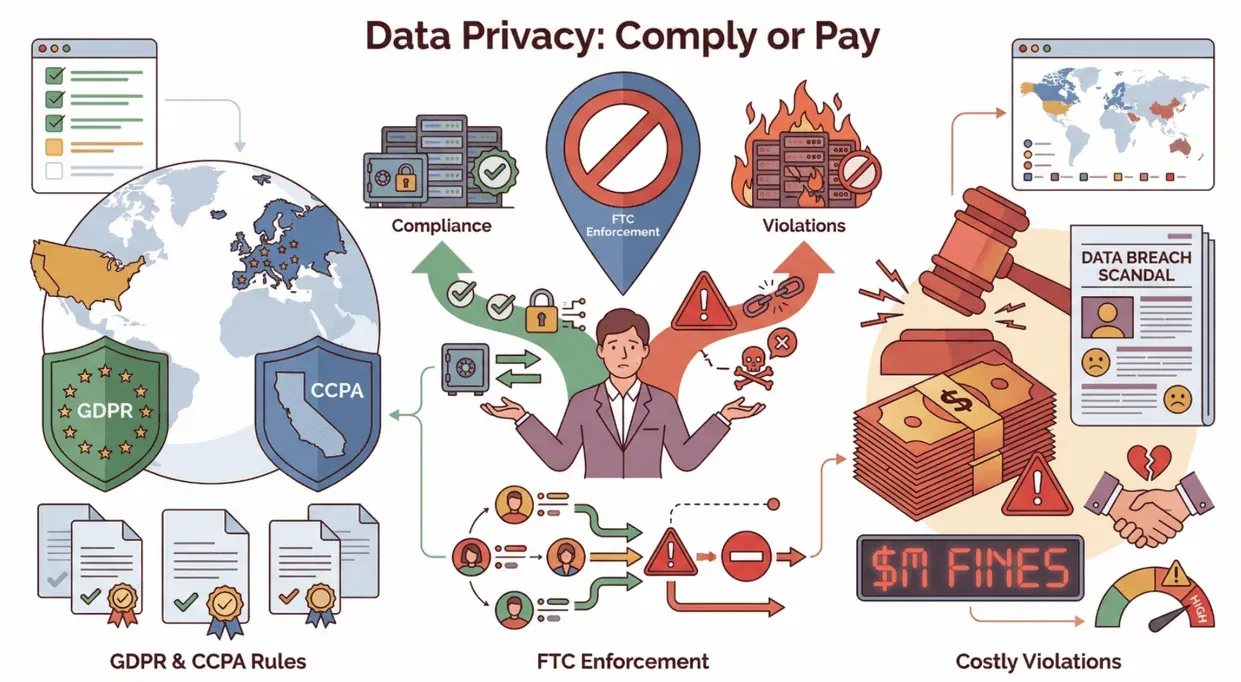 規制強化の動きは実際に加速しています。カリフォルニア州では2026年1月1日にDROPプラットフォームが稼働し、消費者が一括で全登録ブローカーへ販売停止を請求できるようになりました。8月1日以降は、違反したブローカーに1人あたり1日200ドルの罰金が科されます。連邦取引委員会(FTC)も動きを強めており、2026年5月にはKochavaとその子会社に対し、同意なく数億台のモバイル端末の位置情報を販売した行為を禁止しました。2024年のGravy Analytics/Venntelへの措置に続く事例です。つまり、ブローカーの説明を鵜呑みにせず、取得経路・同意記録・契約上の利用範囲まで自分たちで照合する姿勢が前提になっています。
要は、購入したデータの価値は量ではなく、出所・鮮度・利用権限をどこまで検証できたかで決まる、ということです。
消費者データが営業成長の材料になる理由
よく引用される数字を並べると、次のようになります。
- データを軸に意思決定する企業ほど20%高い売上成長を記録しているという調査
- 消費者インサイトの精度がキャンペーンROIを5倍押し上げたという分析
- 鮮度の高いデータで動く営業チームはクロージングが10〜15%早いという報告
どれも景気の良い数字ですが、条件は共通していて、業務内容と評価軸を先に固め、品質を確かめたデータを充てた場合の結果です。業務ごとに分解すると、データの有無で何がどう変わるのかがはっきりします。
| ユースケース | データなしの課題 | 消費者データを購入するメリット |
|---|---|---|
| リード獲得 | 対象条件を定義しにくく、画一的なアプローチになりやすい | 属性・行動条件による候補の絞り込み、CVR改善の検証 |
| 市場調査 | 判断材料が限られ、トレンド把握が遅れやすい | 更新時点に近い情報による洞察、商品戦略を見直す材料 |
| 業務自動化 | 手入力、対応の遅さ | 条件に応じた自動トリガー、営業サイクル短縮の検証 |
| 顧客セグメンテーション | 一律メッセージ | パーソナライズ施策の設計、ロイヤルティ指標の比較 |
| コンプライアンス監視 | 見落とし、根拠の乏しい推測 | リスク兆候の記録、問題の早期把握 |
つまり効果を左右するのは保有データ量ではなく、目的に合う品質のデータを適切なタイミングで使い、施策前後の指標を比較できているかどうかです。
データブローカー経由の調達方法とその限界
企業が消費者データを調達してきたルートは、おおむね3つに集約されます。
- データブローカー(Acxiom、Experian、CoreLogicなど): 公的記録やロイヤルティプログラム、アンケートから情報を集約し、マーケターや保険会社、不動産会社へ再販売します(Built In)。
- 第三者プラットフォーム: 属性・興味関心・行動で絞り込んだリストを販売するオンライン市場です。
- 直接提供事業者: アンケート会社や会員カード運営会社など、自社収集データをそのまま販売する事業者です。
依頼してから費用を支払い、数千〜数百万件のレコードを受け取る、という流れ自体はどのルートでも大きく変わりません。ただし、この方式には無視できない弱点が積み重なっています。
- 更新間隔が長い: 四半期に一度、あるいはそれ以下の頻度でしか更新しないブローカーもあり、手元に届いたときには引っ越し先やメールアドレスがすでに変わっていることもあります(Phys.org)。
- 当たり外れが大きい: ある研究では、購入したレコードの4割が古いか誤っていたと報告されています(Phys.org)。
- 同意の証跡が見えない: ブローカーの同意取得が不十分だった場合、買った側にも責任が及びます。FTCが2026年2月に13社へ送付したPADFAA警告書や、カリフォルニア州のData Broker Enforcement Strike Force(進行中の措置は10件超)を見る限り、規制側は本気で取り締まる構えです。
- 欲しい項目だけ選べない: ブローカーの手持ちデータに合わせるしかなく、自社の定義に沿った項目設計はできません。
- 単価が読みにくい: 高品質な部分ほど値が張り、実際の利用量に見合わない対価を払う羽目になりがちです。
既成データセットの網羅性を取るか、必要な公開情報をその都度取得するか。どちらが優れているという単純な話ではなく、調達目的に照らして品質・権利関係・費用・運用負荷を同じ土俵で比べる必要があります。
| 比較項目 | 従来型ブローカー | AI自動化ソリューション(Thunderbit) |
|---|---|---|
| データ鮮度 | 四半期・年次の更新周期で提供される場合がある | 実行時に対象ページの公開情報を取得。鮮度は元ページの更新状況に依存 |
| カスタマイズ性 | 提供データセットの固定フィールドが中心 | 対象ページ上の情報から必要な項目を設定可能 |
| コンプライアンス | 取得経路や同意記録の透明性を精査する必要がある | 公開ソースを直接記録しやすいが、規約・個人情報・利用目的の検証は必要 |
| コスト | リスト・契約単位の費用が中心で、金額は提供条件による | 利用量・プランに応じた課金で、追加コストの条件は契約内容による |
| スピード | 提供条件により数日〜数週間 | 対象サイトや件数によって数分〜数時間 |
| 保守 | 更新データの再購入や差し替えが必要な場合がある | サイト変更への対応をAIが支援するが、抽出結果の再検証は必要 |
Thunderbitで公開データを自社取得するという選択肢
AIで消費者データをスクレイピング Get Started Free
リストを買う代わりに、必要になった時点の公開Webデータを自社で取得する、という方向性もあります。仲介業者を挟まない分、取得元を自分たちの手元に記録できますが、公開情報であっても対象サイトの利用規約・個人情報の扱い・著作権・利用目的は別途確認が必要です。
Thunderbitは、ブラウザ上のページをAIが読み取り、表形式に組み立て直すChrome拡張機能です。基本操作にコードは要りません。公開Webページの消費者関連データ(レビュー、フォーラム、SNS、公的ディレクトリなど)を対象に、次のようなことができます。
- 列の自動提案: ページ内容から名前・所在地・レビュー感情・購入意向といった候補列をAIが出し、目的や個人情報の扱いに合わせて人が取捨選択する
- サブページ・ページネーション追従: ページ構成やアクセス条件が許す範囲で、個別レビューやプロフィールなど一段深い情報、「次へ」ボタンや無限スクロール先も対象にできる
- サイト別テンプレート: Amazon、Yelp、Shopifyなど用意があるサイトでは初期設定の手間を省ける
- 出力先: CSV、Excel、Google Sheets、Airtable、Notionへ書き出せる。上限や細かな挙動は契約プランに依存する
消費者データ取得におけるThunderbitの主な機能
Thunderbitは、非エンジニアが公開Webページから必要な項目を表形式にしたい場面で候補になります。主な機能と運用上の境界は次の通りです。
- AIによる項目提案: ページ内容を解析し、抽出候補となる列を提案します。利用目的に合わない列や個人情報が含まれていないかは、人が調整してから実行します。
- サブページスクレイピング: より詳しい情報が必要な場合、ページ構成やアクセス権限に応じて、各サブページ(個別レビューやユーザープロフィールなど)からデータを追加できます。
- ページネーション対応: 「次へ」ボタンや無限スクロールを含むページに対応しますが、取得範囲や動作はサイト構成によって異なります。
- サイト別テンプレート: Amazon、Yelp、Shopifyなど対応テンプレートがあるサイトでは、設定作業を減らして収集を始められます。
- エクスポート: CSVやExcelへの出力に対応します。利用できる出力方法や上限は、現在のプランや設定によって異なります。
- 使いやすさ: 非エンジニア向けの操作設計で、基本的な抽出はブラウザ上から進められます。
対象ページと必要な列を決め、取得結果が元ページの値と一致するかを見てから、本運用に進むかどうかを判断する、という順番が安全です。公式サイトによれば、世界で20万人以上が利用しているとのことですが、規模よりもまず自分の対象ページで精度を確かめることをおすすめします。
Thunderbit AI Web Scraper を無料で試す
データの価値とソースの信頼性を検証する5ステップ
良さそうなデータソースを見つけたら、次の順で価値と安全性を確認します。
1. 欲しいデータを具体的に定義する 商品レビューなのか、連絡先情報なのか、行動シグナルなのか。曖昧なまま調達を始めないことが最初の分岐点です。
2. Thunderbitでデータを抽出する
- Thunderbit Chrome拡張機能をインストールします。
- 対象サイトへ移動します。
- Thunderbitアイコンから「AI Suggest Fields」を実行し、列を調整します。
- 必要に応じてサブページスクレイピングを有効にします。
- 「Scrape」を実行し、結果の列と値が対象ページと一致するか照合します。
3. 鮮度と精度を確認する
- ページ上のタイムスタンプやレビュー日付を抽出項目に含め、取得時点と比較します。
- サンプルレコードを抜き取って元ページと突き合わせます。
- AIによる要約や分類は一次整理として扱い、重要な判断に使う値は元ページに戻って見直します。
4. ソースの信頼性を評価する
- ブランド公式サイトや信頼性の高いディレクトリ、大手レビューサイトを優先します。
- 同意が明確でないサイトから個人データを収集するのは避けます。
- コンプライアンスと透明性のために、データソースは記録として残します。
5. エクスポートして整理する
- Excel、Google Sheets、CRMへ出力します。
- 必要に応じてAIで分類・タグ付け・翻訳を行います。
データの利用がサイトの利用規約とプライバシーポリシーに沿っているかは、都度確認してください。
ありがちな落とし穴を避けるコツ
- 中身を見ずに買わない: 更新日、取得元、項目定義、欠損率を購入前に確認する
- 重複を放置しない: Thunderbitで取得した場合も、エクスポート後に重複候補を抽出し統合ルールに沿って整理する
- コンプライアンスを最優先にする: 公開情報でも自由に使えるとは限らないため、同意・利用目的・利用規約・適用法を照合する
- 本格導入の前に小さく試す: 少量サンプルで品質基準を満たすか確かめてから対象範囲を広げる
- 記録を残す: 将来の監査に備え、データソース・取得日時・利用目的・取得プロセスを文書化する
抽出したデータをマーケティング判断に落とし込む
データは集めて終わりではなく、利用目的に沿って整理し、施策の判断材料にして初めて価値を持ちます。ThunderbitのAI機能が支援できるのは次のような作業です。
- データの分類: 行動・感情・属性ごとに分類候補を作り、人が結果を見直す
- オーディエンスのセグメント化: 適法に取得できた情報を使い、「低評価ユーザー」「高単価リピーター」といった対象リストを作る
- キャンペーンのパーソナライズ: 同意や社内ルールの範囲で、データの粒度に応じて訴求やオファーを調整する
- トレンドの把握: 同じ取得条件で消費者感情や需要の変化を定期的に比較する
営業チームであれば、最近の製品レビューを抽出して感情別に分類し、不満傾向をサポート改善に回したうえで、連絡許諾のある顧客には特別オファーを含むフォロー施策を検討する、という使い方ができます。マーケティングチームなら、自社が適法に保有する購買履歴でセグメント化し、パーソナライズしたおすすめを配信したあと、開封率やCVRを施策前後で比較する流れです。
進め方は次の4段階になります。
- Thunderbitで消費者レビューやプロフィールを抽出する
- AIで感情・商品関心・エンゲージメントレベルのタグを付け、人が分類結果を見直す
- 利用権限と配信ルールを満たすセグメントを、メール配信ツールや広告プラットフォームへ出力する
- 施策を実施し、事前に定めたKPIで結果を計測して次回の条件を改善する
数値が動かなかった場合は、対象条件か訴求内容のどちらか一つの変数だけを見直し、次の施策で検証するのが安全です。
コンプライアンスと倫理基準をどう運用に組み込むか
適用される規則は、対象地域・データの種類・取得経路・利用目的・自社の立場によって変わります。調達から利用、保存、削除までの各段階で、事業側と法務・プライバシー担当が判断基準を共有しておくことが前提になります。
- 適用される規則を特定する: GDPR、CCPA、地域ごとの規制、対象サイトの利用規約を整理する
- 同意と利用権限を照合する: 記録された同意などの法的根拠と契約上許された利用範囲をデータ項目ごとに点検する
- 透明性を保つ: データの利用方法を消費者に明示し、要件に応じてオプトアウト手段を用意する
- データを安全に管理する: 漏えいや不正アクセスを防ぐため、保存期間・アクセス権限・処理方法を定める
- 定期的に監査する: 規則や利用目的の変更に対応できるよう、データソース・権限・保存状況を継続的に見直す
ビジネスユーザー向けの最終確認リストです。
- データソースは信頼でき、取得経路が追跡できるか
- データの更新時点、正確性、欠損状況を把握しているか
- 同意その他の法的根拠と契約上の利用権限があるか
- 適用されるプライバシー法と対象サイトの利用規約を満たしているか
- データの保存、アクセス、利用、削除を安全に管理できるか
まとめ:消費者データの調達で外せないポイント
消費者データを営業・マーケティングに生かせるかどうかは、購入件数ではなく、出所・鮮度・利用権限・業務目的との適合性で決まります。
- 従来型データブローカーは、更新周期・契約条件・取得経路を精査する。 提供データが古い、または自社に不要な項目を含む場合があるため、購入前にサンプルと利用条件を比較する
- Thunderbitのようなツールは、必要な公開Webデータを自社で取得したい場合の候補になる。 取得元は記録しやすい一方、対象サイトの規約・個人情報・抽出精度・プラン条件は別途確認する
- 品質検証とコンプライアンスは運用工程に組み込む。 ソース・値・同意/利用権限を記録し、担当者が定期的に見直す
- AI分析はあくまで意思決定の補助。 セグメント化や分類結果は人がレビューし、施策前後の指標で効果を測る
まず対象ページを1つ選び、必要なデータ項目・抽出精度・出力形式が自社の用途に合うかを試すところから始めると判断しやすくなります。Thunderbitをダウンロードして検証用データセットを作成できます。倫理的なデータ取得についてさらに掘り下げたい方はThunderbit Blogでガイドやベストプラクティスを確認できます。
AI Web Scraper を試す Get Started Free
よくある質問
1. マーケティングや営業目的で消費者データを購入するのは合法ですか? 一律には判断できません。対象地域、データの種類、取得方法、利用目的、同意その他の法的根拠によって変わります。GDPRやCCPAなどの適用法、契約上の利用権限、対象サイトの規約を確認し、必要に応じて法務・プライバシー担当の判断を仰いでください。公開情報だからといって、自由に営業・マーケティング利用できるとは限りません。
2. 消費者データを購入する際、最大のリスクは何ですか? 古い・不正確なデータを買ってしまうこと、利用権限を確認できないこと、プライバシー規制や契約条件に違反すること、ブランドの信頼を損なうことです。購入前にサンプル・取得元・更新日・同意記録・契約範囲を照合してください。
3. Thunderbitはコンプライアンス上の落とし穴を避ける助けになりますか? 対象ページから直接データを取得し、取得元や取得日時を記録する運用に組み込みやすいため、データの来歴を追いやすくなります。ただし、Thunderbitを使えば適法性が保証されるわけではありません。公開情報についても、対象サイトの利用規約・個人情報・著作権・利用目的は別途判断する必要があります。
4. 技術スキルがなくても使えますか? 基本的な抽出操作はコーディングなしで進められます。一方、ログインが必要なページ、複雑なページ構成、大規模な定期取得では、設定や運用上の判断が別途必要になる場合があります。
5. 消費者データの品質が高いかどうかは、どう判断すればいいですか? 更新日、取得元、欠損率、重複率、項目定義を確認し、サンプルを元ページと照合します。AIによる分類やクレンジングは一次整理として使い、重要な値は人が検証したうえで、基準を満たしたら対象件数や利用部門を段階的に広げます。
まず対象ページを1つ選び、必要な項目が正しく取得できるか、希望する形式で出力できるかを試すところから始めてください。
さらに詳しく知る



