
Trustpilotには3億6,100万件のアクティブレビューと、127万社以上の企業データがたまっています。けれど、そのデータを抜き出すために作られたスクレイパーの多くは、もう何か月も前に動かなくなっています。最近レビュー取得を試した人なら、あの悪名高い「10ページ目のログイン壁」にぶつかって、ツールがエラーしか返してこなかった経験があるはずです。
ここ数週間、2026年でもTrustpilotのレビューを安定して取得できるツールを、実際にテストし、調べて、比べてきました。状況はかなり変わっています。Trustpilotのボット対策はさらに厳しくなり、Next.jsベースのフロントエンドではデプロイのたびにクラス名が変わり、そして何より大事なのは、未ログインのアクセスではレビューの10ページ目までしか見られなくなったことです。2025年末のRedditスレッドには、ユーザーのイライラがそのまま出ていました。「ストアのactorはどれも使えない」。
では、実際に使えるのはどれなのか。今回は、ログイン壁への対応、ボット対策、メンテナンスの手間、そしてマーケターと開発者それぞれの実務ニーズを基準に、5つのツールを評価しました。
2026年にTrustpilotレビューのスクレイピングが難しくなった理由
Trustpilotは、ただの静的サイトではありません。BeautifulSoupでHTTPリクエストを投げてHTMLを読むだけでは、まず太刀打ちできない仕組みです。Next.jsで作られた最新の動的レンダリングサイトで、ここ1年で防御もかなり強化されています。
実際に何と戦うことになるのか:
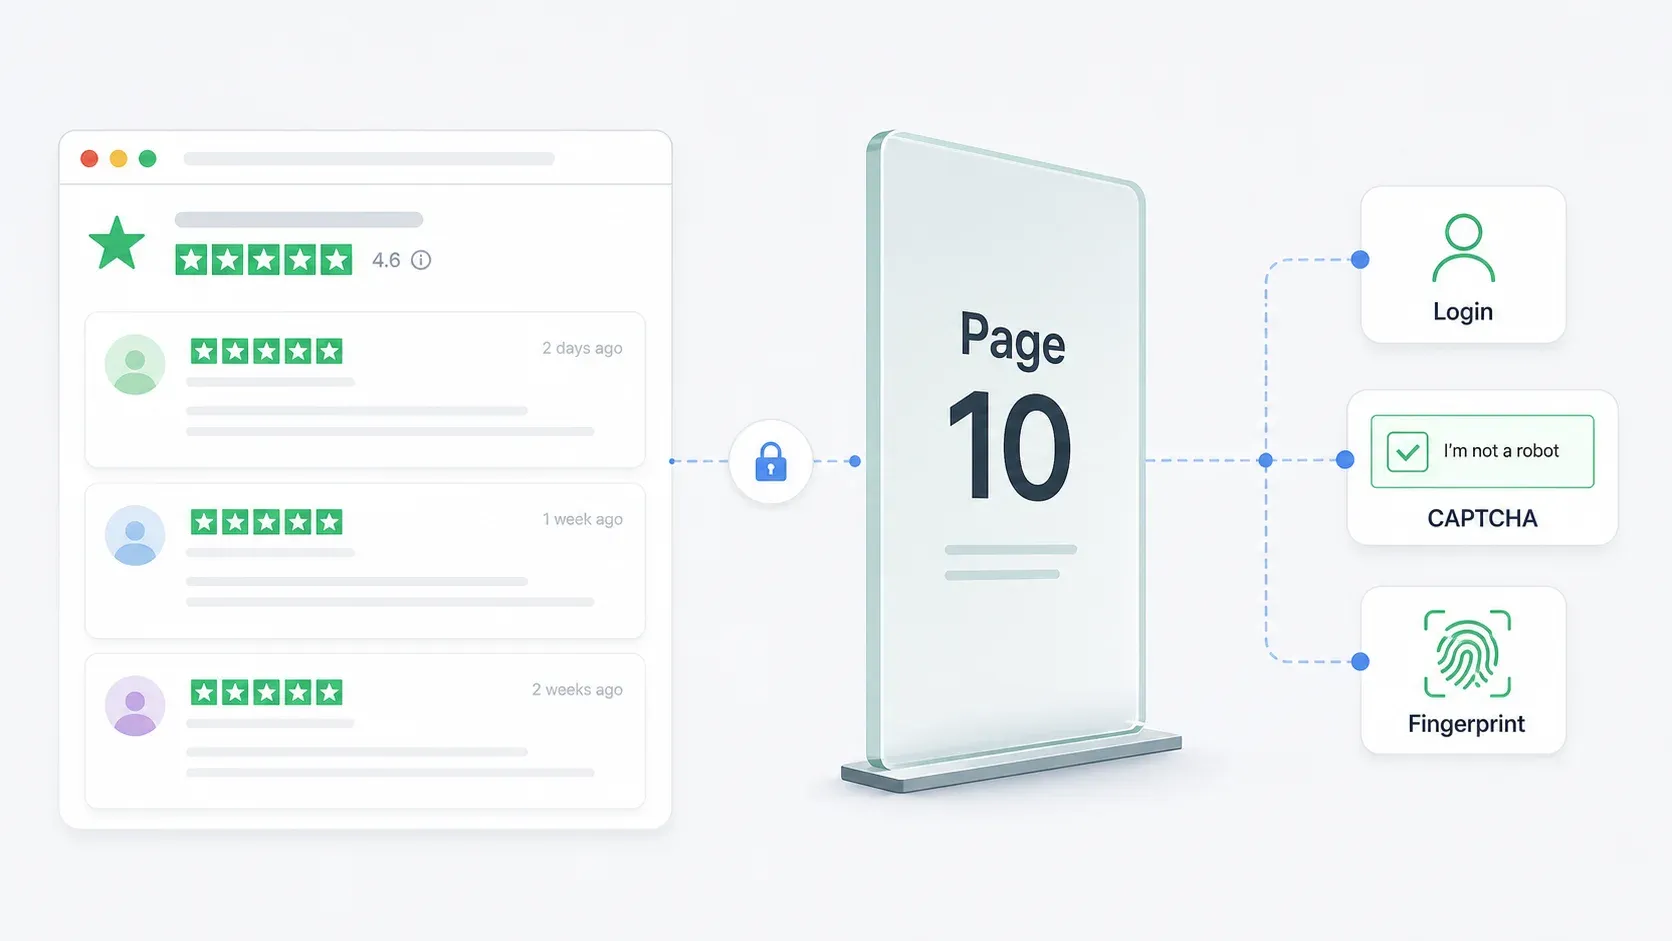
10ページ目のログイン壁。 これが最大の難所です。Web Scraperが2026年3月に公開したTrustpilotガイドでも、Trustpilotはレビュー10ページ分までしか表示せず、それ以降はログインが必要だと明記されています。レビューが2,000件ある企業なら、20件ずつ表示して約100ページ分ありますが、認証済みセッションがなければその90%に届きません。
ボット対策。 TrustpilotはreCAPTCHA、セッションベースのブロック、CDNレベルのリクエスト制限、ブラウザフィンガープリントを使っています。Aboutページにも、サイトは「reCAPTCHAで保護されている」と書かれていて、端末情報や操作シグナルを収集すると明記されています。
動的なCSSクラス名。 TrustpilotはNext.jsとCSS Modulesを使っているので、styles_reviewCardInner__EwDq2のようなクラス名はビルド時に生成され、アップデートのたびに変わります。ScraperAPIのチュートリアルもこうしたセレクタに依存しているため、Trustpilotがフロントエンドを更新した瞬間に壊れる可能性があります。
DOM構造の変更。 クラス名だけではありません。HTMLの階層そのものが変わることもあります。要素の入れ子が変わり、新しいラッパーが増え、ページネーションの構成も組み替えられます。
Apify Actors、Octoparseのワークフロー、カスタムPythonスクリプトのような、CSSセレクタ依存のスクレイパーは、Trustpilotでは構造的に壊れやすいです。動くときは動きますが、止まるときは一気に止まります。そして、その寿命は「数か月」ではなく「数週間」で測られることが多いのです。
今回のベストTrustpilotレビュー・スクレイパーの選定基準
今回の評価では、「Webページをスクレイピングできるか」という一般論では見ていません。ここに挙げたツールは、どれもシンプルなHTMLページからデータを取ることはできます。
本当に知りたいのは、2026年のTrustpilot特有のクセに対応できるかどうかです。
重視したポイントは次の通りです。
| 評価項目 | Trustpilotで重要な理由 |
|---|---|
| ログイン壁対応(10ページ以降) | 多くの企業はレビュー200件以上を持っています。10ページ上限では、履歴データの大半を取りこぼします。 |
| ボット対策の回避方法 | reCAPTCHA、セッションブロック、CDNフィルタリングは、単純なスクレイパーを止めてしまいます。 |
| セレクタ耐性 / 保守性 | 生成されたCSSクラスは、セレクタ依存ツールを頻繁に壊します。自己修復できるかが重要です。 |
| ページネーション対応 | レビューは何百ページにも及びます。手作業で1ページずつ取るのは現実的ではありません。 |
| ノーコードかコード前提か | マーケターはクリック操作を求め、開発者は自由度を求めます。 |
| 料金 / 無料枠 | 予算重視のチームは、導入前にコスト感を把握したいはずです。 |
| 出力形式 | ビジネスユーザーに必要なのは、生JSONだけではなくGoogle Sheets、Airtable、Notionです。 |
ログイン壁を突破できるかどうかが、いちばん大きな分かれ目です。
10ページ目以降に進めない、少なくとも認証済みアクセスへのはっきりした道筋を用意できないなら、2026年のTrustpilotスクレイパーとしては実用的ではありません。
一目でわかるベストTrustpilotレビュー・スクレイパー
比較一覧はこちらです。
| ツール | 難易度 | ログイン壁対応 | ボット対策の考え方 | ページネーション | 無料枠 | 出力形式 |
|---|---|---|---|---|---|---|
| Thunderbit | ノーコード | ブラウザモード(ログイン済みChromeセッションを利用) | AIの意味理解でレイアウト変更に追従 | 自動検出、複数ページ対応 | 月6ページ無料 | Excel、Sheets、Airtable、Notion、CSV、JSON |
| Apify | ローコード | Actor次第。10ページ超ではcookie設定が必要なものもある | 内蔵プロキシローテーション、Actorごとの実装 | Actorごとに設定可能 | 月5ドル分の無料プラットフォームクレジット | JSON、CSV、Excel、XML、RSS |
| Octoparse | ノーコード(ビジュアル) | 手動でcookie / セッション設定が必要 | IPローテーション、住宅プロキシ、CAPTCHA解決(有料) | クリック / スクロール型ワークフロー | 無料プラン + 14日間プレミアム体験 | CSV、Excel、JSON、HTML、XML、データベース |
| Web Scraper | ノーコード(サイトマップ方式) | 制限あり。独自ガイドで10ページ制限を明記 | 有料プランでクラウド + プロキシ | 設定可能。JSクリック推奨 | 無料Chrome拡張 | CSV、XLSX |
| ScraperAPI | 開発者向け(Python) | コードレベルでセッション / cookie管理 | 4,000万以上の住宅プロキシ、JSレンダリング、CAPTCHA対応 | コード実装 | 7日間トライアル、5,000 APIクレジット | 開発者が定義(CSV、JSONなど) |
1. Thunderbit

Thunderbitは、コードを書かずにWebサイトから構造化データを取り出したいビジネスチーム向けのAI搭載Chrome拡張機能です。Trustpilot向けには、専用のレビュー抽出テンプレートがあり、レビュアー名、評価、レビュータイトル、本文、日付、企業からの返信までをワンクリックで取得できます。
少しひいきに聞こえるかもしれませんが、私はこの会社で働いています。ただ、Thunderbitをこの形にした理由は、まさにTrustpilotスクレイピングの難しさそのものにあります。ThunderbitのAIはCSSセレクタに頼らず、ページの意味を理解して読み取ります。Trustpilotがクラス名を変えたりDOMを組み替えたりしても、Thunderbitは要素の意味を見ているので対応できます。
TrustpilotのスクレイピングにThunderbitを試す
Thunderbitは10ページ目のログイン壁にどう対応するのか
ここで効いてくるのがブラウザモードです。ThunderbitはChromeブラウザの中で動作し、すでにTrustpilotへログインしている同じブラウザセッションを使います。ブラウザスクレイピングモードに切り替えると、拡張機能は認証済みセッションで表示できるページをそのまま読み取ります。プロキシの面倒な設定も、cookie注入も、Playwrightのセッションプールも不要です。
使い方はシンプルです。ChromeでTrustpilotにログインし、取得したいレビューのページに移動して、拡張機能を開くだけ。ワンクリックでAIがページ内のレビュー項目を見つけて抽出します。別の形でデータを取りたいなら、その内容を指示すれば大丈夫です。その後のページネーションも自動で進み、ブラウザセッションでアクセスできる範囲をThunderbitが順番に処理していきます。
なぜTrustpilotの変更でThunderbitは壊れにくいのか
Trustpilotテンプレートページでも、この違いははっきり示されています。従来型のスクレイパーは、レイアウトが変わるたびに壊れ、CSSセレクタの更新が必要になります。Thunderbitは、特定のCSSに頼らずコンテンツを理解するセマンティックAIを使っていて、動的コンテンツと自動ページネーションにも対応します。
これを、styles_reviewCardInner__EwDq2のようなクラス名で解析しているScraperAPIのチュートリアルコードと比べてみてください。そのセレクタは、Trustpilotが次回更新を配信した瞬間に壊れる可能性があります。ThunderbitのAIは「このページのどこにレビュー本文があるか?」と見ます。特定のdivクラス名を探すわけではありません。
Trustpilotスクレイピング向けの主な機能
- AIによる項目自動検出:レビュー項目(名前、評価、日付、タイトル、本文、企業返信)を手動設定なしで自動認識。必要なら欲しい項目を伝えるだけで反映
- ワンクリックの操作:1回クリックするだけで完成した表が出る
- ログイン必須ページ向けブラウザモード:認証済みChromeセッション内で動作し、10ページ目以降にも対応
- 自動ページネーション:複数ページのレビューを手作業なしで処理
- サブページ抽出:レビュアー個別プロフィールを巡回して補完データを取得可能
- 定期スクレイピング:毎週・毎月のレビュー監視を設定し、レピュテーション管理に活用
- 出力先:Google Sheets、Airtable、Notion、CSV、JSONに対応。すべて無料で利用可能
料金
- 無料プラン:月6ページまで、クレジットカード不要
- クレジット制:1クレジット = 1出力行
- 有料プラン:月15ドル、または年額払いで月約9ドル(料金ページ)
おすすめ:コードに触れずにTrustpilotレビューを取りたいマーケティングチーム、オペレーションチーム、ビジネスユーザー。数週間ごとに壊れるスクレイパーを保守したくない人にも向いています。
2. Apify
Apifyはクラウド型のスクレイピング基盤で、あらかじめ作られた「Actors」(他ユーザーやApifyチームが作ったスクレイピングテンプレート)をマーケットプレイスから選べます。Trustpilot向けにも、コミュニティが保守している複数のActorが公開されていますが、信頼性はかなりばらつきがあります。
Apifyの強みはパワーがあることですが、同時に分散している点が弱みでもあります。動くActorもあれば、すでに廃止されたものもあります。10ページ以降ではcookieが必要なものもあります。Redditで見かけた「ストアのactorがどれも動かない」という不満は、大げさではなく、Trustpilotの変化がどれだけ早くActor固有のロジックを壊すかを示しています。
Trustpilot用Actorsと既知の制限
Apify Storeには複数のTrustpilot Actorがあります。少なくとも1つは、開発者「burbn」によるもので、10ページを超える場合はcookie入力が必要だと書かれています。ほかにも、評価が0.0だったり、ユーザー数が極端に少なかったり、更新日がかなり新しかったりするものがあり、保守が続いている一方で信頼性に差があることがわかります。
廃止されたActorにも触れておく価値があります。古いActorの中には、Trustpilotに埋め込まれた__NEXT_DATA__ JSONを直接読むという、DOM解析より速い賢いやり方を使っていたものもありました。でも、それもTrustpilotがデータ構造を変えたときに壊れました。
ログイン壁とボット対策
- ログイン壁:選ぶActor次第です。10ページ以降のcookie注入に対応するものもあれば、非対応のものもあります。
- ボット対策:Apifyの基盤にはプロキシローテーションと実行単位ベースのインフラがあります。住宅プロキシはFree/Starterプランで8ドル/GBから使えます。
- 保守:Actorが壊れたら、メンテナーの修正を待つ、別のActorに切り替える、または専用のプライベートActorを依頼することになります。
料金
- 無料プラン:月5ドル分の前払い利用、クレジットカード不要
- Starter:月9ドル + 従量課金
- Scale:月99ドル + 従量課金
- 出力形式:JSON、CSV、Excel、XML、RSS(Actor次第)
おすすめ:複数のActorを比べて、cookie設定ができ、壊れたら自力で対処できる技術寄りのユーザー。完全放置で使いたいチームには向きません。
3. Octoparse
Octoparseは、デスクトップベースのノーコードスクレイパーで、視覚的なクリック操作でワークフローを作れます。Thunderbitの「ワンクリックの手軽さ」とScraperAPIの「開発者向け自由度」の中間にある存在で、コードなしで見た目どおりに設定できますが、ワークフローの構築と保守は自分でやる必要があります。
OctoparseでTrustpilotをスクレイピングする手順
流れはシンプルですが、手動作業が必要です。
- Trustpilotの企業レビューURLを貼り付ける
- レビュー要素(タイトル、本文、評価、日付、レビュアー名)を視覚的に選ぶ
- 次へボタンを使ってページネーションループを設定する
- 待機時間を設定する(reCAPTCHA回避のため2〜5秒推奨)
- 小規模ならローカル実行、大量ならクラウドで実行する
ツールに慣れている人なら、設定は10〜15分くらいで済みます。ただし、OctoparseはDOM要素に結びついたビジュアルセレクタを使うため、Trustpilotのページ構造が変わるたびにワークフローを更新する必要があります。
ログイン壁とボット対策
- ログイン壁:手動でのログイン / cookie / セッション設定が必要。自動では処理されません。
- ボット対策:有料プランには、IPローテーション、住宅プロキシ(3ドル/GB)、自動CAPTCHA解決(1,000件あたり1〜1.5ドル)が含まれます。
- 保守:中程度。Trustpilotのフロントエンド更新時には、ワークフローの作り直しや調整が必要になると考えてください。
料金
- 無料プラン:ずっと無料、10タスク、1デバイス、ローカル抽出、月最大50,000行
- Standard:月69ドル(年額請求)
- Professional:月149ドル
- 14日間のプレミアム体験:クラウド抽出、スケジューリング、API、テンプレートを含む
- 出力形式:Excel、CSV、JSON、HTML、XML。上位プランではデータベースやGoogle Sheetsにも対応
おすすめ:見た目でワークフローを組みたい人、初期設定に時間をかけても気にならない人、ページ変更時のメンテナンスを受け入れられる人。ワンクリックツールより細かく、Pythonを書くよりは簡単にしたいチームに向いています。
4. Web Scraper
Web Scraperは、Chrome拡張機能とクラウドプラットフォームを組み合わせた、サイトマップ方式のスクレイピングツールです。Trustpilot向けでは、企業ページ用の事前構築テンプレートが特に強く、企業名、カテゴリ、住所、評価、レビュー数、TrustScore、WebサイトURLなどの企業情報を抜き出せます。
ただし、レビュー抽出については、はっきり押さえておくべき制限があります。
事前構築テンプレート vs. カスタム構築
マーケットプレイスのテンプレートは、Trustpilot内で企業プロフィールを横断して探す用途には便利です。カスタムでレビューを抜き出したい場合は、Chrome拡張のSitemap Wizardでスクレイパーを視覚的に組み立てます。
Web Scraper自身の2026年3月のガイドでは、URLベースのページネーションではなく、JavaScriptクリックによるページ送りを推奨しています。Trustpilotはページ間でコンテンツを動的に並べ替えるため、結果のズレが起きやすいからです。
ログイン壁とボット対策
ここは曖昧にせず言うべきです。Web Scraperの公式ガイドには、Trustpilotはレビューの最初の10ページしか表示せず、その後はログインが必要だと明記されています。これは回避策ではなく、既知の制限として紹介されています。
- ログイン壁:対応は限定的。10ページ制限は自社ガイドにも書かれています。
- ボット対策:クラウドプランではプロキシ対応あり。ガイドでは2〜5秒の遅延と同時実行数の削減が推奨されています。
- ページネーション:設定はできますが、未認証アクセスでは実質的に最初の10ページまでに制限されます。
料金
- 無料Chrome拡張:ローカルスクレイピング向け、機能は限定的
- Project:月50ドル(5,000 URLクレジット)
- Professional:月100ドル(20,000 URLクレジット)
- Scale:月200ドル〜(条件付きでURLクレジット無制限)
- 有料クラウドプラン:7日間無料トライアルあり
- 出力形式:CSV、XLSX
おすすめ:Trustpilotの企業プロフィールをスクレイピングするための完成テンプレートが欲しい人、または最初の10ページのレビューだけで十分な人。レビュー数がかなり多い企業の全履歴が必要なら、最適ではありません。
5. ScraperAPI
ScraperAPIは、開発者向けのスクレイピング基盤です。クリック操作型のツールではなく、解析ロジックを自分で書く代わりに、ボット対策を処理してくれるプロキシ / レンダリング層です。Trustpilot向けソリューションページでは、JSレンダリング、CAPTCHA対応、4,000万以上のプロキシがうたわれています。
Python開発者で、抽出ロジックを完全に自分で管理したいなら、ScraperAPIは土台となるインフラを提供してくれます。
ただし、保守責任もそのまま自分持ちです。
ScraperAPIでカスタムTrustpilotスクレイパーを作る
ScraperAPIの2026年1月のチュートリアルでは、Python + BeautifulSoupのワークフローが紹介されています。
import requests
from bs4 import BeautifulSoup

payload = {
    "api_key": "YOUR_API_KEY",
    "url": "https://www.trustpilot.com/review/example.com",
    "render": "true",
    "keep_headers": "true",
}

html = requests.get("https://api.scraperapi.com", params=payload).text
soup = BeautifulSoup(html, "html.parser")
完成コードではpages_to_scrape = 10と設定されていて、公開ページの上限を暗に認めています。10ページ以降を取るには、開発者自身で認証済みセッション、cookie、トークンを管理する必要があります。
ログイン壁とボット対策
- ログイン壁:コードレベルでのセッション / cookie管理が必要。ScraperAPIがプロキシとレンダリングを担当し、認証ロジックは自分で実装します。
- ボット対策:自動IPローテーション付きの住宅プロキシプール、
render=trueによるJSレンダリング、スマートなプロキシ切り替えによるCAPTCHA対応。すべてのプランで利用できます。 - 保守:Trustpilotがクラス名を変えたら、そのたびにパースコードを更新する必要があります。チュートリアル内の
styles_reviewCardInner__EwDq2は、すでに時限爆弾みたいなものです。
料金
- 7日間トライアル:5,000無料APIクレジット、クレジットカード不要
- Hobby:月49ドル(100,000 APIクレジット)
- Startup:月149ドル(1,000,000クレジット)
- Business:月299ドル(3,000,000クレジット)
- 出力形式:コードが生成したものすべて(一般的にはCSV、JSON、DB書き込み)
おすすめ:完全なカスタマイズを求め、自分で解析スクリプトを保守でき、セッション管理・ページネーション・データ構造をプログラムで制御したい開発者。非技術者には向きません。
なぜTrustpilotスクレイパーは壊れ続けるのか、そして壊れにくいツールの選び方
Trustpilot用スクレイパーを選ぶうえで、ここがいちばん見落とされやすいポイントです。見るべきなのは「今日動くか」ではありません。「3週間後も動くか」です。
Trustpilotでスクレイパーが壊れる理由は、主に4つあります。
-
生成されるCSSクラスの変更。 Next.jsのCSS Modulesは、
styles_reviewCardInner__EwDq2のようなクラス名を生成します。これらはフロントエンドのデプロイごとに変わるため、そのクラスを狙うスクレイパーは壊れます。 -
DOM構造の変更。 TrustpilotはHTMLの階層を組み替えられます。レビューカードの入れ子が変わったり、ラッパー要素が変わったり、メタデータの位置が動いたりします。
-
ボット検知条件の変更。 reCAPTCHAの閾値は変わります。セッショントークンのローテーションはより厳しくなり、CDNのフィルタリングルールも更新されます。
-
認証 / セッションの変更。 10ページ目のログイン壁は、2025年後半に導入された、あるいはさらに厳しくなりました。今後もアクセス制限がいつ変わってもおかしくありません。
本質的な違いは、セレクタベースかセマンティックベースかです。
-
セレクタベースのツール(Apify Actors、Octoparseのワークフロー、ScraperAPIのスクリプト、Web Scraperのサイトマップ)は、「このCSSパス上にある要素を見つけて」と探します。パスが変われば、何も返さないか、空のデータで失敗します。
-
セマンティック / AIツール(Thunderbit)は、「このページのレビュー本文、評価、日付を見つけて」と探します。AIはHTMLアドレスではなく、意味でページを理解します。レイアウトが変わっても、意味が変わっていなければ壊れません。
私のおすすめは次の通りです。
- メンテナンスを一切したくない? → AIベース(Thunderbit)
- 多少の保守はOK、クラウド自動化が欲しい? → Apify(Actor選定と監視が前提)
- 視覚的に制御したく、保守もある程度できる? → Octoparse
- テンプレート中心で、対象範囲が限定的? → Web Scraper
- 完全な自由度が欲しい、すべて自分で管理したい? → ScraperAPI
取得したTrustpilotレビューをどう活用するか
レビューを集めるのは、あくまで最初の一歩です。よくある質問は、「データは取れた。で、次に何をするの?」です。
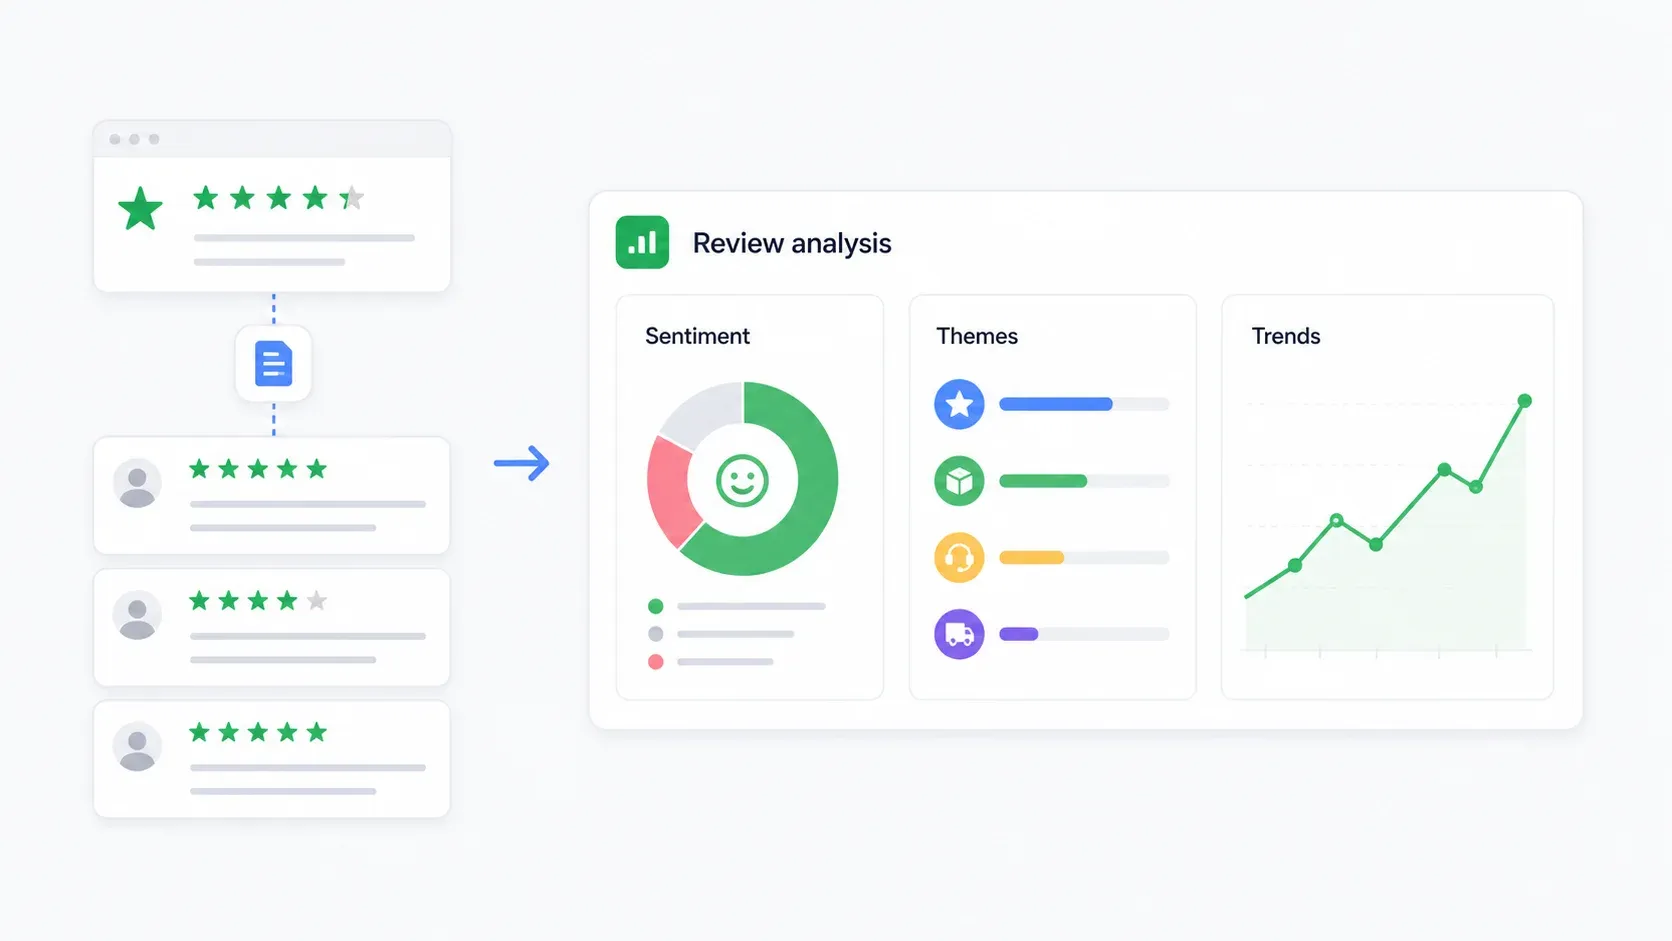
感情分析
いちばんシンプルなのは、レビューをGoogle Sheetsに書き出して、ChatGPT、Claude、SheetsのAI関数などを使い、各レビューをポジティブ、ニュートラル、ネガティブに分類する方法です。さらに、苦情のカテゴリ、緊急度、推奨対応優先度の列を足します。
データ量が多い場合は、CSVをChatGPTにアップロードして、こう頼めます。「これらのレビューを感情別に分類し、代表的な引用付きで上位5つの苦情テーマを特定してください。」
競合モニタリング
Thunderbitの定期スクレイピングを使えば、競合レビューを毎週または毎月取得できます。追跡したい指標は以下です。
- 時系列での平均評価の推移
- 1つ星・2つ星レビューの割合
- レビュー件数の増減
- よくある不満テーマ
- 企業返信率と返信速度
評価と日付でピボットテーブルを作ったシンプルなGoogle Sheetsダッシュボードでも、自動更新される競合インテリジェンスの入口になります。
テーマ抽出
レビューを次のようなカテゴリでまとめます。配送、カスタマーサポート、返金、製品品質、請求、アプリの使いやすさ、価格対価、不正懸念などです。出力は、テーマ、件数、平均評価、代表的な引用、推奨アクションを含む表にすると実用的です。
これはワードクラウドよりずっと役に立ちます。実際に何が満足や不満を生んでいるのかがわかるからです。
複数企業の一括分析
カテゴリ単位の調査では、同じTrustpilotカテゴリ内の複数企業からレビューをスクレイピングします。市場セグメント全体で、レビュー件数、評価分布、星の偏り、テーマの出現率を比較できます。Web Scraperの企業リスティングテンプレートは会社の発見に便利で、レビュー詳細のサンプリングはThunderbitやScraperAPIで処理できます。
Trustpilotスクレイピングに関する法的・倫理的な注意点
私は弁護士ではないので、これは法的助言ではありません。ただし、コンプライアンス上の現実は無視できません。
Trustpilotの利用規約ははっきりしています。利用規約では、Trustpilotが明示的に提供または承認した方法以外でコンテンツにアクセス・収集することを禁じており、とくにテキストマイニング、データマイニング、Webスクレイピングを明示的な許可なしに行うことを挙げています。
リスクの目安は次の通りです。
- 低リスク:自社レビューを社内分析のためにエクスポートするケース。特にTrustpilotの公式ビジネスツールやAPIを使う場合。
- 中リスク:公開されている競合ページを、少量だけ市場調査目的でスクレイピングするケース。それでも利用規約やプライバシー義務の対象です。
- 高リスク:認証壁の先にある10ページ目以降を取得する、技術的制御を回避する、レビューデータを再配布する、スクレイプしたレビューをAIモデル学習に使う、といったケース。
GDPRの観点:レビュアー名、プロフィールリンク、レビュー本文、所在地情報は、EUのプライバシー法上の個人データに当たる可能性があります。実務上の対策としては、必要な項目だけを集める、分析用にレビュアー名をハッシュ化する、保管期間を決める、レビュー本文を大量に再公開しない、などがあります。
公開データと認証データ:誰でも見られるページ(最初の10ページ)をスクレイピングするのと、認証壁の裏側のデータを取るのとでは、法的・倫理的な意味合いがかなり違います。公開データだけで動くツールは、ログイン認証を必要とするツールよりもコンプライアンスリスクが低くなります。
これはツール選びでも大事です。Thunderbitのブラウザモードは、自分のセッションで見えているページに対して動くので、認証を独自に迂回するわけではありません。ScraperAPIは開発者に大きな自由を与える一方で、セッション管理の適法性も含めて責任が伴います。
自分に合ったTrustpilotレビュー・スクレイパーの選び方
ペルソナ別の判断基準は次の通りです。
- コードなしでレビューを取りたい非技術系マーケター → Thunderbit。ワンクリックで、残りはAI任せ。Sheets / Notion / Airtableへ出力可能。
- 設定やデバッグに慣れたローコードユーザー → Apify。Actorを選び、10ページ以降のcookieを設定し、壊れたら監視する。
- ワークフローを自分で動かしたいビジュアルビルダー派 → Octoparse。クリック操作で設定できるが、Trustpilot変更時の保守は覚悟。
- 企業レベルのデータ、または最初の10ページだけで十分 → Web Scraper。企業プロフィール向けの事前構築テンプレートが強い。
- 完全に自分で作り込みたい開発者 → ScraperAPI。解析ロジック、セッション管理、データパイプラインを自分で持つ。
保守負荷を最優先で考えるなら、Thunderbitはほぼ保守不要、ScraperAPIはすべて自分で保守、という位置づけです。予算面では、この一覧にあるツールは全部、無料の入口があります。まずはそこから試すのが賢いやり方です。
まとめ
Trustpilotのレビューは、競合調査、レピュテーション監視、顧客インサイトの獲得にとても役立ちます。
ただし2026年に安定して取るには、10ページ目のログイン壁、DOM変更、ボット対策を、手作業を挟まずに処理できるツールが必要です。
多くのビジネスユーザーにとっては、Thunderbitがいちばん手間の少ない選択肢です。ワンクリック、AIによる項目検出、認証済みページ用のブラウザモード、そしてTrustpilotのフロントエンドが変わっても保守不要。月6ページまでなら無料で試せます、クレジットカードも不要です。
完全な制御を求める開発者にはScraperAPIが土台を提供してくれます。その中間にいる人には、Apify、Octoparse、Web Scraperがそれぞれ特定の用途に合います。大事なのは、自分の技術レベル、保守の許容度、コンプライアンス要件に合うツールを選ぶことです。
ThunderbitがTrustpilotでどう動くのか見たい方は、YouTubeチャンネルに実演動画があります。さらに、コードなしのWebスクレイピングやそもそもWebスクレイピングとは何かについては、こちらのガイドも参考になります。
よくある質問
1. Trustpilotレビューは10ページ目以降もスクレイピングできますか?
はい。ただし、認証済みの経路が必要です。Trustpilotは未ログインのアクセスを最初の10ページまでに制限しています。Thunderbitのブラウザモードはログイン済みChromeセッション内で動作するため、自分が見られるページにアクセスできます。ScraperAPIはコードレベルでのセッション / cookie管理が必要です。Apify Actorsはcookie設定が必要です。Octoparseは手動でのログイン / cookie設定が必要です。Web Scraperの公式ドキュメントも10ページ制限を認めていて、組み込みの回避策はありません。
2. Trustpilotレビューをスクレイピングするのは合法ですか?
Trustpilotの利用規約では、明示的な許可なしの自動データ収集は禁止されています。法的リスクは方法と用途で変わります。自社の公開レビューを取るのは、競合の認証壁を越えて取得するより低リスクです。EUのレビューデータにはGDPRが適用されます。これは法的助言ではないので、大規模または商用のスクレイピングを行う場合は弁護士に相談してください。
3. Trustpilotからはどんなデータを抽出できますか?
一般的には、レビュアー名、星評価、レビュータイトル、本文、投稿日、体験日、購入確認の有無、レビュアーの所在地、企業返信の本文、会社名、TrustScore、総レビュー数、星の分布、レビューURLなどが取得対象になります。
4. Trustpilotスクレイパーはどのくらいの頻度で壊れますか?
セレクタベースのツール(Apify Actors、Octoparseのワークフロー、カスタムPythonスクリプト)は、TrustpilotがCSSクラスやDOM構造を変えるたびに壊れる可能性があります。これは月に複数回起こることもあります。ThunderbitのようなAIセマンティック系ツールは、特定のセレクタではなくページの意味を理解するため、自動で適応します。ただし、10ページ目のログイン壁のような大きなアクセス制御変更には、どのツールも完全には無傷ではありません。
5. Trustpilotレビューを無料でスクレイピングできますか?
この一覧のツールには、どれも無料の入口があります。Thunderbitは月6ページ無料、ScraperAPIは7日間で5,000トライアルクレジット、Web Scraperはローカル利用向けの無料Chrome拡張、Octoparseは永年無料プラン(10タスク、月50,000行)、Apifyは月5ドル分の無料プラットフォームクレジットを提供しています。小規模なサンプリングや検証なら、どれも支払いなしで使えます。
TrustpilotレビューのスクレイピングにThunderbitを試す Get Started Free
さらに詳しく



