
先月、友人の Stripe 連携が金曜の夜11時ごろから、こっそり 503 を返し始めました。誰も気づかないまま土曜の朝を迎え、サポート窓口には決済失敗に怒ったお客さんから 200件を超える問い合わせメールが一気に届いたのです。
こういう話は、ほんまに珍しくありません。よく引用されるベンチマークでは、平均ダウンタイムは1分あたり5,600ドルとされ、大規模障害では1時間あたり数百万ドル規模に達することもあります。実際の損失額はトラフィック量、コンバージョン率、注文単価、SLA の影響、復旧コストで変わりますが、方向性ははっきりしています。監視されていない API は、ただの開発上の面倒ごとやなく、事業リスクです。しかも今は企業が平均131個のサードパーティ API を運用し、そのリスクを高い精度で軽減できると答えた組織は16%にとどまるので、API モニタリングはもう任意ではありません。このガイドで私がやりたかったのは、他ではあまり見かけへん切り口でツールを整理することでした。つまり、あなたの用途別に分けて、アラートの有無ではなく質を比べ、2026年時点の価格を示し、実際にどれくらい早く使い始められるかまで見比べることです。単なるロゴ一覧ではありません。
もう1つ。もしあなたの API 関連業務に、Web データ収集、LLM への入力、RAG システム構築、競合ページの監視、サイト上の価格や商品データ抽出が含まれるなら、「API ツール」の話は uptime 監視だけでは終わりません。散らかった Web ページを構造化データに変える、信頼できる方法も必要です。そこでこのガイドでは Thunderbit Open API も取り上げます。これは uptime モニターではありませんが、Web サイトをきれいな Markdown やスキーマベースの JSON に、API 経由で手早く変換できる手段のひとつです。
API モニタリングとは何か?なぜチームに必要なのか?
API モニタリングとは、エンドポイントが使えるか、速く返るか、そして正しいデータを返しているかを継続的に確かめることです。「サーバーが落ちていないか」だけを見る話ではありません。いいモニターは、HTTP ステータスコード、レスポンスの中身、レイテンシ、SSL 証明書、ログイン → 検索 → 購入みたいな複数ステップのワークフロー、さらにはスキーマの正しさまで検証します。
これは、一般的な Web サイト監視(ページが表示されるかを見る)とも、APM(Application Performance Monitoring:コードレベルのトレース、DB クエリ、ランタイム内部を深掘りするもの)とも違います。API モニタリングはその真ん中にあって、ユーザー、パートナー、連携先が実際にエンドポイントを呼んだときに何を体験するのかを確かめます。
関連するカテゴリとして、Web データ API も押さえておくべきです。これは自社 API の健全性を監視するものではなく、製品やワークフローが外部の Web データを安定して取れるようにするものです。たとえば Thunderbit Open API なら、Web ページをきれいな Markdown に要約し、JSON で構造化フィールドを抜き出し、複数 URL にまたがるバッチ処理も実行できます。もしあなたの「API」プロジェクトが、ベンダー情報、商品ページ、公開リスト、ドキュメントページ、調査ソースなどの最新データに依存しているなら、こうしたデータ抽出 API も uptime チェックと同じくらい運用上大事です。
なぜ非エンジニアにも関係あるのでしょうか?API はダイナミック Web トラフィックの71%を占めており、API 関係者の62%が「API は直接収益を生む」と答えているからです。決済ゲートウェイ、認証サービス、配送 API が落ちれば、それは抽象的なインフラ問題やなく、売上損失、パートナー契約の破綻、サポート対応の急増、信頼低下につながります。プロダクトマネージャー、営業、運用、CS の各チームも、みんな当事者です。
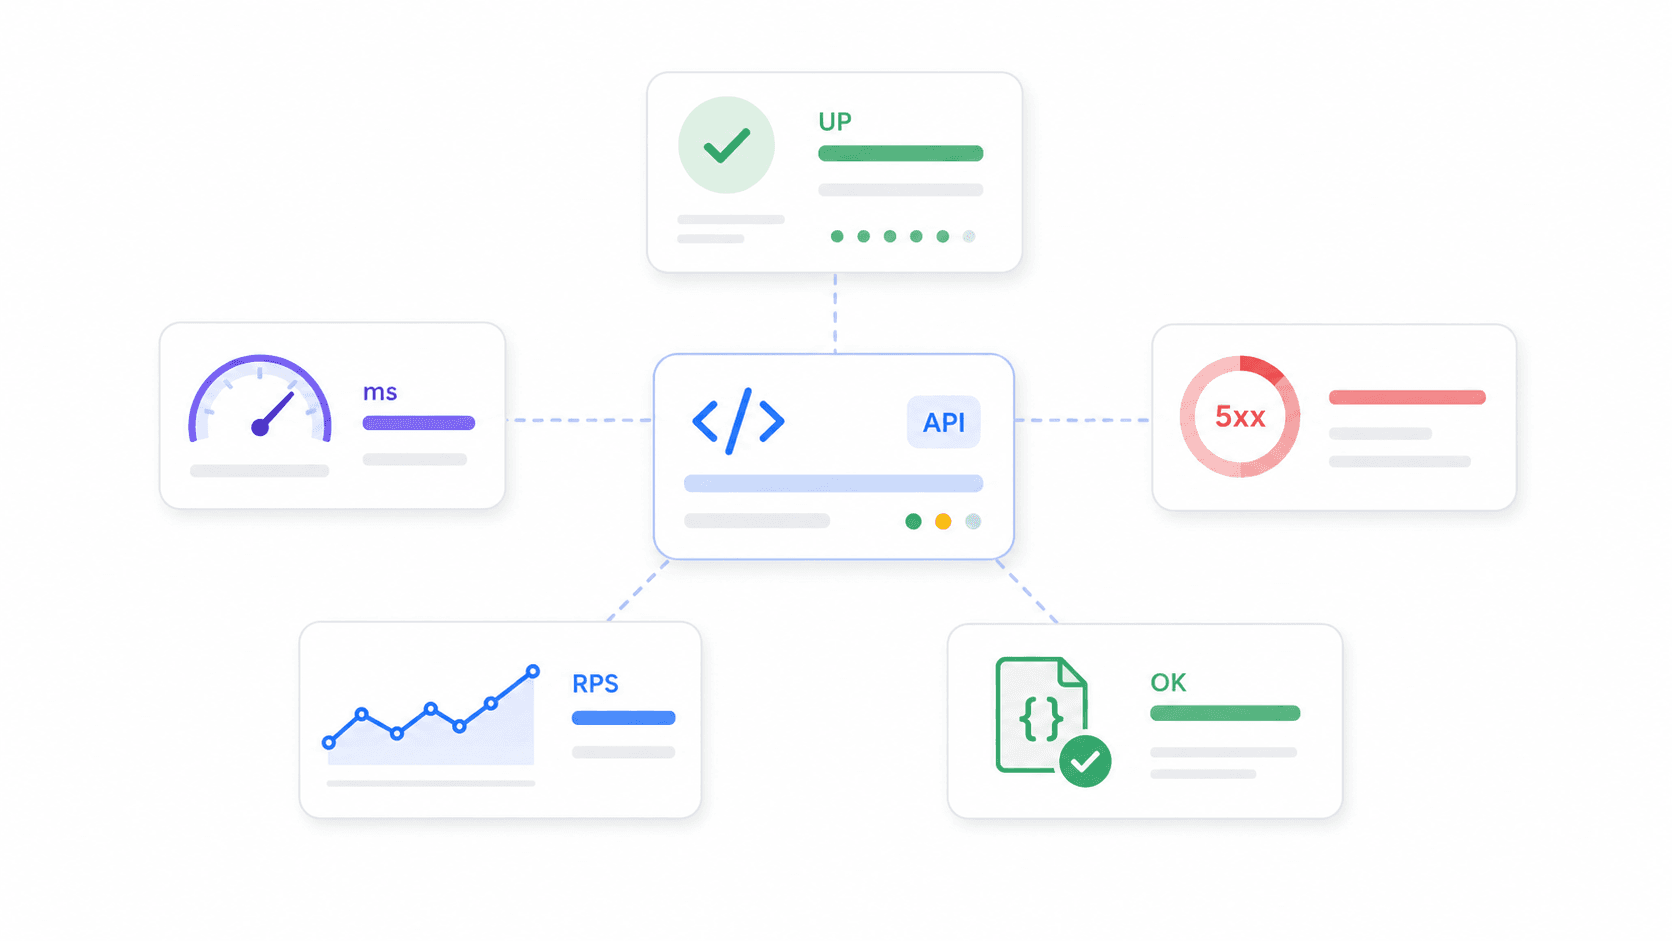
注目すべき主要指標は次のとおりです。
- 稼働率: エンドポイントが使えた時間の割合
- レスポンスタイム / レイテンシ: 応答にかかる時間(平均、p95、p99)
- エラー率: 5xx、タイムアウト、アサーション失敗などを返したリクエストの割合
- スループット: 1秒または1分あたりのリクエスト数
- 正確性: 200 OK を返すだけでなく、期待どおりのデータを返しているか
2026年版の API モニタリングツールをどう評価したか
「おすすめ API モニタリングツール」記事の多くは、ベンダー名と機能を並べるだけです。私はもっと意図的に選びたかった。開発者フォーラムをかなり読み込んだうえで、Thunderbit チームの協力でベンダーサイトから価格と機能データを一括抽出し、実際の比較表を作れたからです(そのワークフローの詳細は後ほど触れます)。
評価時に重視した項目は次のとおりです。
| 評価項目 | 重要な理由 |
|---|---|
| 導入のしやすさ / 初回アラートまでの速さ | 小規模チームには、プラットフォーム導入プロジェクト後ではなく、今すぐのカバー範囲が必要 |
| アラートの賢さとノイズ削減 | ノイズの多いアラートは無視され、本当に重要な障害を見逃す |
| 無料枠の充実度 | 個人開発や初期スタートアップは、まず無料で始めることが多い |
| 価格の分かりやすさ | 可観測性コストは、ホスト数、席数、ログ、シンセティック実行、データ取り込みで膨らみやすい |
| 連携の広さ | アラートは、チームが普段使っている場所(Slack、PagerDuty など)に届く必要がある |
| 拡張性とデータの深さ | 成熟したチームには、トレース、ログ、APM、RBAC、SSO、保存期間が必要 |
| コミュニティとサポートの質 | オープンソースチームには更新頻度が、企業には SLA が重要 |
| Web データ抽出能力 | AI アプリ、RAG ワークフロー、市場調査では、エンドポイントの稼働状況だけでなく、きれいな外部データが必要 |
また、単独開発者、スタートアップ、EC/SaaS、エンタープライズ、オープンソース重視派、API プロダクトチーム、Web データ/AI アプリチームみたいに用途別におすすめを分けています。14個のツール説明を順に読むんやなく、自分の状況に近いところから飛べるようにするためです。Grafana の2025年調査では、46%が相互運用性を、35%が将来的な切り替えやすさを選定基準に挙げており、こうした観点が単なるおまけやないことが分かります。
用途別に見る API モニタリングツール:早見表
ここが近道です。自分の用途の行を見つけて、詳細は下の各ツール説明へ進んでください。
| 用途 | おすすめツール | 主な差別化ポイント |
|---|---|---|
| Web データ / AI アプリチーム | Thunderbit Open API, Moesif, Apitally | Web サイトを LLM、RAG、価格調査、リサーチ用のきれいな Markdown か構造化 JSON に変換 |
| 個人開発 / サイドプロジェクト | UptimeRobot, Uptime Kuma, Gatus | 無料または自前運用、最小限の設定、すぐに使える |
| スタートアップ(5〜15人規模) | Checkly, Better Stack, Postman | 賢いアラート、導入が速い、手頃な価格、ステータスページ |
| EC / SaaS | Datadog, New Relic, Moesif, Checkly | ビジネスメトリクス、APM/トレース、SDK の深さ、複数ステップのシンセティック監視 |
| エンタープライズ / マルチクラウド | Datadog, New Relic, Splunk, Grafana Cloud | 分散トレース、コンプライアンス、ハイブリッド環境、RBAC/SSO |
| オープンソース重視派 | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | 完全な制御、OTel ネイティブ、ベンダーロックインなし |
| API プロダクトチーム | Moesif, Apitally, New Relic | 顧客別利用状況、エンドポイント傾向、異常アラート |
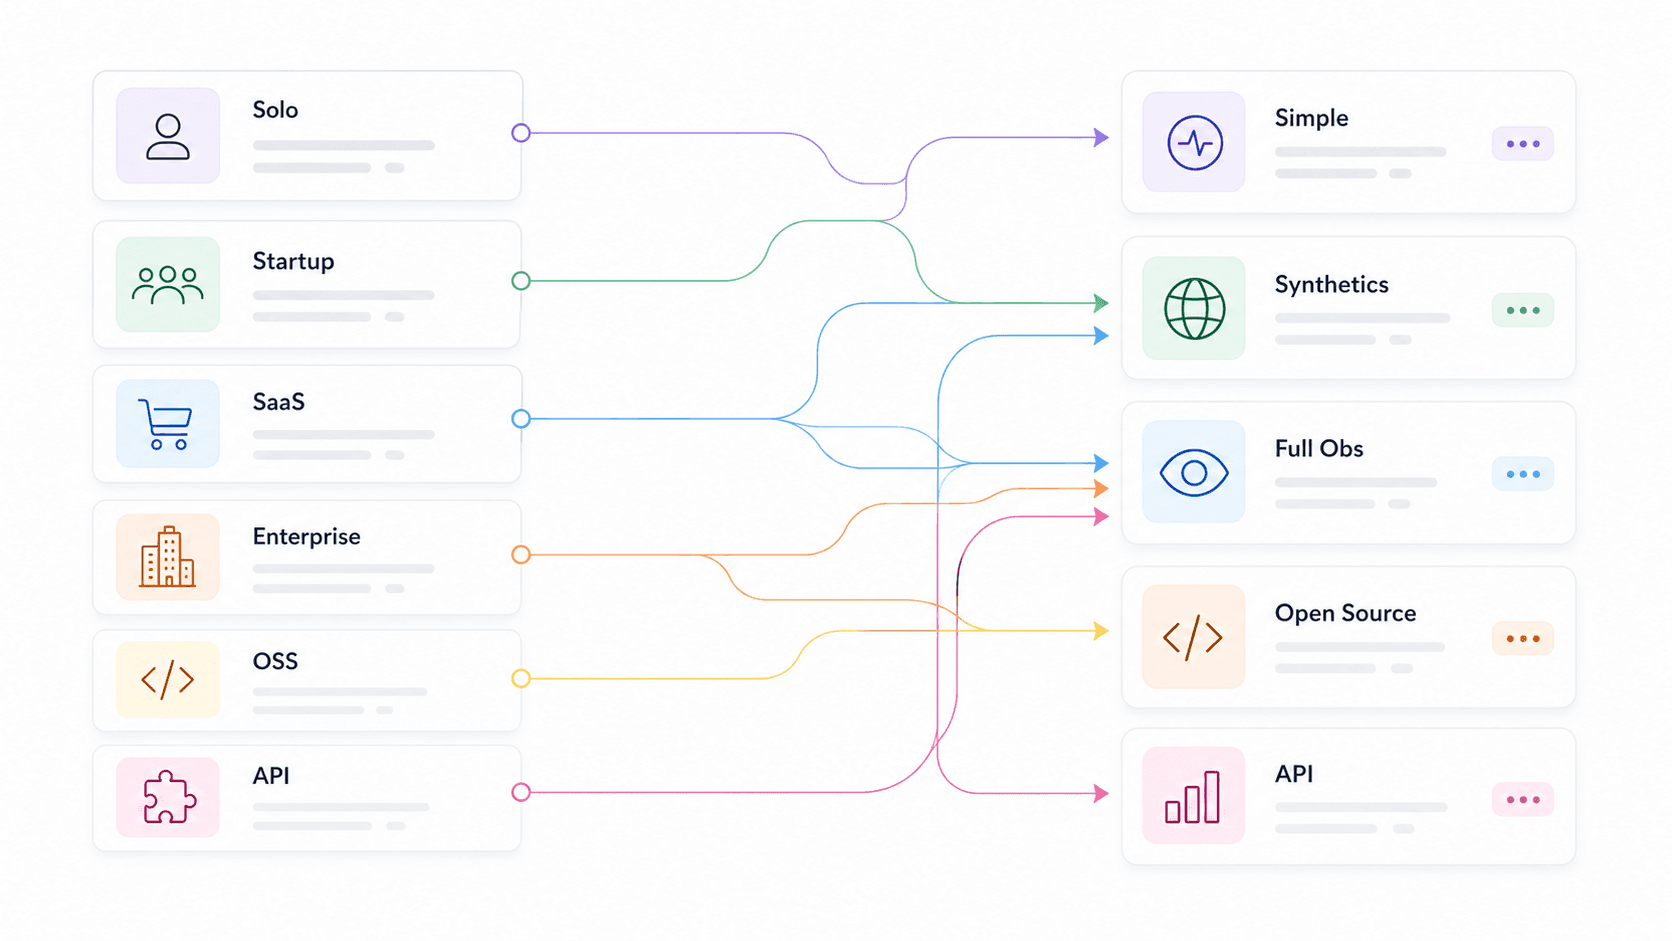
いちばん目立つ傾向は、導入が速いツールほど分析機能は軽めで、深い分析を持つプラットフォームほど設定とコスト管理が必要になる、という点です。これは欠点やなく、理解しておくべきトレードオフです。Thunderbit は少し別の領域にあります。ダウンタイムでエンジニアを起こすためやなく、Web ページを API で使えるデータに変えるときに、最速で力を発揮します。
Thunderbit Open API: Web サイトを構造化 API データに変えるなら最適
Thunderbit Open API で開発を始める ページを Markdown に要約し、構造化 JSON を抽出し、スクレイピング基盤を自前で持たずに URL を一括処理できます。 Get Started Free
Thunderbit Open API は、「監視」や調査のワークフローが外部 Web データに依存しているチームに、まず検討してほしい API です。Checkly や UptimeRobot みたいな従来型の uptime 監視ツールではありません。代わりに Thunderbit は、あらゆる Web ページを、アプリ、エージェント、ダッシュボード、LLM パイプラインでそのまま使えるきれいな構造化データへ変換します。
この API には3つの主要ワークフローがあります。Distill はページをきれいな Markdown にして、LLM 向けに整えます。Extract はスキーマを渡すと、商品名、価格、在庫、企業規模、資金調達 चरण、レビュー評価などの構造化 JSON を返します。Batch は webhook を使って最大100 URL を非同期処理でき、価格ページ、競合カタログ、ベンダーのドキュメント、ニュースソース、大規模な調査リストの監視に便利です。
これが API ツールガイドに入っている理由は、「このページを取ってきて」と言うだけで、実際にはかなり多くのインフラが必要になることを多くのチームが見落としがちやからです。JavaScript が多いサイトはレンダリングが必要です。ページによっては地域ルーティングも必要です。HTML は、LLM にとって役立つ前に、ナビバー、広告、モーダル、定型文を取り除く必要があります。レイアウト変更でセレクタは壊れます。プロキシ回転、ボット対策、リトライ、キュー、結果ポーリングが加わると、小さなデータ処理が保守案件に変わりかねません。Thunderbit は、その多くを1つの API の裏で吸収します。
おすすめの対象: AI アプリ開発者、RAG チーム、EC 運用、営業運用、グロースチーム、市場調査担当、そしてスクレイピング基盤を自前で作らずに Web データを API で取り込みたい開発者。
料金: 無料: 一度きりの API ユニット600。これは Distill なら600ページ、Extract なら30ページまで、同時リクエストは2件です。Starter は年間契約で月16ドル相当、年間60,000 API ユニットと同時リクエスト30件。Pro は年間契約で月40ドル相当、年間600,000 API ユニットと同時リクエスト50件です。
導入スピード: cURL、SDK、または Thunderbit CLI を使って API キーを取得し、最初の Distill または Extract リクエストを投げるまで約5〜15分。
注意点: Thunderbit は、稼働監視、障害エスカレーション、トレース、ログ、オンコールの振り分けにおいて、Datadog、New Relic、Better Stack、Checkly の代わりにはなりません。あくまで、ベンダー価格、ドキュメント、競合ページ、商品一覧、公開データセットなどを含む Web データを収集・整形するための API です。オンコール担当を起こす仕組みではありません。
Datadog: フルスタック可観測性なら最有力
Datadog は、エンタープライズやミッドマーケット SaaS の現場でよく見かけるツールです。理由は明快で、API 監視だけやなく、シンセティック API テスト、分散トレース、ログ、インフラ指標、リアルユーザー監視を1つの画面でつなげるフル可観測性プラットフォームやからです。
API モニタリングに限っても、Datadog は HTTP、SSL、DNS、WebSocket、TCP、UDP、ICMP、gRPC、さらに複数ステップの API テストをサポートします。異常検知モニターは期待値のパターンを学習し、「レイテンシが500msを超えたらアラート」みたいな固定閾値やなく、変化そのものに反応します。これはかなり大きな進化です。さらに、しきい値超過を予測する予測モニターや、複数条件を組み合わせる複合モニターも備えています。
おすすめの対象: API、インフラ、ログ、トレースを1つの画面で見たい EC、SaaS、エンタープライズチーム。
料金: 無料枠は製品ごとに異なります。Infrastructure Pro は1ホストあたり月15ドルから。API のシンセティックテストは 10,000 実行あたり5ドル。連携は800以上。
導入スピード: エージェント導入と基本的なシンセティックテストまで約15〜30分。
注意点: 大規模になると高くつきます。Hacker News や Reddit でも「請求額の急増」は定番の話題です。ホスト、ログ、カスタムメトリクス、シンセティック、ユーザーなど SKU がかなり多いので、ダッシュボードを見る人だけやなく、請求額も監視する人が必要です。プラットフォーム全体を使いこなすには学習コストもあります。
Checkly: 開発者ファーストのシンセティック監視なら最適
Checkly は、API チェックをコードの近くに置きたいスタートアップの開発チームに勧めたいツールです。基本思想は「監視をコード化する」こと。API やブラウザチェックをプログラムで定義し、世界中のロケーションから実行し、CI/CD パイプラインと統合し、すべてを Git で管理します。
アラート品質の面でも優秀です。Checkly のリトライ機能は、誤検知を防ぐ「最初の防衛線」として明確に位置づけられており、固定・線形・指数の各リトライ、同一ロケーションまたは別ロケーションでの再試行、アラート発報前の最大待機時間を設定できます。また、degraded / failed / recovered の状態を分けて扱えるため、ノイズの多いページ通知を減らすのに役立ちます。
おすすめの対象: プログラム可能な API チェック、Playwright ベースのブラウザチェック、CI/CD 連携、素早い導入を求めるスタートアップや開発チーム。
料金: 最近の公開情報では、無料プランに uptime monitor 10個、browser check 1,000件、API check 10,000件が含まれます。Starter は年額換算で月24ドル前後。購入前に公式料金ページを確認してください。
導入スピード: 最初の API チェックと通知先設定まで約10〜20分。
注意点: シンセティック監視に特化しています。深い APM、ログ分析、分散トレースの代替にはなりません。API 障害とデータベースのボトルネックを突き合わせたいなら、別ツールを併用する必要があります。
UptimeRobot: シンプルで手頃な uptime 監視なら最適
UptimeRobot は、API モニタリング界の Honda Civic みたいな存在です。HTTP、キーワード、ping、ポート、SSL、heartbeat の監視を作成し、間隔を選んで、失敗したら通知を受ける。それだけです。
おすすめの対象: 個人開発者、小規模チーム、代理店、あるいは複雑さなしで基本的な uptime とレイテンシ監視をしたい人。
料金: 無料: 50モニター、5分間隔。有料の Solo は年額換算で月7ドル前後。無料利用にクレジットカードは不要です。導入スピード: 約2〜5分で、このリストの中で最速です。
注意点: アラートの賢さは限定的です。基本的なしきい値アラートのみで、異常検知、分散トレース、深い分析はありません。エンドポイントが遅い「理由」を知りたい場合には向きません。
Uptime Kuma: 無料で自前運用するなら最強クラス
Uptime Kuma はセルフホスト界隈で人気が高く、GitHub の数字もそれを裏づけています。86,637 stars、7,831 forks、1,060 contributors を持ち、2026年5月時点では release 2.3.2 です。MIT ライセンスで、HTTP(s)、キーワード、JSON クエリ、WebSocket、TCP、ping、DNS、push、Docker、複数ステータスページ、90以上の通知サービスをサポートします。
おすすめの対象: 完全な制御、プライバシー、SaaS の継続課金ゼロを求める個人開発者やチーム。ただしサーバーを用意できることが前提です。
料金: 無料。実コストは VM/コンテナ、バックアップ、更新作業、そして監視対象そのものが生き続けるための運用です。導入スピード: Docker で基本チェックなら約5〜15分、通知やステータスページを整えるなら15〜30分。
注意点: 保守は自分持ちです。そして大事な落とし穴があります。監視対象と同じインフラ上で Uptime Kuma を動かすと、クラウド障害や DNS 障害でアプリと監視の両方が落ちます。別環境でホストするか、SaaS 監視と組み合わせてください。
Better Stack: 障害対応を素早く進めたいなら最適
Better Stack(ユーザーには今でも Better Uptime と呼ばれることが多い)は、uptime 監視に、インシデント管理、オンコールスケジュール、エスカレーションポリシー、ステータスページをひとまとめにしたプラットフォームです。分析ツールというより、監視を中心にしたインシデント対応ワークフローの方が強みです。
エスカレーションポリシーで、誰に、どの順番で、どれくらいの遅延を挟んで通知するかを決められ、確認が取れるまで続きます。メタデータベースのルーティングでは、重大度や担当に応じてインシデントを振り分けられます。Slack、Teams、webhook、Zapier と連携します。
おすすめの対象: 監視+障害対応+ステータスページを、3つの別ツールに分けずに使いたいスタートアップや中規模チーム。
料金: 無料枠は10 monitor/heartbeat、ステータスページ1つ。Team は年額換算で月29ドル前後。導入スピード: GUI ウィザードで約5〜10分。
注意点: Datadog、New Relic、Moesif と比べると、API ペイロード分析、分散トレース、ビジネス KPI 分析の深さは控えめです。
Prometheus + Grafana: オープンソースで組む定番 API モニタリングスタック
これは業界標準のオープンソース組み合わせです。Prometheus が時系列メトリクスを収集・保存し、Grafana(GitHub stars 73,705、contributors 3,010)がダッシュボードとアラートを提供します。Alertmanager は通知のルーティング、グルーピング、重複排除、サイレンス、抑制を担当します。API エンドポイントの確認には、Blackbox Exporter を足して、HTTP、HTTPS、DNS、TCP、ICMP、gRPC のプローブを行います。
おすすめの対象: オープンソース重視派、Kubernetes/SRE チーム、すでに Prometheus メトリクスを標準化している組織。
料金: 自前運用なら無料。Grafana Cloud には無料枠(API テスト実行10万回/月)と、利用量課金の有料プランがあります。
導入スピード: 基本的な Blackbox + Prometheus + Grafana + Alertmanager で1〜4時間。本番 HA とアラート調整まで含めると数日かかることもあります。
注意点: PromQL、YAML、relabeling、ダッシュボード設計、保存期間、ストレージ、HA、アラート調整は、ちゃんとした運用作業です。繰り返し出てくるトレードオフは「UI は少なく、YAML は多い」。最初からメトリクス思考で、1つの制御面を持ちたいチーム向けで、昼飯までに監視を立ち上げたいチーム向けやありません。
New Relic: SaaS のアプリ性能管理なら最適
New Relic は、APM、インフラ監視、ログ、分散トレース、シンセティック監視、アラート、ダッシュボード、AI 支援のインシデント分析をまとめた製品です。無料枠の月100GB のデータ取り込みとフルプラットフォームユーザー1人は、小規模チームにとってかなり太っ腹です。
アラート疲れの文脈では、New Relic のアラート品質が際立ちます。incident intelligence には、イベント相関、異常検知、予測アラート、原因分析、フラッピング抑制が含まれます。New Relic は、フラッピング抑制の有効性が97.2%なら、1,000件のフラッピング事象のうち表面化する問題は28件だけという例も公開しており、ノイズ削減を数字で示しています。
おすすめの対象: API 監視を、アプリレベルのトレース、エラー、スループット、ユーザー影響と強く結びつけたい SaaS チームや EC プラットフォーム。
料金: 無料: 月100GB、フルユーザー1人。有料はユーザー単価とデータ量ベース。
導入スピード: エージェント導入とガイド付き設定で約15〜30分。
注意点: 大規模運用では料金体系が複雑になりがちです。アラート設定にも学習コストがあり、強力ですが直感的とは言い切れません。
Moesif: API 分析とビジネスメトリクスなら最適
Moesif は、従来型の uptime モニターではありません。顧客別、エンドポイント別、コホート別、企業別、地域別、SDK 別、プラン別、行動別に API 利用を理解するための API 分析・プロダクトインテリジェンスです。あなたの質問が「エンドポイントは生きているか」やなく「どの顧客が影響を受けたのか」なら、Moesif はそのための製品です。
静的なしきい値アラートと動的な異常アラートをサポートしており、トラフィック急増・急減、レイテンシ、行動変化などを監視できます。動的アラートは、モデルを作るために数日分の API 挙動が必要ですが、学習後は静的ルールでは見逃す変化を捉えられます。
おすすめの対象: API プロダクトチーム、SaaS 企業、EC プラットフォームなど、API の性能を売上・利用率・継続率と結びつけたい場合。
料金: 無料/トライアルあり。有料は API イベント量でスケールします。セルフサービスでの正確な金額は私の調査では完全には取れなかったので、最新ページを確認してください。
導入スピード: 約20〜45分(SDK / プロキシ / ゲートウェイ連携が外部 ping より深い)。
注意点: 従来の uptime 監視というより分析寄りです。外部からの可用性チェックには、Checkly、UptimeRobot、Datadog のシンセティック監視を併用することになるでしょう。
Splunk: エンタープライズのログ分析とコンプライアンスなら最適
Splunk は、ログ集約、検索、相関分析、コンプライアンス対応の監査性、ハイブリッド/マルチクラウド対応が外せへんときに使うツールです。Splunk Observability Cloud は、インフラ、APM、シンセティック、リアルユーザー監視、ログ、インシデント対応をカバーします。ITSI/Event Analytics は、注目イベントをエピソードにまとめ、監視サイロをまたいだノイズを減らせます。
Splunk 自身の2025年可観測性調査はかなり厳しい内容です。ITOps/エンジニア回答者の73%が、無視または抑制されたアラートが原因の障害を報告し、59%がツールの多さに苦労し、52%が誤アラートに悩んでいると答えています。
おすすめの対象: 厳格なコンプライアンス、セキュリティ、監査、ログ検索要件を持つエンタープライズやマルチクラウドチーム。
料金: 従量課金・見積もりベース。簡単な本番向け無料枠はありません。
導入スピード: クラウド導入は比較的速いですが、エンタープライズ展開は数日〜数週間かかることがあります。
注意点: 高価です。設定も複雑。個人開発や小規模スタートアップには過剰です。
Postman: すでに API テストをしているチーム向け
Postman は主に API 開発・テストのプラットフォームですが、monitoring 製品を使えば、Postman コレクションをスケジュールし、クラウドロケーションから実行できます。いちばん強いポイントは再利用性です。QA や開発チームがすでにアサーション付きのコレクションを持っているなら、それを監視に変えるのは自然な次の一歩です。
おすすめの対象: すでに Postman コレクションを使っていて、別のシンセティックツールを買わずに定期チェックしたい開発・QA チーム。
料金: 無料枠あり。監視の超過料金は1,000回あたり0.75ドル。50,000回分の追加ブロックは月20ドル。現在のプランページも確認してください。Postman はプラン構成が変わることがあります。
導入スピード: 既存コレクションがあれば約10分。
注意点: Checkly、Datadog、New Relic みたいな専用ツールに比べると、監視機能は軽めです。アラートオプションも基本的です。
そのほか注目したい API モニタリングツール
Gatus: 軽量で自前運用できる、設定駆動のヘルスダッシュボード。GitHub stars 10,906 を持ち、HTTP、ICMP、TCP、DNS、Prometheus 連携しやすいメトリクス、uptime バッジをサポートします。Prometheus よりシンプルで、Uptime Kuma の GUI より YAML / 設定駆動を好む個人開発者に向いています。
Apitally: スタートアップ向けに API トラフィック分析と品質追跡にフォーカスした新しめのツール。5分以内で導入できるとされ、14種類のメトリクスにまたがるカスタムアラートを備えます。フル可観測性プラットフォームを入れずに、軽量な API 分析をしたい場合にええ選択です。
Sematext: ログ、シンセティック、インフラ可視化を備えたフルスタック監視。シンセティックは HTTP monitor 1つ約2ドル、browser monitor 1つ約7ドル、最低月5ドル。ミッドマーケット向けの、より安価な Datadog 代替です。
Uptrace: OpenTelemetry ネイティブの APM、トレース、メトリクス、ログのバックエンド。GitHub stars 4,198。純粋な uptime チェッカーではありませんが、OTel を標準化したいチームが、オープンソース寄りのトレース基盤を求めるなら理想的です。
自作 vs 購入: API モニタリングは自前で組むべきか?
「エンドポイントに ping を打つスクリプトを自分で書けばええんやない? それとも専用ツールを使うべき?」
これは開発者フォーラムでほんまによく出る質問です。Reddit のスレッドを十分読んできたので、流れははっきり分かります。チームはまず curl + cron から始め、しばらくはそれで十分動きます。でも、ダッシュボード、履歴データ、マルチリージョンチェック、信頼できる通知ルーティング、チーム横断の可視化が必要になった時点で、専用ツールに乗り換えるのです。
率直な判断表はこちらです。
| 観点 | 自作スクリプト | 専用ツール |
|---|---|---|
| 導入時間 | 1〜4時間(基本)、堅牢化すると数日 | 5〜30分 |
| 保守 | 永続的に自分で管理 | ベンダーが更新を担当 |
| アラート品質 | 基本的(up/down) | 賢い(レイテンシ傾向、異常、リトライ) |
| コスト | 無料(ただし自分の時間) | 月0〜500ドル以上 |
| ダッシュボード | ゼロから作る | 既製、カスタマイズ可 |
| 向いている場合 | エンドポイントが3個以下、開発寄りのチーム、趣味プロジェクト | エンドポイントが5個以上、運用/プロダクトチーム、売上に直結 |
フォーラムから見えてくる大事な点は、自作した人の多くが、ダッシュボード、履歴データ、チーム横断の可視化が必要になった時点で後悔することです。さらにメタな問題として、「監視にも監視が必要」です。セルフホストの監視、自分の DB、バックアップ、ネットワーク経路、通知プロバイダも、全部信頼できなあかんのです。
エンドポイントが2つしかなく、試行錯誤が好きなら自作で十分です。出すべきプロダクトがあるなら、買うべきです。
同じ理屈は Web データ抽出にも当てはまります。スクレイパーを書き、ヘッドレスブラウザを動かし、プロキシを回し、セレクタを保守し、HTML を整え、キューを作ることはできます。ただし、Web データを API 製品や AI エージェント、調査ワークフローへ安定供給するのが目的なら、Thunderbit Open API を使う方が、自前でスクレイピング基盤を組むよりたいてい速いです。
アラート疲れ: なぜ数より質が大事なのか
API モニタリングツールを選ぶとき、これがいちばん見落とされがちな基準かもしれません。アラート疲れとは、ノイズの多い重複通知や、行動につながらない通知が多すぎて、チームが全部を無視するようになり、結果として本当に重要な障害を見逃す状態のことです。
数値はかなり衝撃的です。BigPanda の2025年レポートでは、中央値の組織が1日2,350件のアラート、年間803,406件を生成していました。インシデントのアクション可能性の中央値はわずか18%で、5件に1件も実際には対処可能やないということです。NeuBird の2026年調査では、オンコールチームの77%が1日10件以上のアラートを受け取り、80%がその半分以下しか行動につながらないと答えています。
最良の監視ツールとは、アラートを実際に信頼できるものです。各ツールのアラートの賢さを比べると次のようになります。
| ツール | アラート種別 | ノイズ削減の方法 | 通知チャネル |
|---|---|---|---|
| Datadog | ML 異常検知、予測、複合 | 過去の異常帯、動的ベースライン、Watchdog AI | Slack、PagerDuty、Opsgenie、Teams、20以上 |
| Checkly | しきい値 + 劣化ベース | 発報前のリトライ、同一/別ロケーション再試行 | Slack、PagerDuty、Opsgenie、Teams、incident.io |
| New Relic | AI による課題グルーピング、異常、予測 | イベント相関、フラッピング抑制、原因コンテキスト | Slack、PagerDuty、Teams、webhook |
| Moesif | 振る舞いベースの異常 | 数日分の挙動をもとにした動的モデル | Slack、PagerDuty、email、SMS |
| Better Stack | uptime / インシデント / オンコール | エスカレーションポリシー、担当ルーティング、遅延設定 | Slack、Teams、webhook、Zapier |
| Prometheus + Alertmanager | PromQL ルールアラート | グルーピング、重複排除、サイレンス、抑制 | email、PagerDuty、Opsgenie、webhook |
| Splunk | イベント、エピソード、サービス健全性 | ITSI Event Analytics、エピソードグルーピング、チケット連携 | Splunk On-Call、ServiceNow、webhook |
| Thunderbit Open API | アラート基盤ではない | 自前のスケジューラ、ワークフローツール、監視スタックと併用 | バッチジョブ用 webhook。アラートは外部で処理 |
実践的な助言: 少数で信頼度の高いアラートから始めてください。発報前リトライ、複数リージョン確認、SLO バーンレートアラート、重複排除、担当ルーティングを使いましょう。内部の症状を全部アラートするんやなく、ユーザー影響や事業上重要なフロー(購入失敗、認証失敗、支払いの 5xx)に絞るべきです。
2026年版 無料枠と料金: 実際いくら払うのか
料金ページは変わります。無料枠も動きます。隠れコスト(ホスト、席数、ログ、シンセティック実行、データ取り込み)に驚かされることもあります。これは、あらゆる「おすすめツール」記事にあってほしいセクションです。2026年時点のスナップショットは次のとおりです。
| ツール | 無料枠 | 有料開始価格 | クレジットカード必要? | 無料で向いている用途 |
|---|---|---|---|---|
| Thunderbit Open API | 一度きりの API ユニット600 | 年額換算で月約16ドル | 不要 | LLM、RAG、価格調査、リサーチ向けの Web データ抽出 |
| Uptime Kuma | 無制限(自前運用) | — | 不要 | フル監視、自前サーバー |
| UptimeRobot | 50モニター、5分間隔 | 月約7ドル | 不要 | 基本的な uptime チェック |
| Better Stack | 10モニター、ステータスページ1つ | 月約29ドル | 不要 | スタートアップ向け uptime + ステータスページ |
| Checkly | uptime 10件、API チェック1万件 | 月約24ドル | 必要 | シンセティック API チェック |
| Postman | 無料アカウント + 監視枠 | 月14ドル/ユーザー前後 | 不要 | 既存コレクションの再利用 |
| Prometheus + Grafana | 無制限(自前運用) | — | 不要 | メトリクス + 可視化 |
| Grafana Cloud | API テスト実行10万回/月 | 月29ドル + 従量課金 | 確認要 | マネージド・シンセティックの試用 |
| New Relic | 月100GB、フルユーザー1人 | ユーザー単価 + データ量課金 | 一部プランで必要 | APM + 基本的な可観測性 |
| Datadog | 試用/製品によって異なる | 月15ドル/ホスト(Infra Pro) | 多くの場合必要 | フルスタック評価 |
| Moesif | 無料/トライアルあり | 量ベース | 確認要 | API 分析の評価 |
| Splunk | トライアルあり | 見積もりベース | 営業対応 | エンタープライズ PoC |
| Gatus | 無制限(自前運用) | — | 不要 | YAML 駆動のステータスダッシュボード |
| Apitally | 無料/トライアルあり | 確認要 | 確認要 | 軽量な API 分析 |
| Sematext | 試用/無料は変動 | HTTP monitor 約2ドル | 確認要 | 低コストのシンセティック/ログ |
| Uptrace | 無料の自前運用 | クラウド価格は変動 | 確認要 | OTel APM の評価 |
隠れコストの注意: Uptime Kuma、Prometheus、Gatus みたいな自前運用ツールは、ライセンス上は「無料」でも、小さな VM、バックアップ、保守時間、外部フェイルオーバーが実際のコストになります。Web データ API の隠れコストは別の形で出ます。ヘッドレスブラウザ、壊れたセレクタ、プロキシプール、ボット対策の回避、HTML 整形の維持です。
小規模チームの目安: API エンドポイントが10個、チームメンバーが3人なら、最安の SaaS ルートはたいてい UptimeRobot の無料/低価格プラン、Better Stack の無料/Team、または実行量が合うなら Checkly です。Datadog と New Relic も検証用途なら手頃ですが、実際の請求額はホスト数、ユーザー数、ログ、トレース、シンセティック実行量で大きく変わります。もしプロジェクトが Web サイトデータを API として必要とするなら、Thunderbit の無料 API ユニットで、課金前にワークフローを試せます。
導入難易度スコアカード: 初回アラートまでどれくらい速いか
私が見たどの競合記事も、価値実現までの時間、つまり登録してから最初の意味あるアラートを受け取るまでの速さを評価していません。小規模チームにとって、これは機能の深さより大事なこともあります。
| ツール | 初回アラートまでの時間 | 必要な技術レベル | 設定方法 |
|---|---|---|---|
| Thunderbit Open API | 約5〜15分 | 低〜中 | API キー、cURL/SDK/CLI |
| UptimeRobot | 約2〜5分 | 低 | GUI、クリックで追加 |
| Better Stack | 約5〜10分 | 低 | GUI ウィザード |
| Checkly | 約10〜20分 | 低〜中 | コードまたは GUI |
| Postman | 約10分(既存コレクションあり) | 低〜中 | コレクションスケジューラ |
| Uptime Kuma | 約5〜30分 | 中 | Docker + GUI |
| Gatus | 約15〜45分 | 中 | YAML + Docker |
| Datadog | 約15〜30分 | 中 | エージェント導入 + GUI |
| New Relic | 約15〜30分 | 中 | エージェント + ガイド付き設定 |
| Moesif | 約20〜45分 | 中 | SDK/プロキシ統合 |
| Grafana Cloud Synthetics | 約15〜45分 | 中 | GUI、Terraform は任意 |
| Prometheus + Grafana | 1〜4時間 | 中〜高 | YAML、PromQL |
| Uptrace | 30〜90分 | 中〜高 | OTel SDK 統合 |
| Splunk | 数時間〜数週間 | 高 | エンタープライズ導入 |
その日のうちに監視を動かしたいなら、この表の上半分から始めてください。堅牢なプラットフォーム可観測性が目的なら、下半分は別プロジェクトとして計画するのがええでしょう。そして、最初の目標が「この100ページの Web データをアプリにきれいに入れること」なら、カスタムスクレイピング基盤を作る前に Thunderbit から始めてください。
API モニタリングツールの比較一覧
決める前にまず眺めたい、1枚で分かる表です。
| ツール | 最適な用途 | 無料枠 | アラートの賢さ | 導入時間 | ホスティング | 目立つ特徴 |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Web データ抽出 / API データパイプライン | API ユニット600 | アラートツールではない | 5〜15分 | クラウド | ページを Markdown に要約、またはスキーマベース JSON を抽出 |
| Datadog | フルスタックのエンタープライズ/SaaS | 試用/変動 | 異常検知、予測、AI | 15〜30分 | クラウド | シンセティックをログ/トレース/インフラと相関 |
| Checkly | 開発者ファーストのシンセティック監視 | 手厚いチェック枠 | リトライ、劣化検知 | 10〜20分 | クラウド | Monitoring as Code + Playwright |
| UptimeRobot | シンプルな uptime 監視 | 50モニター | 基本しきい値 | 2〜5分 | クラウド | 最速の低コスト基本監視 |
| Uptime Kuma | 無料の自前運用 | 無制限 | 基本的な状態/しきい値 | 5〜30分 | 自前運用 | すっきりした UI、SaaS 料金なし |
| Better Stack | インシデント対応 / ステータスページ | 10モニター | エスカレーション、ルーティング | 5〜10分 | クラウド | 監視 + オンコール + ステータスページ |
| Prometheus + Grafana | オープンソースのメトリクス基盤 | 無制限(自前運用) | Alertmanager のグルーピング | 1〜4時間 | 自前運用/クラウド | PromQL エコシステムの深さ |
| New Relic | SaaS APM + API チェック | 月100GB、ユーザー1人 | AI グルーピング、フラッピング抑制 | 15〜30分 | クラウド | APM とシンセティックを強く組み合わせる |
| Moesif | API 分析 / ビジネスメトリクス | 無料/トライアル | 行動ベースの異常 | 20〜45分 | クラウド | 顧客別の API 挙動分析 |
| Splunk | エンタープライズのログ / コンプライアンス | トライアル | ITSI エピソード、AIOps | 数日以上 | クラウド/自主管理 | エンタープライズ向けログ検索と統制 |
| Postman | API テスト済みのチーム | 無料アカウント | 基本的な監視アラート | 10分 | クラウド | 既存の API テストコレクションを再利用 |
Thunderbit が API ツール選定を速くする方法
はっきり言うと、Thunderbit は API モニタリングツールやありません。Web ページをきれいな Markdown や構造化 JSON に変える、エージェント型の Web スクレイパー兼 Open API です。だからこそ、監視ツールを選ぶ前段階、つまりベンダー価格、プラン上限、機能訴求、ドキュメントの詳細、連携一覧を集める工程で役立ちます。
10社以上のベンダー料金ページを1つずつ開いて、プラン名、モニター上限、チェック間隔、連携、クレジットカード要否をスプレッドシートに手入力する代わりに、私たちは Thunderbit Chrome Extension を使って、各ツールの料金ページと機能ページから構造化データを抜き出しました。Thunderbit の AI が各ページを読み取り、プラン名、無料枠、価格、対応連携などのフィールドを提案し、そのまま書き出せる表に整えてくれます。
開発者向けのワークフローでは、Thunderbit Open API が同じ考え方をプログラムで実現します。LLM や RAG 用にきれいな Markdown が欲しいなら Distill。特定フィールドを JSON で返したいなら Extract。料金ページ、ドキュメント URL、商品ページ、競合ページのリストをまとめて非同期処理したいなら Batch を使ってください。
流れはこうです。
- ベンダーの料金ページ(Datadog、Checkly、UptimeRobot など)を開く
- 「One Click Extract」を押す。Thunderbit の AI がページを読み取り、構造を把握し、一度で表を埋める
- サブページ抽出で、各ベンダーの料金、機能、ドキュメントページを取得する
- Google Sheets、Excel、Airtable、Notion、CSV に書き出す
API ファーストのチームなら、API ワークフローも同じくらい簡単です。
- Thunderbit で無料の API キーを取得する
- Distill エンドポイントを呼び出して、公開ページからきれいな Markdown を取得する
- スキーマ説明付きで Extract エンドポイントを呼び出し、構造化 JSON を取得する
- より多くの URL は Batch エンドポイントと webhook で処理する
- 出力をアプリ、スプレッドシート、データウェアハウス、ベクターデータベース、監視ワークフローに流し込む
10社以上を比較するなら、料金ページ、ドキュメント、連携ページまで含めた手作業のコピペは、あっという間に2〜3時間かかります。Thunderbit を使うと、初回の抽出はおよそ15〜30分まで短縮でき、残りは検証と判断に時間を使えます。運用、購買、調査、AI プロダクトの各チームが時間に追われてツール選定をしているなら、実用的な近道です。この種のワークフローについては、コードなしの Web スクレイピング ガイドや、Thunderbit の API 料金、さらに手順解説をまとめた YouTube チャンネル も参考になります。
チームに最適な API モニタリングツールの選び方
「最適」な API モニタリングツールは、チームの規模、技術力、予算、そして自社製品で障害が起きたときに何が失われるかで変わります。
個人開発者に Splunk は必要ありません。規制の厳しい企業が cron ジョブに頼るべきでもありません。API プロダクトチームは、uptime の ping より Moesif 的な顧客分析を必要とするかもしれません。EC チームなら、ログイン、検索、カート追加、チェックアウト、支払い認可みたいな重要フローのチェックを優先すべきです。AI やデータ系プロダクトチームは、フル可観測性より先に Thunderbit 風の Web データ抽出が必要かもしれません。
私の調査全体を通して一貫していた原則は次の3つです。
- 用途に合ったツールを選ぶ。 早見表があるのはそのためです。まずそこから始めてください。
- アラート数よりアラート品質を重視する。 チームがアラートを無視するなら、それは監視やなくノイズです。
- 導入スピードを軽視しない。 今日動いて信頼できるアラートを出せる監視は、完璧な構想だけあっても来月まで checkout が無監視のまま、という状態よりずっとええです。
複数ツールを同時に比較して調査を加速したいなら、ベンダー情報を1つのスプレッドシートに一括抽出するために Thunderbit を試してみてください。API プロダクト、RAG パイプライン、AI エージェント、マーケットインテリジェンスのワークフローで、きれいな Web データが必要なら、Thunderbit Open API から始めるのがええでしょう。監視ツールを代わりに選んでくれるわけやありませんが、意思決定までの時間は確実に短くできますし、自社プロダクトに信頼できる Web データ層を持たせることもできます。
最適な API モニタリングツールに関する FAQ
2026年に最もおすすめの無料 API モニタリングツールは?
SaaS の手軽さを求めるなら、UptimeRobot が 5分間隔のモニター50個を無料で提供し、クレジットカードも不要です。自前運用の自由度を求めるなら、Uptime Kuma はオープンソースで無制限、90以上の通知サービスを備えた見やすい UI が魅力です。すでに技術力があり、メトリクスの深さを重視するチームなら、Prometheus + Grafana + Alertmanager が最強のオープンソース構成です。ただしセットアップは数分やなく、数時間かかります。
目的が uptime 監視やなく、API 経由で Web データを抽出することなら、Thunderbit Open API の無料枠は API ユニット600で、ページを Markdown に整える処理やスキーマベースの JSON 抽出を、スケール前に試すのに十分です。
API モニタリングと APM の違いは?
API モニタリングは外側から、エンドポイントの可用性、応答時間、エラー、正確性を確認します。つまり、ユーザーや連携先が体験する状態を再現するものです。APM(Application Performance Monitoring)はアプリの内側まで踏み込み、コードレベルのトレース、DB クエリ、ランタイムエラー、キュー遅延、サービス依存関係を見ます。Datadog や New Relic は両方を提供しますが、UptimeRobot や Uptime Kuma は外部 uptime チェックに特化しています。
Thunderbit Open API はこのどちらとも少し違います。これは Web データ抽出 API です。外部 Web サイトを Markdown か構造化 JSON に変換でき、LLM アプリ、調査ワークフロー、価格インテリジェンス、データパイプラインに役立ちます。
API はどのくらいの頻度で監視すべきですか?
本番の売上に直結する API(checkout、認証、決済)は、通常1分ごとにチェックすべきです。社内用やトラフィックの少ない API なら、5分ごとでも十分なことが多いです。ただし頻度だけでは不十分です。リトライ、複数リージョン、意味のあるアサーションを使い、各チェックを速く、かつ信頼できるものにしてください。1分ごとでも誤報だらけなら、信頼できる5分ごとのチェックより悪いです。
Web データ抽出の頻度は、ソースがどれくらい頻繁に変わるかで決まります。価格ページなら日次または週次で十分かもしれません。値動きの速い在庫、旅行、マーケットプレイス系のデータは、時間単位またはそれ以上の更新が必要になることがあります。多数の URL を定期処理するなら、Thunderbit のバッチ API と webhook が便利です。
コードを書かずに API を監視できますか?
はい。UptimeRobot、Better Stack、Uptime Kuma はすべて GUI だけで使えます。Checkly は GUI とコードベース設定の両方をサポートします。Postman はコレクション中心の UI です。Prometheus/Grafana は通常 YAML と PromQL が必要です。Datadog と New Relic はガイド付き設定から始められますが、より強力に使うには深い計装が役立ちます。
Web サイトのデータをコードなしで抽出したいなら、Thunderbit の Chrome Extension がノーコードの入口です。アプリから同じワークフローを自動化したいなら、Thunderbit Open API で Distill、Extract、Batch エンドポイントを使えます。
API モニタリングのアラート疲れをどう減らせばいいですか?
賢いアラート機能を持つツールを選んでください。異常検知(Datadog、New Relic)、発報前リトライ(Checkly)、振る舞い異常(Moesif)、グルーピング/サイレンス(Prometheus Alertmanager)などです。まずは少なく、信頼度の高い、ユーザー影響に直結するアラートに絞って始めましょう。静的なしきい値やなく SLO バーンレートアラートを使い、サービス横断で重複排除し、担当別にルーティングし、実際に行動につながった割合を測ってください。もしアラートの20%未満しか本当の対応につながらないなら、先にノイズを減らすべきです。
Web データ抽出に Thunderbit Open API を試す Get Started Free
さらに詳しく読む



