
Yelp ospita 330 milioni di recensioni cumulative e oltre 8,4 milioni di attività rivendicate — e se hai provato di recente a estrarre uno di questi dati, sai bene che non è affatto semplice. Tra CAPTCHA aggressivi, blocchi IP e script Python che si rompono, fare scraping di Yelp nel 2026 è un po’ come cercare di passare davanti a un buttafuori che ti riconosce già in faccia.
Negli ultimi giorni ho testato uno contro l’altro 10 strumenti per estrarre recensioni Yelp: dalle estensioni Chrome no-code alle API per sviluppatori, fino alle piattaforme enterprise per i dati. L’obiettivo era semplice: capire quali strumenti funzionano davvero su Yelp oggi, quali promettono più di quanto mantengano e quali meritano davvero il tuo tempo (e il tuo budget).
Qui sotto ti guiderò attraverso ogni strumento, con una tabella comparativa completa e anche gli aspetti pratici di cui quasi nessuno parla — come gestire i duplicati, usare lo scraping per generare lead e capire come appare davvero un export dei dati Yelp. Se sei un commerciale, un local marketer o ti occupi di operations e vuoi dati Yelp puliti senza scrivere una sola riga di codice, questo articolo fa per te.
Perché estrarre recensioni Yelp nel 2026 (e perché è diventato più difficile)
Yelp non è solo un sito di recensioni: è un vero database di business intelligence in tempo reale. L’82% degli utenti Yelp contatta o acquista da un’attività trovata sulla piattaforma entro una settimana, e ogni giorno vengono inviati alle aziende oltre 85.000 nuove richieste o messaggi. Per le aziende, questo si traduce in casi d’uso molto concreti:
- Analisi della concorrenza: confronta valutazioni, numero di recensioni, categorie, servizi e posizionamento di quartiere nel tuo mercato.
- Monitoraggio del sentiment: traccia nel tempo testo delle recensioni, stelle, date e risposte dei proprietari.
- Generazione di lead: recupera nomi delle attività, telefoni, siti web, indirizzi, categorie e, in alcuni casi, contenuti del profilo del proprietario.
- Ricerca SEO locale: studia frequenza delle recensioni, etichette di categoria, foto e segnali di engagement.
Ma c’è un problema: a partire dal 2024 Yelp ha reso lo scraping molto più difficile. Il loro Trust & Safety Report 2025 mostra che la piattaforma ha processato 22 milioni di recensioni, chiuso oltre 1,3 milioni di account utente e segnalato comportamenti sospetti associati a singoli indirizzi IP. Dal punto di vista tecnico, oggi Yelp usa fingerprinting TLS/JA3, classi CSS offuscate e controlli aggressivi sulla reputazione IP. Il benchmark di AIMultiple luglio 2026 sullo scraping delle recensioni ha inviato 500 URL di recensioni Yelp a ciascuno di cinque provider commerciali. Bright Data è arrivata prima con il 77% e Zyte ha raggiunto il 57%, mentre Nimble si è fermata al 31%; Decodo e Oxylabs non hanno restituito nulla di utilizzabile su Yelp.
Anche le prove degli utenti sono piuttosto chiare. Un utente Reddit nell’ottobre 2024 ha segnalato che il suo script Beautiful Soup era "completamente rotto" dopo l’arrivo di un nuovo CAPTCHA. Un altro su Stack Overflow ha descritto errori 503 ripetuti con Scrapy. I flussi requests + BeautifulSoup tradizionali? Confermati come non funzionanti. Vecchi script Selenium senza undetected-chromedriver? Stessa storia.
Ecco perché scegliere lo strumento giusto conta più che mai — ed è il motivo per cui ne ho testati 10, così non devi farlo tu.
Cosa rende davvero valido uno scraper per recensioni Yelp? (Criteri di selezione)
Non tutti gli scraper Yelp sono uguali. Ho valutato ogni strumento di questa selezione in base a sette criteri importanti sia per sviluppatori, sia per commerciali, sia per piccoli titolari di agenzie:
| Criterio | Perché conta |
|---|---|
| Facilità d’uso (no-code vs. codice) | La maggior parte delle persone che cerca questo tipo di strumento vuole evitare Python, non pagare qualcun altro per scriverlo |
| Gestione anti-bot / CAPTCHA | Il problema n. 1: la stretta di Yelp tra 2024 e 2026 fa la differenza tra successo e fallimento |
| Campi dati estratti | Gli utenti vogliono recensioni + nomi dei proprietari + email + telefono, non solo le stelle |
| Formati di export | CSV, Google Sheets, Airtable, Notion: l’integrazione nei workflow reali conta davvero |
| Prezzo / piano gratuito | Molti lavori su Yelp sono abbastanza piccoli da rientrare in un piano free, se i limiti sono chiari |
| Paginazione e scala | Evitare duplicati su larga scala è un problema ricorrente e ancora irrisolto |
| Arricchimento delle sottopagine | Lo strumento può passare automaticamente da un risultato di ricerca alla scheda del singolo business? |
Per riferimento, le pagine business di Yelp possono esporre un insieme di campi sorprendentemente ricco: nome attività, valutazione, numero di recensioni, categoria, indirizzo, telefono, sito web, orari, quartiere, foto, testo delle recensioni, date delle recensioni, nomi dei recensori e, in alcuni casi, risposte del proprietario o contenuti del profilo aziendale per le pagine rivendicate. I migliori strumenti estraggono gran parte di questi dati; i più deboli ne recuperano solo alcuni.
Perché gli scraper come estensione Chrome meritano un posto in questa lista
Una cosa che ho notato mentre preparavo questo articolo: le raccolte sui migliori scraper Yelp parlano quasi sempre di piattaforme SaaS, API o librerie Python. Le estensioni browser vengono appena nominate. Eppure la domanda esiste davvero — nello stesso thread Reddit di ottobre 2024, un utente il cui scraper Python si era rotto dopo il nuovo CAPTCHA di Yelp ha raccontato che Instant Data Scraper continuava a funzionare perché "gira direttamente nel browser".
Gli scraper basati su browser ereditano un contesto più simile a quello umano: una sessione già attiva, esecuzione JS normale, cookie realistici e meno segnali evidenti di automazione lato server. Non sono invincibili — il centro assistenza di Yelp dice chiaramente che lo scraping tramite estensioni browser non è consentito. Però, dal punto di vista pratico dell’anti-bot, la raccolta via browser crea meno problemi rispetto alle richieste HTTP pure, soprattutto sulle pagine elenco e nei flussi leggeri.
Thunderbit e Instant Data Scraper si sono guadagnati un posto in questa lista proprio perché le estensioni browser sono la categoria che spesso viene ignorata in questi confronti — e risolvono un problema reale per chi non è tecnico.
Prova Thunderbit per lo scraping Yelp
1. Thunderbit — Il miglior scraper Yelp per chi non è tecnico
 Thunderbit è lo strumento che abbiamo sviluppato in azienda, quindi lo dico subito apertamente — ma lo metto al primo posto perché, tra tutti questi strumenti, è davvero quello con la copertura no-code più forte per Yelp. Thunderbit è un’estensione Chrome basata su AI, con template dedicati per gli elenchi business di Yelp e per le pagine recensioni Yelp. Apri la pagina, clicchi una volta e l’AI capisce da sola quali colonne estrarre. Se sai già cosa ti serve, puoi descriverlo e userà quelle indicazioni.
Ciò che rende Thunderbit particolarmente utile per Yelp sono le sue due modalità di scraping. Lo scraping dal browser gira nella tua sessione Chrome, quindi è molto utile quando Yelp è più ostile alle richieste lato server (cosa che nel 2026 succede quasi sempre sulle pagine directory). Lo scraping cloud può elaborare fino a 50 pagine in parallelo per le pagine profilo business pubbliche, dove la pressione anti-bot è più leggera.
La funzione di scraping delle sottopagine è quella che diventa davvero interessante per la lead generation. Puoi partire da una pagina di risultati Yelp, estrarre gli elenchi e poi far visitare automaticamente a Thunderbit ogni singola scheda business per aggiungere campi più ricchi — nome del proprietario, URL del sito, email (tramite il free email extractor di Thunderbit) e numero di telefono (tramite il free phone extractor). È un flusso che non ho visto replicato da nessun altro strumento no-code su Yelp.
Funzioni chiave per lo scraping Yelp
- Impostazione automatica dei campi: con un clic, l’AI di Thunderbit compila l’elenco delle colonne — nome attività, valutazione, numero di recensioni, telefono, indirizzo, categoria, sito web — oppure puoi indicare tu quali campi vuoi davvero.
- Modalità Browser + Cloud: browser per pagine di ricerca più ostiche; cloud per scalare sulle pagine profilo pubbliche.
- Scraping delle sottopagine: passa automaticamente dai risultati di ricerca alle singole schede business.
- Pulizia dati con AI: etichetta, categorizza, riformatta i numeri di telefono in formato E.164 e può anche tradurre le recensioni — tutto durante l’estrazione.
- Gestione della paginazione: supporta sia la paginazione a clic sia lo scroll infinito.
- Scraping programmato: imposta estrazioni ricorrenti con pianificazione in linguaggio naturale per il monitoraggio.
- Export: Google Sheets, Airtable, Notion, Excel, CSV, JSON. Salvare su Sheets, Airtable o Notion non richiede crediti extra — anche se le righe estratte consumano già crediti.
Campi Yelp che Thunderbit può estrarre
| Tipo di pagina Yelp | Campi |
|---|---|
| Ricerca / elenchi business | Nome attività, URL, valutazione, telefono, orari di apertura, indirizzo, numero di recensioni, categorie, servizi, sito web, descrizione, fascia prezzo, stato, latitudine/longitudine, email |
| Pagine recensioni | Username del recensore, URL profilo recensore, URL business, contenuto recensione, valutazione numerica, data recensione, località del recensore, reazioni |
Un flusso tipico Yelp in Thunderbit
- Apri in Chrome una pagina di risultati Yelp per ristoranti.
- Clicca una volta e lascia che l’AI scelga le colonne.
- Regola i campi se serve (oppure accetta i suggerimenti dell’AI).
- Lascialo lavorare mentre fai altro.
- Se vuoi, usa lo scraping delle sottopagine per visitare ogni scheda business e aggiungere campi più ricchi.
- Esporta direttamente in Google Sheets, Airtable o nel formato che preferisci.
Configurare uno scraping base su Yelp mi è bastato un clic. Il flusso di arricchimento delle sottopagine aggiunge un passaggio, ma resta comunque no-code.
Prezzo: il piano gratuito include 6 pagine al mese, fino a 30 crediti per pagina. I piani a pagamento partono da 15 $/mese per 500 crediti. Paghi in base alle righe ottenute: 1 riga = 1 credito, 2 crediti per riga se lo scraping delle sottopagine è attivo, e 30 crediti per ogni lookup di arricchimento dei dati personali.
Ideale per: team sales che fanno lead generation locale, local marketer che vogliono dati Yelp senza programmare e team operations che monitorano le recensioni dei competitor con cadenza regolare.
| Pro | Contro |
|---|---|
| Migliore copertura no-code per Yelp (template business + recensioni) | Il modello a crediti può diventare costoso con molti record |
| Ottimi export e arricchimento delle sottopagine | L’arricchimento delle sottopagine costa 2 crediti per riga invece di 1 |
| La modalità browser è utile sui siti con forte anti-bot | La modalità cloud su Yelp ha più difficoltà della modalità browser sulle pagine di ricerca |
| Scraping programmato e formattazione AI integrati | La paginazione si ferma a 200 pagine per esecuzione nei piani a pagamento |
2. Apify — Il miglior scraper Yelp per esecuzioni cloud scalabili
 Apify è un marketplace ceco con "actor" creati dalla community — e l’ecosistema Yelp qui è sorprendentemente ampio. Troverai actor per lo scraping delle attività Yelp, per le recensioni Yelp e persino per i lead Yelp con arricchimento email. Il compromesso è la variabilità: alcuni actor sono eccellenti, altri sono datati, e le valutazioni pubbliche vanno da 0.0 a 5.0.
A seconda dell’actor, puoi estrarre nome attività, valutazione, recensioni, categorie, prezzo, indirizzo, telefono, sito web, orari, foto, informazioni sul proprietario, servizi, testo delle recensioni, dettagli dell’autore, conteggi delle reazioni e risposte del proprietario.
Gli export sono uno dei punti forti di Apify: i dataset possono essere esportati in JSON, CSV, XML, Excel, HTML Table, RSS e JSONL.
Prezzo: piano gratuito con 5 $ di credito d’uso; Starter a 29 $/mese; Scale a 199 $/mese. Alcuni actor applicano prezzi separati in base al risultato.
Ideale per: team che vogliono raccolta ricorrente via cloud con pianificazione e ottime opzioni di export.
| Pro | Contro |
|---|---|
| Il marketplace di actor migliore per Yelp | La qualità varia in base al manutentore dell’actor |
| Ottimo supporto per export e scheduling | La gestione anti-bot dipende dalla configurazione proxy |
| Esistono actor per l’arricchimento dei lead | L’interfaccia può risultare caotica per i principianti |
3. SerpApi — Il miglior scraper Yelp per sviluppatori che vogliono JSON strutturato
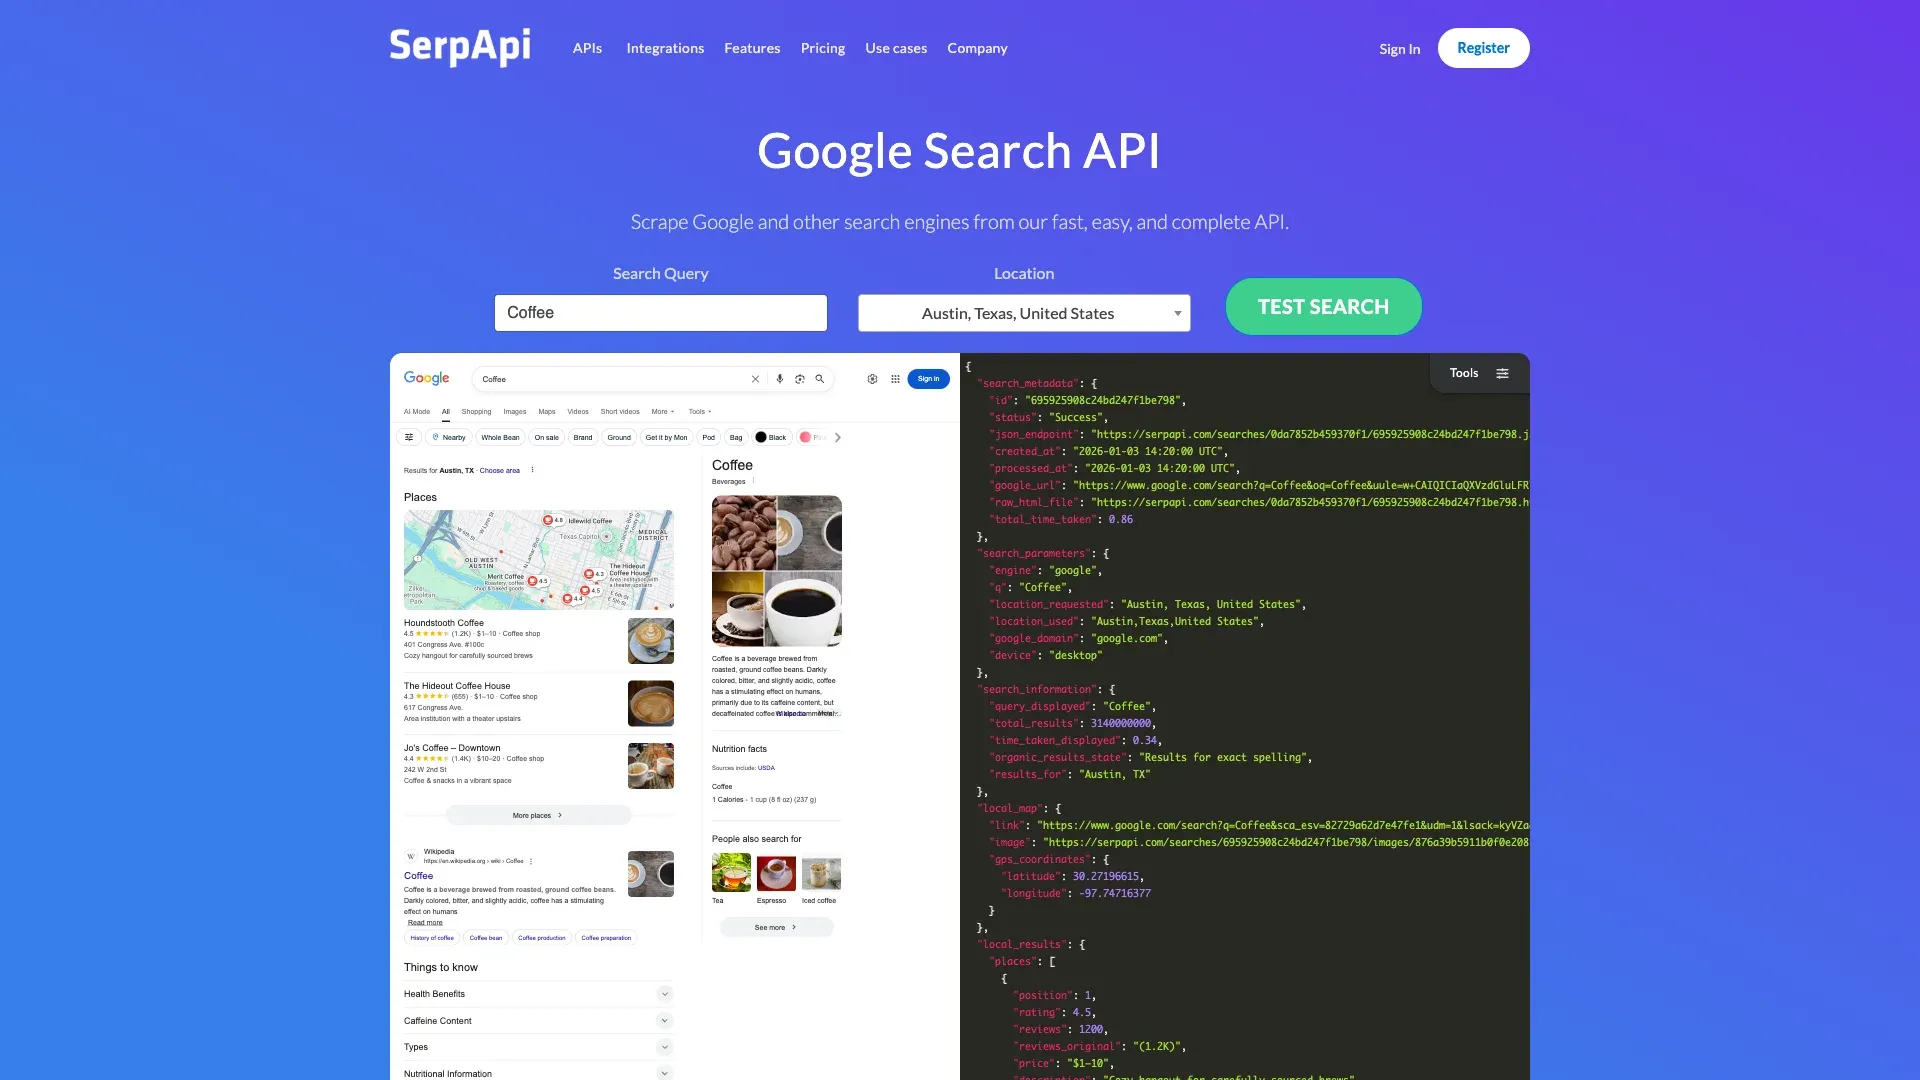 SerpApi è l’opzione API-first più pulita per Yelp. Offre endpoint dedicati sia per la ricerca Yelp (
engine=yelp) sia per le recensioni Yelp (engine=yelp_reviews), restituendo JSON ben strutturato invece di HTML grezzo.
Lato ricerca, ottieni campi come place_ids, title, categories, price, rating, reviews, neighborhoods, snippet e service_options. L’endpoint delle recensioni restituisce nome utente, ID utente, indirizzo utente, testo recensione, lingua, data, valutazione, conteggio feedback e risposte del proprietario. L’API Yelp Reviews si ferma a 49 risultati per pagina e la cache scade dopo 1 ora.
Prezzo: piano gratuito con 250 ricerche al mese; Starter a 25 $/mese per 1.000 ricerche; Developer a 75 $/mese per 5.000; Production a 150 $/mese per 15.000.
Ideale per: sviluppatori che vogliono JSON Yelp strutturato per pipeline di analisi, senza dover mantenere parser.
| Pro | Contro |
|---|---|
| Il miglior JSON Yelp strutturato di questa selezione | Richiede codice |
| Nessuna manutenzione del parser | Nessuna interfaccia no-code |
| Ottimo per pipeline di analytics | Il costo cresce con il volume delle ricerche |
4. Octoparse — Il miglior scraper Yelp con builder visivo dei workflow
 Octoparse è il builder point-and-click più forte in questa lista, ma il template Yelp attuale è focalizzato sulle pagine elenco — con campi come titolo, valutazione clienti, numero di post consigliati, categorie, fascia prezzo, indirizzo e orario di apertura. Per il testo delle recensioni, probabilmente dovresti costruire un workflow personalizzato.
Octoparse supporta estrazione cloud, pianificazione dei task, paginazione e scroll infinito, rotazione IP, proxy residenziali e risoluzione automatica dei CAPTCHA. Il builder visuale è potente, ma per configurazioni personalizzate ha una curva di apprendimento reale.
Prezzo: piano gratuito con 10 task, 1 dispositivo, 2 esecuzioni locali simultanee e fino a 50K righe/mese di export. Standard — il primo piano con esecuzioni cloud — costa 83 $/mese, oppure 69 $/mese con pagamento annuale; Professional costa 299 $/mese, oppure 249 $/mese nel piano annuale. Extra come proxy residenziali (3 $/GB) e risoluzione CAPTCHA (1–1,50 $ per mille) si aggiungono al costo base.
Ideale per: chi vuole un builder visuale e non ha problemi a investire tempo nella configurazione.
| Pro | Contro |
|---|---|
| Il miglior builder visuale della lista | Il template Yelp è più limitato di quello di alcuni concorrenti |
| Ottimi export e pianificazione | Le configurazioni avanzate richiedono una curva di apprendimento |
| Supporto a scraping cloud e proxy | I team piccoli possono essere penalizzati dagli extra |
5. ScraperAPI — Il miglior layer proxy per costruire il proprio scraper Yelp
 ScraperAPI non è uno scraper Yelp in senso stretto: è un layer proxy, rendering e anti-bot per sviluppatori che vogliono controllare l’estrazione da soli. La pagina soluzione Yelp e il tutorial mostrano come instradare le richieste tramite proxy rotanti con rendering JavaScript e gestione CAPTCHA, ma il parser lo scrivi tu.
Il sistema a crediti è chiaro: una richiesta base costa 1 credito, render=true costa 10 crediti e premium + render costa 25. Su Yelp il costo cresce in fretta, perché spesso il rendering JS è necessario.
Prezzo: piano gratuito con 1.000 crediti API e limite di 5 connessioni; prova di 7 giorni con 5.000 crediti; Hobby a 49 $/mese per 100.000 crediti.
Ideale per: sviluppatori che già scrivono scraper e vogliono un layer anti-bot affidabile per Yelp.
| Pro | Contro |
|---|---|
| Ottimo layer anti-bot per workflow personalizzati | Richiede codice |
| Funziona con qualunque script di scraping | Nessuna interfaccia visuale nativa per Yelp |
| Rendering JavaScript e geo-targeting | Logica di estrazione e manutenzione restano a tuo carico |
6. Lobstr.io — Il miglior scraper Yelp no-code preconfigurato per la ricerca
 Lobstr.io è più chiaramente un prodotto per esportare lead Yelp che uno scraper puro per recensioni. La sua pagina Yelp Search Export dichiara 30 attributi dati, 30 lead al minuto e 0,50 $ per 1.000 lead — ma quella tariffa si applica davvero sul piano da 500 $/mese; nel piano iniziale il costo è di circa 2 $ per 1.000.
I campi pubblicati includono URL, nome, recensioni (conteggio), punteggio, attività chiusa, attività rivendicata, prezzo, categorie, sito web, telefono, link menu, indirizzo, latitudine/longitudine, servizi, email, stato pubblicitario e presenza di sponsorizzazione. È un set dati molto forte per la lead generation. Però non ho trovato prove aggiornate che Lobstr estragga il testo completo delle recensioni — quindi è più uno strumento per lead che per monitoraggio delle recensioni.
Prezzo: il piano gratuito include 100 crediti, con export limitato a 30 righe per richiesta (1 credito = 1 risultato univoco). I piani a pagamento partono da 20 $/mese per 10.000 crediti; 100 $/mese danno 100.000 crediti e 500 $/mese arrivano a 1.000.000, ed è lì che nasce il prezzo dichiarato di 0,50 $ per 1.000.
Ideale per: chi ha un budget contenuto e vuole dati business Yelp per la lead generation, non per l’analisi delle recensioni.
| Pro | Contro |
|---|---|
| Molto economico | Non ideale per estrarre il testo delle recensioni |
| Workflow no-code semplice | Meno personalizzabile di una piattaforma generalista |
| Ottimi campi lead, incluso l’arricchimento email | La tariffa per lead pubblicizzata vale solo sul piano più alto |
7. Bright Data — Il miglior scraper Yelp per la raccolta dati su scala enterprise
 Bright Data è l’opzione più orientata all’enterprise in questa lista, con sia uno scraper Yelp sia un prodotto Yelp Reviews Dataset. Il dataset Yelp copre oltre 214,8 milioni di record in due dataset, con un prezzo fino a 0,0025 $ per record e un ordine minimo di 250 $. A quel prezzo costa più, per singolo record, che usare direttamente il loro scraper Yelp — stai comprando dati già raccolti invece di eseguire un’estrazione mirata.
Bright Data dichiara oltre 400 milioni di IP proxy mensili in 195 paesi, gestione automatica dei proxy, rendering completo del browser, risoluzione CAPTCHA, concorrenza illimitata e pianificazione. Lo scraper Yelp parte da 1,50 $/1.000 record nel modello pay-as-you-go, con un piano Scale a 499 $/mese per 384.000 record.
Prezzo: piano gratuito da 5.000 record al mese, senza carta di credito; pay-as-you-go a 1,50 $ per 1.000 record; Scale a 499 $/mese con 384.000 record inclusi.
Ideale per: team enterprise che devono raccogliere dati Yelp su larga scala o acquistare dataset già pronti.
| Pro | Contro |
|---|---|
| La miglior storia di delivery enterprise | Complesso e costoso per team piccoli |
| Prodotto dataset Yelp molto ampio | Eccessivo per progetti Yelp leggeri |
| Infrastruttura anti-bot molto forte | Configurazione più impegnativa per i principianti |
8. PhantomBuster — Il migliore per i team sales che lo usano già per LinkedIn
 PhantomBuster è lo strumento meno adatto a Yelp in questa selezione, e voglio essere sincero su questo. La documentazione ufficiale attuale mostra Phantoms dedicati per Google Maps e Pagine Gialle, ma non sono riuscito a trovare un Phantom Yelp-first chiaramente documentato come invece fanno intendere molti articoli comparativi.
Detto questo, PhantomBuster viene ancora usato molto dai team sales per automazioni cloud a più passaggi, esecuzioni ricorrenti, export CSV/JSON e workflow compatibili con CRM. Se il tuo team lo usa già per l’outbound su LinkedIn e vuoi aggiungere dati Yelp al mix, può funzionare — ma non è progettato specificamente per lo scraping delle recensioni Yelp.
Prezzo: piano gratuito con export limitato a 10 righe; Start a 69 $/mese, oppure 56 $/mese con fatturazione annuale; Grow a 159 $/mese, oppure 128 $/mese con fatturazione annuale; prova gratuita di 14 giorni.
Ideale per: team sales che già usano PhantomBuster per l’automazione outbound e vogliono integrare dati Yelp nel loro workflow.
| Pro | Contro |
|---|---|
| Buono per workflow di lead gen multi-piattaforma | La copertura specifica Yelp è più debole di quanto lasci intendere il marketing |
| Utile per concatenare workflow e passare i dati al CRM | Non è progettato per lo scraping delle recensioni |
| Automazioni cloud e scheduling | Il valore è più forte per l’automazione sales che per l’estrazione Yelp |
9. Instant Data Scraper — Il miglior Chrome extension gratuito per estrazioni rapide da Yelp
 Instant Data Scraper è l’opzione browser gratis al 100%, con oltre 1.000.000 di utenti e una valutazione 4,9/5 sul Chrome Web Store. Lo installi, apri una pagina Yelp, clicchi l’icona dell’estensione e l’AI heuristics rileva automaticamente i dati presenti nella pagina.
Il motivo per cui continua a funzionare su Yelp quando gli script Python falliscono è quello che ho descritto sopra: gira nel tuo browser. Ma è uno strumento piuttosto grezzo — niente scraping delle sottopagine, niente personalizzazione AI dei campi, niente scheduling, e gli export sono limitati a Excel o CSV. E quando una sessione viene segnalata, non c’è alcun piano B: niente esecuzioni cloud, niente pool di proxy.
Le recensioni della community segnalano anche che può bloccarsi nei flussi con pagina successiva, fermarsi all’improvviso e avere difficoltà con il caricamento dinamico di Yelp. È ottimo per un grab veloce su una singola pagina, ma non è uno strumento da produzione.
Prezzo: completamente gratuito. Nessun account richiesto.
Ideale per: chi ha bisogno di un’estrazione Yelp veloce e gratuita e non gli servono scala o personalizzazione.
| Pro | Contro |
|---|---|
| Gratis e immediato | Nessuna esecuzione cloud, scheduling o scraping delle sottopagine |
| Nessun account richiesto | Nessuna personalizzazione AI dei campi |
| Funziona su pagine semplici | Fragile con flussi Yelp dinamici o molto grandi |
| Solo CSV/Excel — niente Sheets o Airtable |
10. Webautomation.io — Il miglior scraper Yelp con template preconfezionati ed esecuzioni cloud
 Webautomation.io si colloca a metà tra uno strumento visuale e una piattaforma hosted per l’estrazione dati. Nel marketplace trovi un Yelp Business Data Extractor, e la piattaforma punta su retry, scheduling, protezione dal fingerprinting ed esecuzione cloud.
I campi di output pubblicati includono URL, titolo, località, indirizzo, link immagine, servizi, orari di apertura, telefono, valutazione, recensioni, sito web e categoria. La pagina dell’extractor prezza ogni riga estratta a 25 crediti, quindi un’estrazione Yelp da 1.000 righe costa 25.000 crediti: meglio verificarlo rispetto al tuo piano prima di iniziare.
Prezzo: piano gratuito con 500 crediti secondo la FAQ sui prezzi — la scheda del piano sulla stessa pagina parla di 10M, quindi non fare affidamento sul numero più alto. Il pay-as-you-go parte da 1 $ per 1.000 crediti, che a 25 crediti per riga equivale a 25 $ per 1.000 righe Yelp. L’abbonamento più economico è 99 $/mese per 400.000 crediti, cioè circa 16.000 righe Yelp.
Ideale per: chi vuole un estrattore Yelp cloud con scheduling e logica di retry.
| Pro | Contro |
|---|---|
| Basato su cloud con scheduling e retry | Presenza di mercato più limitata |
| Esiste un estrattore Yelp già pronto | L’output è più orientato ai metadati business che al testo delle recensioni |
| Protezione dal fingerprinting integrata | Prezzi meno intuitivi di un abbonamento flat |
Confronto rapido dei 10 migliori scraper per recensioni Yelp
Ecco la tabella che avrei voluto avere all’inizio della mia ricerca:
| Strumento | Facilità d’uso | Gestione anti-bot | Campi dati | Formati di export | Prezzo / piano gratuito | Paginazione e scala | Arricchimento sottopagine |
|---|---|---|---|---|---|---|---|
| Thunderbit | No-code (estensione Chrome) | Sessione browser + esecuzioni cloud | Campi business + recensioni | Excel, Sheets, Airtable, Notion, CSV, JSON | 6 pagine gratis/mese; da 15 $/mese | Sì (click + scroll) | Sì |
| Apify | Da low-code a medio | Dipende dall’actor, con proxy | Forti dati business + recensioni + lead | JSON, CSV, XML, Excel, JSONL e altro | 5 $ di credito gratuito; da 29 $/mese | Sì | Alcuni actor sì |
| SerpApi | Richiede codice | Molto forte lato backend | JSON strutturato pulito | JSON | 250 ricerche gratis/mese; da 25 $/mese | Sì (via API) | Via flussi API |
| Octoparse | No-code a medio | Forte sul cloud a pagamento | Buoni campi business/elenco | CSV, JSON, HTML, XML, Excel, DB, Sheets | 10 task gratis, 50K righe/mese; da 83 $/mese | Sì | Sì |
| ScraperAPI | Richiede codice | Forte layer proxy/render | Dipende dal tuo parser | HTML, JSON | 1K crediti gratis; da 49 $/mese | Sì | Personalizzato |
| Lobstr.io | No-code | Dichiara bypass anti-bot | Forti campi lead, debole sul testo recensioni | CSV, JSON, API | 100 crediti gratis; da 20 $/mese | Adatto alla ricerca su larga scala | Limitato |
| Bright Data | Medio-difficile | Molto forte | Business + recensioni completi | JSON, CSV, Parquet, API | 5K record gratis/mese; 1,50 $/1K | Eccellente | Basato su API/dataset |
| PhantomBuster | No-code | Automazione cloud (non Yelp-first) | Dipende dal workflow | CSV, JSON | Piano free (export da 10 righe); da 69 $/mese | Buono per automazioni | Non nativo per Yelp |
| Instant Data Scraper | No-code (estensione Chrome) | Solo sessione browser | Ciò che è visibile nella pagina | Excel, CSV | Gratis | Limitato su larga scala | No |
| Webautomation.io | Da no-code a low-code | Protezione forte dichiarata | Buoni metadati business | CSV, Excel, JSON, JSONL, XML | 500 crediti gratis; da 99 $/mese | Sì | Sì |
In sintesi: Thunderbit vince come soluzione no-code complessiva, SerpApi per le API da sviluppatore, Octoparse per i workflow visuali, Bright Data per l’enterprise, Instant Data Scraper per le estrazioni rapide gratuite e Lobstr.io per l’export di lead a basso costo.
Oltre le recensioni: usare gli scraper Yelp per la lead generation
Molti articoli sugli scraper Yelp trattano Yelp solo come sito di recensioni. Per esperienza, però, questo è un punto di vista troppo riduttivo. Yelp è anche un database di lead — e in certi casi è persino più ricco di Google Maps per il prospecting locale.
Il workflow più efficace per la lead generation non è semplicemente "scaricare una lista". È questo:
- Estrarre i risultati di ricerca Yelp per una categoria e una località.
- Visitare ogni scheda business con lo scraping delle sottopagine.
- Aggiungere sito web, telefono, orari, categorie e contenuti relativi al proprietario.
- Se serve, arricchire l’URL del sito per ricavare indirizzi email.
Lo scraping delle sottopagine di Thunderbit + il free extractor di email/telefono è stato progettato esattamente per questo flusso. Ma anche strumenti come l’Yelp Leads & Business Scraper di Apify e l’Yelp Search Export di Lobstr supportano estrazioni orientate alla lead generation.
Quali dati puoi davvero estrarre da Yelp per i lead?
| Campo | Presente nei risultati di ricerca? | Presente nella scheda business? | Note |
|---|---|---|---|
| Nome attività | Sì | Sì | Campo base in tutti gli strumenti |
| Valutazione | Sì | Sì | Utile per il lead scoring |
| Numero di recensioni | Sì | Sì | Utile per il reputation scoring |
| Telefono | Spesso | Sì | Ottimo campo per vendita/outreach |
| Indirizzo | Spesso | Sì | Più chiaro nella scheda business |
| Sito web | A volte | Sì | Spesso richiede lo scraping della scheda dettaglio |
| Orari | Limitato | Sì | Di solito richiede la pagina business |
| Quartiere | A volte | A volte | SerpApi espone esplicitamente neighborhoods |
| Info proprietario / from-the-business | Raramente | A volte | Richiede contenuti della pagina rivendicata |
| Testo recensioni | Anteprima limitata | Sì | Richiede scraping della recensione o della scheda business |
Yelp vs Google Maps per la lead generation locale
Google Maps è la fonte più ampia per la parte alta del funnel — oltre 2 miliardi di utenti al mese, e l’81% dei consumatori usa Google per trovare recensioni. Ma Yelp ha vantaggi unici per la lead generation:
| Punto dati | Yelp | Google Maps |
|---|---|---|
| Nome del proprietario | Spesso presente nelle pagine rivendicate | Raramente disponibile |
| Email diretta | A volte nel profilo | A volte nel profilo |
| Numero di telefono | Sì | Sì |
| Testo delle recensioni | Sì | Sì |
| Menu / servizi | Sì | Limitato |
| Categorie e servizi | Ricco | Più limitato |
Yelp va quindi considerato una fonte secondaria ad alta intenzione — particolarmente utile quando ti servono nomi dei proprietari, categorie dettagliate o dati sui servizi che Google Maps non mostra sempre con coerenza.
Gestire la paginazione ed evitare duplicati su larga scala
Questo è il problema di cui quasi nessuno parla, ma che tre utenti diversi hanno segnalato in forum separati. Il tutorial Yelp di ScraperAPI conferma che la paginazione delle recensioni Yelp usa il parametro start (ad esempio &start=10, &start=20). La stessa spiegazione di Yelp sul ranking dei risultati osserva che i risultati sponsorizzati possono comparire prima dei risultati numerati e che il ranking dipende da più segnali — non da una semplice lista stabile.
Il risultato? Tre problemi pratici:
- Le schede sponsorizzate si ripetono o falsano il conteggio righe tra le pagine.
- Le ricerche sovrapposte possono recuperare la stessa attività più di una volta.
- I job di monitoraggio ricorrente reimportano gli stessi business, a meno di usare un ID o un URL stabile come chiave.
Checklist DO / DON’T per la paginazione Yelp
- FAI usare l’URL del business o il suo ID come chiave per deduplicare.
- FAI estrarre prima e poi unire/deduplicare in Google Sheets, Airtable o nel tuo database.
- FAI aspettarti che annunci Yelp e righe sponsorizzate falsino il conteggio semplice delle pagine.
- NON FARE affidamento solo sul numero di righe visibili come conteggio dei business unici.
- NON FARE l’errore di pensare che l’ordine dei risultati sia stabile tra un’esecuzione e l’altra.
Tra gli strumenti testati, Thunderbit gestisce sia la paginazione a clic sia lo scroll infinito, e l’export verso Google Sheets/Airtable rende la deduplica semplice. Anche Octoparse supporta paginazione e flussi parent-child, ma la logica di deduplica resta a carico dell’utente. Instant Data Scraper può gestire la paginazione in casi semplici, ma su Yelp è il meno affidabile.
Per i flussi di monitoraggio, lo scraper programmato di Thunderbit ti consente di impostare estrazioni ricorrenti con pianificazione in linguaggio naturale — utile per seguire nuovi business o variazioni delle recensioni nel tempo senza dover rilanciare tutto manualmente.
Come appare davvero un export di dati Yelp (esempi reali)
Uno dei problemi principali delle comparazioni sugli scraper è che non mostrano mai come si presenta davvero l’export. E secondo me è un limite importante: dovresti sapere cosa stai ottenendo prima di impegnarti in uno strumento.
Un export realistico di un ristorante Yelp da Thunderbit potrebbe includere colonne come:
Business Name | Rating | Review Count | Phone | Address | Category | Website URL | Hours | Reviewer Username | Review Content | Review Date | Reviewer Location
Ecco come si confronta la completezza dei campi tra alcuni strumenti per la stessa query Yelp:
| Campo | Thunderbit | Apify | Instant Data Scraper | Python fai-da-te |
|---|---|---|---|---|
| Nome attività | ✅ | ✅ | ✅ | ✅ |
| Nome proprietario | ✅ (tramite sottopagina) | ⚠️ Dipende dall’actor | ❌ | ✅ (codice manuale) |
| Telefono (formato E.164) | ✅ Formattato automaticamente | ✅ Grezzo | ✅ Grezzo | ✅ Grezzo |
| Categorizzazione AI | ✅ Integrata | ❌ | ❌ | ❌ (richiede post-processing) |
| Export su Sheets/Airtable | ✅ Gratis | ✅ Nei piani a pagamento | ❌ Solo CSV | ❌ Manuale |
La differenza tra output grezzo e output pulito dall’AI conta più di quanto sembri. Il Field AI Prompt di Thunderbit può categorizzare le attività, riformattare i numeri di telefono in E.164 e persino tradurre le recensioni — tutto durante l’estrazione. API come SerpApi e ScraperAPI restituiscono dati strutturati più puliti per le pipeline, ma poi la normalizzazione downstream la devi gestire tu.
Una nota rapida sullo scraping Yelp e sulle implicazioni legali
La faccio breve, perché non è il focus dell’articolo, ma le basi è bene conoscerle.
I Termini di servizio di Yelp vietano robot, spider, scraper e la creazione di un database ricercabile dei contenuti Yelp, salvo autorizzazione espressa. Il loro centro assistenza afferma inoltre che lo scraping non è consentito tramite bot, plug-in o estensioni browser.
Detto questo, “non consentito dai ToS” e “illegale” non sono la stessa cosa. Il contesto legale attuale include ancora la linea di casi hiQ v. LinkedIn, e i commenti su Meta v. Bright Data nel 2024 continuano a trattare lo scraping di dati pubblici come una questione molto dipendente dai fatti, non come qualcosa di automaticamente illecito.
I miei consigli: rispetta i rate limit, non estrarre dati privati o protetti da login, rispetta le leggi locali sulla privacy dei dati (GDPR, CCPA) e usa i dati in modo responsabile.
Yelp offre anche un’API Fusion ufficiale — ma è limitata. La ricerca restituisce fino a 240 attività, l’endpoint delle recensioni restituisce solo fino a 3 estratti di recensione e il rate limiting è severo. Per la maggior parte dei casi d’uso, l’API ufficiale non basta — ed è proprio per questo che esistono gli strumenti di scraping.
Quale scraper per recensioni Yelp dovresti scegliere?
Dopo aver testato tutti e 10, ecco il mio giudizio onesto per caso d’uso:
- Utenti non tecnici che vogliono la configurazione più semplice → Thunderbit. Un clic per estrarre, template Yelp solidi, export gratuiti.
- Sviluppatori che vogliono dati API strutturati → SerpApi. JSON pulito, nessuna manutenzione del parser, endpoint Yelp dedicati.
- Team che hanno bisogno di scala massiva → Bright Data. Rete proxy enterprise, dataset Yelp preconfezionati, concorrenza illimitata.
- Utenti attenti al budget che vogliono un’opzione gratuita → Instant Data Scraper per estrazioni rapide. Il piano free di Lobstr offre solo 100 risultati, quindi se ti servono lead Yelp con quello stai di fatto guardando al piano da 20 $/mese.
- Team sales che fanno lead gen su più piattaforme → PhantomBuster se lo usi già per LinkedIn, oppure Lobstr se il workflow è specificamente orientato ai lead Yelp.
- Chi vuole un builder visuale dei workflow → Octoparse.
Se la domanda è "cosa funziona davvero su Yelp oggi", la risposta onesta è che i prodotti guidati dal browser o specifici per Yelp rendono meglio degli scraper generici. Gli strumenti con il fit più chiaro oggi sono Thunderbit per gli utenti non tecnici, SerpApi per gli sviluppatori, Bright Data per l’enterprise, Apify per la flessibilità cloud e Octoparse per chi ama i workflow visuali.
Vuoi vedere come funziona lo scraping Yelp con un solo clic? Il piano gratuito di Thunderbit ti dà sei pagine al mese per provarlo — oppure guarda il canale YouTube di Thunderbit per i video tutorial. E se vuoi approfondire lo web scraping, ecco altre letture dal nostro blog:
- Come fare scraping di Yelp con Python
- I migliori strumenti di web scraping automatizzato
- Estrarre dati da un sito web in Excel
- I migliori AI Web Scraper
- Best practice di web scraping per la lead generation
Buono scraping — e che i tuoi export siano sempre puliti, i duplicati pochi e i CAPTCHA inesistenti.
Prova Thunderbit per lo scraping Yelp
Prova Thunderbit AI Web Scraper Get Started Free
FAQ
Si possono estrarre recensioni Yelp gratis?
Sì, ma solo su piccola scala. I free tier più utili nel 2026: Instant Data Scraper è completamente gratuito e non richiede account; il piano free di Thunderbit include 6 pagine al mese; Apify offre 5 $ di credito d’uso; SerpApi consente 250 ricerche al mese; ScraperAPI fornisce 1.000 crediti API; il free tier di Bright Data è di 5.000 record al mese; il piano gratuito di Lobstr offre 100 risultati, con export limitato a 30 righe. Ognuno ha limiti reali su volume, automazione o profondità dei campi — ma sono sufficienti per testare un workflow ed estrarre qualche pagina.
Quali dati puoi estrarre da Yelp oltre alle recensioni?
Molti più di quanto pensi. Gli strumenti attuali possono estrarre nome attività, valutazione, numero di recensioni, telefono, sito web, indirizzo, categoria, orari, quartiere, foto, servizi e, in alcuni casi, contenuti del profilo del proprietario o campi email arricchiti. I set di campi più completi arrivano dagli strumenti che supportano lo scraping delle sottopagine — cioè estrarre una pagina risultati e poi visitare ogni singola scheda business per aggiungere dati più profondi.
Yelp blocca gli scraper?
Sì, in modo aggressivo. Yelp vieta esplicitamente lo scraping nei Termini di servizio e nel centro assistenza, e le evidenze tecniche recenti mostrano CAPTCHA, errori 503, fingerprinting TLS/JA3, classi CSS offuscate e un blocco più forte sulle pagine directory/ricerca rispetto alle singole schede business. Nel 2026, gli strumenti basati su browser e le API con proxy hanno il tasso di successo migliore.
Qual è la differenza tra browser scraping e cloud scraping su Yelp?
Il browser scraping usa la sessione Chrome in cui ti trovi già, quindi il traffico sembra quello di una normale navigazione. Il cloud scraping gira su server remoti, quindi è più veloce e non occupa il tuo computer (Thunderbit in modalità cloud lavora su 50 pagine alla volta), ma dipende dalla qualità dei proxy per superare Yelp. Regola pratica: browser mode per pagine di ricerca e directory, cloud mode per i profili business singoli.
L’API ufficiale di Yelp basta per la maggior parte dei casi d’uso?
Non per la maggior parte di quelli trattati in questo articolo. Tre estratti di recensioni per attività non ti dicono nulla sul sentiment nel tempo, e il limite di 240 attività si esaurisce in fretta in qualunque categoria densa — non ci costruisci sopra una mappa di mercato o una cronologia delle recensioni. Va bene per inserire una valutazione nella tua app, che è più o meno lo scopo per cui è stata creata.
Scopri di più



