
האינטרנט צמא לנתונים יותר מאי פעם, וב-2026, Node.js מוביל את המהלך עבור צוותים שרוצים לעשות web scraping בצורה חכמה יותר, לא קשה יותר. בין אם אתם אנשי מכירות, אנשי ecommerce, או פשוט חובבי נתונים כמוני, כנראה כבר שמתם לב ש-scraping הוא כבר מזמן לא רק “להשיג את החומר” — אלא לעשות את זה מהר, בקנה מידה גדול, ובלי שה-IP שלכם ייכנס לכלא דיגיטלי. וגם הביקוש לא נרגע: נתוני ווב ציבוריים הפכו בשקט לשכבת הקלט שעליה בונים רוב הצוותים המודרניים, מאינטליגנציה תמחור ועד צינורות אימון ל-LLM, וההימור — והתחרות — מעולם לא היו גבוהים יותר.
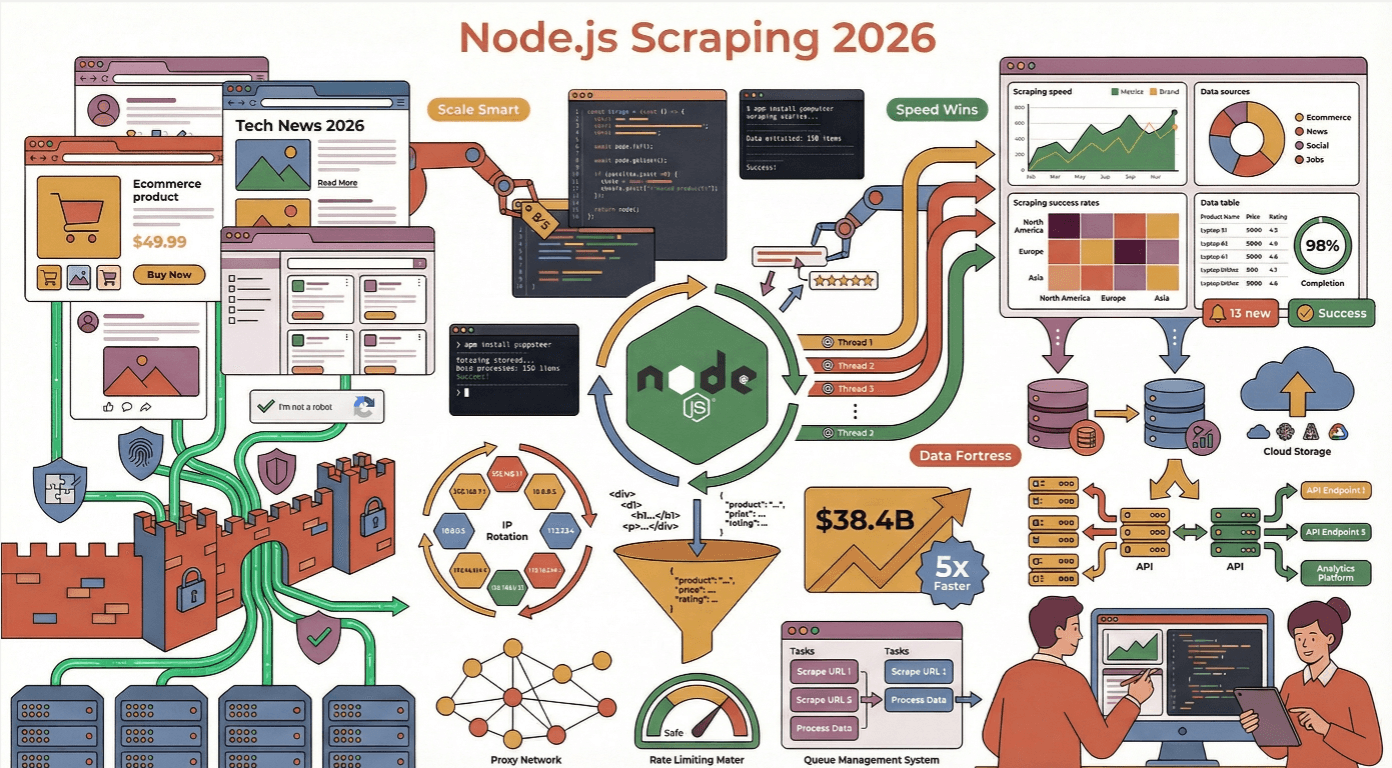
אבל הנה הבעיה: הווב המודרני הוא מבצר של תוכן דינמי, מלכודות anti-bot ופריסות שמשתנות כל הזמן. ראיתי יותר scrapers קורסים ונשרפים ממה שנעים להודות — בדרך כלל כי הם התעלמו משיטות עבודה מומלצות או זלזלו בכמה חכמות הפכו ההגנות נגד scraping. אז בואו נצלול לשיטות העבודה המומלצות והמעשיות ליעילות web scraping עם Node.js, עם כמה סיפורים, קצת הומור והרבה עצות שאפשר ליישם מיד.
למה לבחור ב-Node.js ליעילות ב-Web Scraping?
אם אי פעם ניסיתם לגרד מאות (או אלפי) עמודים בבת אחת, אתם יודעים שמהירות ו-concurrency הם הכול. כאן בדיוק Node.js מצטיין. מודל ה-I/O הא-סינכרוני והלא-חוסם שלו בנוי לטיפול במספר עצום של בקשות רשת מקבילות — אפשר לחשוב עליו כמולטיטסקר האולטימטיבי של הווב (Node.js Docs). בעוד ששפות אחרות נתקעות ומחכות לסיום של כל בקשה, Node.js פשוט ממשיך להפעיל את לולאת האירועים שלו, ומלהטט בין הבקשות כמו אמן קרקס על קפאין.
ראיתי את Node.js עוקף את Python ואת Java בתרחישים שבהם נדרשים עדכונים בזמן אמת וחילוץ בהיקפים גדולים, במיוחד כשאתרי היעד עמוסים ב-JavaScript. למעשה, כ-40% מהמפתחים משתמשים כיום ב-Node.js למשימות backend ואוטומציה, מה שהופך אותו לטכנולוגיית הווב הפופולרית ביותר בעולם.
Node.js מול מסגרות Web Scraping אחרות
בואו ניכנס לרגע לצד הטכני. כך Node.js משתווה למתחרים:
| מסגרת | חוזקות | חולשות | תרחישי שימוש מומלצים |
|---|---|---|---|
| Node.js | א-סינכרוני, מצוין ל-concurrency, אקו-סיסטם עצום של npm, JS מובנה לאתרים דינמיים | עלול לצרוך הרבה זיכרון, callback hell (אם לא משתמשים ב-async/await) | scraping בזמן אמת, אתרים כבדי JS, microservices ניתנים להרחבה |
| Python | המון ספריות scraping (BeautifulSoup, Scrapy), תחביר פשוט | איטי יותר בהיקפי concurrency גדולים, מתקשה עם אתרים מרונדרי JS | HTML סטטי, מחקר, אבטיפוס |
| Java | טיפוסיות חזקה, יציב לארגונים | מילולי, פחות גמיש לסקריפטים מהירים | scraping בקנה מידה גדול, ברמת enterprise |
| Go | מהיר, concurrency יעיל | אקו-סיסטם קטן יותר, עקומת למידה תלולה יותר | scraping עתיר ביצועים ובעל השהיה נמוכה |
עבור רוב המשתמשים העסקיים, Node.js פוגע בדיוק בנקודה הנכונה: מהיר, גמיש, ומתאים בצורה מושלמת לווב המודרני שמונע על ידי JavaScript (Thunderbit Blog).
איך להקים סביבת Node.js חזקה ל-Web Scraping
Scraper טוב מתחיל מתשתית טובה. הנה ההגדרה שאני חוזר אליה שוב ושוב:
- מבנה פרויקט: שמרו על מודולריות. השתמשו בתיקיות כמו
/src,/libsו-/config. שמרו מידע רגיש (מפתחות API, פרוקסים) במשתני סביבה עםdotenv(Thunderbit Guide). - לקוח HTTP: השתמשו ב-axios, got, או ב-node-fetch לביצוע בקשות.
- ניתוח HTML: Cheerio ל-HTML סטטי, ו-Puppeteer או Playwright לתוכן דינמי.
- כלי עזר: השתמשו ב-Lodash לעיבוד נתונים, וב-validator.js או Joi לאימות נתונים.
- בדיקות ו-linting: Mocha לבדיקות, ESLint לאיכות קוד (LogRocket).
ספריות חיוניות ל-Web Scraping עם Node.js
- לקוחות HTTP (axios / got /
fetchהמובנה): לביצוע בקשות. שווה לציין מראש: מאז Node.js v18 אפשר להשתמש ב-fetchבאופן מובנה בלי להתקין שום דבר, וב-Node.js v22 הוא כבר נחשב יציב. בפרויקט חדש על גרסת Node עדכנית כנראה לא תצטרכו את החבילהnode-fetchבכלל — פשוט קראו ל-fetchישירות. אני עדיין נוטה לבחור ב-axios כשאני רוצה interceptors, טיפול אוטומטי ב-JSON, וממשק promises מוכר גם ב-Node וגם בדפדפן, ו-got הוא הבחירה שלי כשאני צריך retries, streams או HTTP/2 כברירת מחדל. בחרו את מה שמתאים ל-stack שלכם; לסקריפט קצר,fetchהמובנה מספיק בהחלט. - Cheerio: מנתח HTML מהיר בסגנון jQuery. מושלם לעמודים סטטיים — מנתח בכ-0.5 שניות (Oxylabs).
- Playwright / Puppeteer: אוטומציית דפדפן headless לאתרים דינמיים וכבדי JS. איטי יותר (~4 שניות לעמוד), אבל חיוני לאתרים שטוענים תוכן אחרי טעינת הדף (Bright Data). אם אתם מתחילים מאפס ב-2026, Playwright הוא ברירת המחדל — תמיכה חוצת-דפדפנים כבר מהקופסה (Chromium / Firefox / WebKit), trace viewer מובנה, והצוות שפיתח במקור את Puppeteer הוא זה שמוביל אותו כיום ב-Microsoft. Puppeteer עדיין מתוחזק לעבודה ממוקדת Chrome, אבל רשימות הגרסאות שלו נטו כבר תקופה לעדכוני תאימות ל-Chrome יותר מאשר ליכולות חדשות.
- dotenv: לניהול משתני סביבה.
- csv-writer/jsonfile: לייצוא נתונים.
איך להימנע ממלכודות נפוצות ב-Web Scraping עם Node.js
קשה לספור כמה פעמים ראיתי scrapers נחסמים, קורסים או סתם מפזרים נתונים מבולגנים. הנה מה שכדאי לשים לב אליו:
- התעלמות מ-robots.txt ומ-Terms of Service: תמיד בדקו לפני scraping. הפרה שלהם עלולה לגרום ל-IP שלכם להיחסם — או גרוע מזה, להכניס אתכם לצרות משפטיות (ScraperAPI).
- העמסת יתר על השרתים: אל תשגרו בקשות ללא הגבלה. הגבילו את ה-scraper עם השהיות אקראיות (1–3 שניות), השתמשו בבקרת concurrency, ואל תתנהגו כמו רובוט היפראקטיבי (ScrapeGraphAI).
- אי-טיפול בשגיאות: עטפו תמיד בקשות ב-try/catch, טפלו בשגיאות HTTP, ותעדו כשלונות. נסו שוב שגיאות זמניות עם exponential backoff (ScrapeGraphAI).
- שכחת כותרות בקשה: השתמשו במחרוזות User-Agent מציאותיות וגלגלו אותן. הוסיפו Accept-Language, Referer וכותרות נוספות כדי לחקות דפדפנים אמיתיים (ScrapeGraphAI).
איך לעקוף מנגנוני Anti-Scraping
אתרים מודרניים חמושים עד השיניים בטכנולוגיות נגד bot. כך אני עוקף את המוקשים הדיגיטליים:
- פרוקסים/IP מתחלפים: השתמשו ב-pool של פרוקסים וגלגלו IP-ים כדי להימנע מחסימות (Medium).
- אקראיות בכותרות: החליפו User-Agent, Accept-Language וכותרות אחרות בכל בקשה.
- Stealth בדפדפן headless: השתמשו בתוספים כמו
puppeteer-extra-plugin-stealthכדי להסתיר טביעות אצבע של אוטומציה. - סימולציה של התנהגות אנושית: הוסיפו השהיות אקראיות, תנועות עכבר, גלילה ואפילו טעויות הקלדה (ZenRows).
סימולציה של התנהגות אנושית ב-scrapers של Node.js
כאן הדברים נהיים כיפיים, וקצת מוזרים. במקום ללחוץ ולגלול מיד, תכנתו את ה-scraper כך ש:
- ימתין פרקי זמן אקראיים בין פעולות (
await page.waitForTimeout(randomDelay)) - יזיז את העכבר במקטעים קטנים ורועדים (
page.mouse.move(x, y)) - יקליד עם השהיות אקראיות ולעיתים גם טעויות כתיב (
page.type(selector, text, {delay: random(100,200)})) - יגלול בצורה לא אחידה, ולא רק עד לתחתית
הטריקים האלה יכולים לשפר משמעותית את שיעור ההצלחה שלכם באתרים מוגנים (ScraperAPI).
פישוט חילוץ נתונים מורכב עם Thunderbit
חילוץ נתונים מכל אתר באמצעות AI תחסכו את כל קוד התשתית: ה-web scraper הסוכני של Thunderbit קורא כל עמוד ומחלץ נתונים בלחיצה אחת, בלי קוד Node.js שצריך לתחזק. Get Started Free
עכשיו בואו נדבר על הפיל שבחדר: scraping זה קשה. אבל זה לא חייב להיות כך. לכן בנינו את Thunderbit.
Thunderbit הוא תוסף Chrome של web scraper סוכני שמאפשר לכם לחלץ נתונים מכל אתר באמצעות אנגלית פשוטה. פשוט לוחצים על “One Click Extract”, נותנים ל-AI להבין מה יש בעמוד, ואז לוחצים “Scrape”. זה כמו לקבל מפתח ג’וניור שלא ישן אף פעם ולא מבקש העלאה.
ויותר טוב מזה — ל-Thunderbit יש גם API, כך שאפשר לחבר אותו ישירות לזרימות העבודה שלכם ב-Node.js. במקום לכתוב אלפי שורות של קוד scraping, אפשר לתת ל-Thunderbit לטפל בעבודה הכבדה — תוכן דינמי, תתי-עמודים, pagination והכול. אתם פשוט שולפים את הנתונים המובנים (CSV, JSON, או ישירות ל-Google Sheets, Airtable, Notion) וממשיכים הלאה עם היום שלכם (Thunderbit Blog).
נסו את תוסף Chrome של Thunderbit בחינם התקינו את תוסף Chrome החינמי וחלצו נתונים מובנים בלחיצה אחת — או קראו ל-API של Thunderbit מתוך אפליקציית Node.js שלכם. Get Started Free
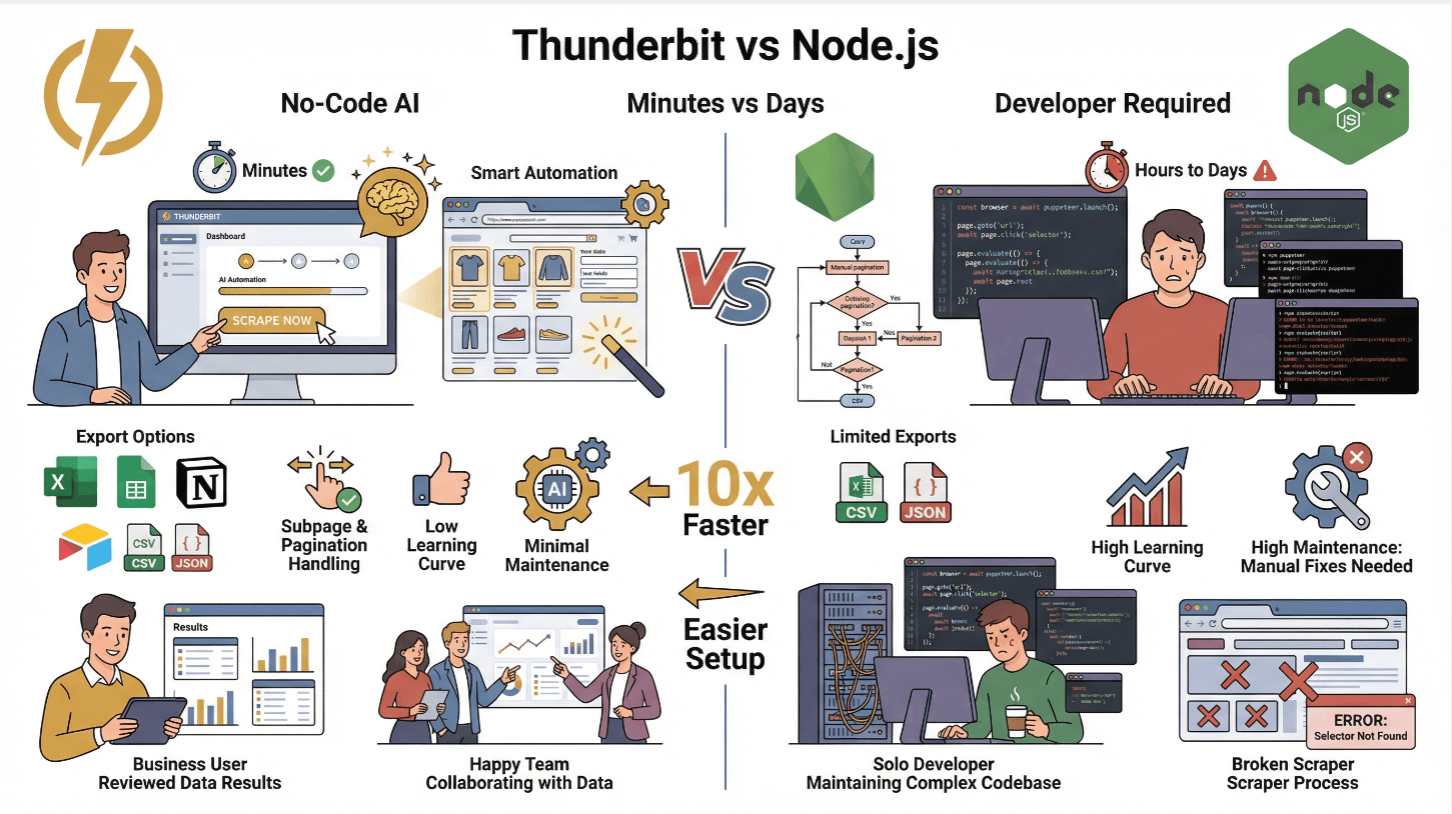
Thunderbit מול scraping מסורתי ב-Node.js
| תכונה | Thunderbit | Scraper מסורתי ב-Node.js |
|---|---|---|
| זמן הקמה | דקות (בלי קוד) | שעות עד ימים (פיתוח, בדיקות) |
| טיפול בתוכן דינמי | כן (AI + דפדפן) | כן (עם Puppeteer/Playwright) |
| תתי-עמודים ו-Pagination | בלחיצה אחת | דורש קוד ידני |
| ייצוא נתונים | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (קוד מותאם אישית) |
| עקומת למידה | נמוכה (משתמשים עסקיים) | גבוהה (מפתחים) |
| תחזוקה | מינימלית (ה-AI מסתגל) | גבוהה (תיקונים ידניים לשינויים באתר) |
Thunderbit מושלם לצוותים לא טכניים או לכל מי שרוצה לדלג על העבודה השחורה ולהתמקד בתובנות. למשתמשים מתקדמים, אפשר עדיין להשתמש ב-API של Thunderbit כדי לבצע scraping בקנה מידה גדול (Thunderbit Docs).
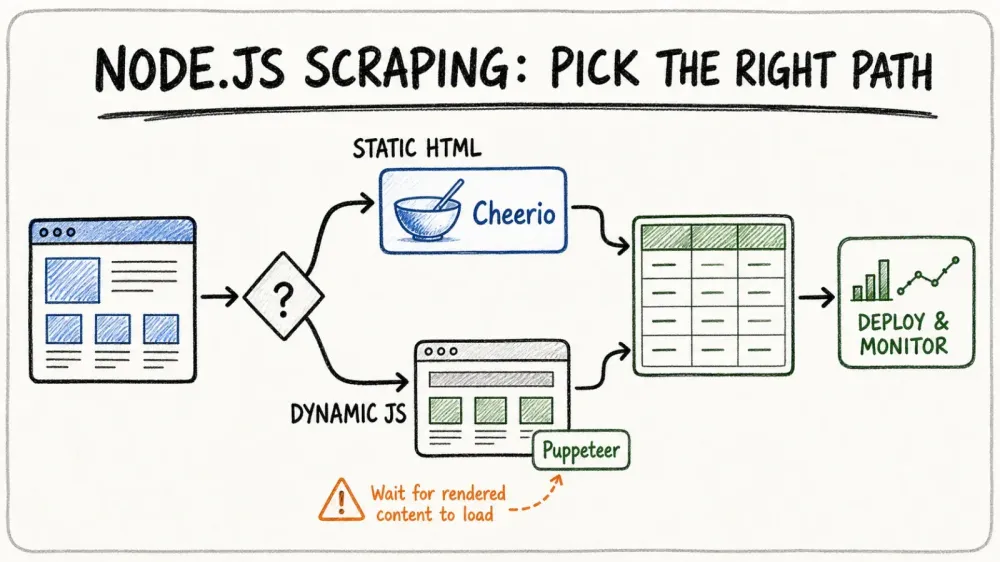
שילוב Cheerio ו-Puppeteer עבור תוכן דינמי
זהו צמד העוצמה האהוב עליי ב-Node.js scraping. כך זה עובד:
- משתמשים ב-Puppeteer כדי לטעון את הדף ולהריץ JavaScript (מחכים ל-
networkidleכדי לוודא שכל התוכן נטען). - שולפים את ה-HTML עם
await page.content(). - מנתחים עם Cheerio: מעבירים את ה-HTML ל-Cheerio לצורך ניתוח וחילוץ נתונים מהיר במיוחד בסגנון jQuery.
הגישה ההיברידית הזו נותנת לכם את הטוב משני העולמות: העוצמה של Puppeteer לתוכן דינמי, והמהירות של Cheerio לניתוח (Browserless).
טיפ לביצועים: בחרו רק את האלמנטים שאתם באמת צריכים. Cheerio טוען את כל ה-DOM לזיכרון, אז הימנעו מ-selectors רחבים ושמרו תוצאות במטמון אם אתם מגרדים את אותם עמודים שוב ושוב (Oxylabs).
אופטימיזציה של ניתוח HTML וחילוץ נתונים
- השתמשו ב-selectors מדויקים: אל תבחרו
$('body *')— התמקדו רק במה שצריך. - Stream לעמודים גדולים: עבור HTML עצום, שקלו סטרימינג או חלוקת העבודה לחלקים.
- שמרו HTML מרונדר במטמון: אם אתם חוזרים ל-URLs, שמרו את ה-HTML כדי להימנע מבקשות מיותרות.
- אמתו וּנקו את הנתונים: השתמשו בספריות אימות כדי שלא תמלאו את מסד הנתונים שלכם בזבל (ScrapeGraphAI).
פריסה בענן של Node.js Scraper בקנה מידה גדול
צריכים scraping בהיקף גדול? הגיע הזמן להיות cloud-native.
- הפכו את ה-scraper ל-Docker: כתבו
Dockerfile, העתיקו את הקוד, התקינו dependencies והגדירו entrypoint. - פרסו לענן: השתמשו ב-AWS EC2, Google Cloud Compute או Azure VMs למשימות פשוטות. בקנה מידה רציני, עברו ל-Kubernetes או לשירותים מנוהלים כמו AWS ECS/EKS, Google Cloud Run או Azure Kubernetes Service (DigitalOcean).
- תזמורת עם Kubernetes: הפעילו כמה pods, בצעו autoscaling לפי ביקוש, והשתמשו ב-load balancers כדי לפזר URLs.
- תזמנו משימות: השתמשו ב-cloud schedulers (CloudWatch Events, Cloud Scheduler) או ב-cron jobs כדי להפעיל scraping בפרקי זמן קבועים.
בדוגמה אמיתית אחת, הגדלה מ-5 ל-10 Kubernetes pods קיצרה scraping של 400 עמודים מדקות לפחות מדקה אחת (DigitalOcean).
ניטור ו-Auto-Scaling של תשתית ה-scraping שלכם
- לוגים: שלחו לוגים ל-CloudWatch, Stackdriver או Datadog. הגדירו התראות על שגיאות או האטות.
- בדיקות תקינות: השתמשו ב-Prometheus וב-Grafana למדדים כמו עמודים שנגרדו בדקה, שיעור שגיאות ותקינות pods.
- Auto-scaling: הגדירו Kubernetes HPA (Horizontal Pod Autoscaler) כדי להרחיב pods לפי CPU או מספר בקשות.
תמיד מומלץ ליישם retries עם exponential backoff כדי להתאושש מהפרעות ברשת או חסימות זמניות.
שיטות מומלצות לאחסון נתונים ולעיבוד לאחר חילוץ
אחרי שחילצתם את הנתונים, צריך גם לאחסן ולנקות אותם:
- משימות קטנות: ייצוא ל-CSV, JSON, או העלאה ל-Google Sheets, Airtable או Notion (Thunderbit עושה זאת כברירת מחדל).
- משימות גדולות: השתמשו ב-SQL (MySQL/PostgreSQL) לנתונים מובנים, או ב-NoSQL (MongoDB, DynamoDB) לנתונים חצי-מובנים או סכמות משתנות (ScrapeHero).
- אחסון בענן: S3 או Google Cloud Storage לקבצים גולמיים ולגיבויים.
- ניקוי נתונים: תמיד אימתו שדות, נרמלו פורמטים (תאריכים, מספרים) והסירו כפילויות. השתמשו ב-schema validators כדי לאכוף איכות נתונים (ScrapeGraphAI).
שמרו גם את הנתונים הגולמיים וגם את הנקיים — אי אפשר לדעת מתי תצטרכו לעבד מחדש או לדבג.
סיכום: נקודות המפתח ליעילות Web Scraping עם Node.js
דלגו על קוד ה-scraper ראו איך ה-web scraper הסוכני של Thunderbit משתווה לכתיבה ולתחזוקה של סקריפטי scraping משלכם. Get Started Free
נסכם את העיקר:
- נצלו את הכוח הא-סינכרוני של Node.js ל-scraping מקבילי בהיקפים גדולים — במיוחד באתרים עתירי JS.
- שלבו את הכלים הנכונים: השתמשו ב-axios/got לבקשות, ב-Cheerio ל-HTML סטטי, ב-Puppeteer לתוכן דינמי, ושילבו ביניהם למהירות וגמישות.
- הימנעו ממלכודות anti-bot: החליפו פרוקסים וכותרות, הדמו התנהגות אנושית, וכבדו את robots.txt.
- פשטו עם Thunderbit: למשתמשים עסקיים או לאבטיפוס מהיר, Thunderbit מאפשר לחלץ נתונים מורכבים בעזרת AI ולחבר אותם ל-stack שלכם ב-Node.js דרך API.
- פרסו בקנה מידה: השתמשו ב-Docker, תזמנו עם Kubernetes, ונטרו הכול כדי להבטיח אמינות.
- אחסנו ונקו את הנתונים: בחרו את פתרון האחסון המתאים לצרכים שלכם, ותמיד אמתו לפני השימוש.
הווב לא נעשה פשוט יותר, אבל עם שיטות העבודה האלה, ה-scrapers שלכם ב-Node.js יכולים להישאר מהירים, אמינים, ותמיד צעד אחד לפני מרוץ החימוש נגד bots. ואם נמאס לכם פעם לנפות selectors ב-2 בלילה, זכרו: ה-AI של Thunderbit ער כל הזמן.
רוצים להעמיק עוד? כנסו ל-Thunderbit Blog לעוד מדריכים מעמיקים, או נסו את תוסף Chrome של Thunderbit כדי לראות כמה קל scraping יכול להיות.
גרדו עם ה-web scraper הסוכני של Thunderbit ה-API של Thunderbit Web Scraper מאפשר לכם להפעיל חילוץ מתוך קוד Node.js משלכם, עם מסלול חינמי להתחלה. Get Started Free
שאלות נפוצות
1. למה Node.js מתאים במיוחד ל-Web Scraping ב-2025?
המודל הא-סינכרוני והאירועי של Node.js מאפשר לו לטפל באלפי בקשות מקבילות, מה שהופך אותו לאידיאלי לגרידה של כמויות גדולות של נתונים או עדכונים בזמן אמת. אקו-סיסטם ה-npm העצום והתמיכה המובנית ב-JavaScript מתאימים בצורה מושלמת לאתרים מודרניים וכבדי JS (Node.js Docs).
2. איך אפשר להימנע מחסימות כשמגרדים עם Node.js?
השתמשו בפרוקסים מתחלפים, אקראו כותרות בקשה, הגבילו את קצב הבקשות עם השהיות אקראיות, והדמו התנהגות אנושית (תנועת עכבר, גלילה, הקלדה) באמצעות כלים כמו Puppeteer. תמיד כבדו את robots.txt ואת תנאי האתר (Medium).
3. מתי להשתמש ב-Cheerio לעומת Puppeteer ב-scraper של Node.js?
השתמשו ב-Cheerio לניתוח מהיר של HTML סטטי (כאשר הנתונים כבר קיימים ב-HTML הגולמי). השתמשו ב-Puppeteer לאתרים שטוענים תוכן באופן דינמי עם JavaScript. לתוצאות הטובות ביותר, השתמשו ב-Puppeteer כדי לרנדר את הדף, ואז ב-Cheerio כדי לנתח את ה-HTML (Bright Data).
4. איך Thunderbit מפשט Web Scraping עם Node.js?
Thunderbit מאפשר לכם לחלץ נתונים מובנים מכל אתר באמצעות AI ו-prompts בשפה טבעית — בלי צורך בקוד. הוא מטפל בתוכן דינמי, תתי-עמודים ו-pagination, ומציע API לשילוב ב-Node.js. את הנתונים אפשר לייצא ישירות ל-Excel, Google Sheets, Airtable או Notion (Thunderbit Blog).
5. מהי הדרך הטובה ביותר להרחיב ולנטר scrapers ב-Node.js בענן?
הפכו את ה-scraper ל-Docker, פרסו אותו על Kubernetes או שירותי ענן מנוהלים, והשתמשו ב-auto-scaling כדי להתמודד עם עומסים. נטרו לוגים ומדדים עם כלים כמו CloudWatch או Prometheus, והגדירו התראות על שגיאות או האטות (DigitalOcean).
מוכנים לשדרג את יכולות ה-web scraping שלכם? נסו את Thunderbit, ושה-scrapers שלכם יהיו מהירים, חמקמקים ותמיד צעד אחד לפני כולם.
נסו את Agentic Web Scraper Get Started Free
למידע נוסף




