
הרשת מוצפת בנתונים — וב־2026, פרויקטים של גריפת אתרים הפכו ל־secret sauce של כמעט הכול, מניתוח עסקי ועד זיהוי מגמות ופריצות דרך מחקריות. גריפת אתרים בפייתון עברה מסקריפט סוף־שבוע של חובבים לתשתית אמיתית עבור לא מעט צוותי דאטה — גם אם "מנוע חדשנות קריטי למשימה" הוא בדיוק מסוג המשפטים שנכנסים ל־pitch decks יותר מאשר ל־postmortems אמיתיים, אז נאמר את זה בפשטות: הרבה צוותים כבר נשענים על זה, וגם הכלים הדביקו את הקצב.
בין אם אתם מדעני נתונים, מפתחים או פשוט חובבי ניסוי סקרנים, הרעיון הנכון לפרויקט — יחד עם הכלי הנכון — יכול לפתוח תובנות שאחרת היו נשארות קבורות בערמת השחת הדיגיטלית. והחלק הכי טוב? עם פתרונות מבוססי AI כמו Thunderbit, אפילו משימות גריפה מורכבות במיוחד כבר בהישג יד — בלי צורך ב־PhD ב־regex.
נסו את AI Web Scraper של Thunderbit
מוכנים לשדרג את הכישורים שלכם ולבנות משהו שבאמת מזיז את המחט? ריכזתי 32 רעיונות יצירתיים, מתקדמים ומעשיים לפרויקטי גריפת אתרים בפייתון — כל אחד מהם ממופה לכלים הטובים ביותר (מ־BeautifulSoup ועד Scrapy ו־Thunderbit), עם טיפים על מורכבות, אוטומציה והשפעה בעולם האמיתי. בואו נצלול פנימה ונראה כמה רחוק אפשר לקחת את הפרויקט הבא שלכם מבוסס הנתונים.
למה פרויקטים של גריפת אתרים בפייתון חיוניים לחדשנות מונעת נתונים
מהי גריפת נתונים ואיך עושים זאת ב־2026 Get Started Free
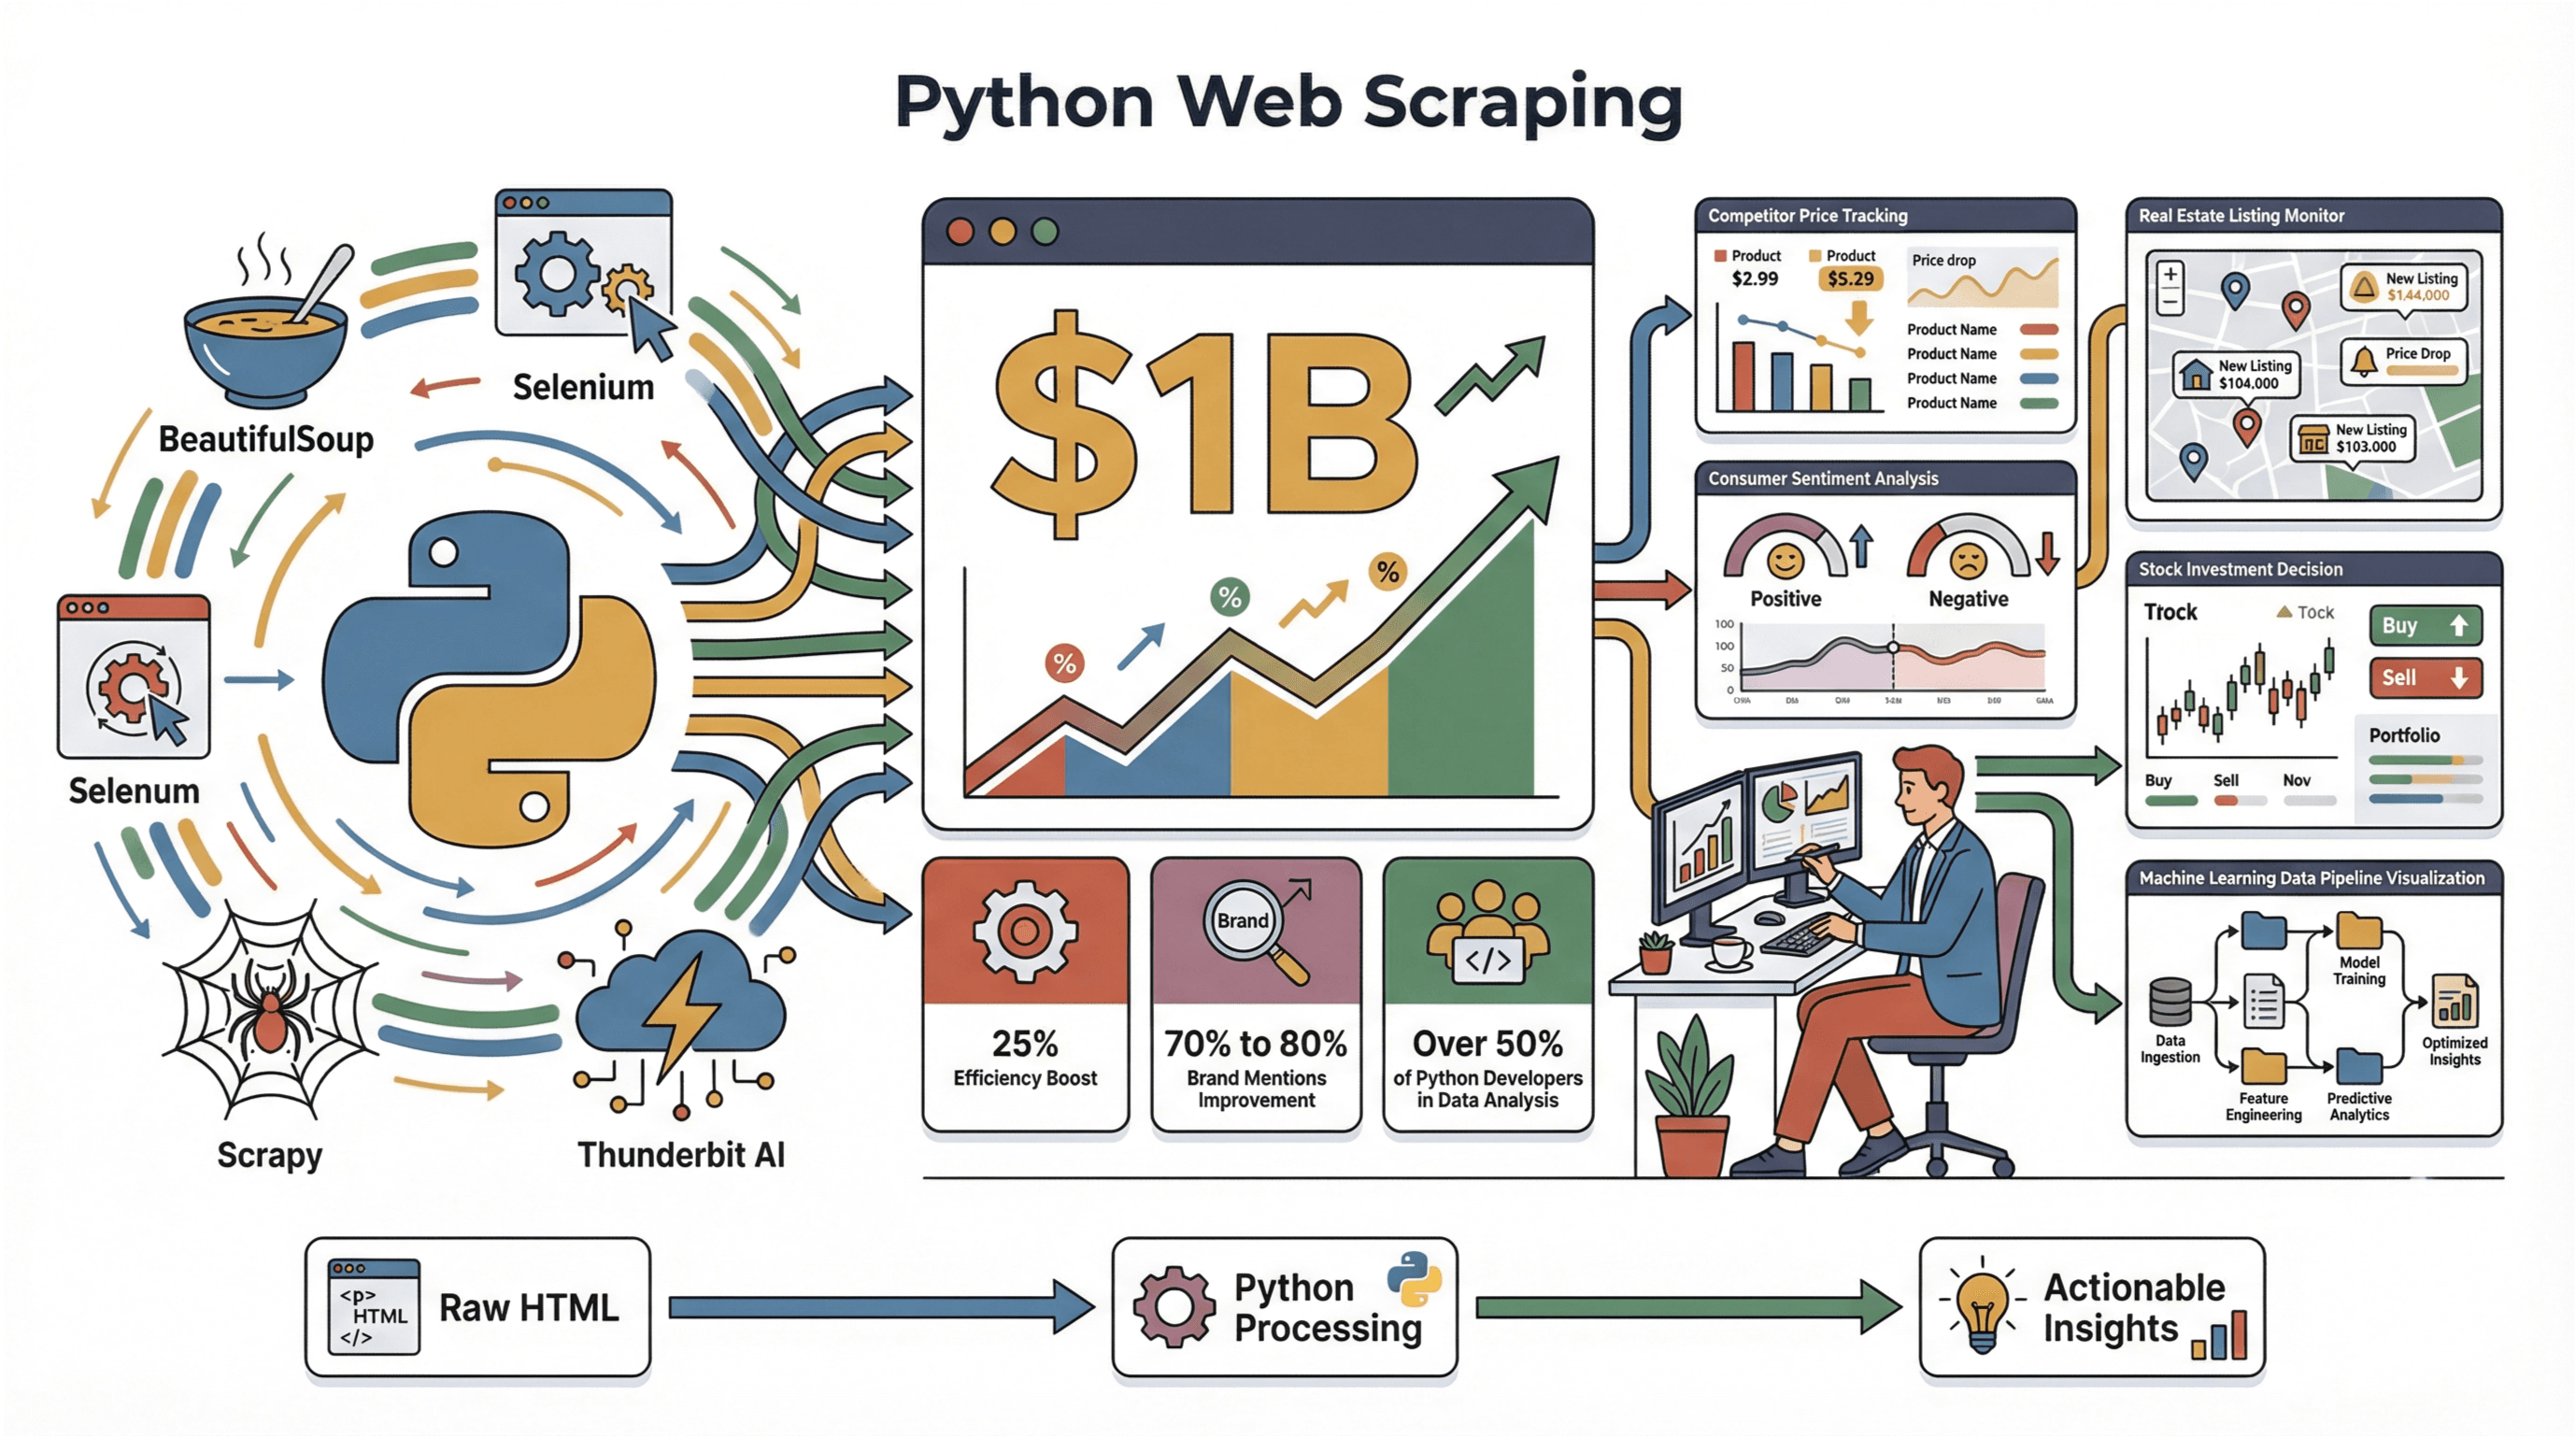
גריפת אתרים הפכה ב־2026 לתעשייה של מיליארדי דולרים, והיא רק ממשיכה לגדול (PromptCloud). חברות משתמשות בצינורות גריפה כדי לעקוב אחרי מחירי מתחרים, לנטר שינויי סנטימנט בקרב צרכנים, ואפילו לאוטומציה של החלטות השקעה. קרנות כמותיות וצוותי מחקר קמעונאיים מתייחסים היום ל־alt-data שנגרף — תמלילי שיחות רווח, פידים של משרות, גריפות מחירים מאתרי מסחר אלקטרוני — כקלט שגרתי למודלים שלהם. אין לי מספר נקי ומבוסס לכל הענף לגבי כמה זה שיפר החלטות (המספרים שמסתובבים לא תמיד מגובים היטב), אבל אות הביקוש ברור לפי כמות הכסף שנכנסת לשירותי גריפה מנוהלים ולרשתות פרוקסי.
פייתון היא שפת ברירת המחדל לפרויקטים כאלה, וקל להבין למה. לפי סקר State of Python של JetBrains ל־2025, 51% מהמשיבים אמרו שהם עובדים על חקירת נתונים ועיבודם — זו השנה הראשונה שבה התחום הזה מחזיק רוב מוחלט (JetBrains). והאקוסיסטם של פייתון — BeautifulSoup, Selenium, Playwright, Scrapy, וכיום גם כלים מסייעי AI כמו Thunderbit — מקצר מדי שנה את הדרך מ־HTML גולמי לסט נתונים שמיש.
בין אם אתם מגרדים חוות דעת על מוצרים לניתוח סנטימנט, עוקבים אחרי לוחות נדל״ן, או בונים מערך נתונים מותאם אישית ללמידת מכונה, פרויקטים של גריפת אתרים בפייתון הם עמוד השדרה של חדשנות מודרנית מונעת נתונים.
איך לבחור את רעיון פרויקט גריפת האתרים הנכון
עם כל כך הרבה אפשרויות, איך בוחרים פרויקט ששווה את הזמן שלכם? הנה המסגרת שלי:
- מתחילים מהמטרה שלכם: איזו החלטה או תהליך הנתונים האלה אמורים לשרת? אם אתם מחפשים מודיעין תחרותי, גרדו מחירי מתחרים או קווי מוצרים. אם אתם רוצים תובנות על לקוחות, בדקו ביקורות או רשתות חברתיות.
- בודקים זמינות נתונים: האם הנתונים פומביים, מאחורי התחברות, או זמינים דרך API? אתרים ציבוריים וסטטיים קלים יותר; אתרים דינמיים או מוגנים דורשים כלים מתקדמים יותר.
- מתאימים את הכלי למשימה: לעמודים סטטיים, BeautifulSoup מצוין. לתוכן דינמי, ייתכן שתצטרכו Selenium או Playwright. עבור נתונים מורכבים או מרובי־פורמטים (כמו PDF או תמונות), כלים מבוססי AI כמו Thunderbit יכולים לחסוך לכם שעות.
- חושבים על סקייל ואוטומציה: האם הפרויקט ירוץ פעם אחת, או לפי לוח זמנים? גריפה מתוזמנת וייצוא קל (ל־Google Sheets, Excel וכו׳) הם חובה לפרויקטים מתמשכים.
הפרויקטים הטובים ביותר מאזנים בין ערך עסקי לבין היתכנות טכנית. ואם אתם לא קוסמי קוד, אל דאגה — כלים כמו Thunderbit הופכים גריפה מתקדמת לנגישה לכולם.
השוואה בין כלי גריפת אתרים בפייתון: מ־BeautifulSoup ועד Thunderbit
בואו נפרק את הכלים המרכזיים שתרצו בארסנל שלכם:
| כלי | מתאים במיוחד ל | מטפל ב־JavaScript? | יכולת סקייל | קלות שימוש | תחזוקה |
|---|---|---|---|---|---|
| BeautifulSoup | דפים סטטיים, משימות מהירות | לא | נמוכה | גבוהה | ידנית |
| Selenium | אתרים דינמיים, עתירי JS (לֶגָסי) | כן | בינונית | בינונית | בינונית |
| Playwright | גריפה מודרנית של אתרים דינמיים / SPA | כן (auto-wait) | בינונית-גבוהה | בינונית | נמוכה-בינונית |
| Scrapy | סריקה מובנית בקנה מידה גדול | לא (אבל אפשר להוסיף) | גבוהה | בינונית | בינונית |
| Thunderbit | נתונים מורכבים/מעורבים מבוססי AI | כן | גבוהה | גבוהה מאוד | נמוכה |
- BeautifulSoup מושלם לאתרים קטנים וסטטיים — חשבו על בלוגים או ספריות פשוטות.
- Selenium מצטיין כשצריך אינטראקציה עם תוכן דינמי, התחברויות או infinite scroll — ויש לו את הקהילה ותמיכת הדרייברים הרחבות ביותר מכל ספריית אוטומציה לדפדפן, כך שאם אתם יורשים בסיס קוד קיים, לרוב כדאי להישאר איתו.
- Playwright (דרך
playwright-python) הוא מה שהייתי בוחר עבור פרויקט חדש ב־2026. ההבדל המעשי הגדול הוא auto-waiting: ה־API ממתין שהאלמנטים יהיו מוכנים לפעולה לפני לחיצה, במקום לפזרtime.sleep(3)ולקוות לטוב. זה לבדו מסיר את מקור הבאגים השביר ביותר של סקרייפרים. החיסרון: קהילה קטנה יותר מ־Selenium, ועוד כמה מקרי קצה של גרסאות דפדפן בארגונים/מערכות ותיקות ש־Playwright עדיין לא מכסה. - Scrapy בנוי לסריקה תעשייתית ולייצוא מובנה, אבל עקומת הלמידה שלו תלולה יותר. הוא עדיין מתוחזק באופן פעיל — גרסה 2.15 יצאה בינואר 2026 והסירה תמיכה ב־Python 3.9, אז בדקו את סביבת ההרצה שלכם לפני השדרוג.
- Thunderbit מביא את ה־AI לשולחן, ומטפל בכל דבר — מניווט בין תתי־עמודים ועד חילוץ מ־PDF ותמונות, ואפילו מציע אילו שדות הכי נכון לגרד. זה הכלי המועדף עליי לפרויקטים שבהם מהירות, עמידות וקלות שימוש חשובים במיוחד.
לצלילה עמוקה יותר לבחירת כלים, עיינו ב־המדריך של Thunderbit לכלי גריפת אתרים.
מטריצת מורכבות הפרויקט והמלצת הכלי
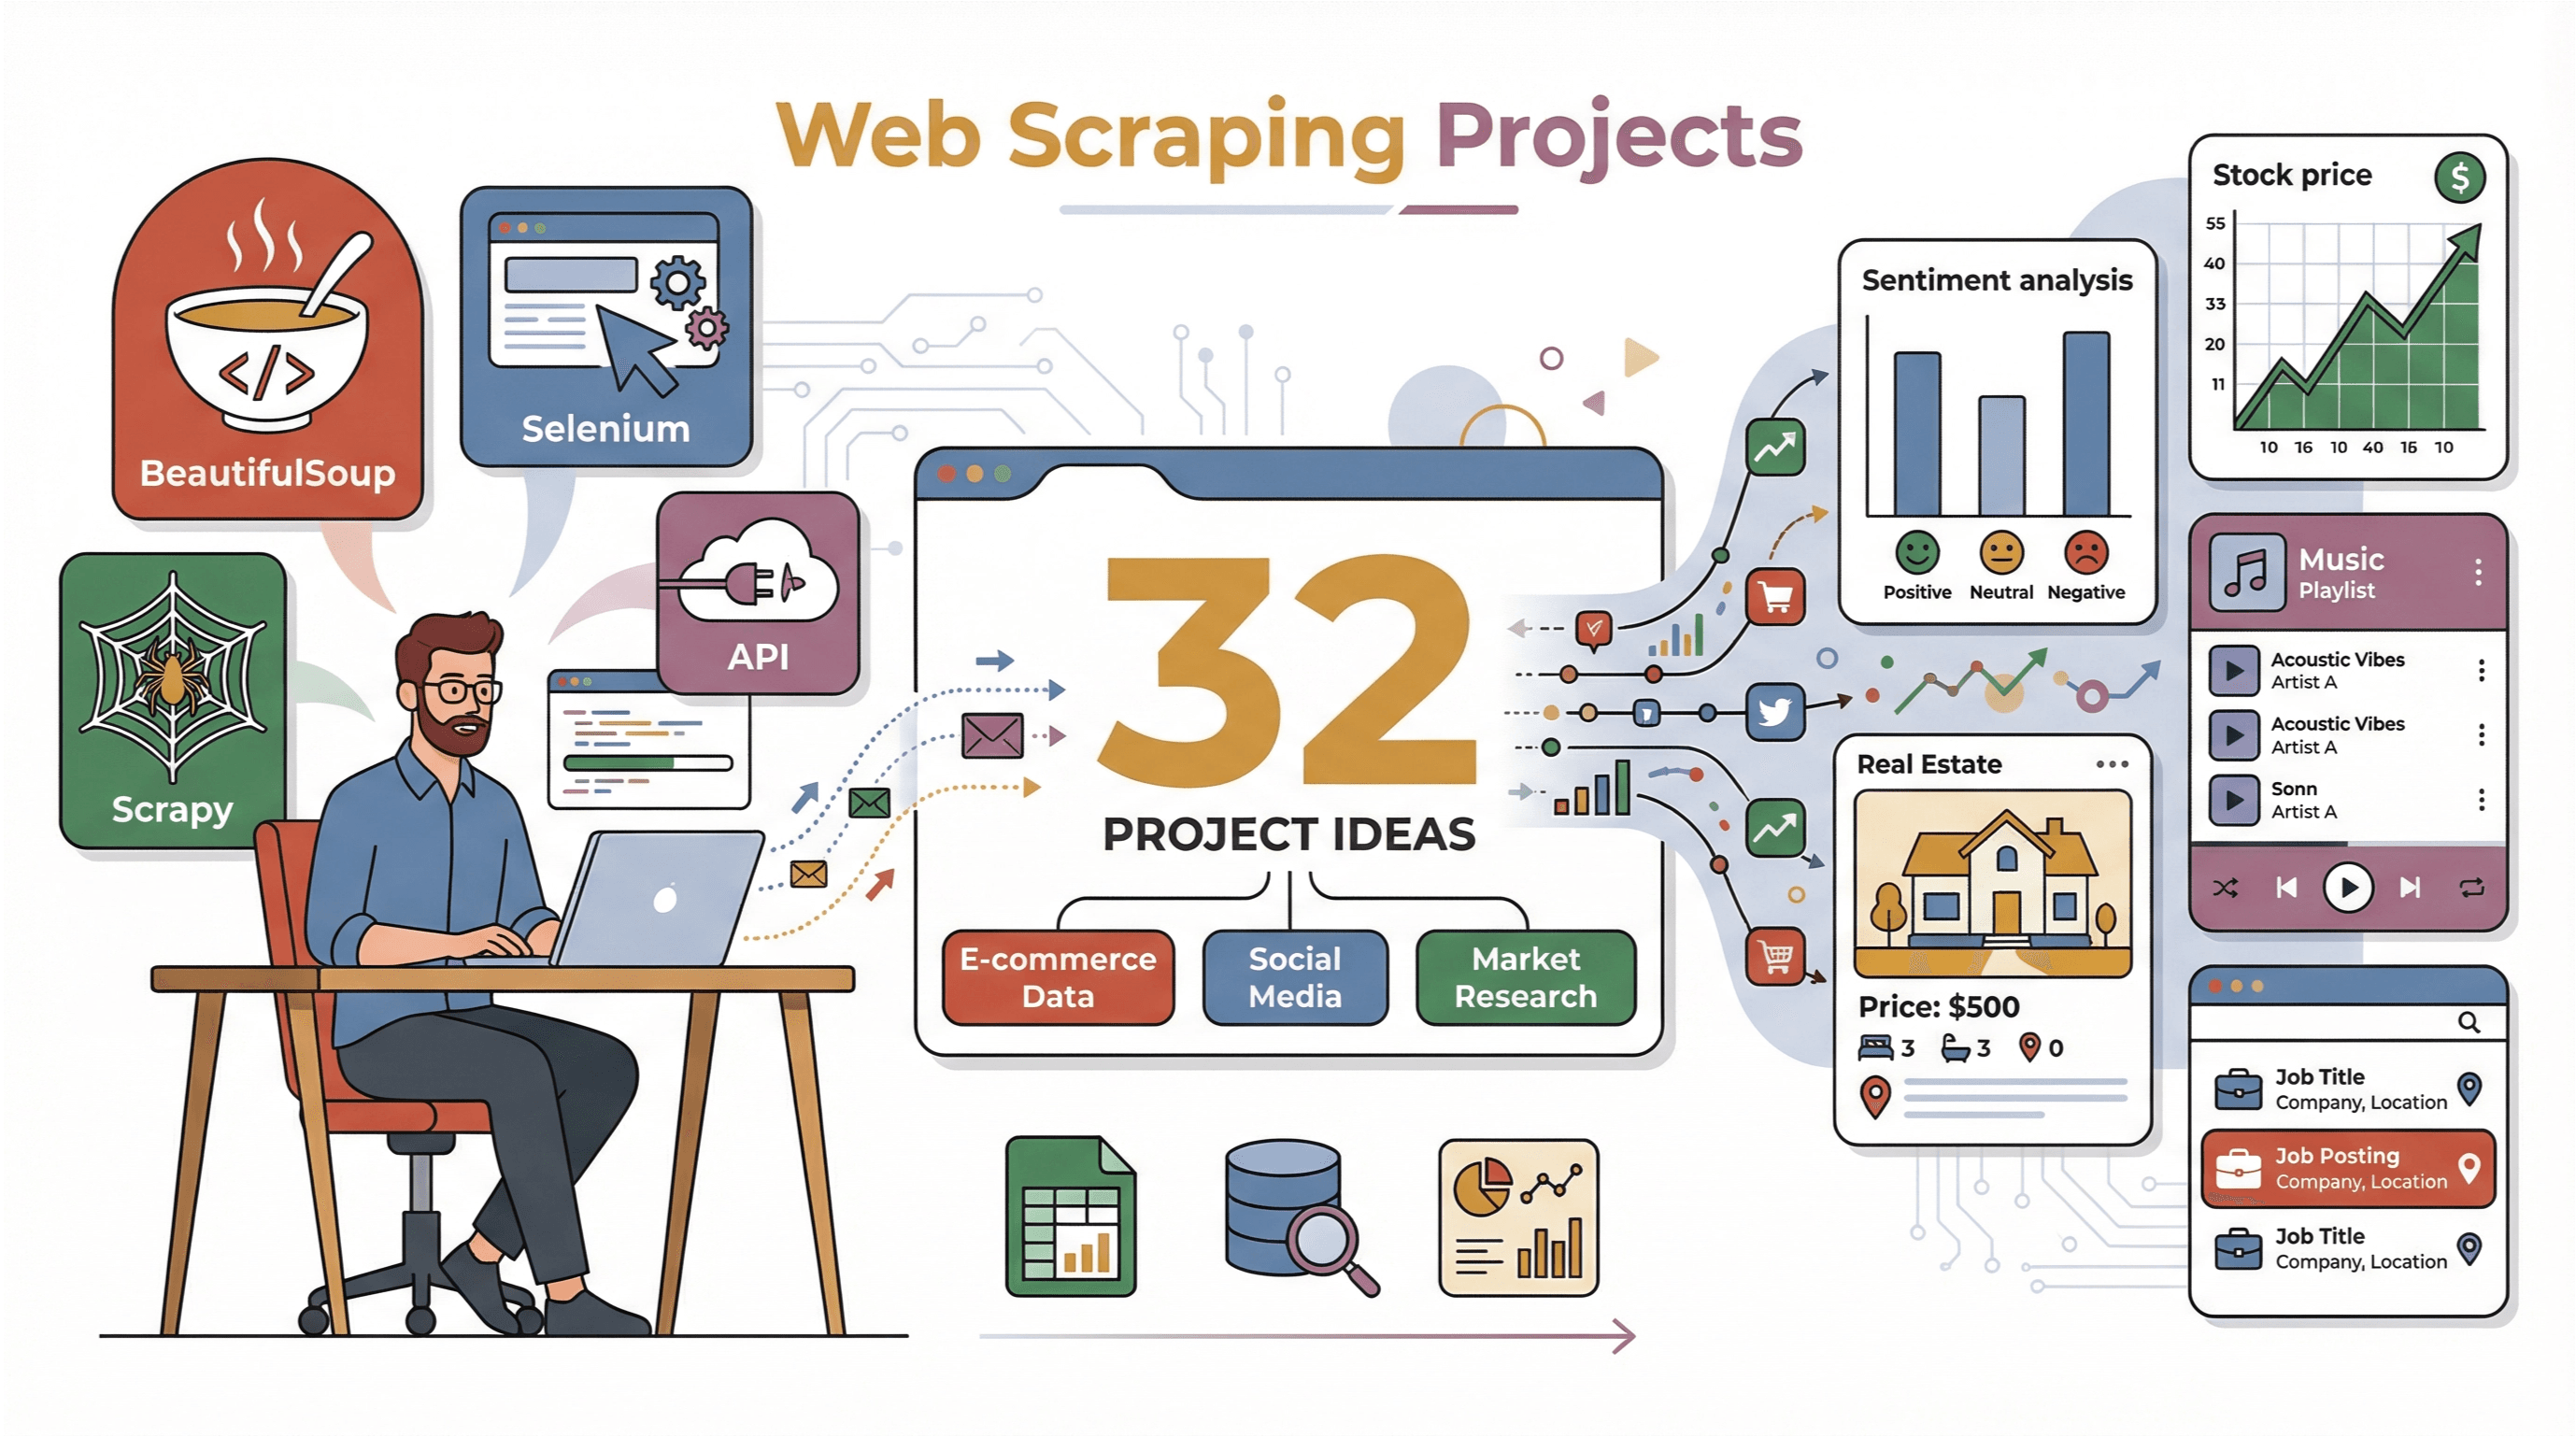 הנה מטריצת עזר מהירה שתעזור לכם להתאים כל רעיון פרויקט לכלי הנכון ולהעריך את המורכבות:
| רעיון פרויקט | הכלי/ים המומלצים | מורכבות | פלט עיקרי |
|---|---|---|---|
| ניתוח סנטימנט של ביקורות Amazon | BeautifulSoup + NLP | בינונית | ביקורות + ציוני סנטימנט |
| תוצאות וססטיסטיקות חיות של Esports | Selenium | גבוהה | נתונים בזמן אמת |
| גריפת נתוני Q&A חמים של Quora | Selenium | בינונית-גבוהה | מערך נתוני שאלות ותשובות |
| נתוני פלייליסטים ב־Spotify | Spotify API | נמוכה | רצועות פלייליסט, מדדים |
| דירוגי אטרקציות תיירותיות | BeautifulSoup | בינונית | דירוגים, ביקורות, מיפוי מיקומים |
| מגמות קופות של סרטים | API או BeautifulSoup | נמוכה-בינונית | סדרת זמן של קופות |
| מגמות ותוכן ב־Twitter | Selenium/API | בינונית | נושאים חמים, סנטימנט |
| Zhihu Q&A | Selenium | גבוהה | מערך נתוני Q&A בסינית |
| ניטור נדל״ן (Thunderbit) | Thunderbit | נמוכה-בינונית | נתוני מודעות, מגמות מחירים |
| ניתוח רבי־מכר של ספרים אלקטרוניים | Selenium/API | בינונית | דירוגים, ביקורות |
| מעקב אחרי מחירי מסחר אלקטרוני | Scrapy + proxies | גבוהה | היסטוריית מחירים, התראות |
| ניתוח Reddit Subreddit | Reddit API | בינונית | חום נושאים, מעורבות |
| מעקב אחר נתוני מניות | yfinance/API | נמוכה | מחירים היסטוריים, אינדיקטורים |
| מודעות דרושים (Scrapy) | Scrapy | בינונית | משרות, שכר |
| ביקורות Google Play | API/Selenium | בינונית | ביקורות, דירוגים, סיכום NLP |
| איגוד תוכן מבלוגי מתחרים | RSS + BeautifulSoup | בינונית | מאגר תוכן, אשכולות נושאים |
| משוב מקורסים מקוונים | Selenium/API | בינונית | דירוגי קורסים, משוב |
| ניקוי מדריך עסקים | Scrapy + Python | בינונית | רשימת עסקים נקייה ומנוקה כפילויות |
| הוצאות ומגמות של פודקאסטים | API + NLP | בינונית | פודקאסטים חמים, נתוני פרקים |
| חילוץ קבצים ב־Thunderbit | Thunderbit | נמוכה | נתונים מובנים מ־PDF/תמונות |
| מגמות ציטוטים אקדמיות | API + parsing | בינונית | ספירות ציטוטים, קווי מגמה |
| נתוני משחקי אינטרנט דרך OCR | Selenium + OCR | גבוהה | סטטיסטיקות משחק מתוך תמונות |
| ניתוח ביקורות של קמעונאים | Scrapy + NLP | בינונית-גבוהה | מאגר ביקורות צרכניות, סיכום |
| חדשות חיות עם Selenium | Selenium + scheduling | בינונית | כותרות בזמן אמת |
| מעקב אחר מגמות אופנה | Scrapy + image analysis | בינונית | סגנונות פופולריים, נתוני טרנדים |
| ייצוא מוצרים של מתחרים (Thunderbit) | Thunderbit | נמוכה | רשימת מוצרים, מאפיינים מרכזיים |
| ניתוח מולטימדיה ב־Tumblr | API/Selenium | בינונית | פוסטים, תגיות, קישורי מדיה |
| חילוץ ביקורות על חברות לוגיסטיקה | BeautifulSoup + NLP | בינונית | סנטימנט של ביקורות שירות |
| סטטיסטיקות חשיפה שיווקית אזורית של מותגי ספורט | Social API + scraping | גבוהה | מדדי חשיפה אזוריים |
| תגובות למוצר ב־YouTube | YouTube API + NLP | בינונית | סנטימנט תגובות, אזכורי תכונות |
| תדירות מבצעי מסחר אלקטרוני | Scrapy | בינונית | לוח מבצעים, ניתוח תדירות |
| נתוני סדרות רב־לשוניים | Scrapy + translation API | גבוהה | תיאורים רב־לשוניים |
עכשיו ניכנס לחלק המעניין באמת — 32 רעיונות לפרויקטים, כל אחד עם הסבר קצר, טיפים לכלי ותובנות ברמה מקצועית.
1. ניתוח סנטימנט של ביקורות מוצרים ב־Amazon (BeautifulSoup)
גרדו ביקורות מוצרים מ־Amazon והריצו ניתוח סנטימנט כדי לגלות מה הלקוחות באמת חושבים. השתמשו ב־BeautifulSoup כדי לחלץ טקסט ביקורת, דירוגי כוכבים ומטא־דאטה של הכותב. טפלו בעימוד כדי לאסוף מערך נתונים חזק, ואז הפעילו ספריות NLP בפייתון (כמו VADER או TextBlob) כדי לדרג סנטימנט ולהבליט נושאים חוזרים. לתוצאות טובות, האטו את הבקשות כדי להימנע מ־CAPTCHA (Oxylabs).
2. תוצאות וסטטיסטיקות חיות של Esports (Selenium)
רוצים לעקוב אחרי תוצאות חיות ב־esports? השתמשו ב־Selenium כדי לגרד לוחות תוצאות דינמיים, שמוצגים ב־JavaScript, מאתרים כמו ESL או Liquipedia. Selenium מאפשר לכם לאוטומט פעולות בדפדפן, לטפל בהתחברויות, ולחלץ סטטיסטיקות בזמן אמת למשחקים כמו League of Legends או CS:GO. טיפ מקצועי: בדקו את קריאות הרשת של הדפדפן כדי למצוא נקודות קצה נסתרות של API ולהאיץ את החילוץ (YouTube).
3. גריפת נתוני Q&A טרנדיים מ־Quora
אספו שאלות ותשובות חמות מ־Quora בעזרת Selenium כדי להתמודד עם infinite scroll ודרישות התחברות. נתחו את טקסט השאלה, תוכן התשובה, מספרי upvotes ומידע על הכותב. לניתוח מעמיק יותר, לחצו על כפתורי “Read More” כדי לקבל תשובות מלאות וסננו פרסומות או תוכן ממומן (ScraperAPI).
4. איסוף נתוני פלייליסטים מ־Spotify עם Python
השתמשו ב־Spotify Web API (עם הספרייה spotipy) כדי לשלוף רצועות פלייליסט, מטא־דאטה ותכונות אודיו. נתחו מגמות פלייליסט, פופולריות של שירים ואפילו מאפייני שיר כמו tempo או energy. רעיונות להמחשה: חלוקת ז׳אנרים, רשתות אמנים או קצב תחלופת רצועות (Spotipy Docs).
5. גריפת דירוגי אטרקציות תיירותיות
גרדו דירוגים וביקורות של אטרקציות תיירותיות מפלטפורמות כמו TripAdvisor באמצעות BeautifulSoup. חלצו שמות אטרקציות, מיקומים, דירוג ממוצע ומספרי ביקורות. נקו את הנתונים וחשבו קואורדינטות לצורכי מפה, ואז נתחו מגמות לפי עיר או עונה (DataHen).
6. נתוני קופות של סרטים והדמיית מגמות
שלפו נתוני קופות היסטוריים ממקורות כמו Box Office Mojo באמצעות ה־API שלהם או BeautifulSoup. הדמיית מגמות באמצעות ספריות פייתון כמו Matplotlib או Plotly — למשל הכנסות לאורך זמן, חלוקה לפי ז׳אנר או זינוקים עונתיים (Kaggle).
7. ניתוח נושאים חמים ותוכן משתמשים ב־Twitter
נטרו טרנדים ב־Twitter באמצעות ה־API (אם יש לכם גישה) או כלים כמו snscrape ו־Selenium. גרדו האשטגים חמים, אספו ציוצים ונתחו סנטימנט או הופעה משותפת של האשטגים. עבור תוכן כבד ב־JS, אוטומציה של דפדפן היא חובה (Thunderbit Blog).
8. גריפת שאלות ותשובות אינטראקטיביות מ־Zhihu
גרדו שאלות ותשובות חמות מ־Zhihu בעזרת Selenium (ועוגיות התחברות אם צריך). חלצו טקסט שאלה, תוכן תשובה, upvotes ומעורבות משתמשים. לניתוח טקסט בסינית, השתמשו בספריות כמו Jieba או SnowNLP.
9. ניטור שוק הנדל״ן בזמן אמת (Thunderbit)
עם Thunderbit, אפשר לנטר מודעות נדל״ן ומחירים בכמה קליקים בלבד. השתמשו ב־“AI Suggest Fields” כדי לזהות אוטומטית נתוני נכסים, הפעילו גריפת תתי־עמודים לפרטים, והגדירו גריפות מתוזמנות לעדכונים יומיים. ייצאו הכול ל־Google Sheets או Airtable — בלי לכתוב קוד (Thunderbit Real Estate Guide).
גרדו מודעות נדל״ן עם Thunderbit
10. ניתוח דירוגי רבי־מכר בפלטפורמות ספרים אלקטרוניים
גרדו רשימות רבי־מכר וביקורות מ־Amazon Kindle או Goodreads באמצעות Selenium או APIs. עקבו אחרי שינויים בדירוג לאורך זמן, נתחו מגמות ז׳אנר וקשרו בין ביקורות לדירוג מכירות (Oxylabs).
11. ניתוח תנודות מחירים במסחר אלקטרוני
השתמשו ב־Scrapy (עם proxies) כדי לעקוב אחרי מחירי מוצרים באתרי מסחר אלקטרוני. אספו נתונים לפי לוח זמנים, בנו מסד נתוני מחירים היסטורי והגדירו התראות לירידות משמעותיות. נתחו דפוסי תמחור דינמי ואסטרטגיות של מתחרים (Opensend).
12. ניתוח חום דיון של נושאים ב־Reddit
חלצו פוסטים ותגובות מ־subreddits באמצעות Reddit API (PRAW). נתחו תדירות פוסטים, upvotes ונפח תגובות כדי לזהות נושאים חמים ומגמות מעורבות. הדגימו באמצעות heatmaps או תרשימי עמודות.
13. מעקב היסטורי אחרי מניות ואינדיקטורים פיננסיים
שלפו מחירי מניות ואינדיקטורים פיננסיים באמצעות yfinance או APIs פיננסיים אחרים. בנו מערכי נתוני סדרות זמן, ציירו מגמות וקשרו אותן לאינדיקטורים כלכליים (AbstractAPI).
14. גריפת מודעות דרושים עם Scrapy
השתמשו ב־Scrapy כדי לסרוק לוחות דרושים, לחלץ כותרות משרות, חברות, מיקומים ושכר. טפלו בעימוד וייצאו נתונים מובנים לניתוח — למשל התפלגות שכר, ביקוש לכישורים או מגמות גיוס (Scrapy Docs).
15. סקריפט לביקורות ודירוגים של אפליקציות ב־Google Play
גרדו ביקורות אפליקציה מ־Google Play באמצעות ה־API או Selenium. חלצו טקסט ביקורת, דירוגים ומטא־דאטה, ואז השתמשו ב־NLP כדי לסכם משוב משתמשים וסנטימנט (SerpApi).
16. איגום תוכן מבלוגים טכנולוגיים של מתחרים
אחדו פוסטים מבלוגים של מתחרים באמצעות פידי RSS ו־BeautifulSoup. ארגנו את התוכן, הסירו כפילויות והשתמשו באשכולות נושאים כדי לזהות מגמות ופערי תוכן.
17. גריפת משוב ודירוגים מקורסים בפלטפורמות למידה מקוונות
חלצו דירוגי קורסים ומשובים מפלטפורמות כמו Coursera או Udemy באמצעות Selenium או APIs. הדגימו פופולריות של קורסים, שביעות רצון ונושאי משוב נפוצים.
18. ארגון נתוני מדריכים עסקיים ו־Yellow Pages
גרדו רישומי עסקים ממדריכים כמו Yellow Pages באמצעות Scrapy. נרמלו כתובות, הסירו כפילויות ובנו מסד נתונים עסקי נקי (Oxylabs).
19. איסוף הוצאות אחרונות ותוכן פופולרי מפלטפורמות פודקאסטים
השתמשו ב־iTunes או ב־Spotify API כדי לשלוף מטא־דאטה של פודקאסטים, הוצאות פרקים ומדדי פופולריות. נתחו נושאים מתפתחים ומגמות הוצאה.
20. העלאת קבצים ל־Thunderbit לצורך חילוץ נתונים מותאם אישית
העלו PDF או תמונות ל־Thunderbit ותנו ל־OCR מבוסס ה־AI שלו לחלץ נתונים מובנים — בלי הקלדה ידנית או regex. מושלם לדיגיטציה של כרטיסי ביקור, חשבוניות או רשימות משתתפים (Thunderbit Docs).
21. ניתוח מגמות ציטוטים אקדמיות
גרדו נתוני ציטוטים ממסדי נתונים אקדמיים באמצעות APIs (כמו CrossRef). נתחו ספירות ציטוטים לאורך זמן כדי לזהות מגמות מחקר מתפתחות.
22. חילוץ נתוני משחקי רשת באמצעות OCR
שלבו Selenium ו־OCR libraries (כמו pytesseract) כדי לחלץ סטטיסטיקות ממשחקי רשת מבוססי תמונה. שימושי למשחקים שמציגים ציונים או נתונים כתמונות.
23. חילוץ וניתוח ביקורות צרכנים מקמעונאים מקוונים
גרדו ביקורות צרכנים מקמעונאים מקוונים באמצעות Scrapy. הפעילו NLP לדירוג סנטימנט, סכמו יתרונות/חסרונות מרכזיים של מוצרים והשוו בין מוצרים מתחרים.
24. גריפת כותרות חדשות וסיכומים בזמן אמת (Selenium)
השתמשו ב־Selenium כדי לגרד כותרות חדשות וסיכומים מאתרי חדשות דינמיים. קבעו גריפות קבועות לעדכונים בזמן אמת.
25. מעקב אחר טרנדים וסגנונות באתרי אופנה
גרדו אתרי אופנה כדי למצוא מוצרים וסגנונות טרנדיים באמצעות Scrapy. אפשר גם להשתמש בניתוח תמונה כדי לזהות צבעים או דוגמאות פופולריים.
26. ייצוא רשימות מוצרים של מתחרים עם Thunderbit
עם Thunderbit, אפשר לייצא רשימות מוצרים ותכונות של מתחרים בתוך דקות. השתמשו בהצעות שדות מבוססות AI ובגריפת תתי־עמודים לנתונים עמוקים, ואז ייצאו ישירות לכלי הגיליונות האהוב עליכם.
27. ניתוח תוכן מולטימדיה ב־Tumblr
גרדו פוסטים מולטימדיה מ־Tumblr באמצעות ה־API או Selenium. נתחו תמונות, סרטונים ותגיות כדי לזהות מגמות תוכן.
28. חילוץ נתוני ביקורות על חברות לוגיסטיקה
גרדו ביקורות ודירוגים על חברות לוגיסטיקה מפלטפורמות כמו Trustpilot באמצעות BeautifulSoup. מַפּוּ משוב לשיפורים תפעוליים בעזרת ניתוח טקסט.
29. סטטיסטיקות חשיפה שיווקית אזורית למותגי ספורט
אספו ונתחו נתוני חשיפה שיווקית עבור מותגי ספורט באמצעות APIs של רשתות חברתיות וגריפת אתרים. עקבו אחרי אזכורים, נוכחות קמעונאית ומגמות אזוריות.
30. ניתוח חוויית הערות על מוצרים ב־YouTube
גרדו תגובות ב־YouTube באמצעות ה־API, ואז השתמשו ב־NLP כדי לחלץ סנטימנט ואזכורי תכונות הקשורים לחוויית שימוש במוצר.
31. מעקב אחר תדירות ושיעור אירועי מבצעים במסחר אלקטרוני
עקבו אחרי אירועי קידום מכירות בפלטפורמות מסחר אלקטרוני באמצעות Scrapy. אגרו נתוני אירועים והדגימו מגמות לאורך זמן.
32. גריפת תיאורי סדרות רב־פלטפורמיות, רב־לשוניות
בנו סקריפטים עם Scrapy ו־translation APIs כדי לאסוף ולתקנן תיאורי סדרות מפלטפורמות סטרימינג שונות ובשפות שונות.
במבט חטוף: טבלת השוואת פרויקטים
| # | רעיון פרויקט | הכלי/ים | מורכבות | פלט עיקרי |
|---|---|---|---|---|
| 1 | ניתוח סנטימנט של ביקורות Amazon | BeautifulSoup + NLP | בינונית | ביקורות + סנטימנט |
| 2 | תוצאות חיות ב־Esports | Selenium | גבוהה | נתונים בזמן אמת |
| 3 | Q&A טרנדי ב־Quora | Selenium | בינונית-גבוהה | מערך נתוני Q&A |
| 4 | נתוני פלייליסטים ב־Spotify | Spotify API | נמוכה | רצועות פלייליסט, מדדים |
| 5 | דירוגי אטרקציות תיירותיות | BeautifulSoup | בינונית | דירוגים, ביקורות, מיפוי |
| 6 | מגמות קופות של סרטים | API/BeautifulSoup | נמוכה-בינונית | סדרת זמן של קופות |
| 7 | מגמות ותוכן ב־Twitter | Selenium/API | בינונית | נושאים חמים, סנטימנט |
| 8 | Zhihu Q&A | Selenium | גבוהה | מערך נתוני Q&A בסינית |
| 9 | ניטור נדל״ן (Thunderbit) | Thunderbit | נמוכה-בינונית | נתוני מודעות, מגמות מחירים |
| 10 | ניתוח רבי־מכר של ספרים אלקטרוניים | Selenium/API | בינונית | דירוגים, ביקורות |
| 11 | מעקב אחר מחירי מסחר אלקטרוני | Scrapy + proxies | גבוהה | היסטוריית מחירים, התראות |
| 12 | ניתוח Subreddit ב־Reddit | Reddit API | בינונית | חום נושאים, מעורבות |
| 13 | מעקב אחר נתוני מניות | yfinance/API | נמוכה | מחירים היסטוריים, אינדיקטורים |
| 14 | מודעות דרושים (Scrapy) | Scrapy | בינונית | משרות, שכר |
| 15 | ביקורות Google Play | API/Selenium | בינונית | ביקורות, דירוגים, סיכום NLP |
| 16 | איגוד בלוגים של מתחרים | RSS + BeautifulSoup | בינונית | מאגר תוכן, אשכולות נושאים |
| 17 | משוב מקורסים מקוונים | Selenium/API | בינונית | דירוגי קורסים, משוב |
| 18 | ניקוי מדריך עסקים | Scrapy + Python | בינונית | רשימת עסקים נקייה ומנוקה כפילויות |
| 19 | הוצאות ומגמות של פודקאסטים | API + NLP | בינונית | פודקאסטים חמים, נתוני פרקים |
| 20 | חילוץ קבצים ב־Thunderbit | Thunderbit | נמוכה | נתונים מובנים מ־PDF/תמונות |
| 21 | מגמות ציטוטים אקדמיות | API + parsing | בינונית | ספירות ציטוטים, קווי מגמה |
| 22 | נתוני משחקי רשת דרך OCR | Selenium + OCR | גבוהה | סטטיסטיקות משחק מתוך תמונות |
| 23 | ניתוח ביקורות קמעונאים | Scrapy + NLP | בינונית-גבוהה | מאגר ביקורות צרכניות, סיכום |
| 24 | חדשות חיות עם Selenium | Selenium + scheduling | בינונית | כותרות בזמן אמת |
| 25 | מעקב אחר מגמות אופנה | Scrapy + image analysis | בינונית | סגנונות פופולריים, נתוני טרנדים |
| 26 | ייצוא מוצרים של מתחרים (Thunderbit) | Thunderbit | נמוכה | רשימת מוצרים, מאפיינים מרכזיים |
| 27 | ניתוח מולטימדיה ב־Tumblr | API/Selenium | בינונית | פוסטים, תגיות, קישורי מדיה |
| 28 | ביקורות של חברות לוגיסטיקה | BeautifulSoup + NLP | בינונית | סנטימנט של ביקורות שירות |
| 29 | חשיפה שיווקית של מותגי ספורט | Social API + scraping | גבוהה | מדדי חשיפה אזוריים |
| 30 | תגובות למוצר ב־YouTube | YouTube API + NLP | בינונית | סנטימנט תגובות, אזכורי תכונות |
| 31 | תדירות מבצעי מסחר אלקטרוני | Scrapy | בינונית | לוח מבצעים, ניתוח תדירות |
| 32 | נתוני סדרות רב־לשוניים | Scrapy + translation | גבוהה | תיאורים רב־לשוניים |
סיכום: לפתוח אפשרויות חדשות עם פרויקטי גריפת אתרים בפייתון
גריפת אתרים עם פייתון היא הרבה יותר מתרגיל טכני — היא משגר ל־breakthroughs מונעי נתונים. בין אם אתם בונים דשבורדים, מניעים מודלים של למידת מכונה, או פשוט מספקים את הסקרנות שלכם, 32 רעיונות הפרויקט האלה מוכיחים שהגבול היחיד הוא הדמיון. ועם כלים כמו Thunderbit, לא חייבים להיות מומחי קוד כדי להתמודד גם עם אתגרי הגריפה הקשים ביותר.
אז בחרו פרויקט, הגדירו את סביבת פייתון שלכם והתחילו להתנסות. הרשת היא מגרש המשחקים של הנתונים שלכם — לכו לבנות משהו מדהים, ותנו לתובנות לזרום פנימה.
לצלילות עומק נוספות ולמדריכים מעשיים, עיינו ב־Thunderbit Blog.
נסו את AI Web Scraper של Thunderbit לפרויקט הבא שלכם Get Started Free
שאלות נפוצות
1. מהו הכלי הטוב ביותר בפייתון לפרויקטים של גריפת אתרים?
זה תלוי בפרויקט שלכם. לעמודים סטטיים, BeautifulSoup פשוט ויעיל. לאתרים דינמיים או אינטראקטיביים, Selenium הוא בחירה מוצקה. עבור גריפה בקנה מידה גדול או מתוזמן, Scrapy אידיאלי. עבור גריפה מבוססת AI, בלי קוד, כולל PDF ותמונות, Thunderbit הוא בחירה מעולה.
2. איך נמנעים מחסימה בעת גריפת אתרים?
השתמשו ב־user agents ריאליסטיים, הוסיפו השהיות בין בקשות, וכבדו את robots.txt. עבור אתרים עם תדירות גבוהה או רגישים, שקלו סיבוב פרוקסי ושימוש באוטומציה של דפדפן כדי לחקות התנהגות אנושית.
3. אפשר להשתמש בגריפת אתרים לפרויקטים מסחריים?
כן, אבל תמיד בדקו את תנאי השימוש וההגבלות המשפטיות של האתר היעד. אתרים רבים מאפשרים גריפה לשימוש אישי או מחקרי, אך שימוש מסחרי עשוי לדרוש הרשאה או גישה ל־API.
4. איך Thunderbit מפשט משימות מורכבות של גריפת אתרים?
Thunderbit משתמש ב־AI כדי לזהות שדות אוטומטית, לטפל בתתי־עמודים ולחלץ נתונים מאתרים דינמיים, PDF ותמונות. הוא מציע הנחיות בשפה טבעית ומייצא נתונים ישירות ל־Google Sheets, Excel, Airtable או Notion — בלי צורך בקוד.
5. מה הדרך הטובה ביותר להתחיל עם פרויקטי גריפת אתרים בפייתון?
בחרו רעיון פרויקט שמרגש אתכם, התקינו את הספריות הנחוצות (BeautifulSoup, Selenium, Scrapy או Thunderbit), והתחילו בקטן — גרדו עמוד אחד ואז הרחיבו. התנסו, שפרו, ואל תחששו לנסות כלים מבוססי AI כדי לזרז את תהליך העבודה שלכם.
גריפה נעימה — ושהנתונים שלכם תמיד יהיו טריים, מובנים ומלאי תובנות.
למידע נוסף



