
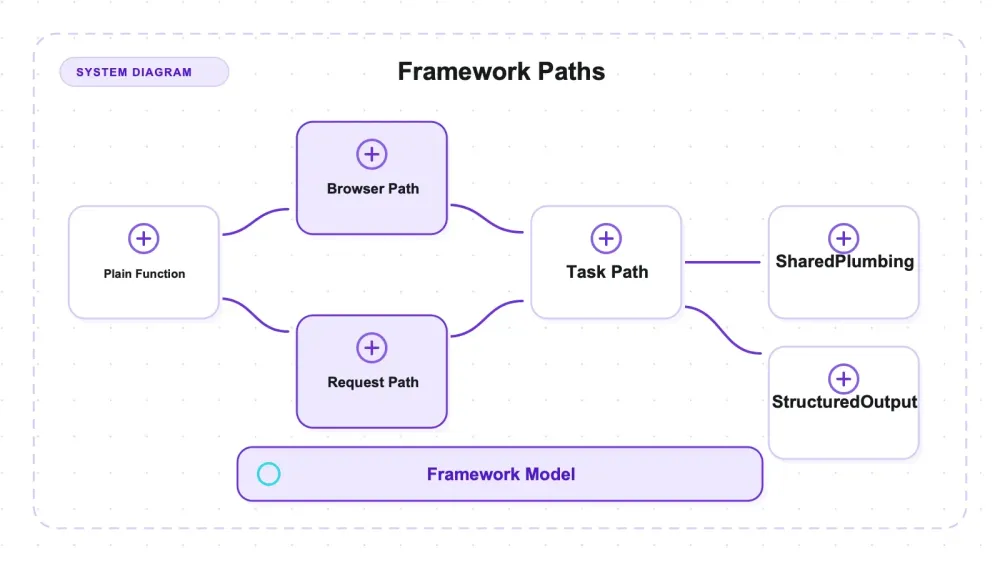
Botasaurus הוא מסגרת Python ל־web scraping מבית Omkar Cloud, שמוצגת כערכת־הכול־כלול לבניית סקרייפרים. כותבים פונקציה רגילה, מוסיפים לה את אחד הדקורטורים @browser, @request או @task, והמסגרת מחברת סביבה דרייבר לדפדפן, לקוח HTTP שמחקה דפדפן, caching, הרצה מקבילית ופלט בכמה פורמטים. זהו מטא־חבילה, וזו הנקודה החשובה: pip install botasaurus לא מתקין סתם ספרייה אחת לסביבה שלך, אלא מרכיב משפחה קטנה של חבילות מקור לצד עץ תלות רחב. הפרט המכני הזה התברר כדבר המעניין ביותר שאפשר היה למדוד בכנות.
Botasaurus משווק את עצמו סביב anti-detection, וזה בדיוק הציר שהסקירה הזו לא נוגעת בו. במקום להשוות אותו מול מנגנוני הגנה פעילים, מיפיתי את המסגרת — מה מותקן, מה מיובא, אילו מתודות קיימות, כמה נפח היא תופסת, ואיזו רישוי היא נושאת — ולא ניסיתי להציב אותה מול הגנות חיות. כל מדידת נפח ומספר ייבוא שמופיעים כאן מגיעים מ־pip, מ־python -c "import ...", ומבדיקה פנימית של מחלקות שנוצרו אבל מעולם לא התבקשו להביא דף; שום דפדפן לא הופעל כדי להפיק אותם. בהמשך כן הפעלתי דפדפנים, אבל רק מול דפים שכתבתי והסרתי בעצמי מ־127.0.0.1, כדי לראות מה הדרייבר אומר על עצמו והאם הוא מסוגל למשוך תוכן מדף שנבנה ב־JavaScript. אף אתר חי לא היה מעורב, לא נוצר קשר עם שירות anti-bot, ולא נבחנה שום CAPTCHA. היעילות מול אתרים אמיתיים נמצאת מחוץ לטווח הסקירה הזו במכוון, ואני מעדיף לומר זאת מראש מאשר לרמוז על בנצ'מרק שלא ביצעתי.
כשהגבול הזה מונח, הממצא המרכזי הוא סיפור של footprint — וסיפור די נעים. התקנה נקייה מייצרת תיקיית site-packages בנפח 122.3MB על פני 44 חבילות, במחשב שבו דרייבר הדפדפן שבמרכז הכול שוקל בערך 4MB. המסגרת לא כבדה כי הדרייבר כבד; היא כבדה כי "הכול כלול" אומר שהיא מביאה איתה numpy, lxml, gevent ועוד תריסר רכיבים לצורך שליפה של HTML. והחלק השני של הממצא הוא מספר שתראו מצטטים כיתרון, אבל לא כדאי לסמוך עליו: import botasaurus נמדד ב־0.08ms, וזה נשמע כמו מסגרת קלה מאוד — אבל בפועל זו רק דלת כניסה ריקה.
מה Botasaurus בעצם
Botasaurus — omkarcloud/botasaurus ב־GitHub, עם 5,561 כוכבים, 486 forks ו־58 issues פתוחים כששלפתי את המטא־דאטה ב־14 ביולי 2026 — היא מסגרת Python, לא ספרייה ממוקדת־מטרה אחת. הגרסאות שבדקתי היו botasaurus 4.0.97 עבור המטא־חבילה ו־botasaurus-driver 4.0.92 עבור המנוע שמתחתיה. המטא־חבילה מצהירה על requires-python >=3.7 (הדרייבר, >=3.5), וסיווגי PyPI שלה טוענים לתמיכה עד Python 3.11 בלבד. אצלי היא הותקנה ועברה בדיקת import בסיסית על Python 3.14.2. זו עדות לגבי ההתקנה הזו, לא הבטחת תאימות לכל היכולות.
חשוב להצמיד לה תווית קטגוריה מדויקת, כי היא קובעת מהו בכלל "טוב". Botasaurus יושב בצד של framework על הספקטרום, באותה שכונה כמו Scrapy ו־Crawlee — מאמצים את המבנה שלו, את הדקורטורים, את מוסכמות העבודה, ובתמורה הוא מנהל את כל הצנרת. זו הצעה אחרת לגמרי לעומת דרייבר ממוקד כמו nodriver, שמספק חיבור ל־Chrome DevTools Protocol ואז זז הצידה. Botasaurus כולל דרייבר (זה botasaurus-driver), אבל עוטף אותו ברץ משימות, שכבת caching, סריאליזציה של פלט, ולקוח request. לא קונים כאן דרייבר; קונים תהליך עבודה מוכתב־דעה שבתוכו יש דרייבר.
שלושת הדקורטורים הם כל התכנון הזה במיניאטורה, ושלושת נקודות הכניסה אמיתיות — אימתתי ש־botasaurus.browser.browser, botasaurus.request.request ו־botasaurus.task.task קיימים ונטענים. @browser מריץ את הפונקציה מול דרייבר דפדפן "מאנושי". @request מריץ אותה מול לקוח HTTP קליל שמחפש להיראות כמו דפדפן. @task הוא העטיפה הכללית לכל מה שלא שייך בבירור לשני הראשונים. מוסיפים דקורטור, ו־Botasaurus מספק את כל המנגנון מסביב: הרצה מקבילית, שימוש חוזר בדרייבר, caching של תוצאות, וכותבים ל־JSON, CSV, Excel ו־HTML. זה רעיון קוהרנטי. האם רוצים כל כך הרבה מסגרת סביב סקרייפר? זו כבר שאלה של טעם, לא של תקלה.
המסקנה והגבול שלה
Botasaurus הוא כלי מיומן, בנוי טוב, ועושה את מה שמסגרות אמורות לעשות: מקצר את המקרה הנפוץ. מודל הדקורטורים נקי. רישיון MIT באמת נדיב. ההתקנה עובדת בלי דרמה. אם הייתי מדרג את ה־ergonomics של ה־API, הוא היה מקבל ציון טוב.
אבל מה שחוזר ומעסיק אותי הוא שהבטחת הדגל של המסגרת עצמה — anti-detection — היא בדיוק הדבר שסקירה אחראית לא יכולה לשפוט בלי לכוון אותה מול הגנות ייצור של מישהו אחר. לדרייבר יש בהחלט surface API שממותג כ־anti-detection: מתודות שאימתתי את קיומן, אבל לא הפעלתי מול שום יעד. זה כל מה שאטען עליו. לא כיוונתי אותו לאתר מוגן, לא מדדתי שיעור הצלחה, לא ביצעתי reverse engineering למנגנון, ולא ארמוז על אף אחד מהשלושה בניסוח. המתודות קיימות במחלקה. מה שהן עושות בשטח הוא נושא לסקירה אחרת — לא לזו.
מה שמופיע בהמשך הוא מלאי של יכולות, התקנה, משאבים ורישוי, לצד מה שהדרייבר עושה על דף שאני שולט בו — טענה צרה יותר ממה שרוב הסקירות לכלי הזה מציעות, והצרות הזו היא בדיוק העניין.
מה הוא מגלה על עצמו
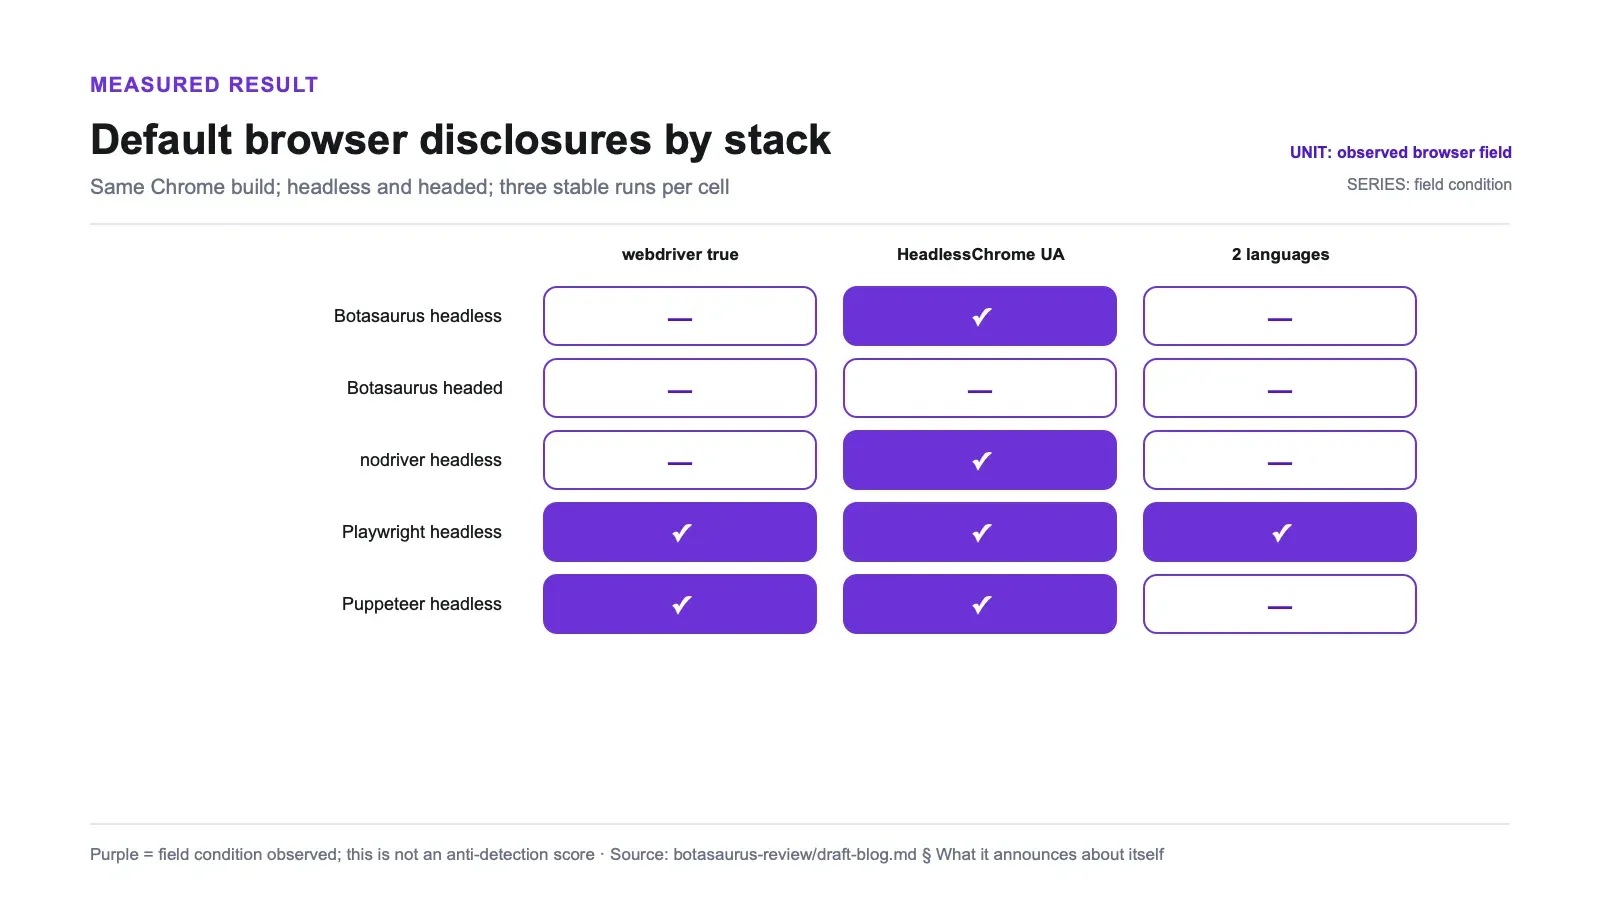
יש שאלה שאפשר לענות עליה בלי להתקרב בכלל להגנה אמיתית: כשהדפדפן מונע על ידי Botasaurus, מה הוא חושף על עצמו בפני הדף שהוא טוען? כתבתי דף שקורא את הדברים הברורים — navigator.webdriver, user-agent, platform, languages, מספרי plugins ו־hardware, הצורה של window.chrome, מה ש־Permissions API אומר, וגדלי חלון ומסך — הוצאתי אותו מ־127.0.0.1, ושלחתי אליו ארבעה stacks: Botasaurus, nodriver, וגם Playwright ו־Puppeteer רגילים כקבוצות בקרה. כל ארבעת הסטאקים הפעילו את אותו build של Chrome (Chrome for Testing 151.0.7922.10), כך שכל הבדל הוא של הספרייה ולא של הדפדפן. מצב headless ו־headed, שלוש הרצות לכל אחד. כל ערך שמופיע כאן נשאר זהה בכל שלוש ההרצות.
| Stack | Mode | navigator.webdriver | User-agent token | navigator.languages |
|---|---|---|---|---|
| Botasaurus 4.0.92 | headless | false | HeadlessChrome/151.0.0.0 | ["en-US"] |
| Botasaurus 4.0.92 | headed | false | Chrome/151.0.0.0 | ["en-US"] |
| nodriver 0.50.3 | headless / headed | false | HeadlessChrome/151 / Chrome/151 | ["en-US"] |
| Playwright 1.56.0 | headless / headed | true | HeadlessChrome/151 / Chrome/151 | ["en-US","en"] |
| Puppeteer 24.16.0 | headless / headed | true | HeadlessChrome/151 / Chrome/151 | ["en-US"] |
ההבדלים תלויים באיזו נקודת בקרה משתמשים. מול Puppeteer רגיל, Botasaurus שינה את navigator.webdriver; רשימת השפות וגדלי החלון באפס־פיקסלים התאימו, בעוד שה־user-agent נבדל רק בפורמט גרסתו. מול Playwright רגיל, ההבדלים שנצפו כללו גם את רשימת השפות וגם את גאומטריית החלון. מול nodriver, הערך הבוליאני והשפות התאימו, ורק פורמט ה־user-agent נבדל בשדות שמוצגים כאן. אלו תצפיות על חשיפה ברירת־מחדל, לא ציון anti-detection.
שני פרטים הופכים את זה למעניין יותר מה־false היבש. הראשון הוא איך הערך מגיע לשם. בכל ארבעת הסטאקים, המאפיין עדיין מגיע מה־getter הטבעי של הדפדפן על Navigator.prototype — function get webdriver() { [native code] } — ולא כמאפיין עצמאי שהודבק לאובייקט עצמו, ולא כפונקציה שהוחלפה. כלומר, Botasaurus לא כותב את המאפיין מחדש אחרי טעינת הדף; הערך נקבע כשהדפדפן עולה, והמאפיין עצמו נשאר לא נגוע.
הפרט השני הוא זה שמסייג את השיווק. במצב headless, ה־user-agent של Botasaurus עדיין מציג HeadlessChrome/151.0.0.0 — בדיוק כמו Puppeteer רגיל, בדיוק כמו Playwright רגיל. אם מריצים headed הוא הופך ל־Chrome/151.0.0.0, שוב באופן זהה. לבנאי Driver יש פרמטר user_agent, כך שאפשר לקבוע אחד בקלות דרך ארגומנט, אבל ברירת המחדל לא מסתירה את המחרוזת הכי מפורסמת שמסמנת אוטומציה בדפדפן.
כמעט הכול האחר היה זהה בין כל ארבעת הסטאקים, וחשוב לומר זאת במפורש כי זה מצמצם את הסיפור — כל מאפיין למטה קיבל את אותו ערך ב־Botasaurus, nodriver, Playwright ו־Puppeteer:
| Property | Value, identical on all four stacks |
|---|---|
platform | MacIntel |
vendor | Google Inc. |
| Plugins | five |
| MIME types | two |
pdfViewerEnabled | true |
| Logical cores | twelve |
| Reported device memory | 16 GB |
| Touch points | zero |
window.chrome | present, with app/csi/loadTimes and no runtime |
| WebGL renderer string | identical across all four |
הקלישאה הישנה שבה Permissions API ו־Notification.permission סותרים זה את זה לא הופיעה בשום מקום — כל הארבעה החזירו default ו־prompt בהתאמה. בנוסף סרקתי את document ואת window כדי למצוא שאריות בסגנון cdc_ שהיו מוכרות מגרסאות ישנות של WebDriver: לא נמצא דבר בארבעתם.
עוד דבר שחשוב לדעת לפני פריסה: עם כל ה־122MB שלו, Botasaurus לא מגיע עם דפדפן ואינו מוריד אחד. find_chrome_executable() מצביע על מה שכבר מותקן במכונה — אצלי, /Applications/Google Chrome.app, גרסה 150.0.7871.187 — וזה גם ה־version שמופיע ב־user-agent. החווה שלך מודיעה על כל Chrome שיש אצלך בפועל; למסגרת כל כך דעתנית, זו ברירת מחדל מפתיעה מאוד בחוסר הדעתנות שלה.
צריך לומר מה זה ומה זה לא. זו רשימה של מה שמערך אוטומטי חושף כשאף אחד לא ביקש ממנו להסתיר — שימושי אם אתה בצד המגן, שימושי אם אתה רוצה לדעת מה הכלים שלך משדרים. זו לא מדידה של האם זה משנה לשירות מסוים כלשהו. לא בדקתי את זה, ואף שורה למעלה לא צריכה להיקרא כהבטחת תוצאה.
קריאה סלחנית יותר למבנה הזה
הצהרת נוכחות היא דבר אחד; החזרת ה־HTML הנכון היא כבר העבודה עצמה. הרצתי את Botasaurus מול אותו fixture תלת־תוכן ששאר הבנצ'מרק הזה משתמש בו, כך שהמספרים מתיישרים עם כל כלי אחר שנמדד כאן. הדף מכיל שלושה דברים: A, קישור סטטי שהסימון שלו הוא ליטרל בתוך הבייטים המוגשים; B, צומת שנבנה על ידי script מוטמע במהלך parse, כשהסימון וה־URL שלו מורכבים מחלקים כך שרק הרצת ה־JavaScript מגלה אותם; ו־C, צומת שמוזרק 800ms אחרי אירוע ה־load, באותה צורה. Class C הוא האדברסרי — קריאה שנלקחת בזמן ה־load לא יכולה לראות אותו.
| Stack | Default read | With an explicit wait |
|---|---|---|
| Botasaurus 4.0.92 | 2 of 3 (A + B, misses C) | 3 of 3 |
| nodriver 0.50.3 | 2 of 3 | 3 of 3 |
| Playwright 1.56.0 | 2 of 3 | 3 of 3 |
| Puppeteer 24.16.0 | 2 of 3 | 3 of 3 |
Botasaurus נוחת בדיוק במקום שבו גם הכבדים נוחתים. driver.get() ואחריו driver.page_html נותנים snapshot בזמן טעינת הדף: הוא מרנדר JavaScript נכון — Class B מוכיח את זה, כי Class B כלל לא קיים בבייטים המוגשים — אבל בהשהיה של 800ms הוא מפספס את Class C. מוסיפים driver.wait_for_element("#delayed-injected") ומקבלים את שלושתם. התוצאה יציבה לאורך שלוש חזרות ושלוש הרצות נפרדות של כל הסוויטה, בלי flakes.
החלק המעניין מופיע כשסורקים את זמן ההזרקה כדי למצוא מתי כל stack מפסיק לתפוס אותו בברירת המחדל:
| Class-C injected after | Botasaurus | nodriver | Playwright | Puppeteer |
|---|---|---|---|---|
| 0 ms | found | found | found | found |
| 100 ms | found | — | — | — |
| 200 ms | found | — | — | — |
| 300 ms | found | — | — | — |
| 400 ms and up | — | — | — | — |
כל שאר הסטאקים מפספסים את Class C ברגע שההזרקה מתרחשת 100ms או יותר אחרי ה־load. Botasaurus עדיין קולט אותו ב־300ms, ורק ב־400ms הוא מוותר. זה Botasaurus מתנהג כמו framework, והסיבה כתובה בתוך הבנאי: wait_for_complete_page_load=True היא ברירת המחדל, ולכן get() מחזירה מאוחר יותר באופן משמעותי לעומת load event פשוט. בפועל, קריאת ברירת המחדל שלו עולה 401–431ms של זמן שעון, לעומת 119–129ms ב־nodriver ו־125–171ms ב־Puppeteer.
ב־fixture המקומי הזה, הטרייד־אוף היה בערך 250ms לכל ניווט תמורת snapshot ברירת מחדל מאוחר יותר. זה תפס תוכן שהוזרק עד 300ms אחרי ה־load בהרצות האלה; זה לא מוכיח ש־Botasaurus מדויק יותר בכל אתר אקראי. אם אתם כותבים סקרייפרים מהירים בלי תנאי המתנה מפורשים, הריפוד הזה עשוי למנוע פספוס של צומת מאוחר. אבל בנפח ניווט גבוה, או כשכבר מחכים לתנאי מדויק, זו פשוט תקורה.
עוד שני זמנים לקנה מידה. העלאת הדפדפן עצמה מציבה את Botasaurus בערך באותו אזור כמו nodriver ו־Puppeteer, והרחק מאחורי Playwright:
| Stack | Browser launch, across runs |
|---|---|
| Botasaurus 4.0.92 | 986–1151 ms |
| nodriver 0.50.3 | 910–1583 ms |
| Puppeteer 24.16.0 | 969–1008 ms |
| Playwright 1.56.0 | 282–365 ms |
ו־wait_for_element() לא עולה כלום נוסף עד עיכוב של 300ms — כי get() כבר התייצרה מעבר להזרקה — ואז קופצת לכ־1.42 שניות ב־400–800ms ול־2.43 שניות ב־1500ms.
שאלת ה־122MB: מה בעצם מתקין מטא־חבילה
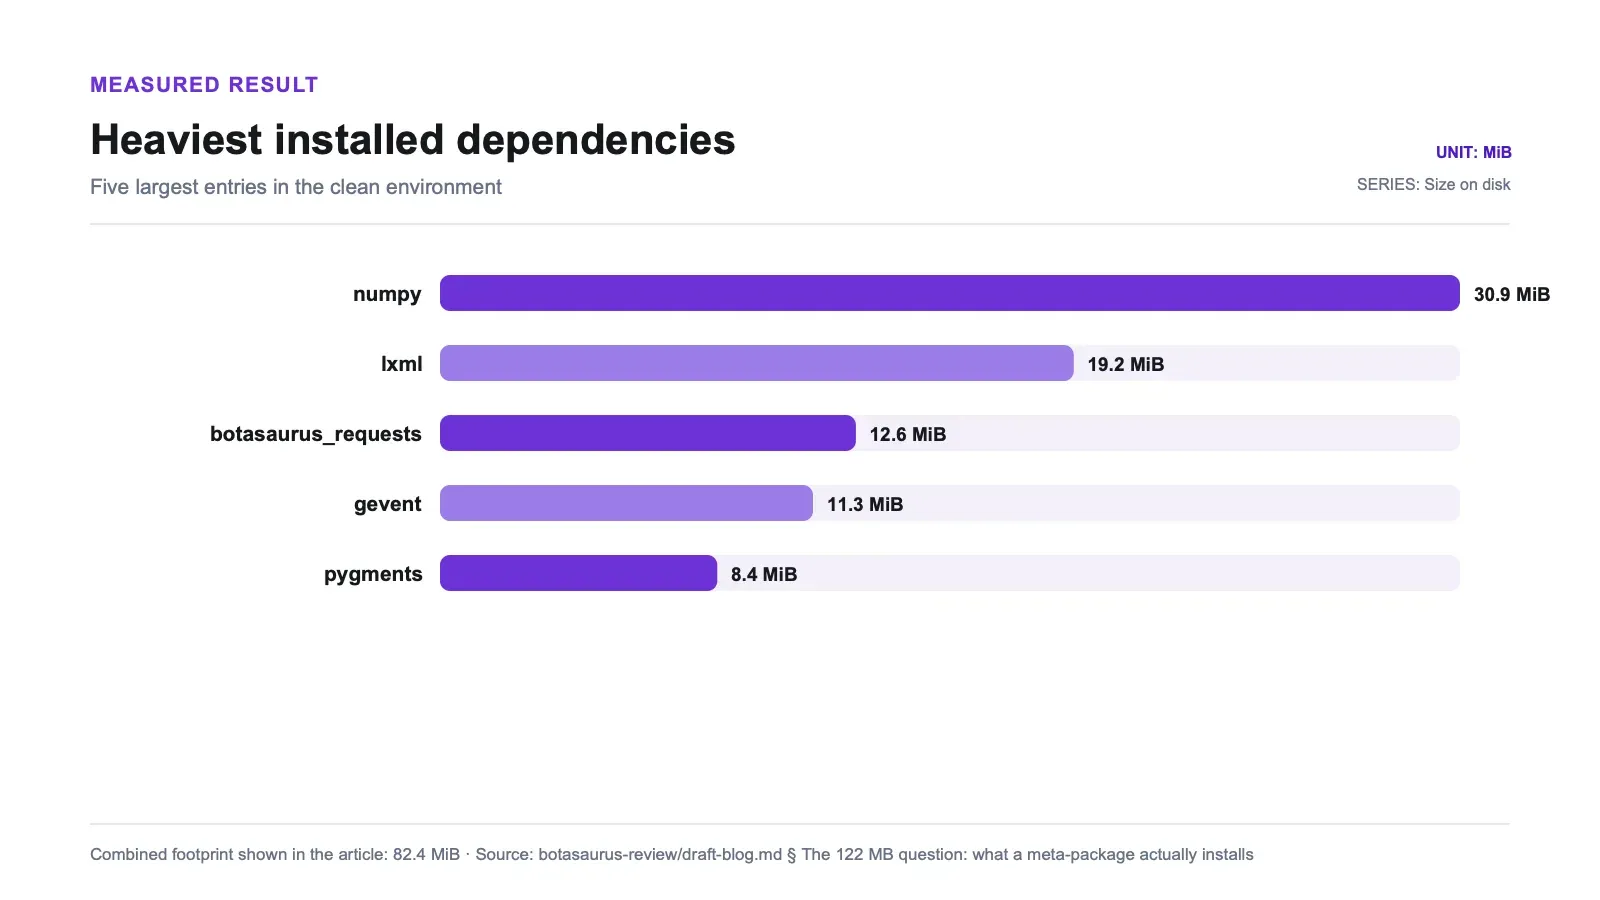
הנה החשבון, כי זה הדבר השימושי ביותר שאפשר לתת לך. pip install botasaurus נקי בסביבת וירטואלית חדשה יצר עץ site-packages בגודל 122.3MB על פני 44 חבילות dist-info. אם מוציאים מזה את pip עצמו (10.9MB, שזה overhead של ה־venv ולא משהו ש־Botasaurus ביקש), מגיעים בערך ל־111MB של המסגרת והתלויות. דרייבר הדפדפן — הרכיב שעושה את האוטומציה בפועל — הוא בערך 4MB מתוך זה. כלומר, בערך 107MB הם כל השאר שהמטא־חבילה החליטה שאתם צריכים.
לאן זה הולך? חמש התלויות הטרנזיטיביות הכבדות ביותר לבדן תופסות את רוב הנפח (כל שורה היא ערך install_footprint.heaviest_deps_mb בקובץ artifacts/raw/runs/resource_baseline.run1.json; הסכום הוא שלי, לא שדה בקובץ):
| Package | Size on disk |
|---|---|
| numpy | 30.9 MB |
| lxml | 19.2 MB |
| botasaurus_requests | 12.6 MB |
| gevent | 11.3 MB |
| pygments | 8.4 MB |
| Five packages combined | 82.4 MB (30.9 + 19.2 + 12.6 + 11.3 + 8.4) |
העובדה ש־numpy הוא הפריט הגדול ביותר הייתה זו שהרימה לי גבה — זו ספריית אלגברה ליניארית שיושבת בתוך כלי שתפקידו להביא ולנתח דפי אינטרנט. זה לא שגוי, אלא פשוט הרבה מכונה עבור השליחות הזו. מסגרות צוברות תלויות שירות, ומשהו בעץ כנראה צריך חישובי מערכים. פשוט מדובר בכמות חומרה לא מבוטלת עבור המשימה.
כדי להבין את הסקאלה, הדרייבר הממוקד nodriver שוקל בערך 17.2MB על פני 6 חבילות באותו מחשב — כלומר בערך פי 7 קל יותר. (המספר הזה לא מגיע מאותו pack: הוא install_footprint.site_packages_total_mb בקובץ artifacts/raw/runs/resource_baseline.run1.json של nodriver עצמו, שנמדד בהרצה נפרדת ובאותו host, ו־122.3 חלקי 17.2 שווה 7.1.) אף אחד מהמספרים האלה אינו תקלה, וזו לא דירוג יכולות; זה פשוט ההבדל המכני בין framework שכולל הכול לבין דרייבר ממוקד. בקונטיינר, footprint כזה נכנס לשכבת האפליקציה. זה לא גודל image מלא, והבדיקה הזו לא מדדה build או זמן cold-deploy.
עוד פיתול אחד של footprint: בזמן הבדיקה הפנימית, השימוש הראשון ב־from botasaurus.request import request גרר הורדה חד־פעמית של בערך 12.8MB. ההרצה שנלכדה לא זיהתה טוב מספיק את הארטיפקט והיעד, ולכן אי אפשר להתייחס לזה כתוספת footprint יציבה בהתקנה. כן אפשר לראות מזה שקוד־path הזה עשוי לדרוש גישת רשת בשימוש הראשון, וזה משהו שכדאי לשחזר אצלכם בתמונה לפני פריסה מנותקת־רשת.
מספר הייבוא שמטעה
מדידת cold-start של import היא המקום שבו קריאה שטחית של המספרים משתבשת. על פני שבעה subprocess imports נקיים, import botasaurus ברמת top-level נמדד ב־מֶדיאַן של 0.08ms. אם מצטטים את זה לבד, זה נשמע כמו המסגרת הקלה ביותר בקטגוריה.
אבל היא לא. היא מהירה כי כמעט אין שם כלום. חבילת botasaurus ברמת top-level חושפת אין __version__ וכמעט אין namespace ציבורי — import שלה בקושי עושה עבודה, כי כמעט אין בה תוכן. המספר שבאמת חשוב לכלי CLI או ל־cold start של serverless הוא ייבוא המנוע: from botasaurus_driver import Driver נמדד סביב 135ms, יציב עד כדי כמה מילישניות בין הרצות. זה העלות הקבועה האמיתית שאתם משלמים לפני שדף אחד אפילו נמשך. ואחרי שהמנוע נטען, הזיכרון התושב עומד על בערך 29–30MB — שוב, עוד לפני שקיים תהליך Chrome כלשהו. מפעילים דפדפן אמיתי, וזה גדל משמעותית; לא מדדתי זיכרון עם דפדפן פעיל, ולכן לא אתן לזה מספר.
המסקנה קצרה אבל חדה: העובדה ש־import botasaurus מיידי היא תוצאה של חבילת top-level חלולה, לא של framework זול. אם אתם ממדדים cold start, תמדדו את הייבוא שבו באמת תשתמשו.
צורת ה־API: 99 מתודות מאחורי דלת כניסה כמעט ריקה
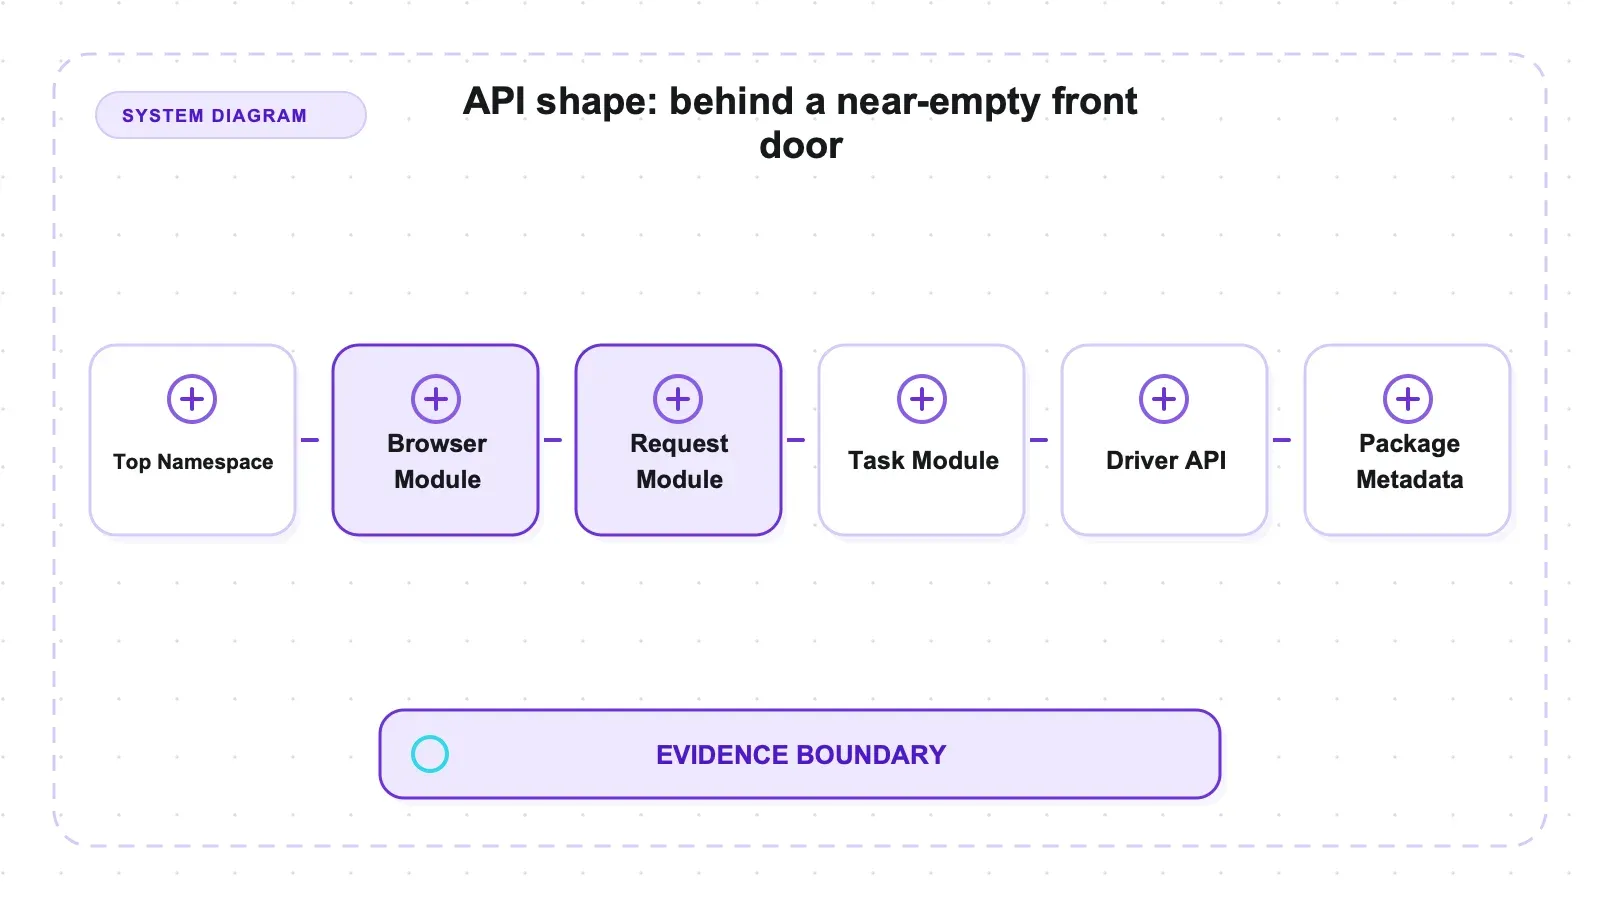
מחלקת Driver של המנוע חושפת 99 מתודות ציבוריות — surface רחב שמכסה ניווט, שאילתות על אלמנטים, cookies ו־local storage, פעולות עכבר ומקלדת, צילומי מסך, ניהול טאבים, passthrough ל־CDP והעלאת קבצים. הבנאי מקבל 18 פרמטרים, וממפה יפה את מרחב הכיוונון: headless, proxy, profile, tiny_profile, block_images, block_images_and_css, wait_for_complete_page_load, chrome_executable_path, extensions, arguments, user_agent, window_size, lang, ועוד כמה. כ־API שנקבע בזמן יצירה, הוא מכסה את כל בקרי הדפדפן הרגילים.
המלכוד של הצורה נמצא למעלה, והוא לא מזיק אבל כן אמיתי. import botasaurus נותן namespace כמעט ריק — אין __version__, וכמעט אין שמות ציבוריים ברמת top-level. כל מה שבאמת משתמשים בו נמצא בתת־מודולים: from botasaurus.browser import browser, Driver, from botasaurus.request import request, from botasaurus.task import task. אם תחפשו botasaurus.__version__ כדי לרשום איזה build רץ, לא תמצאו; תצטרכו לפנות ל־importlib.metadata במקום. שום דבר מזה לא שובר כלום. זה פשוט לא המבנה שרוב מפתחי Python מצפים לו באופן אינסטינקטיבי, והידיעה הזו חוסכת חמש דקות מבולבלות ביום הראשון.
תצפית אחת על התיעוד של המתודות שסימנתי קודם היא לגיטימית ונשארת בתוך הגבול שלי: מבין המתודות שממותגות anti-detection, רק 2 נושאות docstring בתוך הקוד. השאר מתארות את עצמן לפי השם בלבד, בעוד שהתיעוד המלא לכל מתודה נמצא באתר התיעוד החיצוני ולא בקוד המותקן. זו הערה על מיקום המידע, לא על איכות — הרבה ספריות טובות משאירות את התיעוד הפרוזאי מחוץ לקוד — אבל אם זרימת העבודה שלכם היא "קוראים את המקור כדי להבין את המתודה", רוב המשטח הזה יספר לכם רק את השם שלו.
רישוי: MIT לכל אורך הדרך, עד הדרייבר עצמו
גם המטא־חבילה וגם botasaurus-driver מצהירים על MIT, עם הסיווג התקני License :: OSI Approved :: MIT License. MIT הוא רישוי נדיב: בלי copyleft, בלי חובה לפתוח את הקוד שלכם, ועם מעט מאוד חיכוך לאימוץ מסחרי. זו אכן נקודת הבדל אמיתית ומשמעותית לעומת nodriver, דרייבר anti-detect סמוך, שמגיע תחת AGPL-3.0 — רישיון copyleft עם סעיף שימוש ברשת שמטריד לא מעט מחלקות משפטיות. אם הרישוי הוא שיקול מסנן עבורכם, ל־Botasaurus יש יתרון ממשי כאן.
אבל שוב יש הערת־שוליים של מטא־חבילה. ה־MIT הנדיב חל על חבילות המקור של Omkar Cloud עצמה. הוא לא מאשר אוטומטית את כ־40 חבילות התלות הטרנזיטיביות שההתקנה מושכת, שלכל אחת מהן רישיון משלה. אימתתי את ה־MIT ברמת העל של החבילות ש־Omkar Cloud מפרסמת; לא ביצעתי audit רישוי לכל תלות בעץ. עבור פרויקט תחביב ההבחנה הזו כמעט אף פעם לא משנה. עבור אימוץ מלא בארגון ששם לב ל־software bill of materials, עץ של 40 חבילות הוא בדיוק המקום להעביר דרך סורק רישיונות לפני שמתחייבים — לא כי מצאתי בעיה, אלא כי לא בדקתי, ומטא־חבילה היא בדיוק המקום שבו רישיון מפתיע אוהב להתחבא.
יתרונות וחסרונות
יתרונות:
- עיצוב נקי של שלושה דקורטורים (
@browser/@request/@task), וכל שלושת נקודות הכניסה אושרו כקיימות — המסגרת מקצרת את המקרה הנפוץ. - רישיון MIT גם במטא־חבילה וגם בדרייבר, בניגוד ממשי ל־AGPL-3.0 של דרייבר מקביל. נדיב, נוח לשימוש מסחרי, בלי copyleft.
- Surface רחב לדרייבר: 99 מתודות ציבוריות ובנאי עם 18 פרמטרים, שמכסים את צורכי האוטומציה הרגילים בדפדפן.
- הותקן ועבר בדיקות import בסיסיות על Python 3.14.2 ו־3.12.13, מעבר לרשימת הסיווגים שלו (שנעצרת ב־3.11); תאימות runtime לא הוכחה.
- חלון ברירת המחדל הרחום ביותר מבין כל הסטאקים שבדקתי: הוא עדיין קולט תוכן שמוזרק 300ms אחרי ה־load, בעוד nodriver, Playwright ו־Puppeteer מפספסים כבר ב־100ms.
wait_for_complete_page_load=Trueבאמת עובד. - מדווח על
navigator.webdriverכ־falseכברירת מחדל, במקוםtrueכמו בשני הסטאקים הרגילים, בלי patching של המאפיין — ה־descriptor נשאר ה־getter הטבעי של הדפדפן. - הכול מגיע כלול בתכנון — caching, parallelism, שימוש חוזר בדרייבר ופלט ל־JSON/CSV/Excel/HTML הם חלק מהמסגרת, לא תוספות.
חסרונות:
- כבד על הדיסק: 122.3MB על פני 44 חבילות, בערך פי 7 מדרייבר ממוקד, כשבפועל הנפח נגרם מתלויות כמו numpy (30.9MB) ו־lxml (19.2MB) ולא מהדרייבר עצמו, שהוא בערך 4MB.
- ה־0.08ms המרגיע של import ברמת top-level מטעה; ייבוא המנוע שבו באמת תלויים הוא בערך 135ms, והזיכרון אחרי הייבוא עומד על 29–30MB עוד לפני כל דפדפן.
- חלון הקריאה הרחום יותר הזה לא חינמי: 401–431ms לכל navigate-and-read, לעומת 119–129ms בדרייבר קליל על אותו דף ואותו Chrome.
- ריצות headless עדיין מציגות
HeadlessChromeב־user-agent כברירת מחדל, בדיוק כמו הסטאקים הרגילים; אמנם קיים פרמטרuser_agentבבנאי, אבל שום דבר לא מגדיר אותו בשבילכם. - עבור 122MB הוא עדיין לא מספק דפדפן — הוא פשוט מניע את Chrome שכבר מותקן במחשב, כך שגרסת הדפדפן שנחשפת היא מה שיש בפועל על המכונה.
- השימוש הראשון ב־
@requestגרר בהרצה הזו הורדה חד־פעמית של כ־12.8MB; הארטיפקט והיעד לא נלכדו מספיק טוב כדי להתייחס לזה כתוספת footprint יציבה. - חבילת top-level כמעט ריקה ואינה חושפת
__version__; ה־API האמיתי וגם הגרסה עצמה נמצאים במקום פחות מובן מאליו. - לרוב המתודות שממותגות anti-detection אין docstring בתוך הקוד, ולכן קריאת המקור מספרת לכם שמות, לא התנהגות.
מעבר למה שהמספרים האלה מכסים, ולכן לא נבדק כאן: הכול לגבי יעילות anti-bot בעולם האמיתי (מחוץ לטווח במכוון), זיכרון פר־דף, טיפול בפרוקסי ובפרופילים, תפוקה בקנה מידה, וכל פלטפורמה שאינה macOS arm64. מדידות ה־footprint והייבוא הופקו בלי להפעיל דפדפן בכלל; מדידות ה־recall וה־disclosure מגיעות מדפדפנים שדיברו רק עם fixture ב־127.0.0.1.
למי זה מתאים, ומי עדיף שיוותר
Botasaurus מתאים אם אתם רוצים framework ולא רק רכיב. אם אתם מתחילים פרויקט scraping מקובץ ריק ומעדיפים לאמץ מבנה במקום להרכיב אחד — דקורטורים לנקודות כניסה, caching והרצה מקבילית כבר בפנים, וכותבי פלט מובנים — זו אפשרות קוהרנטית עם רישיון MIT. MIT הוא רישיון נדיב, אבל מודל השימוש וההפצה שלכם עדיין דורש בדיקת תאימות רגילה. צוותים שכבר חושבים במונחים של Scrapy או Crawlee ימצאו את המסגור הזה מוכר.
עדיף לוותר, או לפחות לחשוב פעמיים, אם יעד הפריסה שלכם רגיש לגודל. התקנה של 122MB עם numpy ו־gevent בעץ היא הרבה לשגר לתוך קונטיינר דק כשכל מה שאתם באמת צריכים הוא "להניע דפדפן ולחלץ כמה שדות." דרייבר ממוקד ייתן לכם את האוטומציה במשקל קטן בהרבה, במחיר של כתיבת כל הצנרת מסביב בעצמכם. ועדיף לוותר לגמרי אם מה שאתם מחפשים הוא החלטה לגבי יעילות anti-detection, כי זה בדיוק הדבר שבכוונה לא בדקתי — אחרת הייתם סומכים על טענת שיווק שלא אישרתי ולא הפרכתי.
חלופות, ואיפה Thunderbit נכנס
המסגור הישר קודם כול: Botasaurus הוא חינמי, ברישיון MIT, ומאוחסן אצלכם. אתם מפעילים את החווה, אתם מנהלים את העדכונים, ואתם מחזיקים את כל עץ התלויות — כל 44 החבילות שבו — כולל תיקונים, תאימות רישוי, וכל מה ש־numpy יחליט לעשות בגרסה עתידית. עבור הרבה צוותים, הבעלות הזו היא בדיוק מה שהם רוצים, ואף שירות מנוהל לא מנצח "framework שכבר יש לכם" בעלות גולמית.
בעולם הקוד הפתוח, ההשוואות השימושיות הן לפי צורה. אם אתם בצד של framework כמו Botasaurus, Scrapy ו־Crawlee הן המועמדות הברורות להשוואה — בשלות, דעתניות, ולכל אחת מהן מוסכמות עבודה משלה. אם אתם רוצים Markdown מוכן ל־LLM מתוך דף במקום framework שמארגן crawler, Crawl4AI ו־Trafilatura ממוקדות דווקא בזה. אם אתם אוהבים את הזווית של Python ו־anti-detect אבל רוצים משהו קל יותר ממטא־חבילה, Scrapling שווה מבט, ואם שפת קומפילציה היא אופציה, ספריית Go בשם Colly מחליפה רינדור JavaScript במהירות ובנפח קטן. כל אפשרות שמניעה דפדפן, כולל Botasaurus, יורשת את פרופיל העלות שמופיע בהשוואת Playwright מול Puppeteer שלנו — דפדפנים אמיתיים לא זולים להרצה, וזו אחת הסיבות שהמסגרת שסביבם שוקלת כמו שהיא שוקלת.
שירות מנוהל נכנס בנקודה אחרת באותו צינור. Botasaurus הוא הסטאק המפותח והמאוחסן־אצלך; Thunderbit מוכר את המנוהל, ומכוון לאותם מפתחים. ה־Open API הוא שני endpoints. POST /distill (1 credit) מחזיר דף כ־Markdown נקי ומוכן ל־LLM, עם רינדור ו־anti-bot שמטופלים בצד השרת, כך שלא תצטרכו להקים דפדפן או עץ תלויות בכלל. POST /extract (20 credits) מחזיר JSON מובנה לפי JSON Schema שאתם מגדירים, עם renderMode של none, basic או full לפי כמה דפדפן הדף באמת צריך. לשניהם יש גרסאות batch לעד מאה כתובות בבת אחת. יש גם שרת MCP לסוכנים ולעוזרי קוד — thunderbit_suggest_fields הוא חינמי ואומר לכם מה דף חושף לפני שתוציאו משהו — וגם CLI דרך npx @thunderbit/thunderbit-cli ל־cron ול־CI. למי שלא מפתח ולא רוצה לגעת בכל זה, הסיומת ל־Chrome מריצה את אותו מנוע ככלי no-code, וההדרכות ב־ערוץ YouTube של Thunderbit מכסות את הזרימות הנפוצות.
המסחר הוא איפה העבודה יושבת, לא איזה כלי "טוב יותר". Botasaurus משאיר את ה־framework, את צי הדפדפנים, את התלויות, את התשתית ואת התחזוקה בצד שלכם, בלי עמלת vendor לכל בקשה; אבל compute, רוחב־פס, פרוקסי ותפעול עדיין עולים כסף. API מנוהל מוריד מכם את עבודת הרינדור והפלט המובנה, וגובה לפי קריאה — אפשר להשוות זאת מול setup מאוחסן־אצלך בעמוד התמחור.
נסו את Thunderbit לחילוץ נתוני ווב
פסק דין
Botasaurus הוא מועמד סביר אם אתם רוצים מסגרת Python all-in-one ומוכנים לסבול את footprint התלויות שלה. עיצוב שלושת הדקורטורים נקי, surface הדרייבר רחב, והוא עבר בדיקות התקנה וייבוא על גרסאות Python חדשות יותר מאלה שמופיעות בסיווגים שלו. ב־fixture המקומי שלי, snapshot ברירת המחדל גם תפס תוכן שהוזרק 300ms אחרי ה־load, בעוד שהסטאקים האחרים שנבדקו פספסו כבר ב־100ms; זו תוצאה של fixture, לא דירוג כללי.
אבל צריך למדוד את הטענות נכון. זו התקנה של 122MB ו־44 חבילות, כשהדרייבר הוא בערך 4MB וכל השאר הוא numpy, lxml, gevent וחבריהם — בערך פי 7 מדרייבר ממוקד, והמשקל הזה הוא חלק מזמן ה־docker build ומזמן ה־cold-deploy שלכם. ה־0.08ms של ייבוא top-level הוא דלת כניסה חלולה, לא framework קל; ייבוא המנוע ב־~135ms הוא המספר שגובים מכם. חלון הקריאה הסלחני הזה עולה בערך 250ms על כל navigation. ובשאלת ה־default disclosure שבאמת יכולתי לענות עליה, התמונה מצומצמת יותר ממה שהשיווק רומז: רק ערך בוליאני אחד שונה מ־Puppeteer רגיל, ה־user-agent ב־headless עדיין אומר HeadlessChrome, וכל מאפיין אחר שמדדתי היה זהה בין כל ארבעת הסטאקים. ההבטחה ל־stealth שמוכרת את הכלי היא בדיוק הדבר שהסקירה הזו לא מדרגת — אישרתי שהמתודות קיימות, הרצתי את הדרייבר מול דף על המחשב שלי, ועצרתי שם, במכוון. אם יודעים את ה־footprint, מתעלמים ממספר הייבוא המחמיא, ומתייחסים ל־stealth marketing כשאלה פתוחה, Botasaurus הוא framework הוגן שעושה בדיוק מה ש־framework עושה. אם תצפו לדרייבר קליל כנוצה, תופתעו בזמן docker build.
נסו את Thunderbit לחילוץ נתוני ווב Get Started Free
שאלות נפוצות
האם Botasaurus חינמי, ומה הרישיון שלו?
כן, הוא חינמי וברישיון MIT — גם המטא־חבילה botasaurus וגם המנוע botasaurus-driver נושאים את סיווג ה־MIT המאושר על ידי OSI. MIT הוא רישיון נדיב, כך שאין חובת copyleft והוא ידידותי לשימוש מסחרי, וזה הבדל משמעותי לעומת דרייברים anti-detect דומים שמופצים תחת AGPL-3.0. הסתייגות אחת: MIT מכסה את החבילות של Omkar Cloud עצמה, אבל לא אוטומטית את כ־40 תלויות הטרנזיטיביות שההתקנה מושכת, לכן כדאי להריץ סריקת רישוי משלכם לפני אימוץ ארגוני של כל העץ.
כמה גדולה התקנה של Botasaurus, ולמה import botasaurus נראה מיידי בכל זאת?
התקנה נקייה של pip install botasaurus יצרה אצלי עץ site-packages של 122.3MB על פני 44 חבילות. דרייבר הדפדפן עצמו שוקל רק בערך 4MB — המשקל מגיע מהמטא־חבילה שמושכת עץ תלות רחב, ובראשו numpy (30.9MB), lxml (19.2MB), botasaurus_requests (12.6MB), gevent (11.3MB) ו־pygments (8.4MB). זה בערך פי 7 מה־footprint של דרייבר ממוקד כמו nodriver באותו מחשב. שום דבר מזה אינו תקלה; זה המחיר של "הכול כלול", והוא הכי חשוב כשמסתכלים על גודל image של קונטיינר. זמן הייבוא הוא המקום שבו ה־footprint הזה מתחבא: import botasaurus נמדד בכ־0.08ms, אבל רק משום שחבילת top-level כמעט ריקה — בלי __version__, כמעט בלי שמות ציבוריים, ולכן הייבוא כמעט לא עושה כלום. הייבוא שעולה לכם כסף הוא המנוע, from botasaurus_driver import Driver, בכ־135ms, עם זיכרון תושב של כ־29–30MB אחרי הייבוא ולפני ש־Chrome בכלל עולה. אם אתם ממדדים cold start ל־serverless, תמדדו את ייבוא המנוע, לא את הייבוא הריק של top-level.
מה Botasaurus חושף על עצמו, והאם נבדק מול מערכות anti-bot אמיתיות?
החלק הראשון נמדד; השני נבנה כך שלא ייבדק. על דף שהגשתי מ־127.0.0.1, כשהדרייבר מפעיל את אותו build של Chrome כמו קבוצות הבקרה: navigator.webdriver חוזר כ־false, בעוד ש־Playwright רגיל ו־Puppeteer רגיל מחזירים true. הערך הזה נקבע בזמן עליית הדפדפן, לא באמצעות patching של המאפיין — ה־descriptor הוא עדיין ה־getter הטבעי של Chrome. מעבר לזה, כמעט הכול התאים לבקרה בדיוק: אותו platform string, חמישה plugins, שתים־עשרה ליבות, 16GB של device memory מדווח, אותה צורת window.chrome, בלי סתירה מ־Permissions API, ובלי שאריות בסגנון cdc_ על document או window. ריצות headless עדיין מציגות HeadlessChrome/151.0.0.0 ב־user-agent, בדיוק כמו שתי הבקרות — ל־Driver יש פרמטר user_agent, אבל שום דבר לא מגדיר אותו בשבילכם. לגבי היעילות: לא כיוונתי את הדרייבר לאתר חי, לא יצרתי קשר עם שירות anti-bot, ולא נגעתי ב־CAPTCHA. הדרייבר כולל סט מתודות שממותג anti-detection, ואימתתי שהן קיימות, אבל לא קראתי להן, לא בחנתי אותן מול יעד, לא מדדתי שיעור הצלחה, ולא תיארתי מנגנון. טבלת החשיפה למעלה אומרת לכם מה הסטאק מצהיר על עצמו, ולא מי מאזין או מה הוא עושה עם זה.
האם Botasaurus יודע להתמודד נכון עם תוכן שמרונדר ב־JavaScript?
כן, וברירת המחדל שלו סלחנית יותר מרוב המתחרים. על fixture עם שלוש מחלקות תוכן, driver.get() יחד עם driver.page_html החזירו 2 מתוך 3 בעיכוב הזרקה של 800ms — כלומר JavaScript נרנדר כמו שצריך, אבל הקריאה נעשית לפני שתוכן מאוחר מאוד מגיע — ואילו driver.wait_for_element() החזיר 3 מתוך 3. מה שמייחד אותו הוא המקום שבו קריאת ברירת המחדל מוותרת: Botasaurus עדיין קולט תוכן שהוזרק 300ms אחרי ה־load, בעוד ש־nodriver, Playwright ו־Puppeteer מפספסים כבר ב־100ms. זה נובע מ־wait_for_complete_page_load=True בבנאי, וזה עולה בערך 250ms לכל navigation.
איך בעצם מייבאים ומשתמשים ב־Botasaurus אחרי ההתקנה?
לא כמו שהייתם מנחשים. ה־namespace ברמת top-level של botasaurus כמעט ריק, ולכן ה־API האמיתי יושב בתת־מודולים: from botasaurus.browser import browser, Driver, from botasaurus.request import request, ו־from botasaurus.task import task. מעטרים פונקציה רגילה ב־@browser, @request או @task, והמסגרת מטפלת בדרייבר, ב־caching ובפלט מסביב. ומאחר שאין botasaurus.__version__, כדאי להשתמש ב־importlib.metadata אם צריך לרשום איזה build רץ.




