
Le web, ce n’est plus seulement le terrain de jeu des vidéos de chats et des mèmes : c’est aujourd’hui la source de données la plus vaste, la plus chaotique et la plus précieuse au monde. Les entreprises sont lancées dans une vraie course à la donnée : les retailers surveillent chaque jour les prix de leurs concurrents, et les équipes orientées data se tournent de plus en plus vers une extension de navigateur plutôt que d’ouvrir un ticket pour l’ingénierie. Que tu travailles dans la vente, le marketing, l’ecommerce ou les opérations, obtenir les bonnes données — rapidement et dans le bon format — peut faire toute la différence entre prendre une longueur d’avance ou se faire doubler.
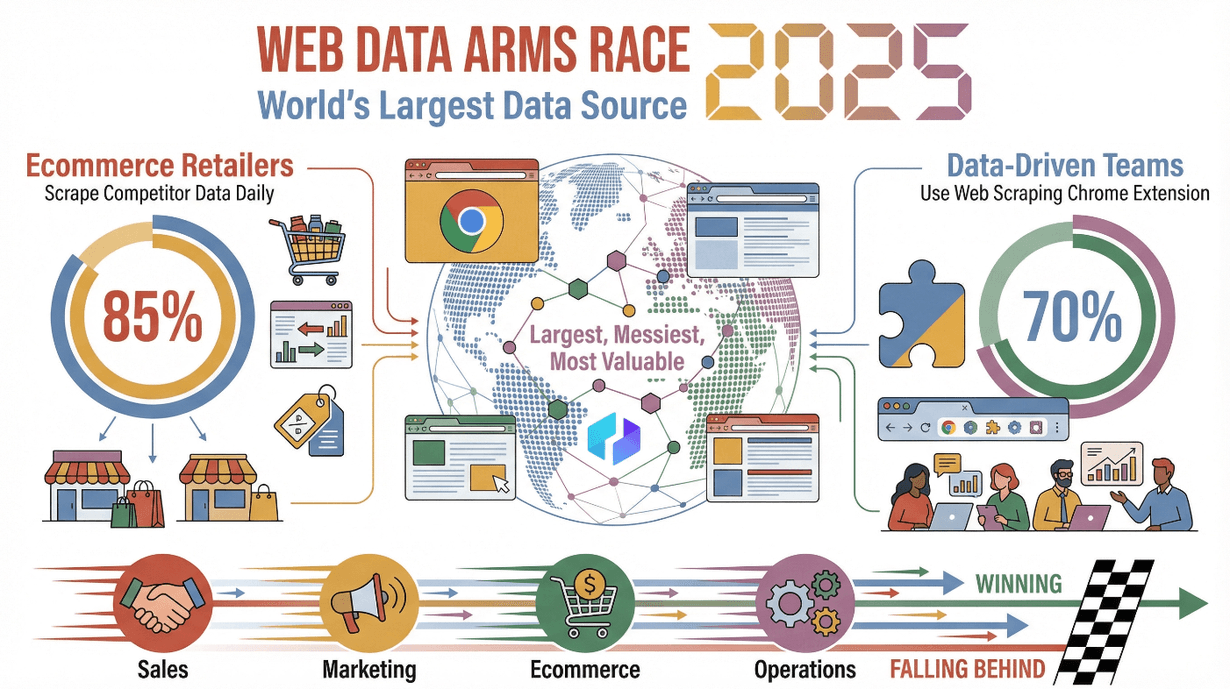 Mais il y a un hic : les sites web ne déroulent pas vraiment le tapis rouge quand il s’agit de récupérer des données. Ils sont souvent complexes, dynamiques et pensés pour des humains, pas pour des tableurs. C’est là que les outils de web scraping entrent en scène : ils transforment le bazar en tableaux clairs, propres et vraiment exploitables. Après des années passées dans le SaaS et l’automatisation, j’ai pu voir de mes propres yeux qu’un bon outil fait gagner des heures, améliore la précision et fait remonter des insights qui étaient là, juste sous ton nez.
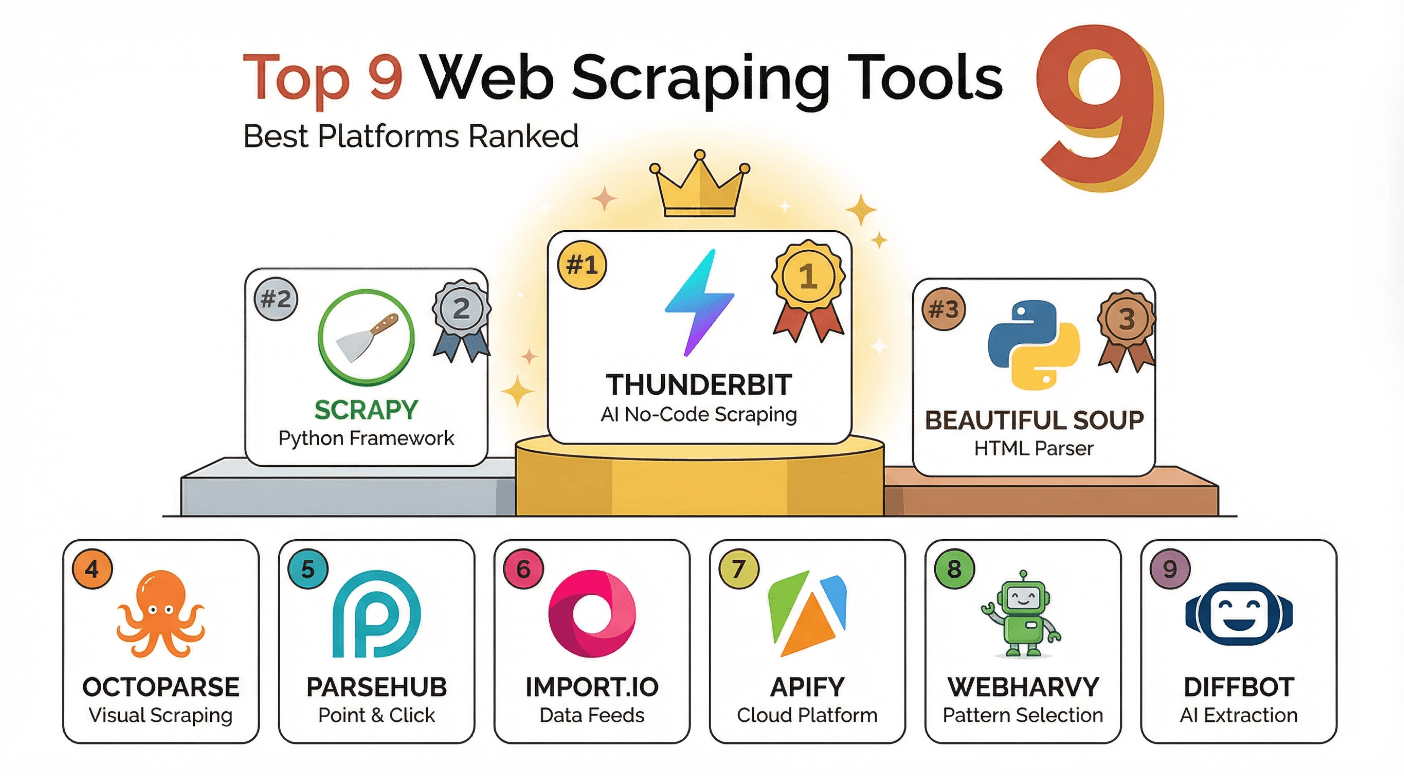
Alors, quels outils de web scraping valent vraiment le coup en 2025 ? J’ai retenu les neuf meilleurs — des extensions Chrome boostées à l’IA pour les utilisateurs métier jusqu’aux frameworks open source pour les développeurs. Allons droit au but.
Pourquoi les outils de web scraping sont essentiels pour les entreprises modernes
Extrayez des données de n’importe quel site grâce à l’IA Get Started Free
Les outils de web scraping sont l’arme secrète d’une prospection plus intelligente, d’un marketing plus fin et d’opérations plus souples. Voici pourquoi ils sont devenus incontournables :
- Génération de leads : les équipes commerciales extraient des annuaires, LinkedIn et des sites d’avis pour bâtir des listes de prospects bien ciblées.
- Analyse concurrentielle : les équipes marketing et ecommerce suivent les prix, les lancements de produits et les emplacements publicitaires des concurrents — souvent en temps réel.
- Études de marché : chercheurs et analystes rassemblent avis, actualités et sentiment utilisateur pour repérer les tendances avant tout le monde.
- Surveillance des prix : les retailers et les marques suivent les prix et les stocks sur des centaines de sites pour rester compétitifs (Kanhasoft).
- Agrégation de contenu : les équipes opérationnelles récupèrent des données depuis les offres d’emploi, annonces immobilières ou catalogues fournisseurs pour fluidifier leurs workflows.
Voici un aperçu rapide de la façon dont les outils de web scraping soutiennent les résultats business :
| Cas d’usage métier | Douleur du manuel | Solution de web scraping |
|---|---|---|
| Génération de leads | Copier-coller depuis des dizaines de sites | Extraction automatisée, export en masse |
| Surveillance des prix | Vérifications manuelles quotidiennes | Scraping planifié, alertes instantanées |
| Études de marché | Lecture de centaines d’avis | Jeux de données agrégés et structurés |
| Agrégation de contenu | Fusion de données provenant de plusieurs sites | Export unifié vers Excel/Sheets |
| Analyse concurrentielle | Données lentes et incomplètes | Insights complets en temps réel |
Le retour sur investissement est bien réel : les équipes qui adoptent des outils de scraping modernes passent de plusieurs jours à seulement quelques heures pour collecter et rechercher de l’information, et les équipes commerciales utilisent souvent ces données pour personnaliser leurs arguments.
Comment nous avons choisi les meilleurs outils de web scraping
Tous les outils de web scraping ne se valent pas. Certains sont pensés pour les utilisateurs métier qui veulent des résultats sans écrire une ligne de code ; d’autres s’adressent aux développeurs pour des projets sur mesure à grande échelle. Voici les critères retenus pour faire notre sélection :
- Facilité d’utilisation : un non-développeur peut-il en tirer de la valeur rapidement ? L’interface est-elle intuitive ?
- Scalabilité : l’outil peut-il gérer des centaines, voire des millions de pages ? Peut-il automatiser et planifier des tâches ?
- Options d’export des données : export vers Excel, Google Sheets, Airtable, Notion ou via API ?
- Support et communauté : la documentation est-elle solide ? Y a-t-il des tutoriels et un support réactif ?
- Tarifs et rapport qualité-prix : existe-t-il une offre gratuite ? Les formules payantes sont-elles claires et équitables ?
- Fonctionnalités uniques : extraction alimentée par l’IA, scraping de sous-pages, intégration API ou workflows visuels.
J’ai aussi relié chaque outil au cas d’usage business qui lui convient le mieux, pour que tu puisses trouver celui qui colle à tes besoins et à ton niveau technique.
1. Thunderbit
Thunderbit est mon premier choix pour les utilisateurs métier qui veulent faire du web scraping avec l’IA sans se casser la tête avec des complications techniques. En tant qu’extension Chrome, Thunderbit est pensé pour les équipes commerciales, marketing, ecommerce et opérations qui ont besoin vite de données précises et structurées.
Qu’est-ce qui fait ressortir Thunderbit ? Sa force, c’est sa simplicité alliée à de vraies capacités :
- Suggestion de champs pilotée par l’IA : clique sur « Suggest Fields with AI » et Thunderbit lit la page, te propose les colonnes (comme Nom, Prix, Email) et génère même des invites d’extraction pour chaque champ.
- Scraping de sous-pages : besoin de plus de détails ? L’IA de Thunderbit peut visiter chaque sous-page (comme une fiche produit ou un profil) et enrichir ton tableau, sans configuration.
- Export instantané : envoie tes données directement vers Excel, Google Sheets, Airtable ou Notion. L’export est toujours gratuit.
- Scraping planifié : automatise les tâches récurrentes (comme la vérification quotidienne des prix) grâce à une planification en langage naturel.
- Extracteurs gratuits d’emails, de téléphones et d’images : récupère des coordonnées ou des images depuis n’importe quel site en un clic.
- AI Autofill : laisse l’IA remplir les formulaires en ligne à ta place — parfait pour les workflows et les tâches répétitives.
Thunderbit est utilisé par plus de 200 000 utilisateurs dans le monde, et l’offre gratuite permet d’extraire jusqu’à 6 pages par mois. Les formules payantes démarrent à seulement 15 $/mois pour 500 crédits — une solution adaptée aux équipes de toutes tailles.
Si tu veux voir Thunderbit en action, jette un œil à notre chaîne YouTube ou explore notre blog pour des tutoriels et des conseils.
Essayer Thunderbit gratuitement
2. Scrapy
Scrapy est le framework open source de référence pour les développeurs qui veulent garder la main sur leurs projets de web scraping. Écrit en Python, Scrapy permet de créer des spiders personnalisés capables d’explorer, d’extraire et de traiter des données à grande échelle.
Pourquoi les développeurs aiment-ils Scrapy ?
- Framework puissant : prend en charge les crawls complexes à plusieurs niveaux, les pipelines personnalisés et l’intégration avec des API.
- Scalable : gère les projets de grande ampleur, les requêtes simultanées et peut extraire de nombreuses pages en parallèle (ZenRows).
- Extensible : ajoute des middlewares pour les proxies, les user agents ou le rendu JavaScript (avec Splash).
- Communauté active : une grande quantité de tutoriels, de plugins et d’aide pour les cas d’usage avancés.
Scrapy est particulièrement adapté aux équipes qui maîtrisent Python et qui ont besoin d’un scraping à grande échelle, d’une intégration dans des pipelines de données ou de workflows robustes et reproductibles. C’est gratuit et open source — mais il faut gérer son propre environnement et maintenir son code.
3. Beautiful Soup
Beautiful Soup est une bibliothèque Python très appréciée des débutants pour sa simplicité et sa puissance dans l’analyse HTML et XML. Si tu dois extraire rapidement des données depuis des pages web statiques, Beautiful Soup est un excellent compagnon.
Pourquoi choisir Beautiful Soup ?
- Facile pour débuter : simple à apprendre, avec une courbe d’apprentissage douce et de nombreux tutoriels (ScraperAPI).
- Analyse flexible : gère sans souci les HTML sales ou cassés.
- Parfait pour les petits projets : idéal pour des scripts ponctuels, des extractions rapides ou pour apprendre les bases du web scraping.
Ses limites ? Beautiful Soup n’est pas conçu pour les sites volumineux ou dynamiques, et ne gère pas JavaScript. Dans ce cas, mieux vaut l’associer à requests ou Selenium — ou passer à Scrapy.
4. Octoparse
Octoparse est un outil de web scraping no-code pensé pour tout le monde — des entrepreneurs solo aux équipes en entreprise. Son interface point-and-click facilite l’extraction de données, même depuis des sites complexes ou dynamiques.
Pourquoi les utilisateurs aiment Octoparse :
- Aucun code requis : constructeur de workflows visuel, sélecteurs par glisser-déposer et modèles prêts à l’emploi.
- Modes cloud et local : lance tes extractions sur ton ordinateur ou dans le cloud pour des tâches plus rapides et plus lourdes.
- Gère la pagination et le contenu dynamique : extrait les pages « Load more », le défilement infini et les sites AJAX.
- Options d’export : téléchargement en CSV, Excel, JSON, HTML ou export vers des bases de données (Octoparse Pricing).
L’offre gratuite d’Octoparse couvre les petits besoins, tandis que les formules payantes démarrent autour de 69 $/mois pour un usage plus intensif. C’est un favori pour les études de marché, l’analyse concurrentielle et tous ceux qui veulent des résultats sans coder.
5. ParseHub
ParseHub est un outil de scraping visuel particulièrement performant sur les sites riches en JavaScript et dynamiques. Son constructeur de workflow permet de cliquer, boucler et extraire de manière conditionnelle, même sur des sites délicats.
Les fonctionnalités qui font la différence chez ParseHub :
- Sélection visuelle des données : clique sur les éléments à extraire, parcoure des listes et gère les pages imbriquées.
- Prend en charge le contenu dynamique : extrait les données chargées par JavaScript, gère les menus déroulants et automatise les clics.
- Export flexible : téléchargement en CSV, Excel, JSON ou intégration avec Dropbox/Amazon S3 (Salesforge).
- Offre gratuite : jusqu’à 5 projets et 200 pages par exécution ; les formules payantes débloquent plus de puissance.
ParseHub est idéal pour les utilisateurs intermédiaires qui cherchent de la flexibilité sans plonger dans le code. Il est particulièrement apprécié pour le scraping ecommerce, les offres d’emploi et l’immobilier.
6. Import.io
Import.io est pensé pour l’extraction et la visualisation de données de niveau entreprise. Avec une vraie orientation vers les projets à grande échelle, Import.io propose une interface intuitive, un support solide et des analyses avancées.
Ce qui distingue Import.io :
- Extraction point-and-click : pas besoin de coder — il suffit de sélectionner les données souhaitées.
- Visualisation des données : outils intégrés pour analyser, représenter et partager tes résultats.
- Fonctionnalités entreprise : conformité, services managés et support pour gros volumes.
- Export et intégration : téléchargement en CSV, Excel ou intégration avec Google Sheets et des outils BI (Salesforge).
Les tarifs sont adaptés aux équipes enterprise, ce qui en fait une solution surtout pertinente pour les organisations qui ont de gros besoins en données et le budget qui va avec.
7. Apify

Apify est une plateforme d’automatisation web et d’extraction de données pensée pour passer à l’échelle. C’est l’un des favoris des développeurs pour créer, exécuter et partager des “actors” de scraping (scripts préconçus ou personnalisés).
Pourquoi Apify est un excellent choix :
- Marketplace d’actors : accède à plus de 200 scrapers prêts à l’emploi pour des sites courants, ou crée les tiens en JavaScript/Python.
- API-first : intègre les données extraites directement dans tes workflows ou tes applications.
- Déploiement cloud : lance des tâches à grande échelle, planifie des exécutions récurrentes et gère tout depuis un tableau de bord (Apify Pricing).
- Tarification flexible : offre gratuite pour les petits besoins ; paiement à l’usage pour les projets plus ambitieux.
Apify est parfait pour les équipes techniques qui veulent automatiser, scaler et intégrer la donnée web dans leurs processus métier.
8. WebHarvy
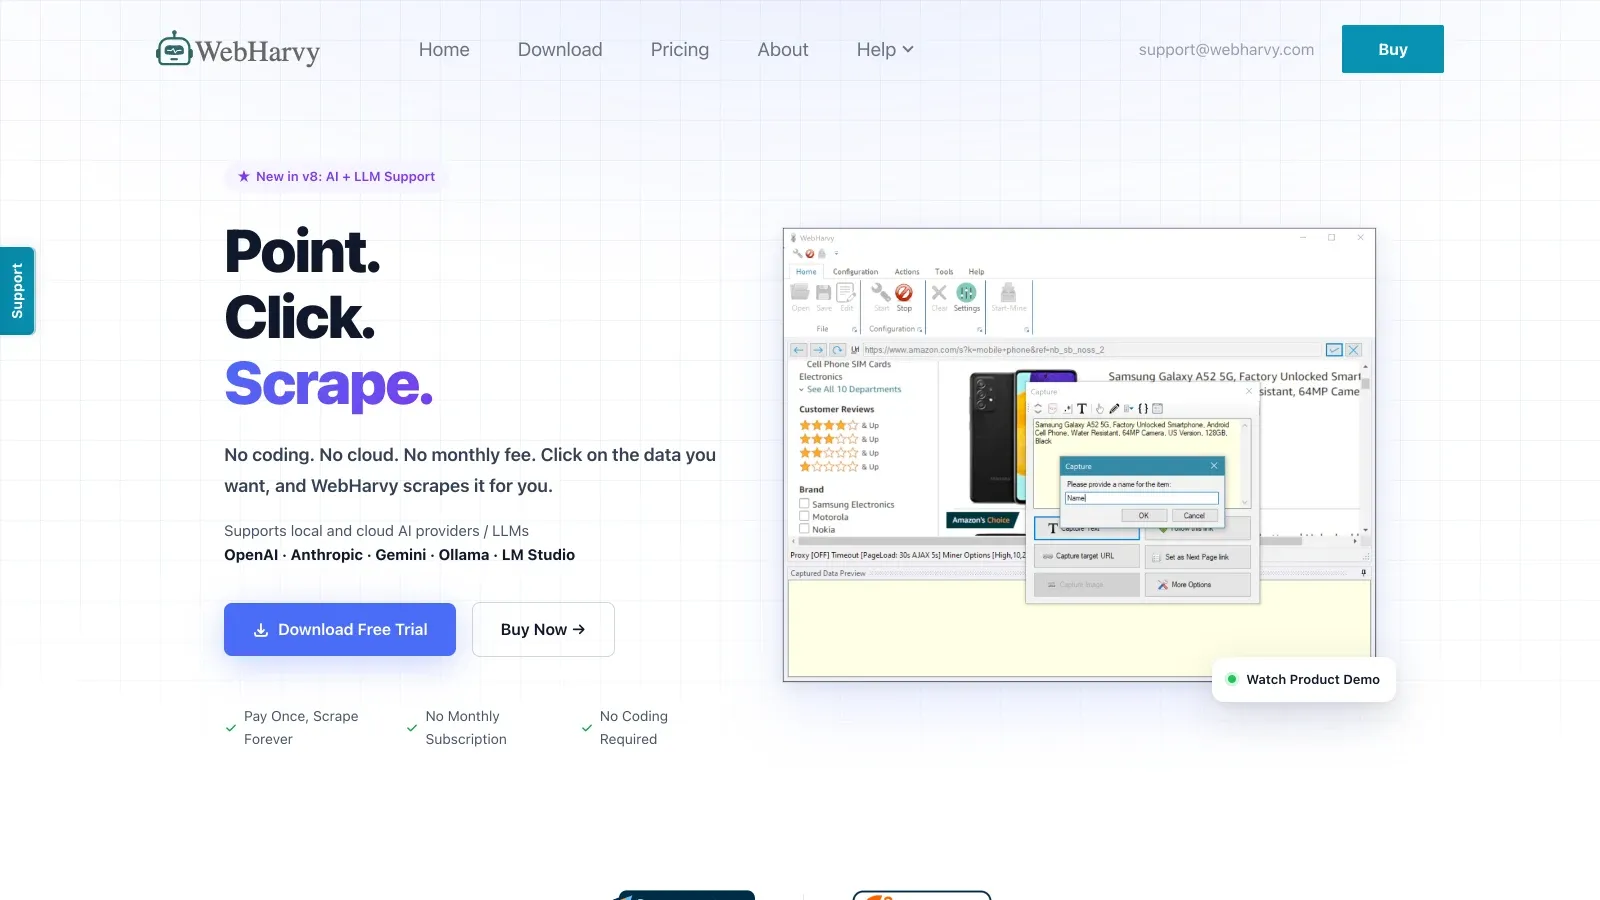
WebHarvy est un outil de web scraping point-and-click qui détecte automatiquement les motifs de données sur les pages web. Il a été pensé pour les non-développeurs qui veulent des résultats sans apprendre XPath ou les sélecteurs CSS.
Les principales fonctionnalités de WebHarvy :
- Détection automatique des motifs : clique sur un champ de données, et WebHarvy repère pour toi les éléments similaires (Thunderbit Blog).
- Prend en charge AJAX/JavaScript : gère le contenu dynamique, l’extraction d’images et l’extraction basée sur des mots-clés.
- Options d’export : téléchargement en Excel, CSV, XML, JSON ou SQL.
- Licence à vie : paiement unique, utilisation illimitée (avec un an de mises à jour et de support).
WebHarvy est très apprécié des petites entreprises, des chercheurs et des entrepreneurs solo qui préfèrent une approche visuelle et n’ont pas besoin d’automatisation avancée.
9. Diffbot
Diffbot est la référence IA de l’extraction de données web. Grâce au machine learning et à la vision par ordinateur, Diffbot transforme n’importe quelle page publique en données structurées — sans configuration manuelle.
Ce qui rend Diffbot unique :
- Extraction pilotée par l’IA : identifie et extrait automatiquement les entités, les relations et les faits présents sur les pages web (VentureBeat).
- Knowledge Graph : accès à une base massive, mise à jour en continu, de personnes, d’entreprises, de produits et plus encore.
- Accès API : intègre les données structurées dans tes applications, tes recherches ou tes workflows analytiques (Diffbot Docs).
- Prêt pour l’entreprise : utilisé par Microsoft, Adobe, Hubspot et d’autres grands acteurs.
Les tarifs commencent à 299 $/mois pour les startups, avec des options de paiement à la requête pour l’accès API (Diffbot Pricing). C’est une solution idéale pour la recherche, la data science en entreprise et tous ceux qui ont besoin d’une précision de niveau IA à grande échelle.
Tableau comparatif des outils de web scraping
Voici un aperçu comparatif des neuf outils :
| Outil | Idéal pour | Sans code | IA intégrée | Compatible API/Développeurs | Scraping de sous-pages | Options d’export | Tarif de départ |
|---|---|---|---|---|---|---|---|
| Thunderbit | Utilisateurs métier | Oui | Oui | Non | Oui | Excel, CSV, Sheets, Notion, Airtable | Gratuit (6 pages), 15 $/mois |
| Scrapy | Développeurs | Non | Non | Oui | Oui (personnalisé) | CSV, JSON, XML, DB | Gratuit, open source |
| Beautiful Soup | Débutants, devs | Non | Non | Oui | Non | Personnalisé (via Python) | Gratuit, open source |
| Octoparse | Non-développeurs, équipes | Oui | Non | Partiellement | Oui | CSV, Excel, JSON, DB | Gratuit, 69 $/mois |
| ParseHub | Sites visuels et dynamiques | Oui | Non | Partiellement | Oui | CSV, Excel, JSON, S3, Dropbox | Gratuit, 189 $/mois |
| Import.io | Enterprise, analytique | Oui | Non | Oui | Oui | CSV, Excel, Sheets, outils BI | Sur mesure, entreprise |
| Apify | Développeurs, automatisation | Non | Non | Oui | Oui | CSV, JSON, Sheets, API | Gratuit, paiement à l’usage |
| WebHarvy | Non-développeurs, PME | Oui | Non | Non | Oui | Excel, CSV, XML, JSON, SQL | 129 $ (paiement unique) |
| Diffbot | IA, recherche, entreprise | Non | Oui | Oui | Oui (crawl IA) | JSON, API Knowledge Graph | 299 $/mois |
Choisir le bon outil de web scraping selon vos besoins
Les meilleurs outils et logiciels de web scraping en 2025 Get Started Free
Alors, quel outil choisir ? Voici ma fiche mémo :
- Pour les non-développeurs / utilisateurs métier : Thunderbit, Octoparse, ParseHub, WebHarvy
- Pour les développeurs / l’automatisation : Scrapy, Beautiful Soup, Apify
- Pour les besoins entreprise / IA : Import.io, Diffbot
- Pour les sites dynamiques ou très riches en JavaScript : ParseHub, Octoparse, Apify
- Pour des exports instantanés et structurés : Thunderbit, Import.io
Mon conseil ? Pars de ton objectif business et de ton aisance technique. Si tu veux un scraping piloté par l’IA, simple à prendre en main et avec export immédiat, Thunderbit est très difficile à battre. Si tu veux un contrôle total ou construire des crawlers sur mesure, Scrapy ou Apify sont d’excellents choix. Pour les besoins à l’échelle entreprise ou les données pilotées par l’IA, Import.io et Diffbot font partie des références.
La plupart des outils proposent des essais gratuits ou des offres gratuites — donc n’hésite pas à en tester plusieurs pour voir celui qui s’intègre le mieux à ton workflow.
Extraire des données avec Thunderbit AI
FAQ
1. Qu’est-ce qu’un outil de web scraping et pourquoi en ai-je besoin ?
Un outil de web scraping est un logiciel qui extrait des données depuis des sites web et les transforme en formats structurés comme des tableurs ou des bases de données. Les entreprises les utilisent pour la génération de leads, la surveillance des prix, les études de marché, et bien plus encore — ce qui permet de gagner du temps et d’améliorer la précision par rapport au copier-coller manuel.
2. Le web scraping est-il légal ?
Le web scraping est légal lorsque tu extrais des données publiquement accessibles et que tu respectes les conditions d’utilisation du site. Évite toujours de collecter des informations personnelles ou sensibles sans consentement, et vérifie la réglementation locale.
3. Quel outil de web scraping est le meilleur pour les non-développeurs ?
Thunderbit, Octoparse, ParseHub et WebHarvy sont tous d’excellentes options pour les utilisateurs non techniques. Thunderbit se démarque grâce à sa suggestion de champs par IA et à ses exports instantanés vers Excel, Google Sheets, Notion ou Airtable.
4. Puis-je extraire des sites dynamiques ou riches en JavaScript ?
Oui ! Des outils comme ParseHub, Octoparse et Apify sont conçus pour gérer le contenu dynamique, AJAX et les pages « Load more ». L’IA de Thunderbit s’adapte aussi à de nombreuses structures de sites modernes.
5. Comment choisir le bon outil de web scraping pour mon entreprise ?
Prends en compte tes compétences techniques, le volume de données, tes besoins d’export et ton budget. Les non-développeurs devraient commencer avec Thunderbit ou Octoparse ; les développeurs préféreront peut-être Scrapy ou Apify ; les entreprises ayant de gros besoins en données peuvent se tourner vers Import.io ou Diffbot. La plupart des outils proposent des essais gratuits : teste-en quelques-uns et vois ce qui marche le mieux.
Prêt à transformer le web en nouvel avantage pour ton entreprise ? Télécharge Thunderbit ou explore notre blog Thunderbit pour d’autres guides et conseils. Bon scraping !
Essayer l’AI Web Scraper Get Started Free
En savoir plus
- Top 10 des outils automatisés de web scraping en 2025
- 15 meilleurs outils d’extraction de données en 2025
- Top 6 des outils essentiels de web scraper pour réussir en 2025
- Comment extraire efficacement les données d’un site web avec les meilleurs outils
- Les meilleurs outils et logiciels de web scraping en 2025



