Steam-Scraper










Steam-Daten mühelos mit Thunderbit freischalten
Steam-Layout ändert sich? Kein Problem
Genervt davon, dass Scraper bei jeder Designänderung von Steam kaputtgehen? Thunderbit nutzt semantische KI, um den Inhalt einer Seite zu verstehen — nicht nur starre Selektoren. Es passt sich Layout-Änderungen automatisch an, sodass Sie weiterhin Spielnamen, Preise, Nutzerbewertungen und andere wichtige Daten erfassen, ohne ständig nachbessern zu müssen.
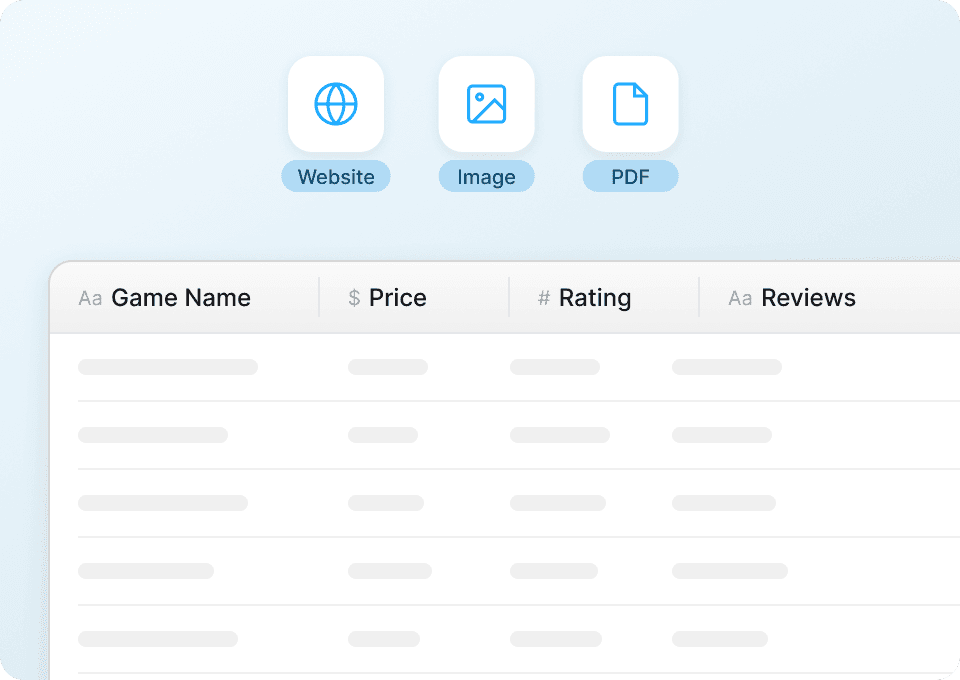
Saubere Steam-Daten sofort erhalten
Verschwenden Sie keine Zeit mehr damit, unordentliche Daten nach dem Scraping von Steam aufzubereiten. Thunderbit strukturiert und formatiert Ihre Daten bereits während der Extraktion automatisch. Exportieren Sie saubere Listen mit Spielnamen, Preisen, Rabattprozentsätzen, Bewertungen und Veröffentlichungsdaten mit nur einem Klick direkt nach Google Sheets, Notion oder Airtable.
Steam-Spieldaten blitzschnell in großen Mengen scrapen
Steam-Spielseiten einzeln zu scrapen kostet enorm viel Zeit. Thunderbit verarbeitet Hunderte von Seiten gleichzeitig. Geben Sie einfach eine Liste von Steam-URLs an, und Thunderbit extrahiert Spielnamen, Preise und Nutzerbewertungs-Scores aus allen Seiten in einem Bruchteil der Zeit.
Schwierigkeiten beim Scrapen von Steam-Daten?
Sehen Sie, wie Thunderbit das Steam-Scraping im Vergleich zu traditionellen Methoden vereinfacht.
Traditionelle Scraper
Die klassische VorgehensweiseThunderbit
Der intelligentere AnsatzVerlass dich nicht nur auf unser Wort
Sieh dir an, was unsere Nutzer über Thunderbit sagen.
Häufig gestellte Fragen
Verwandt Anwendungsfälle
Entdecke weitere Anwendungsfälle für Thunderbits Web-Scraper.
Flixster-Scraper
Mit dem Thunderbit Flixster Web-Scraper können Sie Daten aus Flixsters Top-Box-Office-Listen und nahegelegenen Kinos extrahieren. Dank KI-gestützter Feldvorschläge sammeln Sie im Handumdrehen Filmtitel, Einspielergebnisse, Bewertungen, Erscheinungsdaten, Kinonamen, Standorte und verfügbare Filme – ideal für Analysen oder Recherchen.
Mehr erfahren ->
olympustaff.com Scraper
Mit dem Thunderbit olympustaff.com Web-Scraper können Sie Daten aus Comics-Listen und Kommentaren auf olympustaff.com extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie schnell Comic-Titel, Autoren, Erscheinungsdaten und Leserfeedback – ideal für Analyse oder Recherche. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Daten von olympustaff.com benötigen.
Mehr erfahren ->
Hatena-Scraper
Mit dem Thunderbit Hatena Web-Scraper können Sie mühelos Daten aus Hatena-Blogs und Themenlisten extrahieren – dank KI-gestützter Feldvorschläge. Sammeln Sie Blogtitel, Autorennamen, Veröffentlichungsdaten, Inhaltszusammenfassungen und Trendthemen für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Hatena-Daten benötigen.
Mehr erfahren ->
namu.wiki Scraper
Mit dem Thunderbit namu.wiki Web-Scraper können Sie Daten von namu.wiki extrahieren – darunter relevante Seiten und neueste Diskussionen. Dank KI-gestützter Feldvorschläge sammeln Sie schnell und einfach Seitentitel, URLs, letzte Bearbeitungsdaten, Diskussionsthemen und Teilnehmernamen – ideal für Recherche, Content-Erstellung oder Community-Analysen.
Mehr erfahren ->
NetEase Music Scraper
Mit dem Thunderbit NetEase Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Künstlerseiten von NetEase Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albumdetails, Laufzeiten und Song-Links im Handumdrehen – perfekt für Analysen, Recherchen oder Musikliebhaber, die strukturierte NetEase Music Daten benötigen.
Mehr erfahren ->
QQ Music Scraper
Mit dem Thunderbit QQ Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Werkslisten von QQ Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albuminformationen, Veröffentlichungsdaten und vieles mehr im Handumdrehen – perfekt für Analysen oder Recherchen. Ideal für Musikexperten, Marketer und Musikliebhaber, die strukturierte Daten von QQ Music benötigen.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.



