Craigslist Scraper für lokale Anzeigen










Sichtbare Craigslist-Anzeigen in eine Tabelle verwandeln
Erfassen Sie die auf den gewählten Seiten angezeigten Details – mit dem Bewusstsein, dass jede Anzeige anders aussehen kann.
Craigslist-Anzeigen mit einem Klick erfassen
Öffnen Sie eine Ergebnis- oder Anzeigenseite. One Click Extract kann Titel, Text, Preis, Ort, Datum und URL als Felder vorschlagen. Sie können die Spalten ohne Programmierung anpassen.
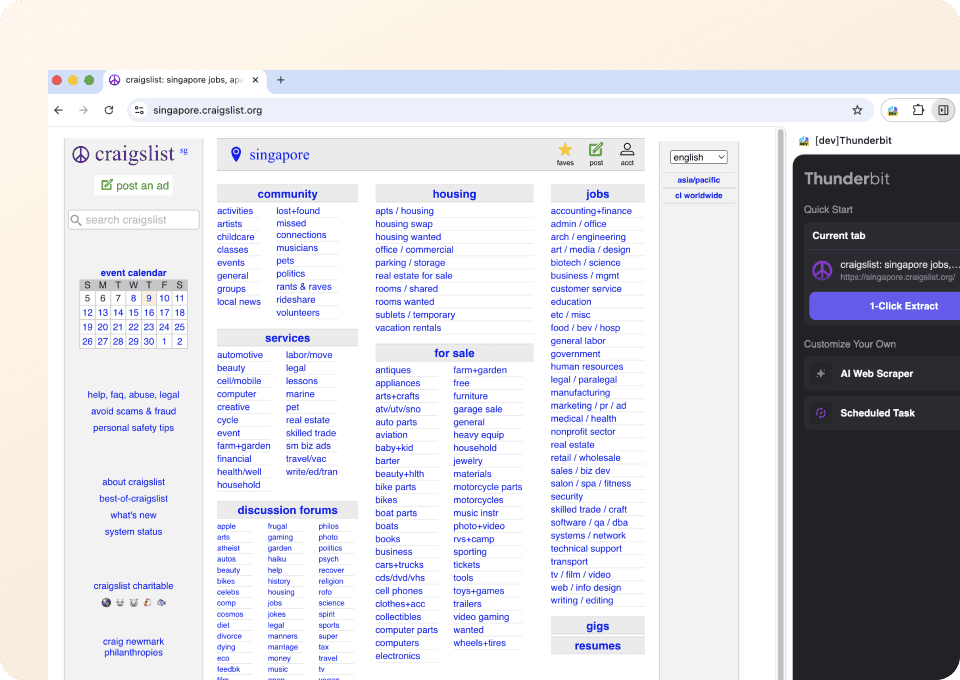
Felder über unterschiedliche Anzeigenlayouts hinweg auslesen
Craigslist-Bereiche und regionale Seiten zeigen unterschiedliche Felder. Thunderbit liest sichtbare Details nach Bedeutung statt nach festen Positionen. Fehlende oder verborgene Informationen bleiben leer.

Sichtbare Anzeigendetails direkt exportieren
Übertragen Sie jede Zeile in eine lokale Liste zur Anzeigenprüfung. Angebotspreise, Daten, Bereiche und Kategoriedetails bleiben der passenden Wohnungs-, Job- oder Verkaufsanzeige zugeordnet.

Jedes Craigslist-Detail beim passenden Beitrag behalten
Beim manuellen Kopieren können Preise, Daten und Orte von den Anzeigen getrennt werden, zu denen sie gehören.
Von Hand kopierte Anzeigen
Wichtiger Kontext geht verlorenStrukturierte Anzeigenzeilen
Sichtbare Details bleiben beim jeweiligen BeitragWelche Daten können Sie aus Craigslist extrahieren?
Wählen Sie aus diesen öffentlich sichtbaren Anzeigenfeldern. Welche Informationen erscheinen, hängt von Bereich, Region, Kategorie und den vom Anbieter freigegebenen Details ab.
- Anzeigentitel
- Anzeigentext
- Anzeigentyp
- Kategorie
- Craigslist-Bereich
- Unterbereich
- Stadtteil
- Angebotspreis
- Preisstatus
- Veröffentlichungsdatum
- Anzeigen-URL
- Bild-URLs
- Datenschutzmodus für Antwort-E-Mail
- Alternative Kontaktinformationen
- Stadt
- Bundesstaat
- Postleitzahl
- Breitengrad
- Längengrad
- Kontaktname
- Kontakttelefon
- Lieferung möglich
- Kryptowährung akzeptiert
- Sprache
- Zustand
- Hersteller
- Modell
- Schlafzimmer
- Badezimmer
- Wohnfläche
See how people build local listing shortlists
Watch short user videos about housing, job, and resale lists built from public Craigslist pages.
Fragen zum Erfassen von Craigslist-Anzeigen
Die Craigslist-Felder unterscheiden sich je nach Gebiet, Bereich, Kategorie und dem, was der Anbieter öffentlich macht.
Explore more ways to research public listings
Try other marketplace, housing, or local listing scrapers when your work goes beyond one Craigslist section or area.
Flixster-Scraper
Mit dem Thunderbit Flixster Web-Scraper können Sie Daten aus Flixsters Top-Box-Office-Listen und nahegelegenen Kinos extrahieren. Dank KI-gestützter Feldvorschläge sammeln Sie im Handumdrehen Filmtitel, Einspielergebnisse, Bewertungen, Erscheinungsdaten, Kinonamen, Standorte und verfügbare Filme – ideal für Analysen oder Recherchen.
Mehr erfahren ->
olympustaff.com Scraper
Mit dem Thunderbit olympustaff.com Web-Scraper können Sie Daten aus Comics-Listen und Kommentaren auf olympustaff.com extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie schnell Comic-Titel, Autoren, Erscheinungsdaten und Leserfeedback – ideal für Analyse oder Recherche. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Daten von olympustaff.com benötigen.
Mehr erfahren ->
Hatena-Scraper
Mit dem Thunderbit Hatena Web-Scraper können Sie mühelos Daten aus Hatena-Blogs und Themenlisten extrahieren – dank KI-gestützter Feldvorschläge. Sammeln Sie Blogtitel, Autorennamen, Veröffentlichungsdaten, Inhaltszusammenfassungen und Trendthemen für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Hatena-Daten benötigen.
Mehr erfahren ->
namu.wiki Scraper
Mit dem Thunderbit namu.wiki Web-Scraper können Sie Daten von namu.wiki extrahieren – darunter relevante Seiten und neueste Diskussionen. Dank KI-gestützter Feldvorschläge sammeln Sie schnell und einfach Seitentitel, URLs, letzte Bearbeitungsdaten, Diskussionsthemen und Teilnehmernamen – ideal für Recherche, Content-Erstellung oder Community-Analysen.
Mehr erfahren ->
NetEase Music Scraper
Mit dem Thunderbit NetEase Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Künstlerseiten von NetEase Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albumdetails, Laufzeiten und Song-Links im Handumdrehen – perfekt für Analysen, Recherchen oder Musikliebhaber, die strukturierte NetEase Music Daten benötigen.
Mehr erfahren ->
QQ Music Scraper
Mit dem Thunderbit QQ Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Werkslisten von QQ Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albuminformationen, Veröffentlichungsdaten und vieles mehr im Handumdrehen – perfekt für Analysen oder Recherchen. Ideal für Musikexperten, Marketer und Musikliebhaber, die strukturierte Daten von QQ Music benötigen.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.


